Tệp lookalike là gì? Cách tạo và tối ưu tệp tương tự
Tệp lookalike là gì? Đó là tệp đối tượng tương tự: nhóm người mới mà nền tảng quảng cáo (điển hình là Meta) tìm ra vì họ giống với một tệp nguồn do bạn cung cấp, ví dụ danh sách khách hàng tải lên, người truy cập web ghi nhận qua pixel, người tương tác với trang hay người xem video. Khi tạo, bạn chọn quốc gia và tỷ lệ từ 1% đến 10%: tỷ lệ càng nhỏ thì nhóm càng giống tệp nguồn, càng lớn thì nhóm càng rộng nhưng độ giống giảm dần.
Khi chạy quảng cáo đến một ngưỡng nhất định, tệp khách hàng cũ hoặc nhóm người từng tương tác với thương hiệu dần cạn, kéo theo chi phí trên mỗi lượt mua hàng tăng lên. Lúc này, tệp lookalike là một trong những cách phổ biến để tìm thêm khách mới cho phễu bán hàng. Tuy nhiên, nếu chỉ tải đại một danh sách số điện thoại lộn xộn lên rồi bấm tạo tệp, kết quả thường không như mong đợi. Bài viết này giải thích cơ chế của công cụ này, cách tạo tệp từng bước và cách tinh chỉnh dữ liệu đầu vào để tệp tương tự làm việc hiệu quả hơn.
Tệp lookalike là gì? Bản chất và sự khác biệt
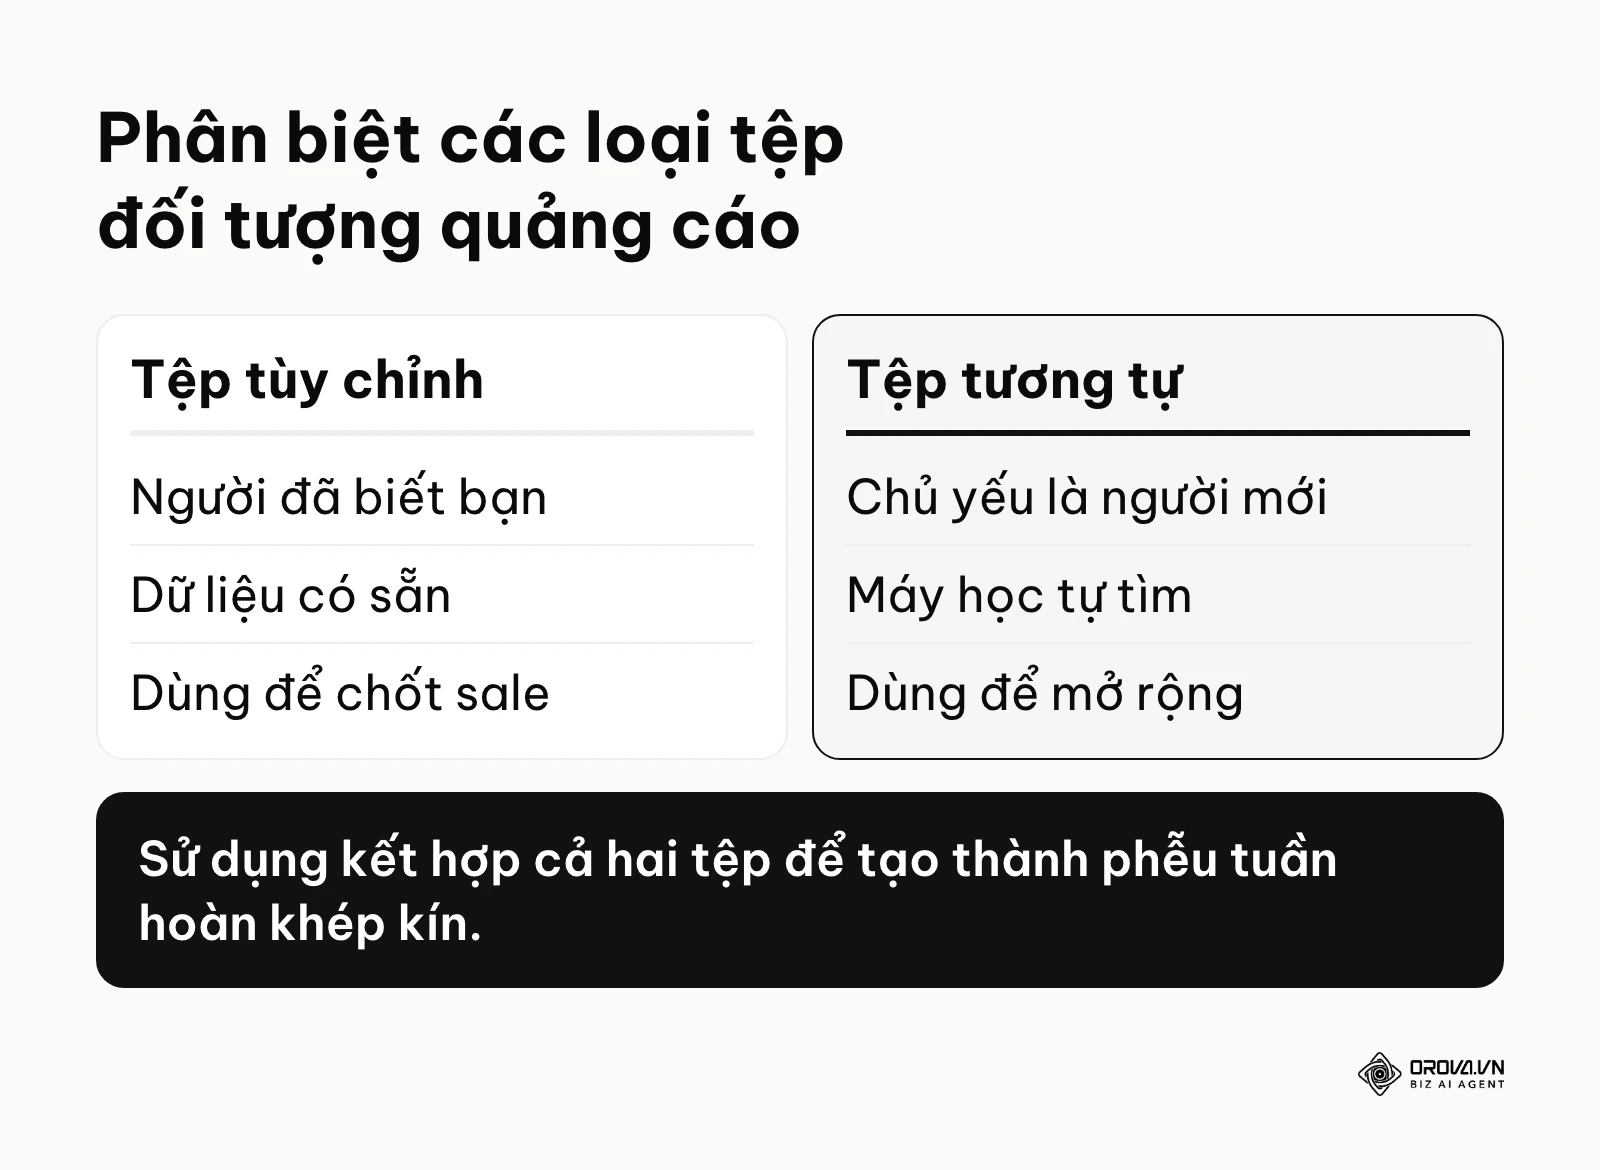
Tệp lookalike là tập hợp những người dùng mới có chung đặc điểm nhân khẩu học, sở thích và hành vi với một nhóm khách hàng gốc do bạn cung cấp. Công cụ này dùng để tiếp cận khách hàng tiềm năng mới, khác với tệp tùy chỉnh vì tệp tùy chỉnh gồm chính những người đã tương tác với bạn, còn tệp tương tự chủ yếu là người chưa từng biết thương hiệu.
Tính năng này ra đời từ nhu cầu mở rộng thị trường mà không phải tự đoán từng sở thích của khách. Hành vi lướt mạng ngày càng phân mảnh, nên nhắm mục tiêu bằng sở thích thủ công thường kém chính xác. Thay vào đó, nền tảng quảng cáo dựa trên dữ liệu của chính nền tảng để tìm những người có đặc điểm gần nhất với tệp nguồn của bạn.
| Đặc điểm | Tệp tùy chỉnh (Custom) | Tệp đối tượng tương tự (Lookalike) | Tệp lưu sẵn (Saved) |
|---|---|---|---|
| Bản chất dữ liệu | Người đã tương tác thật với bạn | Người hoàn toàn xa lạ với thương hiệu | Người do bạn tự đoán sở thích |
| Vai trò trong phễu | Chốt đơn trực tiếp (BOFU) | Kéo khách mới vào phễu (TOFU) | Thử nghiệm thị trường mới |
| Mức độ chính xác | Cực cao, tỷ lệ chốt tốt nhất | Phụ thuộc độ sạch của tệp nguồn | Thường khá thấp, hay bị nhiễu |
Ví dụ minh hoạ đời thường: Hãy tưởng tượng bạn mở một cửa hàng bán thiết bị cắm trại và có 500 khách quen thường mua lều cao cấp, thích lái xe địa hình vào cuối tuần. Tệp đối tượng tương tự chính là việc bạn nhờ hệ thống trí tuệ nhân tạo đi tìm thêm 100.000 người khác trên toàn quốc cũng có thói quen mua sắm đồ dã ngoại cao cấp, thay vì phát tờ rơi quảng cáo mù quáng cho toàn bộ dân cư trong thành phố.
Ý nghĩa của tệp lookalike trong phễu chuyển đổi quảng cáo
Tệp lookalike đóng vai trò là cầu nối quan trọng giúp hệ thống quảng cáo tìm ra khách hàng tiềm năng mới khi tệp dữ liệu cũ đã rơi vào trạng thái bão hoà. Nó nằm ở phần đỉnh phễu (Top of Funnel) để đưa người mới vào, nhưng vì được xây từ tệp nguồn là khách thật nên thường sát nhu cầu hơn so với nhắm mục tiêu theo sở thích đoán mò. Nếu chỉ chạy lại cho tệp khách cũ, doanh nghiệp dễ loay hoay trong một ao cá nhỏ và khó tăng quy mô doanh thu dù bơm thêm tiền.
Ví dụ minh hoạ: Bối cảnh một chủ shop thời trang thiết kế quy mô 15 nhân sự cần đẩy mạnh bộ sưu tập áo khoác mùa đông. Các bước đã làm: Chủ shop xuất danh sách 1.000 khách hàng VIP có giá trị đơn hàng cao nhất trong năm ngoái, tải lên trình quản lý quảng cáo để tạo tệp tương tự tỷ lệ 1%, sau đó thiết lập chiến dịch video kể chuyện thương hiệu. Chỗ vấp và cách gỡ: Ban đầu, chi phí hiển thị khá đắt do hệ thống cần thời gian học hành vi của nhóm người mới, khiến chủ shop định tắt quảng cáo. Tuy nhiên, họ kiên nhẫn giữ nguyên cấu trúc, không sửa liên tục để máy học chạy qua giai đoạn học. Kết quả: Vài ngày sau, quảng cáo tìm đúng nhóm khách có nhu cầu mua đồ đông, tỷ lệ thêm vào giỏ hàng tăng và chi phí trên mỗi lượt mua ổn định hơn hẳn giai đoạn đầu.
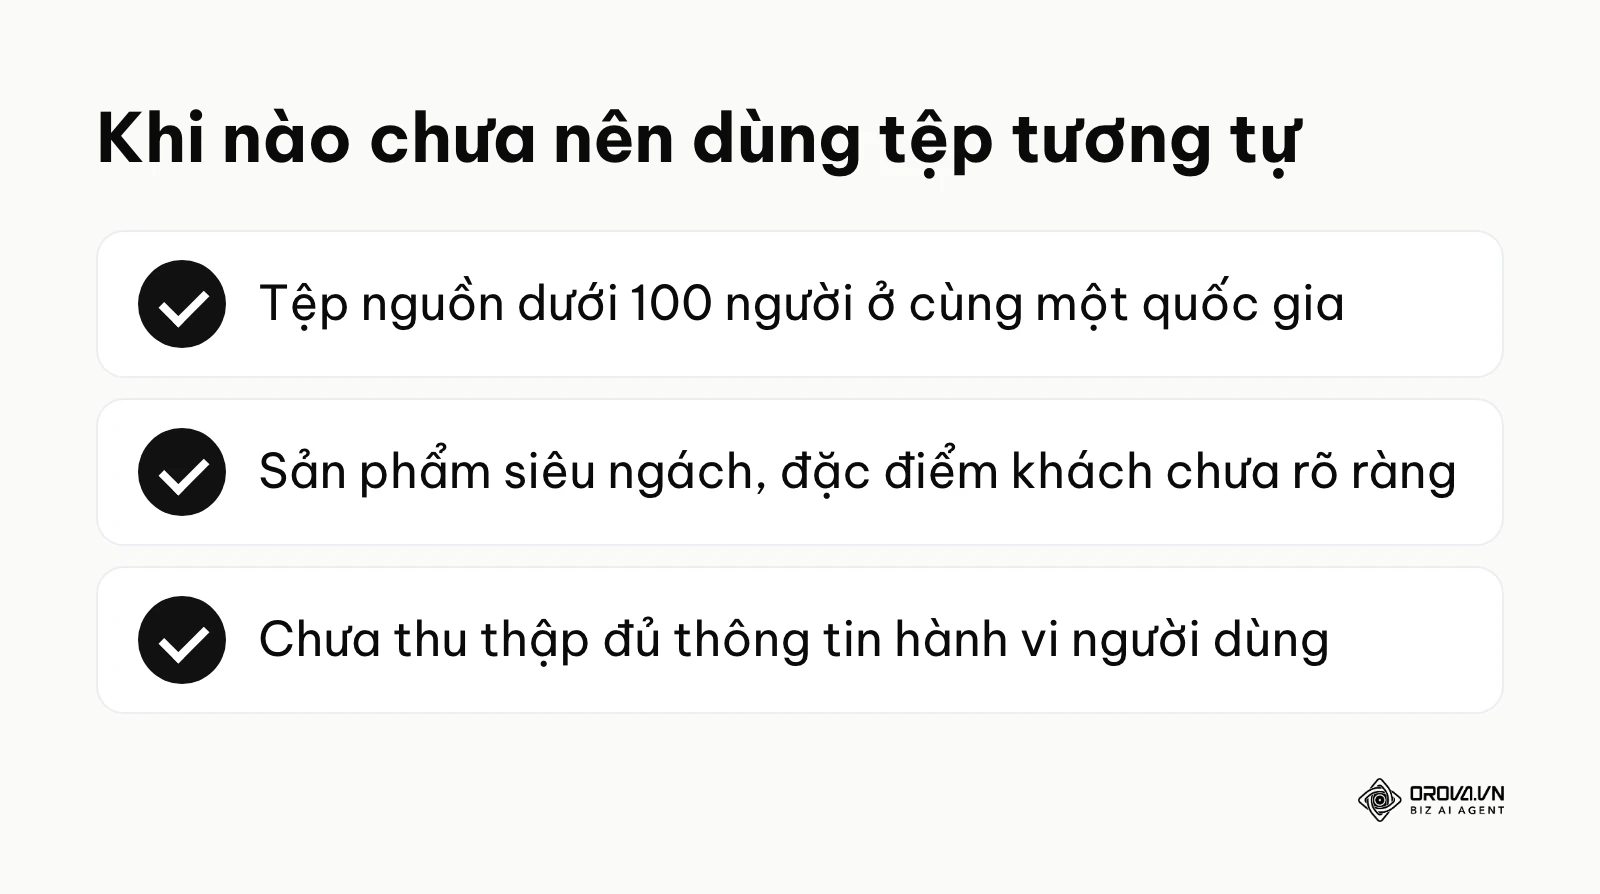
Bạn chưa nên sử dụng tệp đối tượng tương tự khi tệp nguồn còn quá nhỏ. Meta khuyến nghị tệp nguồn tối thiểu 100 người ở cùng một quốc gia; dưới mức này, hệ thống thiếu cơ sở để phân tích. Trường hợp doanh nghiệp bán sản phẩm siêu ngách, đặc điểm người dùng trên mạng xã hội thường không đủ rõ ràng để thuật toán tìm kiếm hiệu quả. Thay vì vội vã lãng phí ngân sách thử nghiệm, bạn nên tập trung chạy chiến dịch tương tác rộng để nuôi dưỡng phễu và thu thập đủ thông tin hành vi người dùng trước.
Giá trị và lợi ích thực tiễn khi tối ưu tệp lookalike
Giá trị lớn nhất của việc dùng tệp đối tượng tương tự là tìm khách mới sát nhu cầu hơn mà không phải tự đoán sở thích, nhờ đó có cơ hội kéo chi phí tiếp cận xuống và mở rộng thị trường có định hướng. Tính năng này giúp cả chủ doanh nghiệp lẫn người trực tiếp cài đặt quảng cáo tiết kiệm đáng kể thời gian ngồi phân tích hành vi mục tiêu thủ công.
Giá trị chiến lược đối với doanh nghiệp
Việc để hệ thống máy học tìm người giống khách thật giúp doanh nghiệp có thêm đường tăng trưởng khi tệp quen đã cạn. Khi tệp nguồn tốt, công ty có thể tiếp cận những nhóm khách ở tỉnh thành hay phân khúc mà trước đây chưa từng nghĩ tới, thay vì chỉ tăng ngân sách cho cùng một nhóm người. Cách làm này giúp kiểm soát chi phí chạy quảng cáo Facebook bền vững hơn thay vì chỉ giải quyết phần ngọn của vấn đề.
Lợi ích vận hành đối với người trực tiếp chạy quảng cáo
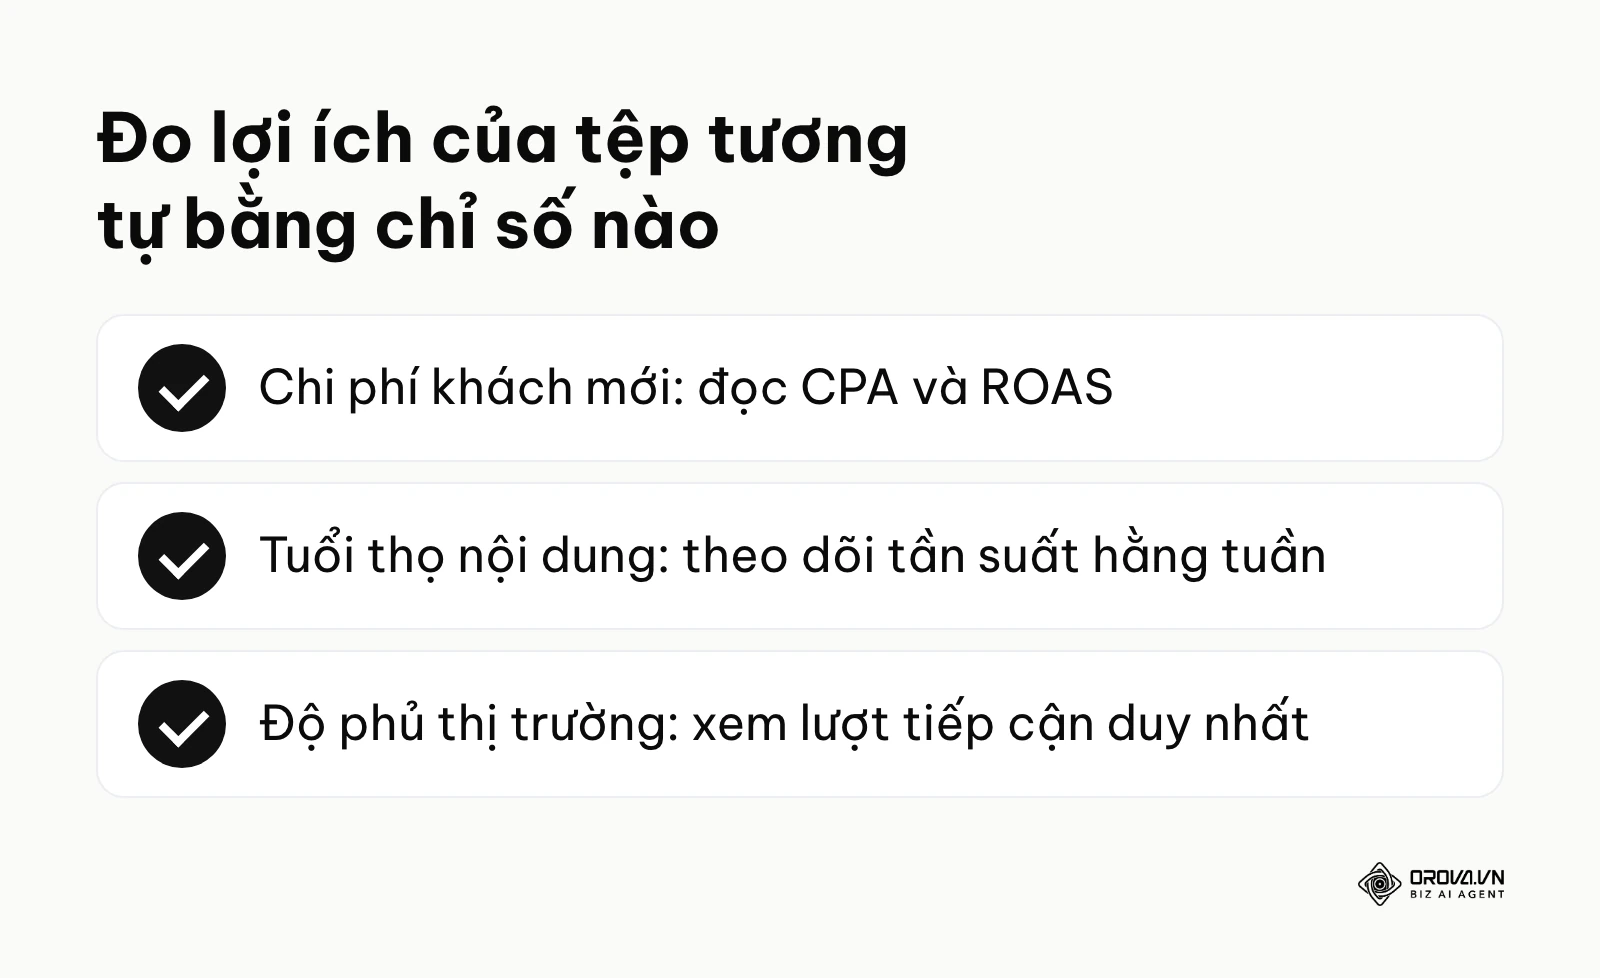
Đối với những người làm nghề, công cụ này giải phóng họ khỏi thao tác thử nghiệm hàng tá sở thích chéo nhau vốn rất mệt mỏi và dễ sai sót. Thay vì ngồi đoán xem khách hàng thích xe hơi hay thích đánh golf, họ chỉ cần chuẩn bị một tệp dữ liệu thật sạch và để thuật toán làm phần việc tính toán nặng nhọc nhất. Điều này cho phép người trực tiếp chạy quảng cáo dồn toàn lực vào việc sáng tạo nội dung, sản xuất video hoặc cải thiện kịch bản chăm sóc khách hàng. Để biết tệp tương tự có thật sự đem lại lãi hay không, đừng chỉ nhìn giá mỗi lượt nhấp mà hãy đọc chi phí trên mỗi chuyển đổi cùng cách tính ROAS cho từng nhóm quảng cáo.
| Lợi ích cụ thể | Đo lường bằng chỉ số nào | Nên đọc chỉ số khi nào |
|---|---|---|
| Giảm áp lực chi phí mua khách mới | Chi phí trên mỗi chuyển đổi (CPA), ROAS | Sau khi nhóm quảng cáo qua giai đoạn máy học |
| Kéo dài tuổi thọ của nội dung quảng cáo | Tần suất lặp lại quảng cáo (Frequency) | Theo dõi đều hằng tuần |
| Tăng cường khả năng tiếp cận thị trường | Tổng lượt tiếp cận duy nhất (Reach) | Thấy sớm nhất, ngay những ngày đầu |
Cách tạo tệp lookalike trên Meta từng bước
Thao tác tạo tệp tương tự trên Meta khá ngắn; phần tốn công là chuẩn bị tệp nguồn. Các bước cơ bản trong Trình quản lý quảng cáo:
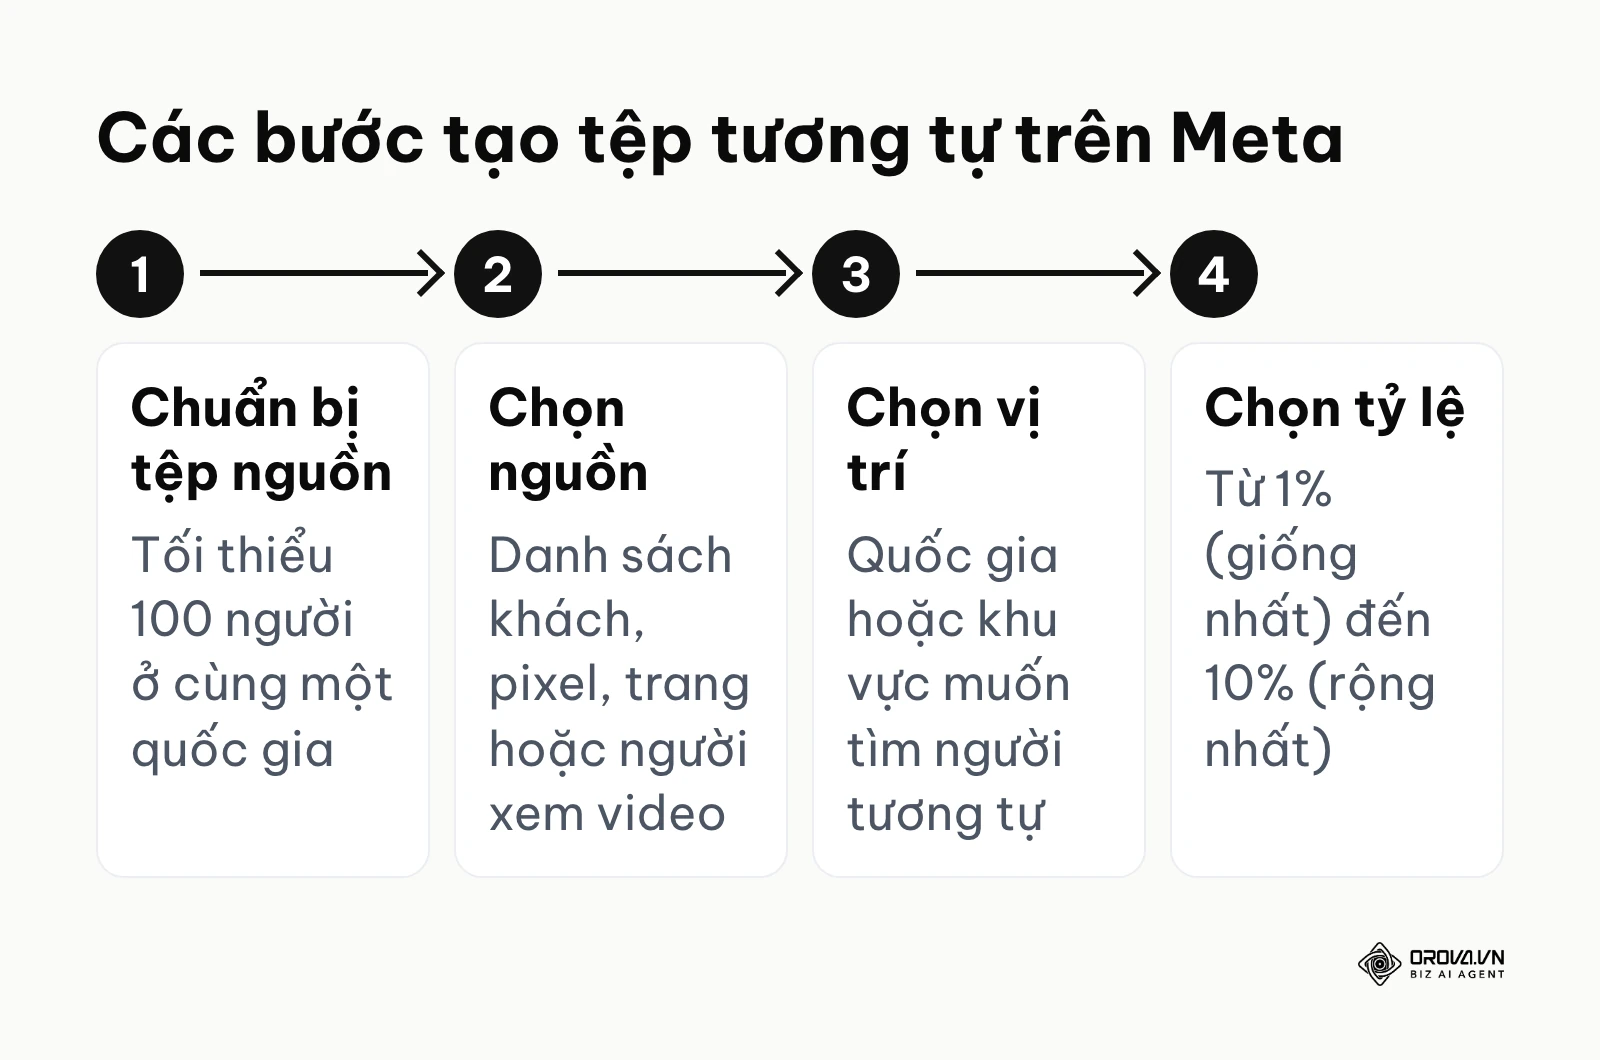
- Chuẩn bị tệp nguồn: Tạo trước một tệp tùy chỉnh làm nguồn, ví dụ danh sách khách hàng tải lên, người truy cập web ghi nhận qua pixel Facebook, người tương tác với trang hoặc người đã xem video. Tệp nguồn cần tối thiểu 100 người ở cùng một quốc gia theo khuyến nghị của Meta.
- Mở mục Đối tượng: Trong Trình quản lý quảng cáo, vào phần Đối tượng, chọn tạo đối tượng mới rồi chọn loại đối tượng tương tự.
- Chọn nguồn: Chọn tệp tùy chỉnh vừa chuẩn bị (hoặc trang, pixel) làm nguồn.
- Chọn vị trí: Chọn quốc gia hoặc khu vực mà bạn muốn tìm người tương tự.
- Chọn tỷ lệ: Kéo thanh tỷ lệ từ 1% đến 10%. Tỷ lệ 1% là nhóm giống tệp nguồn nhất, tỷ lệ cao hơn cho nhóm rộng hơn nhưng độ giống giảm dần. Bạn có thể tạo nhiều mức cùng lúc để thử.
- Tạo và chờ hệ thống dựng tệp: Sau khi bấm tạo, cần chờ một thời gian để tệp sẵn sàng; tệp sẽ được cập nhật định kỳ nếu bạn còn dùng nó trong quảng cáo.
Về quyền riêng tư: danh sách khách hàng tải lên chỉ nên gồm những người đã đồng ý cho bạn dùng thông tin liên hệ cho mục đích tiếp thị. Khi tải qua giao diện, dữ liệu được băm trước khi gửi lên; khi gửi qua API, bạn phải tự băm theo chuẩn SHA-256.
Với Google Ads, cách nhắm đối tượng "tương tự" đã thay đổi nhiều so với trước, nên bạn hãy xem các tuỳ chọn đối tượng đang có trong chính tài khoản của mình thay vì làm theo hướng dẫn cũ.
OROVA ADS ứng dụng AI Agent để tự động hóa và tối ưu hiệu suất quảng cáo trên Google, Meta và TikTok. Scale ngân sách an toàn, giám sát 24/7 và mở rộng quy mô kinh doanh nhanh chóng.
Trải nghiệm giải pháp tại orova.vn/ads
Cách hoạt động và chiến lược tối ưu tệp lookalike chuyên sâu
Hệ thống tạo tệp đối tượng tương tự bằng cách dùng dữ liệu của nền tảng để tìm ra những người có đặc điểm gần nhất với tệp nguồn (Seed Audience) của bạn. Quá trình này đòi hỏi sự kết hợp chặt chẽ giữa dữ liệu đầu vào sạch, thuật toán nhận diện và chiến lược phân bổ ngân sách. Việc nắm vững cách nền tảng chấm điểm người dùng sẽ giúp bạn chủ động định hướng lại luồng phân phối thay vì phó mặc hoàn toàn cho máy móc.
Cơ chế đối chiếu dữ liệu của máy học
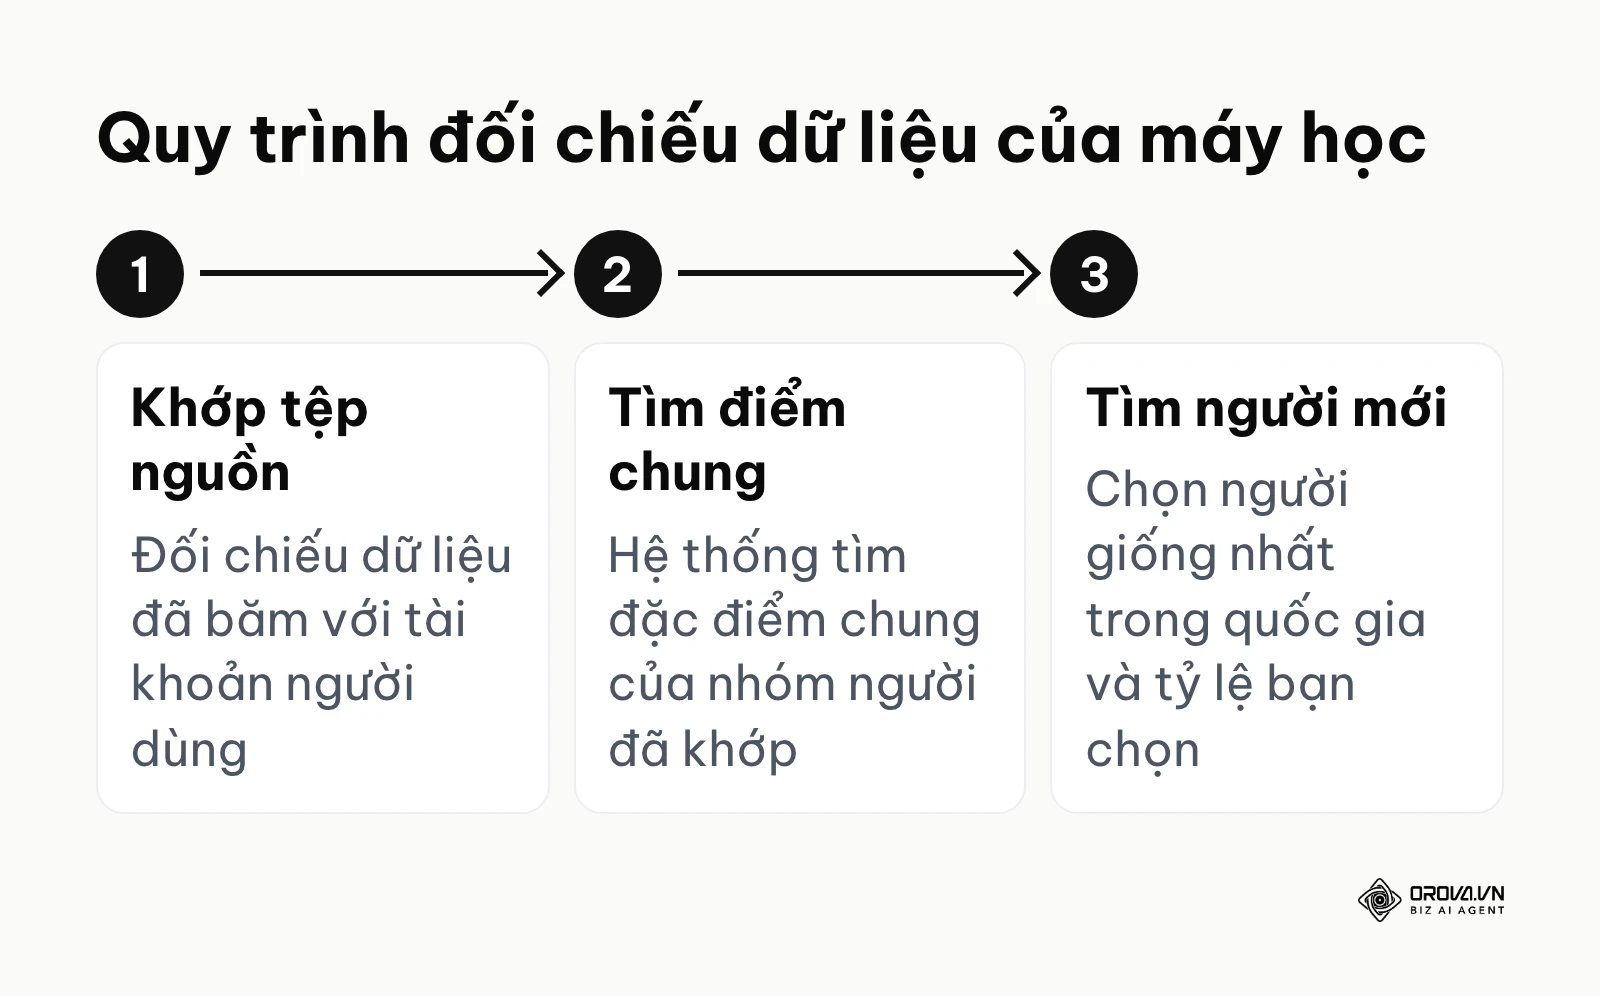
Khi bạn tải một danh sách khách hàng lên, bước đầu tiên là đối chiếu: số điện thoại, email đã băm được so với tài khoản người dùng trên nền tảng, chỉ những dòng khớp được mới thành tệp nguồn thật (tỷ lệ khớp này thường gọi là match rate). Tiếp đó, hệ thống tìm điểm chung của nhóm người đã khớp, không chỉ dừng ở một vài sở thích bề nổi. Cuối cùng, hệ thống tìm những người mới giống nhóm này nhất trong quốc gia và tỷ lệ bạn chọn. Đầu vào là tệp nguồn chuẩn xác, đầu ra là một vùng khách hàng tiềm năng rộng hơn nhiều lần. Chỗ hay hỏng nhất là khi tệp nguồn trộn lẫn quá nhiều kiểu khách, khiến máy học bị nhiễu và không đúc kết được một chân dung nhất quán.
Phân loại mức độ ưu tiên của tệp nguồn (Seed Audience) theo phễu khách hàng
Mọi tệp đối tượng tương tự đều chỉ tốt ngang bằng với chất lượng của tệp nguồn tạo ra nó, giống như việc máy sao chép không thể in ra bản màu đẹp nếu bản gốc bị mờ nhạt. Rất nhiều nhà quảng cáo mắc sai lầm khi đánh đồng mọi loại dữ liệu và kỳ vọng hệ thống tự biết ai là người có khả năng mua hàng mạnh nhất. Thực tế, bạn cần phân loại dữ liệu gốc triệt để theo từng giai đoạn trong phễu hành trình khách hàng để máy học có điểm neo chính xác.
| Phân khúc tệp nguồn (Seed Audience) | Nguồn cấp dữ liệu thường dùng | Chất lượng & Ý định mua (Intent) | Mức độ ưu tiên phân bổ ngân sách |
|---|---|---|---|
| Đáy phễu (Khách đã chi tiêu nhiều tiền) | Danh sách CRM, Máy chủ nội bộ | Cao nhất, chân dung rõ nét nhất | Ưu tiên số 1 (phần lớn ngân sách thử nghiệm) |
| Giữa phễu (Thêm vào giỏ, Nhắn tin) | Pixel trang web, Nút tin nhắn | Khá cao, đang cân nhắc sản phẩm | Ưu tiên số 2 (phần ngân sách còn lại) |
| Đỉnh phễu (Người xem video, tương tác trang) | Tương tác bài đăng, Lượt xem | Thấp, dễ bị pha loãng thông tin | Ưu tiên cuối (chỉ dùng mở rộng phễu) |
Bù đắp dữ liệu bằng Conversions API (CAPI)
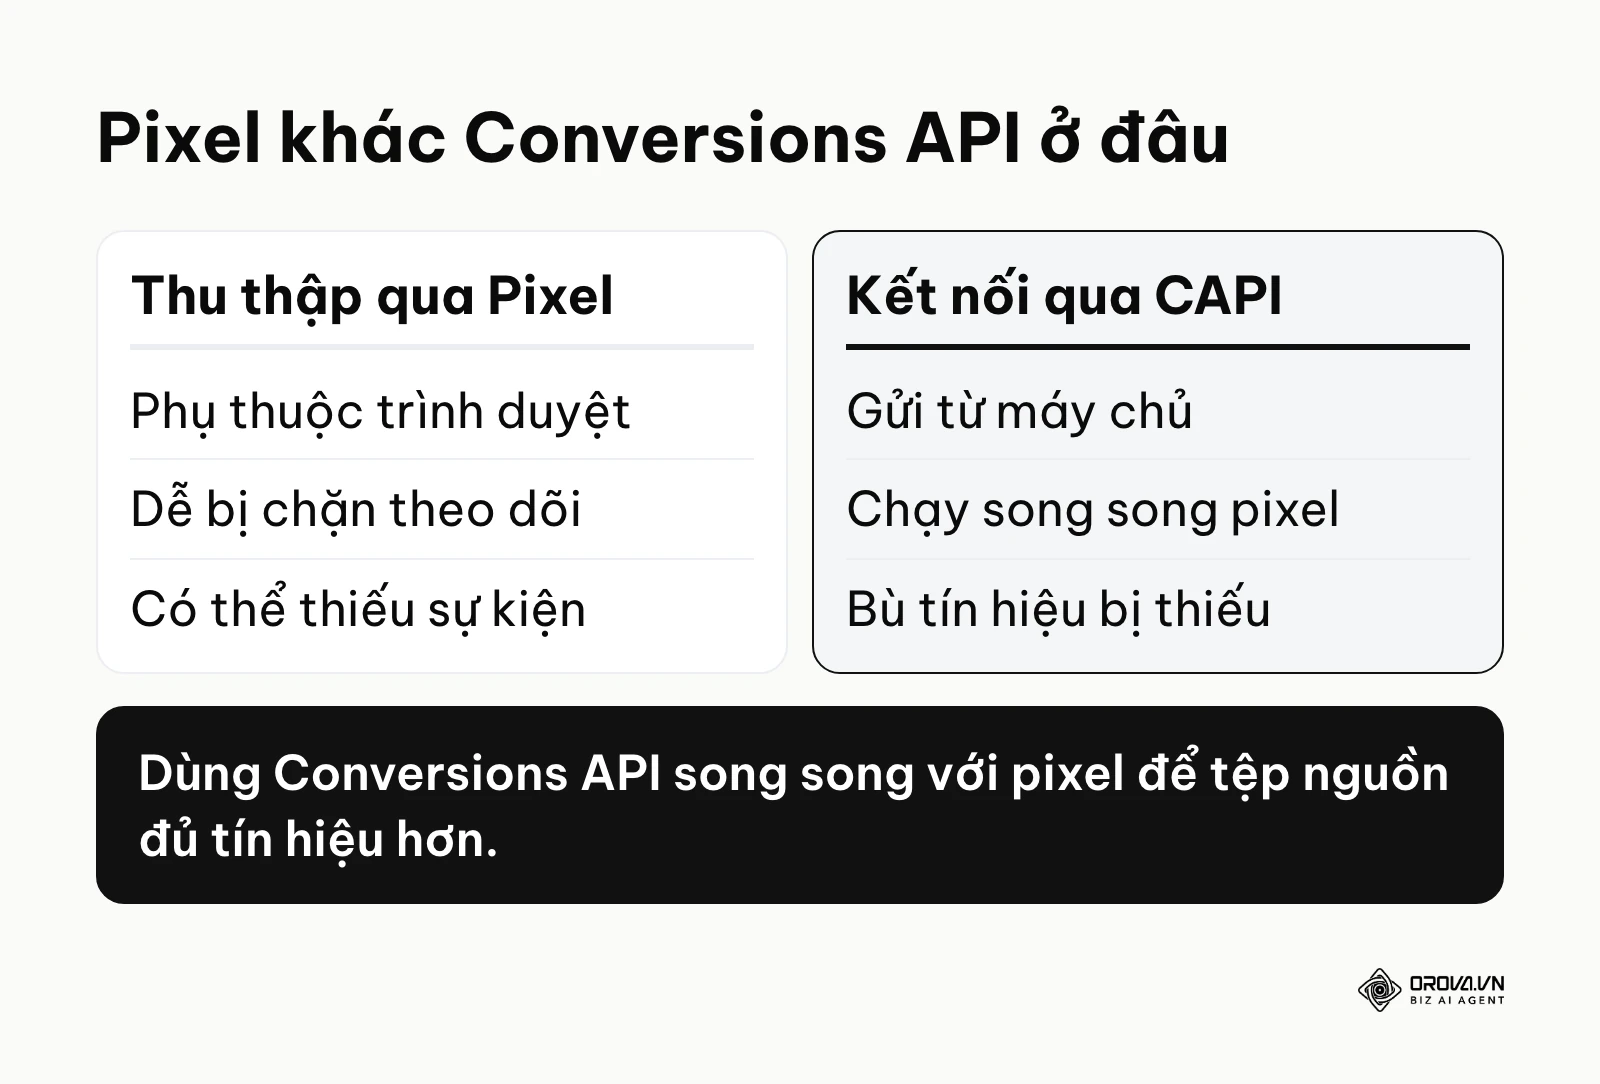
Khi trình duyệt và hệ điều hành ngày càng siết quyền riêng tư (chặn theo dõi, hỏi quyền theo dõi trong ứng dụng), mã theo dõi trên web không còn ghi nhận đủ mọi sự kiện. Hệ thống mất bớt tín hiệu mua hàng thật, làm tệp nguồn dựng từ pixel kém chính xác. Một cách bổ sung phổ biến là Conversions API: gửi thông tin đơn hàng thành công từ máy chủ của bạn lên nền tảng, chạy song song với pixel thay vì phụ thuộc hoàn toàn vào trình duyệt. Dưới đây là 5 bước chuẩn hoá danh sách người dùng trước khi đẩy dữ liệu lên:
- Loại bỏ dữ liệu rác và trùng lặp: Bạn cần dọn sạch các hàng dữ liệu trống, email có dấu hiệu ảo hoặc số điện thoại định dạng sai để mỗi dòng đều đại diện cho một người dùng thật. Việc này giúp máy học không lãng phí tài nguyên vào các điểm nhiễu vô giá trị.
- Định dạng lại số điện thoại theo chuẩn quốc tế: Yêu cầu bắt buộc là toàn bộ số điện thoại phải mang mã quốc gia, ví dụ chuyển đầu số 0 thành +84 cho thị trường nội địa. Hệ thống quốc tế không thể phân tích đúng luồng định vị nếu thiếu đi mã số cốt lõi này.
- Chuẩn hoá định dạng chuỗi văn bản: Cắt bỏ mọi khoảng trắng thừa ở đầu và cuối chuỗi, đồng thời chuyển toàn bộ ký tự email về định dạng chữ thường. Hệ thống thường rất nhạy cảm với các lỗi khoảng trắng vô hình, dẫn đến việc báo lỗi danh sách hàng loạt.
- Bổ sung các trường thông tin phụ trợ: Cung cấp thêm thành phố cư trú, mã bưu chính để tăng tỷ lệ khớp; nếu muốn tạo tệp tương tự dựa trên giá trị, thêm cột giá trị khách hàng để hệ thống ưu tiên tìm người giống nhóm chi tiêu cao.
- Băm dữ liệu và chỉ dùng dữ liệu được phép: Chỉ tải lên thông tin của khách đã đồng ý cho bạn dùng vào mục đích tiếp thị. Khi gửi qua API, thông tin cá nhân phải được băm (hash) theo chuẩn SHA-256 trước khi truyền; tải qua giao diện thì hệ thống băm giúp bạn. Điều này vừa tuân thủ quy định của nền tảng, vừa giảm nguy cơ rò rỉ dữ liệu khách hàng.
Ví dụ minh hoạ: Bối cảnh một agency đang chạy dự án thực phẩm chức năng cho một nhãn hàng dược phẩm. Các bước đã làm: Họ dùng sự kiện truy cập trang web thu qua mã theo dõi trong 90 ngày làm tệp nguồn, hy vọng tìm được khách có thói quen đọc bài viết sức khoẻ. Chỗ vấp và cách gỡ: Do trình duyệt siết bảo mật, dữ liệu hao hụt đáng kể, hệ thống trả về một tệp tương tự lệch, lượt nhấp nhiều nhưng ít người để lại số điện thoại. Agency chuyển sang gửi thẳng dữ liệu đơn chốt thành công (từ khách đã đồng ý) lên nền tảng qua máy chủ, bù lại phần lớn tín hiệu bị thiếu. Kết quả: Tệp nguồn ít người hơn nhưng sắc nét hơn, giúp hệ thống tìm trúng nhóm khách có khả năng chi trả, kéo chi phí mỗi khách hàng về gần mức mục tiêu.
Chiến lược mở rộng (Scale) tệp từ 1% lên 10%
Khi bạn cấu hình chiến dịch với tệp quy mô 1%, bạn đang giới hạn vùng phân phối vào top những người có hành vi giống hệt khách hàng cốt lõi nhất tính trên toàn bộ lãnh thổ. Tuy nhiên, đặc điểm của nhóm cực hẹp này là sẽ rất nhanh chóng bị bào mòn hết số lần hiển thị, dẫn đến tình trạng chi phí đấu giá tăng vọt do hiện tượng tự cạnh tranh nội bộ. Lúc này, bạn buộc phải nâng mức độ mở rộng lên 3%, 5% hoặc thậm chí 10% để hệ thống có thêm không gian tìm kiếm lượng khách hàng rẻ hơn.
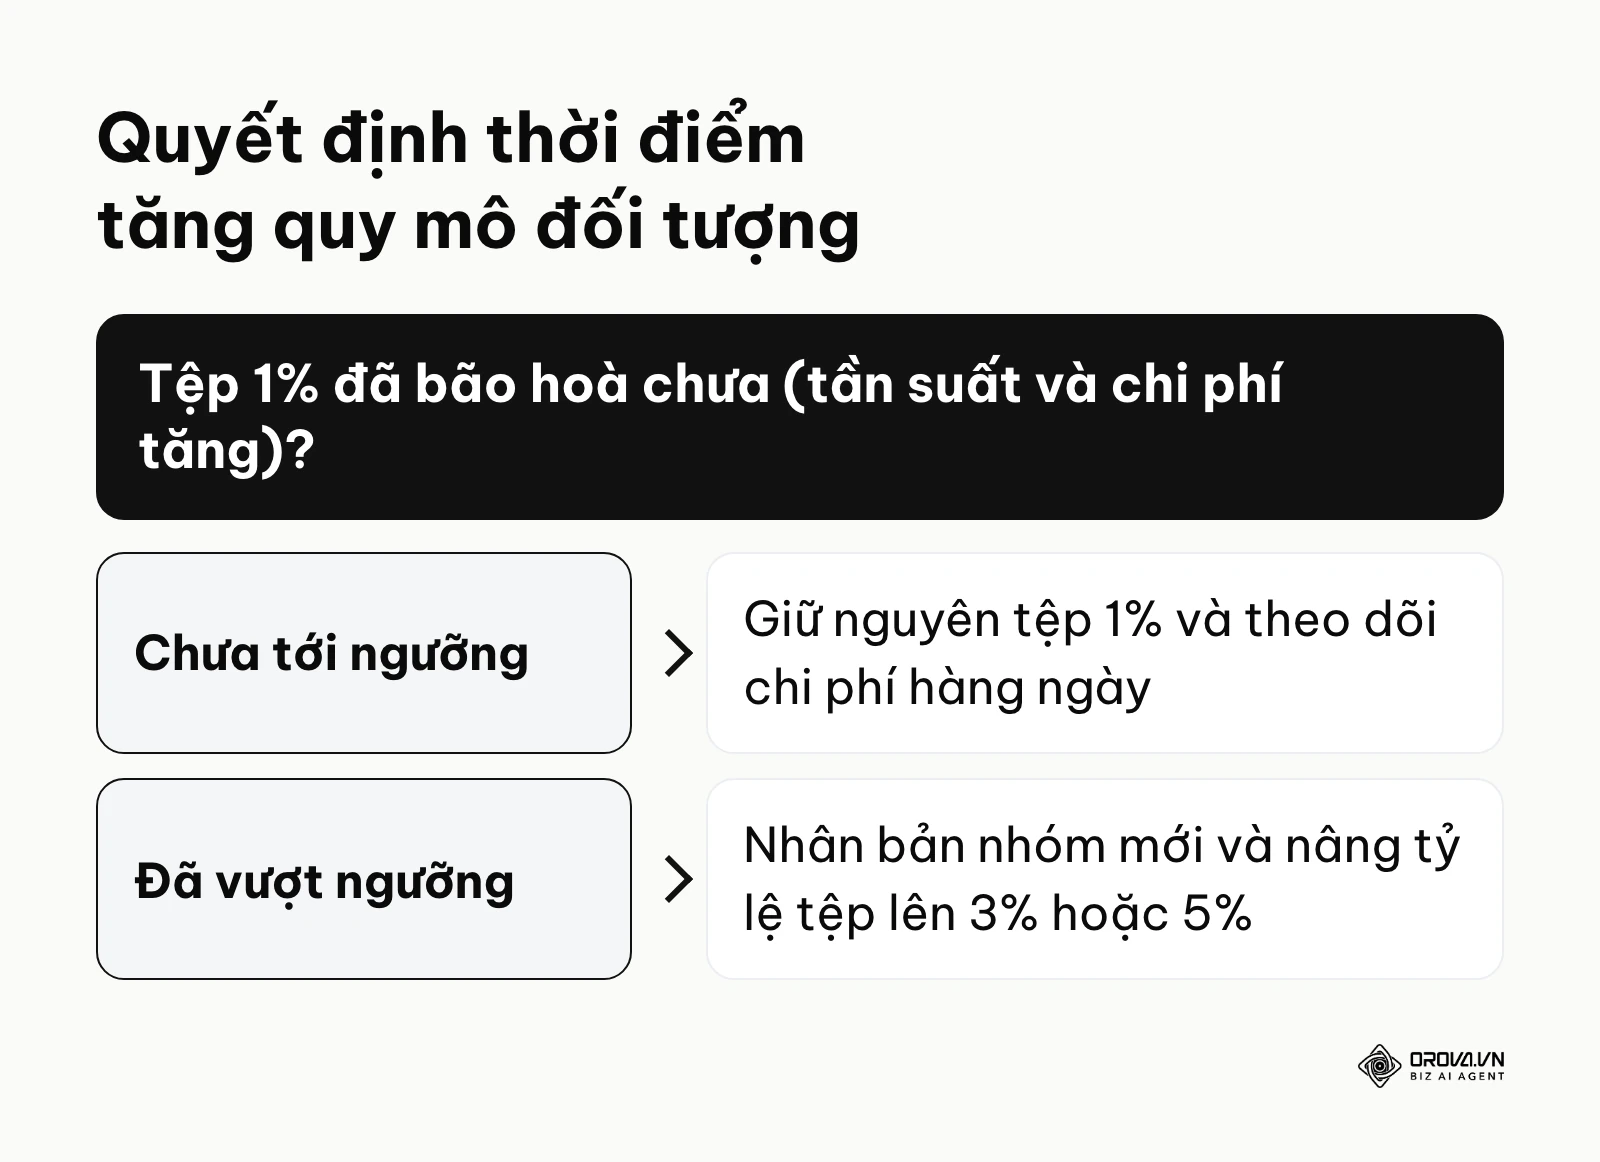
Nguyên tắc sống còn khi mở rộng dung lượng là phải thay đổi linh hoạt thông điệp và cách thiết lập ngân sách. Một người nằm trong nhóm 1% có thể sẵn sàng quẹt thẻ chỉ vì một tính năng kỹ thuật chuyên sâu, nhưng người nằm ở rìa 5% lại cần một câu chuyện thương hiệu bao quát hơn mới bị thuyết phục. Việc tách biệt các tệp phần trăm này ra thành từng nhóm phân phối độc lập, đồng thời loại trừ chéo lẫn nhau, giúp bạn kiểm soát dòng tiền tốt hơn và bảo vệ hiệu suất chiến dịch đang thắng.
Ví dụ minh hoạ: Bối cảnh một người quản lý ngân sách quảng cáo lớn hằng tháng cho ngành hàng thiết bị gia dụng nhà bếp. Các bước đã làm: Khi thấy nhóm nhắm tệp đối tượng 1% đang chốt đơn cực rẻ, người này lập tức nhân bản nhóm đó và chỉnh thẳng thông số lên 5% với mong muốn bùng nổ doanh số cuối tuần. Chỗ vấp và cách gỡ: Chỉ sau hai ngày, chi phí mua hàng tăng vọt do video quảng cáo cũ chỉ tập trung vào một công năng siêu ngách, hoàn toàn không đủ sức thuyết phục vùng thị trường rộng lớn. Rút kinh nghiệm, họ tạm dừng nhóm 5%, quay một video mới đánh mạnh vào nhu cầu tiết kiệm thời gian nấu nướng của mọi bà nội trợ, rồi chạy lại với mức ngân sách thăm dò ban đầu. Kết quả: Chiến dịch lấy lại phong độ phân phối ổn định, còn mang về thêm đơn hàng từ khách ở các tỉnh xa mà nhóm 1% chưa với tới.
Kết hợp tệp lookalike với Advantage+ audience của Meta
Khi Meta đẩy mạnh các tuỳ chọn nhắm mục tiêu tự động, nhiều nhà quảng cáo cho rằng tệp tương tự không còn tác dụng. Thực tế, với Advantage+ audience, bạn vẫn có thể thêm tệp lookalike làm gợi ý đối tượng. Hệ thống dùng gợi ý này làm điểm xuất phát để tìm trước, nhưng có thể mở rộng ra ngoài tệp khi thấy có người phù hợp hơn. Nghĩa là tệp lookalike lúc này không còn là bức rào cứng giới hạn người xem, mà là tín hiệu định hướng cho máy học. Gợi ý càng sạch (tệp nguồn là người mua thật), giai đoạn dò đường càng ngắn và đỡ tốn tiền thử nghiệm.
Scale ngân sách nhưng sợ gãy hiệu suất? 📉
Tích hợp ngay OROVA ADS - AI Agent tự động giám sát và tối ưu quảng cáo Google, Meta, TikTok 24/7. Giờ đây, việc mở rộng và nhân bản đội ngũ Performance Ads chỉ cách bạn một cú click.
🚀 Trải nghiệm ngay tại: orova.vn/ads
Cần làm gì để bắt đầu và thích nghi với tệp lookalike AI
Để bắt đầu áp dụng thành công tệp đối tượng tương tự, mỗi cá nhân trong tổ chức cần chuyển đổi tư duy từ việc thao tác nhắm mục tiêu thủ công sang việc vun đắp dữ liệu chất lượng cao cho máy học. Tùy thuộc vào vị trí quản trị hay vận hành, bạn sẽ có những lộ trình chuẩn bị hệ thống hoàn toàn khác biệt nhằm tối ưu hóa chi phí đường dài.
Đối với chủ doanh nghiệp nhỏ và hộ kinh doanh
Việc đầu tiên bạn cần làm trong tuần này là gom tất cả danh sách khách hàng từ các cuốn sổ tay, file định dạng bảng tính rải rác về một đầu mối lưu trữ tập trung. Sau đó, hãy chủ động phân tách danh sách khách hàng đã thanh toán thành công ra khỏi nhóm khách chỉ hỏi giá nhưng chưa chốt đơn. Hãy nhớ rằng, dữ liệu càng cô đọng và rõ ràng thì thuật toán sẽ càng làm việc với độ chính xác cao. Cuối cùng, hãy trích một phần nhỏ ngân sách chạy thử nghiệm tính năng này để làm quen với cách máy học phản ứng, thay vì dồn toàn lực ngay từ đầu.
Đối với người trực tiếp chạy quảng cáo nội bộ
Bạn cần khẩn trương kiểm tra lại toàn bộ mã theo dõi gắn trên trang đích hoặc hệ thống ứng dụng để đảm bảo sự kiện mua hàng đang được ghi nhận chuẩn xác. Hãy thiết lập các luồng thu thập dữ liệu tùy chỉnh, ví dụ tách riêng nhóm người dùng lướt web trên một phút và nhóm thoát trang ngay lập tức. Sau đó, lên lịch cập nhật tệp nguồn định kỳ mỗi tháng để đảm bảo hệ thống luôn được nạp nguồn nguyên liệu mới mẻ nhất. Đây là cách bền vững nhất để ngăn chặn tình trạng thuật toán chạy vòng quanh một tệp dữ liệu đã đóng rêu.
Đối với agency hoặc freelancer quản lý nhiều dự án
Agency cần đặc biệt chú ý đến cấu trúc phân quyền của tài khoản quảng cáo Facebook để tránh việc dữ liệu gốc bị rò rỉ chéo giữa các thương hiệu cạnh tranh nhau. Hãy xây dựng một quy trình chuẩn hóa định dạng số điện thoại tự động trước khi tải lên hệ thống để tiết kiệm thời gian cho đội ngũ vận hành. Bên cạnh đó, luôn giáo dục khách hàng hiểu rằng giai đoạn máy học đầu tiên sẽ có chi phí hiển thị cao hơn bình thường, yêu cầu sự kiên nhẫn thay vì hoảng loạn tắt chiến dịch sớm.
Bảng dưới gom các sai lầm hay gặp riêng với tệp tương tự; các lỗi chung khác khi chạy quảng cáo bạn có thể xem thêm ở bài các lưu ý khi chạy quảng cáo Facebook.
| Sai lầm hay gặp khi triển khai | Hậu quả nhãn tiền | Cách phòng tránh hiệu quả |
|---|---|---|
| Dùng chung mọi loại khách hàng làm tệp gốc | Máy học bị nhiễu, phân phối quảng cáo sai người | Chia nhỏ tệp theo hành vi: đã mua, đã thêm vào giỏ |
| Không làm mới dữ liệu tệp nguồn suốt nửa năm | Quảng cáo lặp lại liên tục, chi phí chốt đơn tăng vọt | Tạo thói quen cập nhật tệp tự động mỗi tháng |
| Đấu giá chung nhiều tệp % trong cùng một nhóm | Các tệp tự triệt tiêu lẫn nhau, lãng phí ngân sách | Loại trừ đối tượng vòng lặp khi mở rộng quy mô |
Câu hỏi hay gặp về tệp lookalike và thuật toán phân phối
Dưới đây là những câu hỏi phổ biến nhất về cách vận hành của thuật toán tìm kiếm đối tượng tương tự trên các nền tảng quảng cáo hiện đại. Việc thấu hiểu cơ chế nền tảng sẽ giúp bạn tránh được tình trạng rò rỉ ngân sách không đáng có.
Tệp lookalike có còn cần khi đã có AI tự động tìm khách không?
Vẫn có ích, nhưng vai trò đã đổi. Các tuỳ chọn nhắm mục tiêu tự động có thể tự tìm khách, song thường mất thời gian dò đường nếu không có dữ liệu dẫn đường ban đầu. Thêm tệp đối tượng tương tự làm gợi ý giống như một điểm mồi, giúp hệ thống bắt đầu từ vùng gần khách thật nhất; hệ thống vẫn có thể mở rộng ra ngoài tệp khi thấy hiệu quả hơn.
Lookalike audience là gì và kích thước tệp nguồn bao nhiêu là lý tưởng?
Lookalike audience là tên tiếng Anh của tệp đối tượng tương tự: nhóm người mới giống với tệp nguồn của bạn, trong quốc gia và tỷ lệ 1–10% bạn chọn. Meta khuyến nghị tệp nguồn tối thiểu 100 người ở cùng một quốc gia. Đó chỉ là mức sàn; trên thực tế, tệp nguồn lớn hơn và đồng nhất hơn (ví dụ toàn là người đã mua) thường cho kết quả ổn định hơn một tệp vừa đủ số tối thiểu. Giữa một tệp to nhưng lẫn lộn và một tệp nhỏ hơn nhưng toàn khách thật, nên ưu tiên tệp thứ hai.
Có nên gộp chung tệp 1%, 2%, 3% vào cùng nhóm quảng cáo?
Thường không nên gộp chung các mức phần trăm này vào một nhóm quảng cáo khi bạn muốn đo riêng hiệu quả từng mức. Khi gộp chung, tệp nhỏ thường bị tệp lớn nuốt chửng về mặt ngân sách, khiến bạn mất khả năng đánh giá hiệu quả của nhóm sát khách nhất. Thực hành chuẩn là tách rời chúng thành từng nhóm độc lập và sử dụng tính năng loại trừ đối tượng để tránh việc tự đẩy giá thầu lên cao.
Cách xử lý khi quảng cáo tệp lookalike bị lặp tần suất (Frequency cao)?
Tần suất hiển thị lặp lại phản ánh việc thuật toán đã khai thác cạn kiệt phần cốt lõi ngon nhất của tệp đối tượng và bắt đầu xoay vòng. Lúc này, giải pháp tốt nhất là mở rộng quy mô tệp lên các ngưỡng phần trăm cao hơn để bơm thêm nguồn đối tượng mới vào hệ thống. Đồng thời, bạn phải làm mới video hoặc hình ảnh truyền thông để kích thích lại sự chú ý của những người đã trót lướt qua nội dung cũ.
Cách tạo lookalike facebook cho người mới có khó không?
Thao tác tạo trên giao diện chỉ mất vài phút và khá dễ với người mới (xem các bước ở phần cách tạo bên trên). Khó khăn thực sự nằm ở việc bạn có trong tay một tập hợp dữ liệu khách hàng sạch sẽ, được phép sử dụng và có độ tin cậy cao hay không. Nếu chuẩn bị khâu dữ liệu kỹ lưỡng, phần việc thao tác trên hệ thống chỉ là bước hoàn thiện cuối cùng rất nhẹ nhàng.
Nên bắt đầu từ đâu để xây dựng tệp lookalike chất lượng?
Việc bắt đầu xây dựng dữ liệu đối tượng tương tự phụ thuộc hoàn toàn vào hiện trạng thu thập thông tin khách hàng của doanh nghiệp bạn. Bất kể bạn đang ở giai đoạn quản trị nào, bước đi đầu tiên bao giờ cũng là gia cố lại sự vững chắc của danh sách khách hàng gốc.
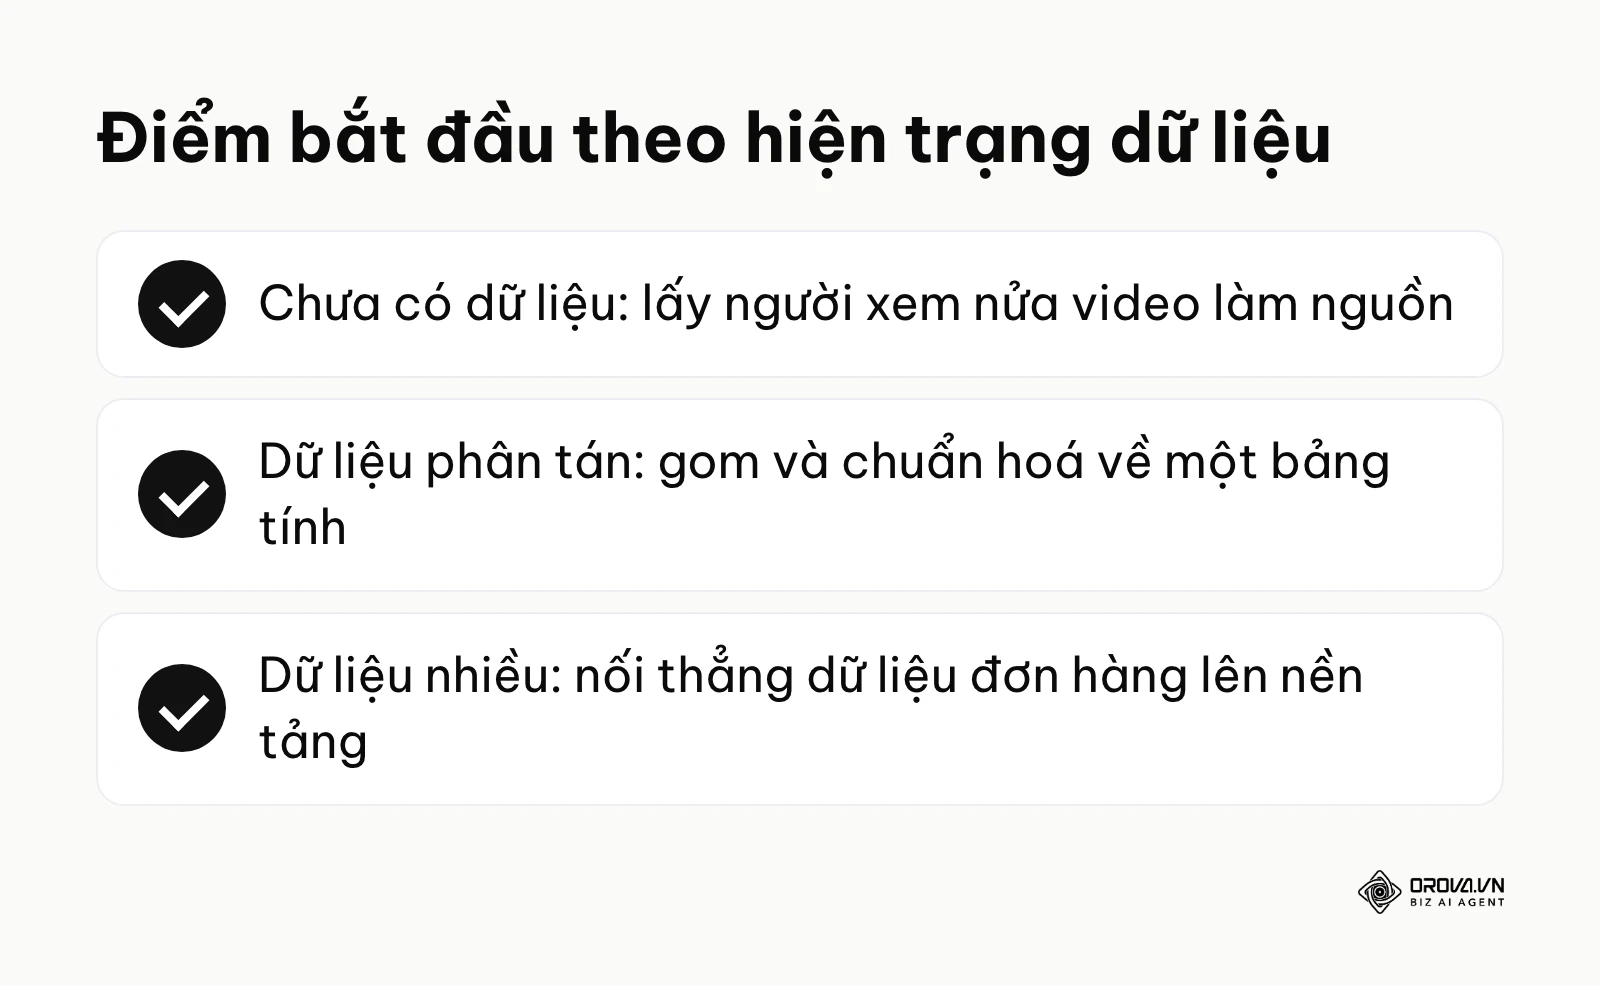
Đối với tình trạng chưa có bất kỳ dữ liệu số nào trong tay, bạn đừng vội nghĩ đến việc tạo danh sách số điện thoại phức tạp. Hãy khởi động bằng cách chạy một chiến dịch truyền thông video siêu ngắn, sau đó gom nhóm tất cả những người đã xem qua nửa thời lượng video đó làm tệp gốc để máy học làm quen.
Đối với tình trạng đã có dữ liệu nhưng phân tán ở nhiều sổ sách, việc cấp thiết nhất là chuẩn hóa lại toàn bộ thông tin theo một định dạng thống nhất duy nhất. Hãy tập trung lọc bỏ các số điện thoại ảo và định dạng lại cột email bằng một file bảng tính trung tâm trước khi đẩy bất cứ thứ gì lên hệ thống quảng cáo.
Đối với tình trạng đã tích lũy số lượng lớn thông tin mà không đo lường được hiệu quả, bạn cần nhanh chóng thiết lập hệ thống kết nối thẳng dữ liệu bán hàng nội bộ. Việc ánh xạ thông tin đơn hàng thật vào hệ thống quảng cáo sẽ là cú huých lớn giúp tệp lookalike tìm đúng người thực sự sẵn sàng mở hầu bao.
Về tác giả
Người xây dựng Orova
Nguyễn Đỗ Trọng Ân có 8 năm làm marketing, trong đó 6 năm quản lý khai thác thị trường châu Á. Anh là người xây dựng Orova, Biz AI Agent hoạt động không ngủ: tự lên kế hoạch, chạy và tối ưu công việc cho doanh nghiệp.
Vận hành doanh nghiệp với AI Agent
Orova là Biz AI Agent hoạt động không ngủ — tự lên kế hoạch, chạy và tối ưu công việc.
Tiết kiệm thời gian, bứt phá hiệu suất.