सर्च इंजन क्या है? यह कैसे काम करता है, प्रकार और उदाहरण
सर्च इंजन क्या है? आसान शब्दों में, सर्च इंजन एक ऐसा सॉफ़्टवेयर सिस्टम है जो वेब पर मौजूद पेजों को अपने-आप ढूंढता है (क्रॉलिंग), उन्हें समझकर एक बड़े डेटाबेस में सहेजता है (इंडेक्सिंग) और जब आप कुछ खोजते हैं, तो उसी डेटाबेस से आपकी क्वेरी के हिसाब से सबसे काम के नतीजे दिखाता है। Google, Microsoft Bing और DuckDuckGo इसके जाने-माने उदाहरण हैं। बहुत से लोग सर्च इंजन को वेबसाइटों की साधारण निर्देशिका (डायरेक्टरी) या वेब ब्राउज़र जैसा ही मान लेते हैं, जबकि इनका काम बिल्कुल अलग है। इस गाइड में हम Google Search Central के आधिकारिक दस्तावेज़ के आधार पर समझेंगे कि सर्च इंजन अंदर से कैसे काम करता है, इसके कौन-कौन से प्रकार हैं, और अपनी वेबसाइट को खोज के नतीजों में लाने के लिए कौन-से व्यावहारिक कदम उठाने चाहिए।
परिभाषा: सर्च इंजन असल में क्या करता है
सर्च इंजन का मुख्य काम वेब पर मौजूद अरबों पेजों में से उपयोगकर्ता के सवाल के लिए सबसे प्रासंगिक और उपयोगी पेज ढूंढकर दिखाना है। यह वेब ब्राउज़र से अलग है: ब्राउज़र केवल किसी वेबसाइट को खोलकर स्क्रीन पर दिखाता है, जबकि सर्च इंजन पहले से वेब के पेजों को खोजकर, समझकर और व्यवस्थित करके रखता है, ताकि आपकी खोज पर तुरंत नतीजे दे सके।
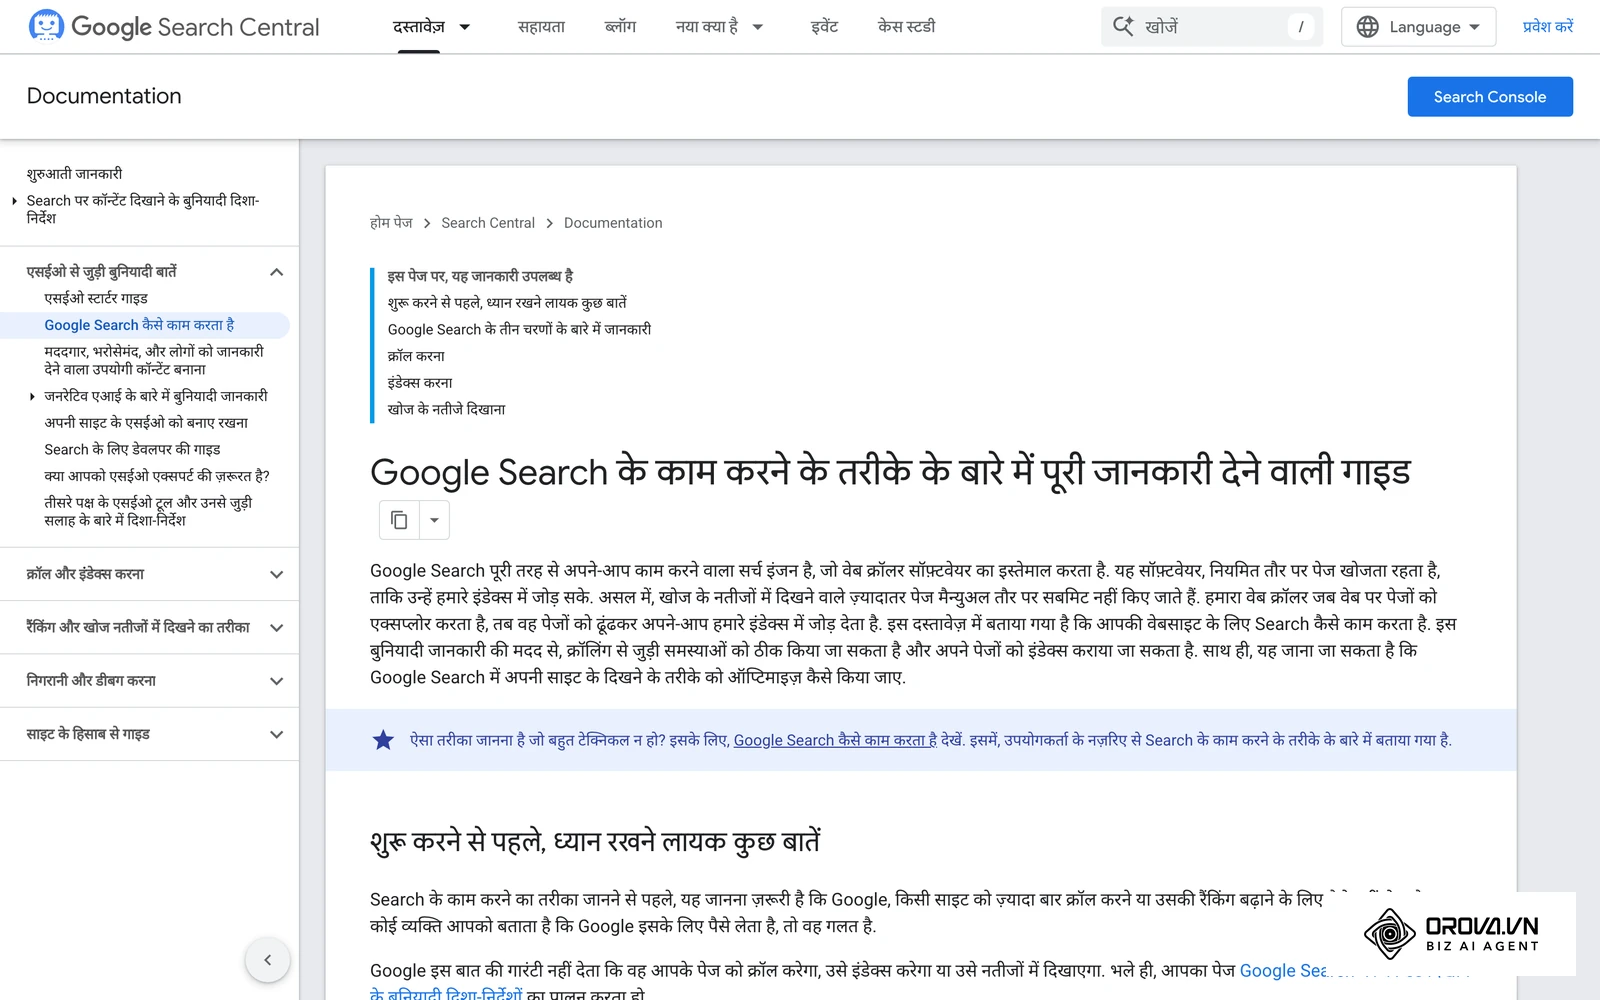
Google Search Central की गाइड के अनुसार, Google Search पूरी तरह अपने-आप काम करने वाला सर्च इंजन है, जो वेब क्रॉलर सॉफ़्टवेयर से नियमित तौर पर पेज खोजता है और उन्हें अपने इंडेक्स में जोड़ता है। खोज के नतीजों में दिखने वाले ज़्यादातर पेज मैन्युअल रूप से सबमिट नहीं किए जाते, बल्कि क्रॉलर उन्हें वेब पर घूमते हुए खुद ढूंढ लेता है।
ऐतिहासिक दृष्टि से, "सर्च इंजन" शब्द अंग्रेज़ी के Search (खोजना) और Engine (यंत्र या प्रणाली) से बना है। वर्ष 1990 में मॉन्ट्रियल के मैकगिल विश्वविद्यालय में एलन एम्टेज (Alan Emtage) द्वारा बनाए गए आर्ची (Archie) को इंटरनेट का पहला सर्च टूल माना जाता है, जो FTP सर्वरों पर मौजूद फ़ाइलों के नामों की सूची बनाकर उन्हें खोजता था। तब से यह तकनीक साधारण शब्द-मिलान से आगे बढ़कर अर्थ और संदर्भ समझने वाले सिस्टम तक पहुंच चुकी है।
सर्च इंजन को अक्सर वेब ब्राउज़र या वेब डायरेक्टरी समझ लिया जाता है। नीचे दी गई तालिका इन तीनों का अंतर स्पष्ट करती है:
| अवधारणा | यह क्या करता है | उदाहरण |
|---|---|---|
| सर्च इंजन (Search Engine) | स्वचालित क्रॉलर से पेज ढूंढता है, उन्हें इंडेक्स करता है और क्वेरी के हिसाब से नतीजे दिखाता है | Google, Microsoft Bing, DuckDuckGo |
| वेब ब्राउज़र (Web Browser) | सर्वर से कोड (HTML, CSS, JavaScript) लाकर वेबसाइट को स्क्रीन पर दिखाता है | Google Chrome, Apple Safari, Mozilla Firefox |
| वेब डायरेक्टरी (Web Directory) | मानव संपादकों द्वारा श्रेणियों में हाथ से व्यवस्थित की गई वेबसाइटों की सूची | Yahoo Directory, DMOZ (दोनों अब बंद हो चुकी हैं) |
रोज़मर्रा के उदाहरण से समझें तो वेब ब्राउज़र एक गाड़ी की तरह है जो आपको किसी पते तक ले जाती है, जबकि सर्च इंजन एक अनुभवी लाइब्रेरियन की तरह है जिसने पहले से पूरी लाइब्रेरी की किताबों का कैटलॉग बना रखा है और आपकी ज़रूरत सुनते ही सही किताब और सही पन्ना बता देता है।
इंटरनेट पर सर्च इंजन की भूमिका
सर्च इंजन इंटरनेट पर सूचना की भरमार (Information Overload) की समस्या को हल करता है। अगर सर्च इंजन न हों, तो किसी वेबसाइट तक पहुंचने का लगभग एकमात्र तरीका उसका सटीक पता (URL) याद रखना होगा, जो आज के समय में व्यावहारिक नहीं है।
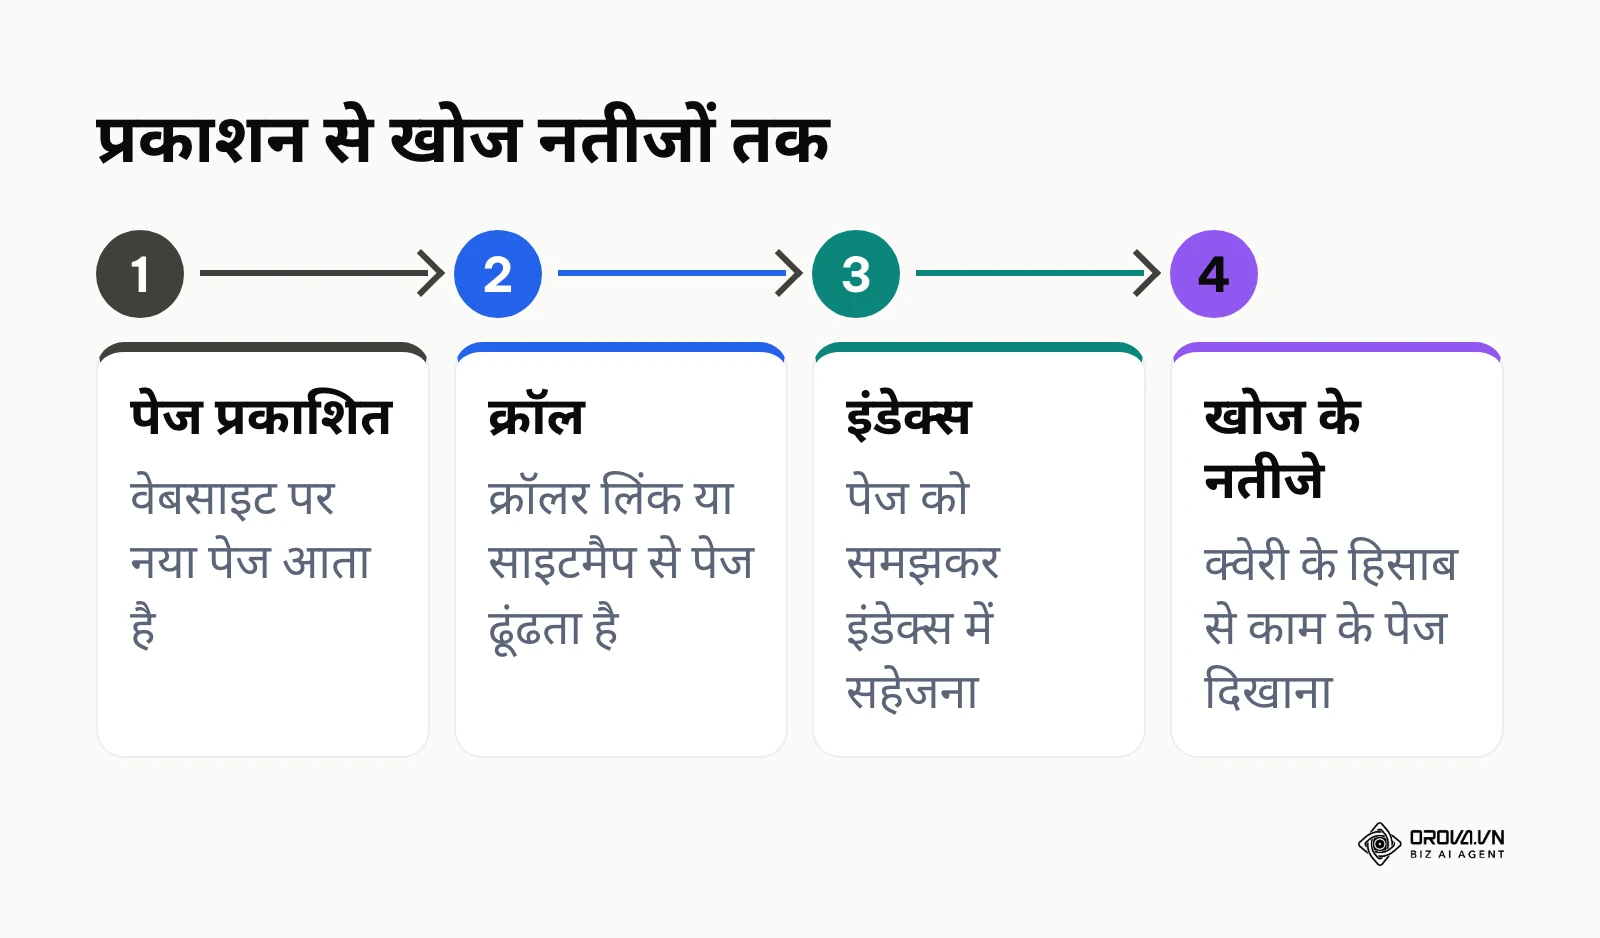
डिजिटल दुनिया में सर्च इंजन प्रकाशक और पाठक के बीच एक केंद्रीय कड़ी का काम करता है। पहले कोई वेबसाइट नया पेज प्रकाशित करती है, फिर सर्च इंजन का क्रॉलर उस पेज को ढूंढता है, उसके बाद सर्च इंजन पेज को समझकर अपने इंडेक्स में सहेजता है, और अंत में जब कोई उपयोगकर्ता खोज करता है, तो वह पेज नतीजों में दिख सकता है। नीचे दिया गया प्रवाह रेखाचित्र इसी क्रम को दिखाता है।
अगर कोई व्यवसाय या सामग्री निर्माता सर्च इंजन को नज़रअंदाज़ करता है, तो उसकी वेबसाइट उन लोगों तक नहीं पहुंच पाती जो ठीक वही चीज़ खोज रहे होते हैं। सर्च से आने वाले बिना भुगतान वाले ट्रैफ़िक (Organic Traffic) के बिना नए लोगों तक पहुंचने के लिए विज्ञापनों पर ज़्यादा निर्भर रहना पड़ता है।
कब सर्च इंजन पर ध्यान देने की ज़रूरत नहीं है: हर डिजिटल परियोजना को सर्च इंजन में दिखने की ज़रूरत नहीं होती। अगर आप केवल अपने संगठन के आंतरिक उपयोग के लिए कोई ERP या इंट्रानेट पोर्टल चला रहे हैं, तो उसे सर्च इंजन पर लाने का कोई कारण नहीं है। इसी तरह, अगर आप किसी गोपनीय उत्पाद का परीक्षण कुछ चुने हुए ग्राहकों के साथ कर रहे हैं या किसी सीमित समुदाय के लिए निजी फ़ोरम चला रहे हैं, तो ऐसे पेजों को सर्च से दूर रखना ही बेहतर है। ऐसी स्थिति में अनुमति लेकर भेजे गए संदेशों के लिए email marketing software या दूसरे सीधे संचार माध्यम ज़्यादा उपयुक्त रहते हैं।
व्यवसाय और वेबसाइट चलाने वालों के लिए इसका महत्व
सर्च इंजन में दिखना दो स्तरों पर मूल्य देता है। पहला स्तर व्यवसाय से जुड़ा है, यानी ग्राहक और बिक्री; दूसरा स्तर उन मार्केटर्स और वेबमास्टर्स से जुड़ा है जो रोज़ वेबसाइट संभालते हैं।
व्यावसायिक दृश्यता क्यों मायने रखती है
सशुल्क विज्ञापनों में बजट खत्म होते ही विज्ञापन दिखना बंद हो जाता है, जबकि खोज के सामान्य (ऑर्गेनिक) नतीजों में दिखने के लिए हर क्लिक का भुगतान नहीं करना पड़ता। Google Search Central साफ़ लिखता है कि Google किसी साइट को ज़्यादा बार क्रॉल करने या उसकी रैंकिंग बढ़ाने के लिए पैसे नहीं लेता। इसका मतलब है कि ऑर्गेनिक नतीजों में जगह पैसे से नहीं, बल्कि काम की और अच्छी गुणवत्ता वाली सामग्री से बनती है।
सर्च में दिखना ब्रांड की साख भी मज़बूत करता है। जब कोई कंपनी अपने क्षेत्र के अहम सवालों पर बार-बार खोज के नतीजों में दिखती है, तो उपयोगकर्ता उसे उस विषय का जानकार मानने लगते हैं।
डिजिटल मार्केटर और वेबमास्टर के लिए लाभ
रोज़ वेबसाइट पर काम करने वाले मार्केटर्स के लिए सर्च डेटा यह समझने का सबसे सीधा ज़रिया है कि लोग असल में क्या खोज रहे हैं। Search Console जैसी मुफ़्त सेवाओं में दिखने वाली क्वेरीज़ बताती हैं कि लोग किस समस्या से जूझ रहे हैं और किन शब्दों में समाधान ढूंढ रहे हैं। इससे टीम अंदाज़े के बजाय वास्तविक खोज इरादे (Search Intent) के आधार पर पेज बना सकती है।
सर्च से जुड़े प्रदर्शन को अलग-अलग पैमानों पर मापा जाता है। नीचे दी गई तालिका में हर लाभ के लिए मापने योग्य मीट्रिक और उसे देखने की जगह दी गई है; आखिरी कॉलम आप अपनी वेबसाइट के आंकड़ों से खुद भरें:
| व्यावसायिक लाभ | मापने योग्य मीट्रिक | कहां देखें | आपकी वर्तमान स्थिति (स्वयं भरें) |
|---|---|---|---|
| ऑर्गेनिक आगंतुकों में वृद्धि | ऑर्गेनिक क्लिक और सेशन | Search Console की Performance रिपोर्ट, एनालिटिक्स टूल | [ ] |
| विज्ञापन पर निर्भरता में कमी | ऑर्गेनिक बनाम सशुल्क स्रोत से आए आगंतुक | एनालिटिक्स टूल की ट्रैफ़िक स्रोत रिपोर्ट | [ ] |
| ब्रांड की पहचान | इंप्रेशन और ब्रांड नाम वाली खोजें | Search Console की Performance रिपोर्ट (क्वेरी फ़िल्टर) | [ ] |
| योग्य व्यावसायिक लीड्स | फ़ॉर्म सबमिशन और सीधे संपर्क | एनालिटिक्स टूल के कन्वर्ज़न या आपका CRM | [ ] |
जब वेबसाइट की तकनीकी नींव तैयार हो जाए, तब नियमित रूप से अच्छे लेख लिखना और प्रकाशित करना अगला काम है। Orova SEO AI से चित्रों सहित SEO लेख 50 भाषाओं में आपके ब्रांड टोन के साथ लिखता है और Application Password के माध्यम से बिना प्लगइन सीधे वर्डप्रेस पर प्रकाशित करता है।
यह कैसे काम करता है: क्रॉल, इंडेक्स और खोज के नतीजे
जब आप सर्च बार में कोई सवाल लिखते हैं, तो सर्च इंजन उसी पल पूरे इंटरनेट को नहीं खंगालता। वह अपने पहले से बने डेटाबेस, यानी इंडेक्स, में से उत्तर ढूंढता है। Google Search Central के अनुसार, Google Search तीन चरणों में काम करता है: क्रॉल करना, इंडेक्स करना और खोज के नतीजे दिखाना। साथ ही Google यह भी साफ़ करता है कि हर पेज इन तीनों चरणों तक नहीं पहुंचता, और Google किसी पेज को क्रॉल करने, इंडेक्स करने या नतीजों में दिखाने की गारंटी नहीं देता।
क्रॉल करना (Crawling): वेब पर पेजों की खोज
वेब के सभी पेजों की कोई एक केंद्रीय रजिस्ट्री नहीं है, इसलिए सर्च इंजन लगातार नए और अपडेट हुए पेज ढूंढता रहता है। Google इसे "यूआरएल की खोज" कहता है। जब पहले से क्रॉल किए गए किसी पेज पर नए पेज का लिंक मिलता है (जैसे किसी कैटगरी पेज पर नई ब्लॉग पोस्ट का लिंक), तो क्रॉलर को उस नए पेज का पता चलता है। कुछ पेज तब मिलते हैं जब साइट मालिक पेजों की सूची, यानी साइटमैप, सबमिट करता है।
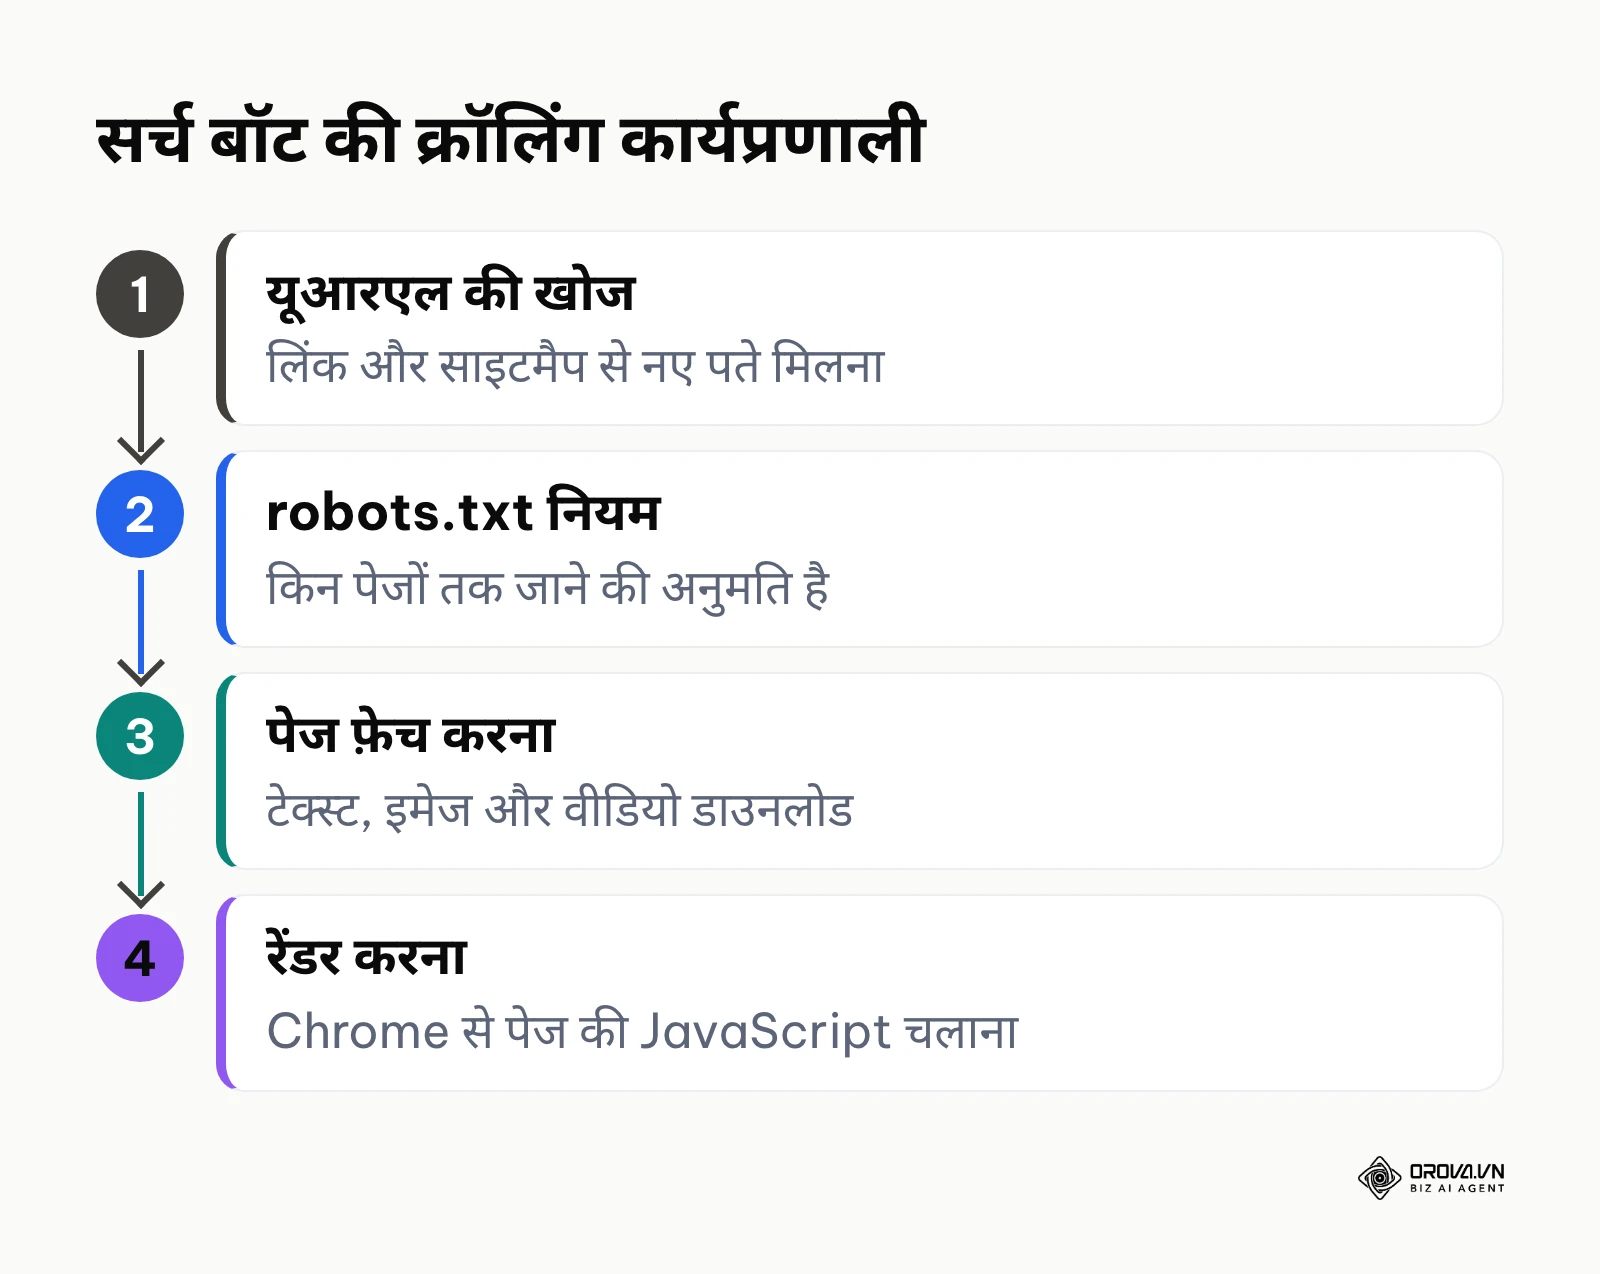
पेज फ़ेच करने वाले Google के प्रोग्राम को Googlebot कहते हैं, जिसे रोबोट, बॉट या स्पाइडर भी कहा जाता है। Googlebot एल्गोरिदम की मदद से तय करता है कि किस साइट को क्रॉल करना है, कितनी बार करना है और हर साइट से कितने पेज लाने हैं। क्रॉल करते समय Google, Chrome के हाल के वर्शन से पेज को रेंडर करता है और पेज पर मौजूद JavaScript चलाता है, क्योंकि कई वेबसाइटें कॉन्टेंट दिखाने के लिए JavaScript पर निर्भर होती हैं।
- यह क्या करता है: नए और अपडेट हुए पेजों के यूआरएल ढूंढना और उनका टेक्स्ट, इमेज और वीडियो डाउनलोड करना।
- इनपुट: पहले से ज्ञात पेज, उन पर मौजूद लिंक, और साइट मालिक द्वारा सबमिट किया गया साइटमैप।
- आउटपुट: पेज का कॉन्टेंट (रेंडर होने के बाद) और आगे क्रॉल करने के लिए नए यूआरएल।
- आम समस्याएं: सर्वर में गड़बड़ी, नेटवर्क की समस्या, और robots.txt के ऐसे नियम जो Googlebot को पेज तक पहुंचने से रोकते हैं। लॉग-इन के पीछे छिपे पेज भी क्रॉल नहीं हो पाते।
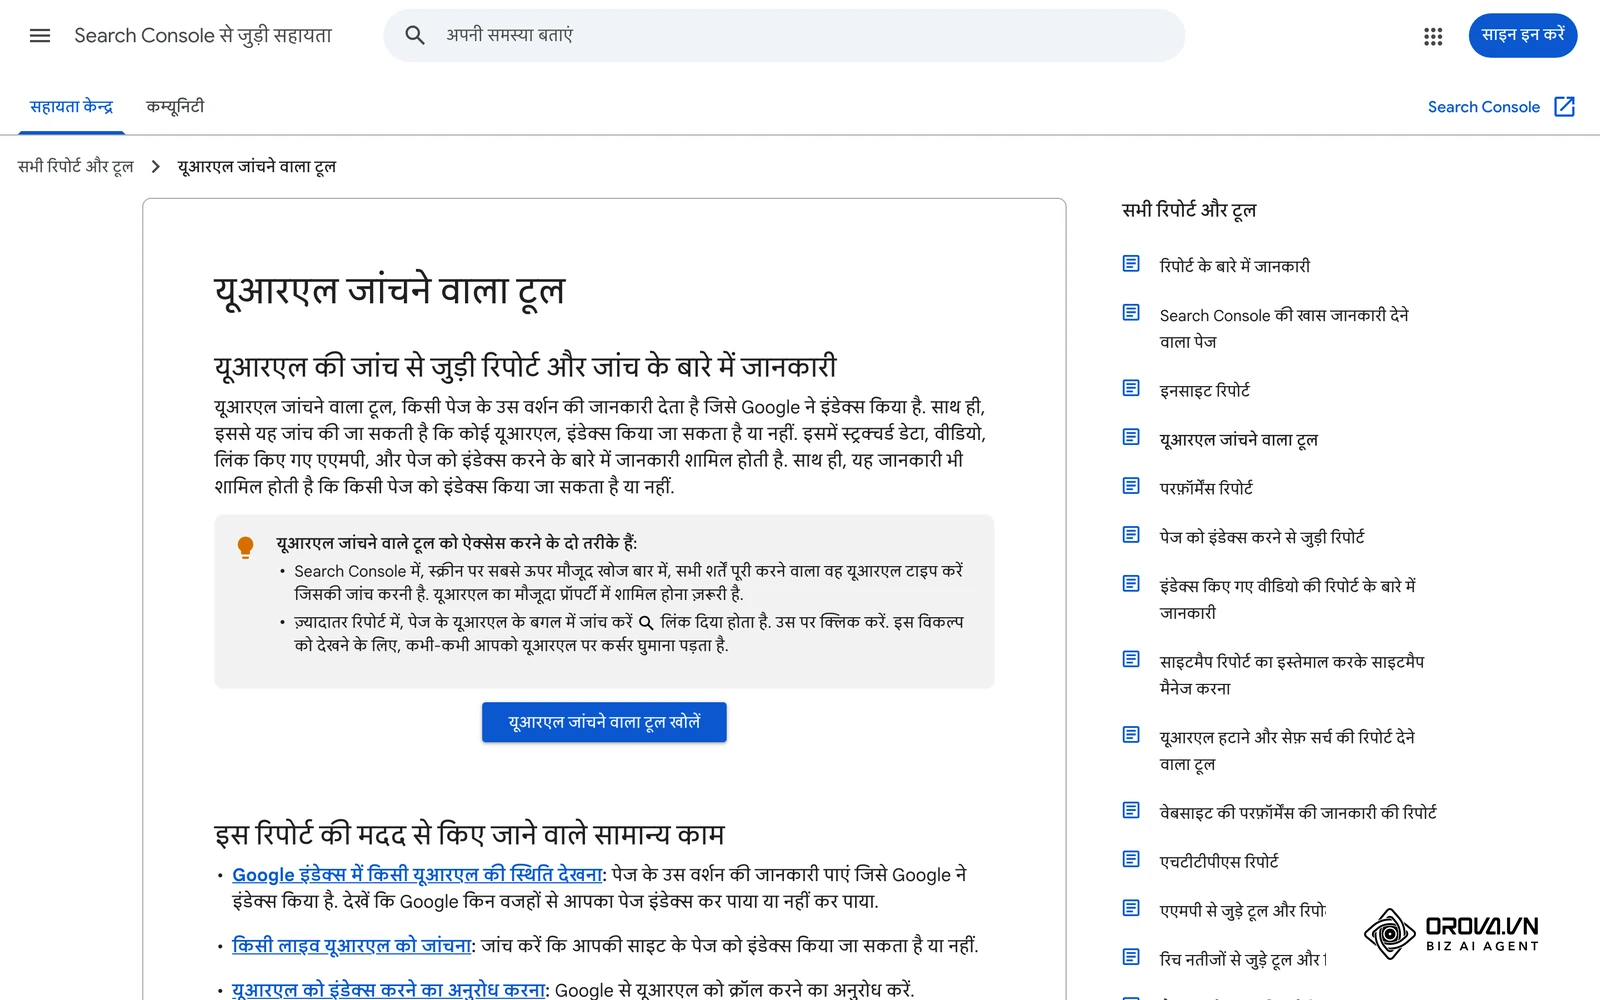
उदाहरण (काल्पनिक): पुणे की एक छोटी B2B पैकेजिंग कंपनी ने अपनी वेबसाइट पर नए उत्पाद पेज जोड़े, लेकिन वे खोज के नतीजों में नहीं दिख रहे थे। जांच में पता चला कि डेवलपर ने गलती से robots.txt फ़ाइल में पूरी उत्पाद डायरेक्टरी को Disallow कर रखा था। टीम ने यह नियम हटाया, साइटमैप दोबारा सबमिट किया और Search Console के यूआरएल जांचने वाले टूल (URL Inspection) से पेजों की स्थिति जांची। यहां सीख यह है कि पेज न दिखे तो सबसे पहले यह देखें कि क्रॉलर उस तक पहुंच भी पा रहा है या नहीं।
इंडेक्स करना (Indexing): पेज को समझना और सहेजना
पेज क्रॉल होने के बाद सर्च इंजन यह समझने की कोशिश करता है कि पेज किस बारे में है। इस चरण को इंडेक्स करना कहते हैं। Google के अनुसार, इसमें टेक्स्ट कॉन्टेंट के साथ-साथ अहम टैग और एट्रिब्यूट, जैसे <title> एलिमेंट और ऑल्ट एट्रिब्यूट, इमेज और वीडियो का विश्लेषण शामिल है।
इसी चरण में Google यह भी तय करता है कि कोई पेज किसी दूसरे पेज का डुप्लीकेट है या कैननिकल (Canonical)। मिलते-जुलते कॉन्टेंट वाले पेजों का एक समूह बनाया जाता है (इसे क्लस्टरिंग कहते हैं) और उसमें से वह पेज चुना जाता है जो समूह का सबसे अच्छा प्रतिनिधित्व करता है; वही कैननिकल पेज खोज के नतीजों में दिखाया जा सकता है। Google पेज की भाषा, कॉन्टेंट किस देश के लिए है और पेज की उपयोगिता जैसे सिग्नल भी इकट्ठा करता है। यह जानकारी Google इंडेक्स में सेव की जा सकती है, जो हज़ारों कंप्यूटरों पर होस्ट किया गया एक बहुत बड़ा डेटाबेस है। ध्यान रखें, Google जिन पेजों को प्रोसेस करता है, वे सभी इंडेक्स हों, यह ज़रूरी नहीं।
- यह क्या करता है: पेज के कॉन्टेंट और मेटाडेटा का विश्लेषण करना, डुप्लीकेट पेजों में से कैननिकल चुनना और जानकारी इंडेक्स में सहेजना।
- इनपुट: क्रॉलर द्वारा लाया गया और रेंडर किया गया पेज।
- आउटपुट: इंडेक्स में पेज की प्रविष्टि, साथ में भाषा, देश और उपयोगिता जैसे सिग्नल।
- आम समस्याएं: कॉन्टेंट की खराब गुणवत्ता, robots meta नियमों (जैसे noindex) के कारण इंडेक्स करने की अनुमति न होना, और ऐसा साइट डिज़ाइन जिसे इंडेक्स करना मुश्किल हो।
उदाहरण (काल्पनिक): एक शैक्षिक वेबसाइट ने अपना CMS बदला, जिसके बाद लेखों का मुख्य टेक्स्ट केवल ब्राउज़र में चलने वाली JavaScript से लोड होने लगा और पुराने यूआरएल 404 त्रुटि देने लगे। टीम ने पुराने यूआरएल को नए यूआरएल पर 301 रीडायरेक्ट से जोड़ा, अहम पेजों के लिए सर्वर-साइड रेंडरिंग अपनाई और अपडेट किया गया साइटमैप सबमिट किया। फिर Search Console की इंडेक्सिंग रिपोर्ट से नज़र रखी कि पेज दोबारा इंडेक्स हो रहे हैं या नहीं।
खोज के नतीजे दिखाना (Serving): रैंकिंग कैसे तय होती है
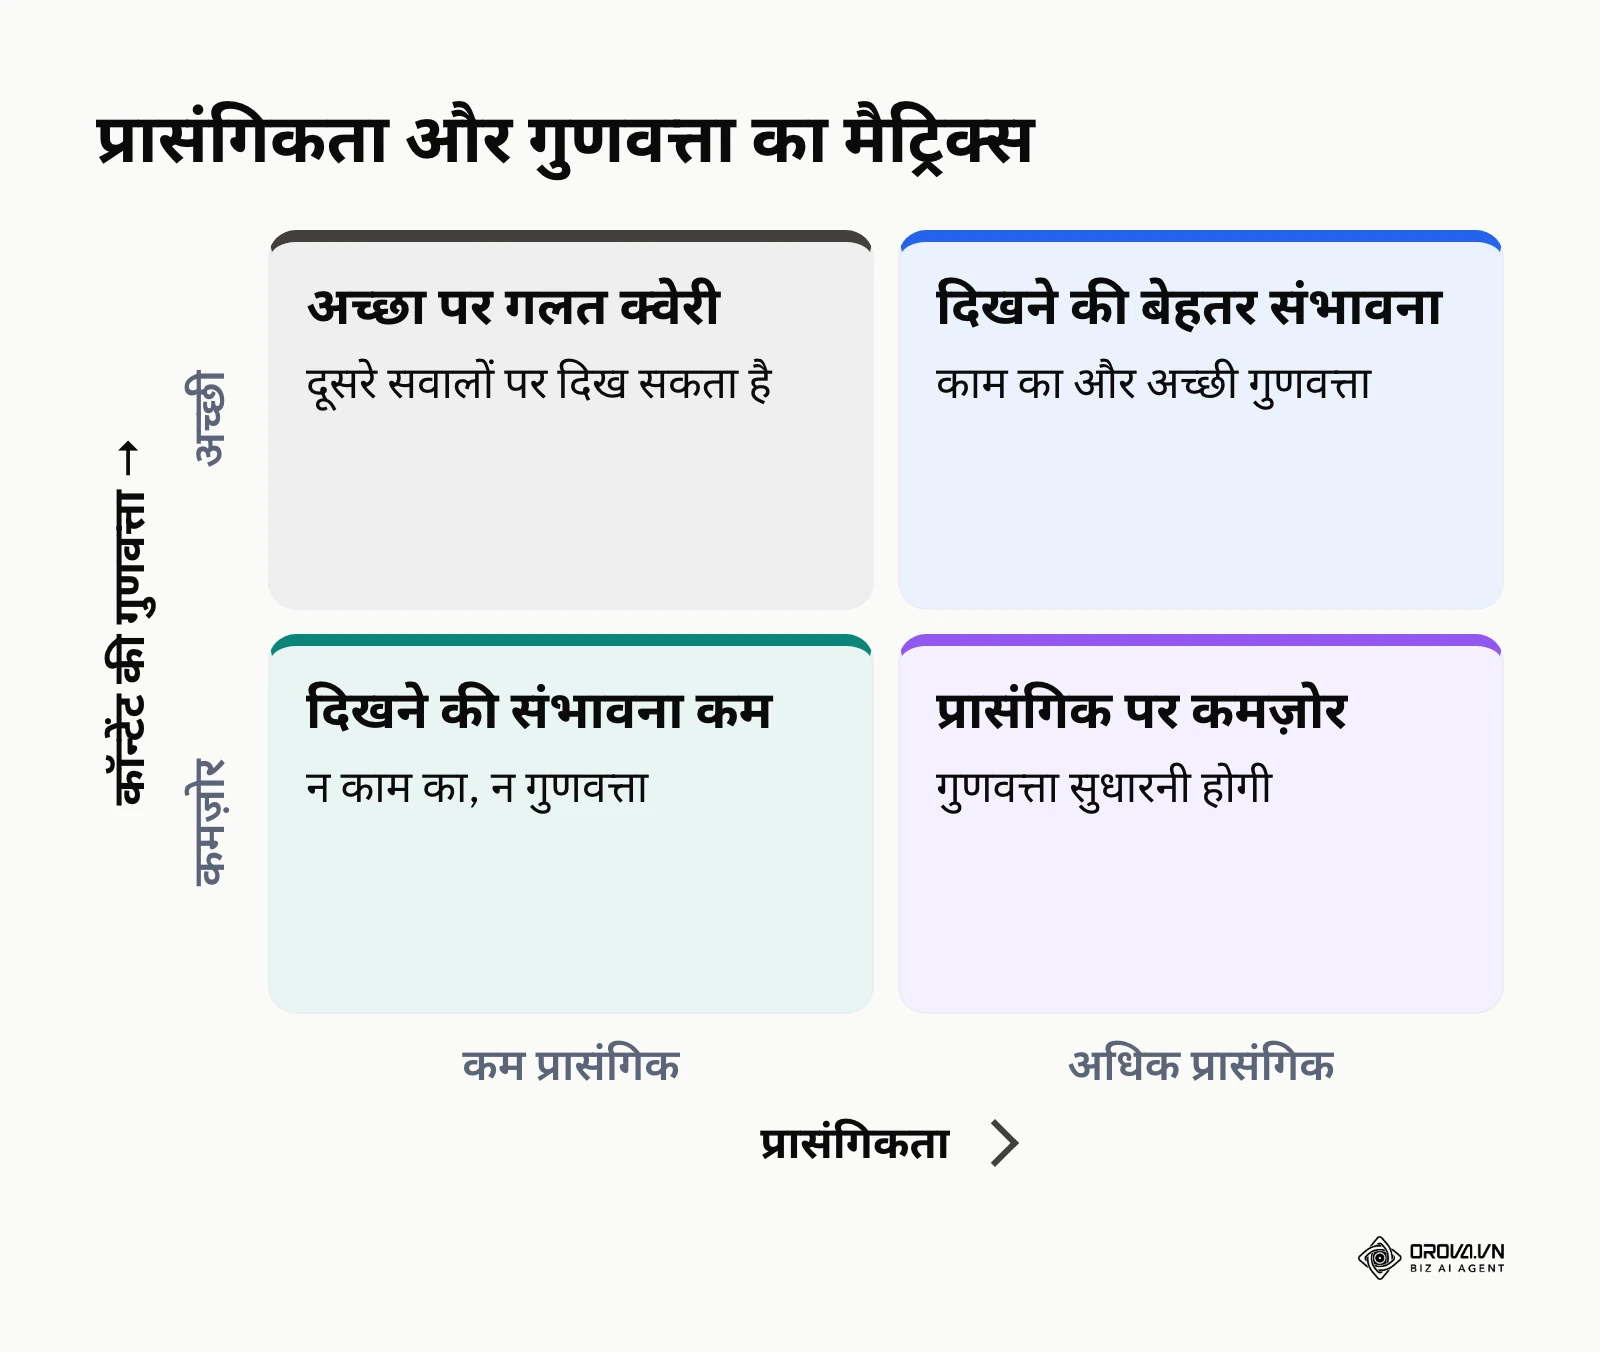
जब कोई उपयोगकर्ता क्वेरी डालता है, तो Google की मशीनें इंडेक्स में क्वेरी से मिलते-जुलते पेज खोजती हैं और वे नतीजे दिखाती हैं जिन्हें Google सबसे अच्छी गुणवत्ता वाला और उपयोगकर्ता के लिए सबसे ज़्यादा काम का मानता है। Google के अनुसार, कॉन्टेंट काम का है या नहीं, यह सैकड़ों बातों पर निर्भर करता है, जिनमें उपयोगकर्ता की जगह, भाषा और डिवाइस (डेस्कटॉप या फ़ोन) शामिल हैं। यही कारण है कि दिल्ली और मुंबई में एक ही चीज़ खोजने वाले दो लोगों को अलग-अलग नतीजे दिख सकते हैं।
क्वेरी के हिसाब से नतीजों का रूप भी बदलता है। "पास की साइकिल मरम्मत की दुकान" जैसी खोज पर स्थानीय नतीजे दिख सकते हैं, जबकि किसी उत्पाद के डिज़ाइन की खोज पर इमेज नतीजे दिख सकते हैं। Google कुछ खोजों के लिए नतीजों के साथ AI Overviews जैसे AI सारांश भी दिखाता है, जिनमें स्रोत वेब पेजों के लिंक होते हैं। यह समझने के लिए AI SEO की बुनियादी बातें जानना उपयोगी है। अपने पेज को सही क्वेरी के लिए प्रासंगिक बनाने में कीवर्ड रिसर्च कैसे करें की समझ भी काम आती है, ताकि सामग्री सीधे उपयोगकर्ता के खोज इरादे से मेल खाए।
- यह क्या करता है: क्वेरी से मेल खाने वाले इंडेक्स किए गए पेजों में से सबसे काम के और अच्छी गुणवत्ता वाले पेज चुनकर क्रम से दिखाना।
- इनपुट: उपयोगकर्ता की क्वेरी, उसकी जगह, भाषा, डिवाइस और इंडेक्स का डेटा।
- आउटपुट: खोज नतीजों का पेज (SERP), जिसमें सामान्य वेब नतीजे, स्थानीय या इमेज नतीजे और कुछ खोजों पर AI सारांश हो सकते हैं।
- आम समस्याएं: Google के अनुसार, कोई पेज इंडेक्स होने के बावजूद नतीजों में न दिखे तो इसकी वजह हो सकती है कि कॉन्टेंट उपयोगकर्ताओं की क्वेरी के लिए काम का न हो, उसकी गुणवत्ता खराब हो, या robots meta नियम उसे दिखने से रोक रहे हों।
Google यह भी साफ़ लिखता है कि वह किसी पेज की रैंक बढ़ाने के लिए पैसे नहीं लेता; रैंकिंग प्रोग्रामिंग से तय होती है। खोज नतीजों के साथ दिखने वाले विज्ञापन अलग से "प्रायोजित" के रूप में चिह्नित होते हैं।
सर्च इंजन के मुख्य प्रकार
आज के सर्च इंजनों को उनके काम करने के तरीके और प्राथमिकताओं के आधार पर कुछ मुख्य श्रेणियों में बांटा जा सकता है: क्रॉलर-आधारित सामान्य सर्च इंजन, गोपनीयता पर ज़ोर देने वाले सर्च इंजन, AI उत्तर इंजन, किसी खास तरह के कॉन्टेंट के लिए वर्टिकल सर्च, और किसी क्षेत्र या भाषा पर केंद्रित सर्च इंजन। नीचे दी गई तालिका हर श्रेणी का तरीका और उदाहरण बताती है। आखिरी कॉलम आप अपनी ज़रूरत के हिसाब से भरें; यह तालिका किसी सर्च इंजन को बेहतर या कमतर नहीं बताती, बल्कि उनके काम का अंतर समझाती है।
| श्रेणी | कैसे काम करता है | उदाहरण | किस तरह की खोज के लिए | आपके काम का? (स्वयं भरें) |
|---|---|---|---|---|
| क्रॉलर-आधारित सामान्य सर्च इंजन | अपने क्रॉलर से पूरे वेब को क्रॉल और इंडेक्स करता है, नतीजों के साथ कुछ खोजों पर AI सुविधाएं भी देता है | Google, Microsoft Bing | रोज़मर्रा की हर तरह की खोज | [ ] |
| गोपनीयता पर केंद्रित सर्च इंजन | अपनी नीति में खोज इतिहास और ट्रैकिंग सीमित रखने पर ज़ोर देता है | DuckDuckGo | जो उपयोगकर्ता निजता को प्राथमिकता देते हैं | [ ] |
| AI उत्तर इंजन | वेब स्रोतों को पढ़कर बातचीत जैसे उत्तर देता है और स्रोतों के लिंक दिखाता है | Perplexity | किसी विषय पर सारांश और आगे के सवाल | [ ] |
| वर्टिकल सर्च | केवल एक तरह के कॉन्टेंट को इंडेक्स करता है | YouTube (वीडियो), Google Scholar (शोध पत्र) | वीडियो, शोध पत्र या किसी खास प्रकार की सामग्री | [ ] |
| क्षेत्र या भाषा पर केंद्रित | किसी खास देश या भाषा के वेब पर ध्यान देता है | Baidu (चीनी भाषा), Yandex (रूसी भाषा) | उस भाषा या बाज़ार से जुड़ी खोज | [ ] |
अपनी वेबसाइट को खोज के नतीजों में लाने के व्यावहारिक कदम
अपनी वेबसाइट को सर्च इंजनों के अनुकूल बनाना एक लगातार चलने वाला काम है। अलग-अलग भूमिकाओं में पहली प्राथमिकताएं अलग होती हैं।
छोटे व्यवसाय मालिकों (Small Business Owners) के लिए कार्ययोजना
छोटे व्यवसायों के पास बजट और समय सीमित होता है, इसलिए उन्हें उन बुनियादी कदमों से शुरुआत करनी चाहिए जिनका असर सीधे दिखने पर पड़ता है:
- अपनी वेबसाइट को Google Search Console और Bing Webmaster Tools में सत्यापित करें, ताकि आप देख सकें कि सर्च इंजन आपकी साइट को कैसे देखते हैं।
- वेबसाइट का एक साफ़ XML साइटमैप तैयार करें और उसे Search Console में सबमिट करें, ताकि क्रॉलर आपके अहम पेजों तक आसानी से पहुंच सके।
- Google Business Profile पर अपने व्यवसाय की स्थानीय जानकारी, काम के घंटे, असली पता और फ़ोन नंबर दर्ज करें, ताकि स्थानीय खोजों में आपकी जानकारी दिख सके।
- वेबसाइट के मुख्य पेजों पर अपने असली उत्पादों और सेवाओं का सीधा और साफ़ विवरण लिखें, जिससे ग्राहकों के सवालों का जवाब वहीं मिल जाए।
इन-हाउस कंटेंट टीम और डिजिटल मार्केटर्स के लिए रणनीति
कंपनी के भीतर सामग्री बनाने वाली टीमों को सामग्री की बनावट और खोज इरादे पर ध्यान देना चाहिए:
- हर लेख लिखने से पहले खोज इरादे को समझें: पाठक केवल जानकारी चाहता है या खरीदारी के चरण में है।
- सामग्री में साफ़ शीर्षक संरचना (H2, H3) रखें और अहम सवालों का सीधा, छोटा उत्तर संबंधित शीर्षक के ठीक नीचे लिखें।
- पुराने और नए पेजों के बीच प्रासंगिक आंतरिक लिंक (Internal Links) जोड़ें, ताकि क्रॉलर और पाठक दोनों आसानी से अगले पेज तक पहुंच सकें। पहुंच बढ़ाने के लिए अपनी सामग्री को सोशल मीडिया मार्केटिंग चैनलों पर भी साझा करें।
- नियमित रूप से Search Console में इंप्रेशन और क्लिक की समीक्षा करें और जिन पेजों का प्रदर्शन गिर रहा हो, उनकी सामग्री को ताज़ा करें।
फ्रीलांसरों और एजेंसी प्रोफेशनल्स के लिए तकनीकी चेकलिस्ट
क्लाइंट की वेबसाइटें संभालने वाले पेशेवरों के लिए एक तय तकनीकी जांच ज़रूरी है। नीचे दी गई 7 बिंदुओं वाली चेकलिस्ट हर नई या दोबारा डिज़ाइन की गई वेबसाइट पर इस्तेमाल करें:
- [ ] XML साइटमैप बनाना और जांचना: साइटमैप में केवल वही कैननिकल यूआरएल हों जो सही तरह से खुलते हैं (HTTP 200)।
- [ ] robots.txt की जांच: अहम पेज, CSS और JavaScript फ़ाइलें क्रॉलर के लिए ब्लॉक न हों।
- [ ] कैननिकल टैग: डुप्लीकेट यूआरएल की समस्या से बचने के लिए हर पेज पर सही कैननिकल टैग मौजूद हो।
- [ ] मोबाइल पर सही दिखना: हर स्क्रीन आकार पर टेक्स्ट पढ़ने लायक हो और बटन आसानी से दबाए जा सकें।
- [ ] Core Web Vitals और गति: इमेज कंप्रेस करें, कैशिंग सेट करें और Search Console की Core Web Vitals रिपोर्ट में धीमे पेजों की सूची देखें।
- [ ] हेडिंग संरचना और स्ट्रक्चर्ड डेटा: पेज पर एक मुख्य शीर्षक (H1) हो और प्रासंगिक स्ट्रक्चर्ड डेटा (जैसे Article या Product) सही तरीके से लगा हो।
- [ ] Search Console का यूआरएल जांचने वाला टूल (URL Inspection): नए प्रकाशित पेजों की लाइव जांच करें और ज़रूरत हो तो इंडेक्स करने का अनुरोध भेजें।
आम गलतियां और उनका समाधान
कुछ आम गलतियां पूरी मेहनत को बेकार कर देती हैं। नीचे दी गई तालिका में इन गलतियों, उनके असर और बचाव के उपायों को संक्षेप में रखा गया है:
| आम गलती | संभावित असर | सही बचाव |
|---|---|---|
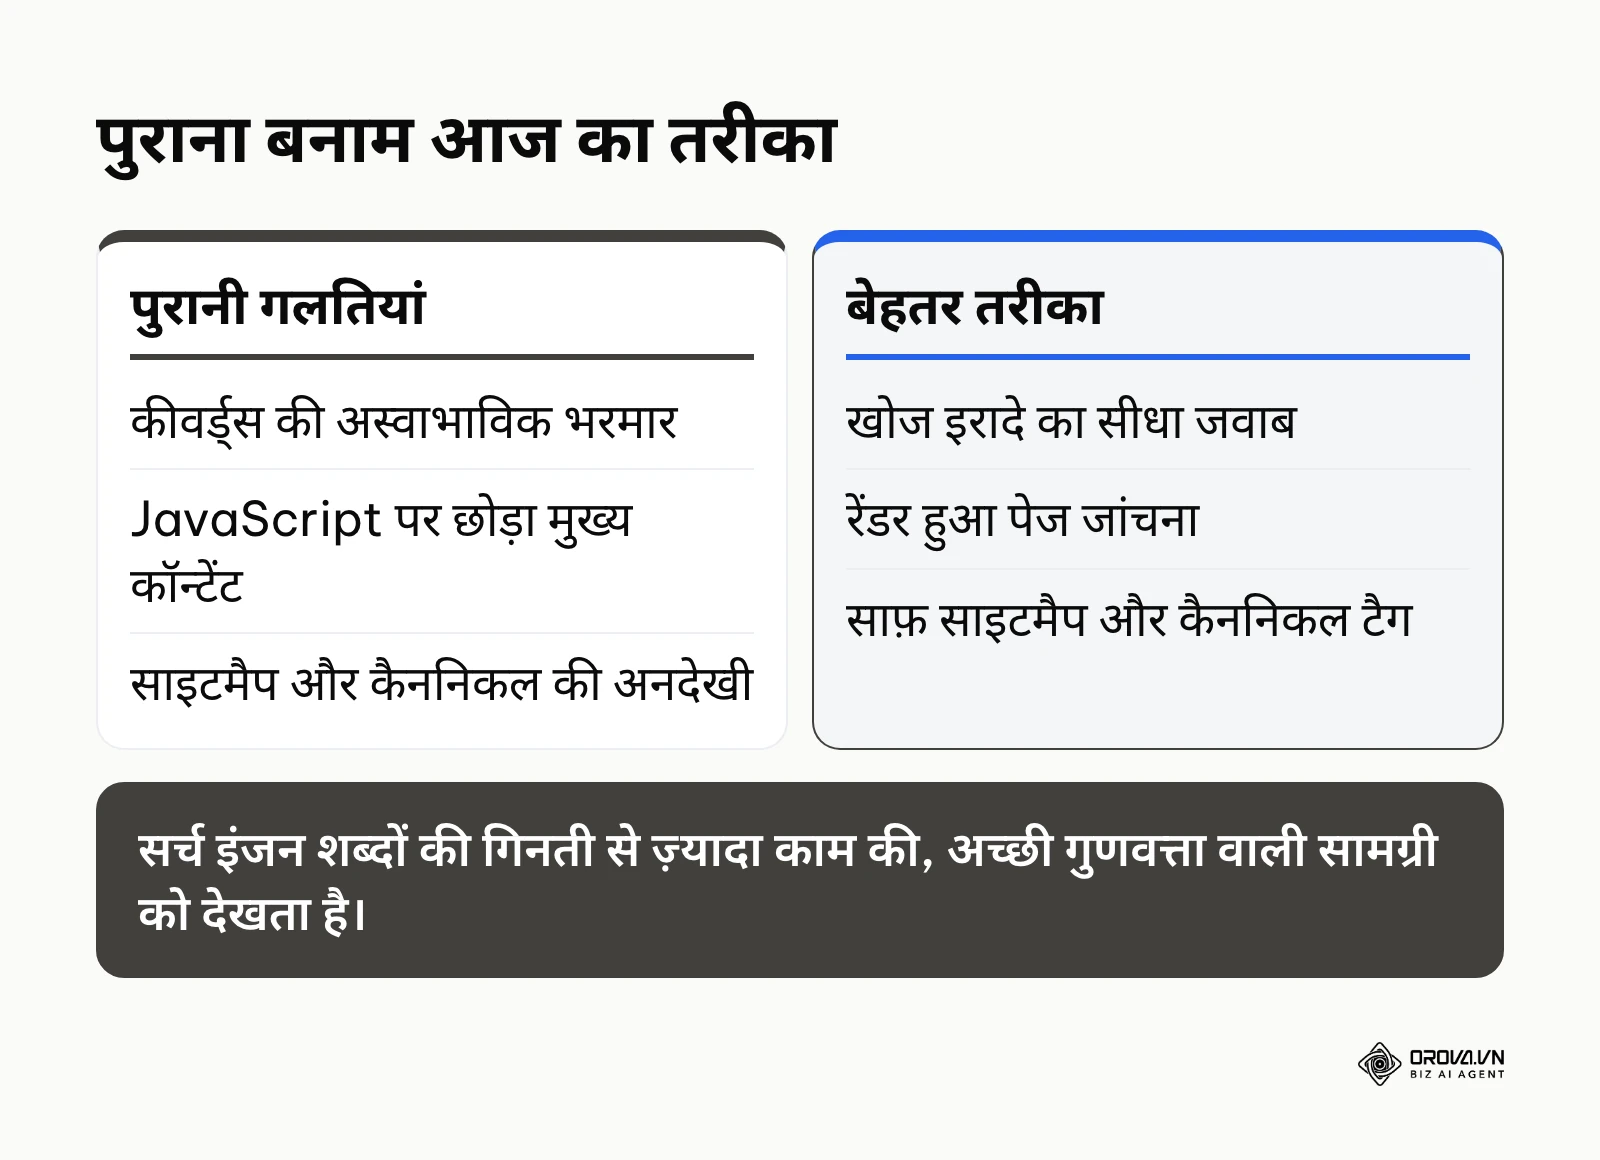
| कीवर्ड्स की अस्वाभाविक भरमार (Keyword Stuffing) | Google की स्पैम नीतियों का उल्लंघन, पेज की रैंकिंग गिरना या नतीजों से हटना | स्वाभाविक भाषा में लिखें और विषय को पूरी तरह समझाएं |
| JavaScript से लोड होने वाला मुख्य कॉन्टेंट जो ठीक से रेंडर न हो | पेज का अधूरा इंडेक्स होना | यूआरएल जांचने वाले टूल में रेंडर हुआ पेज जांचें, ज़रूरत हो तो सर्वर-साइड रेंडरिंग अपनाएं |
| साइटमैप में टूटे हुए (404) या रीडायरेक्ट होने वाले लिंक | क्रॉलर का समय बेकार पेजों पर जाना | साइटमैप की नियमित जांच करें और गलत यूआरएल हटाएं |
| डुप्लीकेट पेजों पर कैननिकल टैग न लगाना | सर्च इंजन का ऐसा पेज कैननिकल चुन लेना जो आप नहीं चाहते | मुख्य यूआरएल तय करके उस पर साफ़ कैननिकल टैग लगाएं |
पुराने लेखों को ताज़ा रखने और Search Console के आंकड़े देखने के लिए अलग-अलग टूल्स जोड़ने की ज़रूरत नहीं। Orova SEO पुराने लेख को उसी URL पर दोबारा प्रकाशित करके अपडेट करता है और Search Console के आंकड़े एक ही जगह दिखाता है; यह 7 जुलाई 2027 तक मुफ़्त उपलब्ध है।
Orova SEO से लेख लिखने और प्रकाशित करने का काम कैसे चलाएं
क्रॉलिंग और इंडेक्सिंग की तकनीकी नींव ठीक होने के बाद अगला काम है नियमित रूप से ऐसे लेख प्रकाशित करना जो लोगों की खोज का जवाब दें, और पुराने लेखों को ताज़ा रखना। यह काम अलग-अलग टूल्स से भी किया जा सकता है। अगर आप इसे एक जगह रखना चाहते हैं, तो Orova SEO AI से चित्रों सहित SEO लेख लिखने, उन्हें वर्डप्रेस पर प्रकाशित करने, पुराने लेख अपडेट करने और Search Console के आंकड़े पढ़ने का काम एक ही जगह करता है।
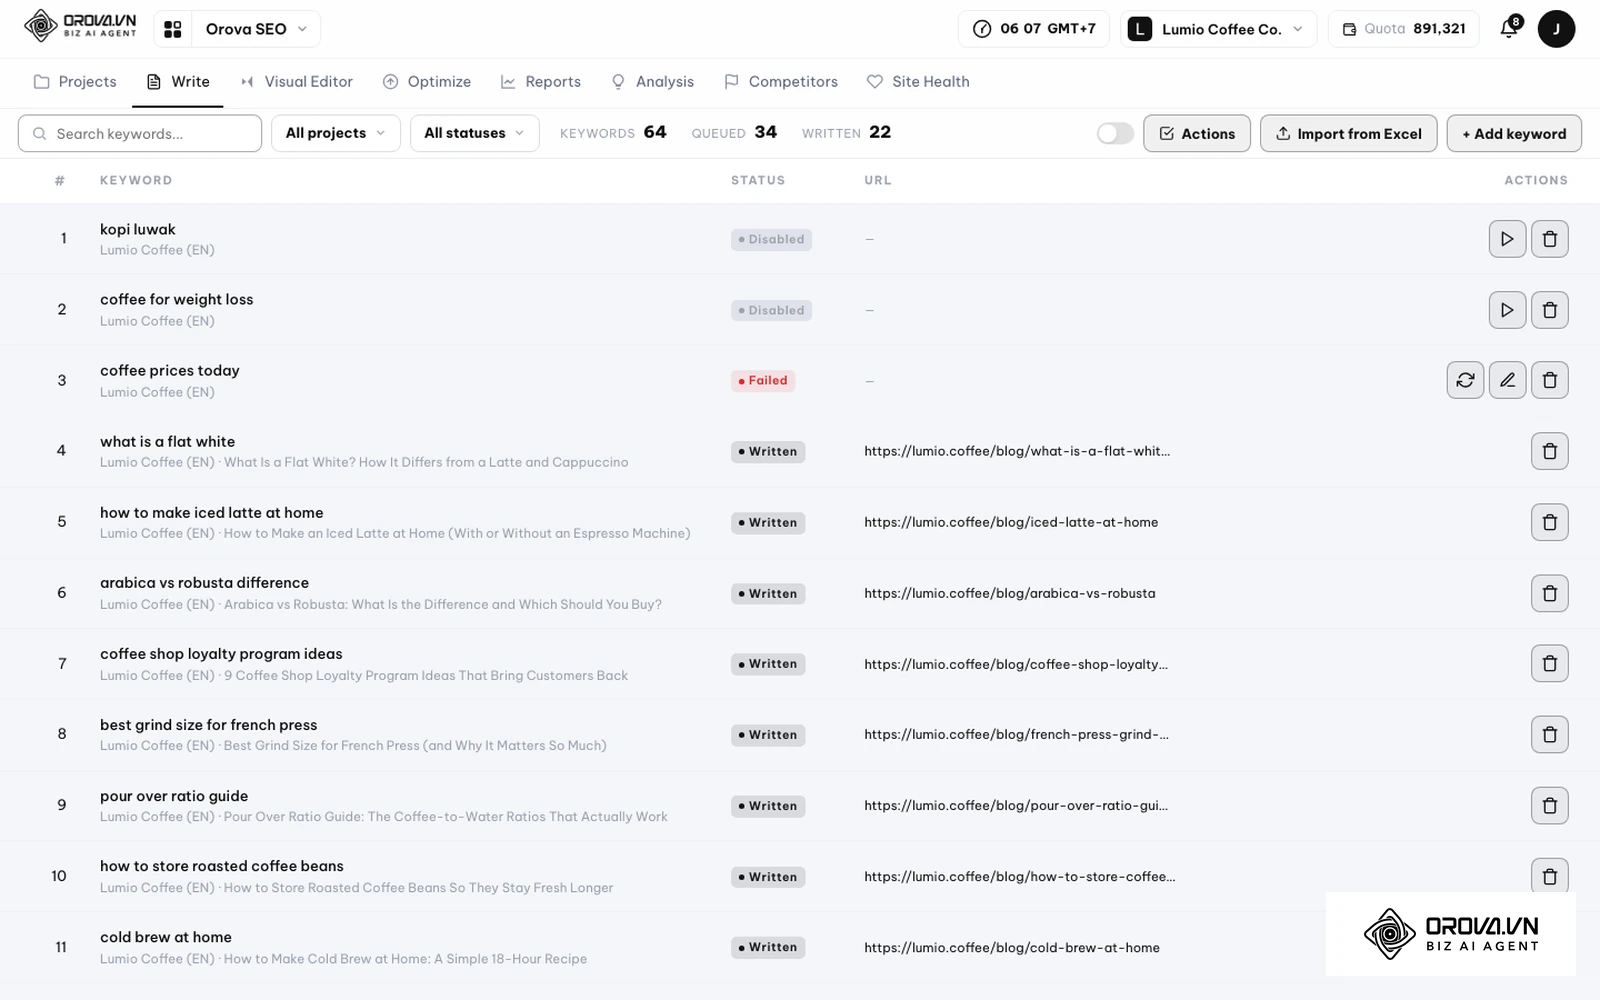
- कीवर्ड जोड़ें: Write टैब में + Add keyword बटन से एक-एक कीवर्ड जोड़ें, या कई कीवर्ड एक साथ Import from Excel से लाएं। सूची में हर कीवर्ड की स्थिति और प्रकाशित लेख का URL दिखता है।
- Search Console से प्राथमिकता: साइट को Search Console से जोड़ने पर Orova SEO आपकी अपनी साइट के उन कीवर्ड्स को प्राथमिकता देता है जिनकी औसत स्थिति 8 से 30 के बीच है।
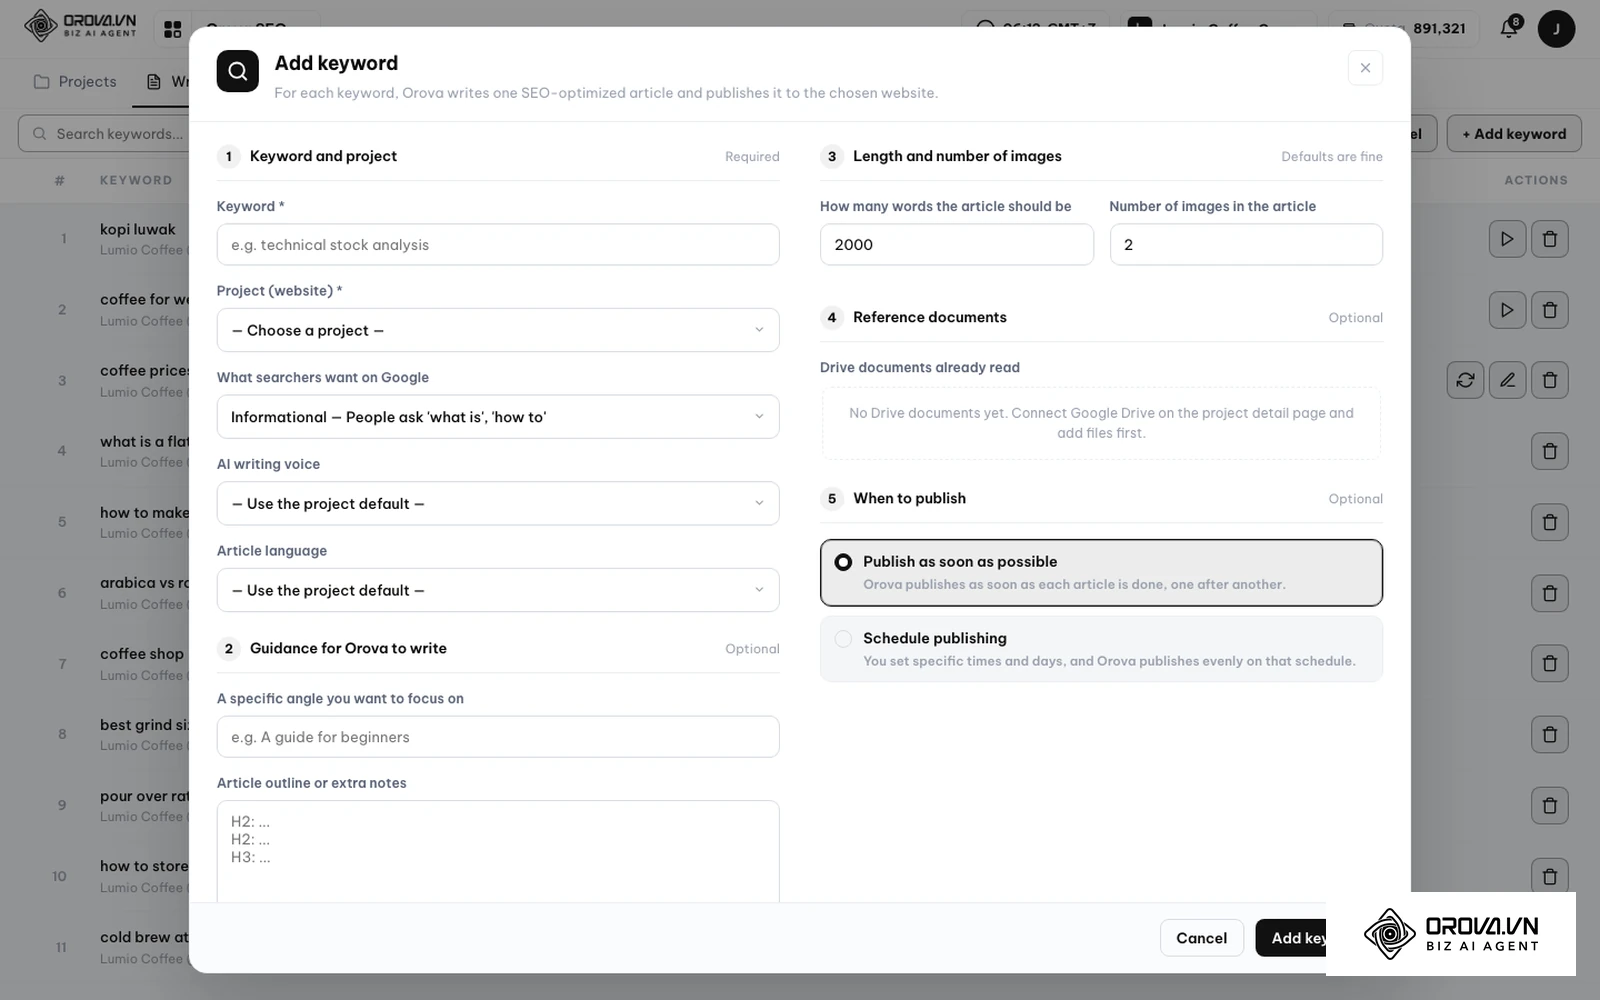
- लेख की सेटिंग चुनें: Add keyword डायलॉग में प्रोजेक्ट, सर्च इंटेंट, लेख की लंबाई और चित्रों का विकल्प चुनें। हर प्रोजेक्ट का अपना ब्रांड टोन होता है और लेख 50 भाषाओं में लिखे जा सकते हैं।
- प्रकाशन तय करें: Publish as soon as possible या Schedule publishing चुनें। लेख वर्डप्रेस पर Application Password के माध्यम से जाता है, किसी प्लगइन की ज़रूरत नहीं होती।
- पुराने लेख अपडेट करें: पुराने लेख को उसी URL पर दोबारा प्रकाशित करके अपडेट किया जा सकता है, जिससे पेज का पता नहीं बदलता।
ध्यान रखें कि कोई भी टूल क्रॉलिंग, इंडेक्सिंग या रैंकिंग की गारंटी नहीं दे सकता, क्योंकि यह फ़ैसला सर्च इंजन का होता है। प्रकाशन के बाद ऊपर दी गई तकनीकी चेकलिस्ट और Search Console के यूआरएल जांचने वाले टूल से नए पेजों की जांच करते रहें।
शुरुआत कहां से करें: अपनी स्थिति के अनुसार पहला कदम
सर्च इंजन पर अपनी मौजूदगी बनाने के लिए किसी भारी तकनीक की ज़रूरत नहीं होती; पहला कदम इस पर निर्भर करता है कि आपकी वेबसाइट अभी किस स्थिति में है। अपनी स्थिति पहचानें और नीचे दिया गया पहला कदम उठाएं।
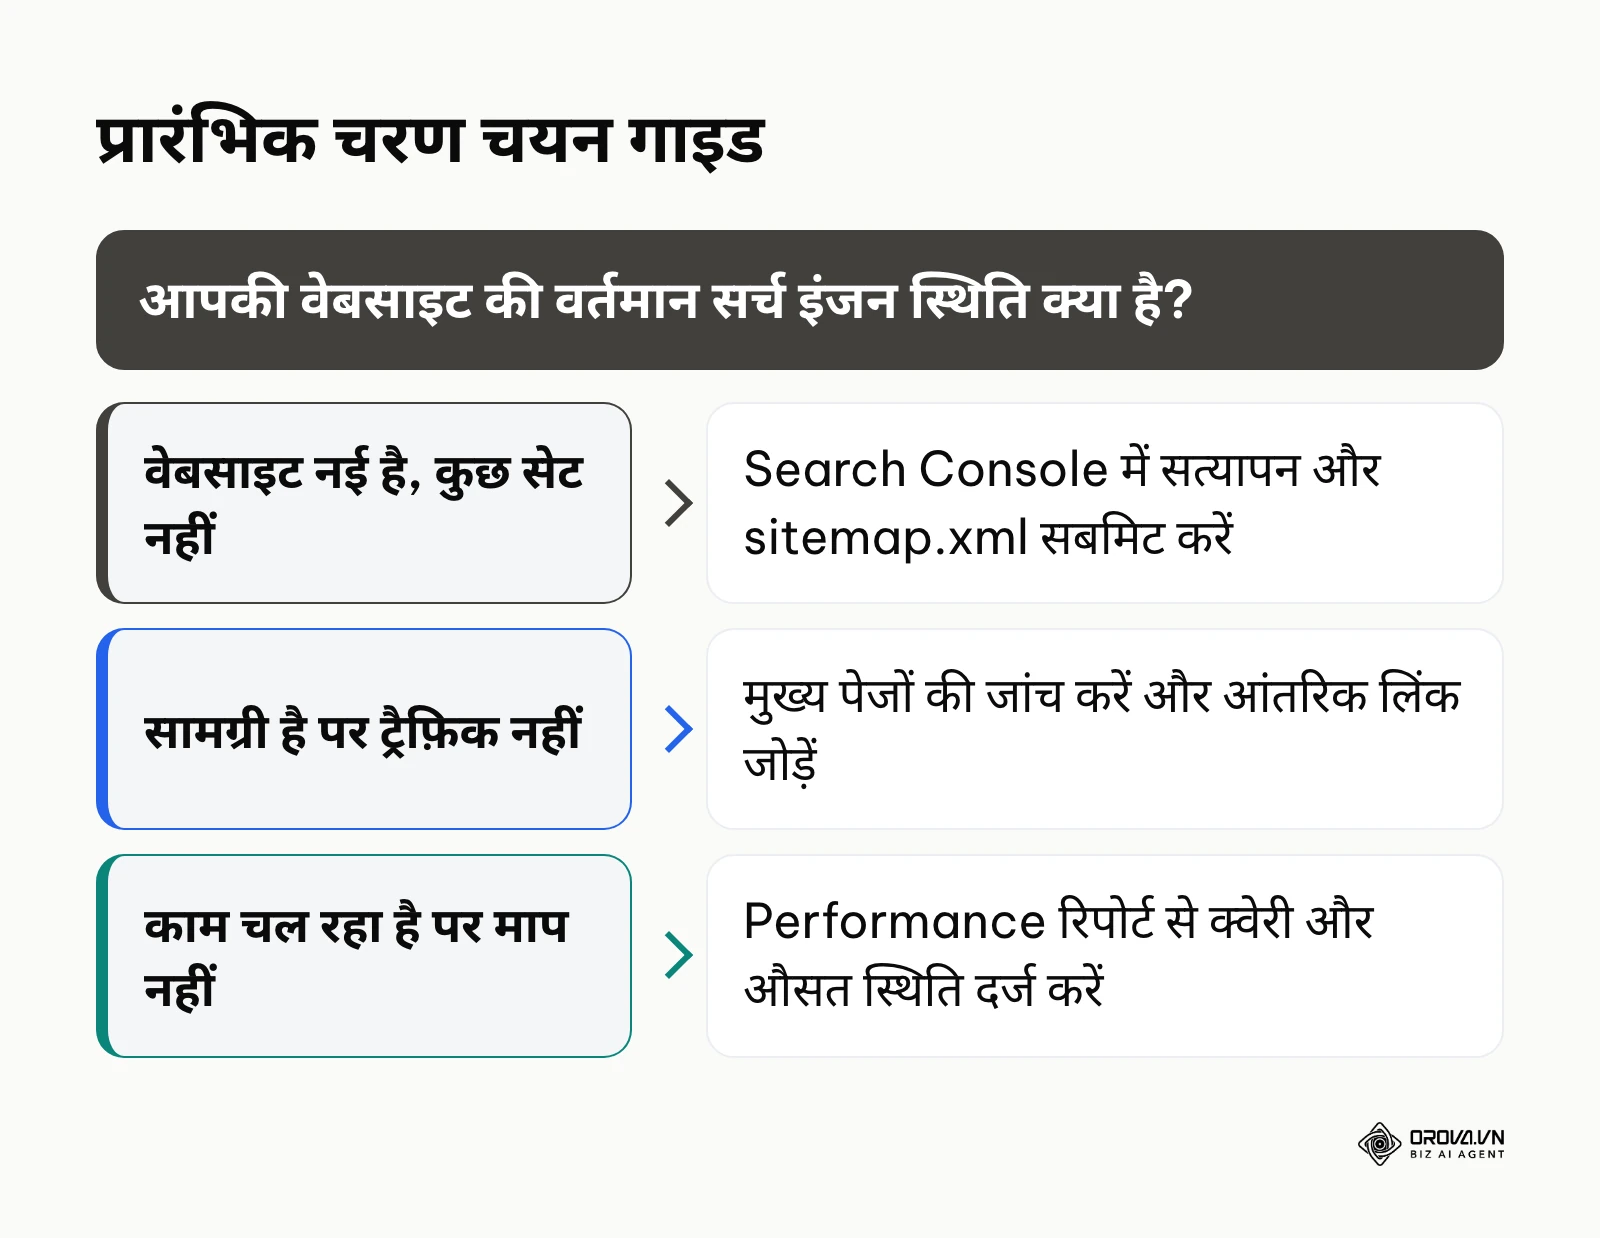
अगर आपकी वेबसाइट बिल्कुल नई है और अभी तक सर्च इंजन के लिए कुछ भी सेट नहीं किया गया है, तो सबसे पहले अपनी वेबसाइट को Google Search Console में सत्यापित करें। अपने डोमेन को DNS रिकॉर्ड या HTML टैग से सत्यापित करें और अपनी साइट का sitemap.xml सबमिट करें। इससे क्रॉलर को आपके पेजों की सूची मिल जाती है।
अगर आपकी वेबसाइट पर पहले से सामग्री है लेकिन ट्रैफ़िक नहीं आ रहा, तो पहला कदम मौजूदा सामग्री की जांच है। अपने मुख्य व्यवसाय से जुड़े सबसे अहम पेजों की सूची बनाएं और देखें कि क्या वे किसी खास समस्या का साफ़ समाधान देते हैं। इन पेजों को आपस में तार्किक रूप से जोड़ें और सुनिश्चित करें कि कोई अहम पेज बिना आंतरिक लिंक के अकेला न छूटे।
अगर आप वेबसाइट पर नियमित काम कर रहे हैं लेकिन उसके प्रदर्शन को माप नहीं रहे, तो Search Console की Performance रिपोर्ट में जाकर अपनी मुख्य खोज क्वेरीज़ और उनकी औसत स्थिति को आधार (बेसलाइन) के रूप में दर्ज करें। यह डेटा बताएगा कि सर्च इंजन आपके पेजों को किन शब्दों पर दिखा रहे हैं और किन पेजों के शीर्षक व विवरण सुधारने की ज़रूरत है।
2026 और उसके बाद: सर्च के रुझानों पर लेखक का दृष्टिकोण
सर्च इंजनों में आज जो बदलाव दिख रहे हैं, उन्हें देखकर लगता है कि जानकारी खोजने का तरीका एक बड़े बदलाव से गुज़र रहा है। इस पर मेरे तीन व्यक्तिगत दृष्टिकोण ये हैं:
पहला, मुझे लगता है कि केवल दस नीले लिंक वाला खोज नतीजों का पेज धीरे-धीरे अकेला मुख्य रूप नहीं रहेगा। Google के AI Overviews और दूसरे संवादात्मक सर्च टूल्स में हम देख रहे हैं कि कई उपयोगकर्ता सीधे सारांश पढ़ना पसंद करते हैं। मेरी राय में, साधारण तथ्यात्मक सवालों पर बिना क्लिक वाली खोजें (Zero-Click Searches) बढ़ सकती हैं। इसलिए वेबसाइट मालिकों को केवल क्लिक के लिए लिखने के बजाय ऐसी सामग्री बनानी होगी जिसे AI उत्तरों में भरोसेमंद स्रोत के रूप में दिखाया जा सके।
दूसरा, मेरा मानना है कि अर्थ समझने वाली और मल्टीमॉडल खोज (Multimodal Search) पारंपरिक कीवर्ड मिलान की भूमिका को और कम करेगी। लोग पहले से ही इमेज, आवाज़ और वीडियो के ज़रिए खोज कर रहे हैं। ऐसे में सामग्री बनाने वालों को इमेज के ऑल्ट टेक्स्ट, वीडियो के विवरण और अन्य मेटाडेटा पर पहले से ज़्यादा ध्यान देना चाहिए।
तीसरा, मेरा दृष्टिकोण है कि AI से बनी एक जैसी सामग्री की बाढ़ के कारण असली अनुभव और मौलिक जानकारी का महत्व बढ़ेगा। जब इंटरनेट पर एक जैसे लेख भर जाएंगे, तो वे लेख अलग दिखेंगे जिनमें वास्तविक परीक्षण, गलतियों से मिली सीख और व्यावहारिक केस स्टडी शामिल हों।
हालांकि, यह दृष्टिकोण गलत भी साबित हो सकता है। अगर कॉपीराइट से जुड़े कानूनी विवाद सर्च कंपनियों को AI सारांश सीमित करने पर मजबूर कर दें, या बड़े भाषा मॉडल (LLM) चलाने की लागत टिकाऊ न रहे, तो पारंपरिक खोज नतीजों का मॉडल लंबे समय तक प्रमुख बना रह सकता है।
अक्सर पूछे जाने वाले सवाल
सर्च इंजन और AI चैटबॉट में क्या बुनियादी अंतर है?
सर्च इंजन वेब पेजों को क्रॉल और इंडेक्स करके आपकी क्वेरी के लिए सबसे काम के पेजों के लिंक दिखाता है। एक सामान्य AI चैटबॉट अपने प्रशिक्षण डेटा के आधार पर बातचीत जैसा उत्तर बनाता है, और हर बार वेब से ताज़ा जानकारी नहीं लेता। आज कई सर्च इंजन दोनों को जोड़ रहे हैं, जहां AI से बना सारांश स्रोत पेजों के लिंक के साथ दिखता है।
क्या AI आने के बाद पारंपरिक सर्च इंजन की ज़रूरत खत्म हो जाएगी?
ऐसा होने की संभावना कम लगती है; ज़्यादा संभव है कि उसका रूप बदले। AI उत्तरों को सही और ताज़ा रखने के लिए वेब पर मौजूद नई और भरोसेमंद जानकारी चाहिए, और उसे ढूंढने व व्यवस्थित करने का काम क्रॉलिंग और इंडेक्सिंग का ढांचा ही करता है।
सर्च इंजन पैसे कैसे कमाते हैं?
ज़्यादातर बड़े सर्च इंजन उपयोगकर्ताओं से खोज का शुल्क नहीं लेते। उनकी आय का मुख्य स्रोत विज्ञापन है, जहां व्यवसाय खोज नतीजों के साथ अपने प्रायोजित (Sponsored) विज्ञापन दिखाने के लिए भुगतान करते हैं। ये विज्ञापन सामान्य नतीजों से अलग चिह्नित होते हैं, और Google के अनुसार सामान्य नतीजों में रैंकिंग के लिए वह पैसे नहीं लेता।
मेरी नई वेबसाइट सर्च इंजन में दिखने में कितना समय लेती है?
इसका कोई तय समय नहीं है। क्रॉलिंग में कुछ दिनों से लेकर कुछ हफ़्तों तक लग सकते हैं, और Google किसी पेज को क्रॉल या इंडेक्स करने की गारंटी नहीं देता। साइटमैप सबमिट करना, अहम पेजों तक आंतरिक लिंक देना और सर्वर को ठीक से चालू रखना इस प्रक्रिया में मदद करता है।
Google Search Console में यूआरएल की इंडेक्स स्थिति कैसे जांचें?
Search Console में अपनी प्रॉपर्टी खोलें और स्क्रीन पर सबसे ऊपर मौजूद खोज बार (यूआरएल जांचने वाला टूल, URL Inspection) में पेज का पूरा पता डालें। अगर नतीजे में "URL is on Google" दिखे, तो पेज Google इंडेक्स में है। अगर पेज Google पर नहीं है, तो कारण पढ़ें, समस्या ठीक करें और फिर उसी जगह से इंडेक्स करने का अनुरोध (Request Indexing) भेजें। लाइव यूआरएल की जांच (Test live URL) से आप यह भी देख सकते हैं कि Googlebot अभी पेज को कैसे देखता है।
क्या सर्च इंजन में वेबसाइट जोड़ने के लिए कोई शुल्क देना पड़ता है?
नहीं। Google Search Central के अनुसार, Google किसी साइट को ज़्यादा बार क्रॉल करने या उसकी रैंकिंग बढ़ाने के लिए पैसे नहीं लेता, और अगर कोई ऐसा दावा करे तो वह गलत है। Search Console में साइट जोड़ना और साइटमैप सबमिट करना मुफ़्त है। अगर कोई केवल "इंडेक्स कराने" के नाम पर पैसे मांगे, तो सावधान रहें।
लेखक के बारे में
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
AI Agents के साथ अपना व्यवसाय चलाएँ
Orova हमेशा सक्रिय Biz AI Agent है — यह आपके लिए काम की योजना बनाता है, उसे चलाता है और बेहतर करता है।
समय बचाएँ, उत्पादकता बढ़ाएँ।