Google Search Console indexing គឺជាអ្វី? យុទ្ធសាស្ត្រជួសជុលទំព័រ
Google Search Console indexing គឺជាពាក្យគន្លឹះបច្ចេកទេសដ៏សំខាន់បំផុតមួយ ដែលអ្នកគ្រប់គ្រងគេហទំព័រគ្រប់រូបតែងតែជួបប្រទះ នៅពេលបង្កើតមាតិការួចរាល់ ប៉ុន្តែមិនឃើញទំព័របង្ហាញលើលទ្ធផលស្វែងរករបស់ Google។ មនុស្សជាច្រើនយល់ច្រឡំថាឱ្យតែបោះពុម្ពផ្សាយអត្ថបទ ឬដាក់តំណភ្ជាប់លើបណ្ដាញសង្គមនោះ Google នឹងបញ្ចូលទំព័រទៅក្នុងប្រព័ន្ធ ដោយស្វ័យប្រវត្តិ។ ការយល់ឃើញចាស់នេះមិនគ្រប់គ្រាន់ទៀតទេ ព្រោះក្បួនដោះស្រាយបច្ចុប្បន្នមានតម្រូវការគុណភាព និងរចនាសម្ព័ន្ធកូដតឹងរ៉ឹងខ្លាំង។ ប្រសិនបើអ្នកគ្រាន់តែរង់ចាំ ដោយមិនយល់ដឹងពីរបាយការណ៍ Page Indexing អ្នកអាចនឹងបាត់បង់អតិថិជនដ៏ច្រើន ដោយសារទំព័រលក់ជាប់គាំងកំហុសបច្ចេកទេស។ អត្ថបទនេះនឹងជួយបកស្រាយគ្រប់ស្ថានភាពស្មុគស្មាញផ្តល់នូវក្របខ័ណ្ឌអាទិភាពដោះស្រាយបញ្ហា និងយុទ្ធសាស្ត្រជាក់ស្តែង ដើម្បីនាំទំព័ររបស់អ្នកឡើងលើ Google ប្រកបដោយប្រសិទ្ធភាព។
Google Search Console indexing គឺជាអ្វី?
Google Search Console indexing គឺជាដំណើរការដែលប្រព័ន្ធ Google វិភាគស្វែងយល់និងរក្សាទុកទំព័ររបស់អ្នក ក្នុងបញ្ជីទិន្នន័យស្វែងរក ដើម្បីអាចបង្ហាញលើ Google Search។ មុខងារនេះត្រូវបានប្រើ ដើម្បីតាមដានសុខភាពវត្តមានគេហទំព័រ និងដោះស្រាយកំហុស។ វាខុសពី Crawling ដែលគ្រាន់តែទាញយកកូដ និងខុសពី Ranking ដែលជាការផ្តល់ចំណាត់ថ្នាក់។
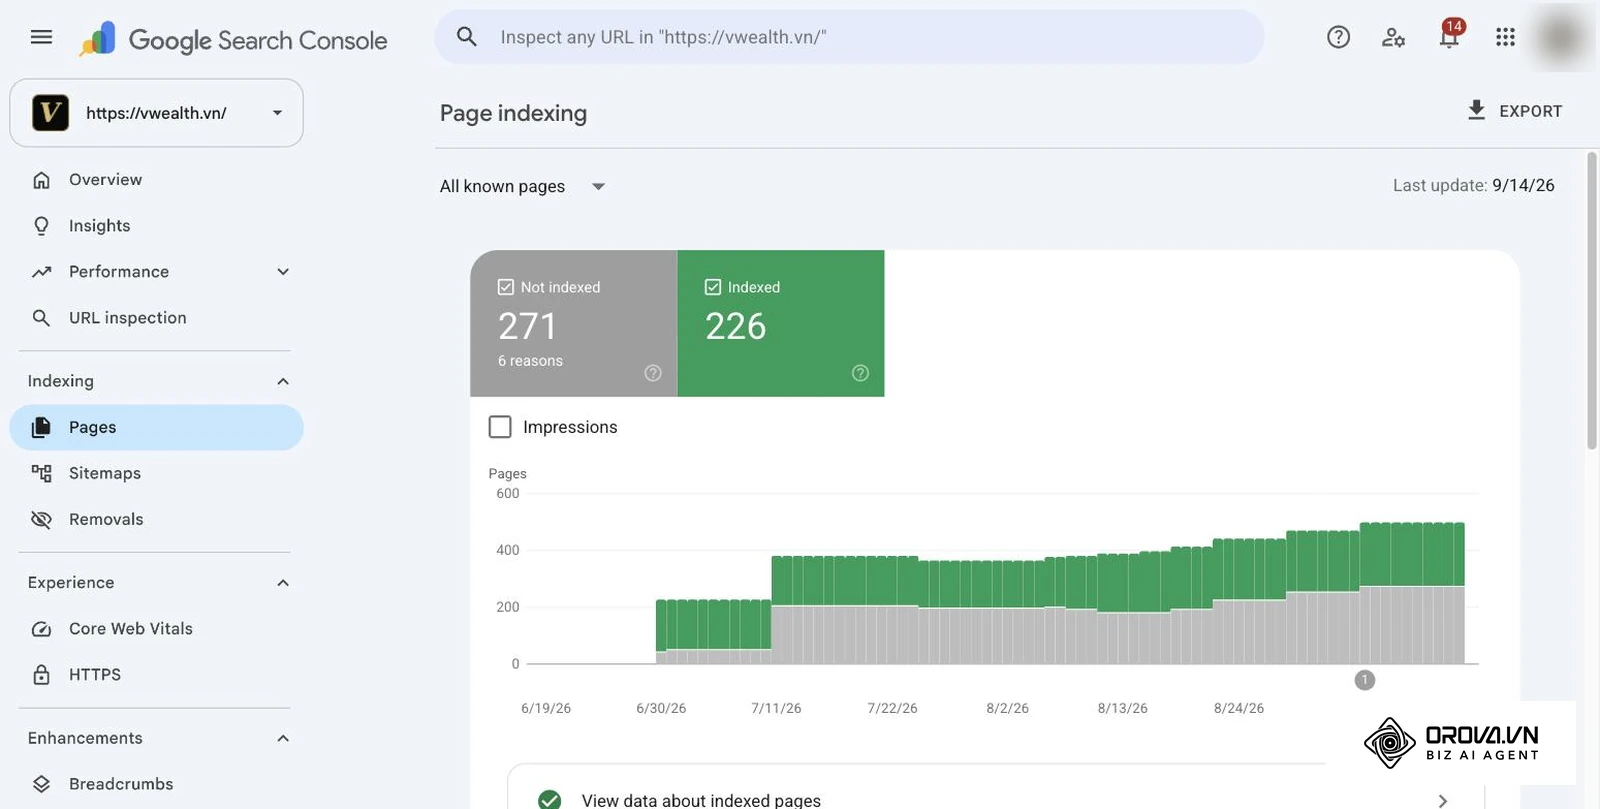
ឈ្មោះនៃមុខងារនេះមានប្រភពចេញ ពីប្រព័ន្ធ Google Search Console ដែលកាលពីមុនត្រូវបានគេស្គាល់ថាជា Google Webmaster Tools។ នៅក្នុងឧបករណ៍នេះរបាយការណ៍ Page Indexing ផ្តល់នូវទិដ្ឋភាពទូទៅនៃទំព័រទាំងអស់ ដែល Googlebot បានជួបប្រទះនៅលើគេហទំព័ររបស់អ្នក ដោយបែងចែករវាងទំព័រ ដែលបានចុះបញ្ជីរួចរាល់ និងទំព័រដែលមិនទាន់ត្រូវបានធ្វើលិបិក្រម ដោយសារមូលហេតុបច្ចេកទេស ឬគុណភាព។
| គោលគំនិត | ភាពខុសគ្នាសំខាន់ | ឧទាហរណ៍ជាក់ស្តែង |
|---|---|---|
| Crawling (ការប្រមូលទិន្នន័យ) | Googlebot រកឃើញនិងទាញយកកូដ HTML រូបភាពនិងឯកសារ ពីម៉ាស៊ីនមេគេហទំព័រ។ | Googlebot ចូលអាន URL អត្ថបទថ្មីរបស់អ្នកនៅម៉ោង ២ រសៀល។ |
| Indexing (ការធ្វើលិបិក្រម) | Google វិភាគខ្លឹមសារអត្ថន័យ និងរក្សាទុកទិន្នន័យទំព័រចូលក្នុងឃ្លាំងទិន្នន័យ Search Index។ | ទំព័រត្រូវបានរក្សាទុក ក្នុងឃ្លាំងទិន្នន័យរបស់ Google និងត្រៀមបង្ហាញ។ |
| Ranking (ចំណាត់ថ្នាក់) | ក្បួនដោះស្រាយវាយតម្លៃ និងរៀបចំលំដាប់ទំព័រ ដែលសមស្របបំផុត សម្រាប់សំណួរស្វែងរក។ | ទំព័ររបស់អ្នកទទួលបានចំណាត់ថ្នាក់លេខ ៣ សម្រាប់ពាក្យគន្លឹះគោលដៅ។ |
ដើម្បីងាយស្រួលស្រមើស្រមៃអ្នកអាចប្រៀបធៀបដំណើរការនេះទៅនឹងបណ្ណាល័យសាធារណៈដ៏ធំមួយ។ ដំណើរការ Crawling ប្រៀបដូចជាបណ្ណារក្សធ្វើដំណើរទៅកាន់រោងពុម្ពនានា ដើម្បីប្រមូលសៀវភៅថ្មីៗយកមកកាន់បណ្ណាល័យ។ ដំណើរការ Indexing គឺជាពេលដែលបណ្ណារក្សអានចំណងជើងពិនិត្យខ្លឹមសារចាត់ថ្នាក់ប្រភេទ និងកត់ត្រាលេខកូដសៀវភៅនោះចូលទៅក្នុងកាតាឡុកប្រព័ន្ធទិន្នន័យ ដើម្បីឱ្យអ្នកអានអាចស្វែងរកឃើញ។ ចំណែកឯ Ranking គឺជាការសម្រេចចិត្តរបស់បណ្ណារក្សថាតើសៀវភៅណាខ្លះ ដែលគួរដាក់តាំងបង្ហាញនៅធ្នើមុខគេបង្អស់ ដើម្បីឱ្យមនុស្សមើលឃើញភ្លាមៗនៅពេលពួកគេដើរចូលមកសួររកប្រធានបទនោះ។ បើសៀវភៅមិនត្រូវបានចុះឈ្មោះ ក្នុងកាតាឡុកទេនោះគ្មានអ្នកអានណាអាចរកវាឃើញឡើយ។
អត្ថន័យនិងសារៈសំខាន់នៃ Google Search Console indexing ក្នុងយុទ្ធសាស្ត្រ SEO
Google Search Console indexing ដើរតួជាស្ពានចម្លងដ៏សំខាន់រវាងគេហទំព័ររបស់អ្នក និងអ្នកប្រើប្រាស់រាប់លាននាក់លើ Google Search។ វាដោះស្រាយបញ្ហាភាពងងឹតងងល់របស់អ្នកគ្រប់គ្រងគេហទំព័រ និងអ្នកជំនាញ SEO ដែលតែងតែឆ្ងល់ថាហេតុអ្វីបានជាមាតិកា ដែលខិតខំសរសេរមិន ដែលទទួលបានការចូលមើលសូម្បីតែម្តង។ ប្រសិនបើគ្មានរបាយការណ៍នេះទេអ្នកនឹងមិនអាចដឹងបានឡើយថាតើបញ្ហាកើតឡើង ដោយសារម៉ាស៊ីនមេបិទការតភ្ជាប់ស្លាកកូដរារាំង ឬមកពីក្បួនដោះស្រាយវាយតម្លៃថាខ្លឹមសារគ្មានគុណភាពគ្រប់គ្រាន់។
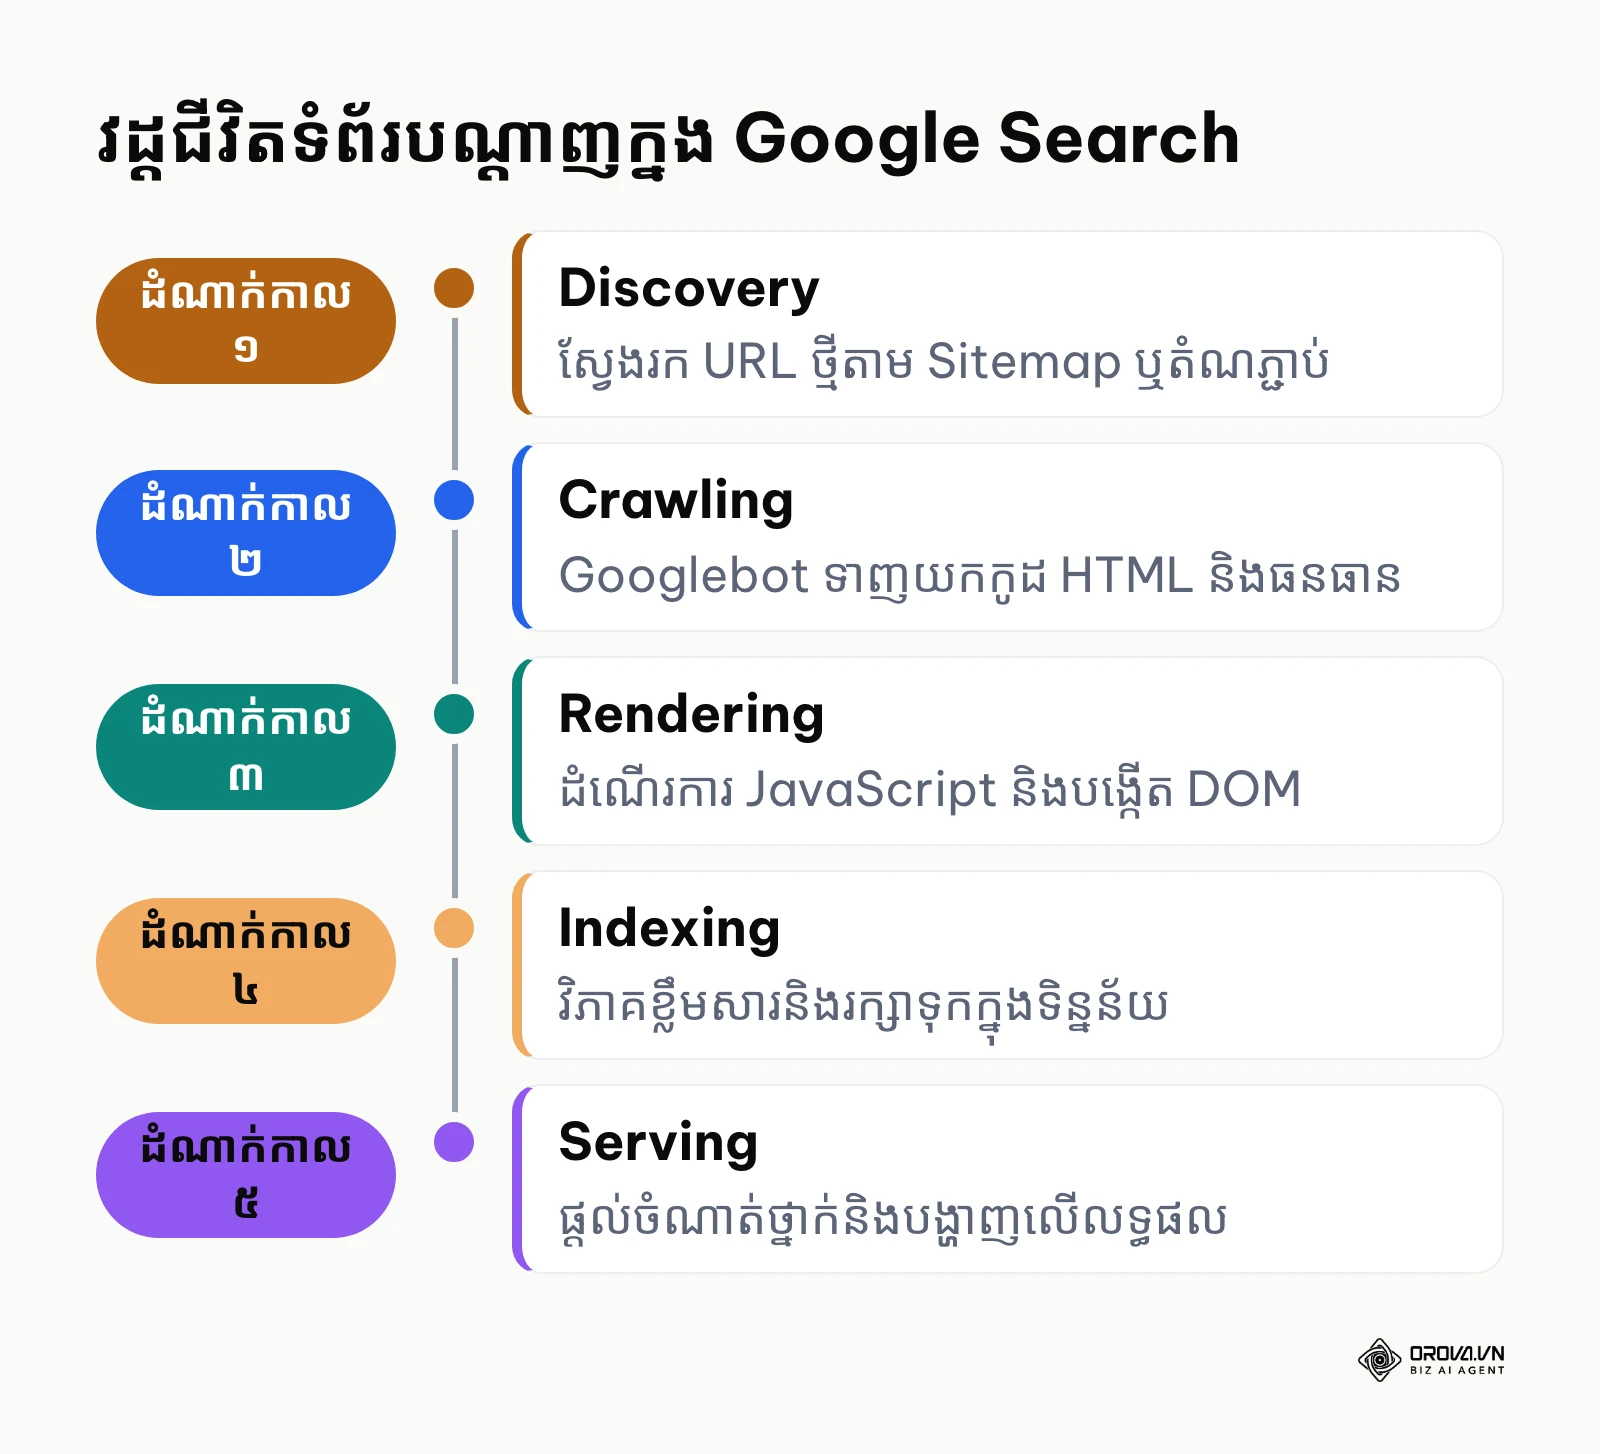
នៅក្នុងប្រព័ន្ធអេកូឡូស៊ីស្វែងរកទាំងមូលដំណើរការនេះស្ថិតនៅចំកណ្តាលនៃវដ្តជីវិតមាតិកា។ ដំណាក់កាលដំបូងចាប់ផ្តើម ពី Discovery (ការរកឃើញ URL ថ្មីតាមរយៈ Sitemap ឬតំណភ្ជាប់) បន្ទាប់មកឈានចូលដល់ Crawling (ការទាញយកកូដ) និង Rendering (ការដំណើរការកូដ JavaScript)។ បន្ទាប់ពីដំណាក់កាលទាំងនេះទើបឈានដល់ Indexing (ការវិភាគនិងរក្សាទុក)។ លុះត្រាតែទំព័រឆ្លងកាត់ការ Indexing ជោគជ័យទើបវាមានសិទ្ធិចូលរួម ក្នុងដំណាក់កាល Ranking (ការប្រកួតប្រជែងដណ្តើមចំណាត់ថ្នាក់) និង Serving (ការបង្ហាញជូនអ្នកស្វែងរក)។ ការយល់ច្បាស់ពី របៀបប្រើ Google Search Console ជួយឱ្យអ្នកគ្រប់គ្រងគេហទំព័រតាមដានដំណើរការនេះបានត្រឹមត្រូវគ្រប់ជំហាន។
យោងតាមឯកសារ Documentation on Crawling and Indexing របស់ Google Search Central ចេញផ្សាយឆ្នាំ 2024 ដំណើរការស្វែងរករបស់ Google ត្រូវបានបែងចែកជា ៣ ដំណាក់កាលដាច់ដោយឡែក ពីគ្នាគឺ Crawling, Indexing និង Serving។ ប្រសិនបើអ្នកមើលរំលង Google Search Console indexing ផលវិបាកដែលត្រូវបង់ថ្លៃ គឺធ្ងន់ធ្ងរខ្លាំង។ គេហទំព័ររបស់អ្នកនឹងបាត់បង់ទស្សនវិស័យទាំងស្រុងលើ Google ចរាចរណ៍សរីរាង្គ (Organic Traffic) ធ្លាក់ចុះដល់សូន្យ ហើយថវិការាប់ពាន់ដុល្លារ ដែលបានចំណាយលើការផលិតមាតិកានឹងក្លាយជាការខ្ជះខ្ជាយ។ លើសពីនេះនៅពេលគេហទំព័រផ្លាស់ប្តូររចនាសម្ព័ន្ធ (Site Migration) ឬប្តូរប្រព័ន្ធគ្រប់គ្រងមាតិកា (CMS) អ្នកនឹងមិនអាចដឹងទាន់ពេលទេថាតើទំព័ររកចំណូលសំខាន់ៗបានធ្លាក់ចេញ ពីប្រព័ន្ធ Google តាំងពីពេលណា។ ដ្យាក្រាមខាងក្រោមសង្ខេបវដ្តជីវិតទំព័របណ្ដាញ ក្នុង Google Search ពីការស្វែងរកដំបូងរហូតដល់ការបង្ហាញលើលទ្ធផលស្វែងរក។
ពេលណាដែលមិនទាន់ត្រូវការ Google Search Console indexing
មាន ៣ ករណីជាក់លាក់ដែលអ្នកមិនទាន់ត្រូវការ Google Search Console indexing ព្រោះអាចខ្ជះខ្ជាយពេលវេលា។ ទីមួយគឺបរិស្ថានសាកល្បងកូដ (Staging Environment) សម្រាប់អ្នកបច្ចេកទេស។ ទីពីរគឺទំព័រចុះចត (Landing Page) នៃយុទ្ធនាការផ្សាយពាណិជ្ជកម្មរយៈពេលខ្លី ដែលពឹងលើចរាចរណ៍បង់ប្រាក់។ ទីបីគឺទំព័រផ្ទៃក្នុងរបស់បុគ្គលិក ឬគណនីអតិថិជន។ ក្នុងករណីទាំងនេះអ្នកគួរប្រើស្លាក noindex ឬ robots.txt ដើម្បីទប់ស្កាត់ជាជាងតាមដានលិបិក្រម។
តម្លៃនិងអត្ថប្រយោជន៍ជាក់ស្តែងនៃ Google Search Console indexing
ការវិនិយោគពេលវេលាលើការស្វែងយល់ និងតាមដាន Google Search Console indexing ផ្តល់នូវផលចំណេញជាក់ស្តែងជា ពីរផ្នែកធំៗ គឺតម្លៃយុទ្ធសាស្ត្រ សម្រាប់អាជីវកម្ម និងអត្ថប្រយោជន៍ប្រតិបត្តិការប្រចាំថ្ងៃ សម្រាប់អ្នកបច្ចេកទេស។
តម្លៃសម្រាប់អាជីវកម្ម៖ ការពារហានិភ័យនិងពង្រីកប្រាក់ចំណូល
សម្រាប់ម្ចាស់អាជីវកម្ម និងអ្នកគ្រប់គ្រងទីផ្សាររបាយការណ៍លិបិក្រម គឺជាឧបករណ៍ការពារប្រាក់ចំណូល និងកាត់បន្ថយហានិភ័យបច្ចេកទេស។ ប្រសិនបើគេហទំព័រពាណិជ្ជកម្មអេឡិចត្រូនិកមានទំព័រផលិតផលរាប់ពាន់ ប៉ុន្តែទំព័រទាំងនោះមិនត្រូវបាន Google ទទួលស្គាល់នោះឱកាសលក់នឹងបាត់បង់ទាំងស្រុង។
តារាងខាងក្រោមប្រៀបធៀបស្ថានភាពអាជីវកម្មមុន និងក្រោយពេលគ្រប់គ្រងលិបិក្រមជាប្រព័ន្ធ៖
| ចំណុចប្រៀបធៀប | មុនពេលគ្រប់គ្រង | ក្រោយពេលគ្រប់គ្រង |
|---|---|---|
| ថវិកាមាតិកា | ចំណាយបង្កើតអត្ថបទរាប់រយ ក្នុងមួយខែ ប៉ុន្តែមិនដឹងថាអត្ថបទប៉ុន្មានពិតជាចូលក្នុងលិបិក្រម | ដឹងច្បាស់ថាទំព័រណាត្រូវបានចុះបញ្ជី និងទំព័រណាត្រូវកែ |
| ទំព័ររកចំណូល | ទំព័រលក់សំខាន់ៗអាចជាប់គាំង ដោយគ្មានអ្នកដឹង | កំណត់អត្តសញ្ញាណទំព័ររកចំណូលខ្ពស់ ហើយតាមដានឱ្យចូលលិបិក្រមលឿនជាងមុន |
| ពេលកែកូដគេហទំព័រ | ចរាចរណ៍អាចធ្លាក់ភ្លាមៗដោយមិនដឹងមូលហេតុ | ឃើញកំហុសថ្មីក្នុងរបាយការណ៍ Page Indexing ទាន់ពេល |
ឧទាហរណ៍បង្ហាញ (ករណីសន្មត)៖ បរិបទគឺគេហទំព័រពាណិជ្ជកម្មអេឡិចត្រូនិចខ្នាតមធ្យម ដែលមានទំព័រផលិតផលជាង ៥០០ ទំព័រនិងអ្នកគ្រប់គ្រងគេហទំព័រម្នាក់។ ជំហានអនុវត្តរួមមានការបើករបាយការណ៍ Page Indexing, រកឃើញទំព័រផលិតផលថ្មី ៨០ ទំព័រមិនទាន់ត្រូវបានធ្វើលិបិក្រម, បន្ថែម XML Sitemap ឡើងវិញនិងដាក់តំណភ្ជាប់ ពីទំព័រប្រភេទផលិតផលមេ (Category Page)។ ចំណុចឧបសគ្គគឺប្រព័ន្ធ CMS បង្កើតប៉ារ៉ាម៉ែត្រ URL ច្រើនពេកធ្វើឱ្យ Googlebot យល់ច្រឡំជាទំព័រស្ទួន ដែលត្រូវបានដោះស្រាយ ដោយការកំណត់ស្លាក canonical ត្រឹមត្រូវនិងទប់ស្កាត់ប៉ារ៉ាម៉ែត្រមិនចាំបាច់ ក្នុង robots.txt។ លទ្ធផលដែលអាចមើលឃើញបាន គឺក្នុងរយៈពេល ៥ ថ្ងៃ URL ផលិតផលទាំង ៨០ ត្រូវបានប្តូរទៅជាស្ថានភាព Indexed ក្នុង Google Search Console ហើយចាប់ផ្តើមបង្ហាញការចុចចូល (Clicks) ជាក់ស្តែងក្នុងផ្ទាំង Performance។
អត្ថប្រយោជន៍សម្រាប់អ្នកអនុវត្តបច្ចេកទេសផ្ទាល់
សម្រាប់អ្នកធ្វើការផ្ទាល់ដូចជាអ្នកគ្រប់គ្រងគេហទំព័រ ឬអ្នកជំនាញ SEO របាយការណ៍លិបិក្រមផ្តល់នូវភស្តុតាងជាក់ស្តែងជំនួសឱ្យការទស្សន៍ទាយ។ កាលពីមុនអ្នកអនុវត្តបច្ចេកទេសត្រូវចំណាយពេលច្រើនថ្ងៃ ដើម្បីរុករកបញ្ហា តាមរយៈ seo tools ផ្សេងៗដោយមិនដឹងថាតើ Googlebot ពិតជាគិតយ៉ាងណាចំពោះគេហទំព័រ។ ក្រោយពេលប្រើប្រាស់របាយការណ៍ Page Indexing ពួកគេអាចដឹងភ្លាមៗនូវកំហុសបច្ចេកទេសដូចជា 404 Not Found, កំហុស Redirect ឬទំព័រដែលត្រូវបានទប់ស្កាត់ ដោយមិនដឹងខ្លួន។
| អត្ថប្រយោជន៍ជាក់ស្តែង | សន្ទស្សន៍វាស់វែង (KPI) | រយៈពេលមើលឃើញលទ្ធផល |
|---|---|---|
| បង្កើនល្បឿនចុះបញ្ជីទំព័រថ្មី | រយៈពេលចាប់ពីបោះផ្សាយដល់ Indexed | ពី ៤៨ ម៉ោងទៅ ៥ ថ្ងៃ |
| ការពារការបាត់បង់ចរាចរណ៍ | អត្រាទំព័រមានកំហុស (Error URLs) ថយចុះក្រោម ២% | ពី ១ ទៅ ២ សប្តាហ៍ |
| បង្កើនប្រសិទ្ធភាព Crawl Budget | ចំនួនទំព័រស្កេនជោគជ័យ ក្នុង Crawl Stats | ពី ២ ទៅ ៤ សប្តាហ៍ |
| ពង្រីកទស្សនវិស័យស្វែងរក | ចំនួនចំណាប់អារម្មណ៍ (Impressions) សរុប | ពី ៣ ទៅ ៦ សប្តាហ៍ |
ស្វែងយល់អំពី Orova.vn – វេទិកា Biz AI Agent ជាមួយដំណោះស្រាយ OROVA SEO ពេញលេញសម្រាប់គេហទំព័រទាំងអស់។ ប្រព័ន្ធនេះជួយបង្កើនប្រសិទ្ធភាពម៉ាស៊ីនស្វែងរកពី A ដល់ Z ជាមួយមុខងារ៖ ការស្រាវជ្រាវពាក្យគន្លឹះ ការសរសេរអត្ថបទថ្មីតាមស្តង់ដារ SEO ការបង្កើនប្រសិទ្ធភាពខ្លឹមសារចាស់ ការតាមដានចំណាត់ថ្នាក់ ព្រមទាំងសមត្ថភាពវិភាគគូប្រកួត និងវិភាគបច្ចេកទេសស៊ីជម្រៅ។ ចុះឈ្មោះថ្ងៃនេះដើម្បីប្រើប្រាស់ OROVA SEO ដោយឥតគិតថ្លៃទាំងស្រុង (ការផ្តល់ជូននេះមានសុពលភាពដល់ថ្ងៃទី ៧ ខែកក្កដា ឆ្នាំ ២០២៧)។
របៀបដំណើរការនៃ Google Search Console indexing និងកាយវិភាគបច្ចេកទេស
ដើម្បីដោះស្រាយបញ្ហាលិបិក្រមឱ្យមានប្រសិទ្ធភាពអ្នកត្រូវយល់ឱ្យស៊ីជម្រៅអំពីកាយវិភាគបច្ចេកទេសនៃប្រព័ន្ធ Google Search Console និងយន្តការខាងក្នុងរបស់ Googlebot។
កាយវិភាគបច្ចេកទេសនៃប្រព័ន្ធធ្វើលិបិក្រម Google
ប្រព័ន្ធដំណើរការលិបិក្រមរបស់ Google រួមមាន ៣ សមាសភាគសំខាន់ដែលដំណើរការជាបន្តបន្ទាប់គ្នា៖
- សមាសភាគ URL Discovery & Crawl Queue៖
- មុខងារ៖ ស្វែងរក URL ថ្មីៗតាមរយៈ XML Sitemap តំណភ្ជាប់ផ្ទៃក្នុង ឬតំណភ្ជាប់ពីខាងក្រៅរួចបញ្ចូលទៅក្នុងជួររង់ចាំ (Crawl Queue)។
- ធាតុចូល៖ អាសយដ្ឋាន URL ថ្មីឬ URL ចាស់ដែលទើបតែធ្វើបច្ចុប្បន្នភាព។
- លទ្ធផលចេញ៖ បញ្ជី URL ដែលត្រូវបានកំណត់អាទិភាព ដើម្បីឱ្យ Googlebot ចុះទៅប្រមូលទិន្នន័យ។
- ចំណុចងាយខូច៖ ការរៀបចំឯកសារ robots.txt ខុសបច្ចេកទេសឬបញ្ហាម៉ាស៊ីនមេឆ្លើយតបយឺត (Server Timeout) ធ្វើឱ្យ Googlebot មិនអាចទាញយកទំព័របាន។
- សមាសភាគ Parsing & JavaScript Rendering៖
- មុខងារ៖ ដំណើរការកូដ HTML, CSS និងទាញយកធនធាន JavaScript ដើម្បីបង្កើតជាគំរូ Document Object Model (DOM) ពេញលេញដូចដែលអ្នកប្រើប្រាស់មើលឃើញ។
- ធាតុចូល៖ កូដឆៅ (Raw HTML) និងឯកសារ JavaScript ពីម៉ាស៊ីនមេ។
- លទ្ធផលចេញ៖ ទំព័រដែលបាន Render រួចរាល់ (Rendered HTML) ត្រៀមសម្រាប់ការវិភាគអត្ថន័យ។
- ចំណុចងាយខូច៖ កូដ JavaScript ស្មុគស្មាញពេកឬ API ដំណើរការយឺតបណ្តាលឱ្យ Googlebot ផ្ដាច់ការ Render មុនពេលខ្លឹមសារសំខាន់បង្ហាញ។
- សមាសភាគ Indexing Pipeline & Quality Scoring៖
- មុខងារ៖ វិភាគអត្ថបទរូបភាពស្លាករចនាសម្ព័ន្ធ និងវាយតម្លៃគុណភាពមាតិកា ដើម្បីសម្រេចថាតើត្រូវរក្សាទុកទំព័រនោះ ក្នុង Search Index ឬអត់។
- ធាតុចូល៖ Rendered HTML និងសញ្ញាគុណភាព (Quality Signals)។
- លទ្ធផលចេញ៖ ស្ថានភាពទំព័រដែលបានចុះបញ្ជី (Indexed) ឬមិនបានចុះបញ្ជី (Not Indexed) ក្នុង Google Search Console។
- ចំណុចងាយខូច៖ មាតិកាស្ទួន (Duplicate Content), កង្វះតម្លៃបន្ថែម (Low Information Gain) ឬការកំណត់ស្លាក Canonical មិនត្រឹមត្រូវ។
ក្របខ័ណ្ឌ Triage Framework៖ ការកំណត់អាទិភាពដោះស្រាយកំហុស Indexing
នៅពេលបើករបាយការណ៍ Page Indexing អ្នកគ្រប់គ្រងគេហទំព័រច្រើនតែមានការភិតភ័យ នៅពេលឃើញ URL រាប់ពាន់ត្រូវបានចាត់ចូលក្នុងបញ្ជី Not Indexed។ ការព្យាយាមកែប្រែគ្រប់ URL ដោយគ្មានទិសដៅគឺជាការខ្ជះខ្ជាយធនធានយ៉ាងធំធេង។ ក្របខ័ណ្ឌ Triage Framework បែងចែកកំហុសជា ៣ កម្រិតអាទិភាពតាមផលប៉ះពាល់អាជីវកម្ម។ ដ្យាក្រាមខាងក្រោមសង្ខេបម៉ាទ្រីសកំណត់អាទិភាពដោះស្រាយកំហុស Indexing តាមកម្រិតផលប៉ះពាល់ និងការខិតខំប្រឹងប្រែង។
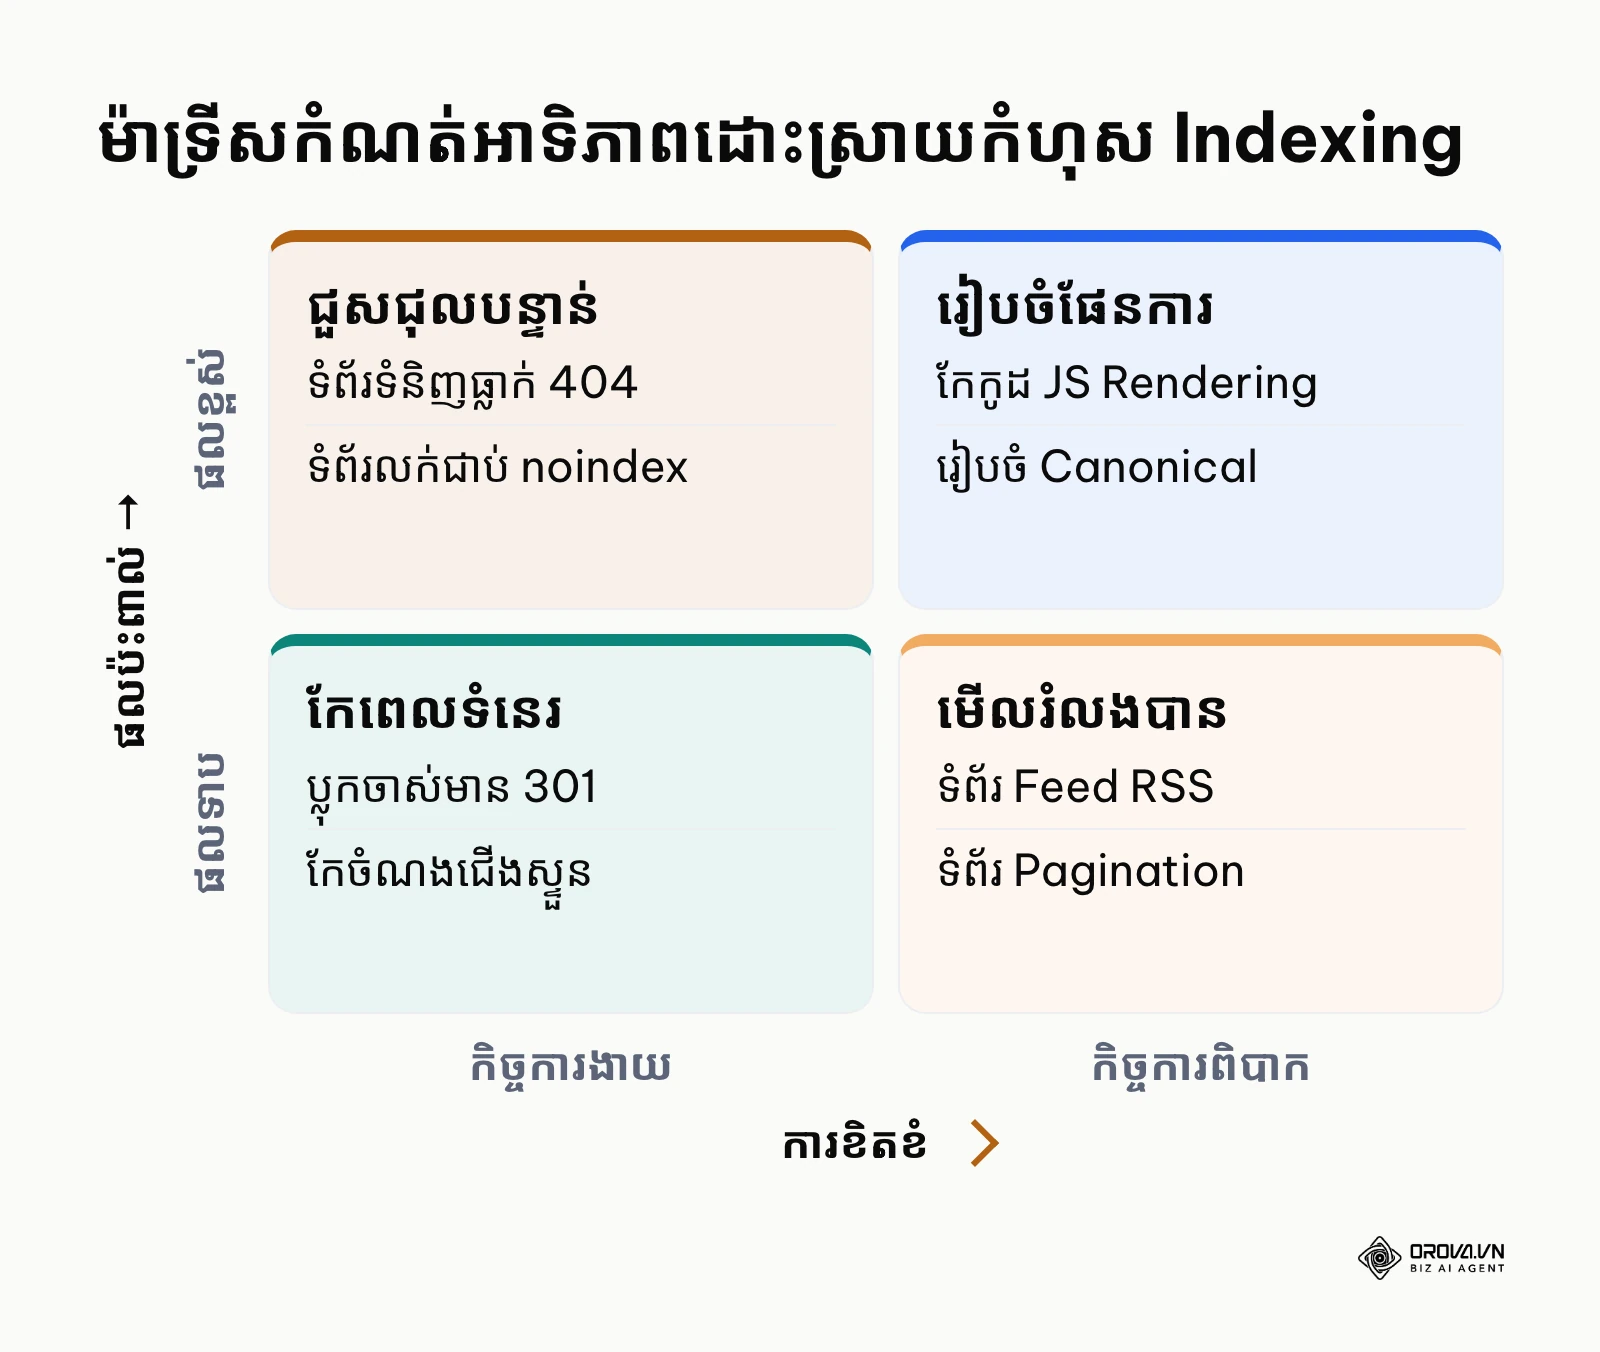
កម្រិតទី ១៖ កំហុសបន្ទាន់ (Critical Errors)។ នេះជាកំហុសដែលប៉ះពាល់ផ្ទាល់ដល់ទំព័ររកប្រាក់ចំណូលដូចជាទំព័រផលិតផលទំព័រសេវាកម្ម ឬទំព័រ Landing Page សំខាន់ៗ។ កំហុសក្នុងក្រុមនេះរួមមាន Server Error (5xx), ទំព័រលក់សំខាន់ ដែលច្រឡំដាក់ noindex, ឬទំព័រដែលធ្លាក់ចូលក្នុង 404 Not Found។ អ្នកត្រូវតែដោះស្រាយបញ្ហាទាំងនេះភ្លាមៗក្នុងរយៈពេល ២៤ ម៉ោង។
កម្រិតទី ២៖ កំហុសធម្មតា (Normal Optimization)។ ក្រុមនេះរួមមានបញ្ហា Canonical មិនស៊ីសង្វាក់គ្នា, ទំព័រមានកំហុស Redirect ច្រើនតង់, ឬបញ្ហា JavaScript Rendering យឺត។ កំហុសទាំងនេះមិន ធ្វើឱ្យគេហទំព័រដួលរលំទេ ប៉ុន្តែវាបន្ថយល្បឿននៃការកើនឡើងចំណាត់ថ្នាក់។ អ្នកគួររៀបចំផែនការកែសម្រួល ក្នុងរយៈពេលពី ១ ទៅ ២ សប្តាហ៍។
កម្រិតទី ៣៖ កំហុសអាចមើលរំលងបាន (Safe to Ignore)។ ស្ថានភាពជាច្រើន ក្នុងរបាយការណ៍ គឺជាដំណើរការធម្មជាតិនៃប្រព័ន្ធស្វែងរក។ ឧទាហរណ៍ដូចជាទំព័រ Feed RSS, ទំព័រ Pagination (ទំព័រលេខ ២, លេខ ៣ នៃបញ្ជីអត្ថបទ), ទំព័រដែលបិទ noindex ដោយចេតនា, ឬ URL ចាស់ៗដែលបានលុបចោលជាអចិន្ត្រៃយ៍។ អ្នកមិនចាំបាច់ចំណាយពេលកែប្រែបញ្ហាទាំងនេះឡើយ។
ការវិភាគ Crawled Not Indexed និង Discovered Not Indexed
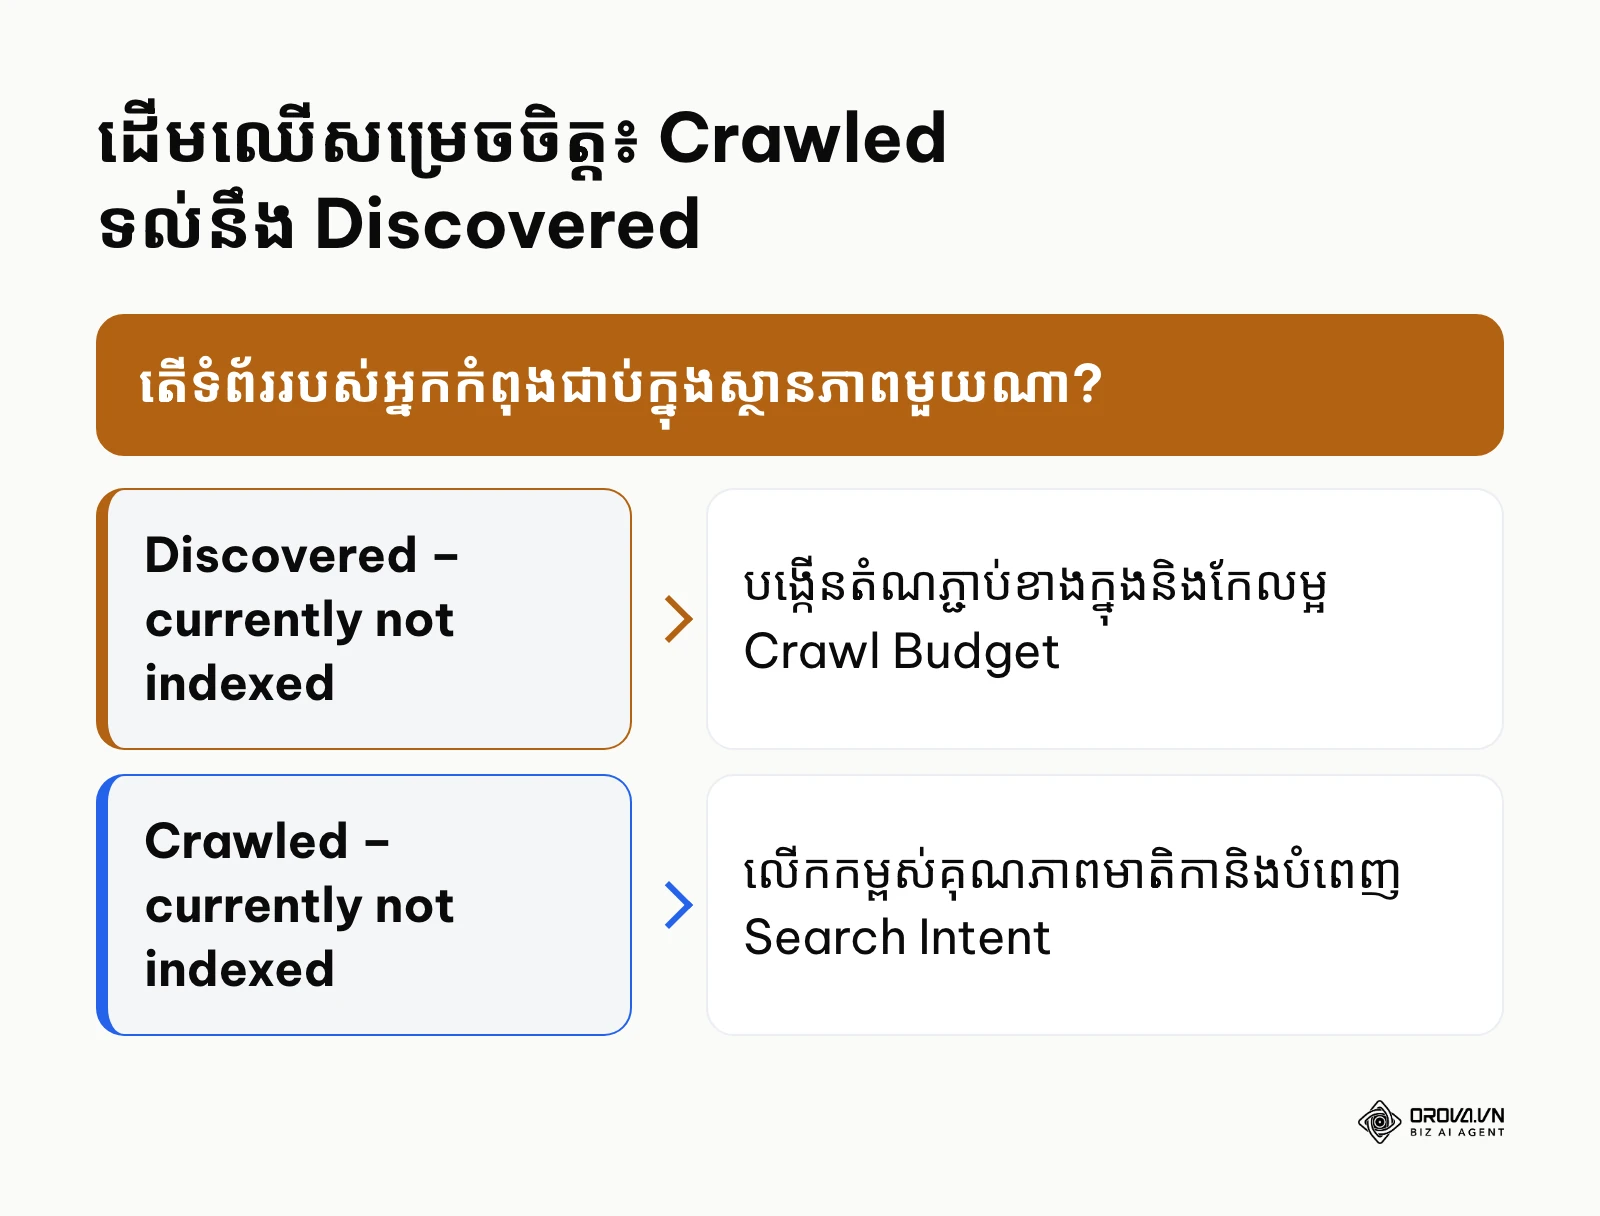
បញ្ហាដែលបង្កការឈឺក្បាលបំផុត សម្រាប់អ្នកធ្វើ SEO គឺស្ថានភាពពីរដែលមើលទៅស្រដៀងគ្នា ប៉ុន្តែមានដើមហេតុបច្ចេកទេសខុសគ្នាស្រឡះ គឺ Crawled – currently not indexed និង Discovered – currently not indexed។ ដ្យាក្រាមខាងក្រោមសង្ខេបដើមឈើសម្រេចចិត្ត ដើម្បីកំណត់ទិសដៅដោះស្រាយរវាងស្ថានភាព Crawled និង Discovered។
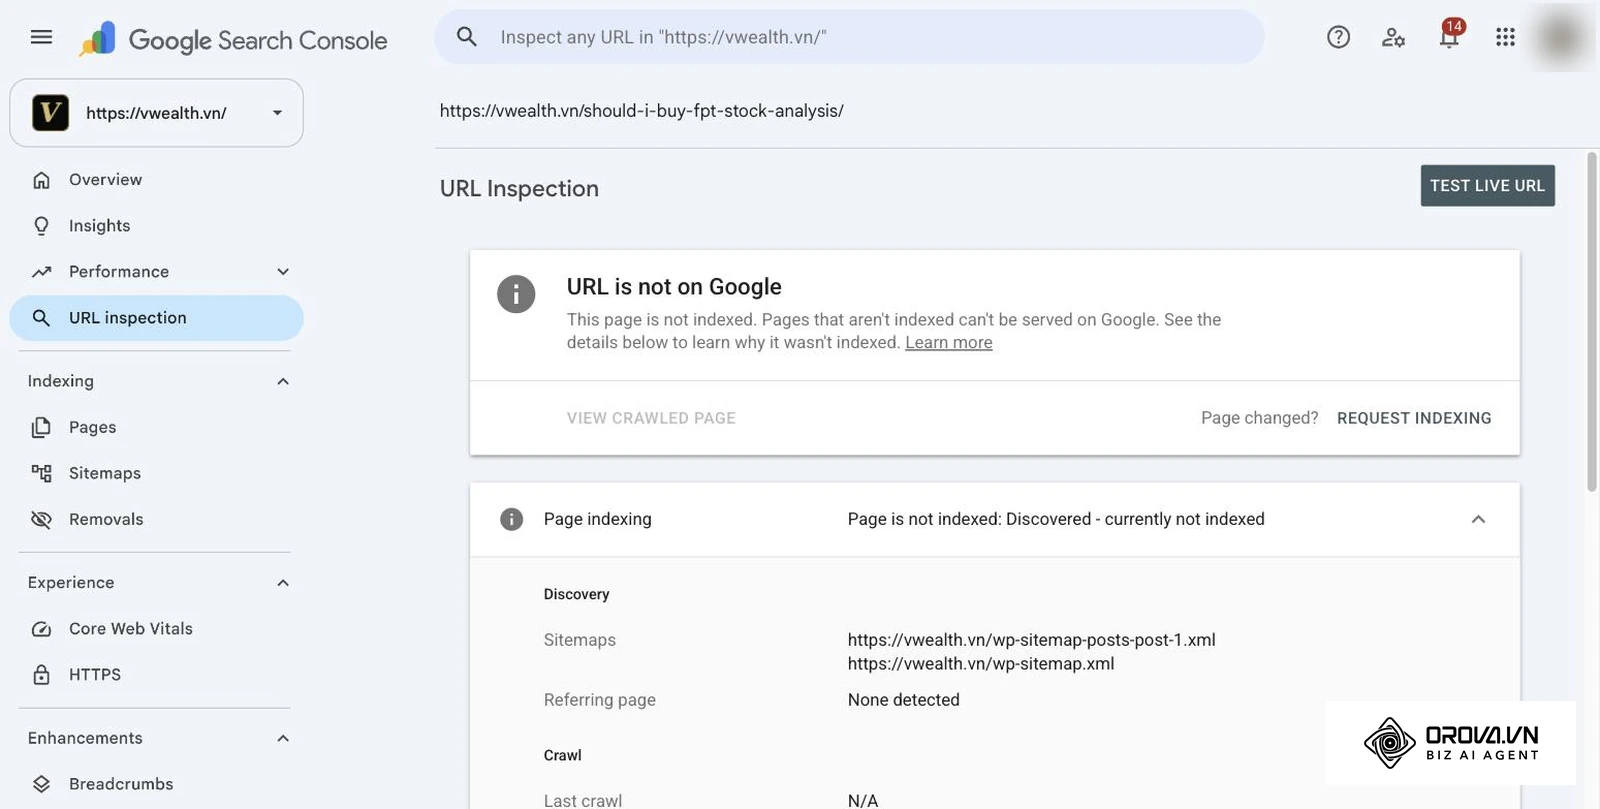
ស្ថានភាព Discovered – currently not indexed មានន័យថា Google ដឹងថា URL នោះមានវត្តមាន (តាមរយៈ Sitemap ឬតំណភ្ជាប់ដែល Googlebot បានឃើញ) ប៉ុន្តែ Googlebot មិនទាន់បានចូលទៅអាន ឬទាញយកទិន្នន័យនៅឡើយទេ។ មូលហេតុចម្បងគឺ ដោយសារម៉ាស៊ីនមេរបស់អ្នកផ្ទុកលើសទម្ងន់ (Server Overload) ឬគេហទំព័ររបស់អ្នកមាន Crawl Budget កម្រិតទាបធ្វើឱ្យ Googlebot ត្រូវកំណត់អាទិភាពស្កេនទំព័រផ្សេងទៀតសិន។ ដំណោះស្រាយសម្រាប់ស្ថានភាពនេះ គឺការបង្កើនល្បឿនម៉ាស៊ីនមេ និងការបង្កើតតំណភ្ជាប់ផ្ទៃក្នុងរឹងមាំ ពីទំព័រមេ។
ផ្ទុយទៅវិញស្ថានភាព Crawled – currently not indexed មានន័យថា Googlebot បានចូលទៅកាន់ទំព័របានទាញយកកូដបានពិនិត្យខ្លឹមសាររួចរាល់ ហើយ ប៉ុន្តែសម្រេចចិត្តមិនបញ្ចូលទំព័រនោះទៅក្នុងលិបិក្រមឡើយ។ នេះគឺជាសញ្ញាព្រមានអំពីគុណភាពមាតិកា។ Google វាយតម្លៃថាទំព័រនោះខ្វះភាពស៊ីជម្រៅមានខ្លឹមសារស្ទួន ឬមិនទាន់ឆ្លើយតបត្រូវនឹងបំណងរបស់អ្នកស្វែងរក (Search Intent)។
Google មិនធានាថារាល់ទំព័រ ដែលខ្លួនបានស្កេននឹងត្រូវបញ្ចូលក្នុងលិបិក្រមនោះទេ។ ទំព័រដែលផ្តល់តម្លៃជាក់ស្តែង និងខុសពីទំព័រដែលមានស្រាប់មានឱកាសខ្ពស់ជាង ក្នុងការត្រូវបានរក្សាទុក។
ឧទាហរណ៍បង្ហាញ (ករណីសន្មត)៖ បរិបទគឺគេហទំព័រប្លុកព័ត៌មានបច្ចេកវិទ្យាខ្នាតតូច ដែលមានអត្ថបទជំនាញចំនួន ៦០ អត្ថបទដំណើរការ ដោយអ្នកនិពន្ធមាតិកាម្នាក់។ ជំហានអនុវត្តរួមមានការពិនិត្យឃើញអត្ថបទស៊ីជម្រៅចំនួន ៥ ធ្លាក់ចូលក្នុងស្ថានភាព Crawled – currently not indexed, ធ្វើការត្រួតពិនិត្យ Search Intent, បន្ថែមទិន្នន័យស្រាវជ្រាវជាក់ស្តែង និងរូបភាពដ្យាក្រាមដើម, រួចភ្ជាប់តំណភ្ជាប់ខាងក្នុងចំនួន ៣ ពីអត្ថបទដែលមានចរាចរណ៍ខ្ពស់បំផុត។ ចំណុចឧបសគ្គគឺដំបូងអត្ថបទមានរចនាសម្ព័ន្ធស្រដៀងនឹងគូប្រជែងខ្លាំងពេកទើប Googlebot វាយតម្លៃថាខ្វះ E-E-A-T ដែលត្រូវបានដោះស្រាយ ដោយការបន្ថែមទស្សនវិស័យអ្នកជំនាញ និងតារាងប្រៀបធៀបជាក់ស្តែងរួចប្រើ URL Inspection ស្នើសុំ Request Indexing។ លទ្ធផលដែលអាចមើលឃើញបាន គឺបន្ទាប់ពី ៧ ថ្ងៃអត្ថបទទាំង ៥ ត្រូវបានបញ្ចូលទៅក្នុងលិបិក្រមពេញលេញ ហើយពាក្យគន្លឹះគោលដៅបានបង្ហាញ ក្នុងទំព័រទី ២ នៃលទ្ធផល Google Search។
បញ្ជីត្រួតពិនិត្យ ៧ ជំហានដើម្បីដោះទំព័រចេញពី Crawled – currently not indexed
ដើម្បីដោះស្រាយបញ្ហា Crawled – currently not indexed ឱ្យបានជាស្ថាពរអ្នកអាចអនុវត្តតាមបញ្ជីត្រួតពិនិត្យ ៧ ជំហានជាក់ស្តែងដូចខាងក្រោម៖
| ជំហាន | អ្វីដែលត្រូវធ្វើ | របៀបអនុវត្ត |
|---|---|---|
| ១ | ពិនិត្យ Search Intent | ធានាថាខ្លឹមសារឆ្លើយតបត្រង់ទៅនឹងសំណួររបស់អ្នកស្វែងរក ដោយមិនសរសេរវាងវៃ ឬខ្វះចំណុចសំខាន់។ |
| ២ | បង្កើនតម្លៃព័ត៌មានបន្ថែម (Information Gain) | បន្ថែមឧទាហរណ៍ជាក់ស្តែងទិន្នន័យស្រាវជ្រាវផ្ទាល់ខ្លួន ឬទស្សនវិស័យអ្នកជំនាញ ដែលគូប្រជែងមិនមាន។ |
| ៣ | បង្កើតតំណភ្ជាប់ផ្ទៃក្នុង (Internal Links) | ដាក់តំណភ្ជាប់យ៉ាងហោចណាស់ ២ ទៅ ៣ ពីទំព័រដែលមានចរាចរណ៍ខ្ពស់ និងមានអំណាចលើគេហទំព័រ។ |
| ៤ | បញ្ចូលកូដទិន្នន័យរចនាសម្ព័ន្ធ | ការប្រើប្រាស់ស្លាក schema markup ត្រឹមត្រូវជួយឱ្យ Googlebot យល់ពីបរិបទនៃអង្គភាព (Entity) និងខ្លឹមសារបានលឿនជាងមុន។ |
| ៥ | ពិនិត្យខ្លឹមសារស្ទួន | លុបបំបាត់អត្ថបទ ដែលស្រដៀងគ្នានៅលើគេហទំព័រ និងកំណត់ស្លាក Canonical ឱ្យបានច្បាស់លាស់។ |
| ៦ | ធ្វើតេស្ត Live URL | ប្រើឧបករណ៍ URL Inspection ដើម្បីពិនិត្យមើលថាតើ Googlebot អាចទាញយកនិង Render ទំព័របានពេញលេញ ឬនៅ។ |
| ៧ | ស្នើសុំ Indexing ឡើងវិញ | ចុចប៊ូតុង Request Indexing ក្នុង Google Search Console ហើយរង់ចាំការធ្វើបច្ចុប្បន្នភាព។ |
ទំនាក់ទំនងរវាង Crawl Stats, Crawl Budget និងល្បឿនធ្វើលិបិក្រម
អ្នកគ្រប់គ្រងគេហទំព័រភាគច្រើនមើលរំលងផ្ទាំង Crawl Stats នៅក្នុងផ្នែក Settings នៃ Search Console។ តាមពិតទៅរបាយការណ៍នេះបង្ហាញ ពីទំនាក់ទំនងផ្ទាល់រវាងធនធានម៉ាស៊ីនមេ និងល្បឿនធ្វើលិបិក្រម។
ប្រសិនបើគេហទំព័ររបស់អ្នកមានការឆ្លើយតបម៉ាស៊ីនមេយឺត (Host Response Time ខ្ពស់) នោះ Googlebot នឹងបន្ថយល្បឿនស្កេនទំព័រ ដោយស្វ័យប្រវត្តិ ដើម្បីកុំឱ្យម៉ាស៊ីនមេរបស់អ្នកគាំង។ ការវិភាគកូដឆ្លើយតប ក្នុង Crawl Stats រួមមាន៖
- កូដ 200 OK៖ បង្ហាញថាការទាញយកដំណើរការធម្មតា។
- កូដ 304 Not Modified៖ ជួយសន្សំ Crawl Budget ព្រោះ Googlebot មិនចាំបាច់ទាញយកទំព័រឡើងវិញបើគ្មានការផ្លាស់ប្តូរ។
- កូដ 404 Not Found៖ កើតឡើងនៅពេលទំព័រមិនមាន។ ប្រសិនបើមានច្រើនពេកវានឹងស៊ី Crawl Budget ដោយឥតប្រយោជន៍។
- កូដ 5xx Server Error៖ គ្រោះថ្នាក់បំផុត! កូដ 5xx ធ្វើឱ្យ Googlebot ដកថយភ្លាមៗ ហើយបញ្ឈប់ការធ្វើលិបិក្រមទំព័រថ្មីៗជាបណ្តោះអាសន្ន។
ផលប៉ះពាល់នៃ JavaScript Rendering និងគោលការណ៍ Helpful Content
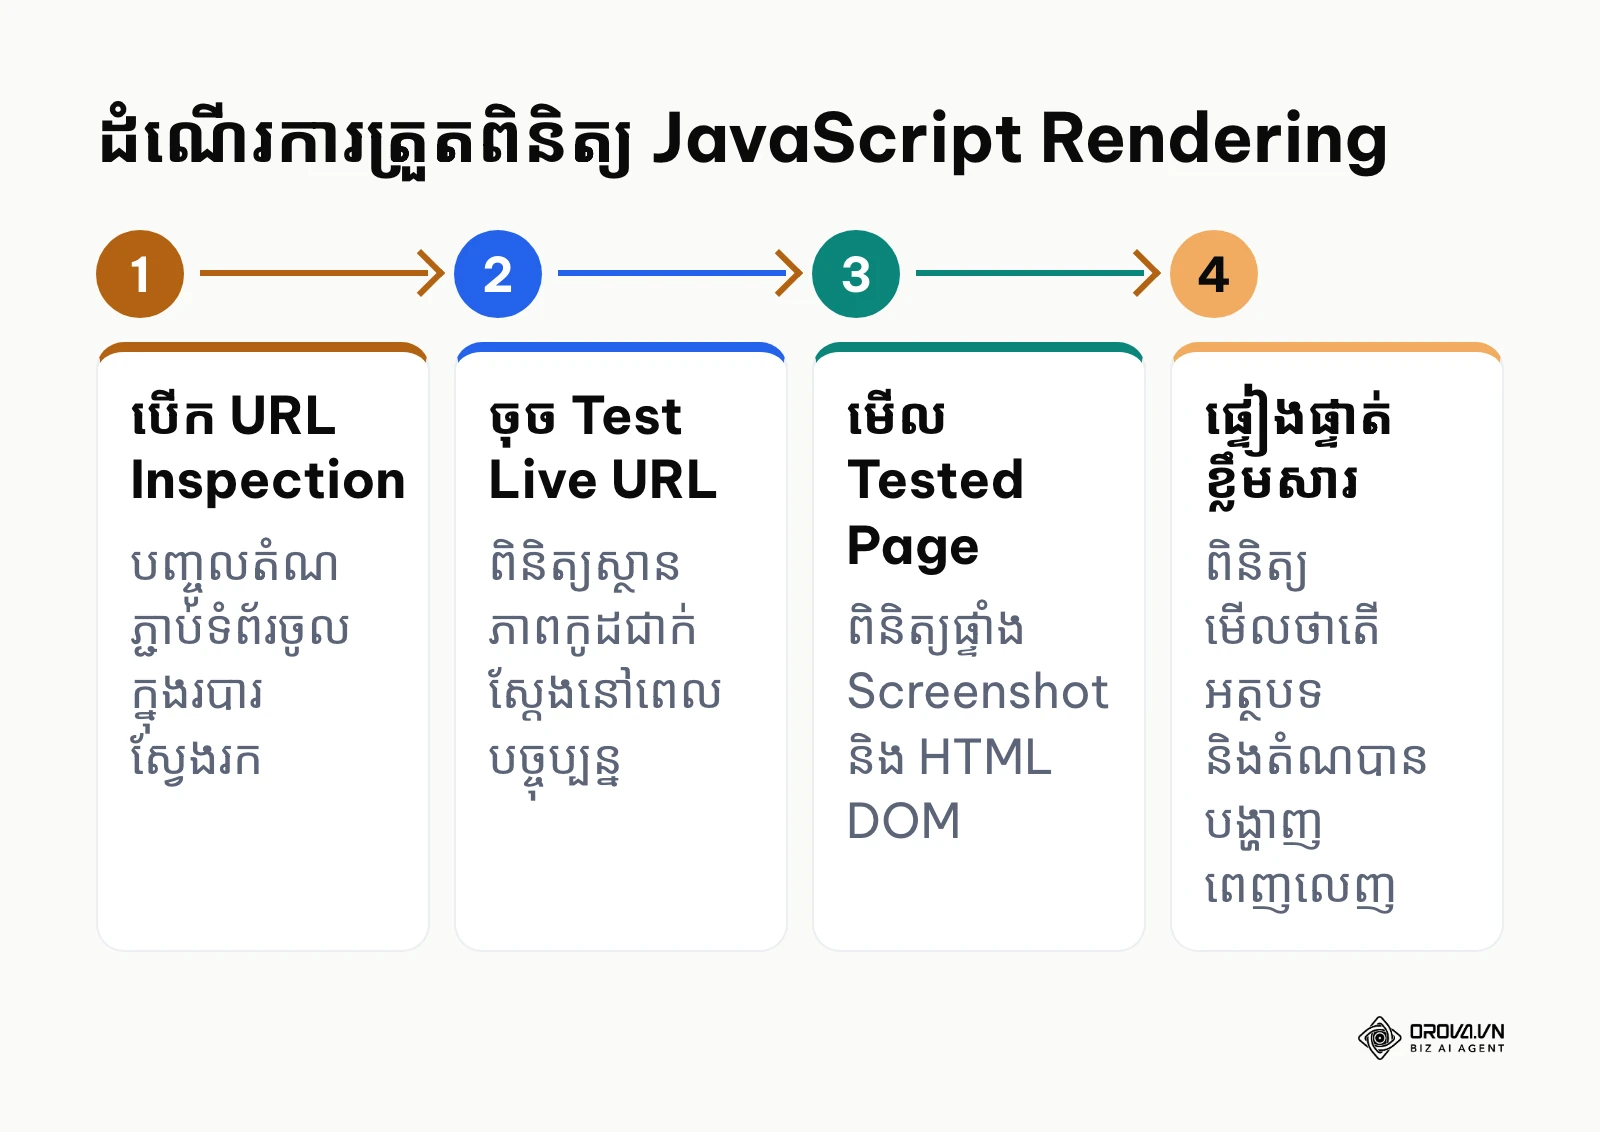
គេហទំព័របច្ចុប្បន្ន ដែលបង្កើតឡើងដោយបច្ចេកវិទ្យាទំនើបដូចជា React, Vue, ឬ Next.js ច្រើនតែប្រឈមមុខនឹងបញ្ហាលិបិក្រម ដោយសារដំណើរការ JavaScript Rendering។ ដ្យាក្រាមខាងក្រោមសង្ខេបដំណើរការត្រួតពិនិត្យ JavaScript Rendering តាមរយៈ URL Inspection។
យោងតាមឯកសារបច្ចេកទេស JavaScript SEO Basics របស់ Google Search Central ឆ្នាំ 2024 ម៉ាស៊ីន Googlebot ប្រើប្រាស់ Web Rendering Service (WRS) ដើម្បីដំណើរការ JavaScript ប៉ុន្តែដំណើរការនេះអាចចំណាយពេលយូរជាងទំព័រ HTML ធម្មតា។ ទំព័រត្រូវឆ្លងកាត់ ៣ ដំណាក់កាល៖ Crawling, Rendering និង Indexing។ ប្រសិនបើខ្លឹមសាររបស់អ្នកពឹងផ្អែកលើ JavaScript ទាំងស្រុង (Client-Side Rendering) ទំព័រត្រូវរង់ចាំ ក្នុងជួរ Render មុនពេល Google មើលឃើញខ្លឹមសារពិត ហើយបើកូដទាញទិន្នន័យយឺត ឬបរាជ័យខ្លឹមសារសំខាន់អាចមិនត្រូវបានមើលឃើញទាល់តែសោះ។
ដើម្បីដោះស្រាយអ្នកត្រូវប្រើប្រាស់មុខងារ URL Inspection រួចចុច Test Live URL បន្ទាប់មកជ្រើសរើស View Tested Page។ នៅក្នុងផ្ទាំង Screenshot និង HTML DOM អ្នកត្រូវពិនិត្យមើលថាតើចំណងជើងអត្ថបទ និងតំណភ្ជាប់សំខាន់ៗបានបង្ហាញពេញលេញដែរ ឬទេ។ ប្រសិនបើផ្ទាំង Screenshot បង្ហាញតែអេក្រង់ស ឬបាត់ខ្លឹមសារសំខាន់នោះអ្នកត្រូវពិចារណាប្តូរទៅប្រើ Server-Side Rendering (SSR) ឬ Pre-rendering ភ្លាមៗ។
ឧទាហរណ៍បង្ហាញ (ករណីសន្មត)៖ បរិបទគឺគេហទំព័រកម្មវិធីអនឡាញ (SaaS) បង្កើតឡើងដោយបច្ចេកវិទ្យា React SPA ដែលមានទំព័រមុខងារចំនួន ៣០។ ជំហានអនុវត្តរួមមានការពិនិត្យឃើញទំព័រចុះឈ្មោះ និងណែនាំមុខងារត្រូវបានស្កេន ប៉ុន្តែមិនបង្ហាញចំណងជើង ក្នុងលទ្ធផល Google, ប្រើមុខងារ Test Live URL ក្នុង URL Inspection, ពិនិត្យផ្ទាំង Screenshot និងកូដ HTML DOM ដែលបាន Render។ ចំណុចឧបសគ្គគឺកូដ JavaScript ដំណើរការទាញយកទិន្នន័យយឺតពេក ធ្វើឱ្យ Googlebot ផ្ដាច់ការ Render មុនពេលអត្ថបទសំខាន់ៗបង្ហាញ ដែលត្រូវបានដោះស្រាយ ដោយក្រុមបច្ចេកទេសប្តូរទៅប្រើបច្ចេកទេស Server-Side Rendering (SSR) សម្រាប់ទំព័រ Landing Page សំខាន់ៗ។ លទ្ធផលដែលអាចមើលឃើញបាន គឺពេលត្រួតពិនិត្យឡើងវិញតាម URL Inspection រូបភាព Screenshot បង្ហាញទំព័រពេញលេញ ហើយ ២ សប្តាហ៍ក្រោយមកទំព័រមុខងារទាំងអស់ត្រូវបាន Google ចុះបញ្ជីក្នុងលិបិក្រមជាផ្លូវការ។
តារាងផ្ទៀងផ្ទាត់ ១២ ស្ថានភាពលិបិក្រមក្នុង Google Search Console
ខាងក្រោមនេះជាតារាងផ្ទៀងផ្ទាត់លម្អិតនៃស្ថានភាពកំហុសទាំង ១២ ដែលជួបញឹកញាប់បំផុត ក្នុងរបាយការណ៍ Page Indexing៖
| កូដស្ថានភាព GSC | កម្រិតផលប៉ះពាល់ | ដើមហេតុបច្ចេកទេស | ដំណោះស្រាយស្តង់ដារ | រយៈពេល Googlebot ធ្វើបច្ចុប្បន្នភាព (ប៉ាន់ស្មាន) |
|---|---|---|---|---|
| Server error (5xx) | បន្ទាន់ខ្លាំង | ម៉ាស៊ីនមេដួលរលំ ឬឆ្លើយតបយឺតពេក (Timeout)។ | ជួសជុលកូដម៉ាស៊ីនមេ និងពង្រីកធនធាន Hosting។ | ពី ១ ទៅ ៣ ថ្ងៃក្រោយជួសជុល |
| Redirect error | បន្ទាន់ | ខ្សែសង្វាក់ Redirect ច្រើនតង់ឬ Redirect Loop។ | កាត់បន្ថយការ Redirect ឱ្យនៅត្រឹមមួយតង់ផ្ទាល់។ | ពី ៣ ទៅ ៧ ថ្ងៃ |
| URL marked 'noindex' | បន្ទាន់ (បើជាទំព័រលក់) | មានស្លាក meta noindex ឬ header X-Robots-Tag។ | លុបស្លាក noindex ចេញពីកូដទំព័រដែលចង់បង្ហាញ។ | ពី ២ ទៅ ៥ ថ្ងៃ |
| Soft 404 | មធ្យម | ទំព័រទទេឬគ្មានទំនិញតែឆ្លើយតបកូដ 200 OK។ | កំណត់ឱ្យឆ្លើយតបកូដ 404 ពិតប្រាកដឬ Redirect 301។ | ពី ៣ ទៅ ៧ ថ្ងៃ |
| Blocked by robots.txt | មធ្យម | ឯកសារ robots.txt បិទការចូលប្រើប្រាស់។ | កែសម្រួលច្បាប់ Disallow ក្នុង robots.txt។ | ពី ២៤ ទៅ ៤៨ ម៉ោង |
| Not found (404) | ទាប | URL មិនមានឬត្រូវបានលុបចោលត្រឹមត្រូវ។ | បើជាទំព័រចាស់លុបចោលមិនបាច់កែប្រែអ្វីឡើយ។ | ពី ១ ទៅ ៤ សប្តាហ៍ |
| Alternate page with canonical | ទាប | ទំព័រមានកំណែទូរសព្ទ ឬ AMP ត្រឹមត្រូវ។ | ជារឿងធម្មតាមិនទាមទារការកែសម្រួលឡើយ។ | មិនចាំបាច់កែប្រែ |
| Duplicate without canonical | មធ្យម | ទំព័រមានខ្លឹមសារស្ទួនតែមិនបានបញ្ជាក់ Canonical។ | បន្ថែមស្លាក rel="canonical" ទៅទំព័រដើម។ | ពី ៥ ទៅ ១០ ថ្ងៃ |
| Google chose different canonical | មធ្យម | Google មិនយល់ស្របជាមួយស្លាក Canonical របស់អ្នក។ | ពង្រឹងតំណភ្ជាប់ផ្ទៃក្នុង និងភាពខុសគ្នានៃមាតិកា។ | ពី ១ ទៅ ២ សប្តាហ៍ |
| Crawled – currently not indexed | ខ្ពស់ | គុណភាពមាតិកាទាប ឬខ្វះភាពស៊ីជម្រៅ E-E-A-T។ | កែលម្អខ្លឹមសារបន្ថែមតម្លៃព័ត៌មាន និងតំណភ្ជាប់។ | ពី ១ ទៅ ៣ សប្តាហ៍ |
| Discovered – currently not indexed | ខ្ពស់ | ខ្វះ Crawl Budget ឬម៉ាស៊ីនមេមានការឆ្លើយតបយឺត។ | ពង្រឹងតំណភ្ជាប់ផ្ទៃក្នុង និងបង្កើនល្បឿន Server។ | ពី ៣ ទៅ ១៤ ថ្ងៃ |
| Page with redirect | ទាប | URL ចាស់ត្រូវបាន Redirect 301 ទៅ URL ថ្មី។ | ជារឿងធម្មតាសម្រាប់ទំព័រ ដែលបានប្តូរអាសយដ្ឋាន។ | ពី ១ ទៅ ៣ សប្តាហ៍ |
កាលវិភាគនិងនីតិវិធីក្រោយពេលចុច Validate Fix
បន្ទាប់ពីអ្នកបានកែតម្រូវកំហុសបច្ចេកទេសរួចរាល់ជំហានបន្ទាប់ គឺការស្នើសុំឱ្យ Google ផ្ទៀងផ្ទាត់ឡើងវិញ តាមរយៈប៊ូតុង Validate Fix នៅក្នុង Search Console។ ដ្យាក្រាមខាងក្រោមសង្ខេបដំណាក់កាលផ្ទៀងផ្ទាត់ Validate Fix របស់ Googlebot តាមលំដាប់លំដោយ។
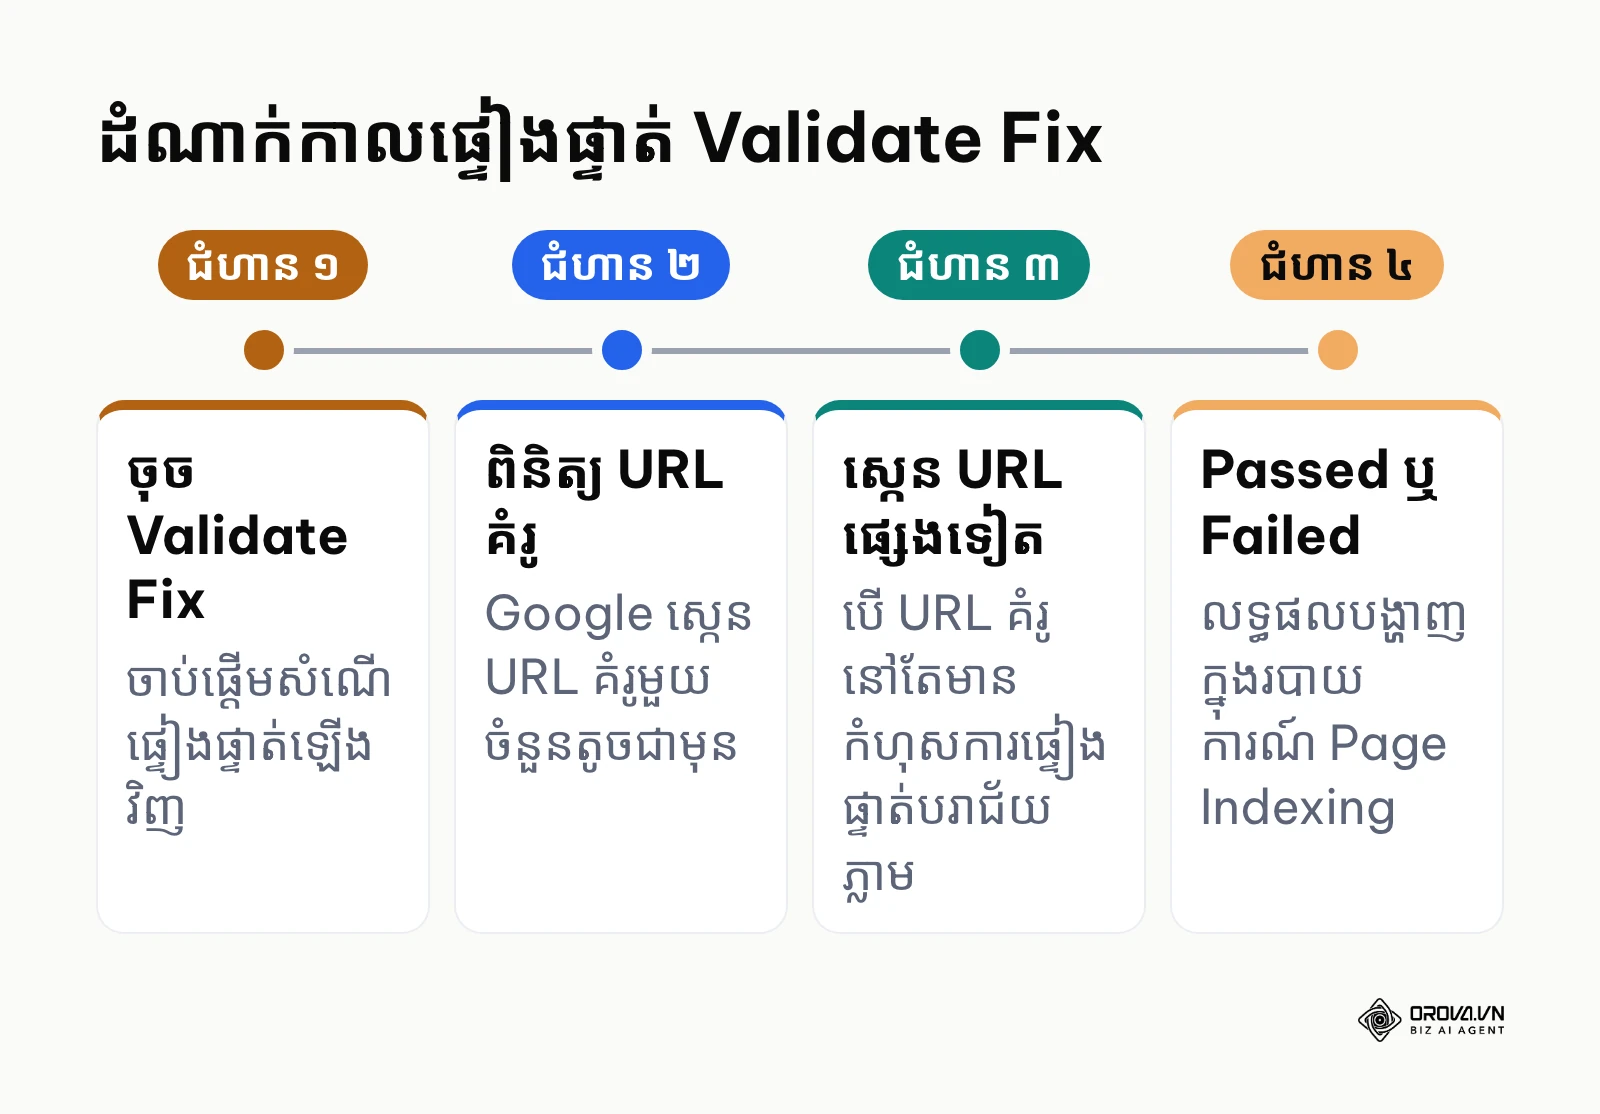
ដំណើរការផ្ទៀងផ្ទាត់នេះមិនកើតឡើងភ្លាមៗនោះទេ។ ជាទូទៅវាត្រូវចំណាយពេលចាប់ពី ពីរបីថ្ងៃរហូតដល់ ពីរសប្តាហ៍អាស្រ័យលើចំនួន URL ដែលមានកំហុសនិងភាពញឹកញាប់នៃការចុះមកប្រមូលទិន្នន័យរបស់ Googlebot លើគេហទំព័ររបស់អ្នក។ ក្នុងអំឡុងពេលនេះ Google នឹងស្កេន URL គំរូមួយចំនួនតូចជាមុនសិន។ ប្រសិនបើ URL គំរូនោះនៅតែមានកំហុសការផ្ទៀងផ្ទាត់នឹងត្រូវបរាជ័យភ្លាមៗ (Validation Failed)។
ដើម្បីជៀសវាងការបរាជ័យអ្នកត្រូវអនុវត្តតាមបញ្ជីត្រួតពិនិត្យ ៥ ចំណុចជាមុន៖
- ធ្វើតេស្តបន្តផ្ទាល់ តាមរយៈ Test Live URL លើទំព័រគំរូយ៉ាងហោចណាស់ ៥ ទំព័រ។
- ធានាថាម៉ាស៊ីនមេឆ្លើយតបកូដ 200 OK យ៉ាងរលូននិងល្បឿនឆ្លើយតបក្រោម ៥០០ms។
- សម្អាតឃ្លាំងសម្ងាត់ (Clear Cache) នៅលើ Server, Cloudflare ឬ CDN។
- ពិនិត្យឯកសារ robots.txt និងស្លាក Meta Robots ឡើងវិញឱ្យប្រាកដថាគ្មានការរារាំង ដោយអចេតនា។
- ធ្វើបច្ចុប្បន្នភាព XML Sitemap និងធានាថាមានតែ URL ត្រឹមត្រូវប៉ុណ្ណោះ ដែលត្រូវបានបញ្ជូន។
ជាមួយ OROVA.VN និងម៉ូឌុល OROVA SEO លោកអ្នកនឹងបញ្ចប់ជាស្ថាពរនូវថ្ងៃខែដ៏នឿយហត់នៃការធ្វើការដោយដៃ។ ជំនួសឱ្យការខិតខំរាប់ម៉ោងដើម្បីសរសេរអត្ថបទ និងធ្វើរបាយការណ៍ ឥឡូវនេះដំណើរការទាំងមូលត្រូវបានបង្កើនប្រសិទ្ធភាព និងបញ្ចប់ក្នុងរយៈពេលត្រឹមតែ ៥ នាទីប៉ុណ្ណោះ។
អ្វីដែលត្រូវធ្វើដើម្បីចាប់ផ្តើមនិងសម្របខ្លួនជាមួយ Google Search Console indexing
ការគ្រប់គ្រង Google Search Console indexing ទាមទារយុទ្ធសាស្ត្រច្បាស់លាស់ទៅតាមទំហំ និងធនធាននៃស្ថាប័ននីមួយៗ។ ខាងក្រោមនេះជាផែនការសកម្មភាពជាក់ស្តែង សម្រាប់តួនាទីទាំង ៣៖
សម្រាប់ម្ចាស់អាជីវកម្មខ្នាតតូច
ម្ចាស់អាជីវកម្មខ្នាតតូចច្រើនតែមានពេលវេលាតិចតួច និងខ្វះបុគ្គលិកបច្ចេកទេសជំនាញ។ អ្នកគួរផ្តោតលើកិច្ចការសំខាន់ៗដែលមានផលប៉ះពាល់ខ្ពស់បំផុត៖
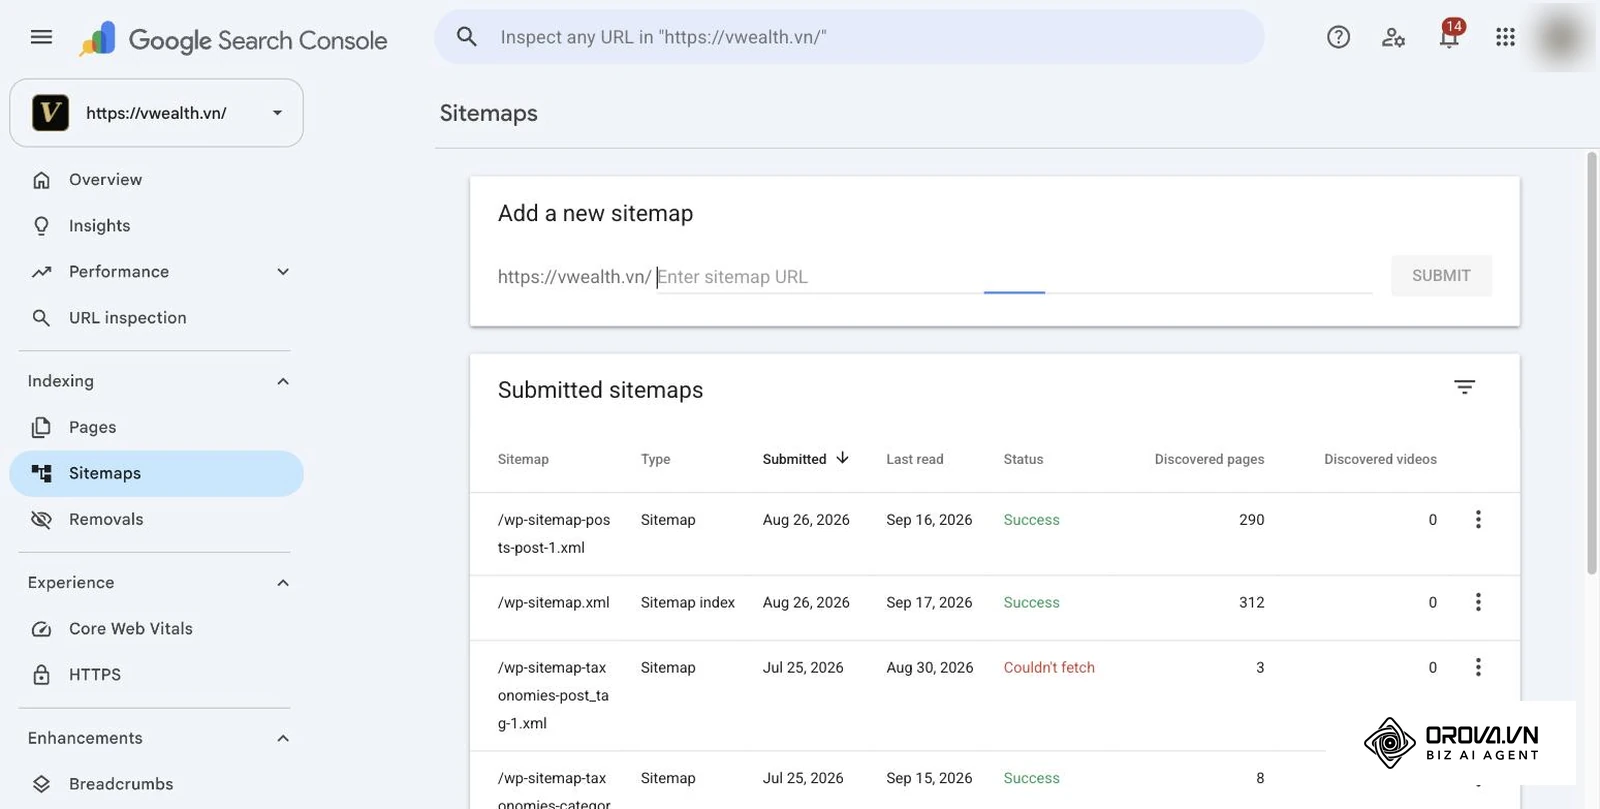
- បង្កើតនិងផ្ទៀងផ្ទាត់គណនី Google Search Console តាមរយៈ Domain Property ឱ្យបានត្រឹមត្រូវ (កិច្ចការធ្វើភ្លាម ក្នុងសប្តាហ៍ទីមួយ)។
- បញ្ជូន XML Sitemap ផ្លូវការរបស់គេហទំព័រចូលទៅក្នុងផ្ទាំង Sitemaps។
- ពិនិត្យផ្ទាំង Page Indexing រៀងរាល់ពីរសប្តាហ៍ម្តង ដើម្បីធានាថាទំព័រលក់សំខាន់ៗមិនធ្លាក់ចូលក្នុងកំហុស 404 ឬ 5xx។
- ជៀសវាងការបោះពុម្ពផ្សាយមាតិកា ដែលចម្លងពីគេហទំព័រដទៃ ដែលជាដើមហេតុចម្បង ធ្វើឱ្យទំព័រជាប់គាំង Crawled Not Indexed។
សម្រាប់អ្នកជំនាញ SEO និងអ្នកគ្រប់គ្រងគេហទំព័រក្នុងស្ថាប័ន
អ្នកទទួលបន្ទុកផ្ទាល់ ក្នុងក្រុមហ៊ុនត្រូវមានផែនការត្រួតពិនិត្យស៊ីជម្រៅជាប្រចាំខែ៖
- ធ្វើសវនកម្មបច្ចេកទេសគេហទំព័រ (technical seo audit services) ដើម្បីស្វែងរកទំព័រ ដែលខូចនិងតំណភ្ជាប់មិនដំណើរការ (កិច្ចការធ្វើភ្លាម ក្នុងសប្តាហ៍ទីមួយ)។
- ត្រួតពិនិត្យរបាយការណ៍ Crawl Stats ដើម្បីវាយតម្លៃសុខភាពម៉ាស៊ីនមេ និងបង្កើនប្រសិទ្ធភាព Crawl Budget។
- កំណត់រចនាសម្ព័ន្ធ Canonical Tags ឱ្យបានច្បាស់លាស់ សម្រាប់ទំព័រដែលមានប៉ារ៉ាម៉ែត្រស្ទួន។
- រៀបចំយុទ្ធសាស្ត្រតំណភ្ជាប់ផ្ទៃក្នុង (Internal Linking Structure) ដើម្បីជួយរុញច្រានទំព័រ ដែលស្ថិតក្នុងស្ថានភាព Discovered Not Indexed ឱ្យទទួលបានការ Crawl លឿនជាងមុន។
- បង្កើតដំណើរការស្វ័យប្រវត្តិនៃការត្រួតពិនិត្យសុខភាពគេហទំព័រ និងការជូនដំណឹងជាបន្ទាន់ នៅពេលមានកំហុស 5xx កើតឡើង។
សម្រាប់ទីភ្នាក់ងារឌីជីថលនិង Freelancer
សម្រាប់ទីភ្នាក់ងារ ដែលត្រូវគ្រប់គ្រងគេហទំព័រអតិថិជនច្រើន ក្នុងពេលតែមួយ៖
- បង្កើតផ្ទាំងគ្រប់គ្រងកណ្តាល ដើម្បីតាមដានអត្រា Indexation Rate របស់អតិថិជនទាំងអស់ (កិច្ចការធ្វើភ្លាម ក្នុងសប្តាហ៍ទីមួយ)។
- អនុវត្តក្របខ័ណ្ឌ Triage Framework ដើម្បីផ្តល់អាទិភាពដោះស្រាយបញ្ហា ដែលប៉ះពាល់ដល់ប្រាក់ចំណូលរបស់អតិថិជនជាមុន។
- រៀបចំរបាយការណ៍សវនកម្មលិបិក្រមប្រចាំខែជូនអតិថិជន ដោយបញ្ជាក់ច្បាស់ ពីទំព័រដែលបានជួសជុល និងទំព័រដែលបានចុះបញ្ជីថ្មី។
- ណែនាំអតិថិជនអំពីការបង្កើតមាតិកា ដែលមាន E-E-A-T ខ្ពស់ដើម្បីការពារកុំឱ្យអត្ថបទប្លុកថ្មីៗធ្លាក់ចូលក្នុងស្ថានភាព Crawled Not Indexed។
កំហុសទូទៅនិងវិធីជៀសវាងពេលគ្រប់គ្រង Indexing
ដ្យាក្រាមខាងក្រោមសង្ខេបបញ្ជីត្រួតពិនិត្យការពារកំហុស Indexing ដែលគួរអនុវត្តជាប្រចាំ។ ក្នុងការអនុវត្តជាក់ស្តែងអ្នកគ្រប់គ្រងគេហទំព័រច្រើនតែប្រព្រឹត្តកំហុសឆ្គងបច្ចេកទេសមួយចំនួន ដែលនាំឱ្យខាតបង់ចរាចរណ៍យ៉ាងធ្ងន់ធ្ងរ៖
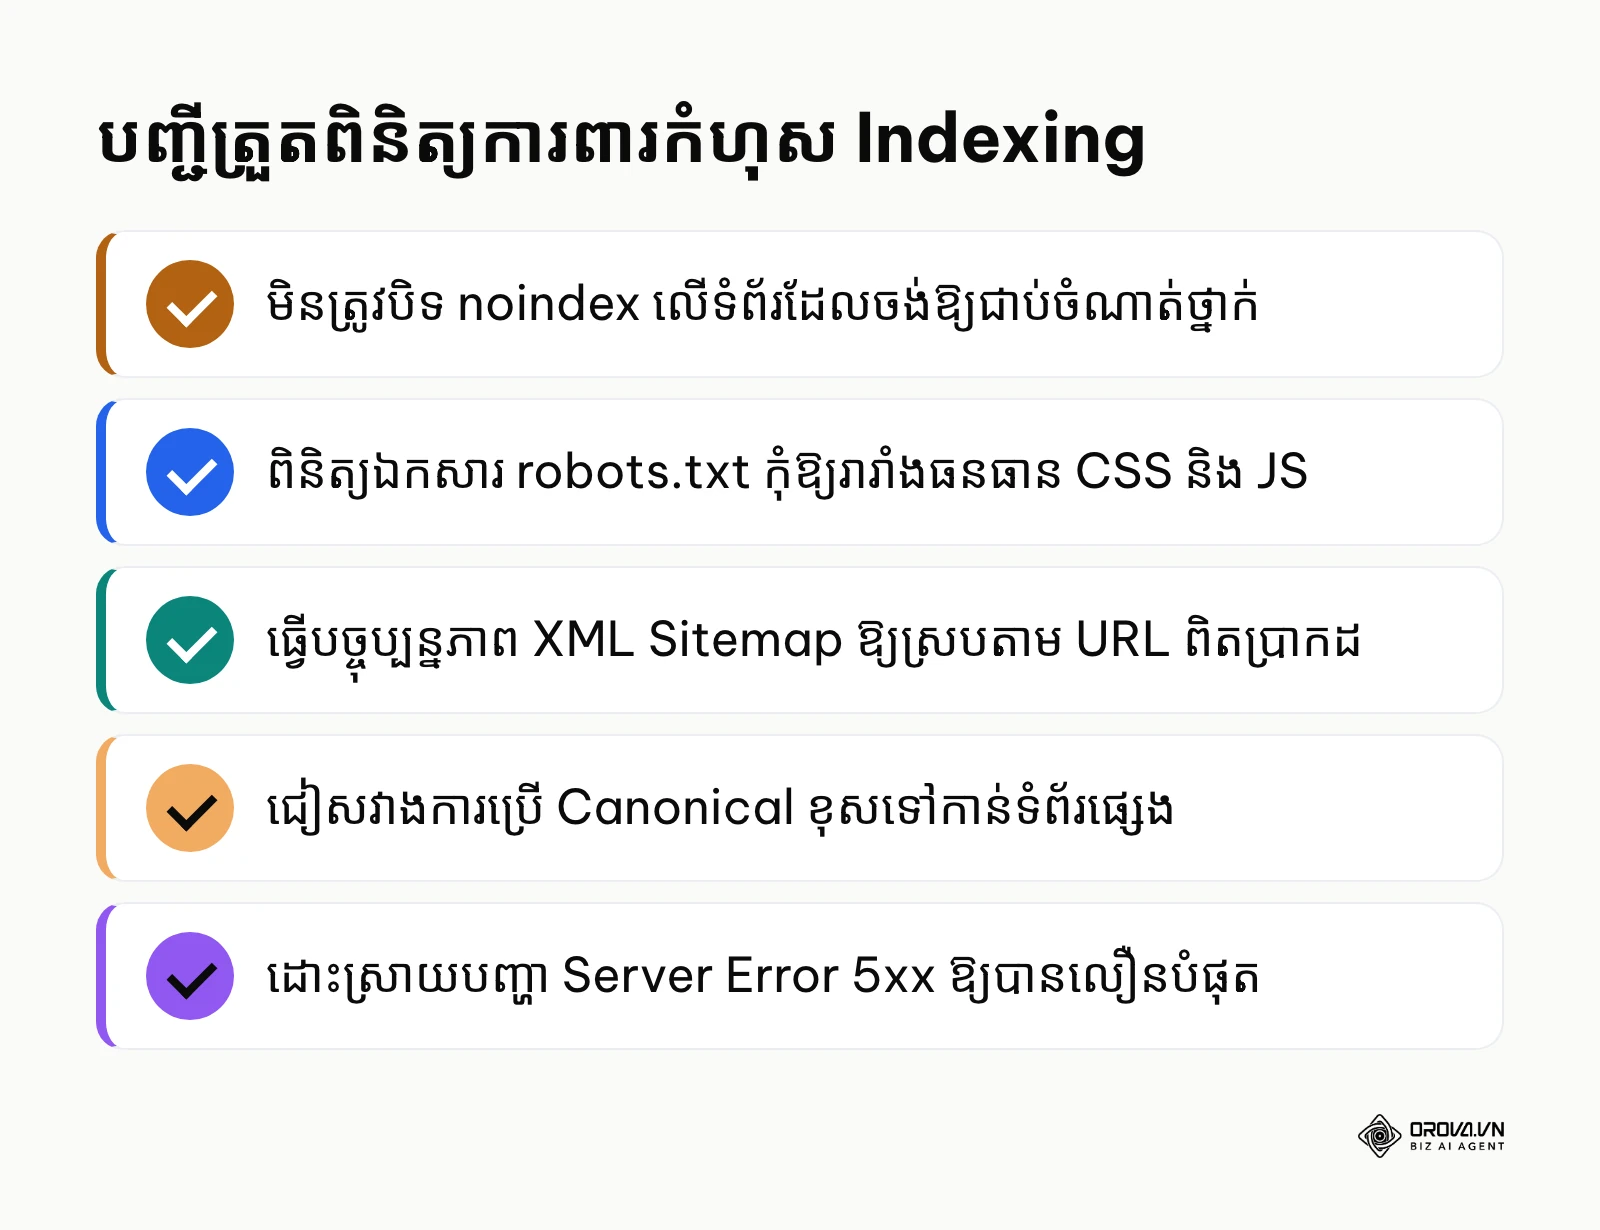
| កំហុសទូទៅ | ផលវិបាក | វិធីជៀសវាងត្រឹមត្រូវ |
|---|---|---|
| ភ្លេចដកស្លាក noindex ក្រោយពេលដាក់គេហទំព័រឱ្យដំណើរការ | Googlebot មិនធ្វើលិបិក្រមគេហទំព័រទាំងមូលចរាចរណ៍ស្វែងរកស្មើ ០។ | បង្កើតបញ្ជីត្រួតពិនិត្យមុនពេល Launch និងពិនិត្យកូដប្រភពទំព័រមេ។ |
| បិទការចូលប្រើប្រាស់ឯកសារ CSS/JS ក្នុង robots.txt | Googlebot មិនអាច Render ទំព័របានពេញលេញ ធ្វើឱ្យបាត់ចំណាត់ថ្នាក់។ | អនុញ្ញាតឱ្យ Googlebot ចូលដំណើរការធនធានស្គ្រីប និងស្ទីលទាំងអស់។ |
| បញ្ជូន Sitemap ដែលមាន URL ខូចឬ URL Redirect | ស៊ី Crawl Budget ដោយឥតប្រយោជន៍និងបន្ថយល្បឿនធ្វើលិបិក្រម។ | ធានាថា Sitemap មានតែ URL ត្រឹមត្រូវកម្រិត 200 OK ប៉ុណ្ណោះ។ |
| ប្រើប្រាស់ Canonical ខុសទៅកាន់ទំព័រមិនពាក់ព័ន្ធ | Google យល់ច្រឡំនិងដកទំព័រត្រឹមត្រូវចេញ ពីបញ្ជីស្វែងរក។ | កំណត់ Canonical ចង្អុលទៅកាន់ទំព័រដើមច្បាស់លាស់តែមួយគត់។ |
និន្នាការ Google Search Console indexing ក្នុងប៉ុន្មានឆ្នាំខាងមុខ៖ ទស្សនៈផ្ទាល់ខ្លួនរបស់អ្នកនិពន្ធ
គិតត្រឹមឆ្នាំ ២០២៦ នេះយើងកំពុងឃើញការផ្លាស់ប្តូរយ៉ាងគំហុកនៅក្នុងរបៀប ដែលម៉ាស៊ីនស្វែងរកដំណើរការ និងវាយតម្លៃទំព័របណ្ដាញ។ ផ្អែកលើការសង្កេតបច្ចេកវិទ្យាបច្ចុប្បន្នខ្ញុំសូមចែករំលែកនូវទស្សនវិស័យផ្ទាល់ខ្លួនចំនួន ៣ អំពីអនាគតនៃ Google Search Console indexing ក្នុងរយៈពេល ២ ទៅ ៣ ឆ្នាំខាងមុខ៖
ការផ្លាស់ប្តូរពីការប្រមូលទិន្នន័យទូទៅមកជាការជ្រើសរើសគុណភាពផ្អែកលើ AI
សញ្ញាដែលខ្ញុំសង្កេតឃើញ គឺអ្នកគ្រប់គ្រងគេហទំព័រកាន់តែច្រើនរអ៊ូអំពីទំព័រ ដែលធ្លាក់ចូលក្នុងស្ថានភាព Crawled – currently not indexed។ តាមការយល់ឃើញរបស់ខ្ញុំ ក្នុងរយៈពេល ២ ទៅ ៣ ឆ្នាំខាងមុខ Google នឹងមិនបន្តប្រមូលទិន្នន័យគ្រប់ទំព័រលើអ៊ីនធឺណិតដូច ពីមុនទៀតឡើយដោយសារការកើនឡើងនៃមាតិកា AI ធ្វើឱ្យចំណាយលើការរក្សាទុកទិន្នន័យកើនឡើងខ្ពស់។ ខ្ញុំយល់ឃើញថា Google នឹងដាក់ក្បួនដោះស្រាយ AI នៅដំណាក់កាល Crawl Queue ផ្ទាល់ដើម្បីវាយតម្លៃគុណភាពមុនពេលសម្រេចចិត្តទាញយកកូដ។ អ្នកគួរត្រៀមខ្លួន ដោយផ្តោតលើការផលិតមាតិកា ដែលមានតម្លៃបន្ថែមខ្ពស់។ ការយល់ឃើញនេះអាចនឹងខុស ប្រសិនបើថ្លៃដើមម៉ាស៊ីនមេថយចុះខ្លាំង។
សារៈសំខាន់នៃ Indexing API និងការបញ្ជូនទិន្នន័យដោយផ្ទាល់ក្នុងរយៈពេល ២ ទៅ ៣ ឆ្នាំខាងមុខ
សញ្ញាបច្ចុប្បន្នបង្ហាញថាការរង់ចាំឱ្យ Googlebot ចុះមកស្កេន Sitemap កំពុងក្លាយជាយន្តការយឺតយ៉ាវ សម្រាប់ព័ត៌មានទាន់ហេតុការណ៍ និងទំនិញអេឡិចត្រូនិក។ ខ្ញុំមានទំនោរគិតថានៅប៉ុន្មានឆ្នាំខាងមុខស្ថាបត្យកម្មនៃការធ្វើលិបិក្រមនឹងប្តូរទៅជាការបញ្ជូនទិន្នន័យតាមព្រឹត្តិការណ៍ផ្ទាល់ (Event-driven Indexing) តាមរយៈ Indexing API សម្រាប់គេហទំព័រស្ទើរតែទាំងអស់។ អ្នកអភិវឌ្ឍន៍គួរចាប់ផ្តើមរៀបចំរចនាសម្ព័ន្ធ API ឱ្យស្របតាមស្តង់ដារតាំង ពីពេលនេះ។ ទោះជាយ៉ាងណាការយល់ឃើញនេះអាចនឹងមិនកើតឡើងទេ ប្រសិនបើ Google បន្តរឹតបន្តឹង API ដើម្បីការពារ Spam។
ការត្រៀមខ្លួនសម្រាប់អ្នកគ្រប់គ្រងគេហទំព័រ៖ ផ្តោតលើ Information Gain និងភាពត្រឹមត្រូវនៃទិន្នន័យ
សញ្ញាដែលស្តែងចេញ នៅពេលនេះគឺបទពិសោធន៍ស្វែងរក AI Overviews ទាមទារឱ្យមានប្រភពទិន្នន័យច្បាស់លាស់ និងរចនាសម្ព័ន្ធស្តង់ដារ។ តាមទស្សនៈរបស់ខ្ញុំទំព័រណា ដែលគ្រាន់តែសង្ខេបចំណេះដឹងចាស់ឡើងវិញនឹងត្រូវកាត់ចេញ ពីលិបិក្រមជាបណ្តើរៗ។ អ្នកគួរត្រៀមខ្លួន ដោយការវិនិយោគលើការស្រាវជ្រាវផ្ទាល់ និងបង្កើត Schema Markup លម្អិត។ ប្រសិនបើ Google ផ្លាស់ប្តូរទិសដៅទៅរកប្រព័ន្ធបិទជិតនោះយុទ្ធសាស្ត្រនេះអាចនឹងត្រូវការការកែសម្រួល។
តារាងខាងក្រោមសង្ខេបទស្សនៈទាំង ៣ ខាងលើនិងអ្វីដែលអ្នកអាចត្រៀមចាប់ពីពេលនេះ៖
| ទស្សនៈ | សញ្ញាដែលឃើញនៅពេលនេះ | អ្វីដែលគួរត្រៀម |
|---|---|---|
| Google ជ្រើសរើសទំព័រតាមគុណភាពកាន់តែតឹងរ៉ឹង | ទំព័រជាប់ Crawled – currently not indexed កាន់តែច្រើន | ផ្តោតលើមាតិកាដែលមានតម្លៃបន្ថែមខ្ពស់ |
| ការបញ្ជូនទិន្នន័យផ្ទាល់មានសារៈសំខាន់ជាងមុន | ការរង់ចាំ Googlebot ស្កេន Sitemap យឺតសម្រាប់ព័ត៌មានទាន់ហេតុការណ៍ | រក្សា XML Sitemap ឱ្យស្អាតនិងតាមដានការផ្លាស់ប្តូរ API របស់ Google |
| ទំព័រសង្ខេបចំណេះដឹងចាស់ពិបាកនៅក្នុងលិបិក្រម | AI Overviews ទាមទារប្រភពច្បាស់លាស់ | វិនិយោគលើការស្រាវជ្រាវផ្ទាល់ និង Schema Markup |
សំណួរដែលជួបញឹកញាប់អំពី Google Search Console indexing
ហេតុអ្វីបានជាអត្ថបទវែងនិងសរសេរត្រឹមត្រូវតាម SEO នៅតែជាប់ស្ថានភាព Crawled Not Indexed?
Google មិនត្រឹមតែរាប់ចំនួនពាក្យ ឬពិនិត្យពាក្យគន្លឹះប៉ុណ្ណោះទេ ប៉ុន្តែវាយតម្លៃលើតម្លៃព័ត៌មានបន្ថែម (Information Gain) និងបទពិសោធន៍ជាក់ស្តែងរបស់អ្នកនិពន្ធ។ ប្រសិនបើអត្ថបទរបស់អ្នកវែង ប៉ុន្តែគ្រាន់តែសរសេរឡើងវិញនូវអ្វី ដែលគេហទំព័រដទៃបាននិយាយរួចហើយនោះ Googlebot នឹងចាត់ទុកថាជាខ្លឹមសារគ្មានភាពចាំបាច់ ក្នុងការធ្វើលិបិក្រម។
តើប៊ូតុង Validate Fix ក្នុង Search Console ត្រូវចំណាយពេលប៉ុន្មានហើយបើបរាជ័យតើត្រូវធ្វើអ្វី?
ដំណើរការ Validate Fix ជាទូទៅត្រូវចំណាយពេល ពីពីរបីថ្ងៃរហូតដល់ ពីរសប្តាហ៍អាស្រ័យលើ Crawl Budget នៃគេហទំព័ររបស់អ្នក។ ប្រសិនបើការផ្ទៀងផ្ទាត់បរាជ័យអ្នកត្រូវប្រើឧបករណ៍ URL Inspection ពិនិត្យកូដស្ថានភាពផ្ទាល់លើ URL គំរូកែតម្រូវបញ្ហាបច្ចេកទេសឱ្យបានត្រឹមត្រូវរួចសម្អាត Cache មុនពេលចុចស្នើសុំម្តងទៀត។
តើគួរប្រើប្រាស់ Google Indexing API សម្រាប់អត្ថបទប្លុកធម្មតាដែរឬទេ?
Google Indexing API ត្រូវបានបង្កើតឡើងជាផ្លូវការ សម្រាប់តែទំព័រប្រកាសការងារ (JobPosting) និងទំព័រផ្សាយផ្ទាល់ (BroadcastEvent) ប៉ុណ្ណោះ។ ការប្រើប្រាស់ API នេះសម្រាប់អត្ថបទប្លុកធម្មតាអាចជួយឱ្យទំព័រឡើងលឿន ក្នុងរយៈពេលខ្លី ប៉ុន្តែវាប្រឈមមុខនឹងហានិភ័យនៃការបំពានគោលការណ៍ណែនាំរបស់ Google និងអាចរងការដាក់ពិន័យ នៅពេលក្រោយ។
តើករណីណាខ្លះក្នុងរបាយការណ៍ Page Indexing ដែលជារឿងធម្មតាហើយមិនបាច់កែប្រែ?
ករណីដូចជា Alternate page with proper canonical tag, Page with redirect និងទំព័រ 404 ចាស់ៗដែលបានលុបចោលជាអចិន្ត្រៃយ៍ គឺជារឿងធម្មតាទាំងស្រុងនៃគេហទំព័រសុខភាពល្អ។ វត្តមានរបស់ស្ថានភាពទាំងនេះបង្ហាញថាប្រព័ន្ធកំពុងដំណើរការចាត់ចែងទិន្នន័យបានត្រឹមត្រូវ ហើយអ្នកមិនចាំបាច់ចំណាយពេលកែសម្រួលឡើយ។
តើ Google Search Console indexing នៅតែចាំបាច់ដែរឬទេនៅពេលមាន AI?
Google Search Console indexing នៅតែជាគ្រឹះបច្ចេកទេស ដែលមិនអាចខ្វះបាន ទោះបីជាបច្ចេកវិទ្យា AI មានការរីកចម្រើនខ្លាំងយ៉ាងណាក៏ ដោយ។ មុនពេលដែលម៉ូដែល AI ស្វែងរកអាចដកស្រង់ទិន្នន័យរបស់អ្នកទៅឆ្លើយសំណួរទំព័ររបស់អ្នកត្រូវតែត្រូវបាន Googlebot ប្រមូលនិងរក្សាទុក ក្នុងលិបិក្រមជាមុនសិនបើមិនដូច្នេះទេវត្តមានឌីជីថលរបស់អ្នកនឹងស្មើនឹងសូន្យ។
តើគួរចាប់ផ្តើមពីចំណុចណាជាមួយ Google Search Console indexing?
ការចាប់ផ្តើមកែលម្អសុខភាពគេហទំព័រមិនទាមទារឱ្យអ្នកដោះស្រាយបញ្ហាទាំងអស់ ក្នុងពេលតែមួយនោះឡើយ។ អ្នកអាចចាប់ផ្តើម ដោយជំហានជាក់ស្តែងមួយគត់ស្របតាមស្ថានភាពបច្ចុប្បន្ននៃគេហទំព័ររបស់អ្នក៖
| ស្ថានភាពគេហទំព័ររបស់អ្នក | ជំហានដំបូងដែលត្រូវធ្វើ |
|---|---|
| មិនទាន់មានអ្វីសោះ | ជំហានដំបូងតែមួយគត់ ដែលអ្នកអាចធ្វើរួចរាល់ ក្នុងពេលមួយព្រឹក គឺការចុះឈ្មោះគណនី Google Search Console ផ្ទៀងផ្ទាត់សិទ្ធិជាម្ចាស់ តាមរយៈកំណត់ត្រា DNS TXT និងបញ្ជូនឯកសារ XML Sitemap ផ្លូវការ។ បន្ទាប់មកទុកពេលឱ្យប្រព័ន្ធដំណើរការប្រមូលទិន្នន័យដំបូង ពីរបីថ្ងៃដោយមិនបាច់បារម្ភឡើយ។ |
| មានរួចហើយតែមិនមានរបៀបរៀបរយ | ជំហានដំបូងដែលត្រូវអនុវត្តភ្លាម គឺការបើករបាយការណ៍ Page Indexing រួចទាញយកឯកសារបញ្ជី URL ដែលស្ថិតក្នុងស្ថានភាព Not Indexed មកដាក់ក្នុង Google Sheets។ ធ្វើការច្រោះយកតែ URL ណាដែលជាទំព័រលក់ ឬអត្ថបទសំខាន់ៗ ដែលជាប់កំហុស Server Error ឬ Crawled Not Indexed ដើម្បីដាក់ក្នុងបញ្ជីអាទិភាពដោះស្រាយជាបន្ទាន់។ |
| កំពុងធ្វើ SEO តែមិនបានវាស់វែងសុខភាព Indexing | ជំហានដំបូងបំផុត គឺការគណនាសមាមាត្រធ្វើលិបិក្រម (Indexation Rate) ដោយយកចំនួនទំព័រ Valid Indexed ចែកនឹងចំនួនទំព័រសរុប ដែលបានបញ្ជូនក្នុង Sitemap។ ប្រសិនបើសមាមាត្រនេះទាបជាងកម្រិតយោង ដែលអ្នកកំណត់ (ឧទាហរណ៍ ៨០%) នោះជាសញ្ញាដែលអ្នកត្រូវផ្អាកការបោះពុម្ពមាតិកាថ្មីមួយរយៈសិន ហើយផ្តោតលើការកែលម្អគុណភាពទំព័រចាស់ៗ និងរៀបចំតំណភ្ជាប់ផ្ទៃក្នុងឡើងវិញ។ |
ការយកចិត្តទុកដាក់លើសុខភាពបច្ចេកទេសជាប្រចាំនឹងជួយធានាថារាល់ការខិតខំប្រឹងប្រែងបង្កើតមាតិការបស់អ្នកនឹងទទួលបានលទ្ធផលសមស្រប តាមរយៈ Google Search Console indexing។
About the author
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
ដំណើរការអាជីវកម្មជាមួយ AI Agent
Orova គឺជា Biz AI Agent ដែលដំណើរការគ្រប់ពេល — រៀបផែនការ អនុវត្ត និងកែលម្អដោយខ្លួនឯង។
សន្សំពេលវេលា បង្កើនប្រសិទ្ធភាព