How search engines work៖ ពី Crawl, Index ដល់ AI Overviews និងកំហុស Index
ការស្វែងយល់យ៉ាងស៊ីជម្រៅអំពីរបៀបដែល how search engines work គឺជាមូលដ្ឋានគ្រឹះដំបូងបំផុតក្នុងការកសាងគេហទំព័រដែលទទួលបានចរាចរណ៍ស្វែងរកពិតប្រាកដ។ និយាយឱ្យខ្លី ម៉ាស៊ីនស្វែងរកធ្វើការតាម 3 ជំហាន៖ Crawling (រ៉ូបូតរុករក និងទាញយកទំព័រតាមតំណភ្ជាប់ និង sitemap) Indexing (វិភាគ និងរក្សាទុកមាតិកាក្នុងឃ្លាំងទិន្នន័យ) និង Serving (ជ្រើសរើស និងតម្រៀបទំព័រដែលពាក់ព័ន្ធបំផុតនៅពេលមានគេស្វែងរក)។ អ្នកគ្រប់គ្រងគេហទំព័រ និងអ្នកអភិវឌ្ឍន៍ជាច្រើនតែងតែជួបប្រទះការខកចិត្តយ៉ាងខ្លាំង នៅពេលដែលពួកគេបានចំណាយពេលច្រើនសប្តាហ៍ក្នុងការសរសេរអត្ថបទល្អៗ ឬបង្កើតគេហទំព័រដ៏ស្រស់ស្អាតដោយប្រើប្រាស់បច្ចេកវិទ្យាទំនើបដូចជា React ឬ Next.js ប៉ុន្តែទំព័រទាំងនោះបែរជាមិនបង្ហាញលើទំព័រលទ្ធផលស្វែងរកសោះឡើយ។ វិធីសាស្ត្រដែលមនុស្សភាគច្រើនធ្លាប់ធ្វើ គឺគ្រាន់តែចូលទៅចុចប៊ូតុងស្នើសុំការពិនិត្យឡើងវិញក្នុងឧបករណ៍គ្រប់គ្រង ឬទន្ទឹងរង់ចាំដោយសង្ឃឹមថាម៉ាស៊ីនស្វែងរកនឹងស្គាល់ដោយស្វ័យប្រវត្តិ។ វិធីនេះមិនអាចដោះស្រាយបញ្ហាបានឡើយ ប្រសិនបើអ្នកមិនទាន់យល់ច្បាស់ពីយន្តការបច្ចេកទេសនៅពីក្រោយវាំងនន។ អត្ថបទវិភាគស៊ីជម្រៅនេះនឹងបកស្រាយលម្អិតអំពីដំណើរការបច្ចេកទេសទាំងមូល ចាប់តាំងពីការប្រមូលទិន្នន័យ ការ Render កូដ រហូតដល់ស្ថាបត្យកម្ម AI Overviews ក្នុងឆ្នាំ 2026 រួមទាំងវិធីសាស្ត្រដោះស្រាយកំហុស Index ជាក់ស្តែងបំផុត។
how search engines work គឺជាអ្វី និងគោលការណ៍ស្នូលសម្រាប់អ្នកគ្រប់គ្រងគេហទំព័រ
ម៉ាស៊ីនស្វែងរក គឺជាប្រព័ន្ធសូហ្វវែរស្មុគស្មាញដែលត្រូវបានរចនាឡើងដើម្បីស្វែងរក ប្រមូល រៀបចំ និងចាត់ចំណាត់ថ្នាក់ព័ត៌មាននៅលើបណ្តាញអ៊ីនធឺណិត ដើម្បីឆ្លើយតបទៅនឹងសំណួររបស់អ្នកប្រើប្រាស់ក្នុងរយៈពេលត្រឹមតែប៉ុន្មានមីលីវិនាទីប៉ុណ្ណោះ។ គោលបំណងចម្បងនៃការយល់ដឹងពីរបៀបដែល how search engines work គឺដើម្បីរៀបចំរចនាសម្ព័ន្ធគេហទំព័រឱ្យស្របតាមស្តង់ដារបច្ចេកទេស ជួយឱ្យរ៉ូបូតស្វែងរកអាចចូលអានទិន្នន័យបានលឿន និងយល់ច្បាស់ពីតម្លៃនៃមាតិកា។
ចំណេះដឹងនេះចាំបាច់បំផុតសម្រាប់អ្នកអភិវឌ្ឍន៍គេហទំព័រ អ្នកគ្រប់គ្រងប្រព័ន្ធបច្ចេកវិទ្យា និងអ្នកជំនាញដែលចង់បង្កើនការបង្ហាញខ្លួនលើប្រព័ន្ធឌីជីថល។ ផ្ទុយទៅវិញ សម្រាប់គេហទំព័រផ្ទៃក្នុងរបស់ក្រុមហ៊ុន ផ្ទាំងគ្រប់គ្រងរដ្ឋបាល ឬទំព័រសាកល្បងដែលមិនត្រូវការអ្នកទស្សនាសាធារណៈ អ្នកមិនគួរចំណាយពេលបង្កើនប្រសិទ្ធភាពសម្រាប់ម៉ាស៊ីនស្វែងរកនោះទេ ប៉ុន្តែគួរកំណត់កូដទប់ស្កាត់មិនឱ្យម៉ាស៊ីនស្វែងរកចូលមកវិញ។
យោងតាមឯកសារ Google Search Essentials របស់ Google Search Central ប្រព័ន្ធស្វែងរកតម្រូវឱ្យគេហទំព័រអាចចូលដំណើរការបានដោយសេរីដោយគ្មានឧបសគ្គផ្នែកម៉ាស៊ីនបម្រើមុនពេលពិចារណាដាក់ចំណាត់ថ្នាក់។ សូម្បីតែទំព័រដែលមានមាតិកាល្អឥតខ្ចោះក៏ដោយ ប្រសិនបើប្រព័ន្ធបច្ចេកទេសរារាំងមិនឱ្យ crawler ចូលអានកូដបាន នោះទំព័រនោះនឹងមិនមានវត្តមានលើប្រព័ន្ធស្វែងរកឡើយ។ សេចក្តីសង្ខេបខាងក្រោមបង្ហាញពីលំហូរស្ថាបត្យកម្មស្នូលដែលគ្រប់ទំព័រត្រូវឆ្លងកាត់។
| ដំណាក់កាលស្នូល | ភារកិច្ចចម្បងរបស់ម៉ាស៊ីនស្វែងរក | គោលដៅបច្ចេកទេសសម្រាប់គេហទំព័រ | ហានិភ័យប្រសិនបើបរាជ័យ |
|---|---|---|---|
| Crawling | រុករក និងទាញយកកូដ HTML តាមតំណភ្ជាប់ | ធានាថាម៉ាស៊ីនបម្រើឆ្លើយតបរហ័ស និងបើក robots.txt | ទំព័រមិនត្រូវបានរកឃើញ ឬត្រូវរំលងចោល |
| Rendering | ដំណើរការកូដ JavaScript ដើម្បីបង្កើត DOM | កាត់បន្ថយការប្រើ JS ធ្ងន់ និងគាំទ្រ SSR | មាតិកាខាងក្នុងបាត់បង់ទាំងស្រុង |
| Indexing | វិភាគអត្ថបទ រូបភាព និងរក្សាទុកក្នុងឃ្លាំង | រៀបចំរចនាសម្ព័ន្ធទិន្នន័យ និង canonical ច្បាស់លាស់ | ជាប់ស្ថានភាពមិនត្រូវបានបញ្ចូលក្នុងបញ្ជី |
| Ranking | ផ្គូផ្គងសំណួរ និងវាយតម្លៃតាមក្បួនដោះស្រាយ | ផ្តល់ចម្លើយស៊ីជម្រៅ និងកសាងភាពជឿជាក់ | ទំព័រធ្លាក់ទៅទំព័រក្រោយៗដែលគ្មានអ្នកមើល |
| AI Overviews | ទាញយកព័ត៌មានជាក់លាក់មកសំយោគតាម RAG | សរសេរចំចំណុច និងរៀបចំកូដ Schema Markup | មិនត្រូវបានជ្រើសរើសសម្រាប់ចម្លើយសង្ខេប |
ការត្រៀមលក្ខណៈបច្ចេកទេសមុនពេលបង្កើនប្រសិទ្ធភាពម៉ាស៊ីនស្វែងរក
មុនពេលអ្នកចាប់ផ្តើមកែសម្រួលមាតិកា ឬអនុវត្តយុទ្ធសាស្ត្រស្វែងរកណាមួយ អ្នកត្រូវរៀបចំបរិស្ថានបច្ចេកទេសគេហទំព័រឱ្យបានរួចរាល់ជាមុនសិន។ ម៉ាស៊ីនស្វែងរកពឹងផ្អែកលើពិធីការទំនាក់ទំនងស្តង់ដារមួយចំនួនដើម្បីដឹងថាតើទំព័រណាគួរអាន និងទំព័រណាគួរចៀសវាង។
យោងតាមស្តង់ដារ Architecture of the World Wide Web, Volume One ឆ្នាំ 2004 របស់ស្ថាប័ន World Wide Web Consortium (W3C) ការកំណត់អត្តសញ្ញាណធនធានតាមរយៈ URI គឺជាលក្ខខណ្ឌចម្បងដែលអនុញ្ញាតឱ្យប្រព័ន្ធស្វ័យប្រវត្តិអាចភ្ជាប់ទំនាក់ទំនងរវាងទិន្នន័យបាន។ ប្រសិនបើរចនាសម្ព័ន្ធអាសយដ្ឋានគេហទំព័ររបស់អ្នកមានភាពរញ៉េរញ៉ៃ ឬផ្លាស់ប្តូរជាញឹកញាប់ដោយគ្មានការបញ្ជូនបន្តត្រឹមត្រូវ ម៉ាស៊ីនស្វែងរកនឹងជួបការលំបាកយ៉ាងខ្លាំងក្នុងការតាមដាន។
| ធាតុបច្ចេកទេសចាំបាច់ | ប្រភពទាញយក ឬទីតាំងកំណត់ | រយៈពេលអនុវត្តជាមធ្យម |
|---|---|---|
| ឯកសារ robots.txt | បង្កើតផ្ទាល់នៅ root directory នៃ domain (ឧទាហរណ៍៖ domain.com/robots.txt) | 15–30 នាទី |
| ឯកសារ sitemap.xml | បង្កើតដោយស្វ័យប្រវត្តិតាមប្រព័ន្ធ CMS ឬកម្មវិធីបង្កើត Sitemap | 30–60 នាទី |
| គណនី Google Search Console | ចុះឈ្មោះ និងផ្ទៀងផ្ទាត់សិទ្ធិកាន់កាប់តាម DNS TXT record | 1–2 ម៉ោង (រង់ចាំ DNS) |
| ការកំណត់ Canonical Tags | បន្ថែមក្នុងផ្នែក <head> នៃកូដ HTML តាមទំព័រនីមួយៗ | 1–3 ម៉ោងតាមប្រព័ន្ធ |
| សិទ្ធិចូលមើលម៉ាស៊ីនបម្រើ (Server Logs) | ផ្ទាំងគ្រប់គ្រង Hosting, Nginx, Apache ឬ Cloudflare | 1–2 ម៉ោង |
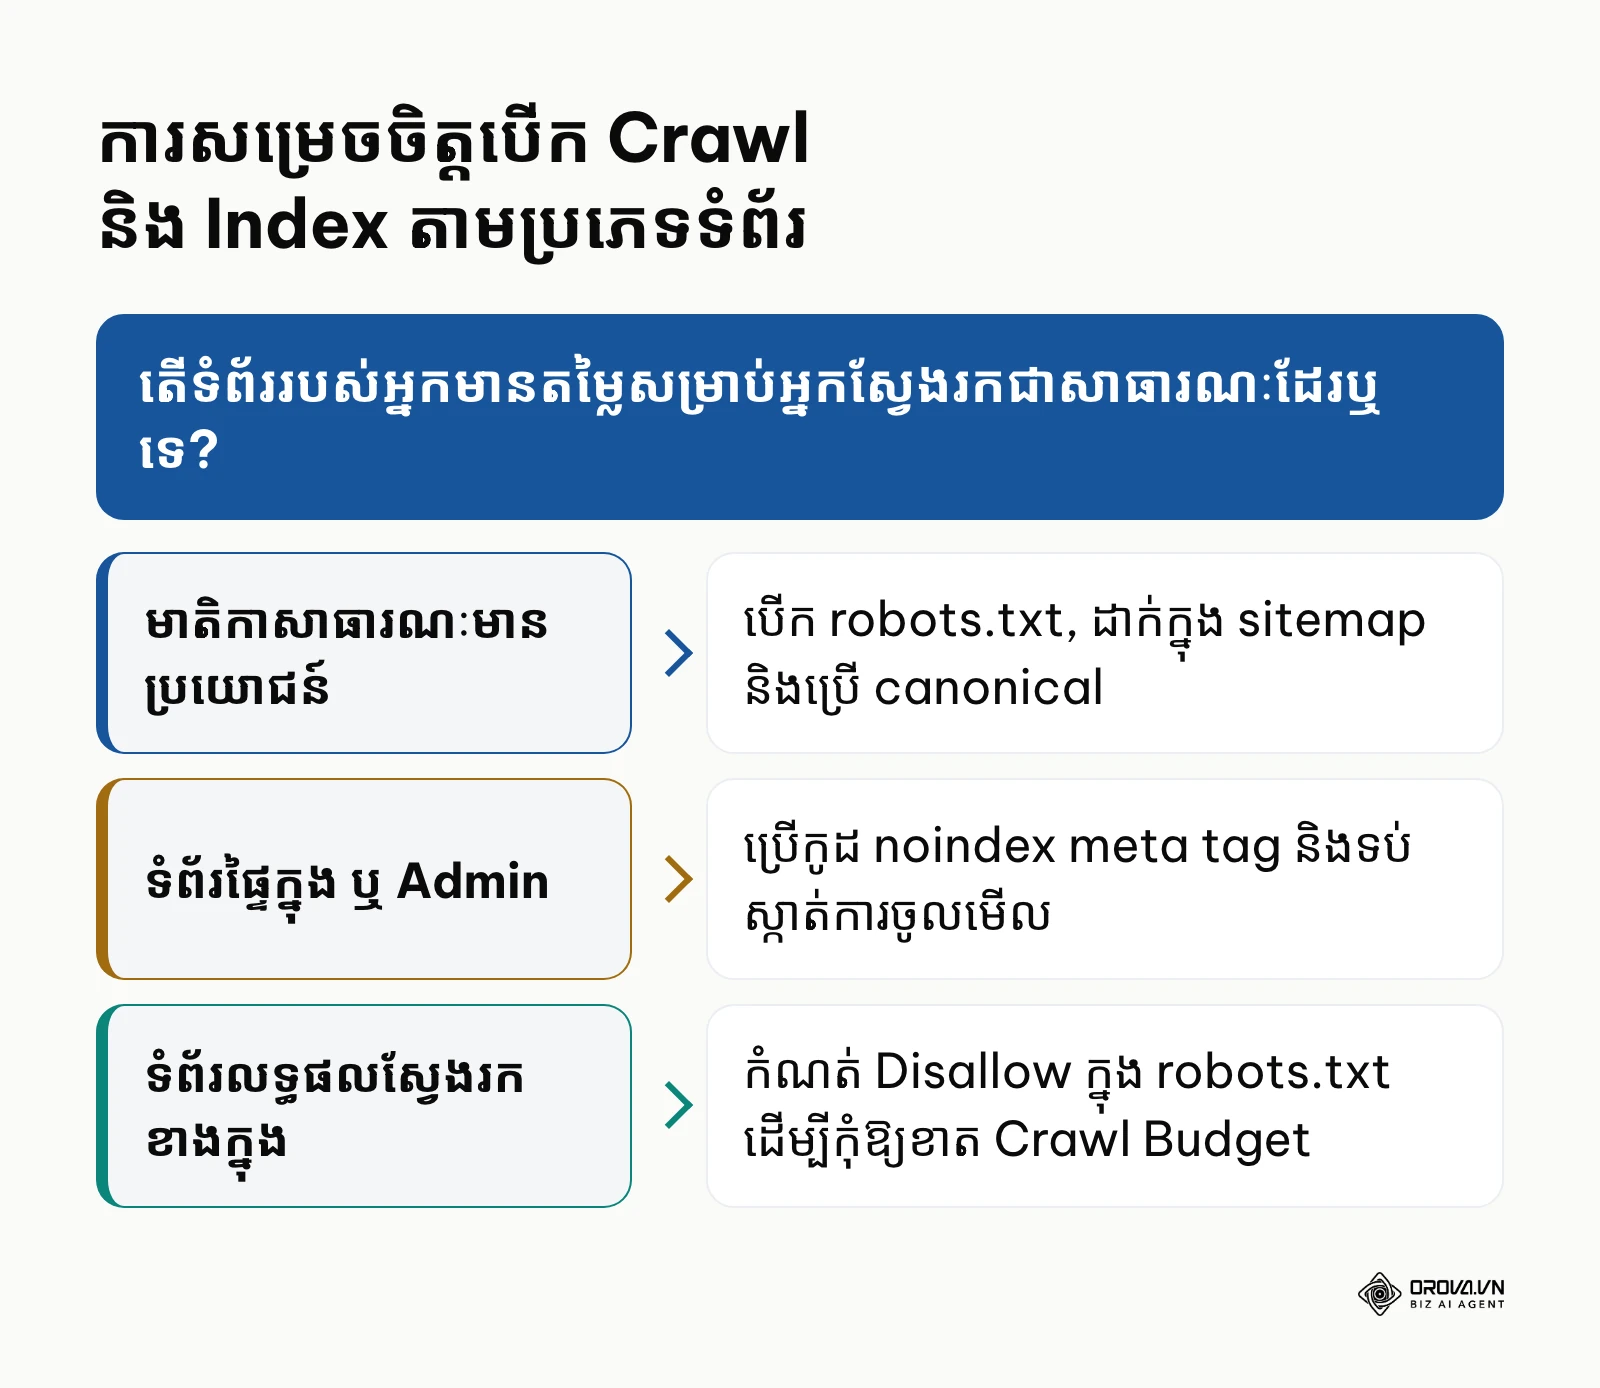
ឧទាហរណ៍សម្រាប់បង្ហាញ៖ គេហទំព័រលក់ទំនិញអេឡិចត្រូនិចខ្នាតមធ្យមមួយដែលមានទំនិញជាង 5,000 មុខ បានប្រឈមមុខនឹងបញ្ហាម៉ាស៊ីនស្វែងរកមិនព្រមចូលអានទំនិញថ្មីៗអស់រយៈពេលជាង 2 ខែ។ អ្នកគ្រប់គ្រងគេហទំព័របានត្រួតពិនិត្យឯកសារ robots.txt ឃើញថាមិនមានការបិទខ្ទប់ឡើយ ប៉ុន្តែនៅពេលពិនិត្យមើលរចនាសម្ព័ន្ធតម្រងទំនិញ (Faceted Navigation) ពួកគេបានរកឃើញថាប្រព័ន្ធបានបង្កើត URL ប៉ារ៉ាម៉ែត្ររាប់សែនទំព័រដោយសារការច្រោះពណ៌ និងទំហំ។ ក្រុមការងារបានបន្ថែមច្បាប់ Disallow លើប៉ារ៉ាម៉ែត្រតម្រងក្នុង robots.txt និងបានកំណត់ canonical tag ចង្អុលទៅកាន់ទំព័រទំនិញដើម។ ជាលទ្ធផលក្នុងរយៈពេល 3 សប្តាហ៍ ម៉ាស៊ីនស្វែងរកបានបង្វែរធនធានមកប្រមូលទិន្នន័យលើទំព័រទំនិញថ្មីៗបានពេញលេញជាងមុន។
ដំណើរការ ៦ ដំណាក់កាលបច្ចេកទេសពី Crawling ដល់ AI Overviews
ដំណើរការបច្ចេកទេសរបស់ម៉ាស៊ីនស្វែងរកមិនមែនជាជំហានទោលនោះទេ ប៉ុន្តែជាខ្សែសង្វាក់ស្វ័យប្រវត្តិកម្មដ៏ស្មុគស្មាញ។ ដើម្បីឱ្យទំព័រមួយអាចបង្ហាញខ្លួននៅលើគេហទំព័រលទ្ធផលស្វែងរក វាត្រូវឆ្លងកាត់ដំណាក់កាលសំខាន់ៗចំនួន 6 ដែលមានការពឹងផ្អែកគ្នាទៅវិញទៅមកយ៉ាងតឹងរ៉ឹង។
ដំណាក់កាលទី 1៖ ការស្វែងរក URL និងការគ្រប់គ្រង Crawl Budget
ដំណាក់កាលដំបូងបង្អស់គឺការស្វែងរកអាសយដ្ឋានគេហទំព័រថ្មីៗតាមរយៈបញ្ជីរង់ចាំដែលហៅថា URL Frontier។ ម៉ាស៊ីនស្វែងរកស្វែងរក URL តាមរយៈវិធីពីរយ៉ាងគឺ ការចុចតាមតំណភ្ជាប់ខាងក្នុង និងក្រៅ (Hyperlinks) និងការអានបញ្ជីឈ្មោះទំព័រដែលបានដាក់ស្នើក្នុងឯកសារ sitemap.xml។
នៅពេលស្វែងរកឃើញ URL ថ្មី ម៉ាស៊ីនស្វែងរកត្រូវគណនាកញ្ចប់ថវិកាប្រមូលទិន្នន័យ (Crawl Budget) សម្រាប់គេហទំព័រនោះ។ Crawl Budget គឺជាចំនួនទំព័រអតិបរមាដែលរ៉ូបូតស្វែងរកមានបំណង និងមានលទ្ធភាពទាញយកក្នុងរយៈពេលជាក់លាក់មួយ ដោយផ្អែកលើកត្តាពីរសំខាន់គឺ៖ Crawl Capacity Limit (សមត្ថភាពផ្ទុករបស់ម៉ាស៊ីនបម្រើគេហទំព័រ) និង Crawl Demand (កម្រិតប្រជាប្រិយភាព និងភាពញឹកញាប់នៃការកែប្រែទំព័រ)។
- សកម្មភាពអនុវត្ត៖ រៀបចំឯកសារ sitemap.xml ឱ្យមានតែទំព័រដែលត្រឹមត្រូវ (កូដ 200 OK) និងបង្កើតរចនាសម្ព័ន្ធតំណភ្ជាប់ផ្ទៃក្នុង (Internal Linking) ឱ្យមានរបៀបរៀបរយ។
- សញ្ញាណជោគជ័យ៖ រ៉ូបូតស្វែងរកចូលមកអានទំព័រថ្មីៗក្នុងរយៈពេលប៉ុន្មានម៉ោងបន្ទាប់ពីការបង្ហោះ។
- កំហុសទូទៅ៖ បណ្តោយឱ្យមានតំណភ្ជាប់ខូច (Broken Links 404) ច្រើនពេក ដែលនាំឱ្យខ្ជះខ្ជាយ Crawl Budget លើទំព័រទទេ។
ដំណាក់កាលទី 2៖ ការប្រមូលទិន្នន័យ (Crawling & Fetching Protocol)
នៅពេល URL ត្រូវបានជ្រើសរើសចេញពីបញ្ជី Frontier កម្មវិធីរ៉ូបូត (ដូចជា Googlebot ឬ Bingbot) នឹងផ្ញើសំណើ HTTP/HTTPS GET ទៅកាន់ម៉ាស៊ីនបម្រើគេហទំព័រដើម្បីទាញយកឯកសារកូដ។ ដំណើរការនេះត្រូវបានគ្រប់គ្រងដោយក្បួនច្បាប់តឹងរ៉ឹងនៅក្នុងឯកសារ robots.txt។
មុនពេលទាញយកទំព័រណាមួយ រ៉ូបូតស្វែងរកត្រូវទាញយក និងពិនិត្យឯកសារ robots.txt ជាមុនសិន។ ប្រសិនបើឯកសារនេះបង្ហាញកូដ Disallow សម្រាប់ URL នោះ រ៉ូបូតនឹងបញ្ឈប់ការទាញយកភ្លាមៗ។ ម៉ាស៊ីនបម្រើគេហទំព័រត្រូវតែឆ្លើយតបមកវិញនូវកូដ HTTP ត្រឹមត្រូវ។ ប្រសិនបើម៉ាស៊ីនបម្រើឆ្លើយតបយឺតយ៉ាវ ឬផ្តល់កូដកំហុស 5xx រ៉ូបូតនឹងបន្ថយល្បឿននៃការប្រមូលទិន្នន័យដើម្បីកុំឱ្យប្រព័ន្ធរបស់អ្នកគាំង។
- សកម្មភាពអនុវត្ត៖ បង្កើនល្បឿនឆ្លើយតបដំបូងរបស់ម៉ាស៊ីនបម្រើ (Time to First Byte - TTFB) ឱ្យនៅក្រោម 0.8 វិនាទី និងពិនិត្យមើលកំណត់ហេតុម៉ាស៊ីនបម្រើ (Server Logs) ជាប្រចាំ។
- សញ្ញាណជោគជ័យ៖ សំណើភាគច្រើនលើសលប់ក្នុងរបាយការណ៍ Crawl Stats ឆ្លើយតបដោយកូដ 200 OK។
- កំហុសទូទៅ៖ ម៉ាស៊ីនបម្រើដួលរលំនៅពេលមានសំណើច្រើន ឬការកំណត់ជញ្ជាំងភ្លើង (Firewall/WAF) រារាំង IP ផ្លូវការរបស់ Search Bot ដោយច្រឡំថាជាការវាយប្រហារ។
ដំណាក់កាលទី 3៖ ការ Render កូដ JavaScript តាមយន្តការ Two-Wave Indexing
គេហទំព័រទំនើបភាគច្រើនដំណើរការដោយពឹងផ្អែកលើ JavaScript (ដូចជា React, Angular, Vue)។ ម៉ាស៊ីនស្វែងរកមិនអាចមើលឃើញមាតិកាពេញលេញភ្លាមៗពីកូដ HTML ដំបូងបានឡើយ ប្រសិនបើទិន្នន័យត្រូវបានទាញយកតាមរយៈ API ក្រោយពេលទំព័រដំណើរការ។ នេះជាមូលហេតុដែលដំណើរការ Two-Wave Indexing ត្រូវបានបង្កើតឡើង។
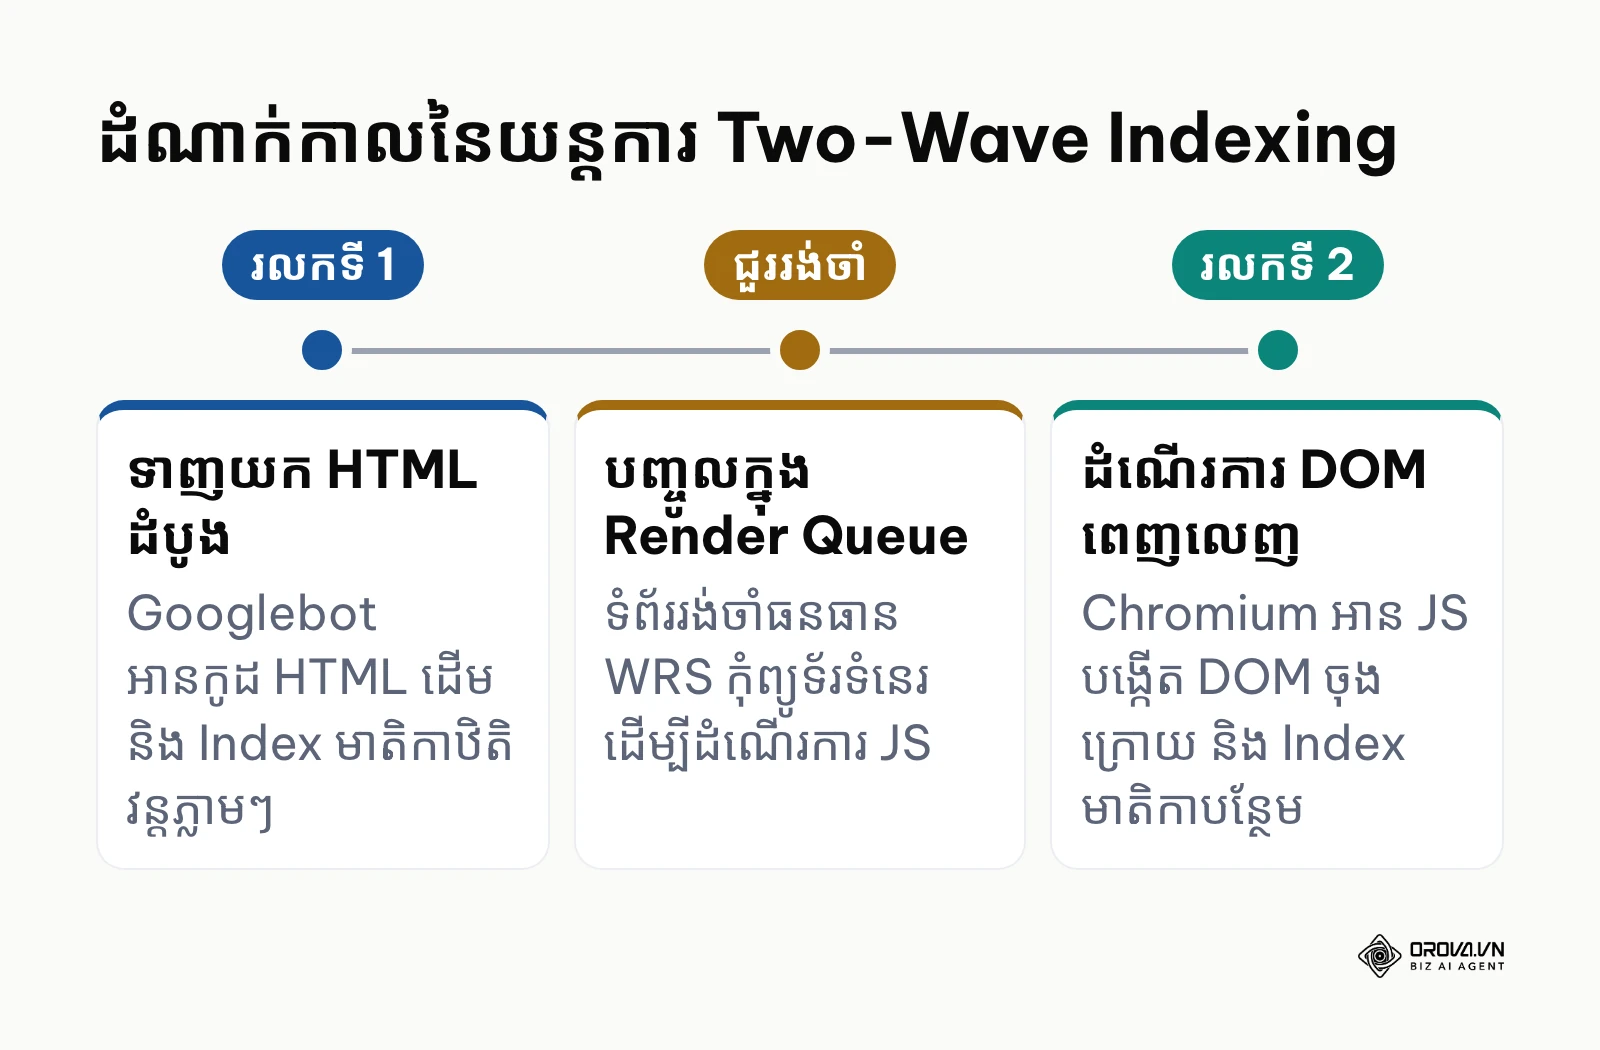
យោងតាមឯកសារ JavaScript SEO basics របស់ Google Search Central ដំណើរការ Render កូដ JavaScript ត្រូវបានដាក់ក្នុងជួររង់ចាំដាច់ដោយឡែក ហើយទំព័រអាចនៅក្នុងជួរនោះពីពីរបីវិនាទី ឬយូរជាងនេះ។ នៅក្នុងរលកទីមួយ (First Wave) ម៉ាស៊ីនស្វែងរកអានតែ HTML និង CSS ដើមប៉ុណ្ណោះ។ ប្រសិនបើមាតិការបស់អ្នកបង្ហាញតាមរយៈ Client-Side Rendering (CSR) ម៉ាស៊ីនស្វែងរកនឹងឃើញតែទំព័រទទេ ហើយត្រូវរុញទំព័រនោះទៅកាន់ជួររង់ចាំ Render Queue។ នៅក្នុងរលកទីពីរ (Second Wave) កម្មវិធី Web Rendering Service (WRS) ដែលដំណើរការលើ Chromium គ្មានចំណុចប្រទាក់ (Headless Chromium) នឹងបើកកូដ JavaScript ដើម្បីបង្កើត Document Object Model (DOM) ពេញលេញមុននឹងបញ្ជូនទៅដំណាក់កាលបន្ទាប់។
- សកម្មភាពអនុវត្ត៖ ប្រើប្រាស់បច្ចេកវិទ្យា Server-Side Rendering (SSR) ឬ Static Site Generation (SSG) ដើម្បីធានាថាកូដ HTML ដើមមានបង្កប់មាតិកាអត្ថបទពេញលេញរួចជាស្រេច។
- សញ្ញាណជោគជ័យ៖ នៅពេលប្រើឧបករណ៍ របៀបប្រើ Google Search Console ពិនិត្យតាមរយៈ URL Inspection Test Live ទិដ្ឋភាពអេក្រង់បង្ហាញមាតិកាពេញលេញដូចអ្នកប្រើប្រាស់ពិតប្រាកដ។
- កំហុសទូទៅ៖ បិទឯកសារ .js ក្នុង robots.txt ឬប្រើកូដ API ដែលទាមទារការចុចពីអ្នកប្រើប្រាស់ទើបបង្ហាញអត្ថបទ។
ដំណាក់កាលទី 4៖ ការវិភាគ និងបញ្ចូលទិន្នន័យទៅក្នុង Inverted Index
បន្ទាប់ពីទំព័រត្រូវបាន Render រួចរាល់ ម៉ាស៊ីនស្វែងរកនឹងចាប់ផ្តើមដំណើរការទិន្នន័យ (Processing) ដើម្បីរៀបចំបញ្ចូលទៅក្នុងឃ្លាំងទិន្នន័យមេ ដែលហៅថា Inverted Index។ Inverted Index គឺជាមូលដ្ឋានទិន្នន័យដ៏ធំធេងដែលរៀបចំស្រដៀងនឹងសន្ទស្សន៍នៅទំព័រចុងក្រោយនៃសៀវភៅ ដោយវាផ្គូផ្គងរាល់ពាក្យនីមួយៗជាមួយនឹងបញ្ជីទំព័រដែលផ្ទុកពាក្យនោះ។
ក្នុងដំណាក់កាលនេះ ម៉ាស៊ីនស្វែងរកនឹងធ្វើការបំបែកពាក្យ (Tokenization) សម្អាតកូដដែលមិនចាំបាច់ និងវិភាគទីតាំងនៃពាក្យគន្លឹះ (ក្នុងចំណងជើង H1, H2, អត្ថបទកថាខណ្ឌ ឬ alt text នៃរូបភាព)។ លើសពីនេះ ម៉ាស៊ីនស្វែងរកនឹងដំណើរការក្បួនស្វែងរកទំព័រស្ទួន (Deduplication) ដោយជ្រើសរើសយក URL តែមួយគត់ធ្វើជាតំណាង (Canonical URL)។ ប្រសិនបើទំព័ររបស់អ្នកមានមាតិកាដូចគេ ឬមានគុណភាពទាបពេក ម៉ាស៊ីនស្វែងរកអាចសម្រេចចិត្តមិនបញ្ចូលក្នុង Index ឡើយ។
- សកម្មភាពអនុវត្ត៖ បង្កប់ទិន្នន័យរចនាសម្ព័ន្ធ Schema Markup ឱ្យបានត្រឹមត្រូវ និងសរសេរមាតិកាដើមដែលប្លែកពីគេ។
- សញ្ញាណជោគជ័យ៖ ទំព័របង្ហាញស្ថានភាព "Indexed" យ៉ាងឆាប់រហ័សក្នុងផ្ទាំងគ្រប់គ្រងគេហទំព័រ។
- កំហុសទូទៅ៖ មានបញ្ហាខ្លឹមសារស្ទួនគ្នាច្រើនដោយសារការប្រើប្រាស់ URL ច្រើនទម្រង់ (http/https, www/non-www, trailing slash) ដោយគ្មាន canonical tag។
ដំណាក់កាលទី 5៖ ការវាយតម្លៃ និងចាត់ចំណាត់ថ្នាក់តាមក្បួនដោះស្រាយ
នៅពេលអ្នកប្រើប្រាស់វាយពាក្យស្វែងរកចូលទៅក្នុងប្រព័ន្ធ ម៉ាស៊ីនស្វែងរកមិនស្កេនអ៊ីនធឺណិតទាំងមូលនោះទេ ប៉ុន្តែវាស្វែងរកនៅក្នុង Inverted Index ដែលបានរៀបចំទិន្នន័យរួចជាស្រេច។ ដំណើរការផ្គូផ្គង និងចាត់ចំណាត់ថ្នាក់នេះកើតឡើងក្នុងរយៈពេលតិចជាងមួយវិនាទីតាមរយៈក្បួនដោះស្រាយរាប់រយ។
ក្បួនដោះស្រាយទំនើបលែងពឹងផ្អែកតែលើការរាប់ចំនួនពាក្យគន្លឹះដូចពីមុនទៀតហើយ។ គិតត្រឹមឆ្នាំ 2026 ម៉ាស៊ីនស្វែងរកប្រើប្រាស់ប្រព័ន្ធបញ្ញាសិប្បនិម្មិតកម្រិតខ្ពស់ដូចជា RankBrain, BERT និង MUM ដើម្បីស្វែងយល់ពីអត្ថន័យស៊ីជម្រៅ (Semantic Search) និងបរិបទនៃសំណួរ។ កត្តាកំណត់ចំណាត់ថ្នាក់សំខាន់ៗ និងអ្វីដែលអ្នកអាចធ្វើបាន៖
| កត្តា | អ្វីដែលម៉ាស៊ីនស្វែងរកពិនិត្យ | សកម្មភាពសម្រាប់គេហទំព័ររបស់អ្នក |
|---|---|---|
| Relevance | ភាពពាក់ព័ន្ធរវាងមាតិកា និងអត្ថន័យនៃសំណួរ | ឆ្លើយចំបំណងស្វែងរកក្នុងកថាខណ្ឌដំបូង |
| E-E-A-T | បទពិសោធន៍ ជំនាញ អាជ្ញាធរ និងទំនុកចិត្ត | បង្ហាញអ្នកនិពន្ធ ប្រភព និងទិន្នន័យដើម |
| Backlinks | គុណភាពតំណភ្ជាប់យោងពីគេហទំព័រផ្សេង | បង្កើតមាតិកាដែលអ្នកដទៃចង់យោង |
| Core Web Vitals | ល្បឿន និងស្ថិរភាពនៃការបង្ហាញទំព័រ | កែលម្អ LCP, INP និង CLS |
| Offline vs Online | Index ត្រូវរៀបចំទុកមុន ចំណែកការចាត់ថ្នាក់កើតឡើងពេលមានសំណួរ | ធានាថាទំព័រត្រូវបាន Index មុនពេលរំពឹងចំណាត់ថ្នាក់ |
- សកម្មភាពអនុវត្ត៖ បង្កើតមាតិកាដែលឆ្លើយតបចំតម្រូវការស្វែងរក (Search Intent) និងពង្រឹងរចនាសម្ព័ន្ធបច្ចេកទេសគេហទំព័រតាមរយៈការធ្វើ technical SEO audit services ជាប្រចាំ។
- សញ្ញាណជោគជ័យ៖ ទំព័រទទួលបានចំណាត់ថ្នាក់ក្នុងទំព័រទីមួយសម្រាប់ពាក្យគន្លឹះគោលដៅ និងពាក្យគន្លឹះពាក់ព័ន្ធជាច្រើនទៀត។
- កំហុសទូទៅ៖ ការញាត់ពាក្យគន្លឹះច្រើនហួសហេតុ (Keyword Stuffing) ឬការបង្កើតមាតិកាស្តើងដែលមិនបានផ្តល់ដំណោះស្រាយពិតប្រាកដ។
ដំណាក់កាលទី 6៖ ការទាញយកព័ត៌មានដោយ AI Overviews និងស្ថាបត្យកម្ម RAG
ការវិវត្តដ៏ធំបំផុតមួយនៅក្នុងបច្ចេកវិទ្យាម៉ាស៊ីនស្វែងរកបច្ចុប្បន្ន គឺការដាក់ឱ្យប្រើប្រាស់មុខងារសង្ខេបចម្លើយដោយស្វ័យប្រវត្តិតាមរយៈ AI Overviews។ យន្តការនេះមិនដំណើរការដោយគ្រាន់តែបង្កើតអត្ថបទដោយការស្មានដូចកម្មវិធីសន្ទនាទូទៅនោះទេ ប៉ុន្តែវាពឹងផ្អែកលើស្ថាបត្យកម្ម Retrieval-Augmented Generation (RAG)។
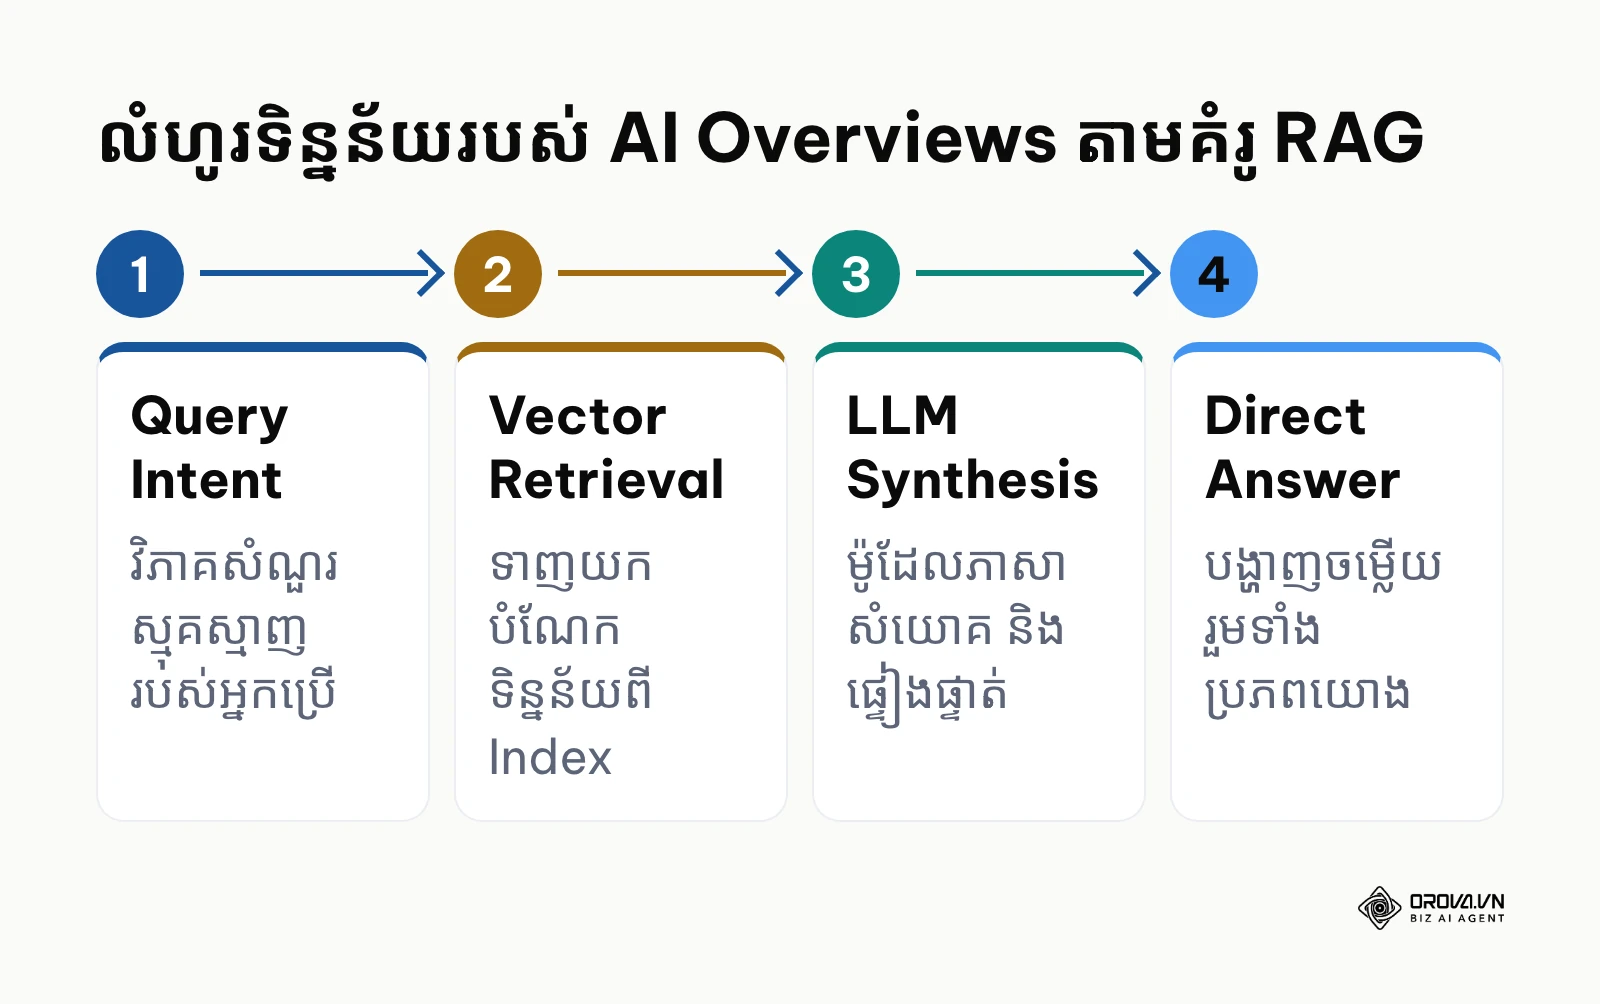
ដំណើរការ RAG ចាប់ផ្តើមដោយការបំប្លែងសំណួររបស់អ្នកប្រើប្រាស់ទៅជា Vector Embeddings ដើម្បីទាញយកកថាខណ្ឌ ឬបំណែកទិន្នន័យជាក់លាក់ដែលពាក់ព័ន្ធបំផុតចេញពីឃ្លាំង Index។ បន្ទាប់មក ម៉ូដែលភាសាធំ (Large Language Model) នឹងដំណើរការសំយោគព័ត៌មានទាំងនោះក្នុងពេលវេលាជាក់ស្តែង ដើម្បីបង្កើតជាចម្លើយសង្ខេបដ៏ច្បាស់លាស់នៅផ្នែកខាងលើនៃទំព័រលទ្ធផល ព្រមទាំងភ្ជាប់ជាមួយតំណភ្ជាប់យោងទៅកាន់ប្រភពដើម។ ប្រសិនបើមាតិការបស់អ្នកមានរចនាសម្ព័ន្ធចម្លើយខ្លី ខ្លឹមសារត្រឹមត្រូវ និងងាយស្រួលស្រង់យក ប្រព័ន្ធ AI នឹងជ្រើសរើសទំព័ររបស់អ្នកជាឯកសារយោងផ្លូវការ។
- សកម្មភាពអនុវត្ត៖ ផ្តល់ចម្លើយសង្ខេប 40–60 ពាក្យភ្លាមៗនៅក្រោមចំណងជើងរងនីមួយៗ ប្រើប្រាស់តារាងប្រៀបធៀប និងបញ្ជីរាយនាមដែលមានទិន្នន័យច្បាស់លាស់។
- សញ្ញាណជោគជ័យ៖ គេហទំព័ររបស់អ្នកលេចឡើងជាប្រភពយោង (Citation Link) នៅក្នុងប្រអប់ AI Overviews។
- កំហុសទូទៅ៖ ការសរសេររៀបរាប់វែងអន្លាយគ្មានចំណុចកណ្តាល ឬការផ្តល់ព័ត៌មានមិនច្បាស់លាស់ដែលធ្វើឱ្យម៉ូដែល AI មិនអាចស្រង់ទិន្នន័យបាន។
ឧទាហរណ៍សម្រាប់បង្ហាញ៖ ក្រុមហ៊ុនផ្តល់សេវាកម្មផ្នែកទន់មួយបានបង្កើតគេហទំព័រថ្មីដោយប្រើប្រាស់ Single Page Application (SPA)។ បន្ទាប់ពីដាក់ឱ្យដំណើរការអស់រយៈពេល 3 ខែ ទំព័រអត្ថបទប្លុករបស់ពួកគេមិនទទួលបានការ Index សូម្បីតែមួយទំព័រ។ ក្រុមការងារបានពិនិត្យមើលតាមរយៈ URL Inspection រួចរកឃើញថាម៉ាស៊ីនស្វែងរកមើលឃើញត្រឹមតែស្លាក <div id="root"></div> ប៉ុណ្ណោះ ដោយសារកូដ JavaScript ដំណើរការយឺតពេករហូតដល់អស់ពេលកំណត់ (Timeout) របស់ WRS។ ពួកគេបានសម្រេចចិត្តប្តូរស្ថាបត្យកម្មទៅជា Server-Side Rendering (SSR) ដោយប្រើ Next.js ដើម្បីបញ្ជូនកូដ HTML ពេញលេញពីម៉ាស៊ីនបម្រើ។ ក្នុងរយៈពេលត្រឹមតែ 10 ថ្ងៃប៉ុណ្ណោះ ទំព័រភាគច្រើនចាប់ផ្តើមត្រូវបាន Google ចូលអាន និងដាក់បញ្ចូលក្នុង Index។
ស្វែងយល់អំពី Orova.vn – វេទិកា Biz AI Agent ជាមួយដំណោះស្រាយ OROVA SEO ពេញលេញសម្រាប់គេហទំព័រទាំងអស់។ ប្រព័ន្ធនេះជួយបង្កើនប្រសិទ្ធភាពម៉ាស៊ីនស្វែងរកពី A ដល់ Z ជាមួយមុខងារ៖ ការស្រាវជ្រាវពាក្យគន្លឹះ ការសរសេរអត្ថបទថ្មីតាមស្តង់ដារ SEO ការបង្កើនប្រសិទ្ធភាពខ្លឹមសារចាស់ ការតាមដានចំណាត់ថ្នាក់ ព្រមទាំងសមត្ថភាពវិភាគគូប្រកួត និងវិភាគបច្ចេកទេសស៊ីជម្រៅ។ ចុះឈ្មោះថ្ងៃនេះដើម្បីប្រើប្រាស់ OROVA SEO ដោយឥតគិតថ្លៃទាំងស្រុង (ការផ្តល់ជូននេះមានសុពលភាពដល់ថ្ងៃទី ៧ ខែកក្កដា ឆ្នាំ ២០២៧)។
ការវិភាគស៊ីជម្រៅ៖ ម៉ាទ្រីសដោះស្រាយបញ្ហា Indexing និងកត្តាកំណត់លទ្ធផល SEO
បញ្ហាធំបំផុតដែលអ្នកគ្រប់គ្រងគេហទំព័រតែងតែជួបប្រទះ មិនមែនជាការយល់ដឹងពីទ្រឹស្តីនោះទេ ប៉ុន្តែជាការប្រឈមមុខនឹងស្ថានភាពជាក់ស្តែងនៅពេល Google Search Console រាយការណ៍ថាមិនអាច Index ទំព័របាន។ ខាងក្រោមនេះជាម៉ាទ្រីសដោះស្រាយបញ្ហាជាក់ស្តែងទាំង 6 ដែលកើតឡើងញឹកញាប់បំផុត។
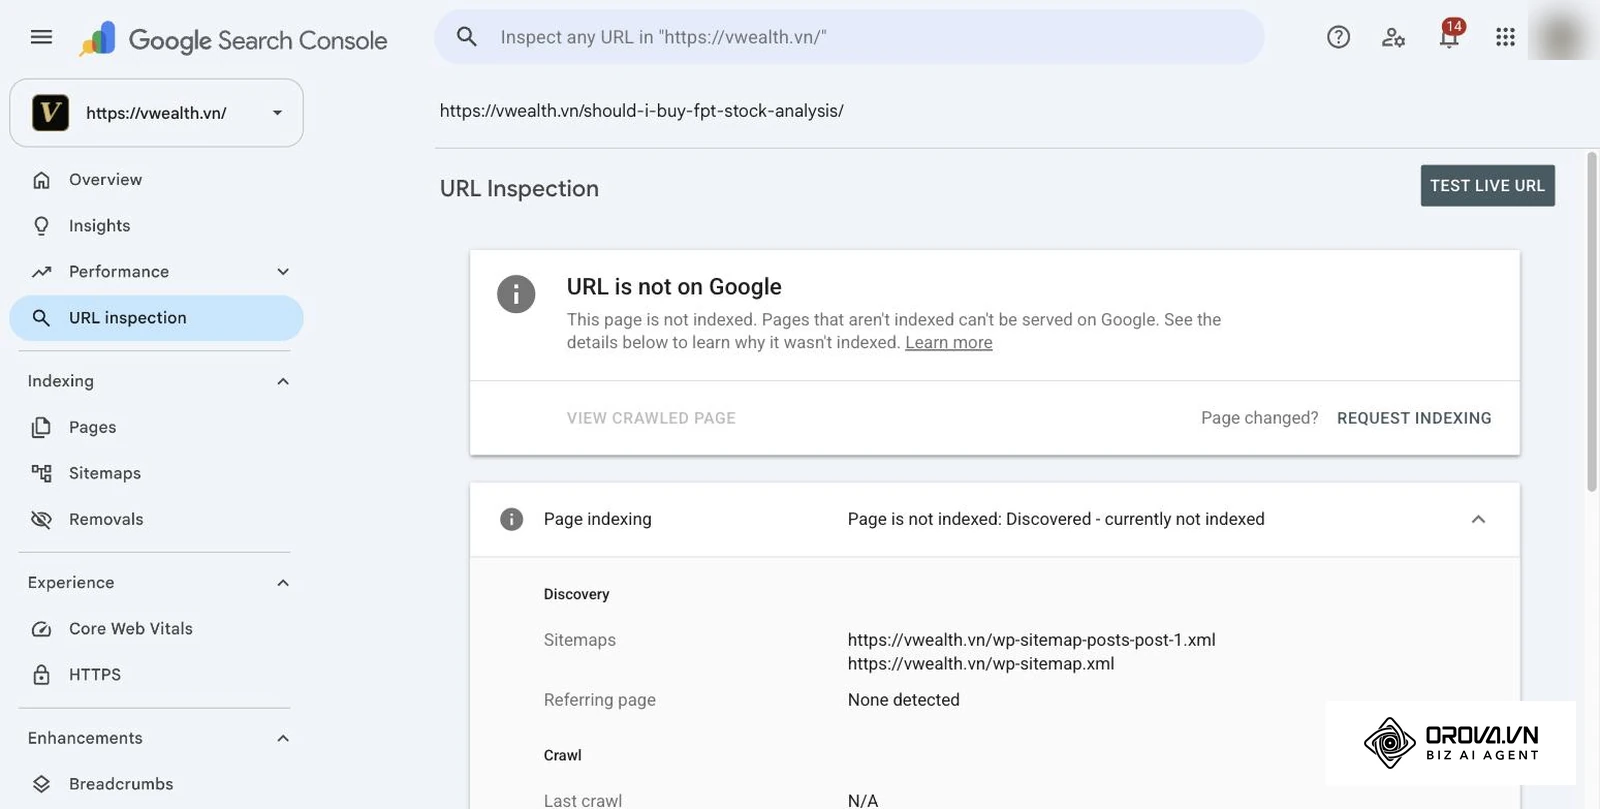
| ស្ថានភាពក្នុង GSC | មូលហេតុបច្ចេកទេសពិតប្រាកដ | ហានិភ័យចំពោះ SEO | សកម្មភាពដោះស្រាយភ្លាមៗ | រយៈពេល Google ធ្វើបច្ចុប្បន្នភាព |
|---|---|---|---|---|
| Crawled - currently not indexed | Googlebot បានអានទំព័ររួចហើយ ប៉ុន្តែវាយតម្លៃថាមាតិកាមានគុណភាពទាប ស្ទួន ឬមិនទាន់ដល់កម្រិតគុណភាពដែលត្រូវរក្សាទុក | ទំព័រមិនបង្ហាញលើលទ្ធផលស្វែងរក និងខ្ជះខ្ជាយធនធាន Crawl | បន្ថែមទិន្នន័យជាក់ស្តែង កែសម្រួលមាតិកាឱ្យស៊ីជម្រៅ លុបផ្នែកចម្លង និងបន្ថែម internal link ពីទំព័រខ្លាំងៗ | 2 ទៅ 6 សប្តាហ៍ |
| Discovered - currently not indexed | Google ដឹងថាមាន URL នេះ (តាម sitemap ឬ link) ប៉ុន្តែមិនទាន់បានចូលអានដោយសារម៉ាស៊ីនបម្រើយឺត ឬ Crawl Budget អស់ | ទំព័រថ្មីត្រូវរង់ចាំយូរខកខានឱកាសប្រកួតប្រជែង | បង្កើនល្បឿនម៉ាស៊ីនបម្រើ កាត់បន្ថយ URL ឥតប្រយោជន៍ និងភ្ជាប់ link ពីទំព័រមេ | 1 ទៅ 4 សប្តាហ៍ |
| Duplicate without user-selected canonical | ទំព័រមានខ្លឹមសារដូច ឬស្រដៀងនឹងទំព័រផ្សេងទៀត ប៉ុន្តែអ្នកមិនបានដាក់ស្លាក canonical ដើម្បីបញ្ជាក់ | Google នឹងជ្រើសរើស URL ដោយខ្លួនឯង ឬមិន Index ទាំងពីរ | បន្ថែមស្លាក <link rel="canonical"> ចង្អុលទៅ URL ចម្បងតែមួយគត់ | 1 ទៅ 2 សប្តាហ៍ |
| Excluded by 'noindex' tag | មានស្លាក meta robots 'noindex' ឬ header response បញ្ជាមិនឱ្យដាក់ក្នុងបញ្ជី | ទំព័រនឹងត្រូវដកចេញពីលទ្ធផលស្វែងរកទាំងស្រុង | ពិនិត្យកូដ <head> ឬការកំណត់ SEO plugin ដើម្បីដកពាក្យ 'noindex' ចេញ | 3 ទៅ 7 ថ្ងៃ |
| Page with redirect | URL កំពុងបញ្ជូនបន្ត (301 ឬ 302) ទៅកាន់ទំព័រផ្សេងទៀត | មិនមានហានិភ័យធ្ងន់ធ្ងរ ប៉ុន្តែមិនគួរដាក់ URL បញ្ជូនបន្តក្នុង sitemap.xml ឡើយ | ធ្វើបច្ចុប្បន្នភាព sitemap.xml ដោយជំនួសដោយ URL ចុងក្រោយដែលត្រឹមត្រូវ | 1 ទៅ 2 សប្តាហ៍ |
| Alternate page with proper canonical tag | ទំព័រនេះជាទម្រង់ជំនួស (ដូចជាទម្រង់ទូរស័ព្ទ ឬ AMP) ហើយបានកំណត់ canonical ត្រឹមត្រូវ | ធម្មតា គ្មានហានិភ័យ (នេះជាសញ្ញាបង្ហាញថាប្រព័ន្ធដំណើរការត្រូវ) | មិនបាច់កែប្រែអ្វីឡើយ ប្រសិនបើ URL ចម្បងត្រូវបាន Index រួចរាល់ | គ្មាន |
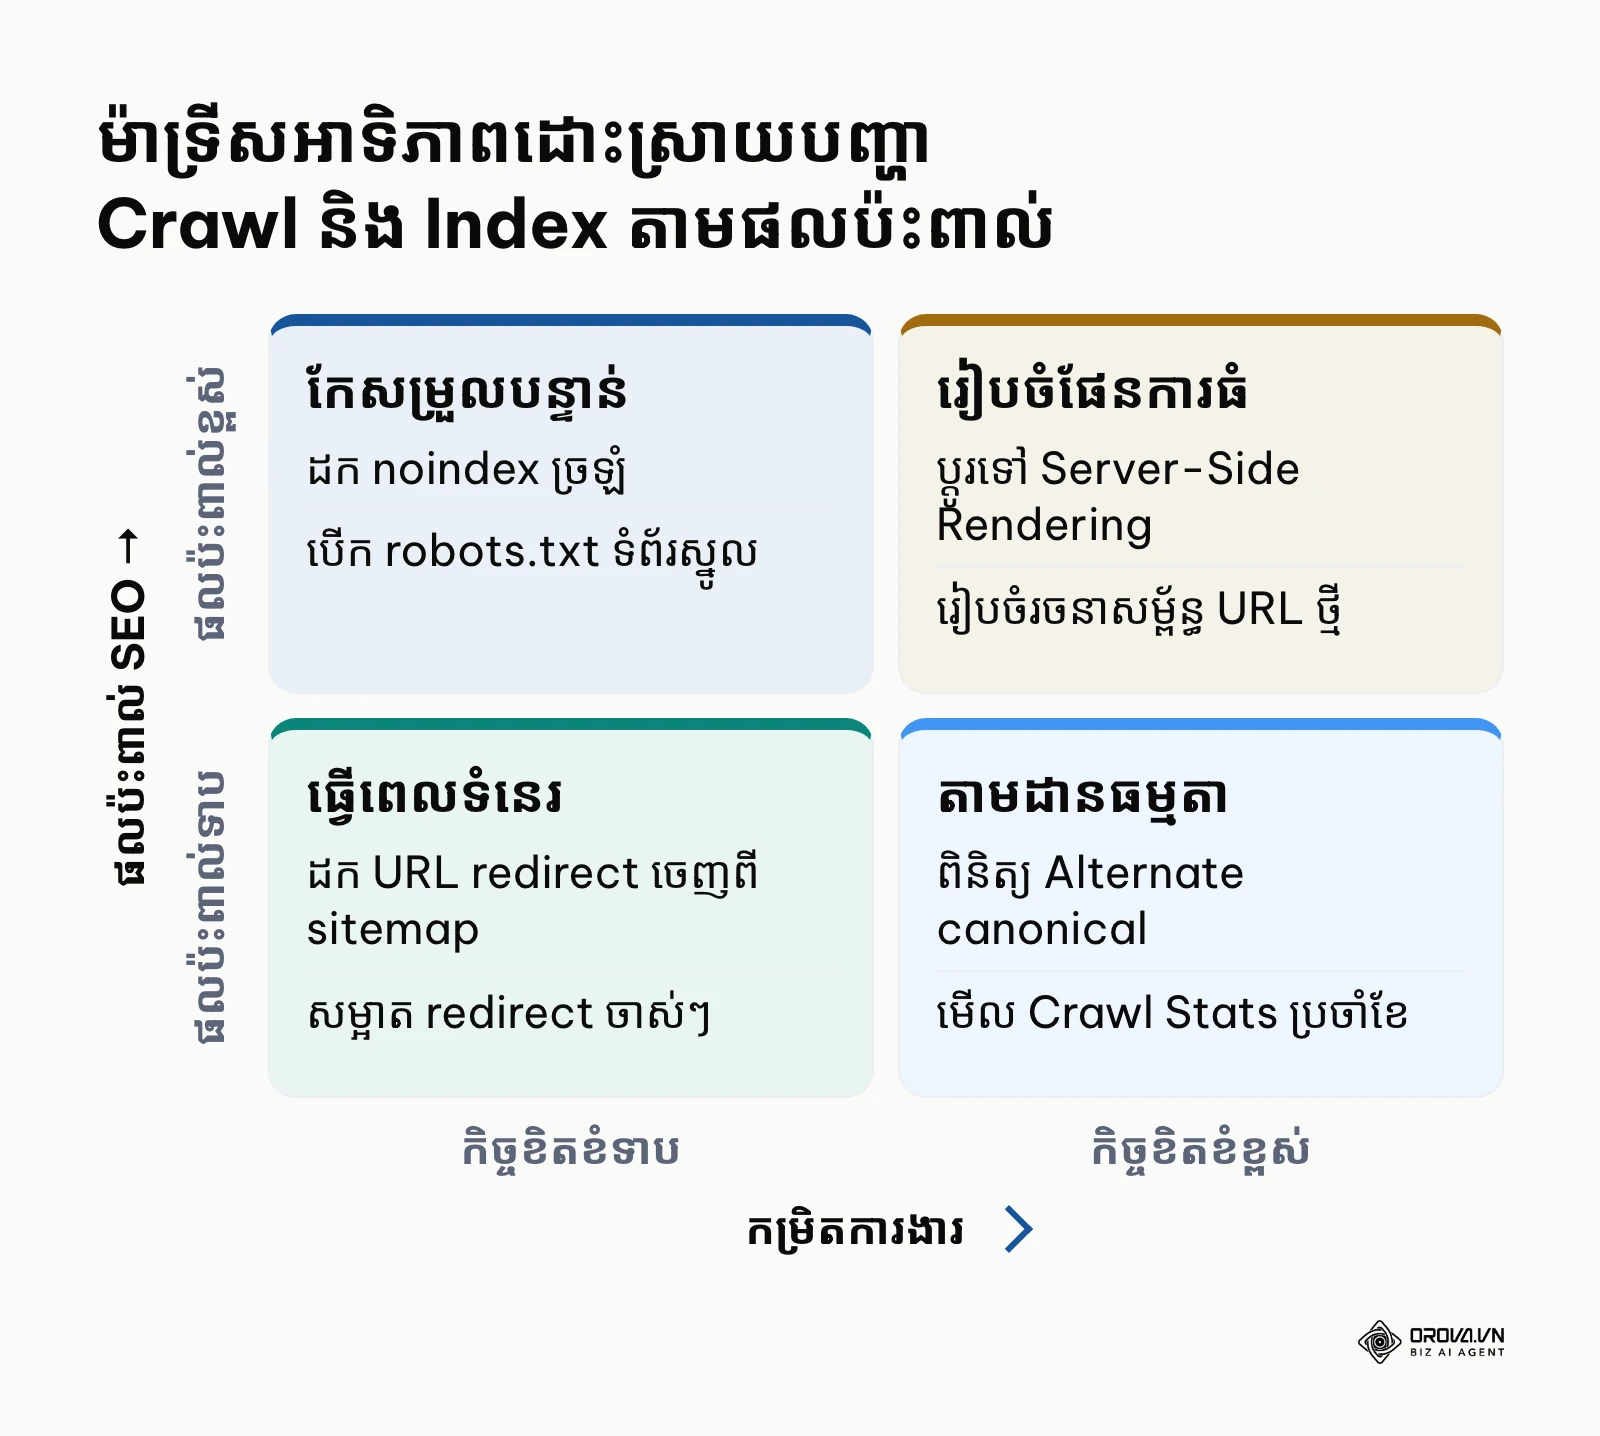
ដើម្បីការពារកុំឱ្យកើតមានបញ្ហាខាងលើ អ្នកអាចប្រើប្រាស់បញ្ជីត្រួតពិនិត្យបច្ចេកទេស 12 ចំណុចនេះដើម្បីវាយតម្លៃគេហទំព័ររបស់អ្នក៖
- ឯកសារ robots.txt មិនត្រូវបានកំណត់ឱ្យបិទ (Disallow: /) លើទំព័រដែលចង់ឱ្យមានចំណាត់ថ្នាក់ឡើយ។
- ឯកសារធនធាន CSS និង JavaScript មិនត្រូវបានទប់ស្កាត់ ដែលអាចរារាំងដំណើរការ Rendering។
- ឯកសារ sitemap.xml ត្រូវបានដាក់ស្នើត្រឹមត្រូវ និងមានតែ URL ដែលឆ្លើយតបកូដ 200 OK។
- រាល់ទំព័រទាំងអស់មានស្លាក rel="canonical" ចង្អុលបង្ហាញអាសយដ្ឋានត្រឹមត្រូវជានិច្ច។
- គ្មានការប្រើប្រាស់ស្លាក noindex ដោយអចេតនានៅលើបរិស្ថានផ្សាយផ្ទាល់ (Live Production)។
- ម៉ាស៊ីនបម្រើឆ្លើយតបកូដ HTTP Status Code ត្រឹមត្រូវ (កូដ 200 សម្រាប់ទំព័រធម្មតា, 404/410 សម្រាប់ទំព័រដែលលុប)។
- ពិធីការ HTTPS ដំណើរការត្រឹមត្រូវដោយគ្មានកំហុសចម្រុះ (Mixed Content)។
- រចនាសម្ព័ន្ធ URL មានភាពសាមញ្ញ មិនផ្ទុកប៉ារ៉ាម៉ែត្រ Session ID ឬ Tracking ច្រើនហួសហេតុ។
- មាតិកាសំខាន់ៗត្រូវបានបង្កប់ក្នុងកូដ HTML ដំបូងដោយមិនពឹងផ្អែកទាំងស្រុងលើការចុចរបស់អ្នកប្រើប្រាស់។
- តំណភ្ជាប់ផ្ទៃក្នុង (Internal Links) ប្រើប្រាស់ស្លាក a ដែលមាន href ស្តង់ដារ មិនប្រើប្រាស់ JavaScript onclick។
- ល្បឿនឆ្លើយតបរបស់ម៉ាស៊ីនបម្រើ (TTFB) មានកម្រិតលឿនជាង 0.8 វិនាទីនៅគ្រប់តំបន់។
- រចនាសម្ព័ន្ធទិន្នន័យ Schema Markup ត្រូវបានផ្ទៀងផ្ទាត់ដោយគ្មានកំហុសបច្ចេកទេសធ្ងន់ធ្ងរ។
ក្រៅពីការដោះស្រាយកំហុស ការជ្រើសរើសវិធីសាស្ត្រស្ថាបត្យកម្មគេហទំព័រក៏មានផលប៉ះពាល់យ៉ាងខ្លាំងទៅលើសមត្ថភាពប្រមូលទិន្នន័យ និង Index ផងដែរ។ តារាងខាងក្រោមប្រៀបធៀបស្ថាបត្យកម្មបច្ចេកទេសទាំងបីដែលគេពេញនិយមប្រើប្រាស់បំផុត៖
| ស្ថាបត្យកម្មគេហទំព័រ | ភាពងាយស្រួលសម្រាប់ម៉ាស៊ីនស្វែងរក | សមស្របសម្រាប់ករណីណា | ចំណុចខ្សោយផ្នែក SEO |
|---|---|---|---|
| Server-Side Rendering (SSR) | ខ្ពស់បំផុត (HTML ពេញលេញត្រូវបញ្ជូនភ្លាមៗ) | គេហទំព័រព័ត៌មាន ប្លុក និងពាណិជ្ជកម្មអេឡិចត្រូនិចធំៗ | ទាមទារធនធានម៉ាស៊ីនបម្រើខ្លាំង និងការចំណាយខ្ពស់ |
| Static Site Generation (SSG) | ខ្ពស់បំផុត (ឯកសារ HTML ត្រូវបានបង្កើតទុកជាមុន) | គេហទំព័រអាជីវកម្មទូទៅ ឯកសារបច្ចេកទេស និងប្លុកផ្ទាល់ខ្លួន | ចំណាយពេលយូរក្នុងការ Build ឡើងវិញនៅពេលមានទំព័រច្រើន |
| Client-Side Rendering (CSR) | ទាប (ទាមទារដំណើរការ Two-Wave Rendering) | ផ្ទាំងគ្រប់គ្រងខាងក្នុង (Dashboard) ឬកម្មវិធីបិទជិត | ងាយនឹងជួបបញ្ហាទំព័រទទេ និងពន្យារពេល Index យូរ |
រង្វាស់ និងការតាមដានប្រសិទ្ធភាព Crawl និង Index លើគេហទំព័រ
ការយល់ដឹងពីដំណើរការម៉ាស៊ីនស្វែងរកនឹងមិនមានន័យពេញលេញឡើយ ប្រសិនបើអ្នកមិនដឹងពីរបៀបវាស់វែងលទ្ធផលបច្ចេកទេស។ ការតាមដានសុខភាពគេហទំព័រគួរតែធ្វើឡើងជាប្រចាំសប្តាហ៍ និងប្រចាំខែតាមរយៈទិន្នន័យជាក់ស្តែង។
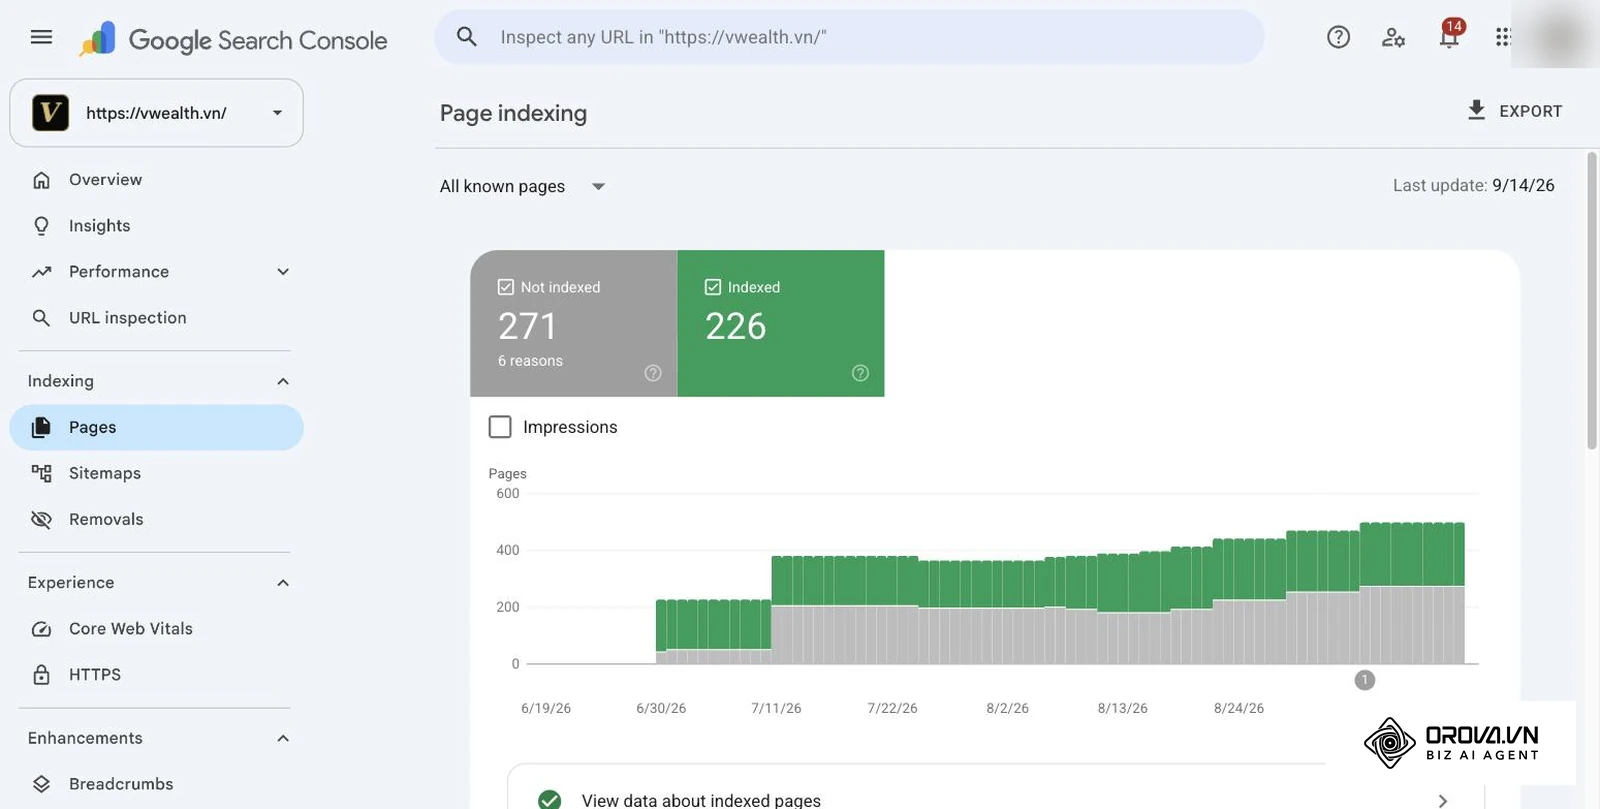
ទិន្នន័យទាំងនេះអាចមើលបានដោយផ្ទាល់នៅក្នុង Google Search Console ក្រោមផ្ទាំង "Page Indexing" និង "Crawl Stats" ព្រមទាំងការវិភាគកំណត់ហេតុផ្ទាល់របស់ម៉ាស៊ីនបម្រើ (Server Access Logs)។ ការពិនិត្យមើលតែតួលេខចរាចរណ៍សរុបតែមួយមុខមិនអាចប្រាប់អ្នកបានទេថាតើម៉ាស៊ីនស្វែងរកកំពុងជួបបញ្ហាប្រមូលទិន្នន័យលើគេហទំព័ររបស់អ្នកឬយ៉ាងណា។
| សូចនាករបច្ចេកទេស | អត្ថន័យ និងតួនាទី | កម្រិតណែនាំដែលគួរពិនិត្យ (មិនមែនស្តង់ដារផ្លូវការរបស់ Google) |
|---|---|---|
| Crawl Requests កើនឡើងខុសប្រក្រតី | ចំនួនសំណើដែល Googlebot ផ្ញើមកកាន់ម៉ាស៊ីនបម្រើក្នុងមួយថ្ងៃ | ធ្លាក់ចុះភ្លាមៗលើសពី 50% ឬកើនឡើងខ្លាំងលើទំព័រ 404 |
| Average Response Time | រយៈពេលមធ្យមដែលម៉ាស៊ីនបម្រើប្រើដើម្បីឆ្លើយតបសំណើ | លើសពី 1,000 មីលីវិនាទី (1 វិនាទី) ជាបន្តបន្ទាប់ |
| Valid Pages Ratio | សមាមាត្រទំព័រដែលត្រូវបាន Index ធៀបនឹងទំព័រក្នុង sitemap | ទាបជាង 85% នៃចំនួនទំព័រសរុបដែលបានដាក់ស្នើ |
| Crawled - currently not indexed | ចំនួនទំព័រដែលត្រូវបានអានតែបដិសេធមិនដាក់ក្នុងបញ្ជី | លើសពី 15% នៃទំព័រមាតិកាសរុបលើគេហទំព័រ |
| 5xx Server Error Rate | អត្រាសំណើដែលម៉ាស៊ីនបម្រើដួលរលំមិនអាចឆ្លើយតប | លើសពី 1% នៃសំណើសរុបរបស់ Search Bot |
ឧទាហរណ៍សម្រាប់បង្ហាញ៖ គេហទំព័រព័ត៌មានមួយបានធ្វើការផ្លាស់ប្តូរប្រព័ន្ធគ្រប់គ្រងមាតិកា (CMS Migration) និងបានរៀបចំរចនាសម្ព័ន្ធ URL ថ្មីទាំងអស់។ មួយសប្តាហ៍ក្រោយមក ពួកគេបានកត់សម្គាល់ឃើញថារយៈពេលឆ្លើយតបជាមធ្យមរបស់ម៉ាស៊ីនបម្រើបានកើនឡើងពី 250ms ទៅដល់ 2,200ms ហើយចំនួនទំព័រដែលបាន Index ធ្លាក់ចុះយ៉ាងគំហុក។ តាមរយៈការពិនិត្យរបាយការណ៍ Crawl Stats ពួកគេបានរកឃើញថាការកំណត់ redirect 301 បង្កើតជាខ្សែសង្វាក់បន្តបន្ទាប់គ្នា (Redirect Chains ដល់ទៅ 4-5 តង់) ដែលធ្វើឱ្យរ៉ូបូតស្វែងរកជាប់គាំង។ បន្ទាប់ពីកែសម្រួលការបញ្ជូនបន្តឱ្យចង្អុលចំទំព័រចុងក្រោយដោយផ្ទាល់ក្នុងជំហានតែមួយ ល្បឿនឆ្លើយតបបានធ្លាក់ចុះមកត្រឹម 180ms វិញ ហើយសន្ទស្សន៍ទំព័រក៏បានវិលមករកប្រក្រតីភាពក្នុងរយៈពេល 2 សប្តាហ៍។
កំហុសបច្ចេកទេសទូទៅ ៦ យ៉ាងដែលរារាំងម៉ាស៊ីនស្វែងរកមិនឱ្យ Index
នៅក្នុងការអនុវត្តជាក់ស្តែង អ្នកគ្រប់គ្រងគេហទំព័រតែងតែបង្កើតកំហុសឆ្គងបច្ចេកទេសដោយមិនដឹងខ្លួន។ កំហុសទាំងនេះរារាំងរ៉ូបូតស្វែងរកមិនឱ្យបំពេញការងារបានពេញលេញ។
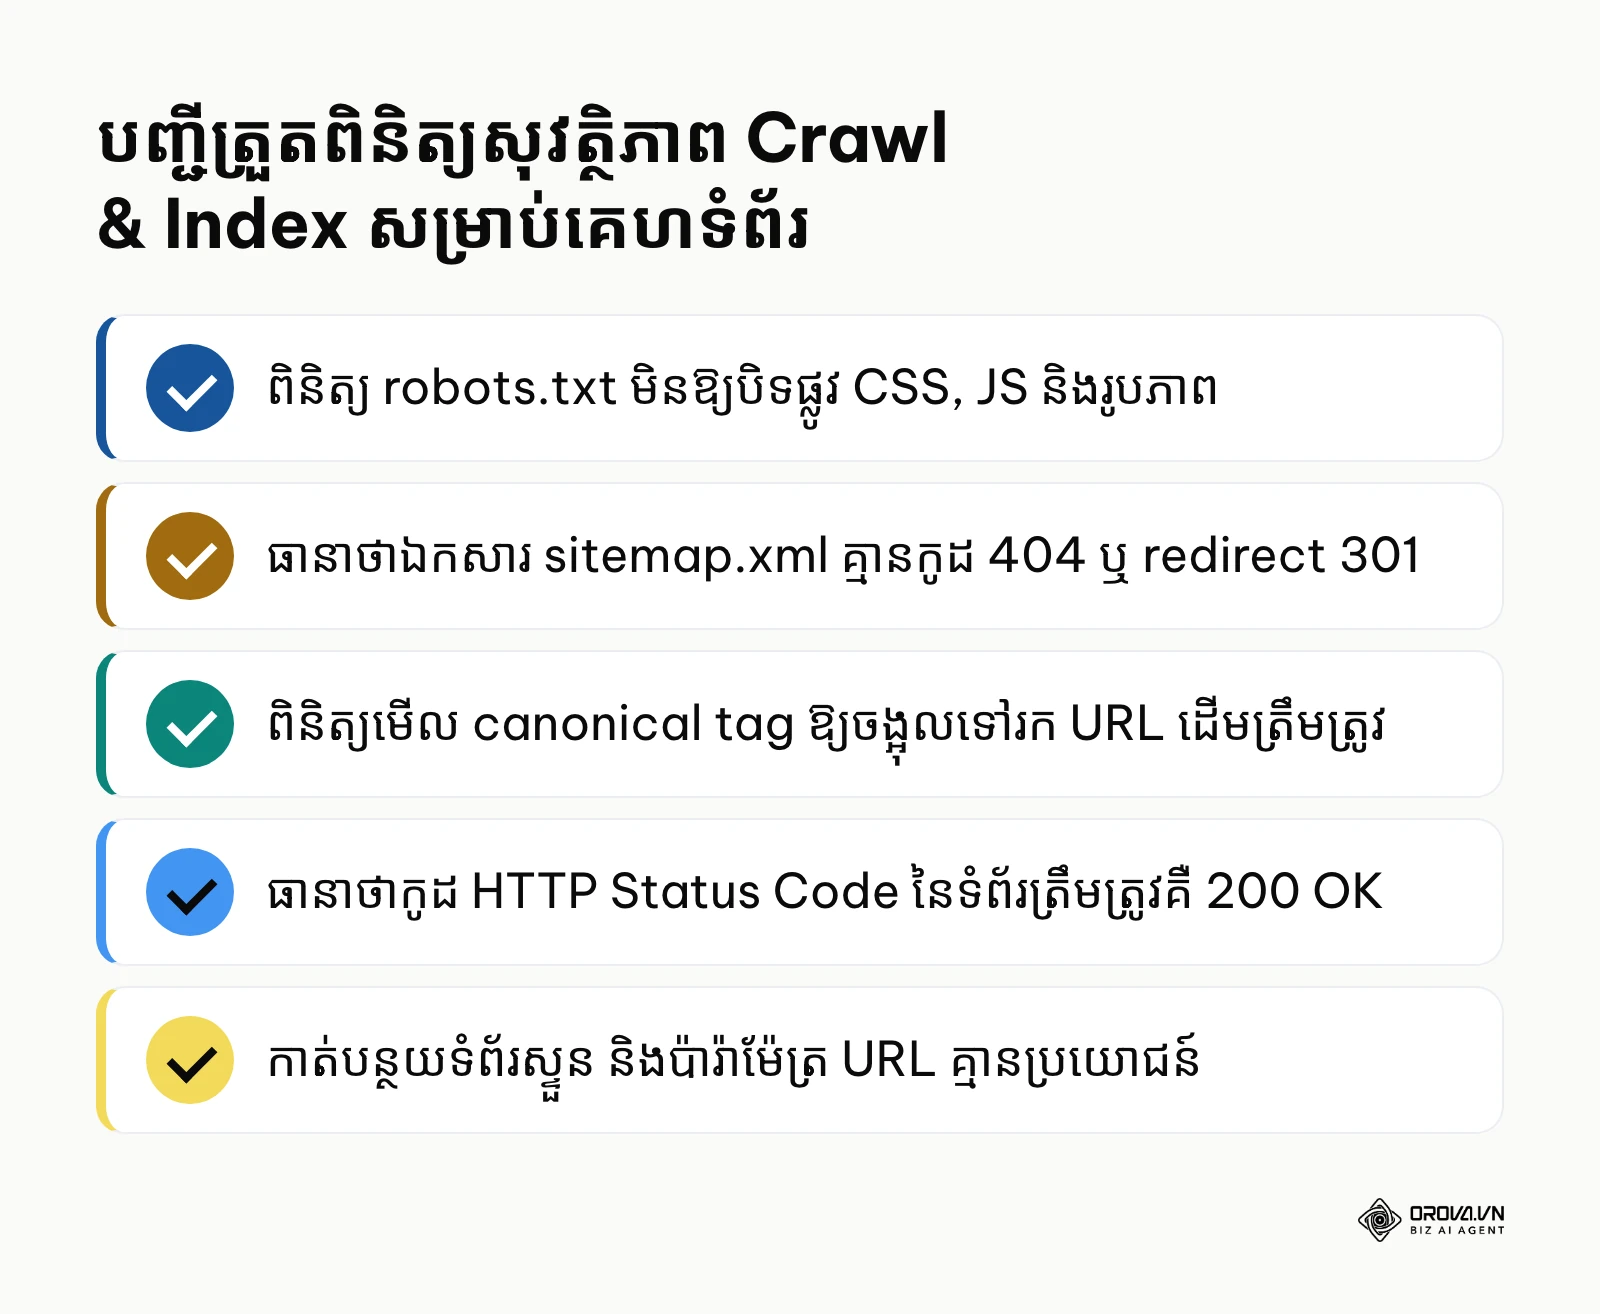
កំហុសទីមួយគឺការភ្លេចដកកូដ noindex ចេញពីបរិស្ថានសាកល្បង។ នៅពេលអ្នកអភិវឌ្ឍន៍ផ្ទេរគេហទំព័រពី Staging ទៅកាន់ Production ពួកគេច្រើនតែភ្លេចដកស្លាក <meta name="robots" content="noindex"> ចេញពីកូដ Header។ ផលវិបាកគឺម៉ាស៊ីនស្វែងរកនឹងដកគេហទំព័រទាំងមូលចេញពីបញ្ជីស្វែងរកភ្លាមៗ។ វិធីកែតម្រូវគឺត្រូវបង្កើតបញ្ជីត្រួតពិនិត្យដោយស្វ័យប្រវត្តិមុនពេល Deploy និងពិនិត្យកូដប្រភពទំព័រភ្លាមៗក្រោយពេលបង្ហោះជាផ្លូវការ។
កំហុសទីពីរគឺការទប់ស្កាត់ឯកសារ CSS និង JavaScript នៅក្នុងឯកសារ robots.txt។ មនុស្សជាច្រើនយល់ច្រឡំថាការដាក់ Disallow: /assets/ ឬ Disallow: /*.js$ ជួយសន្សំសំចៃ Crawl Budget។ ការពិតជាក់ស្តែងគឺវាធ្វើឱ្យម៉ាស៊ីនស្វែងរកមិនអាច Render ទំព័របានពេញលេញ ដែលនាំឱ្យការវាយតម្លៃប្លង់ទំព័រ និងភាពងាយស្រួលលើទូរស័ព្ទធ្លាក់ចុះយ៉ាងធ្ងន់ធ្ងរ។ វិធីកែតម្រូវគឺត្រូវបើកសិទ្ធិឱ្យរ៉ូបូតស្វែងរកអាចចូលដំណើរការរាល់ធនធានដែលចាំបាច់សម្រាប់ការបង្ហាញទំព័រ។
កំហុសទីបីគឺការបង្កើតរង្វិលជុំនៃការបញ្ជូនបន្ត (Redirect Loops) និងខ្សែសង្វាក់បញ្ជូនបន្តវែងអន្លាយ។ នៅពេល URL មួយបញ្ជូនបន្តទៅកាន់ URL មួយទៀតច្រើនជំហានបន្តបន្ទាប់គ្នា រ៉ូបូតស្វែងរកត្រូវចំណាយសំណើបន្ថែមលើជំហាននីមួយៗ ហើយយោងតាមឯកសាររបស់ Google Search Central Googlebot តាមការបញ្ជូនបន្តបានត្រឹមតែ 10 ជំហានប៉ុណ្ណោះ រួចឈប់ ដោយមិនទាញយកទំព័រចុងក្រោយ។ វិធីកែតម្រូវគឺត្រូវត្រួតពិនិត្យគេហទំព័រដោយប្រើប្រាស់ SEO Tools ដើម្បីស្វែងរក និងកាត់បន្ថយការបញ្ជូនបន្តឱ្យនៅត្រឹមមួយជំហានគត់ (Direct 1-to-1 Redirect)។
តារាងខាងក្រោមសង្ខេបកំហុសទាំង 6 ដែលពន្យល់ក្នុងផ្នែកនេះ៖
| កំហុស | សញ្ញាសម្គាល់ដែលអ្នកអាចពិនិត្យ | វិធីកែតម្រូវ |
|---|---|---|
| ភ្លេច noindex ពី Staging | ទំព័រធ្លាក់ចូល "Excluded by 'noindex' tag" ក្នុង Page Indexing | ដក meta robots noindex ហើយពិនិត្យកូដប្រភពក្រោយ Deploy |
| បិទ CSS/JS ក្នុង robots.txt | URL Inspection បង្ហាញទំព័របាក់បែក ឬខ្វះធនធាន | បើកសិទ្ធិឱ្យរ៉ូបូតអានធនធានដែលចាំបាច់សម្រាប់ Render |
| Redirect Chains/Loops | URL បញ្ជូនបន្តច្រើនជំហាន ឬវិលជុំ | ចង្អុល redirect ទៅទំព័រចុងក្រោយក្នុងជំហានតែមួយ |
| Infinite Scroll គ្មានតំណ | ទំព័រចាស់ៗមិនលេចក្នុង Index | បង្កើត Pagination ដែលមាន URL ផ្ទាល់ខ្លួន |
| Canonical ខុសគោលដៅ | ទំព័រថ្មីៗធ្លាក់ចូល Duplicate ឬ Alternate page | ប្រើ canonical ដែលចង្អុលទៅ URL បច្ចុប្បន្នរបស់ទំព័រ |
| Soft 404 | Page Indexing បង្ហាញ "Soft 404" | ឆ្លើយតបកូដ 404 ឬ 410 ពិតប្រាកដ |
កំហុសទីបួនគឺការពឹងផ្អែកលើប៊ូតុងចុច JavaScript ដើម្បីផ្ទុកទំព័របន្ទាប់ (Infinite Scroll ឬ Load More) ដោយគ្មានតំណភ្ជាប់ជំនួស។ ប្រសិនបើទំព័រផលិតផល ឬអត្ថបទចាស់ៗអាចចូលមើលបានលុះត្រាតែអ្នកប្រើចុចប៊ូតុង ឬអូសចុះក្រោម រ៉ូបូតស្វែងរកនឹងមិនអាចចុចប៊ូតុងទាំងនោះបានឡើយ ធ្វើឱ្យទំព័រខាងក្នុងទាំងអស់បាត់បង់ការរកឃើញ។ វិធីកែតម្រូវគឺត្រូវបង្កើតប្រព័ន្ធទំព័របែបប្រពៃណី (Pagination) ដែលទំព័រទី 2, 3 ... នីមួយៗមាន URL ផ្ទាល់ខ្លួន (ឧទាហរណ៍ ?page=2) និងតំណភ្ជាប់ស្លាក a ធម្មតានៅពីក្រោយខ្នង។
កំហុសទីប្រាំគឺការកំណត់ស្លាក Canonical ខុសគោលដៅ។ ករណីនេះច្រើនតែកើតឡើងនៅពេលចម្លងទំព័រគំរូ ហើយភ្លេចកែសម្រួលអាសយដ្ឋាន canonical ធ្វើឱ្យទំព័រថ្មីៗរាប់សិបចង្អុលទៅរកទំព័រដើមតែមួយ។ ជាលទ្ធផល ម៉ាស៊ីនស្វែងរកនឹងចាត់ទុកទំព័រថ្មីៗទាំងនោះជាទំព័រស្ទួន ហើយមិនដាក់បញ្ចូលក្នុង Index ឡើយ។ វិធីកែតម្រូវគឺត្រូវប្រើប្រាស់ dynamic canonical tags ដែលបង្កើត URL ស្របតាមអាសយដ្ឋានបច្ចុប្បន្នដោយស្វ័យប្រវត្តិ។
កំហុសទីប្រាំមួយគឺការមិនអើពើចំពោះទំព័រ Soft 404។ នេះជាស្ថានភាពដែលទំព័រមួយលែងមានមាតិកា ឬបង្ហាញសារ "រកមិនឃើញទិន្នន័យ" ប៉ុន្តែម៉ាស៊ីនបម្រើនៅតែឆ្លើយតបកូដ 200 OK ជំនួសឱ្យកូដ 404 Not Found។ ម៉ាស៊ីនស្វែងរកនឹងខ្ជះខ្ជាយពេលវេលាក្នុងការប្រមូលទិន្នន័យលើទំព័រទទេទាំងនេះ។ វិធីកែតម្រូវគឺត្រូវកំណត់រចនាសម្ព័ន្ធម៉ាស៊ីនបម្រើឱ្យបញ្ជូនកូដ 404 ឬ 410 ឱ្យបានត្រឹមត្រូវនៅពេលមាតិកាត្រូវបានលុបចោល។
ជាមួយ OROVA.VN និងម៉ូឌុល OROVA SEO លោកអ្នកនឹងបញ្ចប់ជាស្ថាពរនូវថ្ងៃខែដ៏នឿយហត់នៃការធ្វើការដោយដៃ។ ជំនួសឱ្យការខិតខំរាប់ម៉ោងដើម្បីសរសេរអត្ថបទ និងធ្វើរបាយការណ៍ ឥឡូវនេះដំណើរការទាំងមូលត្រូវបានបង្កើនប្រសិទ្ធភាព និងបញ្ចប់ក្នុងរយៈពេលត្រឹមតែ ៥ នាទីប៉ុណ្ណោះ។
និន្នាការ how search engines work ក្នុងរយៈពេលប៉ុន្មានឆ្នាំខាងមុខ៖ ទស្សនៈរបស់អ្នកនិពន្ធ
ផ្អែកលើការវិវត្តយ៉ាងលឿននៃបច្ចេកវិទ្យាក្នុងវិស័យស្វែងរក ខ្ញុំយល់ឃើញថា និន្នាការ how search engines work កំពុងឈានចូលដំណាក់កាលផ្លាស់ប្តូរទម្រង់ដ៏ធំបំផុតដែលមិនធ្លាប់មានពីមុនមក។ ខាងក្រោមនេះជាការវិភាគផ្ទាល់ខ្លួនរបស់ខ្ញុំលើទិសដៅទៅអនាគត៖
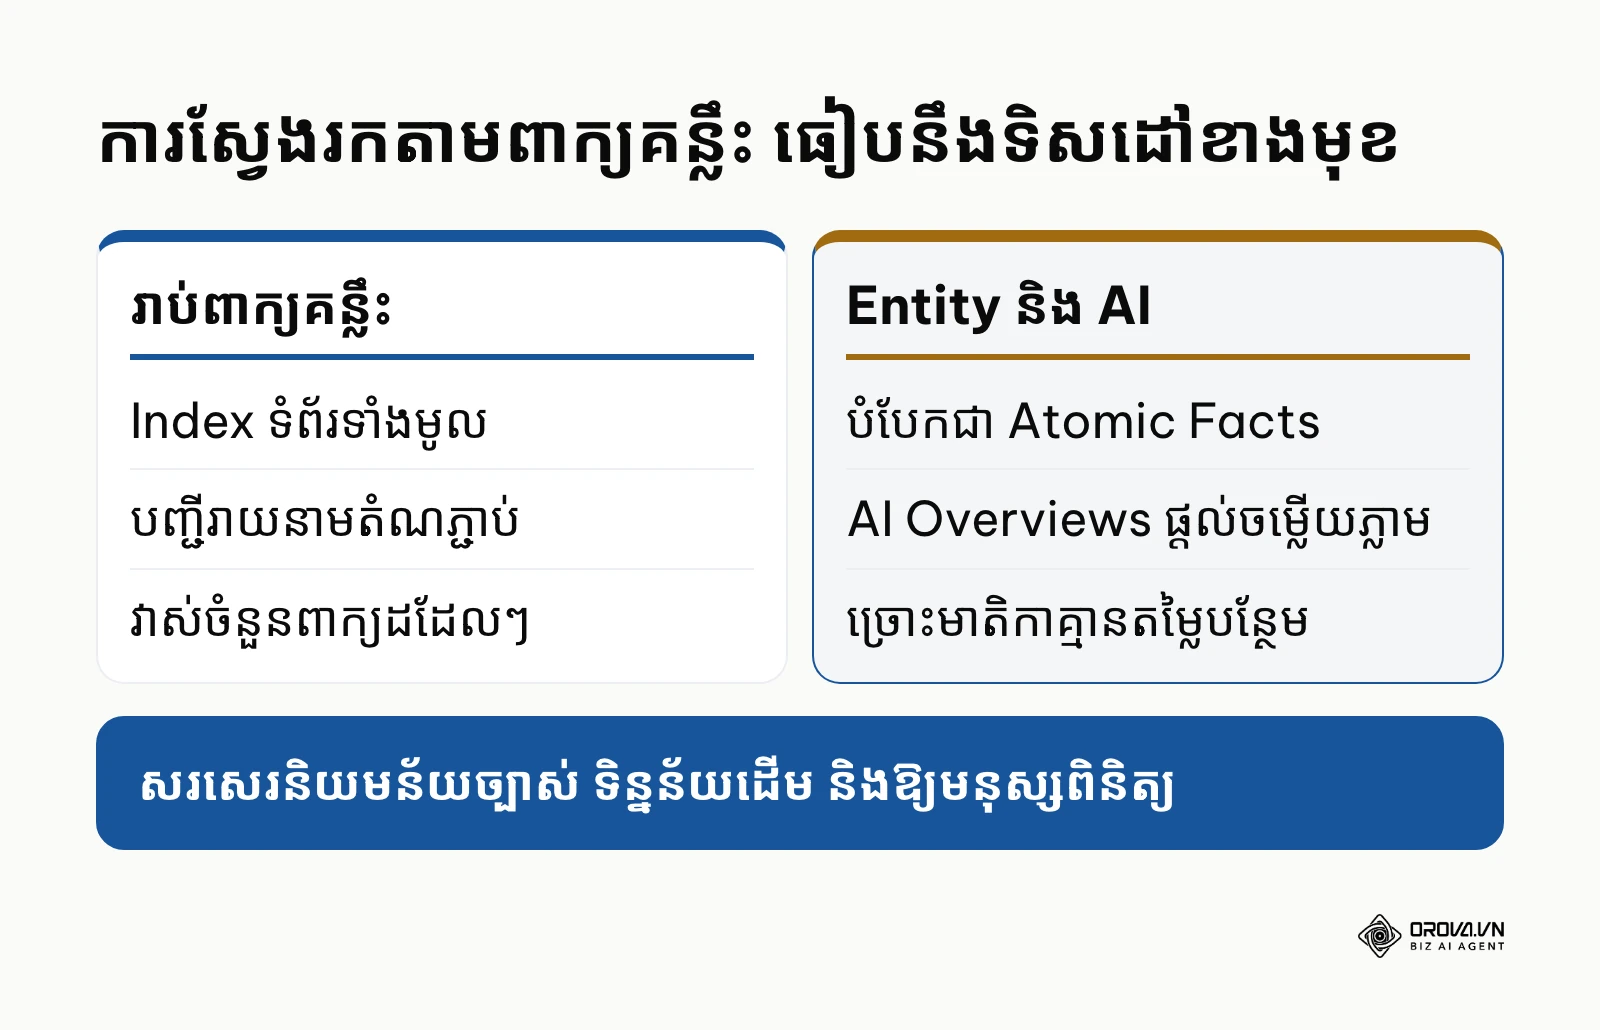
ទីមួយ ការផ្លាស់ប្តូរពីការស្វែងរកតាមពាក្យគន្លឹះទៅជាការស្វែងរកតាមអង្គភាពទិន្នន័យ (Entity-First Indexing)។ សព្វថ្ងៃនេះ គិតត្រឹមឆ្នាំ 2026 យើងឃើញយ៉ាងច្បាស់ថាម៉ាស៊ីនស្វែងរកលែងផ្តោតលើការរាប់ចំនួនពាក្យដដែលៗទៀតហើយ ប៉ុន្តែពួកគេកំពុងប្រើប្រាស់ Knowledge Graph ដើម្បីភ្ជាប់ទំនាក់ទំនងរវាងមនុស្ស ទីកន្លែង និងគំនិតផ្សេងៗ។ ខ្ញុំយល់ឃើញថានៅប៉ុន្មានឆ្នាំខាងមុខ ដំណើរការ Indexing អាចនឹងមិនរក្សាទុកទំព័រជាទម្រង់ឯកសារទាំងមូលទៀតឡើយ ប៉ុន្តែនឹងបំបែកទំព័រនីមួយៗទៅជាអង្គភាពទិន្នន័យតូចៗ (Atomic Facts) នៅក្នុង Vector Database។ ប្រសិនបើនិន្នាការនេះកើតឡើងពិតមែន អ្នកគ្រប់គ្រងគេហទំព័រត្រូវតែរៀបចំកូដ Schema Markup ឱ្យបានច្បាស់លាស់បំផុត និងសរសេរខ្លឹមសារដែលកំណត់និយមន័យផ្ទាល់ មិនមែនសរសេរវាងវៃឡើយ។ ទោះជាយ៉ាងណា ការសន្និដ្ឋាននេះអាចនឹងថយល្បឿន ប្រសិនបើការចំណាយលើធនធានកុំព្យូទ័រក្នុងការរក្សាទុកទិន្នន័យវ៉ិចទ័រមានតម្លៃខ្ពស់ហួសហេតុសម្រាប់ម៉ាស៊ីនស្វែងរក។
ទីពីរ ការកើនឡើងនៃស្ថាបត្យកម្ម RAG នឹងផ្លាស់ប្តូរឥរិយាបថចុចចូលមើលគេហទំព័រ (Zero-Click Search)។ សញ្ញាណដែលយើងកំពុងឃើញជាក់ស្តែងនៅថ្ងៃនេះ គឺវត្តមាននៃ AI Overviews ដែលផ្តល់ចម្លើយពេញលេញភ្លាមៗនៅលើទំព័រលទ្ធផល។ ខ្ញុំយល់ឃើញថានៅប៉ុន្មានឆ្នាំខាងមុខ ម៉ាស៊ីនស្វែងរកនឹងក្លាយទៅជា "ម៉ាស៊ីនផ្តល់ចម្លើយ" ច្រើនជាង "បញ្ជីរាយនាមតំណភ្ជាប់"។ គេហទំព័រណាដែលផ្តល់តែព័ត៌មានទូទៅកម្រិតស្រាល អាចបាត់បង់ចរាចរណ៍ស្វែងរកច្រើន។ ដើម្បីត្រៀមខ្លួនសម្រាប់ស្ថានភាពនេះ អ្នកបង្កើតមាតិកាត្រូវតែផ្តោតលើការផ្តល់ទិន្នន័យស៊ីជម្រៅ បទពិសោធន៍ផ្ទាល់ដៃ និងទិន្នន័យស្រាវជ្រាវផ្តាច់មុខដែល AI មិនអាចទស្សន៍ទាយបាន។ ការយល់ឃើញនេះអាចនឹងមិនកើតឡើងទាំងស្រុង ប្រសិនបើមានបញ្ហាផ្លូវច្បាប់ពាក់ព័ន្ធនឹងកម្មសិទ្ធិបញ្ញាដែលបង្ខំឱ្យម៉ាស៊ីនស្វែងរកត្រូវបង្ហាញតំណភ្ជាប់ប្រពៃណីឡើងវិញ។
ទីបី ការវាយតម្លៃមាតិកាដែលបង្កើតដោយ AI នឹងកាន់តែតឹងរ៉ឹងក្នុងដំណាក់កាល Indexing។ បច្ចុប្បន្ននេះ បណ្តាញអ៊ីនធឺណិតកំពុងជន់លិចដោយអត្ថបទរាប់លានដែលបង្កើតឡើងដោយស្វ័យប្រវត្តិតាមរយៈម៉ូដែលភាសាធំៗ។ ខ្ញុំយល់ឃើញថាម៉ាស៊ីនស្វែងរកនឹងបង្កើតយន្តការច្រោះគុណភាពកាន់តែមុតស្រួចតាំងពីដំណាក់កាល Crawling មកម្ល៉េះ ដោយកាត់បន្ថយ Crawl Budget ភ្លាមៗចំពោះគេហទំព័រណាដែលផ្សាយមាតិកាគ្មានតម្លៃបន្ថែម។ អ្នកគួរតែរៀបចំខ្លួនចាប់ពីពេលនេះ ដោយបញ្ចូលការត្រួតពិនិត្យពីមនុស្សពិតប្រាកដ (Human-in-the-loop) និងធានាថារាល់អត្ថបទទាំងអស់សុទ្ធតែឆ្លុះបញ្ចាំងពីជំនាញវិជ្ជាជីវៈពិតប្រាកដ។
| និន្នាការ | សញ្ញាដែលឃើញនៅថ្ងៃនេះ | អ្វីដែលអ្នកអាចធ្វើឥឡូវនេះ |
|---|---|---|
| Entity-First Indexing | Knowledge Graph ភ្ជាប់មនុស្ស ទីកន្លែង និងគំនិត | សរសេរនិយមន័យច្បាស់ និងផ្ទៀងផ្ទាត់ Schema Markup |
| Zero-Click Search | AI Overviews ផ្តល់ចម្លើយនៅលើទំព័រលទ្ធផល | ផ្តល់ទិន្នន័យដើម និងបទពិសោធន៍ផ្ទាល់ដែល AI មិនអាចសង្ខេបជំនួសបាន |
| ច្រោះមាតិកា AI តឹងរ៉ឹង | មាតិកាស្វ័យប្រវត្តិកើនឡើងយ៉ាងច្រើន | ឱ្យមនុស្សពិនិត្យអត្ថបទ មុនពេលផ្សាយ |
សំណួរដែលគេសួរញឹកញាប់អំពី how search engines work
ហេតុអ្វីបានជាគេហទំព័រត្រូវបាន Googlebot ចូលមើលច្រើនដង ប៉ុន្តែនៅតែបង្ហាញ 'Crawled - currently not indexed'?
ស្ថានភាពនេះកើតឡើងនៅពេលដែលរ៉ូបូតស្វែងរកបានទាញយក និងអានកូដទំព័ររបស់អ្នករួចរាល់ហើយ ប៉ុន្តែប្រព័ន្ធវាយតម្លៃសម្រេចចិត្តមិនបញ្ចូលវាទៅក្នុង Inverted Index។ មូលហេតុចម្បងជាធម្មតាមិនមែនជាបញ្ហាបច្ចេកទេសរារាំងនោះទេ ប៉ុន្តែមកពីមាតិកានៅលើទំព័រនោះមានគុណភាពទាបពេក ស្រដៀងគ្នាខ្លាំងទៅនឹងទំព័រផ្សេងទៀតលើអ៊ីនធឺណិត ឬគេហទំព័ររបស់អ្នកខ្វះសញ្ញាណនៃភាពគួរឱ្យទុកចិត្ត (E-E-A-T)។ ដើម្បីដោះស្រាយបញ្ហានេះ អ្នកត្រូវបន្ថែមទិន្នន័យដើម កែលម្អខ្លឹមសារឱ្យស៊ីជម្រៅ និងបង្កើតតំណភ្ជាប់ផ្ទៃក្នុងពីទំព័រសំខាន់ៗមកកាន់ទំព័រនោះ។
តើ AI Overviews ទាញយកទិន្នន័យពីទំព័រដែលបាន Index រួច ឬដំណើរការ crawler ផ្ទាល់ខ្លួនភ្លាមៗ?
យោងតាមឯកសារ AI features របស់ Google Search Central ទំព័រដែលអាចបង្ហាញជាតំណយោងក្នុង AI Overviews ត្រូវតែត្រូវបាន Index និងមានសិទ្ធិបង្ហាញ snippet ក្នុង Google Search រួចជាស្រេច ដូច្នេះប្រព័ន្ធពឹងផ្អែកលើទិន្នន័យក្នុងឃ្លាំង Index ជាចម្បង។ ប្រព័ន្ធប្រើប្រាស់ស្ថាបត្យកម្ម RAG ដើម្បីទាញយកបំណែកទិន្នន័យដែលពាក់ព័ន្ធបំផុតចេញពីសន្ទស្សន៍ដែលមានស្រាប់ រួចបញ្ជូនទៅកាន់ម៉ូដែលភាសាដើម្បីសំយោគជាចម្លើយ។
តើម៉ាស៊ីនស្វែងរកវាយតម្លៃមាតិកាដែលបង្កើតដោយ AI ក្នុងដំណាក់កាល Indexing និង Ranking យ៉ាងដូចម្តេច?
ម៉ាស៊ីនស្វែងរកទំនើបដូចជា Google មិនដាក់ទណ្ឌកម្មមាតិកាដោយសារតែវាត្រូវបានបង្កើតឡើងដោយ AI នោះឡើយ។ គោលការណ៍ស្នូលគឺផ្ដោតលើគុណភាពនៃមាតិកាជាចម្បង មិនមែនផ្ដោតលើវិធីសាស្ត្រនៃការផលិតនោះទេ។ ទោះជាយ៉ាងណាក៏ដោយ ប្រសិនបើមាតិកា AI នោះជាការចម្លងឡើងវិញនូវអ្វីដែលមានស្រាប់ ខ្វះភាពជាក់លាក់ ឬត្រូវបានបង្កើតឡើងក្នុងគោលបំណងកេងបន្លំពាក្យគន្លឹះ នោះប្រព័ន្ធនឹងចាត់ទុកវាជាមាតិកាឥតប្រយោជន៍ និងបដិសេធការ Index ឬទម្លាក់ចំណាត់ថ្នាក់។
តើអ្វីជាភាពខុសគ្នាសំខាន់រវាង Crawling និង Indexing?
Crawling គឺជាដំណើរការបច្ចេកទេសដែលរ៉ូបូតស្វែងរកធ្វើដំណើរតាមបណ្តាញអ៊ីនធឺណិតដើម្បីស្វែងរក និងទាញយកកូដឯកសារតាមរយៈតំណភ្ជាប់។ ចំណែកឯ Indexing គឺជាដំណើរការវិភាគ ស្វែងយល់អត្ថន័យ និងរក្សាទុកទិន្នន័យដែលប្រមូលបាននោះទៅក្នុងមូលដ្ឋានទិន្នន័យធំដើម្បីរៀបចំសម្រាប់បង្ហាញនៅពេលមានការស្វែងរក។ ទំព័រមួយអាចត្រូវបាន Crawl ដោយជោគជ័យ ប៉ុន្តែមិនប្រាកដថាត្រូវបាន Index នោះឡើយ ប្រសិនបើវាខ្វះគុណភាព ឬមានកំហុសបច្ចេកទេស។
តើឯកសារ robots.txt អាចរារាំងទំព័រមិនឱ្យបង្ហាញលើ Google បានទាំងស្រុងដែរឬទេ?
ឯកសារ robots.txt គ្រាន់តែរារាំងរ៉ូបូតស្វែងរកមិនឱ្យចូលទៅអានមាតិកាក្នុងទំព័រនោះប៉ុណ្ណោះ ប៉ុន្តែវាមិនអាចរារាំងការបង្ហាញលើទំព័រស្វែងរកបានទាំងស្រុងឡើយ។ ប្រសិនបើទំព័រនោះទទួលបានតំណភ្ជាប់ពីគេហទំព័រខាងក្រៅផ្សេងទៀត Google នៅតែអាច Index អាសយដ្ឋាន URL នោះដោយផ្អែកលើអត្ថបទយោងនៃតំណភ្ជាប់ (Anchor Text) ទោះបីជាវាមិនដឹងពីមាតិកាខាងក្នុងក៏ដោយ។ ប្រសិនបើអ្នកចង់ធានាថាមិនឱ្យបង្ហាញលើលទ្ធផលស្វែងរកដាច់ខាត អ្នកត្រូវដកច្បាប់ Disallow ចេញ ហើយប្រើប្រាស់ស្លាក <meta name="robots" content="noindex"> វិញ។
តើគួរចាប់ផ្តើមពីណា?
ប្រសិនបើអ្នកមិនទាន់ដឹងថាគួរចាប់ផ្តើមពីចំណុចណានោះទេ សូមពិចារណាស្ថានភាពជាក់ស្តែងនៃគេហទំព័ររបស់អ្នក៖
| ស្ថានភាពគេហទំព័រ | ជំហានដំបូង | កន្លែងពិនិត្យ |
|---|---|---|
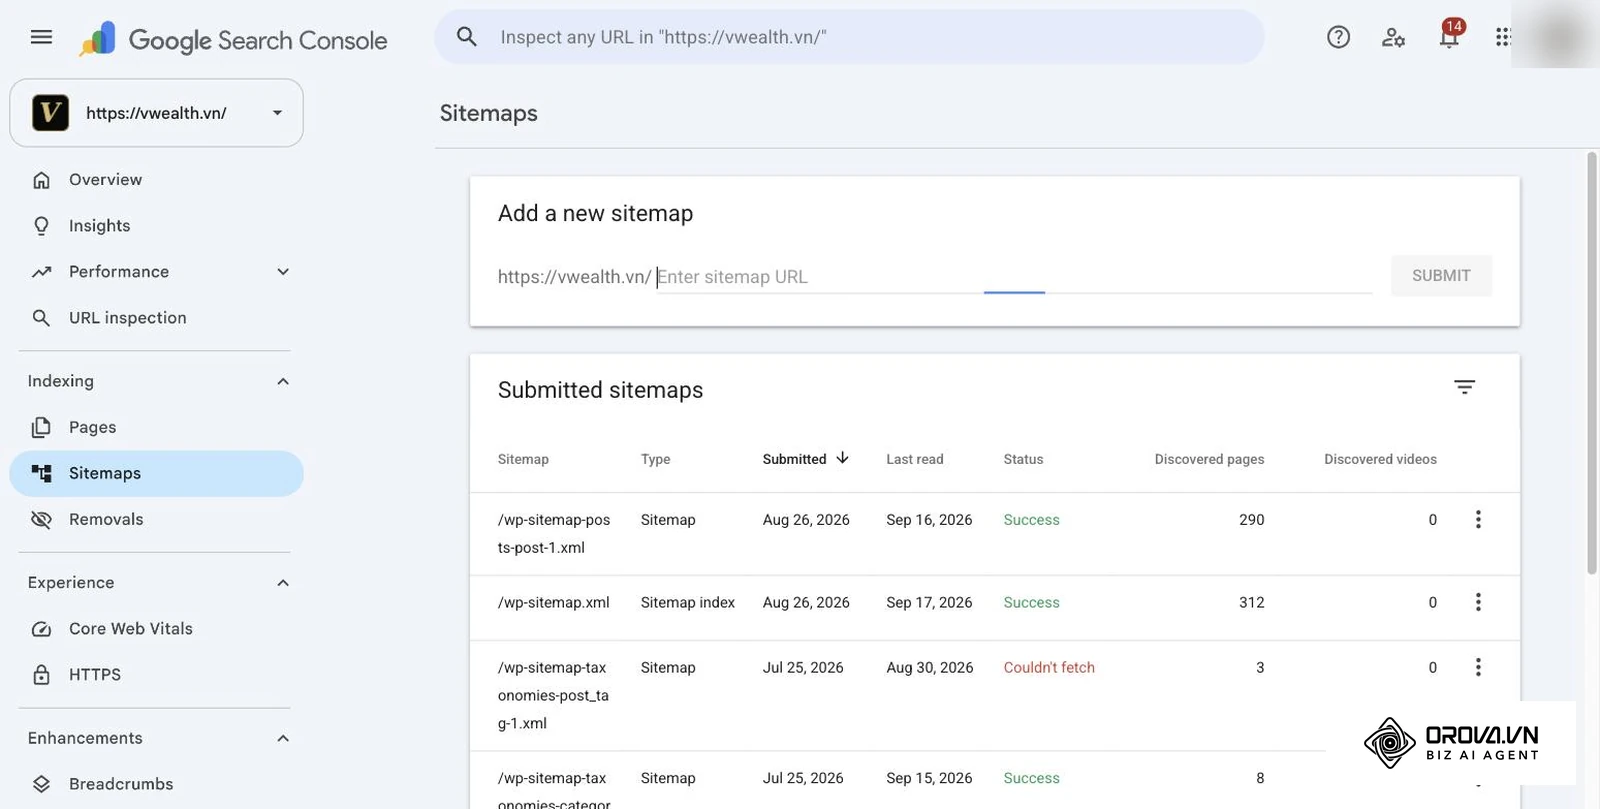
| ទើបបង្កើតថ្មី | ផ្ទៀងផ្ទាត់ Search Console និងដាក់ស្នើ sitemap.xml | Sitemaps ក្នុង Search Console |
| មានស្រាប់ តែមិនឡើងចំណាត់ថ្នាក់ | ពិនិត្យទំព័រ "Crawled - currently not indexed" និងធ្វើតេស្ត 5 ទំព័រសំខាន់ | Page Indexing និង URL Inspection |
| ខ្នាតធំ មានទំព័ររាប់ពាន់ | រក Crawl Budget ដែលខ្ជះខ្ជាយ និងបិទ URL តម្រងគ្មានតម្លៃ | robots.txt, Crawl Stats និង Server Logs |
សម្រាប់គេហទំព័រដែលទើបតែបង្កើតថ្មី និងមិនទាន់មានចរាចរណ៍ស្វែងរកទាល់តែសោះ ជំហានដំបូងបំផុតដែលអ្នកអាចធ្វើបានក្នុងរយៈពេលមួយម៉ោង គឺការចុះឈ្មោះគណនី Google Search Console ផ្ទៀងផ្ទាត់កូដ DNS និងដាក់ស្នើឯកសារ sitemap.xml ដែលមានតែ URL ត្រឹមត្រូវ។ ការធ្វើបែបនេះនឹងជួយឱ្យរ៉ូបូតស្វែងរកដឹងពីវត្តមាននៃទំព័ររបស់អ្នកជាផ្លូវការ។
សម្រាប់គេហទំព័រដែលមានស្រាប់ ប៉ុន្តែកំពុងជួបបញ្ហាទំព័រមិនឡើងចំណាត់ថ្នាក់ ឬធ្លាក់ចុះ ជំហានដំបូងដែលគួរធ្វើភ្លាមៗគឺការចូលទៅពិនិត្យផ្ទាំង "Page Indexing" ក្នុង Search Console ដើម្បីពិនិត្យមើលថាតើមានទំព័រប៉ុន្មានដែលជាប់គាំងក្នុងស្ថានភាព "Crawled - currently not indexed"។ ជ្រើសរើសទំព័រគំរូចំនួន 5 ដែលសំខាន់បំផុត រួចប្រើឧបករណ៍ URL Inspection ធ្វើតេស្តផ្ទាល់ (Test Live URL) ដើម្បីពិនិត្យមើលកូដ DOM ថាតើ JavaScript ត្រូវបាន Render ត្រឹមត្រូវដែរឬទេ។
សម្រាប់គេហទំព័រខ្នាតធំ ឬគេហទំព័រពាណិជ្ជកម្មអេឡិចត្រូនិចដែលមានទំព័ររាប់ពាន់ ជំហានដំបូងដែលត្រូវអនុវត្តនៅរសៀលនេះ គឺការពិនិត្យឯកសារ robots.txt និងកំណត់ហេតុម៉ាស៊ីនបម្រើ (Server Logs) ដើម្បីស្វែងរកចំណុចលេចធ្លាយនៃ Crawl Budget។ កំណត់ទប់ស្កាត់រាល់ទំព័រតម្រងប៉ារ៉ាម៉ែត្រដែលគ្មានតម្លៃ SEO ដើម្បីប្រមូលផ្តុំកម្លាំងរបស់រ៉ូបូតឱ្យផ្តោតលើតែទំព័រផលិតផលស្នូល។
ការយល់ដឹងច្បាស់លាស់ និងការអនុវត្តត្រឹមត្រូវតាមយន្តការបច្ចេកទេសគឺជាគន្លឹះតែមួយគត់ក្នុងការគ្រប់គ្រងលទ្ធផលស្វែងរក ពីព្រោះភាពជោគជ័យនៃគេហទំព័រអាស្រ័យទាំងស្រុងលើរបៀបដែលអ្នកសម្របសម្រួលជាមួយគោលការណ៍ how search engines work។
About the author
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
ដំណើរការអាជីវកម្មជាមួយ AI Agent
Orova គឺជា Biz AI Agent ដែលដំណើរការគ្រប់ពេល — រៀបផែនការ អនុវត្ត និងកែលម្អដោយខ្លួនឯង។
សន្សំពេលវេលា បង្កើនប្រសិទ្ធភាព