Robots.txt là gì? Cách viết file robots txt đúng chuẩn Google
Robots.txt là một tệp văn bản thuần đặt ở thư mục gốc của tên miền (ví dụ https://tenmien.com/robots.txt), dùng để báo cho các trình thu thập dữ liệu như Googlebot biết những đường dẫn nào chúng được phép hoặc không được phép thu thập (crawl). Nhiều người gõ tìm "robots txt" vì nghĩ đây là công tắc ẩn trang khỏi Google, nhưng thực ra tệp này chỉ điều khiển việc thu thập, không phải việc lập chỉ mục (index).
Hình dung website của bạn là một cửa hàng vừa mở cửa đón khách. Bạn muốn khách đi vào khu trưng bày, chứ không muốn họ lạc vào kho chứa chổi lau nhà hay phòng nghỉ nhân viên. Robots.txt giống tấm biển "Khu vực dành cho nhân viên" treo trước cửa kho: khách lịch sự sẽ đọc và làm theo, nhưng tấm biển không phải ổ khoá.
Rất nhiều chủ website nghĩ chỉ cần nội dung hay là công cụ tìm kiếm sẽ tự đọc mọi thứ một cách thông minh. Thực tế, với những website có nhiều đường dẫn tự sinh (bộ lọc, trang tìm kiếm nội bộ, tham số sắp xếp), bot có thể tốn rất nhiều lượt thu thập vào những trang không có giá trị. Nếu bạn mới làm quen với SEO, đây là một trong những tệp kỹ thuật nên hiểu sớm, vì viết sai một dòng có thể chặn Google đọc cả website.
Bài viết này giải thích robots.txt hoạt động ra sao theo tài liệu của Google Search Central, các lệnh được hỗ trợ, những hiểu lầm hay gặp, kèm vài tệp mẫu đúng cú pháp để bạn tham khảo.
Robots.txt là gì?
Robots.txt là tệp văn bản thuần (mã hoá UTF-8) nằm ở gốc tên miền, chứa các nhóm quy tắc cho từng loại trình thu thập dữ liệu. Mỗi nhóm bắt đầu bằng dòng User-agent cho biết quy tắc áp dụng cho bot nào, tiếp theo là các dòng Disallow (không cho thu thập) và Allow (cho phép thu thập). Tệp còn có thể chứa dòng Sitemap để chỉ đường tới sơ đồ trang web.
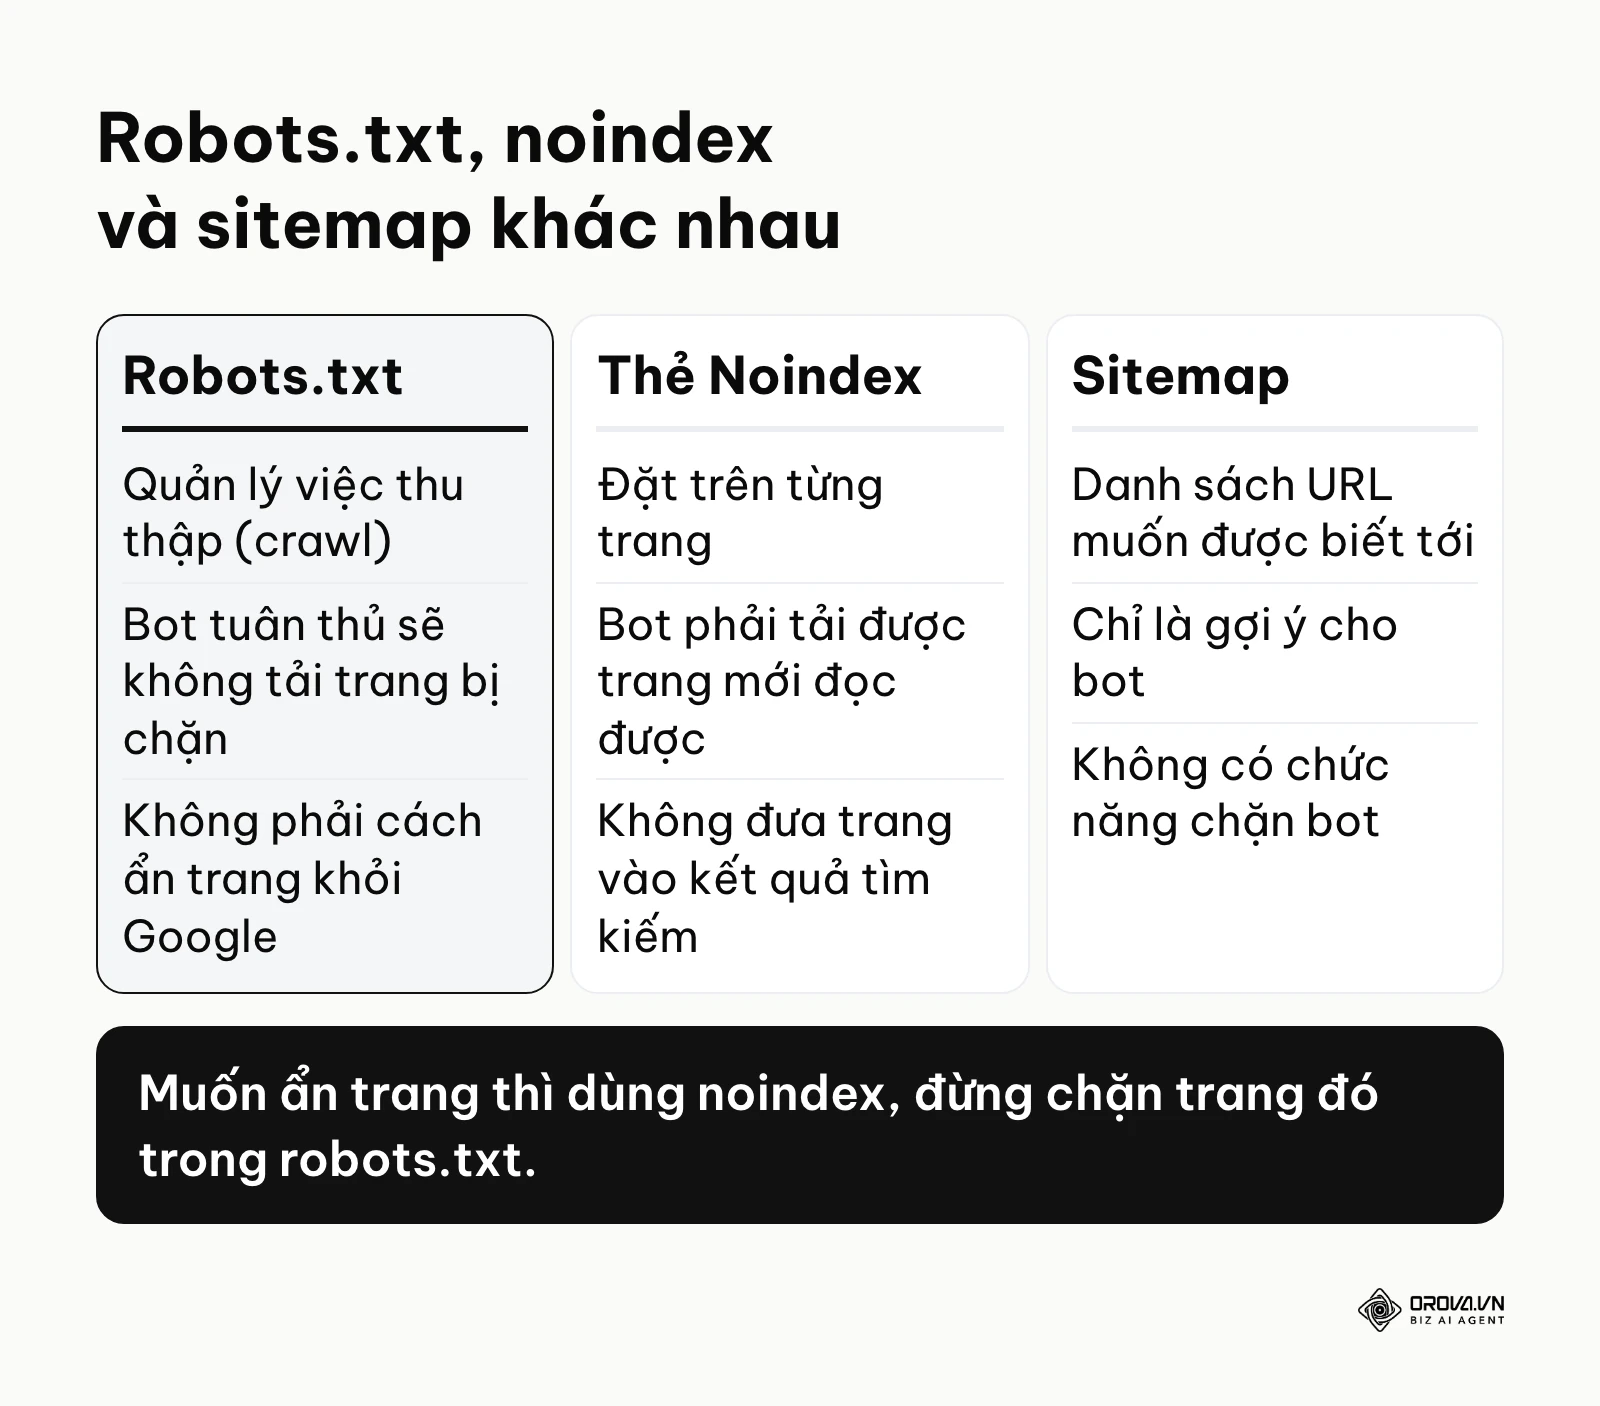
Quy ước này có từ những năm đầu của web và đã được chuẩn hoá thành Robots Exclusion Protocol (RFC 9309) của IETF năm 2022. Điều quan trọng cần nhớ: đây là quy ước tự nguyện. Các bot lớn như Googlebot hay Bingbot tuân theo, nhưng một bot cào dữ liệu xấu hoàn toàn có thể phớt lờ. Vì vậy robots.txt là công cụ quản lý việc thu thập, không phải công cụ bảo mật.
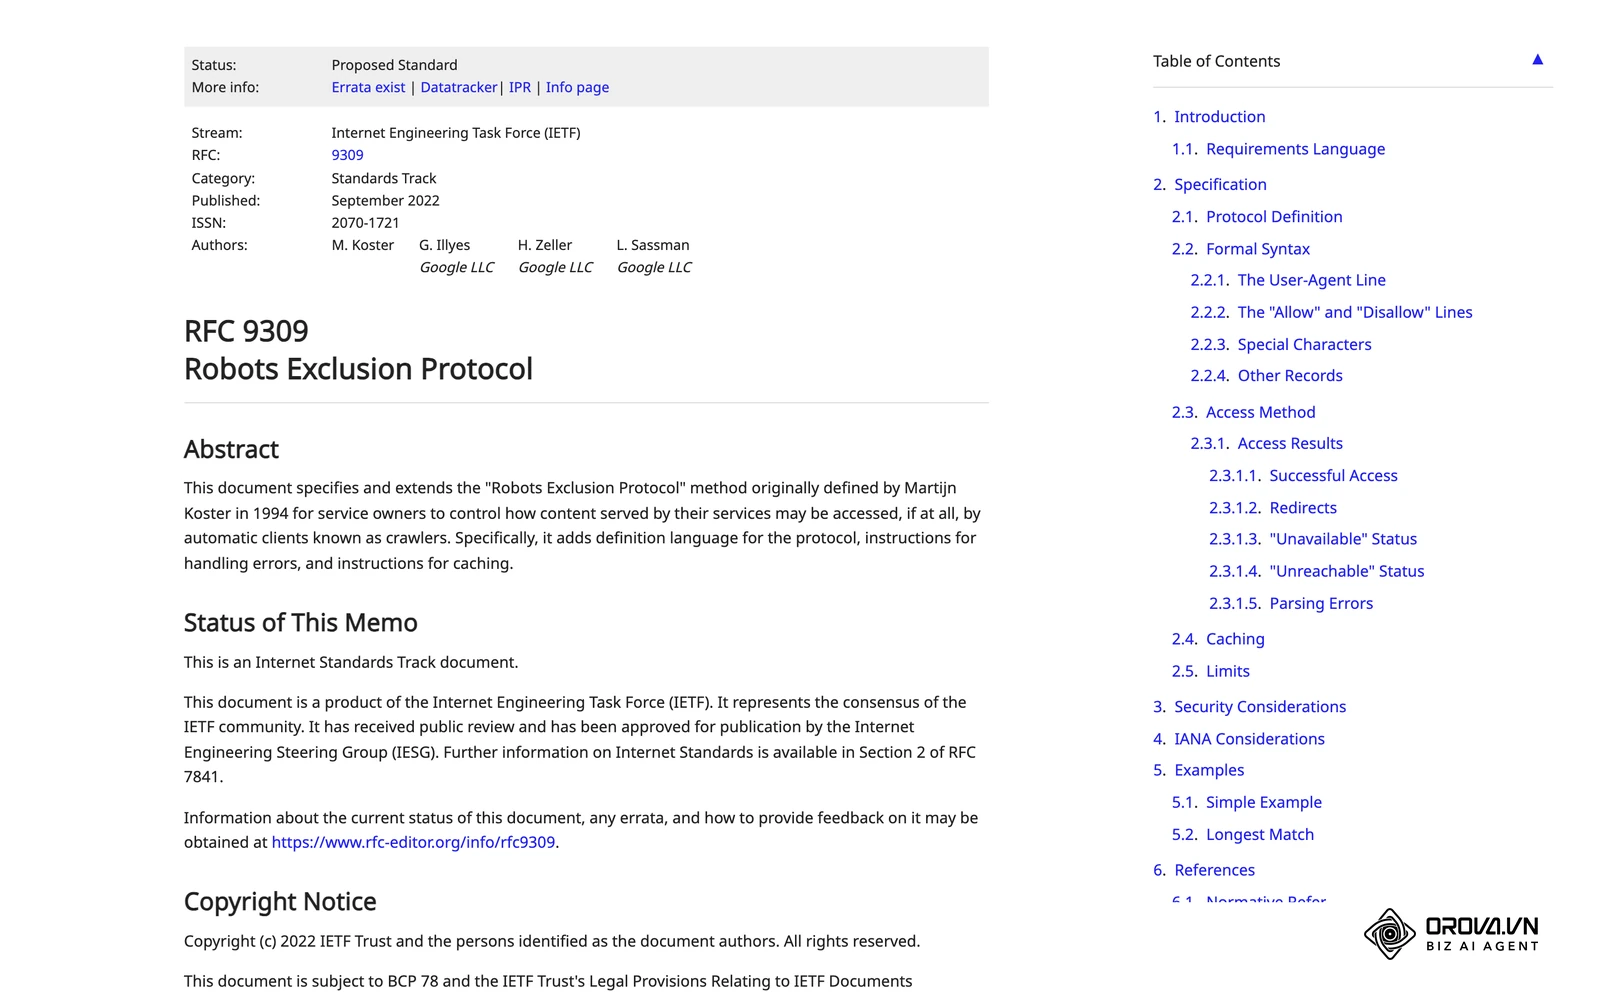
| Công cụ kiểm soát | Khác biệt cốt lõi | Ví dụ ứng dụng thực tế |
|---|---|---|
| Tệp robots.txt | Chặn bot tải nội dung trang. Trang bị chặn vẫn có thể xuất hiện trên Google (thường không có mô tả) nếu có link khác trỏ tới. | Chặn bot thu thập các trang kết quả tìm kiếm nội bộ trên website. |
| Thẻ meta noindex | Báo Google không đưa trang vào kết quả tìm kiếm. Bot phải tải được trang mới đọc được thẻ này, nên trang không được bị chặn trong robots.txt. | Ẩn trang cảm ơn sau khi khách điền form. |
| Sitemap (sơ đồ trang web) | Cung cấp danh sách đường dẫn bạn muốn công cụ tìm kiếm biết tới, không có khả năng chặn bot. | Báo cho Google biết vừa có bài blog mới xuất bản. |
Ví dụ đời thường, website của bạn giống như một nhà hàng. Sitemap là cuốn thực đơn giới thiệu các món. Thẻ noindex giống việc bạn cho khách vào xem một món nhưng dặn đừng ghi món đó vào sách giới thiệu nhà hàng. Còn robots.txt là tấm biển treo trước cửa bếp: khách tuân thủ sẽ không bước vào, nhưng người ngoài vẫn có thể nghe kể là trong bếp có món gì.
Ý nghĩa của việc kiểm soát luồng dữ liệu
Mỗi công cụ tìm kiếm đều có chương trình duyệt web tự động (thường gọi là crawler hay spider). Nhiệm vụ của chúng là đi theo các đường link để tải trang về hệ thống. Trước khi thu thập một website, Googlebot tìm tệp robots.txt ở gốc tên miền (ví dụ https://tenmien.com/robots.txt), đọc nhóm quy tắc dành cho mình rồi mới quyết định tải những đường dẫn nào.
Tệp này giải quyết bài toán phân bổ lượt thu thập. Nếu không có quy tắc nào, bot có thể sa vào những "bẫy" kỹ thuật (spider trap), như một trang lịch tự sinh ra trang cho mọi tháng trong tương lai, hay bộ lọc hàng hoá tạo ra vô số tổ hợp đường dẫn gần như trùng nhau. Mỗi lượt bot dành cho những trang đó là một lượt không dành cho trang sản phẩm hay bài viết thật sự của bạn.
Nếu bỏ qua bước thiết lập này trên một website lớn, hệ quả thường thấy là máy chủ phải phục vụ nhiều yêu cầu vô ích và bài mới được thu thập chậm hơn mong muốn. Khi bài mới mãi không lên Google, robots.txt là một trong những chỗ đầu tiên cần soát, bên cạnh các lý do bài viết không được Google index khác như nội dung trùng lặp hay thiếu link nội bộ.
Có một điều cần nói rõ ngay từ đầu: robots.txt không giấu được thông tin. Ai cũng có thể mở tệp này bằng trình duyệt, nên liệt kê đường dẫn trang quản trị bí mật vào đó chẳng khác nào chỉ đường cho người tò mò. Trang nhạy cảm cần được bảo vệ bằng đăng nhập hoặc mật khẩu.
Khi nào chưa cần cấu hình tệp này? Google cho biết nếu bạn không muốn kiểm soát việc thu thập thì không bắt buộc phải có robots.txt: khi tệp không tồn tại (trả về lỗi 404), Googlebot coi như được phép thu thập toàn bộ. Một landing page đơn giản hay website vài chục trang thường không cần quy tắc gì đặc biệt. Còn với website đang dựng thử (staging), thay vì dựa vào lệnh chặn, bạn nên đặt mật khẩu bảo vệ toàn trang (HTTP Authentication) để chặn cả người lạ lẫn bot.
Vì sao robots.txt quan trọng với SEO
Nắm vững cách kiểm soát việc thu thập mang lại lợi ích hai chiều: giảm tải vô ích cho máy chủ và giúp công cụ tìm kiếm dành lượt thu thập cho đúng những trang bạn muốn được tìm thấy.
Ngăn chặn lãng phí băng thông và tài nguyên máy chủ
Mỗi lần một bot tải một trang, máy chủ phải xử lý truy vấn cơ sở dữ liệu, trả về hình ảnh và chạy các tập lệnh. Với website lớn, khi nhiều loại bot cùng thu thập hàng loạt đường dẫn tự sinh, tốc độ phục vụ khách thật có thể bị ảnh hưởng.
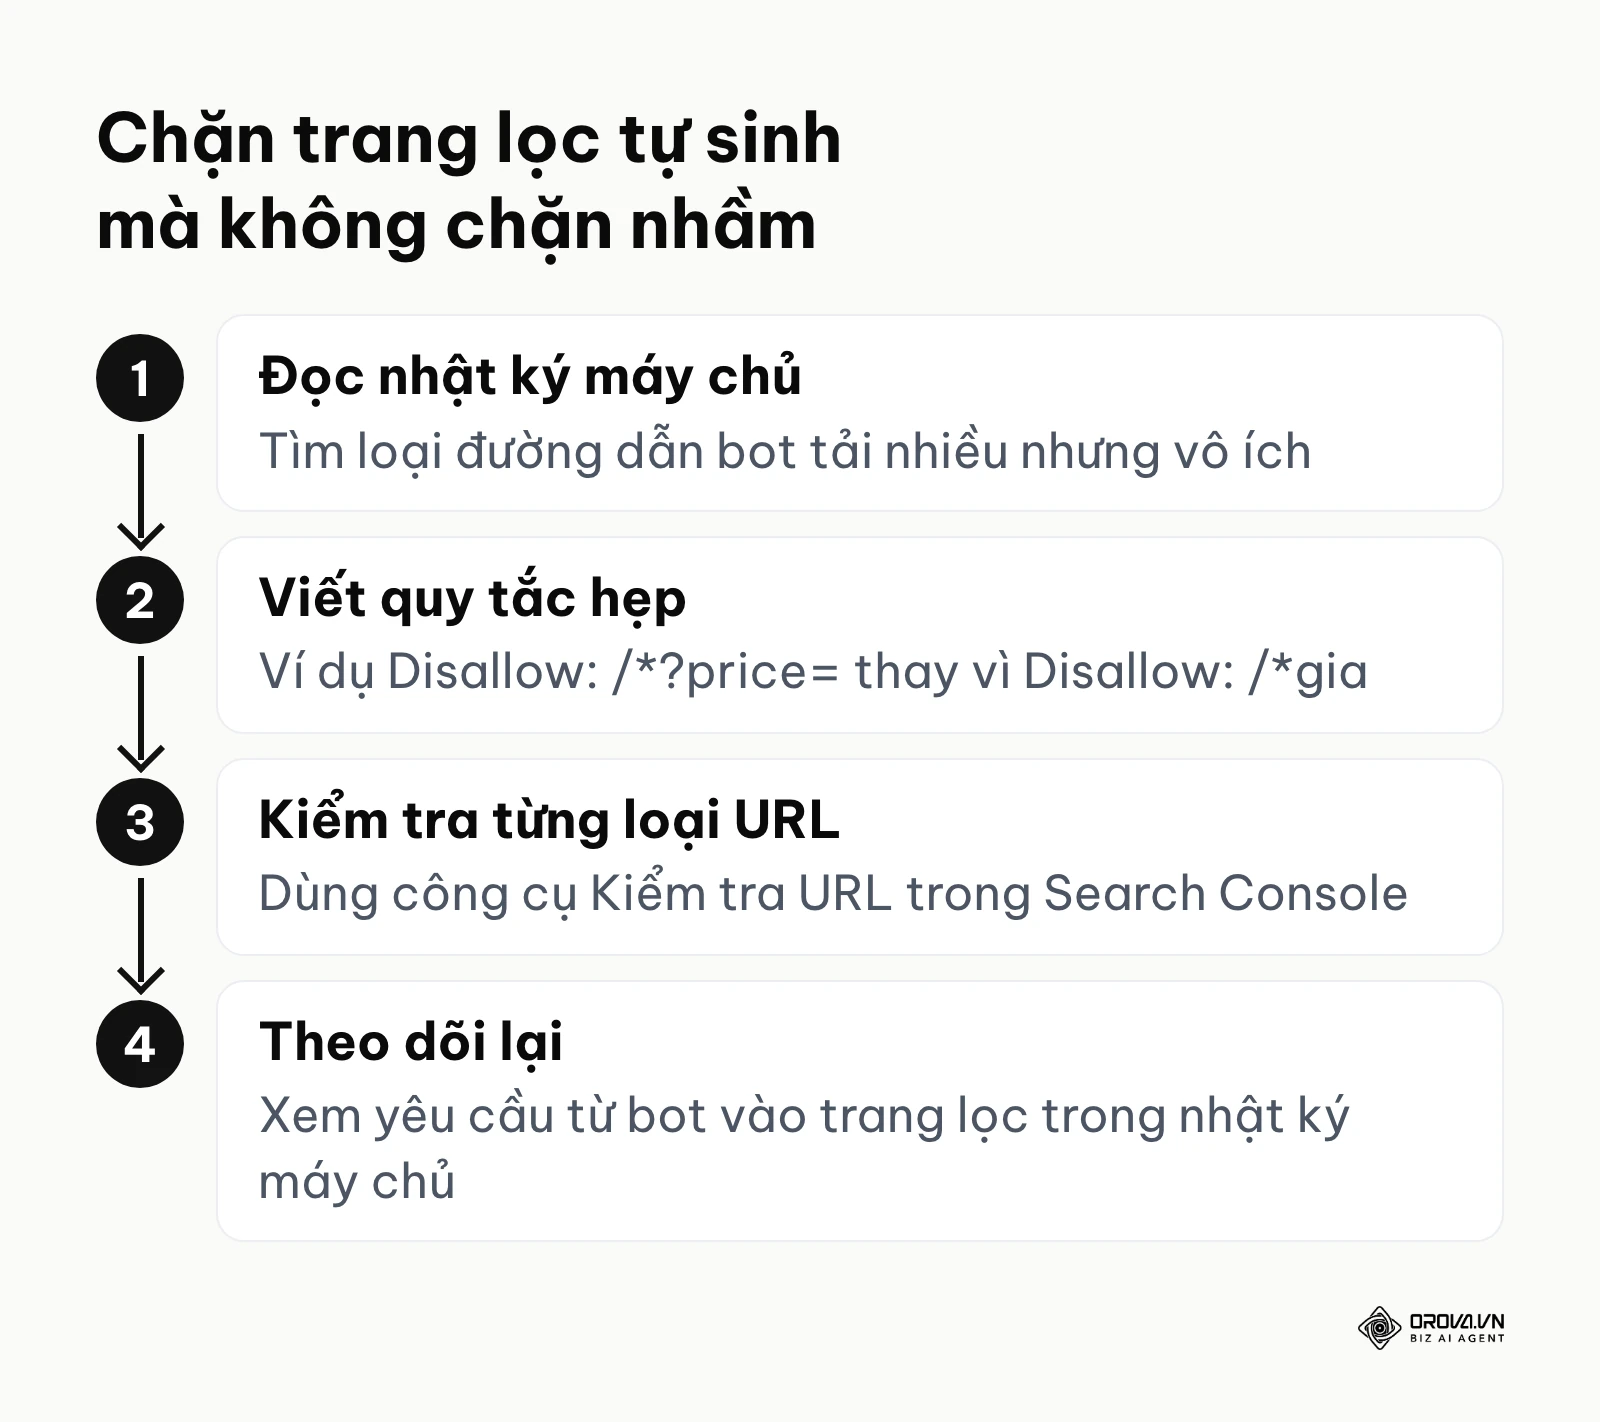
Ví dụ minh hoạ:
- Bối cảnh: Trưởng phòng công nghệ của một trang thương mại điện tử đồ gia dụng với hàng chục nghìn mã sản phẩm.
- Các bước đã làm: Đọc nhật ký truy cập máy chủ, thấy bot đang thu thập rất nhiều đường dẫn sinh ra từ bộ lọc giá dạng /noi-chien?price=.... Kỹ thuật viên thêm quy tắc chặn các đường dẫn có tham số lọc giá vào robots.txt.
- Chỗ vấp và cách gỡ: Ban đầu viết quy tắc quá rộng là Disallow: /gia, vô tình chặn luôn danh mục tĩnh /gia-dung/. Đội kỹ thuật sửa thành Disallow: /?price= và Disallow: /*&price= để chỉ chặn khi tham số nằm sau dấu hỏi hoặc dấu và, rồi dùng công cụ Kiểm tra URL trong Search Console để thử lại từng loại đường dẫn.
- Kết quả: Lượng yêu cầu từ bot vào các trang lọc giảm rõ rệt trong nhật ký máy chủ, còn trang danh mục và trang sản phẩm vẫn được thu thập bình thường.
Điều hướng Crawl Budget tập trung vào nội dung sinh lời
Crawl Budget (ngân sách thu thập dữ liệu) là số đường dẫn Googlebot có thể và muốn thu thập trên website của bạn trong một khoảng thời gian. Google nói rõ đây chủ yếu là mối bận tâm của website rất lớn hoặc website có nội dung thay đổi liên tục. Với website vài trăm trang, Google thường thu thập đủ mà bạn không phải làm gì thêm.
Với website lớn, nguyên tắc đơn giản: càng ít lượt bị tiêu vào trang lọc, trang sắp xếp, trang tìm kiếm nội bộ, thì càng nhiều lượt dành cho trang sản phẩm và bài viết. Một cấu trúc website chuẩn SEO với danh mục rõ ràng, link nội bộ hợp lý sẽ làm việc này tốt hơn nhiều so với việc chỉ cố chặn thật nhiều đường dẫn.
Ngăn ngừa hiển thị các vùng dữ liệu chưa sẵn sàng
Người làm nội dung thường có bản nháp, trang khuyến mãi chưa tới ngày tung ra, hay tệp PDF nội bộ. Nhiều người nghĩ chặn chúng trong robots.txt là xong, nhưng đây là hiểu lầm phổ biến nhất. Chặn thu thập không ngăn được việc hiển thị: nếu trang đó có link từ nơi khác, Google vẫn có thể đưa đường dẫn lên kết quả tìm kiếm mà không cần đọc nội dung.
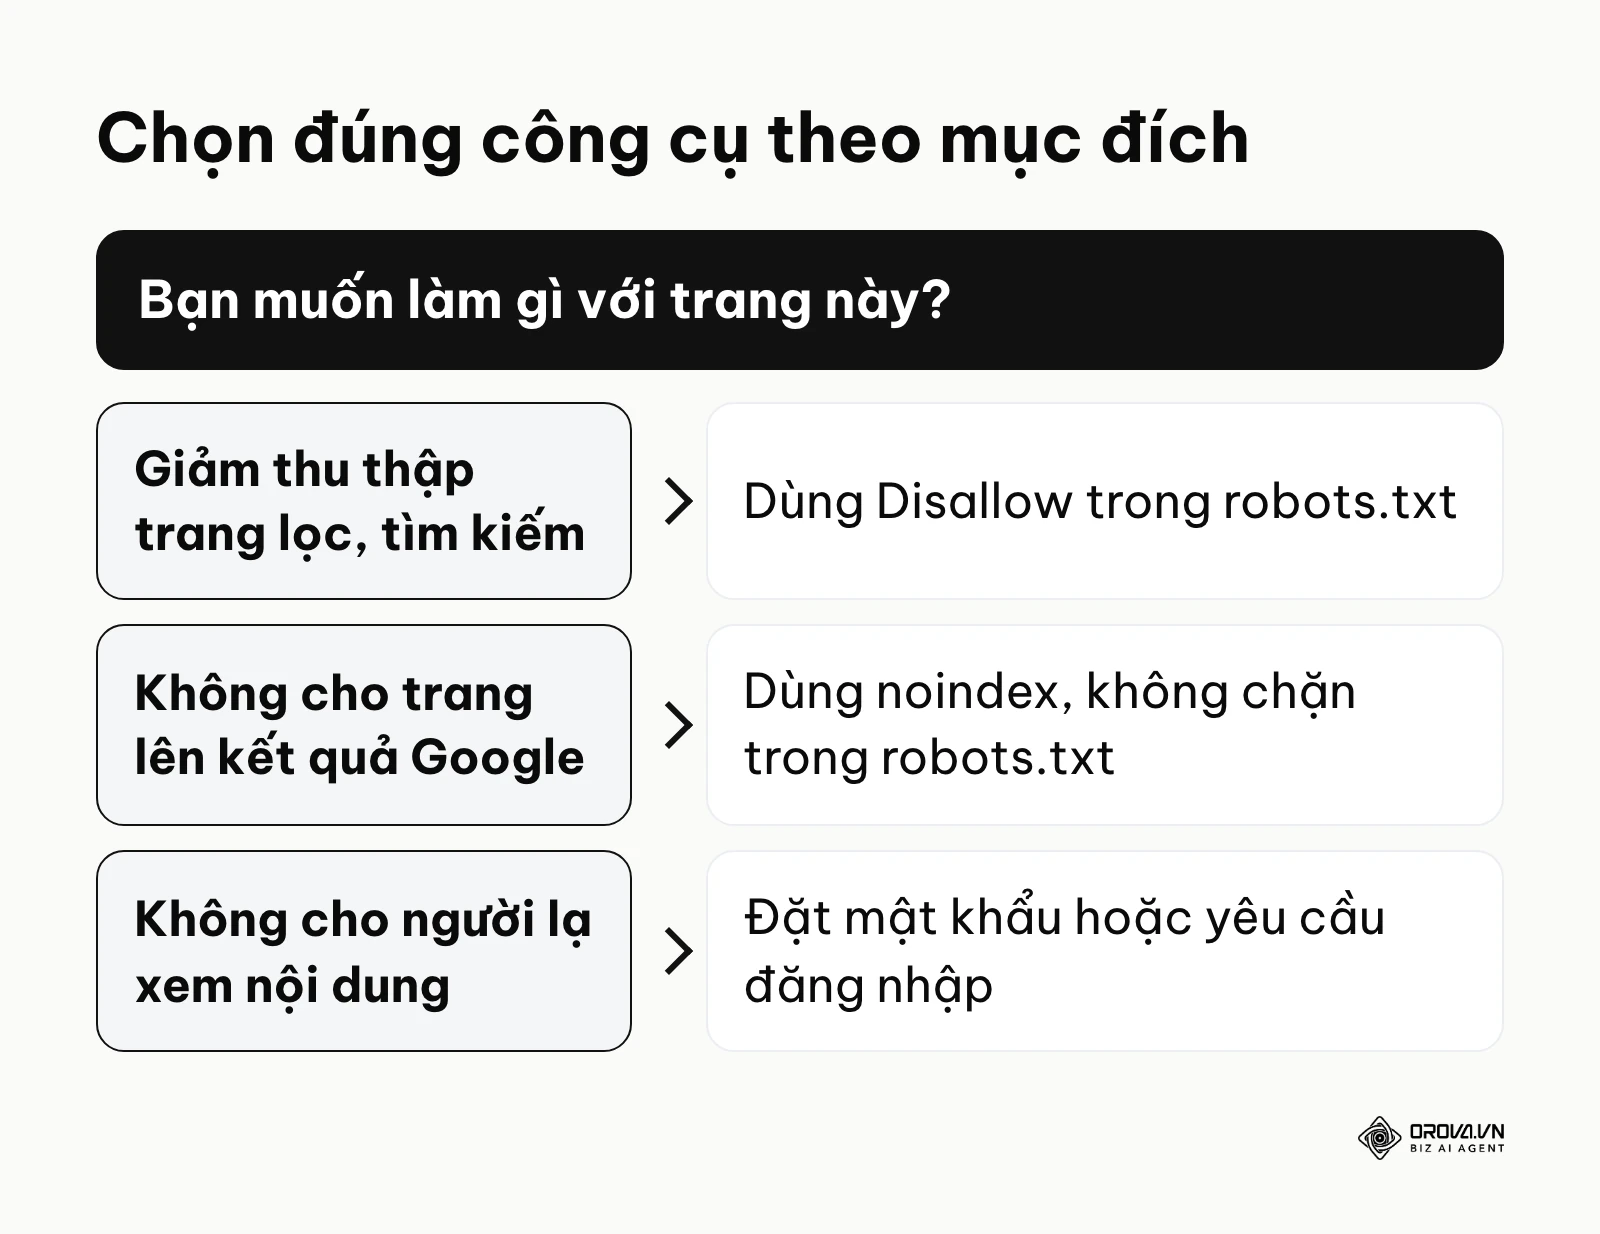
Cách đúng tuỳ mục đích. Muốn trang không xuất hiện trên Google, dùng thẻ meta noindex (hoặc tiêu đề HTTP X-Robots-Tag: noindex cho tệp PDF), đồng thời KHÔNG chặn trang đó trong robots.txt, vì bị chặn thu thập thì Google không đọc được noindex. Muốn không ai xem được, đặt mật khẩu hoặc yêu cầu đăng nhập.
| Mục đích | Công cụ nên dùng | Ghi chú |
|---|---|---|
| Giảm thu thập trang lọc, trang tìm kiếm nội bộ | robots.txt (Disallow) | Theo dõi trong báo cáo Số liệu thống kê thu thập dữ liệu của Search Console |
| Không cho trang xuất hiện trên Google | Thẻ meta noindex hoặc X-Robots-Tag | Trang phải để bot tải được, không chặn trong robots.txt |
| Không cho người lạ xem nội dung | Mật khẩu, đăng nhập | robots.txt là tệp công khai, không có tác dụng bảo mật |
Khám phá Orova.vn – nền tảng Biz AI Agent với giải pháp OROVA SEO toàn diện dành cho mọi website. Hệ thống hỗ trợ tối ưu hóa công cụ tìm kiếm từ A-Z với các tính năng: nghiên cứu từ khóa, viết bài mới chuẩn SEO, tối ưu nội dung cũ, theo dõi thứ hạng, cùng khả năng phân tích đối thủ và kỹ thuật chuyên sâu. Đăng ký ngay hôm nay để trải nghiệm OROVA SEO hoàn toàn miễn phí (ưu đãi áp dụng đến hết 07/07/2027).
Cách hoạt động và giải phẫu các thành phần
Một tệp robots.txt được chia thành các nhóm quy tắc. Trước khi đi vào từng lệnh, có vài điều cơ bản theo tài liệu của Google:
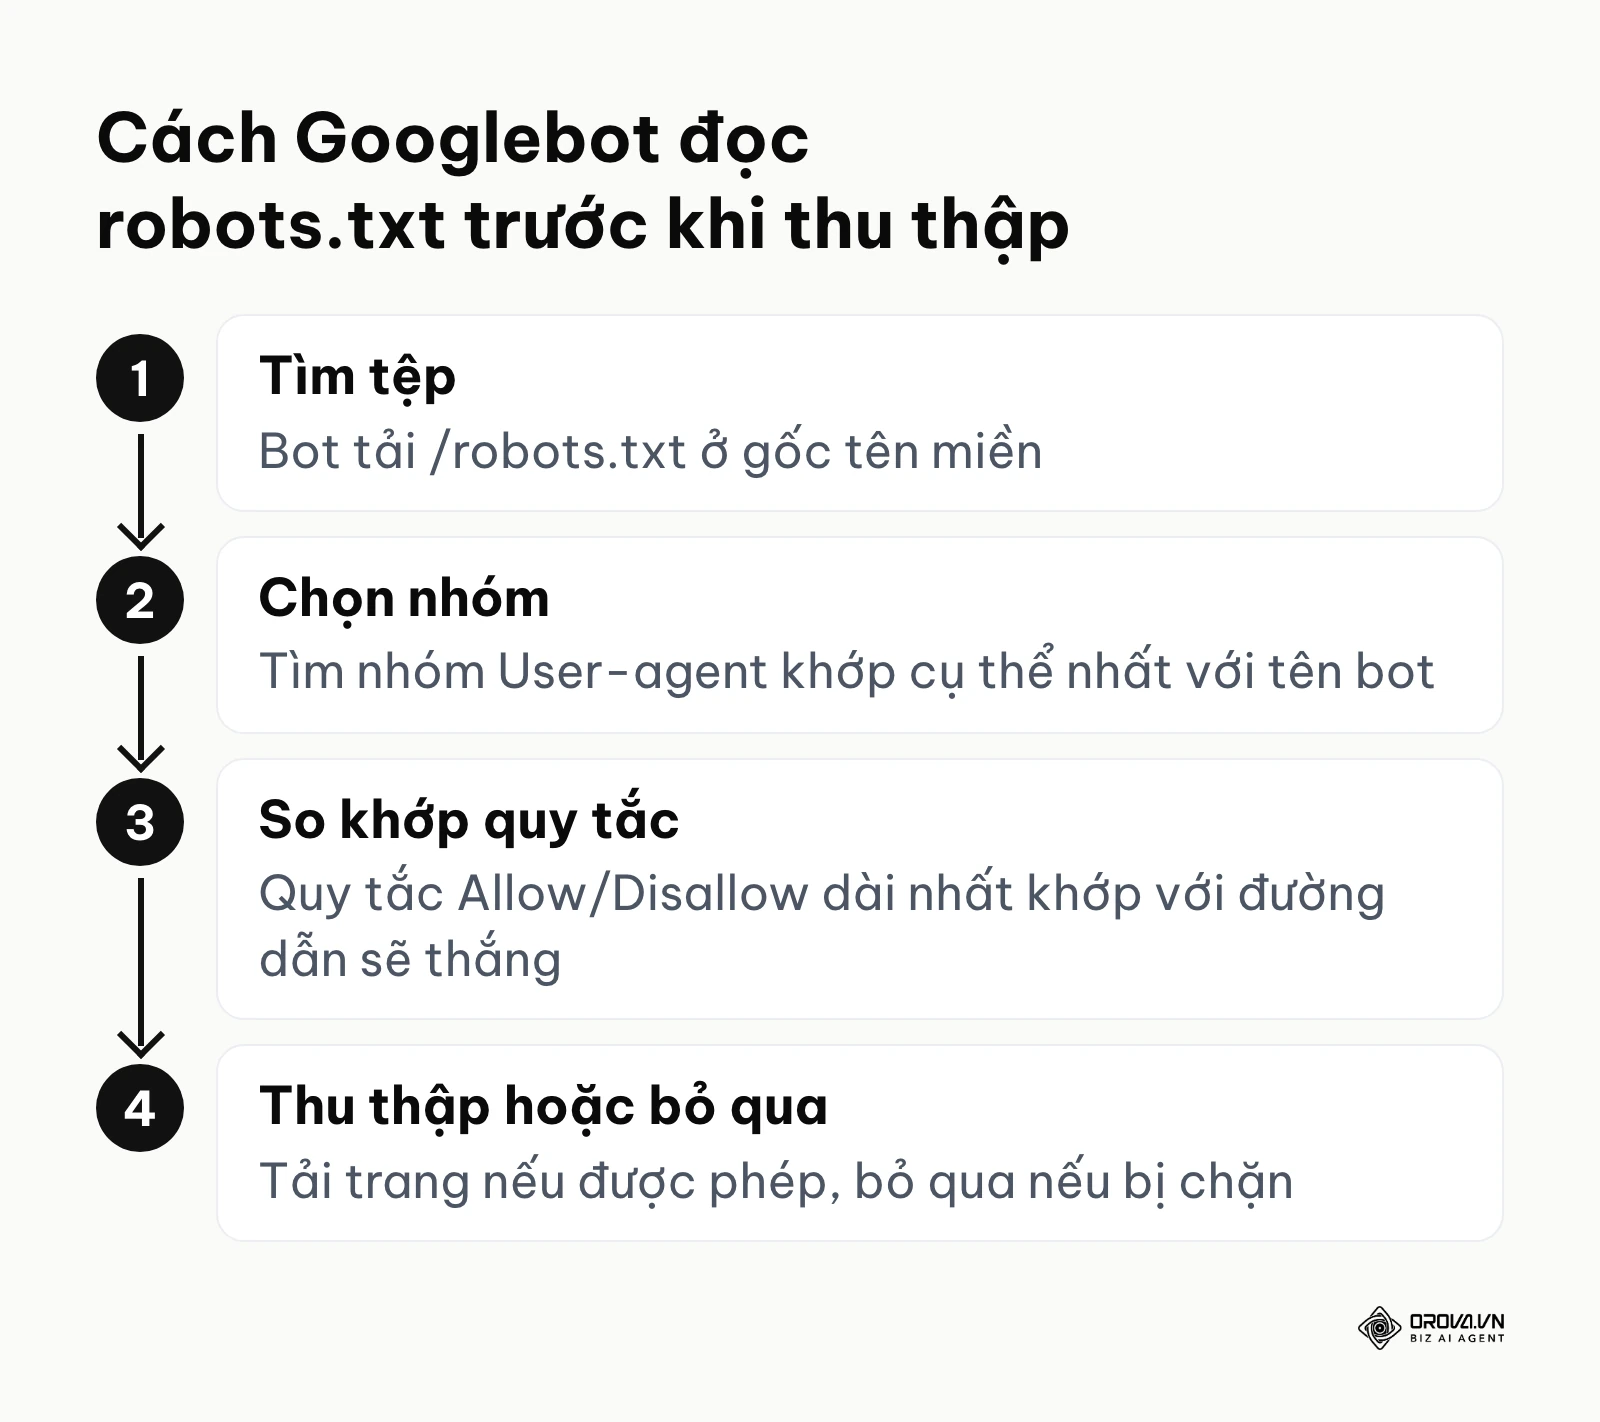
- Tệp phải tên đúng là robots.txt (chữ thường) và nằm ở gốc tên miền. Tệp đặt trong thư mục con như tenmien.com/trang/robots.txt sẽ không được đọc.
- Mỗi tên miền phụ, mỗi giao thức (http, https) và cổng có tệp riêng. Tệp ở tenmien.com không áp dụng cho blog.tenmien.com.
- Tệp là văn bản thuần mã hoá UTF-8. Google chỉ đọc tối đa 500 KiB đầu tiên, phần vượt quá bị bỏ qua.
- Đường dẫn trong quy tắc phân biệt chữ hoa chữ thường: /Admin/ và /admin/ là hai đường dẫn khác nhau.
- Google hỗ trợ bốn trường: User-agent, Disallow, Allow, Sitemap. Các dòng như Crawl-delay hay Noindex trong robots.txt sẽ bị Google bỏ qua.
User-agent: Xác định danh tính đối tượng được cấp quyền
Mỗi nhóm quy tắc bắt đầu bằng một hoặc nhiều dòng User-agent, cho biết nhóm đó dành cho bot nào. Dấu * nghĩa là mọi bot không có nhóm riêng. Một bot chỉ làm theo nhóm khớp cụ thể nhất với tên của nó: nếu có nhóm User-agent: Googlebot, Googlebot sẽ theo nhóm đó và bỏ qua nhóm *.
Đầu vào của dòng này là tên bot (ví dụ Googlebot, Bingbot), đầu ra là việc bot xác định nhóm quy tắc nào dành cho mình. Chỗ dễ hỏng là viết sai tên bot, khiến nhóm quy tắc không áp dụng cho bot bạn nhắm tới. Lỗi thứ hai là tạo nhóm riêng cho Googlebot rồi quên chép các quy tắc chung vào đó, vì Googlebot sẽ không đọc nhóm * nữa.
Gần đây, nhiều chủ website quan tâm tới các bot thu thập dữ liệu cho trí tuệ nhân tạo. Nếu một hãng AI công bố tên User-agent cho bot của họ và cam kết tuân theo robots.txt, bạn có thể khai báo một nhóm User-agent riêng cho bot đó. Ví dụ, OpenAI công bố bot GPTBot, còn Google có mã Google-Extended để chủ website chọn không cho nội dung được dùng cho các mô hình AI của Google; theo Google, mã này không ảnh hưởng tới việc website xuất hiện trên Google Search. Danh sách bot AI thay đổi liên tục, nên trước khi thêm, hãy đọc trang hướng dẫn chính thức của từng hãng để lấy đúng tên.
Cú pháp Disallow: Thiết lập vành đai cấm
Sau dòng User-agent, lệnh Disallow cho bot biết đường dẫn nào không được thu thập. Giá trị là đường dẫn tính từ gốc tên miền, bắt đầu bằng dấu gạch chéo /. Để trống giá trị (Disallow:) nghĩa là không chặn gì.
Lệnh này so khớp theo phần đầu của đường dẫn. Disallow: /thu-muc/ chặn mọi đường dẫn bắt đầu bằng /thu-muc/. Chỗ dễ hỏng nhất là quên dấu gạch chéo ở cuối: Disallow: /admin không chỉ chặn /admin/ mà còn chặn cả /admin-marketing.html, vì cả hai đều bắt đầu bằng /admin. Và Disallow: / (chỉ một dấu gạch chéo) chặn thu thập toàn bộ website.
Cú pháp Allow: Mở cửa ngoại lệ trong khu vực cấm
Đôi khi bạn muốn khoá cả một căn phòng nhưng chừa lại một ngăn tủ. Lệnh Allow tạo ra ngoại lệ đó: cho phép thu thập một đường dẫn nằm bên trong vùng đã bị Disallow.
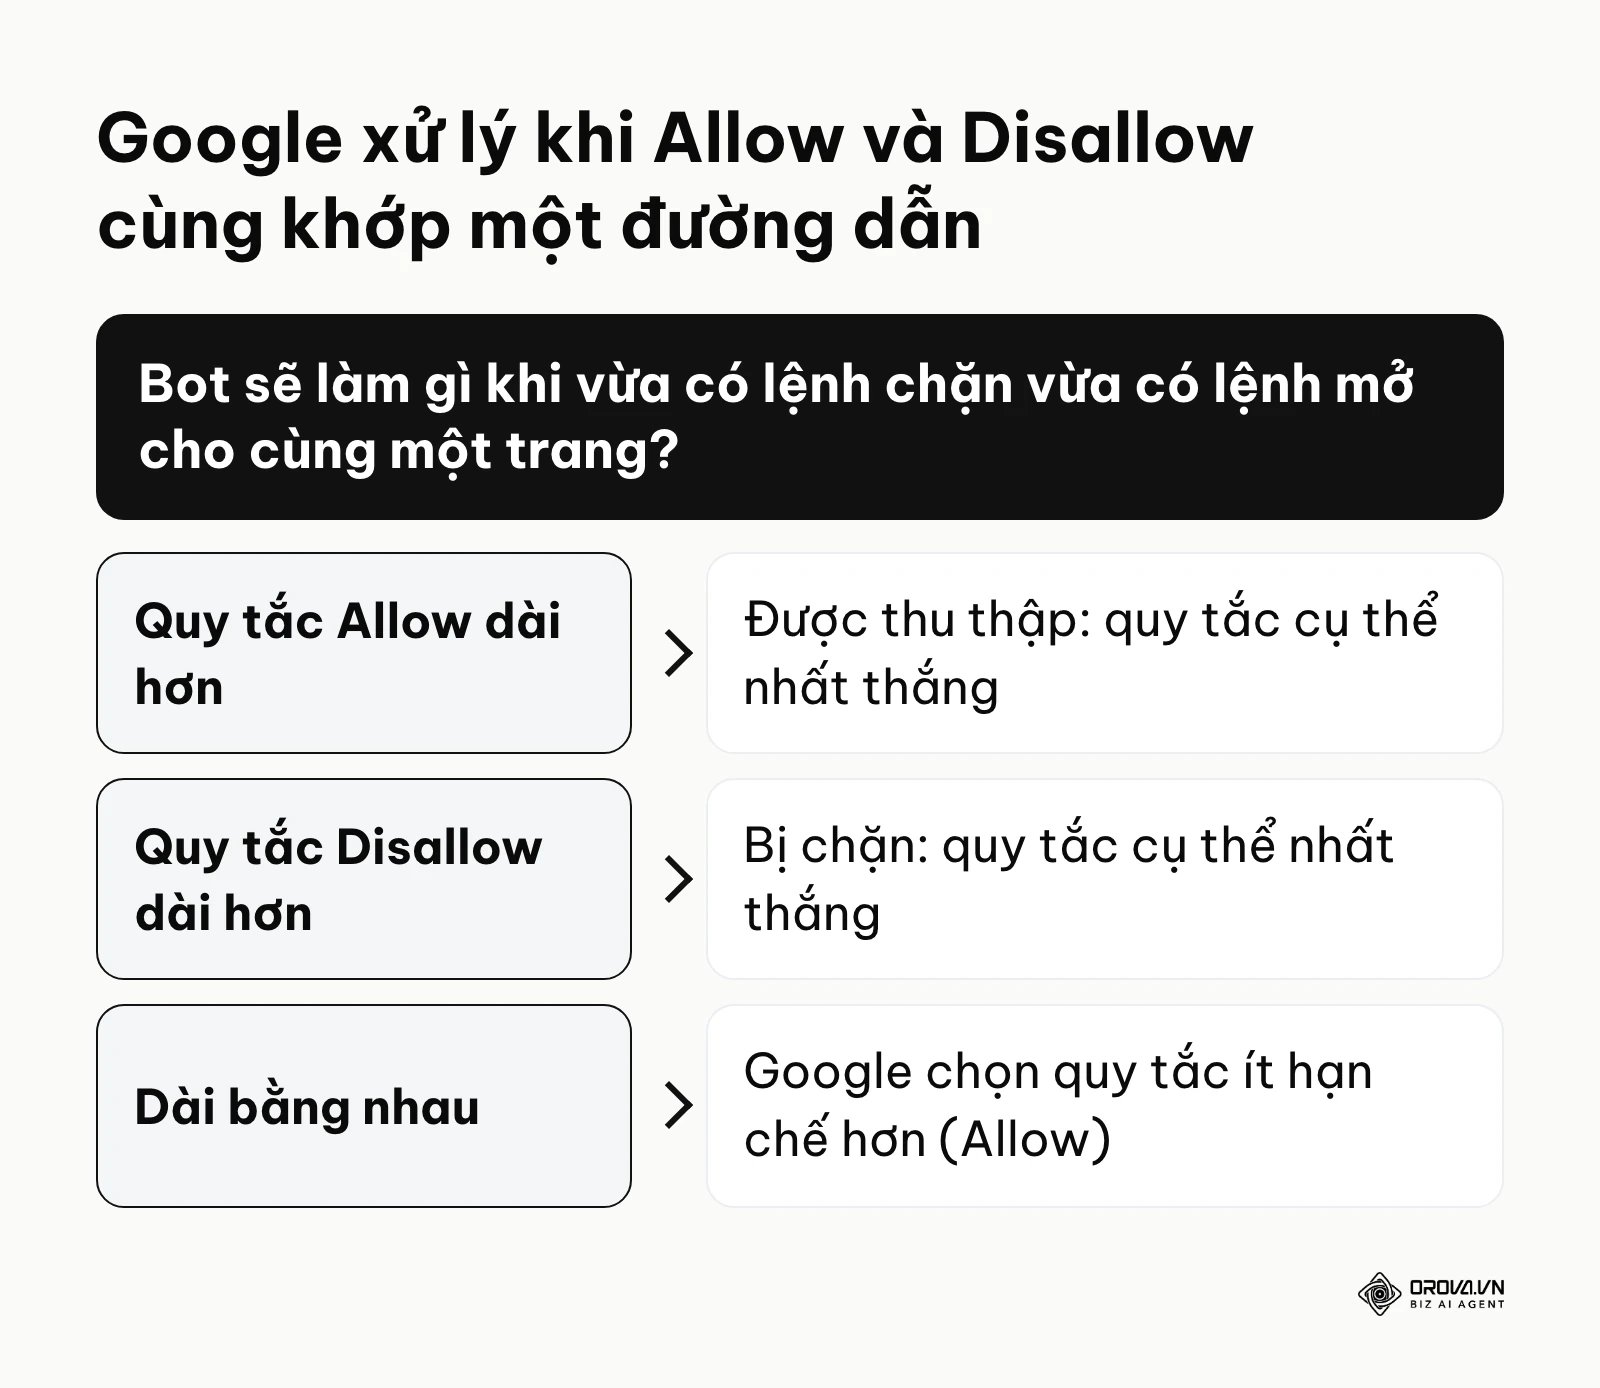
Với Google, thứ tự các dòng trong nhóm không quan trọng. Khi một đường dẫn khớp cả Allow lẫn Disallow, Google dùng quy tắc cụ thể nhất, tức quy tắc có đường dẫn dài nhất. Nếu hai quy tắc dài bằng nhau, Google chọn quy tắc ít hạn chế hơn, tức Allow. Chỗ hay hỏng là viết Allow ngắn hơn Disallow, khiến ngoại lệ không có tác dụng.
User-agent: *
Disallow: /tai-lieu/
Allow: /tai-lieu/bang-gia-cong-khai.html
Trong ví dụ trên, /tai-lieu/bang-gia-cong-khai.html vẫn được thu thập vì quy tắc Allow dài hơn, còn mọi đường dẫn khác trong /tai-lieu/ bị chặn.
Ký tự đại diện (Wildcard): Xử lý tham số và URL động
Với website có nhiều đường dẫn động, liệt kê thủ công từng đường dẫn là không khả thi. Google hỗ trợ hai ký tự đại diện: dấu sao * thay cho không hoặc nhiều ký tự bất kỳ, và dấu đô la $ đánh dấu điểm kết thúc của đường dẫn.
- Disallow: /*?sort= chặn mọi đường dẫn có tham số sort đứng ngay sau dấu hỏi.
- Disallow: /*.pdf$ chặn mọi đường dẫn kết thúc bằng .pdf, nhưng không chặn /tai-lieu.pdf?v=2 vì đường dẫn này không kết thúc bằng .pdf.
Ví dụ minh hoạ:
- Bối cảnh: Quản trị viên của một cổng thông tin lưu trữ báo cáo đa ngành trong nhiều năm, có hàng nghìn biểu mẫu PDF gần như trùng nhau làm bot tốn lượt thu thập.
- Các bước đã làm: Thêm dòng Disallow: /*.pdf$ để bot không thu thập các tệp PDF trên toàn trang, rồi tải tệp robots.txt mới lên gốc tên miền.
- Chỗ vấp và cách gỡ: Quên rằng chuyên mục "Báo cáo thường niên" dạng PDF cần được tìm thấy trên Google. Quản trị viên thêm Allow: /bao-cao-thuong-nien/*.pdf$. Quy tắc này dài hơn quy tắc chặn chung nên thắng, các báo cáo thường niên lại được thu thập.
- Kết quả: Báo cáo công khai vẫn được thu thập, các biểu mẫu khác không còn tốn lượt của bot. Với những tệp PDF không muốn xuất hiện trên Google, quản trị viên dùng thêm tiêu đề X-Robots-Tag: noindex thay vì chỉ dựa vào robots.txt.
Khai báo Sitemap: Bản đồ kho báu
Dòng Sitemap không thuộc nhóm User-agent nào và có thể đặt ở bất kỳ đâu trong tệp, thường là cuối tệp. Giá trị phải là đường dẫn đầy đủ, có cả https:// và tên miền, trỏ tới tệp sitemap XML. Bạn có thể khai báo nhiều dòng Sitemap nếu có nhiều tệp.
Dòng này giúp công cụ tìm kiếm tìm ra sitemap của bạn, nhất là với những công cụ bạn chưa gửi sitemap thủ công. Sitemap chỉ là gợi ý về những đường dẫn bạn muốn được biết tới, không đảm bảo các trang đó sẽ được thu thập hay lập chỉ mục.
| Loại lệnh | Đặc điểm hoạt động | Phù hợp với website nào |
|---|---|---|
| Lệnh cơ bản (User-agent, Disallow) | Chặn theo phần đầu đường dẫn. | Mọi website cần chặn một vài khu vực. |
| Lệnh ngoại lệ (Allow) | Mở lại một đường dẫn cụ thể trong vùng bị chặn, quy tắc dài hơn thắng. | Website có thư mục lồng nhau, nhiều tầng. |
| Ký tự đại diện (*, $) | Xử lý tham số tự sinh, đuôi tệp. | Trang thương mại điện tử, báo điện tử nhiều chuyên mục. |
| Nhóm User-agent riêng cho bot AI | Chỉ có tác dụng với bot tuân theo robots.txt và đúng tên đã khai báo. | Trang muốn hạn chế nội dung bị dùng cho AI, sau khi đọc hướng dẫn của từng hãng. |
| Sitemap | Chỉ đường tới sitemap XML bằng URL đầy đủ. | Mọi website có sitemap. |
Thư viện file mẫu thực chiến sẵn sàng sử dụng
Các mẫu dưới đây đúng cú pháp theo tài liệu của Google, nhưng đường dẫn cụ thể phải sửa theo website của bạn. Dòng bắt đầu bằng # là ghi chú, bot bỏ qua. Không mẫu nào chặn thư mục chứa CSS, JavaScript hay hình ảnh, vì Google cần các tệp này để hiển thị trang đúng như người dùng thấy.
Mẫu 1: Website công ty giới thiệu dịch vụ Cho phép thu thập gần như mọi thứ, chỉ chặn khu vực đăng nhập và trang kết quả tìm kiếm nội bộ.
User-agent: *
Disallow: /dang-nhap/
Disallow: /tim-kiem/

Sitemap: https://tenmien.com/sitemap.xml
Mẫu 2: Website WordPress có bán hàng bằng WooCommerce Chặn trang quản trị nhưng mở admin-ajax.php (nhiều giao diện cần tệp này), chặn giỏ hàng, thanh toán và các đường dẫn tham số tự sinh. Không chặn /wp-content/ hay /wp-includes/.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /*?add-to-cart=
Disallow: /*?orderby=
Disallow: /*?s=

Sitemap: https://tenmien.com/sitemap_index.xml
Mẫu 3: Website tin tức muốn khai báo riêng cho bot AI Chặn trang tìm kiếm nội bộ cho mọi bot, và thêm nhóm riêng cho bot AI mà bạn đã kiểm tên trên trang hướng dẫn chính thức của hãng.
# Quy tắc chung cho mọi bot
User-agent: *
Disallow: /tim-kiem/
Disallow: /*?s=

# Nhóm riêng cho bot AI (kiểm lại tên trên trang hướng dẫn của từng hãng)
User-agent: GPTBot
User-agent: Google-Extended
Disallow: /

Sitemap: https://tenmien.com/sitemap.xml
Lưu ý: bot nào có nhóm riêng sẽ chỉ đọc nhóm đó. Googlebot không bị ảnh hưởng bởi nhóm Google-Extended ở trên.
Với OROVA.VN và module OROVA SEO, bạn sẽ hoàn toàn chấm dứt chuỗi ngày xử lý công việc thủ công mệt mỏi. Thay vì loay hoay hàng giờ đồng hồ để viết bài và lập báo cáo, giờ đây toàn bộ quy trình được tối ưu hóa và hoàn thiện chỉ trong 5 phút.
Cần làm gì để bắt đầu kiểm soát bot và bảo vệ website?
Làm chủ robots.txt không chỉ là việc của lập trình viên. Tuỳ vai trò, bạn có thể bắt đầu từ những bước khác nhau.
Chủ doanh nghiệp nhỏ (SME)
Nếu bạn không rành kỹ thuật, ưu tiên hàng đầu là "không làm hỏng những gì đang chạy tốt".
- Kiểm tra sự tồn tại: Gõ tenmien.com/robots.txt lên trình duyệt xem tệp có tồn tại không, và có dòng Disallow: / nằm dưới User-agent: * hay không.
- Trao đổi với đơn vị làm web: Hỏi họ tệp đang chặn những gì và vì sao, nhất là sau mỗi lần đổi giao diện hay chuyển máy chủ.
- Ra quyết định về bot AI: Nếu muốn hạn chế nội dung bị dùng cho AI, yêu cầu kỹ thuật viên thêm nhóm User-agent riêng theo hướng dẫn chính thức của từng hãng, và hiểu rằng việc này chỉ có tác dụng với bot tuân thủ.
Chuyên viên SEO (In-house)
Đây là người thường xuyên thao tác và chịu trách nhiệm trực tiếp về khả năng hiển thị trên Google.
- Khảo sát hiện trạng: Tải tệp hiện hành về và đối chiếu với cấu trúc thư mục thật của website.
- Rà soát báo cáo: Mở Google Search Console, vào báo cáo Lập chỉ mục trang, xem nhóm "Bị chặn bởi tệp robots.txt" có chứa trang quan trọng nào không. Nếu chưa quen giao diện, xem thêm cách sử dụng Google Search Console.
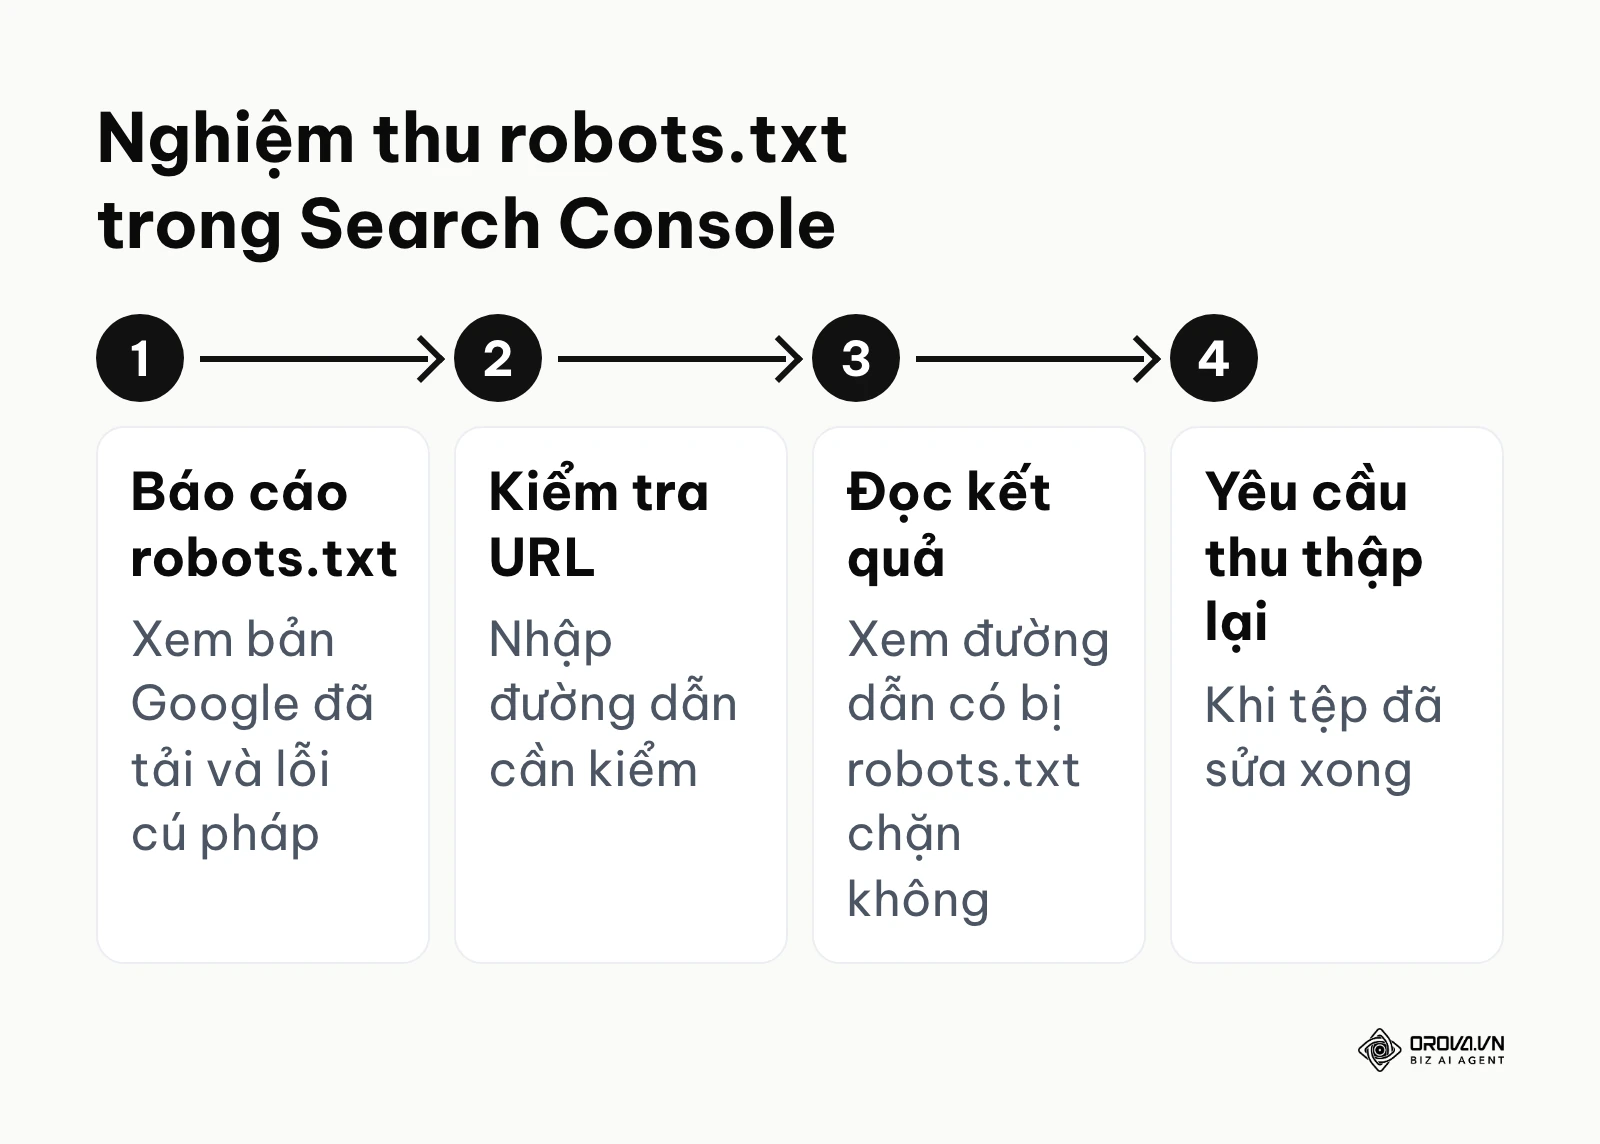
- Kiểm tra tệp: Mở báo cáo robots.txt trong phần Cài đặt của Search Console để xem Google đã tải phiên bản nào, lúc nào, có lỗi cú pháp không. Công cụ "Trình kiểm tra robots.txt" cũ đã bị Google gỡ, báo cáo này là nơi thay thế.
- Nghiệm thu từng đường dẫn: Sau mỗi lần thêm quy tắc, dùng công cụ Kiểm tra URL để xem một đường dẫn cụ thể có bị robots.txt chặn hay không.
- Triển khai và xoá bộ nhớ đệm: Nếu website dùng CDN hoặc plugin cache, xoá cache để tệp mới được trả về đúng. Khi cần Google cập nhật nhanh, có thể yêu cầu thu thập lại ngay trong báo cáo robots.txt.
Ví dụ minh hoạ:
- Bối cảnh: Một chuyên viên SEO mới nhận dự án phục hồi khả năng hiển thị cho website giới thiệu dịch vụ chạy WordPress.
- Các bước đã làm: Dùng công cụ Kiểm tra URL, thấy ảnh chụp trang Google hiển thị bị vỡ bố cục. Mở robots.txt, phát hiện người làm trước đã chặn /wp-includes/ và /wp-content/, nơi chứa CSS và JavaScript. Xoá hai dòng này và tải tệp mới lên.
- Chỗ vấp và cách gỡ: Vài ngày sau, báo cáo robots.txt vẫn hiển thị phiên bản cũ. Hoá ra CDN đang lưu tệp cũ trong bộ nhớ đệm. Chuyên viên xoá cache trên CDN rồi yêu cầu Google thu thập lại tệp robots.txt.
- Kết quả: Công cụ Kiểm tra URL hiển thị trang đầy đủ bố cục, và từ đó Google đọc được trang đúng như người dùng nhìn thấy.
Đơn vị thiết kế web và Agency
Với đơn vị làm web cho nhiều khách hàng, việc chuẩn hoá quy trình cho tệp này rất đáng làm.
- Xây dựng thư viện chuẩn: Tạo mẫu tệp cho từng loại dự án (landing page, blog, thương mại điện tử), và ghi rõ dòng nào phải sửa theo từng website.
- Kiểm tra trước khi bàn giao: Đưa việc mở tenmien.com/robots.txt vào danh sách nghiệm thu, đảm bảo không còn Disallow: / từ môi trường thử nghiệm.
- Tắt chế độ ẩn của môi trường thử nghiệm: Với WordPress, kiểm tra tuỳ chọn "Ngăn chặn các công cụ tìm kiếm đánh chỉ mục trang web này" trong phần Cài đặt Đọc đã được bỏ chọn trước khi bàn giao. Khi định kỳ rà soát kỹ thuật cho khách, robots.txt nên là một mục cố định, như trong một đợt SEO audit thực tế.
Càng can thiệp sâu, nguy cơ mắc lỗi càng cao. Dưới đây là các sai lầm kinh điển cần tránh.
| Sai lầm kỹ thuật hay gặp | Hậu quả | Cách phòng tránh |
|---|---|---|
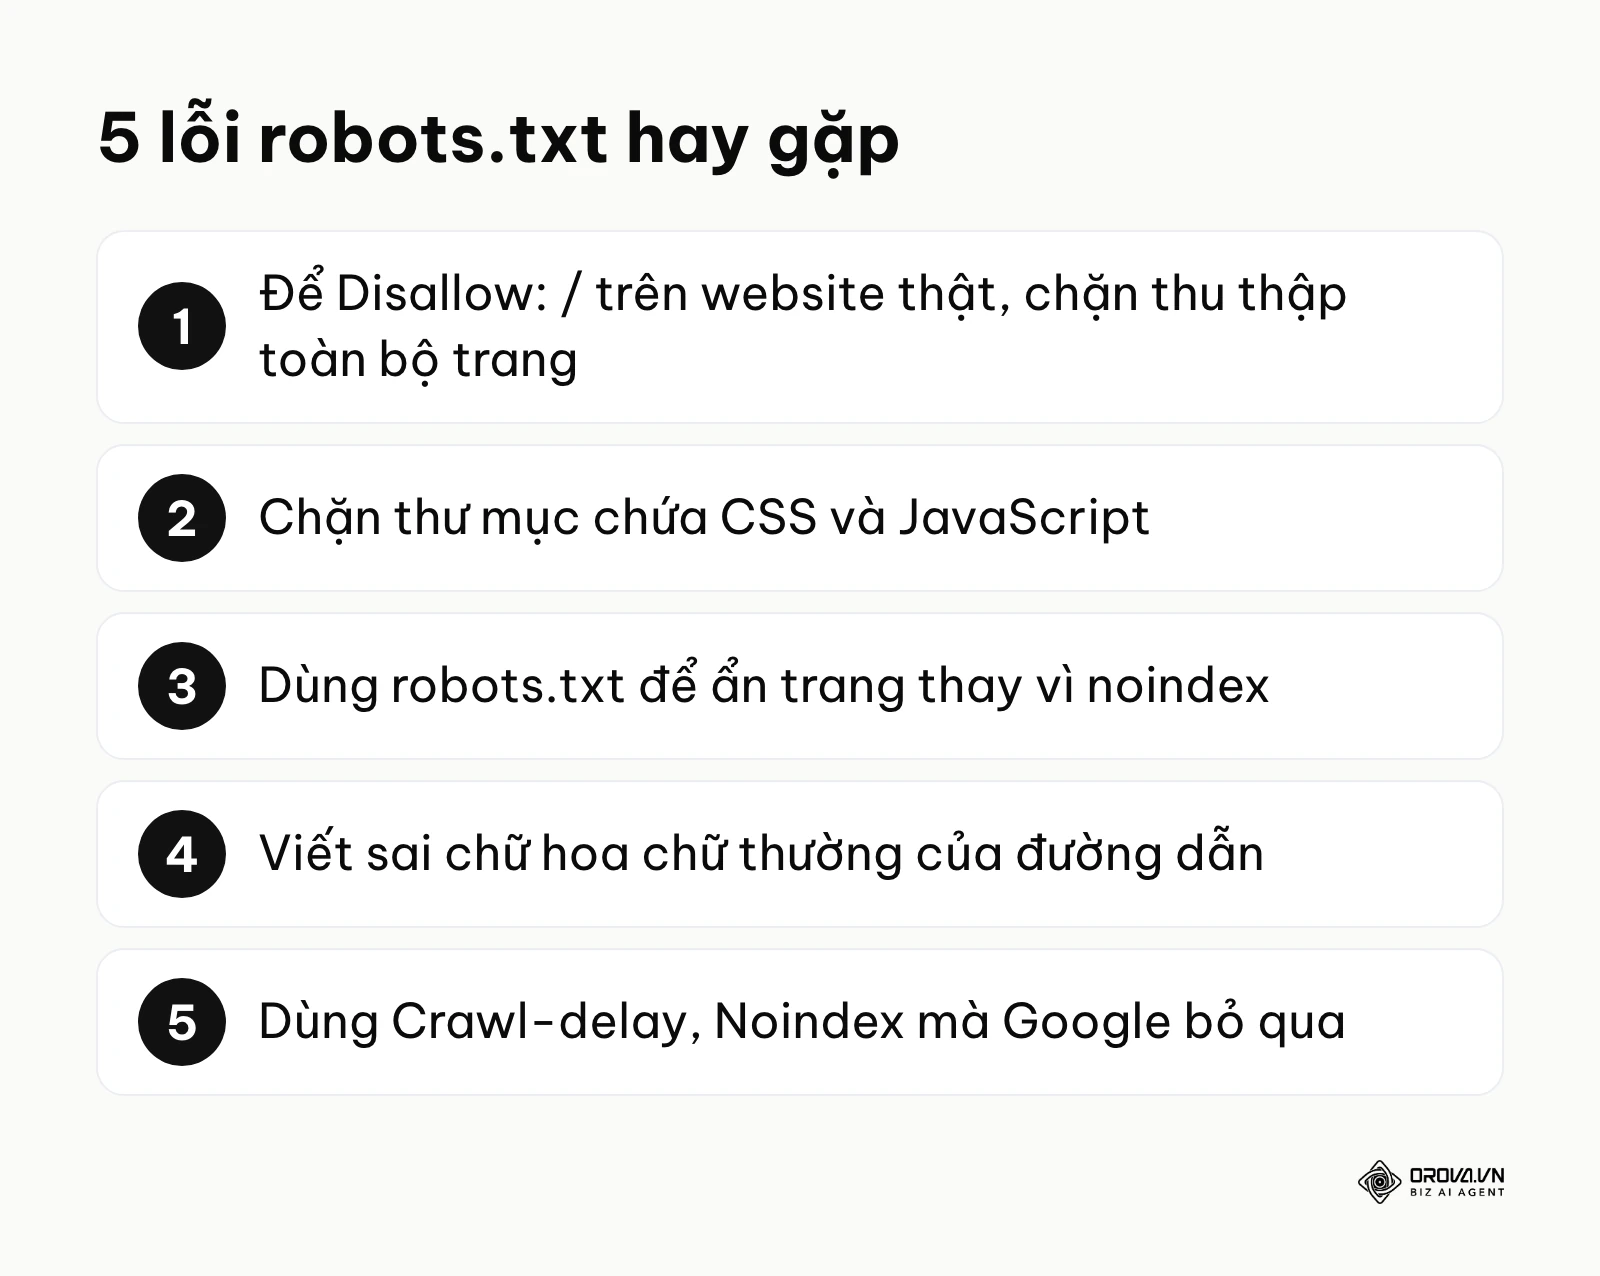
| Để Disallow: / dưới User-agent: * trên website thật. | Google không thu thập được trang nào, nội dung mới không được cập nhật trên kết quả tìm kiếm. | Kiểm tra tệp mỗi khi chuyển từ môi trường thử nghiệm sang website thật. |
| Chặn thư mục chứa CSS hoặc JavaScript. | Google không hiển thị được trang như người dùng thấy, có thể hiểu sai nội dung và bố cục. | Không chặn các thư mục giao diện như /wp-content/, /assets/, /css/. |
| Viết sai chữ hoa chữ thường (chặn /Admin/ trong khi đường dẫn thật là /admin/). | Quy tắc không có tác dụng vì đường dẫn trong robots.txt phân biệt hoa thường. | Chép đúng đường dẫn từ thanh địa chỉ trình duyệt. |
| Dùng robots.txt để ẩn trang khỏi Google. | Trang vẫn có thể hiện trên kết quả tìm kiếm, và Google không đọc được thẻ noindex. | Dùng noindex và để trang được thu thập. |
| Dùng Crawl-delay hoặc Noindex trong robots.txt để điều khiển Google. | Google bỏ qua các dòng này. | Dùng đúng công cụ: noindex trên trang, các thiết lập trong Search Console. |
Câu hỏi hay gặp về thiết lập kỹ thuật
Robots.txt có còn cần thiết khi đã có các hệ thống AI thông minh không?
Có. Robots.txt vẫn là cách chuẩn để nói với các trình thu thập dữ liệu tuân thủ quy ước rằng phần nào của website bạn không muốn chúng tải. Điều này áp dụng cho cả bot của công cụ tìm kiếm lẫn bot AI có công bố tên. Tuy nhiên, robots.txt không ngăn được bot cố tình phớt lờ quy tắc; với những bot đó, bạn cần biện pháp ở tầng máy chủ như tường lửa hoặc giới hạn truy cập.
Làm sao để chặn các công cụ của đối thủ soi xét cấu trúc website của tôi?
Nhiều công cụ SEO bên thứ ba công bố tên bot của họ (ví dụ AhrefsBot, SemrushBot) và hướng dẫn chặn bằng robots.txt. Bạn có thể thêm nhóm User-agent với đúng tên đó và đặt Disallow: /. Hãy nhớ việc này chỉ tác động tới bot tuân thủ, và không ảnh hưởng tới dữ liệu mà các công cụ đó đã thu thập từ trước hay lấy từ nguồn khác.
Nên dùng robots.txt hay thẻ noindex để ẩn một trang vĩnh viễn?
Dùng thẻ meta noindex (hoặc tiêu đề X-Robots-Tag: noindex cho tệp không phải HTML), và không chặn trang đó trong robots.txt. Nếu trang bị chặn thu thập, Google không đọc được thẻ noindex, và nếu có link trỏ tới, đường dẫn vẫn có thể hiện trên kết quả tìm kiếm nhưng không có mô tả.
Lỡ tay lưu nhầm lệnh chặn toàn bộ website thì bao lâu sau Google mới phục hồi hiển thị?
Không có mốc thời gian cố định. Việc cần làm ngay là sửa tệp, xoá cache nếu có, rồi vào báo cáo robots.txt trong Search Console để yêu cầu Google thu thập lại tệp. Google thường lưu bản robots.txt trong bộ nhớ đệm một thời gian, nên thay đổi không có tác dụng tức thì. Sau đó, dùng công cụ Kiểm tra URL để yêu cầu lập chỉ mục lại các trang quan trọng nhất. Lỗi càng để lâu, việc thu thập lại toàn bộ website càng mất nhiều thời gian.
Nên bắt đầu từ đâu để làm chủ dữ liệu?
Quản lý robots.txt tốt không đòi hỏi bạn phải là lập trình viên, nhưng cần làm có hệ thống. Hãy đối chiếu website của mình với ba tình huống dưới đây để chọn bước đầu tiên.
Trạng thái 1: Chưa có tệp robots.txt Nếu bạn mở tenmien.com/robots.txt và nhận về lỗi 404, đừng lo: Google coi như được phép thu thập toàn bộ website. Nếu muốn có tệp để khai báo sitemap, hãy mở trình soạn văn bản thuần (Notepad hoặc TextEdit ở chế độ văn bản thuần), dùng mẫu 1 ở trên rồi sửa đường dẫn cho đúng website. Lưu tệp với tên robots.txt, mã hoá UTF-8, tải lên thư mục gốc, rồi mở lại địa chỉ trên trình duyệt để chắc tệp hiển thị đúng.
Trạng thái 2: Đã có tệp nhưng nội dung chắp vá, chép từ mạng Nhiều website có tệp chứa hàng chục dòng chặn những thư mục đã không còn tồn tại, do người làm trước để lại. Hãy xuất danh sách thư mục hiện có, đối chiếu với từng quy tắc, xoá những dòng không còn ý nghĩa và đặc biệt soát các dòng chặn CSS, JavaScript. Tệp gọn giúp bạn và đồng nghiệp đọc hiểu nhanh, ít rủi ro chặn nhầm.
Trạng thái 3: Đã thiết lập chuẩn nhưng chưa theo dõi Khi tệp đã ổn, việc tiếp theo là theo dõi định kỳ. Mở báo cáo Số liệu thống kê thu thập dữ liệu trong Google Search Console để xem Googlebot đang dành lượt thu thập cho loại trang nào, và báo cáo robots.txt để chắc Google tải được tệp mới nhất. Đưa robots.txt vào danh sách kiểm tra mỗi lần đổi giao diện, chuyển máy chủ hay thêm chuyên mục mới.
Về tác giả
Người xây dựng Orova
Nguyễn Đỗ Trọng Ân có 8 năm làm marketing, trong đó 6 năm quản lý khai thác thị trường châu Á. Anh là người xây dựng Orova, Biz AI Agent hoạt động không ngủ: tự lên kế hoạch, chạy và tối ưu công việc cho doanh nghiệp.
Vận hành doanh nghiệp với AI Agent
Orova là Biz AI Agent hoạt động không ngủ — tự lên kế hoạch, chạy và tối ưu công việc.
Tiết kiệm thời gian, bứt phá hiệu suất.