
Arquitectura web SEO: qué es y cómo estructurar un sitio escalable
La arquitectura web seo constituye el cimiento invisible sobre el que se sostiene el rastreo, la indexación y la distribución de autoridad de cualquier proyecto digital. Muchos sitios web publican cientos de contenidos o miles de productos comerciales cada mes, pero observan con frustración cómo su tráfico orgánico se estanca, sus nuevas URLs tardan semanas en aparecer en los índices de búsqueda y Googlebot malgasta sus visitas en parámetros irrelevantes. La creencia tradicional de que el posicionamiento se reduce a optimizar etiquetas de texto y acumular enlaces externos resulta insuficiente cuando la base estructural es deficiente. Si las páginas no están organizadas de forma lógica y accesible, los motores de búsqueda no logran comprender qué contenidos importan ni cómo se relacionan entre sí. Esta guía técnica analiza en profundidad cómo planificar, auditar y ejecutar una estructura jerárquica moderna, abordando problemas complejos como la navegación por facetas, los silos semánticos y la adaptación a motores de inteligencia artificial sin poner en peligro el tráfico existente.
¿Qué es la arquitectura web SEO y en qué se diferencia de la estructura técnica?
La arquitectura web SEO es la organización lógica, jerárquica y semántica de las páginas de un sitio para optimizar el rastreo de motores de búsqueda y la navegación humana. Sirve para distribuir autoridad y clarificar temáticas, diferenciándose del diseño puramente funcional en su priorización de flujos de rastreo y relevancia temática estructurada.
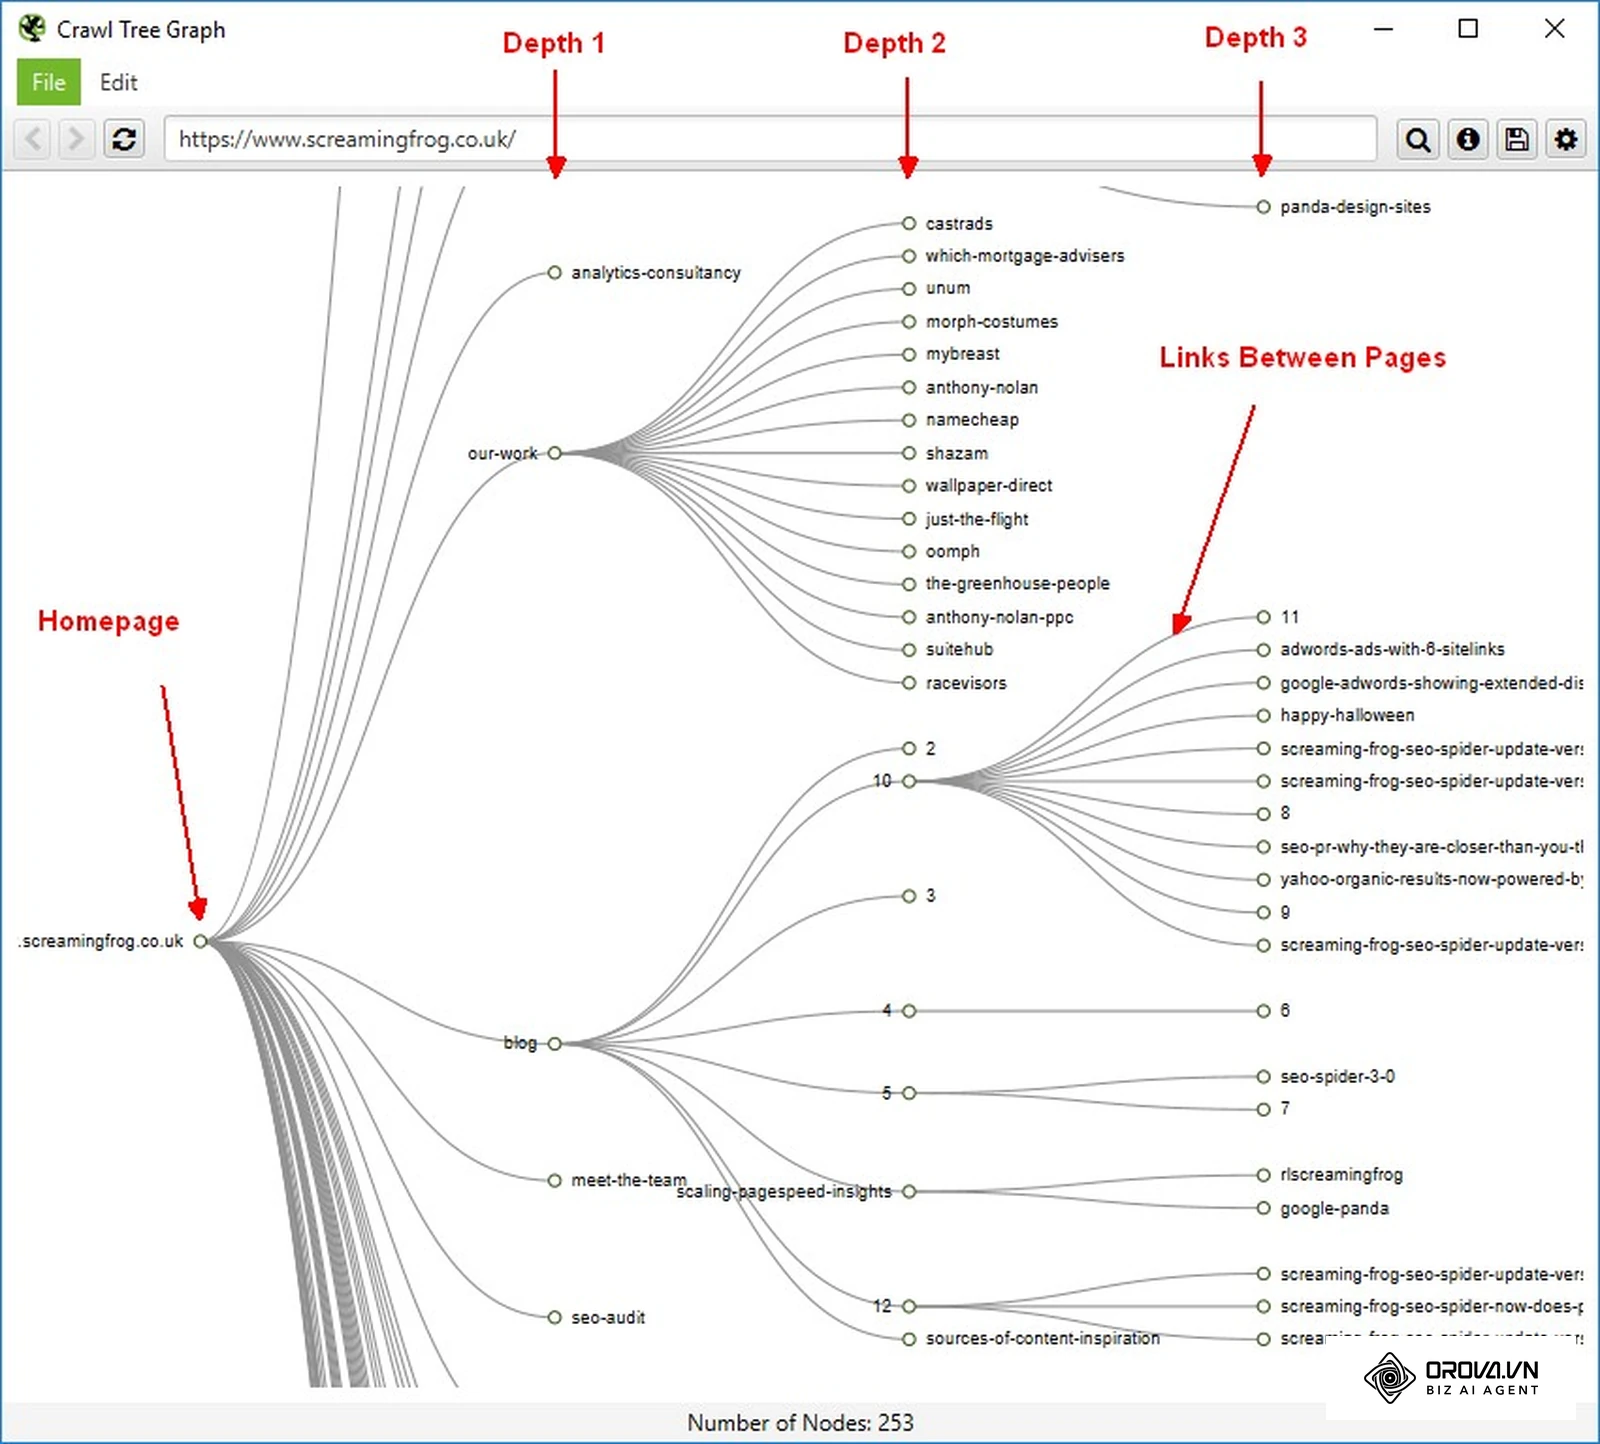
La forma más rápida de ver la arquitectura de un sitio real es el gráfico de árbol de rastreo (Crawl Tree Graph) de Screaming Frog SEO Spider: cada columna corresponde a un nivel de profundidad de clics desde la página de inicio y cada línea es un enlace interno. Si una rama se alarga hasta la cuarta o quinta columna, esas páginas están demasiado lejos de la portada; si hay URLs que no cuelgan de ninguna rama, son huérfanas.
El término proviene de la convergencia entre la arquitectura de la información tradicional, desarrollada por Richard Saul Wurman en la década de 1970 para clasificar datos en soportes físicos, y los algoritmos de recuperación de información basados en grafos de enlaces que originaron los motores de búsqueda modernos. Mientras que la arquitectura tradicional organizaba contenidos exclusivamente para la comprensión visual humana, la disciplina orientada al posicionamiento orgánico añade una dimensión algorítmica indispensable: la necesidad de que programas automatizados (crawlers o rastreadores) descubran, interpreten y ponderen el valor relativo de cada nodo dentro de la red del sitio.
Es común confundir la arquitectura web SEO con otros elementos técnicos o visuales de una plataforma. Para establecer límites claros, la siguiente tabla detalla sus diferencias frente a conceptos adyacentes:
| Concepto | En qué se diferencia | Ejemplo |
|---|---|---|
| Arquitectura web SEO | Define la jerarquía temática, la profundidad de clics y las rutas de flujo de PageRank entre todas las páginas. | Un clúster semántico donde una categoría transaccional nutre y recibe autoridad de diez guías de compra. |
| Estructura técnica de URLs | Representa la sintaxis y las carpetas visibles en la barra de direcciones del navegador. | La convención textual /categoria/subcategoria/producto-nombre/ frente a /p/12345/. |
| Enlazado interno UI/UX | Diseña los componentes visuales de interacción para que el usuario navegue sin fricción. | Un botón de llamada a la acción en la cabecera o un carrusel dinámico de artículos recomendados. |
Para visualizar esta distinción en el mundo físico, imagina la construcción de unos grandes almacenes. La arquitectura web SEO equivale a la distribución urbanística de los edificios y las escaleras mecánicas que conectan las plantas principales con las secciones especializadas, garantizando que los clientes y los carritos de mercancías lleguen a cualquier pasillo en pocos pasos. La estructura de URLs sería la rotulación de los carteles colgantes que indican el pasillo exacto, mientras que el enlazado interno UI/UX corresponde a las flechas luminosas en el suelo que guían hacia las cajas de pago.
El valor estratégico de la arquitectura web SEO: qué problemas resuelve en el negocio
Una arquitectura deficiente genera pérdidas económicas directas al dispersar la autoridad de dominio y colapsar los recursos de rastreo que los buscadores destinan al portal. Cuando un sitio web crece de manera desordenada, surgen miles de páginas huérfanas (orphan pages, documentos que no reciben enlaces internos desde ninguna otra parte del sitio) y se desencadena la canibalización SEO, una situación en la que varias URLs de la misma empresa compiten por las mismas intenciones de búsqueda, confunden a los algoritmos y reducen la visibilidad global de la marca.
Dentro de una estrategia digital completa, la arquitectura web SEO ocupa una posición central que conecta la investigación de mercado con la ejecución técnica. No es el primer paso ni el último, sino el puente estructural que determina el éxito de las demás acciones:
- Lo que precede: La investigación de palabras clave, la identificación de entidades semánticas y la definición de los objetivos de negocio determinan qué páginas deben existir.
- El papel de la arquitectura: Organiza dichas páginas en niveles jerárquicos coherentes, asigna la profundidad de acceso y diseña los caminos de transmisión de relevancia.
- Lo que sucede después: La redacción de contenidos especializados, la optimización de metadatos y las campañas de captación de enlaces externos construyen sobre esa cuadrícula ya validada.
Si una empresa ignora este orden, el coste de corregir los fallos a posteriori se multiplica. Rediseñar una web cuando ya cuenta con decenas de miles de URLs indexadas exige redirecciones complejas, auditorías de enlaces rotos y una inevitable volatilidad temporal en el posicionamiento orgánico.
Cuándo aún no necesitas una arquitectura web compleja
No todos los proyectos requieren sistemas jerárquicos avanzados ni divisiones en múltiples subcategorías. Si estás lanzando una página de aterrizaje única (landing page) para validar una propuesta de producto, un catálogo de servicios profesionales que no supera las quince URLs o un portal de presentación corporativa en fase de pruebas, diseñar silos semánticos complejos representa un gasto innecesario de tiempo técnico. En estos escenarios tempranos resulta más eficiente mantener una estructura plana de un solo nivel, donde cada página cuelgue directamente de la raíz, y concentrar los esfuerzos en consolidar la propuesta de valor y la conversión del usuario.
Beneficios tangibles de una arquitectura web SEO optimizada para usuarios y rastreadores
El impacto de una estructura bien ejecutada se percibe tanto en la cuenta de resultados como en la eficiencia operativa diaria de los equipos técnicos. Separar estos dos planos permite justificar la inversión en refactorización web ante directores de tecnología y responsables de marketing.
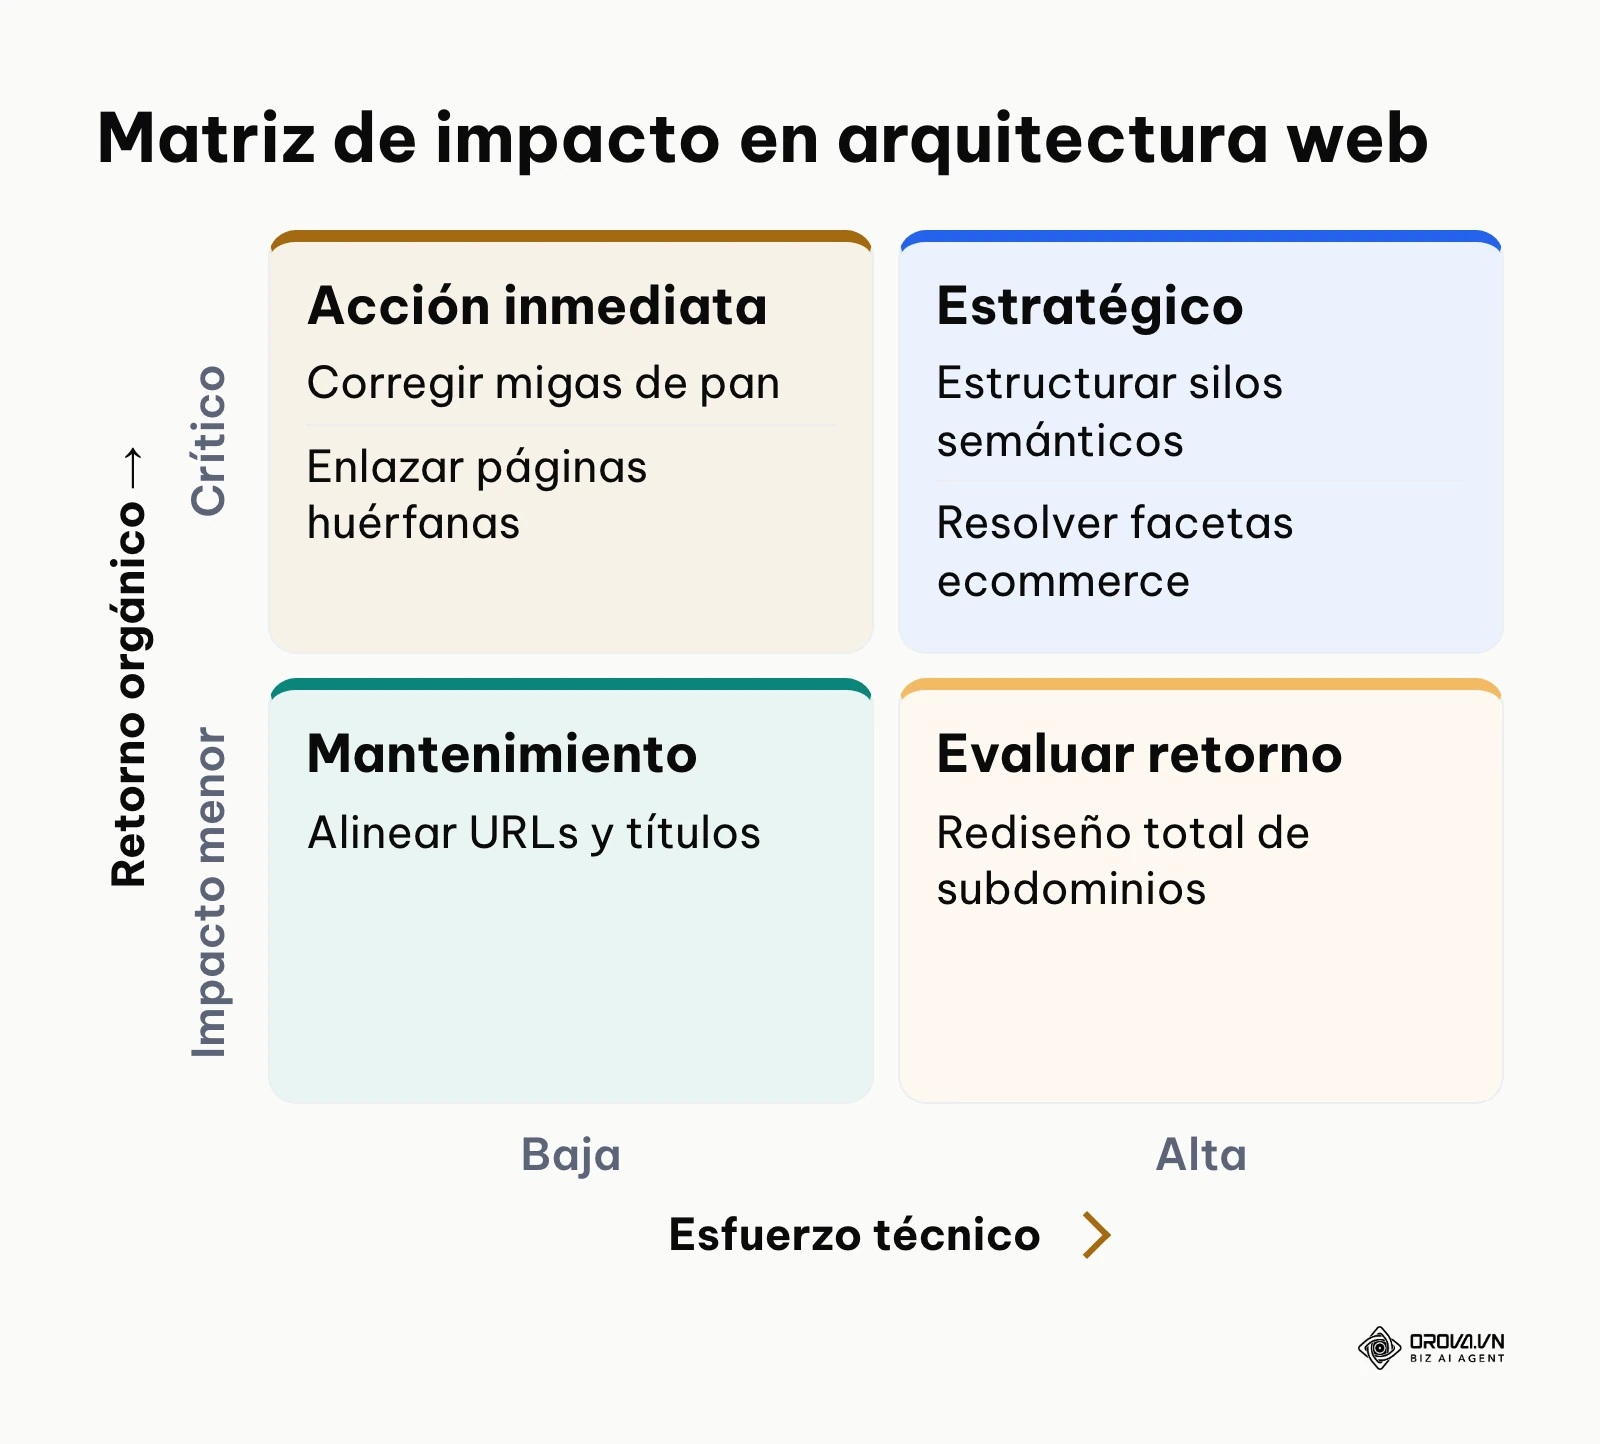
La siguiente matriz permite priorizar las iniciativas sobre la arquitectura según el nivel de dificultad técnica y el rendimiento esperado en visibilidad orgánica.
Optimización del presupuesto de rastreo y velocidad de indexación
El presupuesto de rastreo (crawl budget) hace referencia a la cantidad de URLs que un motor de búsqueda decide y puede analizar en un sitio durante un intervalo temporal determinado. En sitios web con estructuras caóticas, los robots de rastreo consumen su cuota en URLs con parámetros infinitos, filtros duplicados y páginas de error.
Antes de intervenir una estructura, es habitual observar que los rastreadores dedican una parte considerable de sus solicitudes a páginas sin valor comercial. Tras aplicar una arquitectura limpia y podar ramas innecesarias, los motores concentran sus recursos en las páginas transaccionales y los contenidos estratégicos, lo que suele acelerar la indexación de los artículos nuevos.
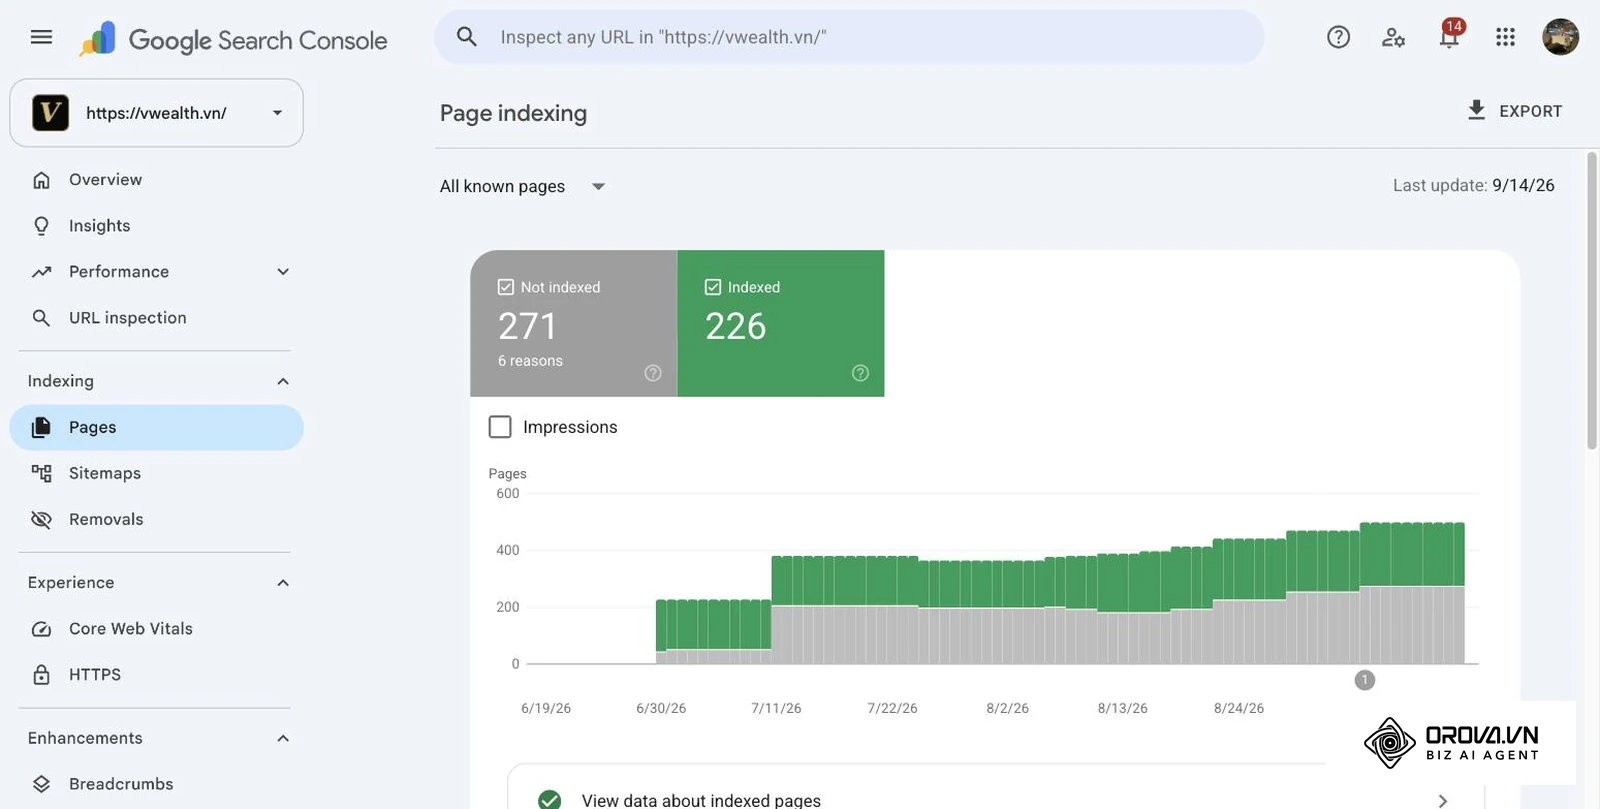
Ejemplo real con datos de vwealth.vn: el informe Indexación de páginas de Search Console (actualizado el 14/9/2026) muestra 226 páginas indexadas frente a 271 no indexadas por 6 motivos distintos. Cuando las URLs no indexadas superan a las indexadas, el primer sitio donde mirar es la arquitectura: páginas huérfanas, duplicados por parámetros o contenidos demasiado profundos. Abre cada motivo, exporta las URLs y agrúpalas por carpeta para ver qué rama de la estructura produce el problema.
Distribución controlada de autoridad temática y PageRank interno
El algoritmo PageRank continúa siendo el fundamento matemático con el que los buscadores evalúan la importancia de un documento dentro de una red de enlaces. Por norma general, la página de inicio (homepage) de un sitio web acumula la mayor cantidad de enlaces externos y autoridad bruta de dominio.
Sin una arquitectura calculada, esa autoridad se disipa en enlaces al pie de página sin valor o se estanca en niveles superficiales. Al diseñar jerarquías controladas, la fuerza de enlace se transfiere de forma escalonada desde la raíz hacia las categorías principales, y de estas hacia las subcategorías y fichas finales, fortaleciendo el posicionamiento de términos comerciales de alta dificultad.
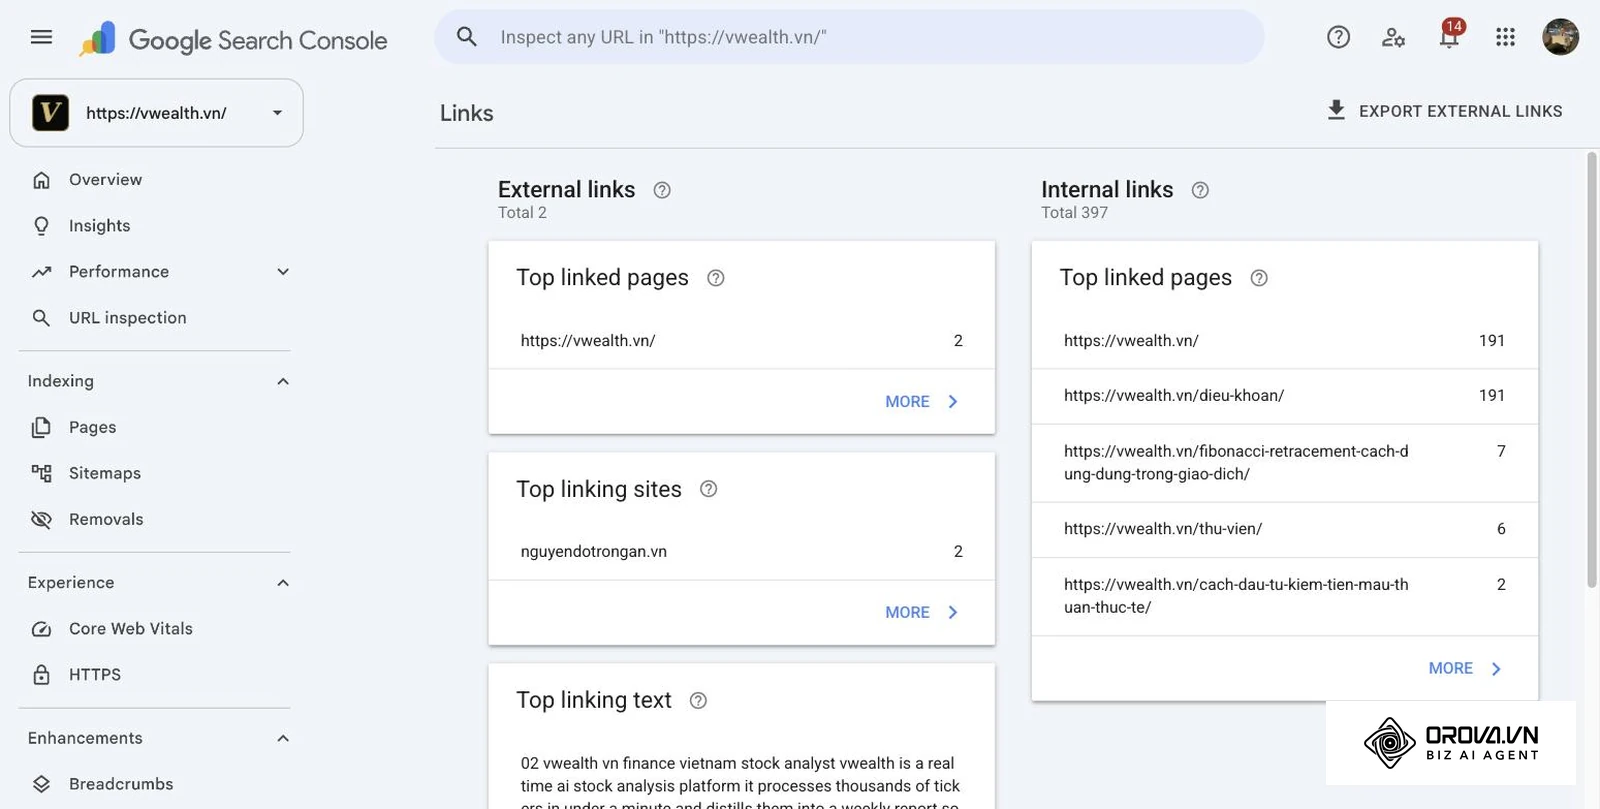
Ejemplo real con datos de vwealth.vn: en el informe Enlaces de Search Console, el sitio suma 397 enlaces internos. La página de inicio recibe 191 y la página legal /dieu-khoan/ (términos de uso) también 191, porque ambas aparecen en la cabecera o el pie de todas las plantillas; en cambio, el artículo interno mejor enlazado recibe solo 7. Es el patrón típico de una arquitectura sin capa intermedia: la autoridad interna se reparte por igual hacia una página legal sin demanda de búsqueda y apenas llega a los contenidos. La corrección pasa por crear páginas de categoría o pilares enlazados desde el menú y enlazar los artículos desde ellas, no desde el pie de página.
Reducción de canibalizaciones y clarificación de la intención de búsqueda
Cuando un portal carece de taxonomías claras, los redactores y creadores de contenido publican artículos sobre temas similares en diferentes secciones. Esto provoca que varias URLs luchen entre sí en la página de resultados (SERP), intercambiando posiciones de forma inestable y dividiendo los clics del usuario.
Una arquitectura basada en clústeres asigna un único hogar conceptual a cada término clave. Si existe una página pilar (pillar page) dedicada a un concepto amplio, todos los artículos secundarios orbitan a su alrededor y apuntan hacia ella mediante enlaces semánticos, consolidando una única respuesta autorizada que Google puede clasificar con absoluta certeza.
La tabla siguiente muestra cómo cuantificar los beneficios estructurales a través de métricas verificables y el plazo habitual para observar cambios tangibles:
| Beneficio técnico | Métrica de medición | Tiempo estimado para ver impacto |
|---|---|---|
| Aceleración de indexación | Frecuencia de rastreo de páginas nuevas en Google Search Console | De 1 a 3 semanas |
| Reducción de desperdicio de rastreo | Disminución de solicitudes a URLs no indexables en archivos log | De 2 a 4 semanas |
| Mejora de autoridad interna | Distribución de puntuación de enlaces internos (Link Score) en rastreadores técnicos | Inmediato tras despliegue |
| Resolución de canibalización | Estabilidad de URL clasificada para palabras clave objetivo en herramientas de monitorización | De 3 a 6 semanas |
| Comprensión del usuario | Reducción de la tasa de rebote en páginas de categoría intermedia | De 4 a 8 semanas |
Ejemplo ilustrativo: Una tienda online de equipamiento para deportes de montaña contaba con 14.000 fichas de catálogo y presentaba un estancamiento en sus ventas orgánicas. El equipo técnico llevó a cabo un análisis de profundidad con herramientas de rastreo automatizado y detectó que más del 40% de los productos se encontraban a seis o más clics de distancia de la página principal. Se reconfiguró el menú principal reduciendo los niveles jerárquicos a un máximo de tres pasos y se crearon páginas concentradoras por deporte que agrupaban calzado, textil y accesorios. El principal obstáculo surgió al comprobar que muchos productos pertenecían simultáneamente a las categorías de senderismo y escalada, lo que generaba duplicidad de rutas en las migas de pan; el problema se resolvió estableciendo una ruta canónica única por producto en el archivo sitemap y enlazando la categoría secundaria mediante módulos de productos relacionados. En la consola de búsqueda se observó una reactivación progresiva del rastreo en las fichas profundas y, en un plazo de cinco semanas, las páginas de categoría principal comenzaron a mostrarse de forma estable en las primeras posiciones para búsquedas de marcas específicas.
Descubre Orova.vn – una plataforma Biz AI Agent con la solución OROVA SEO completa, destinada a todos los sitios web. El sistema acompaña la optimización para motores de búsqueda de A a Z con las siguientes funciones: investigación de palabras clave, redacción de nuevos artículos optimizados para SEO, optimización de los contenidos existentes, seguimiento de posiciones, además del análisis de la competencia y el análisis técnico en profundidad. Regístrate hoy mismo para descubrir OROVA SEO de forma totalmente gratuita (oferta válida hasta el 7 de julio de 2027).
Cómo funciona la arquitectura web SEO: componentes técnicos y metodologías avanzadas
Desarrollar una estructura de alto rendimiento exige comprender el funcionamiento interno de cada elemento que guía a los usuarios y a los algoritmos a través de las páginas del sitio.
Jerarquía lógica y profundidad de clics frente a profundidad de URL
La jerarquía de un portal determina el nivel de dependencia entre sus distintas secciones. Sin embargo, existe una confusión generalizada entre la profundidad de la URL (URL Depth) y la profundidad de clics (Click Depth o Crawl Depth).
- Qué hace: Establece la distancia mínima que un rastreador debe recorrer desde la página de inicio para alcanzar cualquier documento del sitio.
- Entradas: El mapa de enlaces internos que componen la cabecera, el cuerpo del contenido, los menús contextuales y las rutas de navegación.
- Salidas: Una matriz de accesibilidad donde cada URL cuenta con un valor numérico de profundidad (1 para la home, 2 para categorías primarias, 3 para subcategorías, etc.).
- Puntos críticos de fallo: Confundir la cantidad de barras diagonales en la dirección web (dominio.com/a/b/c/d/pagina) con la distancia real de navegación. Para Googlebot, una URL con estructura plana como dominio.com/pagina puede estar a ocho clics de distancia si ningún enlace directo la conecta con niveles superiores, lo que la convierte en una página casi invisible para el algoritmo. Como norma general, ninguna página de importancia comercial o informativa debe superar los 3 clics de distancia desde la página principal.
De silos estrictos a clústeres temáticos semánticos
El modelo tradicional de arquitectura conocido como Hard Silo propone aislar cada categoría del sitio en un compartimento estanco, prohibiendo terminantemente los enlaces entre diferentes secciones para evitar que la relevancia se diluya. Aunque esta teoría dominó el sector en décadas pasadas, en la actualidad resulta insuficiente y perjudicial para portales modernos.
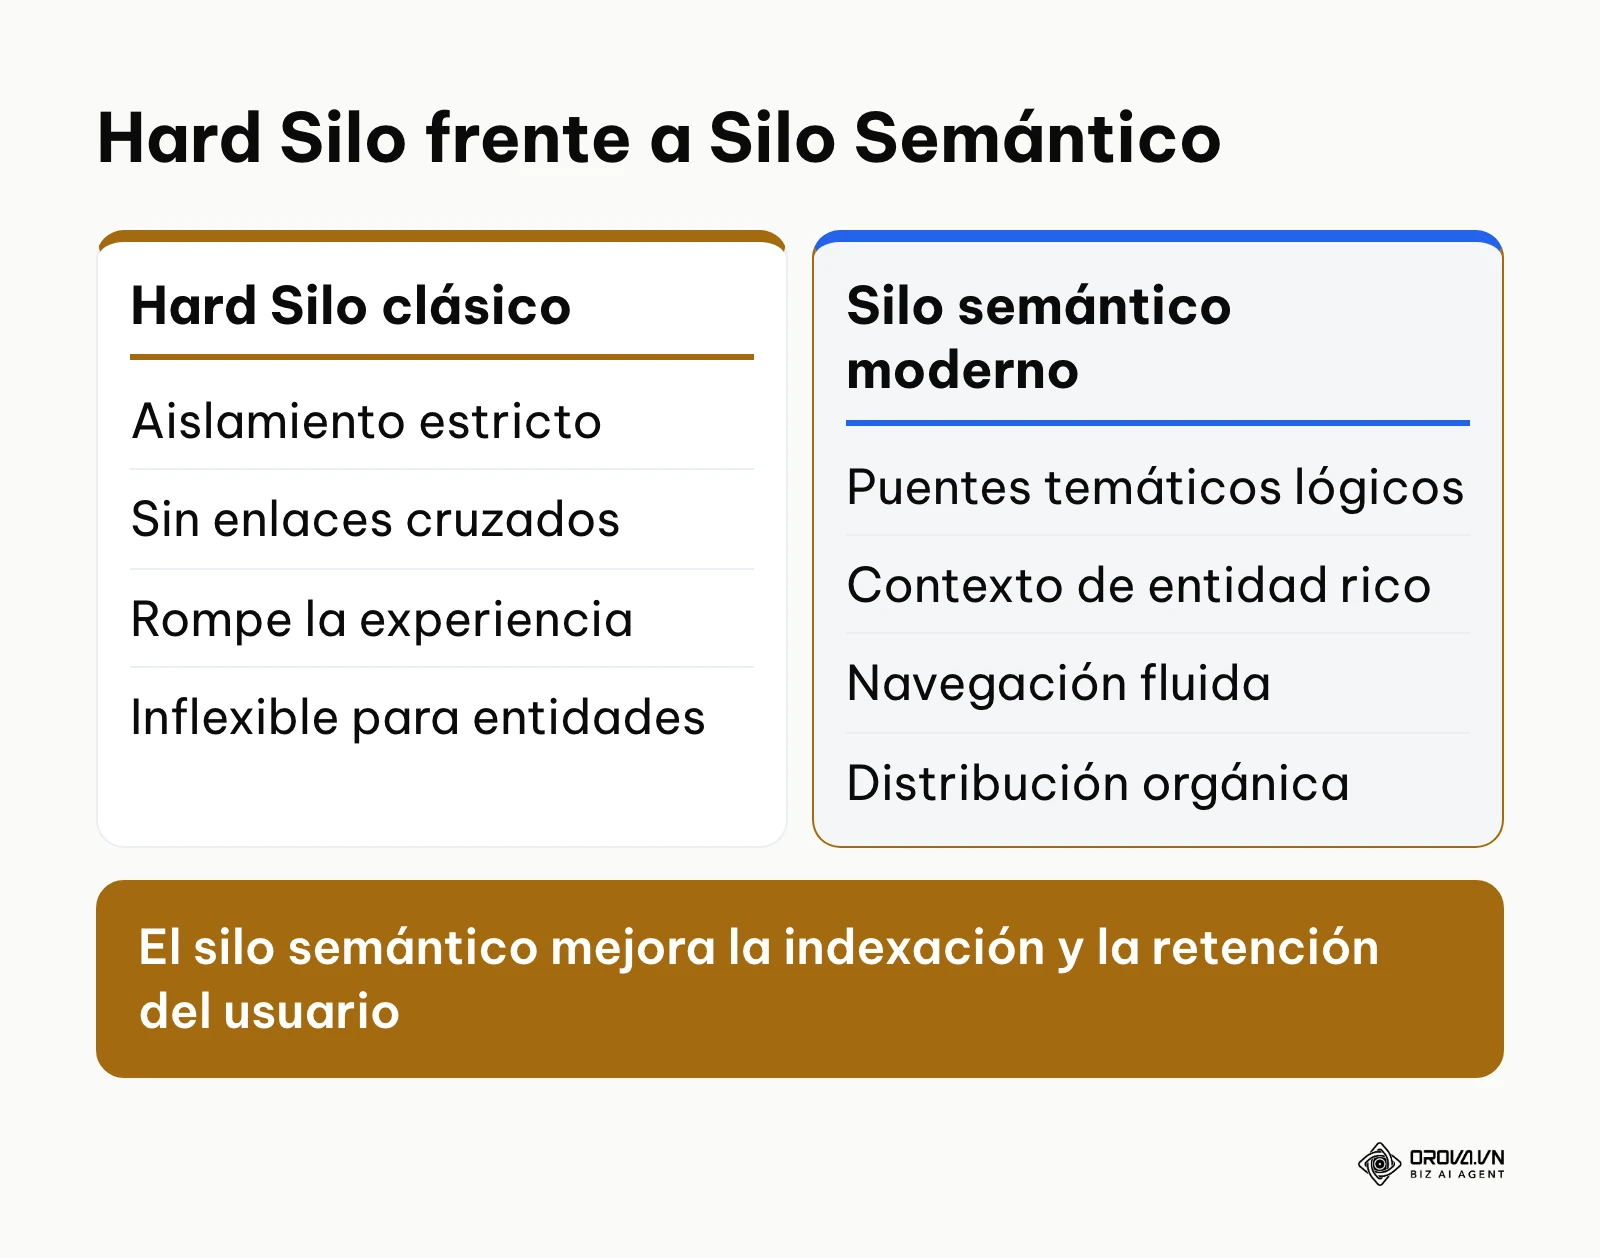
El siguiente diagrama contrasta la rigidez del modelo Hard Silo frente a la adaptabilidad del Silo Semántico con puentes temáticos.
Los sitios web del mundo real albergan productos y contenidos que pertenecen de forma natural a múltiples áreas de conocimiento. Por ejemplo, una guía sobre calzado impermeable para correr en invierno se vincula simultáneamente con el área de atletismo y con la categoría de ropa térmica. Si se prohíbe el enlace entre ambas, se rompe la experiencia de usuario y se priva a los buscadores de comprender las conexiones entre entidades dentro del grafo de conocimiento (Knowledge Graph).
La solución técnica moderna es el Silo Semántico o clúster temático flexible apoyado en la metodología de pillar page:
- Páginas puente semánticas (Semantic Bridge Pages): Son documentos específicos diseñados para unir dos temas complementarios sin romper la jerarquía. La guía de calzado impermeable actúa como puente enlazando hacia la categoría principal de zapatillas de correr y hacia la categoría de protección invernal.
- Control de textos de anclaje (Anchor text): Al enlazar de forma transversal entre silos distintos, el texto del enlace debe ser descriptivo y específico de la entidad receptora, evitando términos genéricos como "ver más" o palabras clave exactas que compitan con la página de origen.
- Atributos de entidad compartidos: Los enlaces cruzados deben justificarse por una relación ontológica real. Enlazar desde la sección de nutrición deportiva hacia la de bicicletas de montaña es coherente si el tema aborda la hidratación en rutas ciclistas de larga distancia; enlazar sin vínculo temático evidente dispersa la especialización del nodo.
Navegación por facetas y taxonomías en ecommerce
En plataformas de comercio electrónico y portales de clasificados, los sistemas de filtrado por facetas (faceted navigation) son la causa número uno de problemas de indexación masiva (index bloat) y consumo destructivo de presupuesto de rastreo. Cuando los usuarios combinan filtros de talla, color, precio, material y ordenación, el gestor de contenidos genera millones de URLs dinámicas que contienen contenido prácticamente idéntico.
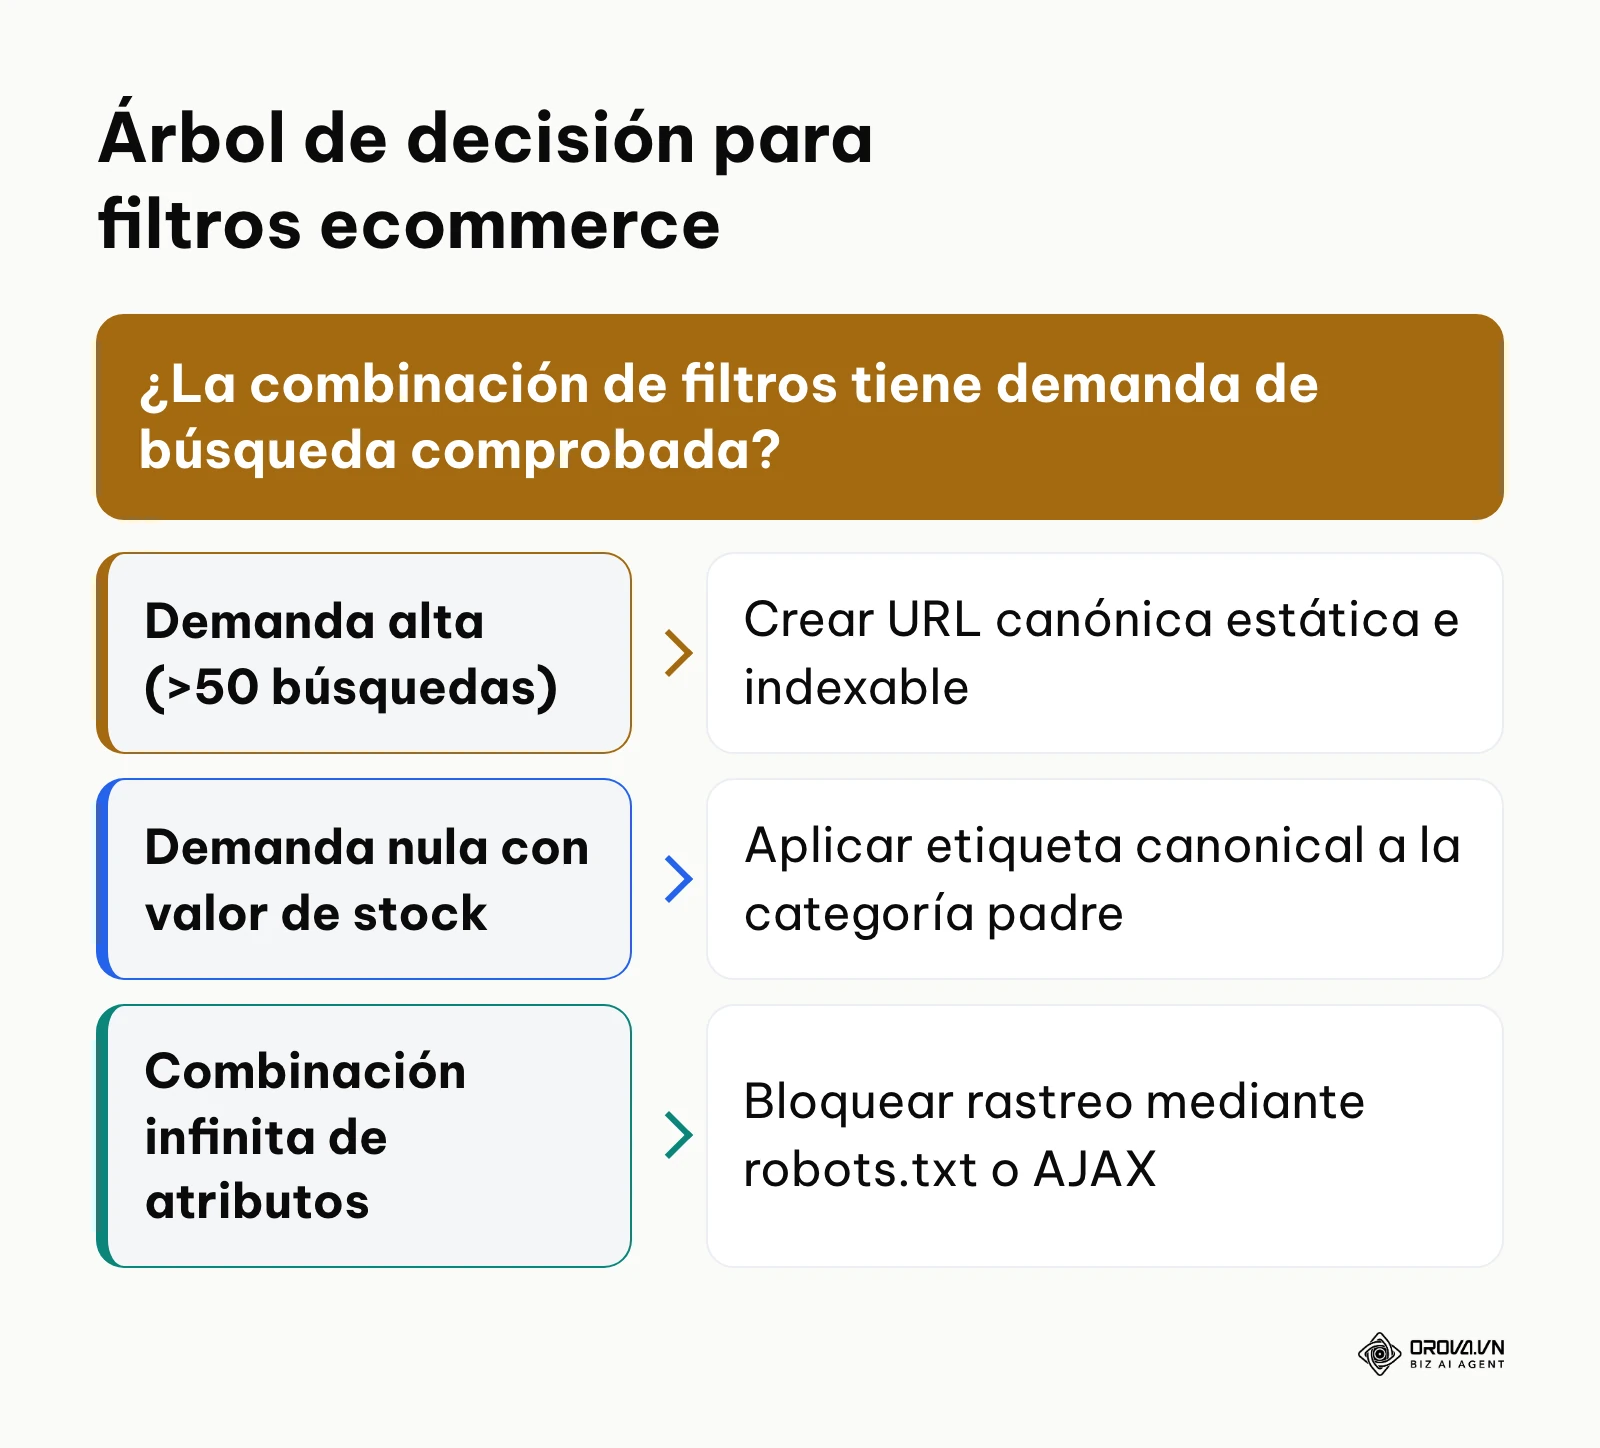
El siguiente árbol de decisión permite clasificar de forma sistemática el tratamiento técnico que debe recibir cada parámetro de filtrado.
Según la documentación de Google Search Central sobre la gestión del presupuesto de rastreo en sitios grandes, el rastreador asigna recursos en función de la popularidad y la velocidad de respuesta del servidor. Permitir que el robot explore combinaciones infinitas de filtros degrada el rendimiento de rastreo del catálogo principal.
Para resolver este desafío en el marco de una estrategia de SEO para ecommerce, se utiliza el siguiente marco técnico de decisiones:
| Caso de uso | Criterio de volumen | Implementación técnica recomendada | Código / Directiva aplicada |
|---|---|---|---|
| Atributo con alta demanda de búsqueda | Volumen de búsqueda superior a 50 consultas mensuales (ej. zapatillas rojas) | URL estática limpia, indexable, incluida en el sitemap y enlazada desde el menú o el contenido. | Etiqueta canónica autoreferenciada, código de estado HTTP 200, título y H1 optimizados. |
| Filtro de navegación sin demanda de búsqueda | Cero búsquedas mensuales pero útil para el comprador (ej. filtro por rango de precio) | La URL no debe indexarse de forma independiente; debe consolidar autoridad en la categoría superior. | Etiqueta rel="canonical" apuntando a la categoría padre sin parámetros. |
| Combinación múltiple de atributos secundarios | Cruce de tres o más filtros (ej. talla 42 + color azul + envío en 24h) | Bloquear completamente el rastreo para no desperdiciar peticiones del bot. | Directiva Disallow en el archivo robots.txt para patrones de parámetros o implementación AJAX. |
| Filtros de ordenación y paginación interna | Parámetros del tipo ?sort=price_asc o ?page=2 | Las páginas ordenadas no deben indexarse; la paginación debe rastrearse mediante enlaces simples <a href>. | Canonical hacia la versión por defecto en ordenaciones; canónicas autoreferenciadas en paginación estándar. |
En entornos corporativos avanzados, la solución definitiva consiste en ocultar la generación de URLs para filtros sin demanda mediante el patrón de diseño PRG (Post-Redirect-Get) o mediante tecnologías de renderizado del lado del cliente (AJAX/Fetch) donde los cambios de faceta modifican la vista del usuario sin alterar el historial del navegador con parámetros rastreables.
Protocolo de auditoría y reestructuración web en cinco pasos
Reorganizar un sitio web que ya recibe visitas y cuenta con cientos o miles de páginas requiere un procedimiento estricto para evitar pérdidas de tráfico orgánico.
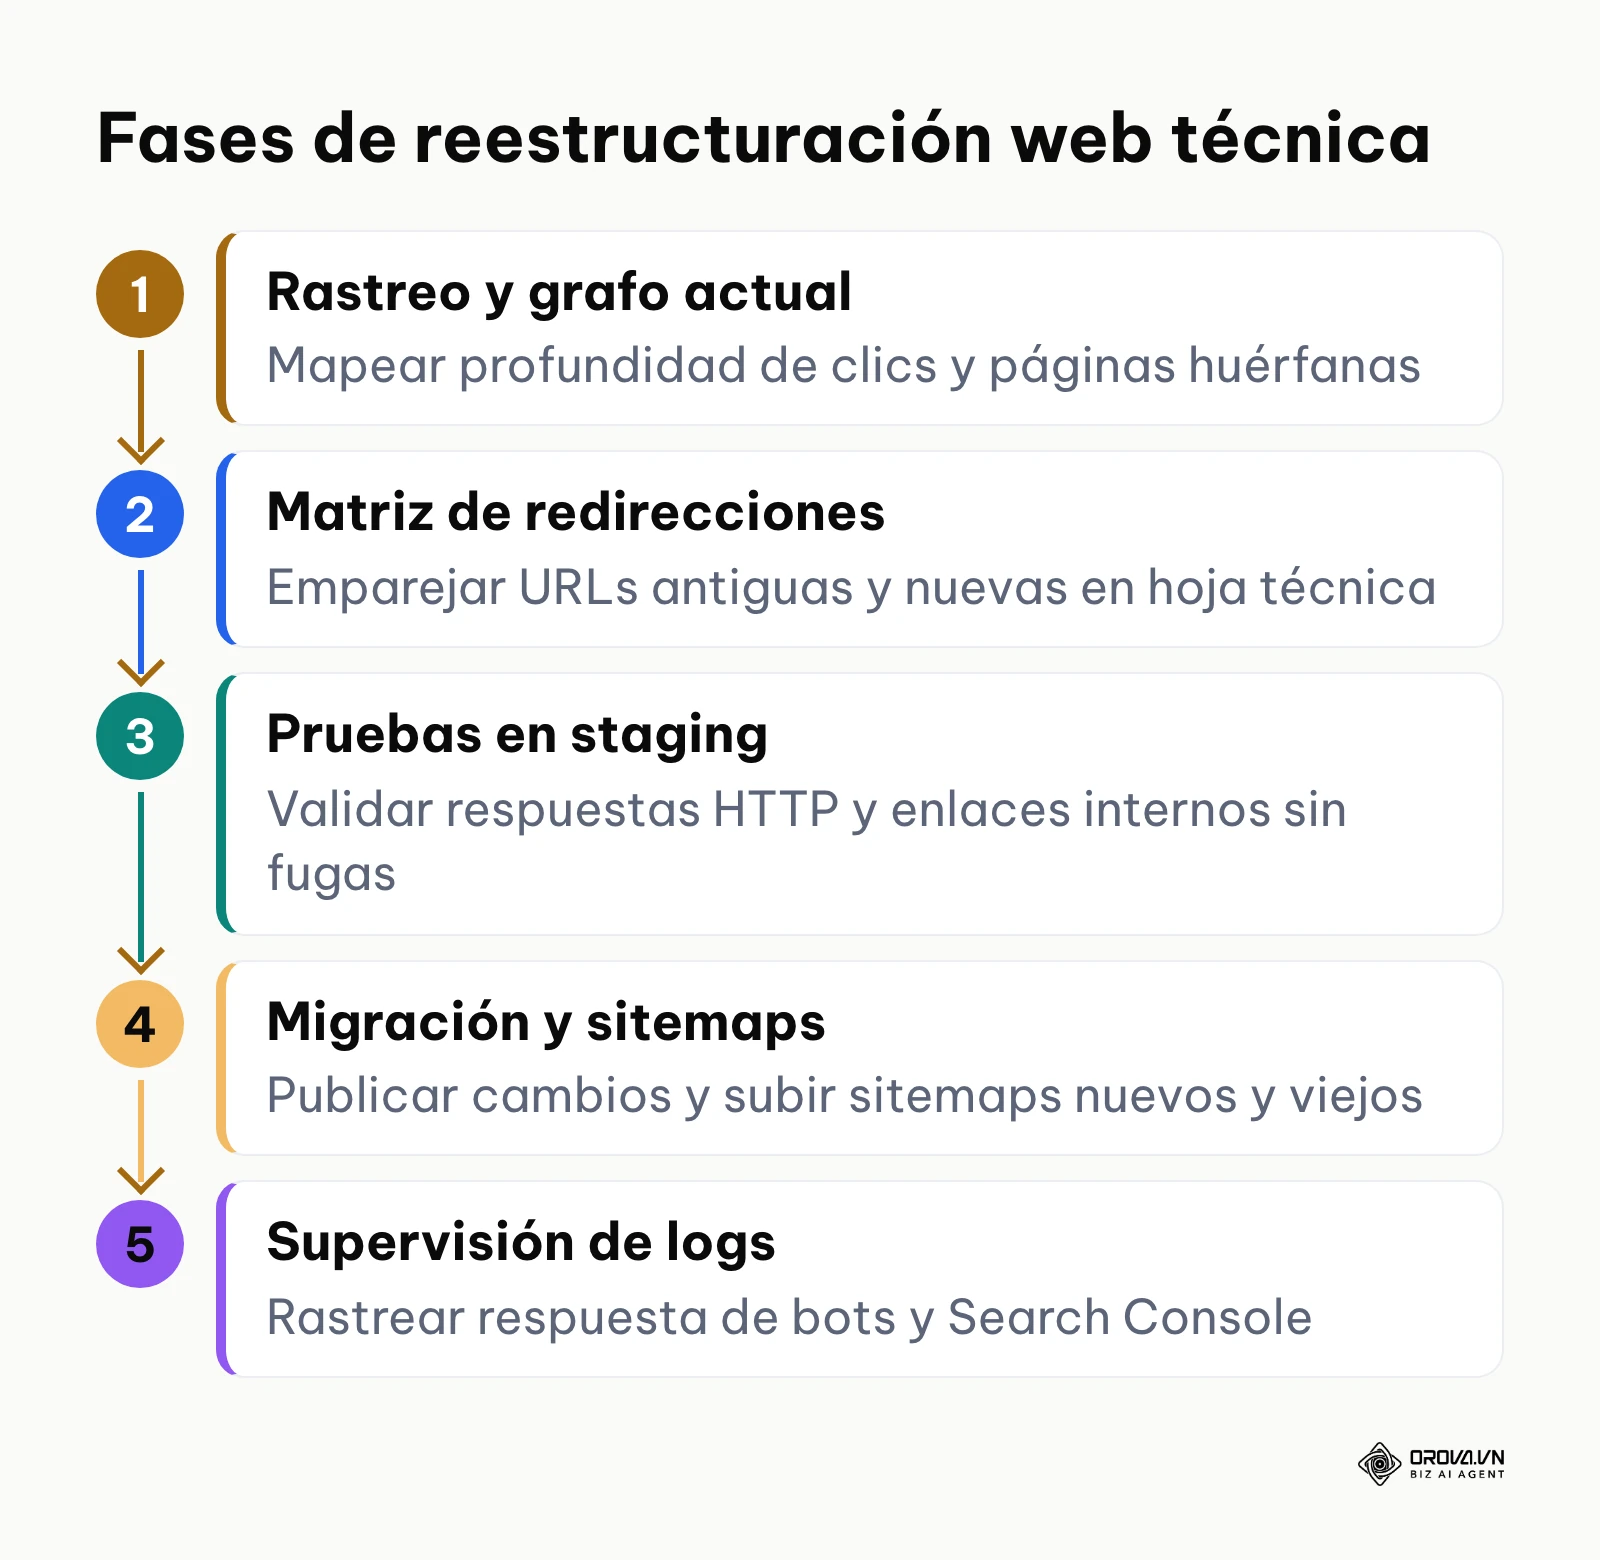
El proceso siguiente desglosa las etapas necesarias para transformar una arquitectura en producción sin comprometer la estabilidad del dominio.
Paso 1: Extracción del grafo de rastreo y detección de anomalías
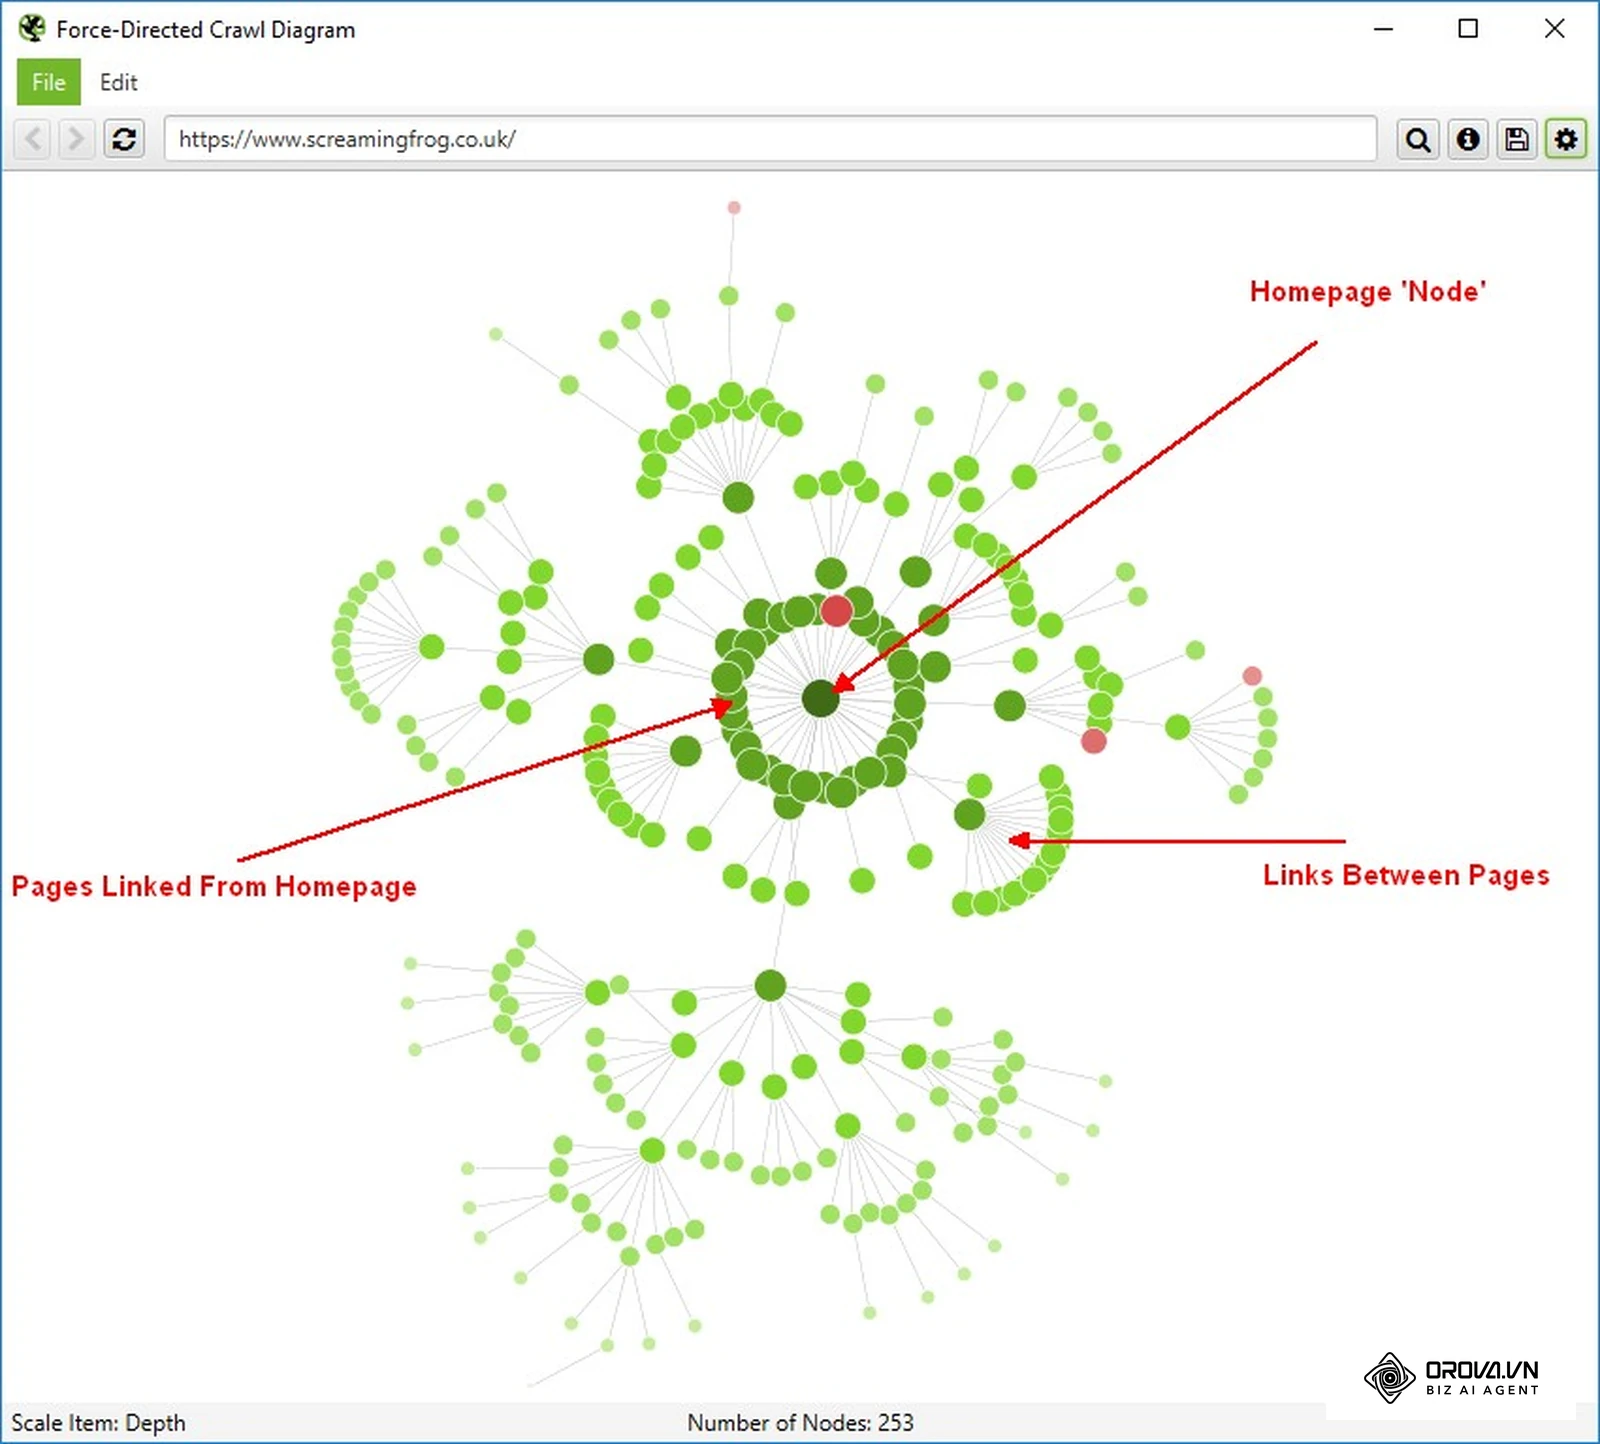
Se ejecuta un rastreo técnico completo con un crawler especializado (como Screaming Frog o Sitebulb) configurado para interpretar enlaces internos, directivas canónicas y códigos de respuesta. A continuación, se examina el diagrama de rastreo dirigido por fuerzas (Force-Directed Crawl Diagram) para visualizar cómo fluye la exploración: la página de inicio queda en el centro y los grupos de nodos alejados o desconectados delatan secciones mal enlazadas. Se aíslan las páginas con una profundidad de clics superior a 4 y se cruza el listado de URLs con los datos de Google Analytics y Search Console para identificar páginas huérfanas que generan tráfico pero carecen de enlaces internos.
Paso 2: Diseño de la matriz de mapeo y redirecciones 301
Ninguna URL debe modificarse o eliminarse sin una correspondencia exacta en una hoja de trabajo técnica. Cada dirección antigua debe emparejarse con su equivalente más cercana en la nueva estructura mediante redirecciones permanentes (código de estado HTTP 301).
Según la recomendación técnica del World Wide Web Consortium (W3C) en 'Architecture of the World Wide Web, Volume One' (2004), la persistencia e interpretabilidad semántica de los identificadores URI es el principio fundamental de la navegación distribuida. Cambiar rutas sin redirigir destruye los enlaces externos entrantes y devuelve errores 404 que deterioran la reputación técnica del sitio.
La siguiente tabla ilustra el formato de trabajo que debe emplearse para documentar la migración estructural:
| URL de origen (Antigua) | Profundidad antigua | URL de destino (Nueva) | Profundidad nueva | Justificación del cambio | Código HTTP planificado |
|---|---|---|---|---|---|
| /tienda/calzado/running/hombres/invierno/zapatilla-x | Nivel 6 | /calzado-running/invierno/zapatilla-x | Nivel 3 | Reducción de niveles y eliminación de carpetas redundantes | 301 Permanente |
| /blog/noticias/2021/04/como-elegir-talla | Nivel 5 | /guias/guia-tallas-calzado | Nivel 2 | Conversión de artículo temporal en página pilar evergreen | 301 Permanente |
| /categoria-obsoleta/producto-descatalogado | Nivel 4 | /categoria-equivalente/ | Nivel 2 | Fusión de producto sin stock hacia categoría de reemplazo | 301 Permanente |
Paso 3: Validación en entorno de pruebas (Staging)
Antes de aplicar las modificaciones en los servidores de producción, la nueva arquitectura se despliega en un entorno de desarrollo cerrado a los buscadores. En esta fase se realiza un rastreo completo del entorno para comprobar:
- Que no existen cadenas de redirección (una URL A que apunta a B, y luego B apunta a C).
- Que los enlaces internos de los menús, pie de página y contenidos apuntan directamente a las URLs definitivas, sin depender de las redirecciones 301.
- Que los textos de anclaje mantienen coherencia con las nuevas secciones temáticas.
Paso 4: Despliegue coordinado y actualización de sitemaps XML
En el momento del lanzamiento público se activan las redirecciones a nivel de servidor (mediante configuración en Nginx, Apache o reglas perimetrales en Cloudflare). Inmediatamente después, se generan dos mapas de sitio XML diferentes:
- Sitemap antiguo: Contiene las URLs que acaban de ser redirigidas, facilitando que Googlebot las rastree rápidamente y procese el código 301 hacia los nuevos destinos.
- Sitemap nuevo: Contiene exclusivamente las nuevas URLs limpias con código HTTP 200, señalando el índice definitivo que debe mostrarse en los resultados.
Paso 5: Monitorización de registros de servidor y Search Console
Durante los sesenta días posteriores a la migración se realiza un seguimiento diario de los códigos de respuesta del servidor en los archivos log. Se comprueba que las visitas de los robots se trasladan progresivamente a las nuevas URLs y que no se disparan errores 500 por sobrecarga ni errores 404 por enlaces omitidos en la matriz.
Arquitectura web SEO adaptada a motores de búsqueda con inteligencia artificial
El avance de los motores de búsqueda basados en modelos lingüísticos avanzados (como las AI Overviews de Google, la búsqueda de ChatGPT o Perplexity) está transformando el consumo de información técnica. En este nuevo contexto, conocido como optimización para motores generativos (GEO vs SEO), los algoritmos ya no se limitan a clasificar un enlace azul, sino que sintetizan respuestas completas extrayendo fragmentos de múltiples fuentes.
Para que los sistemas de inteligencia artificial elijan tu sitio como fuente de referencia e interpreten la relación de tus documentos, la arquitectura debe incorporar tres optimizaciones técnicas:
- Datos estructurados jerárquicos y anidados: No basta con incluir esquemas aislados de tipo Article o Product. La arquitectura debe expresarse formalmente mediante esquemas anidados.
Con el vocabulario de Schema.org, el anidamiento de los tipos BreadcrumbList, CollectionPage e ItemList permite definir taxonomías sin ambigüedad. Un esquema de categoría debe contener un elemento CollectionPage que a su vez contenga un ItemList enumerando formalmente las entidades hijas.
- Descomposición de consultas en jerarquías de encabezados (H2/H3): Los motores de IA procesan el contenido dividiendo las páginas en fragmentos vectoriales (chunks). Estructurar los encabezados como pares lógicos de pregunta y respuesta técnica facilita que los algoritmos de recuperación aumentada por generación (RAG - Retrieval-Augmented Generation) seleccionen tu sección exacta para responder a una consulta específica.
- Hubs de autoridad temática (Topic Authority Hubs): Los modelos generativos evalúan si un dominio posee cobertura exhaustiva sobre una materia antes de citarlo. Una arquitectura que interconecta de forma bidireccional todas las facetas de un tema específico demuestra mayor especialización algorítmica que un sitio generalista que aborda temas dispersos sin conexión estructural.
Medición del flujo de autoridad y periodo de volatilidad
El siguiente gráfico temporal describe las etapas habituales por las que atraviesa un sitio web durante una reorganización de su estructura y el comportamiento de sus métricas.
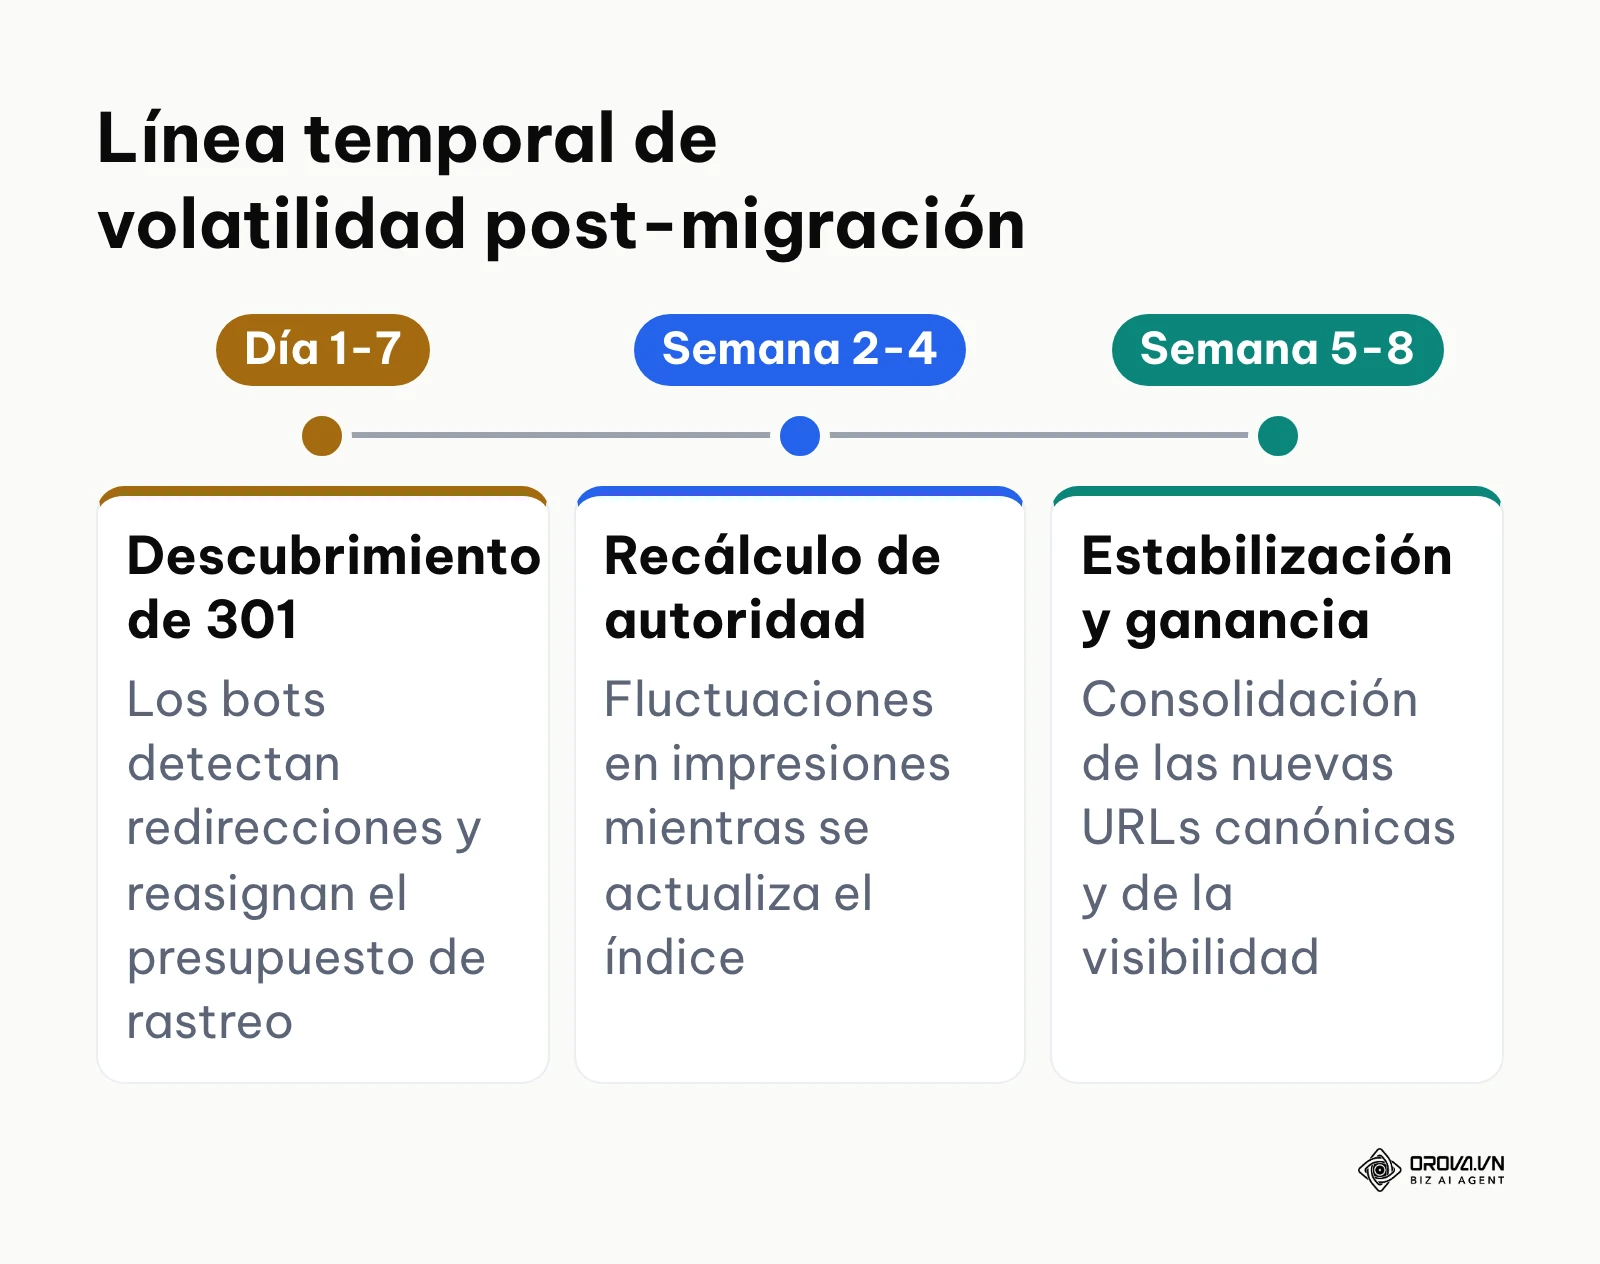
El periodo de volatilidad (volatility period) tras una reestructuración profunda suele extenderse entre dos y ocho semanas, dependiendo del tamaño del portal y de la frecuencia previa de rastreo. Durante los primeros quince días es habitual observar una caída temporal en las impresiones dentro de Google Search Console, debido a que el buscador desindexa las rutas antiguas antes de terminar de consolidar las señales de las nuevas URLs canónicas.
Para medir el flujo real de PageRank interno sin basarse en suposiciones, se utilizan dos técnicas complementarias:
- Puntuación de enlaces internos en rastreadores (Internal Link Score): Herramientas como Screaming Frog calculan un valor ponderado de 0 a 100 para cada página en función del número y la calidad de los enlaces internos que recibe. Tras una reorganización, las páginas de mayor valor comercial deben presentar las puntuaciones de Link Score más elevadas del inventario, seguidas por las subcategorías intermedias.
- Análisis de archivos log del servidor: Al cruzar el registro de accesos de Googlebot con la base de datos de URLs, se comprueba qué secciones reciben el mayor porcentaje de visitas del bot. Si las categorías secundarias reciben más peticiones que las principales, la estructura presenta cuellos de botella o bucles de enlaces que desvían la atención del rastreador.
Las señales de alarma en Search Console que exigen intervención inmediata durante la migración incluyen:
- Incremento súbito de URLs en el informe "Rastreada: actualmente sin indexar", lo que sugiere contenido redundante o falta de autoridad interna en las nuevas páginas.
- Aumento continuado de errores 404 durante más de catorce días consecutivos.
- Pérdida simultánea de impresiones y clics en páginas que no fueron objeto de modificaciones de contenido ni de redirección.
Subdominios frente a subcarpetas y enrutamiento multivariante de migas de pan
La decisión técnica entre organizar nuevas secciones bajo un subdominio (blog.dominio.com) o una subcarpeta (dominio.com/blog/) tiene un impacto directo en la distribución de la fuerza de posicionamiento:
- Subcarpetas: Comparten de forma directa e inmediata toda la autoridad histórica acumulada por el dominio principal. Cualquier enlace externo que reciba el blog o la tienda beneficia al resto del portal. Salvo restricciones técnicas insalvables de infraestructura o servidores independientes, las subcarpetas son la opción predilecta para maximizar el rendimiento SEO.
- Subdominios: Son tratados por los motores de búsqueda como entidades independientes o dominios satélite en la mayoría de sus procesos de cálculo algorítmico. Requieren construir autoridad y perfil de enlaces desde cero, fragmentan la percepción de marca en los grafos de rastreo y complican la gestión de cookies y analítica web.
Por otro lado, cuando un producto o artículo pertenece a múltiples categorías dentro del portal, las rutas de migas de pan (breadcrumbs) pueden generar conflictos de taxonomía. La solución para evitar errores en datos estructurados y duplicidades canónicas consiste en implementar un enrutamiento de migas de pan basado en una ruta canónica fija (Primary Category Routing). Aunque un usuario acceda a una zapatilla deportiva a través de la sección de ofertas o de la categoría de atletismo, las migas de pan mostradas en el código fuente HTML y en el esquema BreadcrumbList deben reflejar siempre la categoría primaria designada (Inicio > Calzado > Atletismo > Zapatilla), garantizando que los motores de búsqueda registren una jerarquía conceptual única y estable.
La siguiente tabla resume los diferentes modelos de arquitectura web que pueden aplicarse en el sector digital:
| Tipo de arquitectura | Características técnicas | Para quién es adecuada | Riesgo principal |
|---|---|---|---|
| Horizontal o plana (Flat) | Pocos niveles jerárquicos; casi todas las páginas se sitúan a uno o dos clics de la raíz. | Sitios pequeños, catálogos de servicios B2B o carteras corporativas de menos de cien páginas. | Canibalización y pérdida de contexto temático si el sitio crece por encima de quinientas páginas. |
| Silo estricto (Hard Silo) | Categorías aisladas sin comunicación horizontal entre ramas; enlaces unidireccionales estrictos. | Portales con líneas de negocio completamente independientes y sin puntos temáticos comunes. | Fricción severa en la navegación del usuario y desconexión ontológica ante entidades del Knowledge Graph. |
| Silo semántico flexible | Jerarquía por clústeres temáticos conectados mediante páginas puente y relaciones de entidad justificadas. | Portales de contenido técnico, revistas digitales y sitios de servicios complejos en expansión. | Exige control estricto de textos de anclaje para no transferir autoridad a secciones irrelevantes. |
| Arquitectura facetada controlada | Taxonomías dinámicas con indexación selectiva según demanda de búsqueda y bloqueo de variantes. | Grandes plataformas de comercio electrónico, directorios profesionales y portales de clasificados. | Generación incontrolada de URLs duplicadas si fallan las directivas de canónicos o robots.txt. |
Para evaluar el estado de cualquier plataforma técnica, el siguiente listado reúne veinticinco criterios de comprobación obligatorios que cubren desde el rastreo hasta los datos estructurados:
| N.º | Elemento de auditoría | Criterio de validación técnica | Estado esperado |
|---|---|---|---|
| 1 | Profundidad máxima de clics | Ninguna URL crítica debe superar tres clics desde la home | Superado si profundidad <= 3 |
| 2 | Páginas huérfanas | Detección de URLs indexables sin enlaces internos entrantes | 0% páginas huérfanas |
| 3 | URLs con parámetros | Los parámetros de ordenación y sesión no deben ser indexables | Bloqueados o canonicalizados |
| 4 | Facetas con demanda | Filtros con más de cincuenta búsquedas poseen URL estática propia | Código 200 y canonical propio |
| 5 | Facetas sin demanda | Combinaciones infinitas de atributos bloqueadas para el bot | Directiva Disallow o AJAX |
| 6 | Paginación técnica | Enlaces de paginación implementados con etiquetas <a href> reales | Canónicas autoreferenciadas |
| 7 | Migas de pan visuales | Presentes en todas las páginas interiores indicando la ruta | Ruta lógica coherente |
| 8 | Schema BreadcrumbList | Marcado estructurado formal en JSON-LD sin errores de sintaxis | Válido en validador de Schema |
| 9 | Coherencia de URLs canónicas | Todas las URLs enlazadas internamente son su propia canónica | Sin discrepancias canonical |
| 10 | Cadenas de redirección | Enlaces internos apuntan a la URL final, no a URLs redirigidas | Cero cadenas de 301 |
| 11 | Enlaces internos rotos | Ausencia total de enlaces hacia códigos de respuesta 404 o 500 | Cero enlaces internos rotos |
| 12 | Diversidad de textos de anclaje | Textos descriptivos de la entidad receptora sin sobreoptimización | Variedad léxica natural |
| 13 | Menú de navegación principal | No sobrecargar el menú con cientos de enlaces innecesarios | Solo enlaces a categorías clave |
| 14 | Enlaces en pie de página | Enlaces reservados para información corporativa y legal obligatoria | Sin bloques masivos de keywords |
| 15 | Sitemaps XML limpios | Solo contienen URLs canónicas con código de estado HTTP 200 | Sin 301, 404 ni noindex |
| 16 | Tamaño de sitemaps XML | Límite estricto de 50.000 URLs o 50 MB por archivo individual | Fragmentación con sitemap index |
| 17 | Tiempos de respuesta del servidor | Tiempo hasta el primer byte (TTFB) inferior a 600 milisegundos | Servidor ágil para rastreadores |
| 18 | Paridad móvil de arquitectura | La estructura de enlaces es idéntica en versión móvil y escritorio | Mismo DOM y accesibilidad |
| 19 | Canibalización en canónicas | Páginas con intenciones de búsqueda diferentes no comparten canonical | Canónicas independientes |
| 20 | Páginas puente semánticas | Enlaces cruzados entre silos cuentan con justificación ontológica | Relación temática comprobable |
| 21 | Rendimiento en logs de rastreo | Las páginas clave acumulan la mayoría de las peticiones de bots | Frecuencia alineada con valor |
| 22 | Control de etiquetas noindex | Páginas legales y paneles privados marcados correctamente | Noindex activo en zonas privadas |
| 23 | Gestión de contenido duplicado | Variantes de protocolo (http/https) y www redirigidas a una versión | Una única versión accesible |
| 24 | Marcado CollectionPage | Categorías estructuradas formalmente con datos de colección | Schema anidado completo |
| 25 | Estabilidad tras migración | Seguimiento diario de Search Console y logs durante sesenta días | Sin anomalías de rastreo |
Ejemplo ilustrativo: Un portal editorial especializado en software corporativo contaba con 5.200 artículos técnicos acumulados durante seis años y sufría de un estancamiento prolongado en su visibilidad. El equipo de contenido realizó una auditoría completa de enlaces internos y descubrió que más de 1.800 artículos antiguos se situaban en niveles de profundidad 5 y 6, prácticamente invisibles para los rastreadores automáticos. Se diseñó un plan de reestructuración dividiendo el catálogo en seis centros temáticos principales (Topic Hubs) basados en categorías tecnológicas específicas y se crearon páginas concentradoras intermedias con enlaces contextuales. El obstáculo principal surgió cuando, en la fase de prueba, varios enlaces internos apuntaron a versiones redirigidas generando cadenas de redirección que ralentizaban la navegación; el fallo se corrigió ejecutando un rastreo de comprobación en el entorno de pruebas y sustituyendo todos los enlaces internos por sus URLs canónicas directas. En la consola de búsqueda de Google, el tiempo medio que el rastreador tardaba en descubrir y clasificar nuevos artículos pasó de catorce días a menos de cuarenta y ocho horas, mientras que los artículos históricos recuperaron presencia constante en los informes de indexación.
Con OROVA.VN y el módulo OROVA SEO, pones fin definitivamente a las jornadas agotadoras de trabajo manual. En lugar de batallar durante horas para redactar artículos y elaborar informes, todo el proceso queda ahora optimizado y completado en tan solo 5 minutos.
Qué hacer para implementar o adaptar tu arquitectura web SEO según tu perfil profesional
La adaptación de una estructura digital varía sustancialmente según los recursos técnicos y la responsabilidad de cada profesional involucrado en el proyecto.
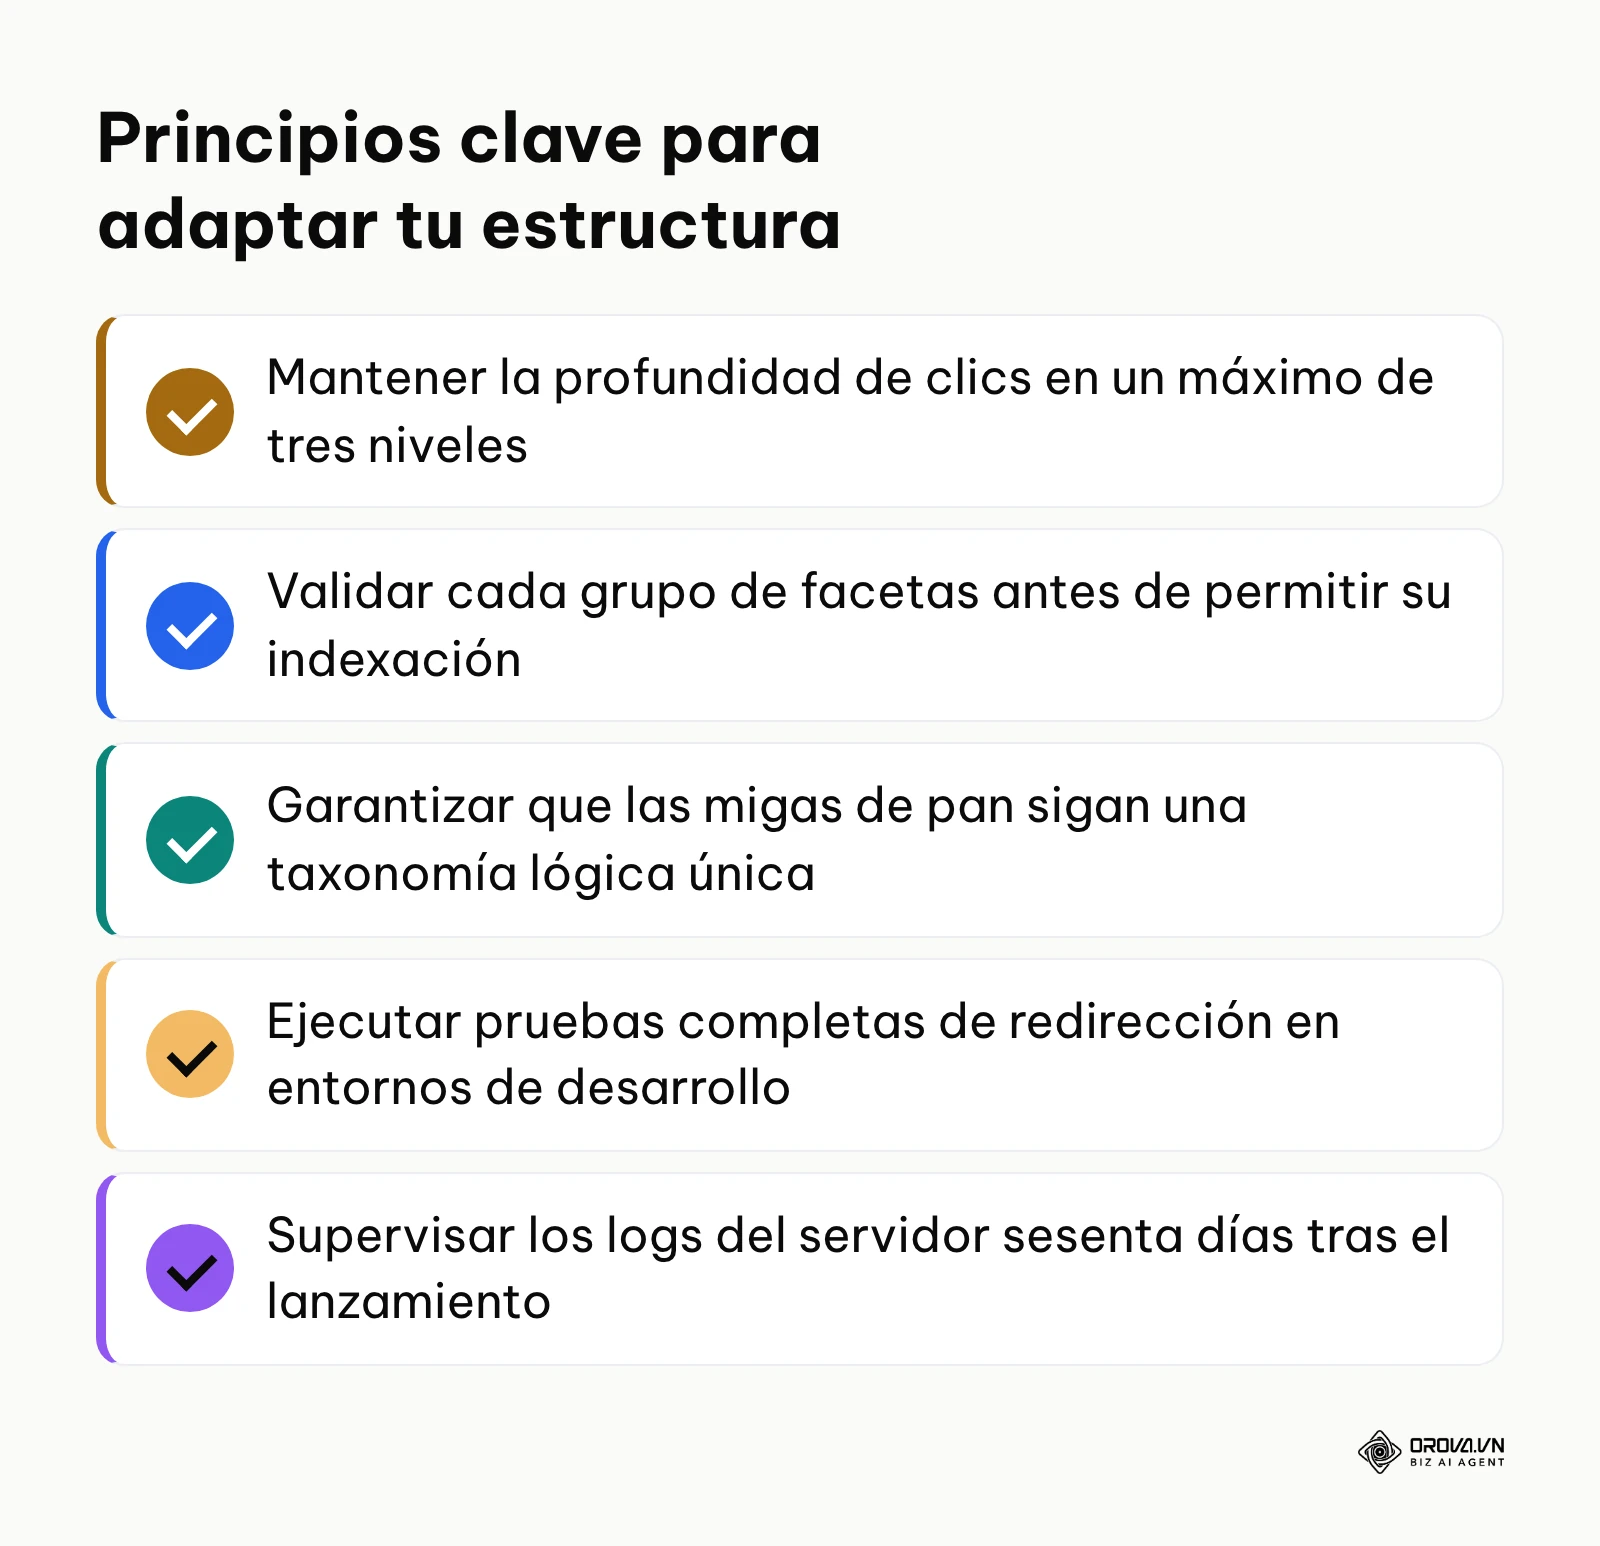
El siguiente resumen sintetiza las reglas operativas prioritarias que deben guiar la adaptación de tu plataforma.
Para fundadores y propietarios de pequeños negocios
Si gestionas tu propio negocio digital o lideras un equipo reducido, tu prioridad debe ser la simplicidad técnica y la prevención de errores que luego resulten costosos de corregir:
- Dibuja la estructura en papel o pizarra antes de crear una sola página: Define un mapa conceptual con un máximo de tres niveles (Página de inicio > Tres o cuatro categorías principales > Servicios o productos específicos). No crees categorías adicionales hasta que cuentes con suficiente contenido para poblarlas.
- Revisa las URLs huérfanas en tu primera semana: Utiliza una herramienta de auditoría sencilla para comprobar que todas las páginas de tu sitio web reciben al menos un enlace directo desde el menú de navegación, las páginas de servicios o el pie de página.
- Evita crear categorías vacías: Si un servicio o producto aún no está listo para su comercialización, no habilites una sección en blanco en el menú. Las páginas con escaso contenido o textos en construcción pueden perjudicar la percepción de calidad del dominio.
Para responsables internos de SEO y producto
Los especialistas que coordinan la estrategia técnica dentro de una empresa mediana o grande deben alinear los requisitos de posicionamiento con los ciclos de desarrollo de software:
- Establece reglas de canónicos y parámetros en el gestor de contenidos: Define junto al equipo de desarrollo qué filtros y facetas deben generar URLs indexables y cuáles deben consolidarse mediante etiquetas canónicas hacia la categoría madre o gestionarse mediante solicitudes dinámicas en el navegador.
- Integra datos estructurados jerárquicos en las plantillas: Supervisa que las plantillas de código generen automáticamente el esquema BreadcrumbList en todas las páginas y que las páginas de categoría utilicen el tipo CollectionPage con su listado formal de elementos hijos.
- Controla la profundidad de clics en cada despliegue de producto: Añade la métrica de profundidad máxima de clics a las pruebas de control de calidad (QA) previas al paso a producción, garantizando que los nuevos lanzamientos se mantengan a tres clics o menos de la portada.
- Supervisa mensualmente los registros de servidor: Analiza los archivos log del servidor para comprobar si los robots de rastreo están dedicando tiempo a URLs desactualizadas o parámetros huérfanos, ajustando las directivas del archivo robots.txt cuando sea necesario.
Para consultores y agencias técnicas
Los profesionales externos que se enfrentan a sitios web complejos o heredados deben ejecutar intervenciones metódicas con garantías contractuales:
- Diseña matrices de mapeo 301 con validación automatizada de estados: Ante cualquier rediseño o cambio de taxonomía, elabora una hoja de cálculo completa que empareje cada URL antigua con su nuevo destino definitivo, verificando que los códigos de respuesta devuelvan un estado 301 sin cadenas intermedias.
- Implementa puentes semánticos controlados entre categorías: Identifica temas complementarios que requieran enlaces cruzados y documenta las pautas de textos de anclaje para los redactores, asegurando que los enlaces refuercen entidades afines sin dispersar la especialización de cada clúster.
- Presenta informes visuales de distribución de PageRank interno: Utiliza diagramas de grafo y puntuaciones de autoridad interna para demostrar a los clientes cómo las modificaciones estructurales han mejorado el acceso de los rastreadores a sus páginas transaccionales más rentables.
La siguiente tabla resume los errores más habituales detectados en proyectos de arquitectura digital, sus repercusiones y las medidas preventivas necesarias:
| Error común | Consecuencia técnica | Cómo evitarlo |
|---|---|---|
| Menús de cabecera con cientos de enlaces masivos | Dispersión excesiva del PageRank inicial hacia páginas secundarias sin relevancia | Mantener únicamente las categorías clave en la cabecera principal y usar menús secundarios contextuales |
| Parámetros infinitos en URLs de navegación | Desperdicio masivo del presupuesto de rastreo y generación de contenido duplicado | Configurar canónicos hacia la categoría padre o bloquear los parámetros en el archivo robots.txt |
| Enlaces cruzados sin relación temática justificada | Confusión algorítmica sobre la temática de cada sección y dilución de autoridad | Vincular solo temas que compartan entidades conceptuales en el grafo de conocimiento |
Ejemplo ilustrativo: Un portal inmobiliario con 35.000 fichas perdió un 25% de tráfico orgánico tras un rediseño no planificado. Los registros del servidor revelaron que el nuevo sistema de filtrado por barrios y precios había generado más de 200.000 combinaciones de URLs con parámetros rastreables que saturaban al bot de Google. Se implementó de urgencia una regla en el archivo robots.txt para bloquear los parámetros de ordenación y rangos de precio, mientras que los filtros de barrios con demanda se transformaron en URLs estáticas limpias con contenido específico. Los enlaces antiguos que devolvían 404 se redirigieron con 301 a las nuevas páginas de zona. En un plazo de tres semanas, el volumen de peticiones del bot sobre URLs sin valor se redujo un 70% en los registros de acceso y las páginas de propiedades en venta recuperaron su ritmo normal de rastreo e indexación.
Tendencias en arquitectura web SEO para los próximos años: visión del autor
A fecha de 2026, los motores de búsqueda basados en modelos lingüísticos avanzados han demostrado que la recuperación de información ya no depende de la coincidencia exacta de palabras clave, sino de la interconexión semántica de los conceptos dentro de un portal.
En mi opinión, durante los próximos dos o tres años presenciaremos una transformación radical en la forma en que los rastreadores evalúan la arquitectura de la información:
1. Los grafos de conocimiento locales sustituirán a los esquemas jerárquicos rígidos. Los motores generativos no consumen páginas como documentos aislados, sino que reconstruyen grafos de entidades para responder a consultas complejas. Considero que las plataformas que organicen sus contenidos como redes semánticas interconectadas, donde cada página defina formalmente sus dependencias ontológicas mediante esquemas anidados, tendrán una ventaja decisiva sobre aquellas que sigan utilizando taxonomías rígidas de árbol. Para prepararse desde ahora, los desarrolladores deben adoptar modelos de datos estructurados enriquecidos y asegurar que cada nodo temático aporte valor informativo único (Information Gain).
2. El renderizado universal y el código fuente estático volverán a ser el estándar ineludible. Hoy en día muchas empresas apuestan por arquitecturas desacopladas (Headless) que delegan la generación de enlaces en scripts ejecutados en el navegador del usuario. Me inclino por pensar que los motores de búsqueda incrementarán las penalizaciones de rastreo hacia aquellos sitios cuyos enlaces estructurales no estén presentes de forma directa en el HTML inicial recibido por el servidor. Para blindar un proyecto, los equipos técnicos deben priorizar el renderizado del lado del servidor (SSR - Server-Side Rendering) o la generación estática incremental, garantizando que el grafo de navegación sea inmediatamente legible para cualquier analizador automatizado.
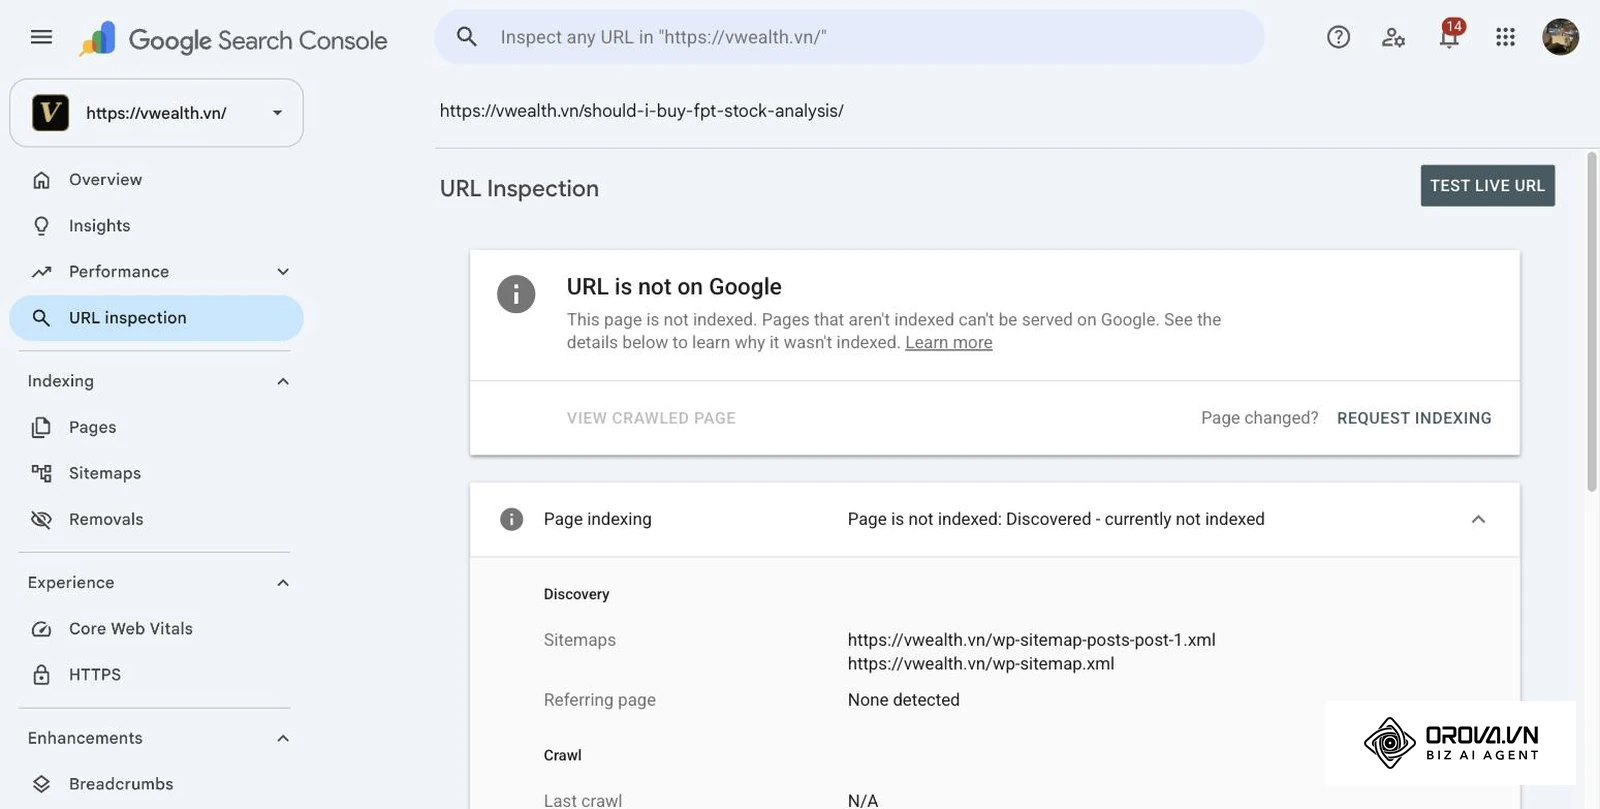
3. La poda sistemática de URLs superará en importancia a la expansión de contenidos. Durante la última década el crecimiento orgánico se asoció a la creación incesante de nuevas páginas secundarias. Hoy vemos que los costes de computación de los buscadores están obligando a los algoritmos a ser extremadamente selectivos con los recursos de rastreo que asignan a cada dominio. En mi opinión, los portales que prosperarán en el futuro próximo no serán los que acumulen decenas de miles de URLs de escaso valor, sino aquellos que consoliden su arquitectura en clústeres densos, resolviendo la navegación por facetas y eliminando páginas superfluas. Recomiendo iniciar auditorías de inventario para fusionar contenidos redundantes antes de que los algoritmos de calidad reduzcan su presupuesto de rastreo. Un ejemplo real de lo que hay que buscar: en la inspección de URL de Search Console de vwealth.vn, un artículo aparece como «Descubierta: actualmente sin indexar» y sin ninguna página de referencia; Google solo lo conoce por el sitemap. Es justo el tipo de URL huérfana que conviene enlazar desde su clúster o fusionar con otra.
Estas previsiones podrían resultar inexactas si las principales empresas tecnológicas deciden abrir protocolos directos de alimentación de datos mediante interfaces de programación (APIs) que sustituyan por completo la necesidad de que los bots rastreen la web pública tradicional, o si los modelos de lenguaje reducen drásticamente sus costes de inferencia hasta el punto de indexar el contenido dinámico en tiempo real sin restricciones de computación.
Preguntas frecuentes sobre arquitectura web SEO
¿Sigue siendo necesaria la arquitectura web SEO ahora que existe la inteligencia artificial?
Sigue siendo un factor determinante para el éxito digital. Aunque los motores de inteligencia artificial procesan el lenguaje de forma más avanzada, continúan dependiendo de enlaces y estructuras lógicas para descubrir páginas, calcular la autoridad de un dominio y comprender la jerarquía entre entidades. Un sitio web desorganizado impide que los algoritmos de recuperación aumentada por generación extraigan información precisa, reduciendo las probabilidades de que tu contenido sea citado en las respuestas automáticas de los buscadores.
¿Es mejor utilizar un subdominio o una subcarpeta para organizar el blog o la tienda?
En la mayoría de los proyectos, la subcarpeta (dominio.com/blog/) es la opción recomendable porque concentra las señales en un único sitio; el subdominio solo compensa cuando hay una restricción técnica real, como un servidor o una plataforma independiente.
¿Cómo resolver las migas de pan cuando un producto pertenece a varias categorías?
Asigna una única categoría primaria a cada producto y haz que las migas de pan visibles y el BreadcrumbList muestren siempre esa ruta, aunque el usuario llegue desde otra sección.
¿Cuánto dura el periodo de volatilidad de tráfico al reestructurar un sitio web hacia un modelo silo?
Suele durar entre dos y ocho semanas, según el número de URLs modificadas y la frecuencia con la que Googlebot rastrea el sitio.
¿Cómo se puede medir el flujo de PageRank interno mediante el análisis de archivos log?
Cruza las visitas de Googlebot en los logs del servidor con el Link Score de un rastreador como Screaming Frog: si las secciones secundarias reciben más visitas del bot que las páginas estratégicas, la estructura desvía el rastreo.
¿Qué diferencia crítica existe entre la profundidad de clics y la profundidad de la URL?
La profundidad de la URL cuenta las carpetas de la dirección; la profundidad de clics cuenta los enlaces que hay que pulsar desde la portada. Para los buscadores importa la segunda.
¿Por dónde empezar a optimizar tu arquitectura web SEO?
La reestructuración de un portal no debe abordarse de forma indiscriminada, sino identificando el punto de partida en el que se encuentra tu proyecto técnico.
Si estás ante un sitio nuevo desde cero, tu primer paso realizable en una sola sesión de trabajo consiste en diseñar el mapa jerárquico completo en una hoja de cálculo antes de instalar el gestor de contenidos o crear páginas. Define la página principal, selecciona un máximo de cuatro categorías troncales basadas en la investigación previa de palabras clave y asegúrate de que cada una de ellas cuente con un propósito de búsqueda claramente diferenciado. Este ejercicio previene la necesidad de ejecutar redirecciones y reestructuraciones complejas en el futuro.
Si gestionas un sitio en producción con estructura caótica y profunda, tu primera acción para una jornada de trabajo es ejecutar un rastreo completo con una herramienta especializada y filtrar el listado de páginas por profundidad de clics. Localiza todas aquellas URLs estratégicas que superen los tres clics de distancia desde la página principal y crea enlaces contextuales directos desde las categorías madre o desde las páginas de mayor autoridad para recortar su profundidad en menos de cuatro horas de trabajo técnico.
Si cuentas con una arquitectura ya implementada pero careces de métricas o seguimiento, el paso inmediato que puedes completar en una mañana de trabajo es cruzar tu inventario actual de URLs con el informe de páginas no indexadas de Google Search Console y los registros de acceso de tu servidor. Identifica qué carpetas o parámetros están consumiendo solicitudes de los rastreadores sin generar clics orgánicos y elabora un listado de directivas para limitar su acceso en el archivo robots.txt o aplicar etiquetas canónicas correctoras.
Comprender y ejecutar estos fundamentos técnicos desde la primera sesión es el camino más directo para consolidar una arquitectura web seo sólida, escalable y resistente a las actualizaciones de los motores de búsqueda.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Gestiona tu negocio con AI Agents
Orova es el Biz AI Agent que nunca para: planifica, ejecuta y optimiza el trabajo por ti.
Gana tiempo y multiplica tu productividad.