
Qué es el archivo robots txt: plantillas por CMS y bots de IA
El archivo robots txt es un pequeño documento de texto que le dice a Google, Bing y a los demás rastreadores qué partes de tu sitio pueden recorrer y cuáles no. Imagina que lanzas una tienda nueva y, semanas después, descubres que el buscador apenas ha visitado tus páginas de producto, pero sí cientos de rutas sin valor: carritos vacíos, combinaciones de filtros o páginas de inicio de sesión. Casi siempre el origen está en un robots.txt ausente, mal escrito o copiado sin entenderlo. Un error frecuente es creer que este archivo sirve para esconder información privada; no es así. Su función real es orientar el rastreo hacia el contenido que importa. En esta guía verás qué es, cómo se lee línea a línea, plantillas por CMS, los errores que más daño hacen y cómo tratar a los rastreadores de inteligencia artificial.
Archivo robots txt: ¿Qué es?
El archivo robots txt es un documento de texto plano ubicado en el directorio raíz de un sitio web que contiene instrucciones fundamentales para los rastreadores automatizados. Sirve para gestionar inteligentemente el presupuesto de rastreo indicando qué rutas estructurales deben evitarse siempre, y se diferencia radicalmente de un mapa del sitio porque restringe el acceso en lugar de fomentarlo o sugerirlo.
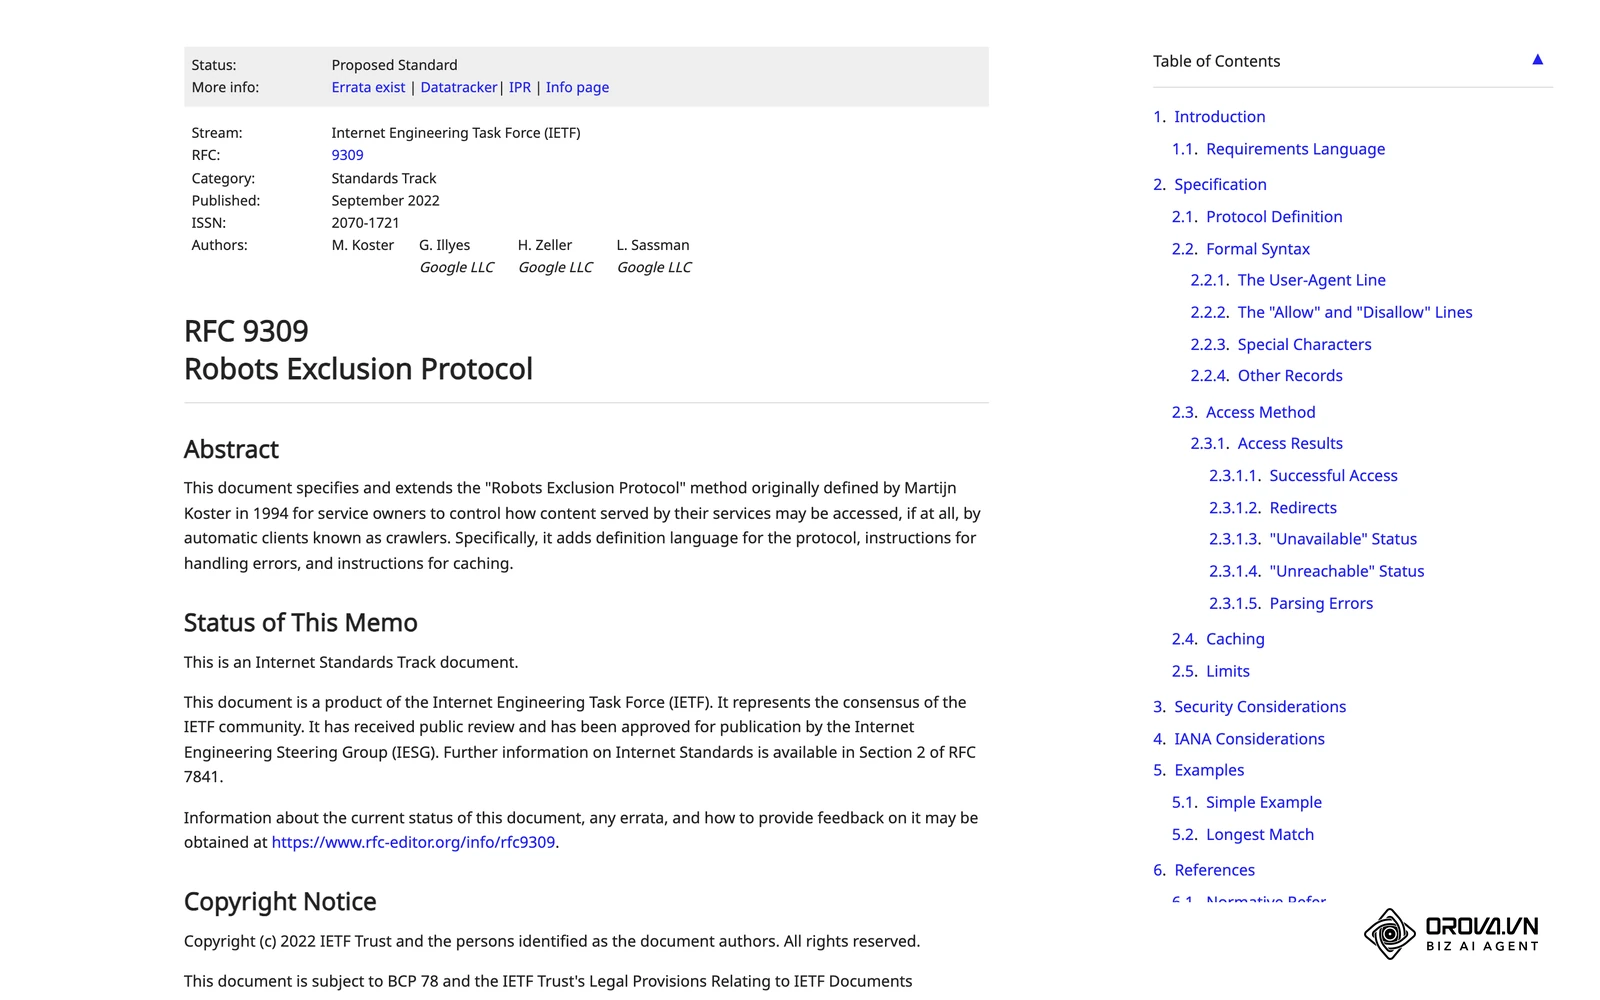
De acuerdo con el documento RFC 9309 publicado por la Internet Engineering Task Force (IETF) en 2022, el protocolo se ha estandarizado formalmente para garantizar su adopción universal y reducir la ambigüedad en el procesamiento de rutas. Su origen se remonta a 1994, cuando Martijn Koster propuso el Protocolo de Exclusión de Robots después de que un rastreador saturara su servidor con peticiones repetidas. Hoy, este principio básico sigue gobernando la infraestructura del posicionamiento orgánico mundial.
Para comprender a fondo su lugar dentro del ecosistema técnico, es necesario contrastarlo fuertemente con otros mecanismos comunes de control que habitualmente generan una profunda confusión en los equipos de implementación. La clásica diferencia entre robots txt y sitemap radica fundamentalmente en el carácter de sus intenciones, algo que detallamos a continuación.
| Concepto técnico | Dónde radica la diferencia operativa principal | Ejemplo de uso práctico y cotidiano |
|---|---|---|
| Archivo de exclusión | Bloquea el proceso de lectura algorítmica mucho antes de que el robot pueda procesar el código de la página. | Evitar que los buscadores entren a leer la carpeta administrativa oculta de /wp-admin/. |
| Mapa del sitio (Sitemap) | Actúa como un índice o catálogo que sugiere encarecidamente nuevas rutas a descubrir; no tiene el poder técnico de bloquear nada. | Enviar proactivamente una lista priorizada de todas las URL de los artículos de noticias recientes. |
| Etiqueta Meta Noindex | Permite físicamente que el programa informático lea el documento, pero emite una orden estricta que prohíbe guardarlo o mostrarlo en los resultados públicos. | Ocultar una página transaccional de "Gracias por tu compra" que solo debe verse tras un pago exitoso. |
Llevado a un ejemplo cotidiano, puedes visualizar tu sitio web como un restaurante de alta categoría. El mapa del sitio funciona como el menú elegante que entregas a tus clientes sugiriendo los mejores platos (las páginas de venta). Por otro lado, tu archivo de exclusión es equivalente al cartel de "Prohibido el paso: Solo personal autorizado" que colocas firmemente en las puertas batientes de la cocina o en el almacén de limpieza; no estás ocultando un secreto de estado, simplemente estás evitando que tus comensales tropiecen y se pierdan en áreas que no fueron diseñadas para ofrecer una experiencia estética ni comercial.
El propósito estructural del archivo
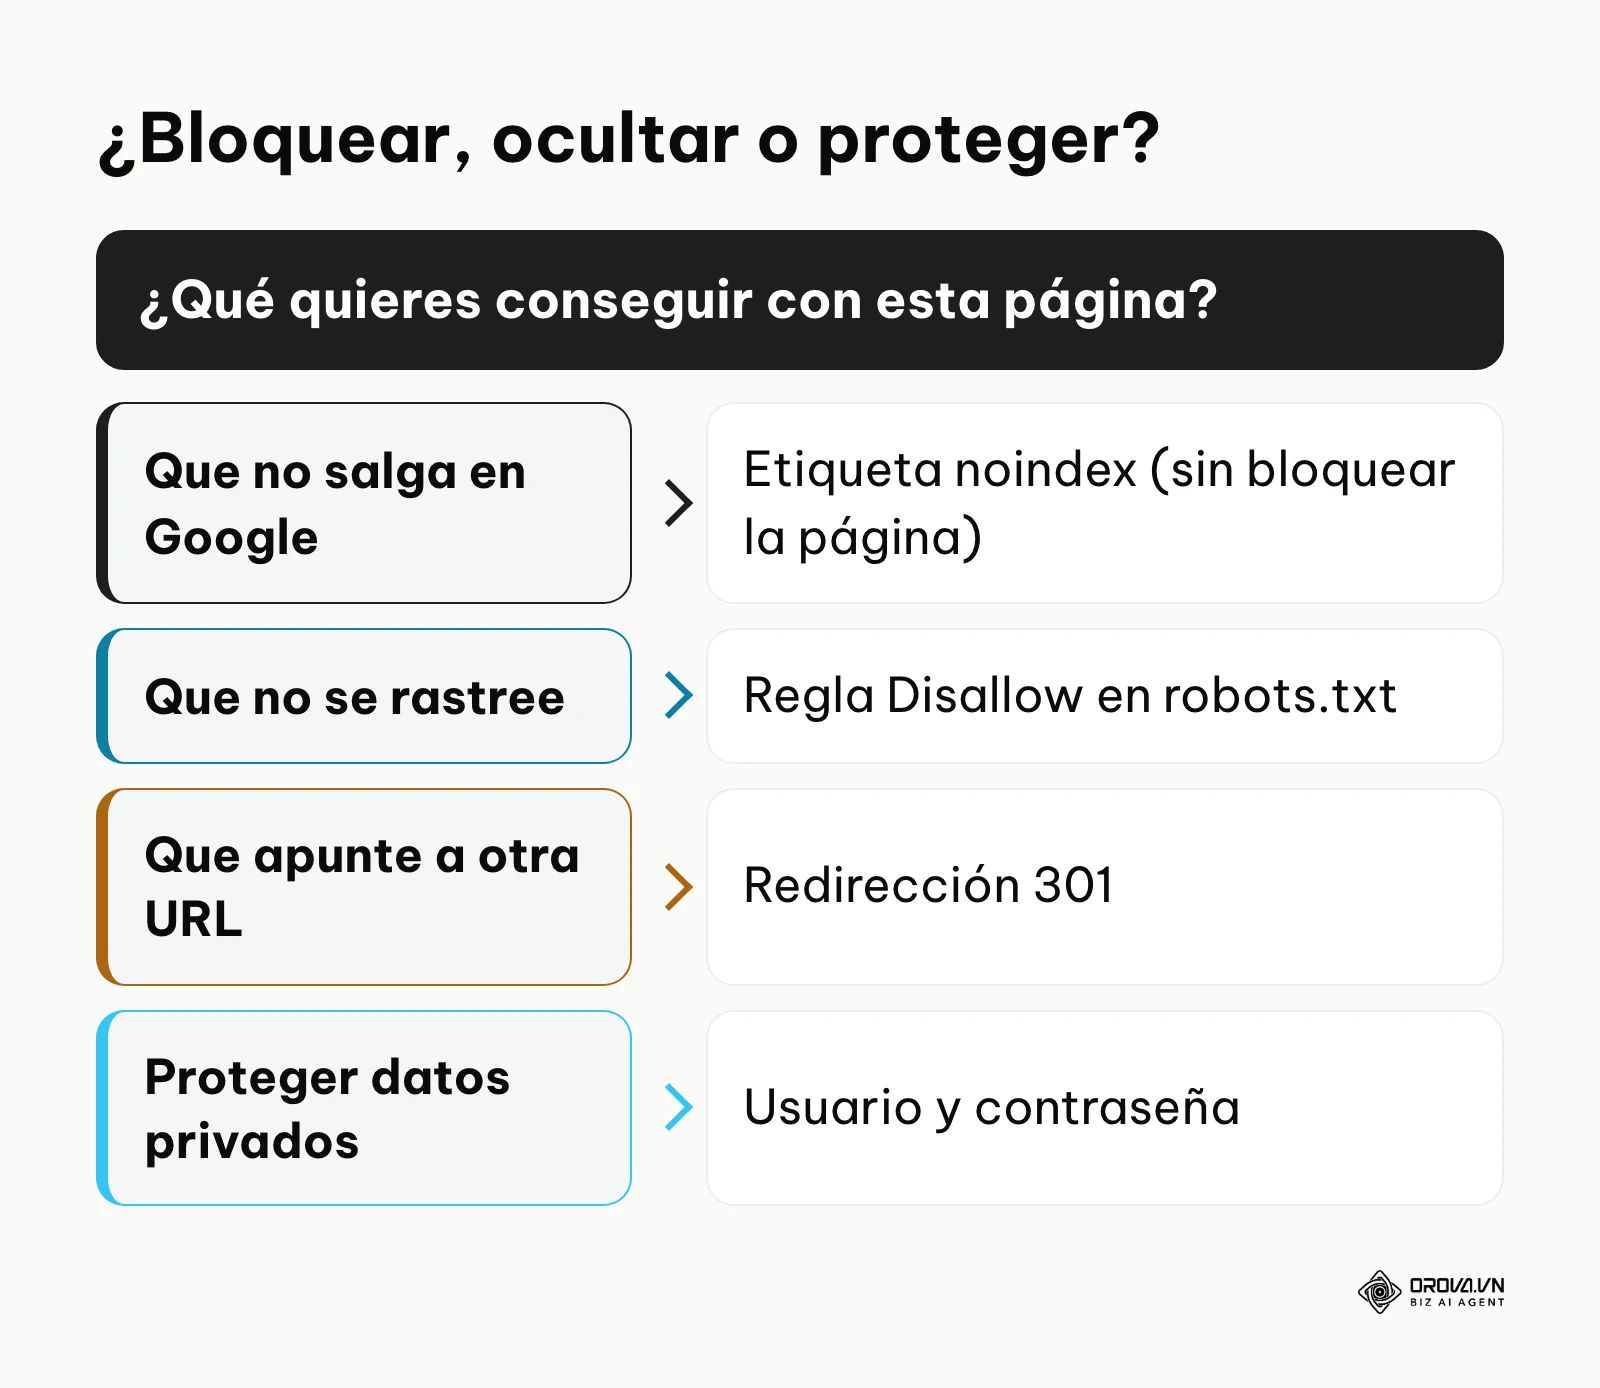
El propósito central de este documento es gestionar eficientemente los recursos del servidor mediante la conservación estricta de tu presupuesto de rastreo (crawl budget, que es la cantidad máxima teórica de documentos que un buscador está dispuesto a procesar dentro de tu dominio en un día determinado). Este archivo se sitúa en la primera línea de la cadena arquitectónica; es la puerta de entrada ineludible. Antes de que cualquier algoritmo de Google, Bing o plataformas emergentes siquiera intente descargar una imagen o leer un párrafo de texto en tu ecosistema, primero buscará obsesivamente este pequeño archivo en la ruta de inicio. El árbol de decisiones debajo resume las vías de acción correctas para proteger tu presupuesto y tu privacidad simultáneamente.
Aunque cada buscador interpreta algunos detalles a su manera, la idea de fondo es la misma: el rastreo es un recurso limitado. Si decides ignorar este documento y dejar todo abierto, los motores desperdiciarán sus preciados milisegundos procesando páginas repetitivas generadas automáticamente, dejando sin oxígeno tus páginas comerciales más recientes o importantes.
Ejemplo ilustrativo: Una empresa especializada en la venta de zapatillas deportivas poseía un inmenso catálogo. El equipo técnico notó con preocupación que el límite diario de rastreo se desperdiciaba completamente en cientos de URLs creadas por filtros dinámicos irrelevantes, tales como combinaciones de talla y color que no aportaban valor informativo. Tras analizar la situación, implementaron comandos de bloqueo altamente precisos dirigidos a restringir el acceso a cadenas que incluyeran parámetros como "?talla=". Durante el ajuste, un error tipográfico bloqueó por unas horas la carpeta de estilos, y lo detectaron revisando los registros del servidor. Tras corregirlo, el rastreo empezó a concentrarse en las categorías principales y las colecciones nuevas se descubrían antes.
Cuando no necesitas usar este documento en tu estrategia: Existen escenarios técnicos particulares donde modificar o crear directrices restrictivas resulta completamente innecesario y, a menudo, contraproducente. Si posees un pequeño portal de servicios corporativos que consta de apenas veinte páginas estáticas, que además carece de funcionalidades de búsqueda interna y no maneja paneles de administración complejos, la configuración abierta y predeterminada de tu alojamiento web es más que suficiente. Invertir recursos en restricciones aquí carece de lógica de retorno. Asimismo, si tu intención primordial y urgente es lograr que una página indexada por accidente desaparezca de los resultados globales, implementar un bloqueo estructural aquí es un error garrafal; el camino correcto en esa situación es insertar siempre una orden de Noindex directamente en el encabezado fuente del documento.
Impacto y beneficios técnicos
El valor principal radica en la reducción sistemática de costos operativos por transferencia de datos y en la aceleración táctica de la indexación de tus vectores de conversión. Cuando el archivo está configurado meticulosamente, el impacto técnico se divide en dos esferas complementarias: el retorno del lado comercial para los líderes del negocio y las eficiencias del flujo de trabajo diario para los implementadores.
Valor táctico directo para la empresa
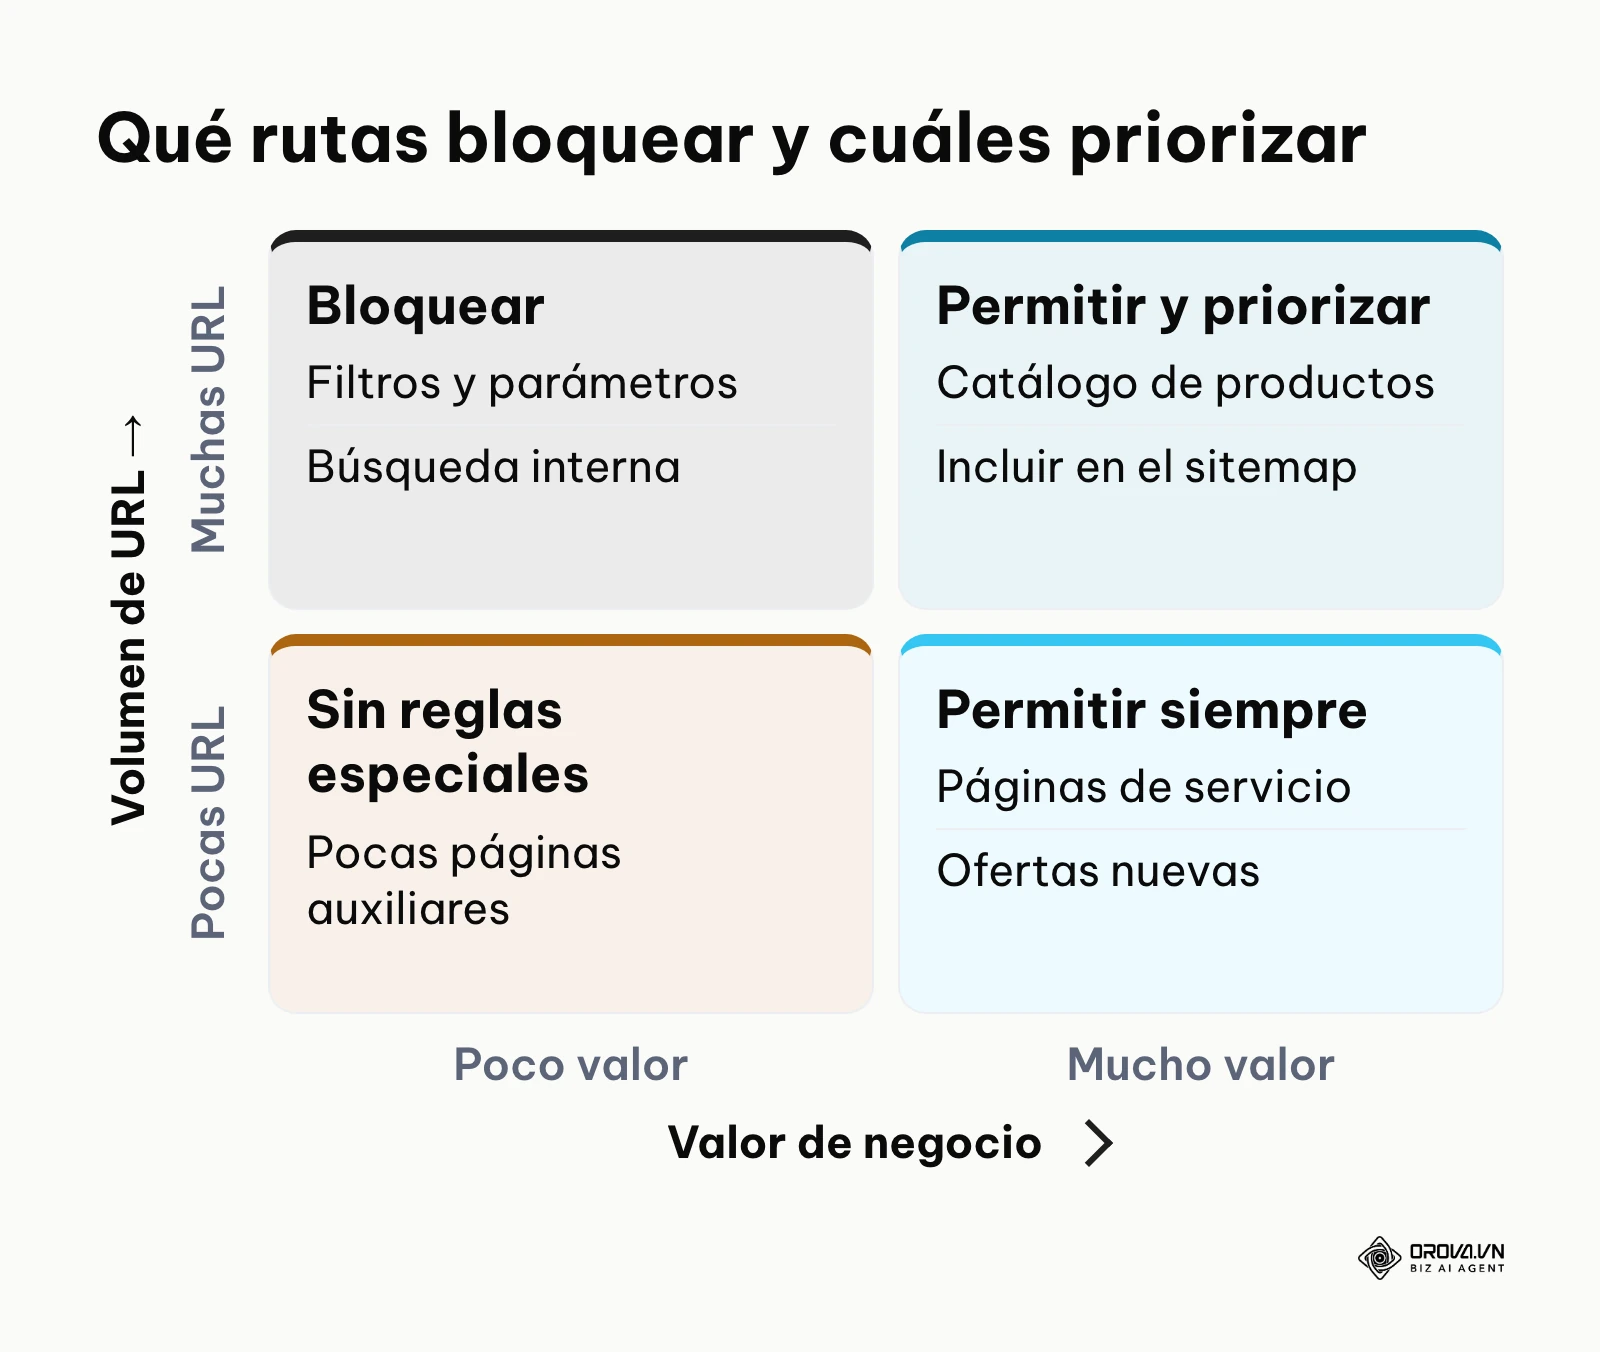
Para una compañía en crecimiento, cada vez que un bot irrelevante descarga repetidamente miles de archivos pesados y sin valor comercial, el departamento financiero está pagando en exceso por facturas de ancho de banda y capacidad en la nube, sin obtener ni un solo centavo de retorno. Restringir rutas sin valor puede reducir esa carga y ayuda a que, cuando el equipo publica una oferta nueva, los buscadores la encuentren antes en lugar de perder tiempo en páginas irrelevantes.
Beneficios operativos de paz mental para el equipo técnico
Para el ingeniero o especialista de posicionamiento interno, una configuración maestra se traduce en un ecosistema de datos inmensamente más limpio. Esto significa que al revisar los registros internos o al analizar los informes de errores en Google Search Console, no tendrán que malgastar horas valiosas de la semana filtrando cientos de falsas alarmas generadas por páginas que jamás debieron escanearse. Un entorno restringido y organizado previene la fatiga por alertas, reduciendo la fricción mental del equipo al enfocarse solo en alertas que realmente afectan la salud del sistema.
Ejemplo ilustrativo: Un gran portal dedicado a la publicación intensiva de artículos periodísticos y columnas de opinión enfrentaba caídas intermitentes de sus servidores de bases de datos. El equipo de sistemas descubrió que múltiples rastreadores globales pasaban las noches iterando sobre archivos de noticias de hace diez años que poseían complejos parámetros de formato de impresión. Decidieron redactar de urgencia reglas restrictivas para desviar temporalmente el tráfico de bots lejos de las hemerotecas antiguas. En la prisa, una línea mal escrita restringió involuntariamente la categoría actual de deportes y economía. Tras percatarse de que el tráfico caía drásticamente esa mañana, los operadores revirtieron la regla específica apoyándose en un entorno de pruebas controlado. Tras el ajuste definitivo, la carga del servidor bajó y los picos de caída dejaron de repetirse.
Para consolidar la claridad operativa, aquí exponemos cómo se miden estos avances técnicos en el día a día.
| Beneficio | Cómo verificarlo | Cuándo suele notarse |
|---|---|---|
| Rastreo concentrado en lo importante | Proporción de URL valiosas frente a URL de filtros o parámetros en el informe de estadísticas de rastreo. | Tras varias semanas, según la frecuencia de rastreo del sitio. |
| Menos carga en el servidor | Menos peticiones de bots en los registros y en el panel del proveedor de alojamiento. | En pocos días, porque los rastreadores leen el archivo con frecuencia. |
| Informes más limpios | Menos URL de filtros y parámetros en el informe de indexación de páginas. | De forma progresiva. |
Descubre Orova.vn – una plataforma Biz AI Agent con la solución OROVA SEO completa, destinada a todos los sitios web. El sistema acompaña la optimización para motores de búsqueda de A a Z con las siguientes funciones: investigación de palabras clave, redacción de nuevos artículos optimizados para SEO, optimización de los contenidos existentes, seguimiento de posiciones, además del análisis de la competencia y el análisis técnico en profundidad. Regístrate hoy mismo para descubrir OROVA SEO de forma totalmente gratuita (oferta válida hasta el 7 de julio de 2027).
Cómo funciona y anatomía del archivo
El mecanismo de funcionamiento se basa en la lectura lineal y estricta de directrices de texto, línea por línea, actuando como un filtro primario antes de ejecutar cualquier solicitud de descarga en tu servidor. Aunque su apariencia resulta rudimentaria al constar únicamente de frases cortas, el archivo procesa la información utilizando una lógica de coincidencia de patrones muy específica. Las herramientas automatizadas aplican normas rígidas, donde la regla más extensa y coincidente suele imponerse jerárquicamente frente a comandos más cortos o genéricos. A continuación verás las cuatro directivas principales, plantillas como la de como crear archivo robots txt wordpress y cómo tratar a los rastreadores de IA. Según la documentación de Google Search Central sobre las especificaciones de robots.txt, Google procesa como máximo 500 KiB de este archivo e ignora el contenido que supere ese límite, por lo que la brevedad y concisión no son solo preferencias estilísticas, son mandatos operativos formales.
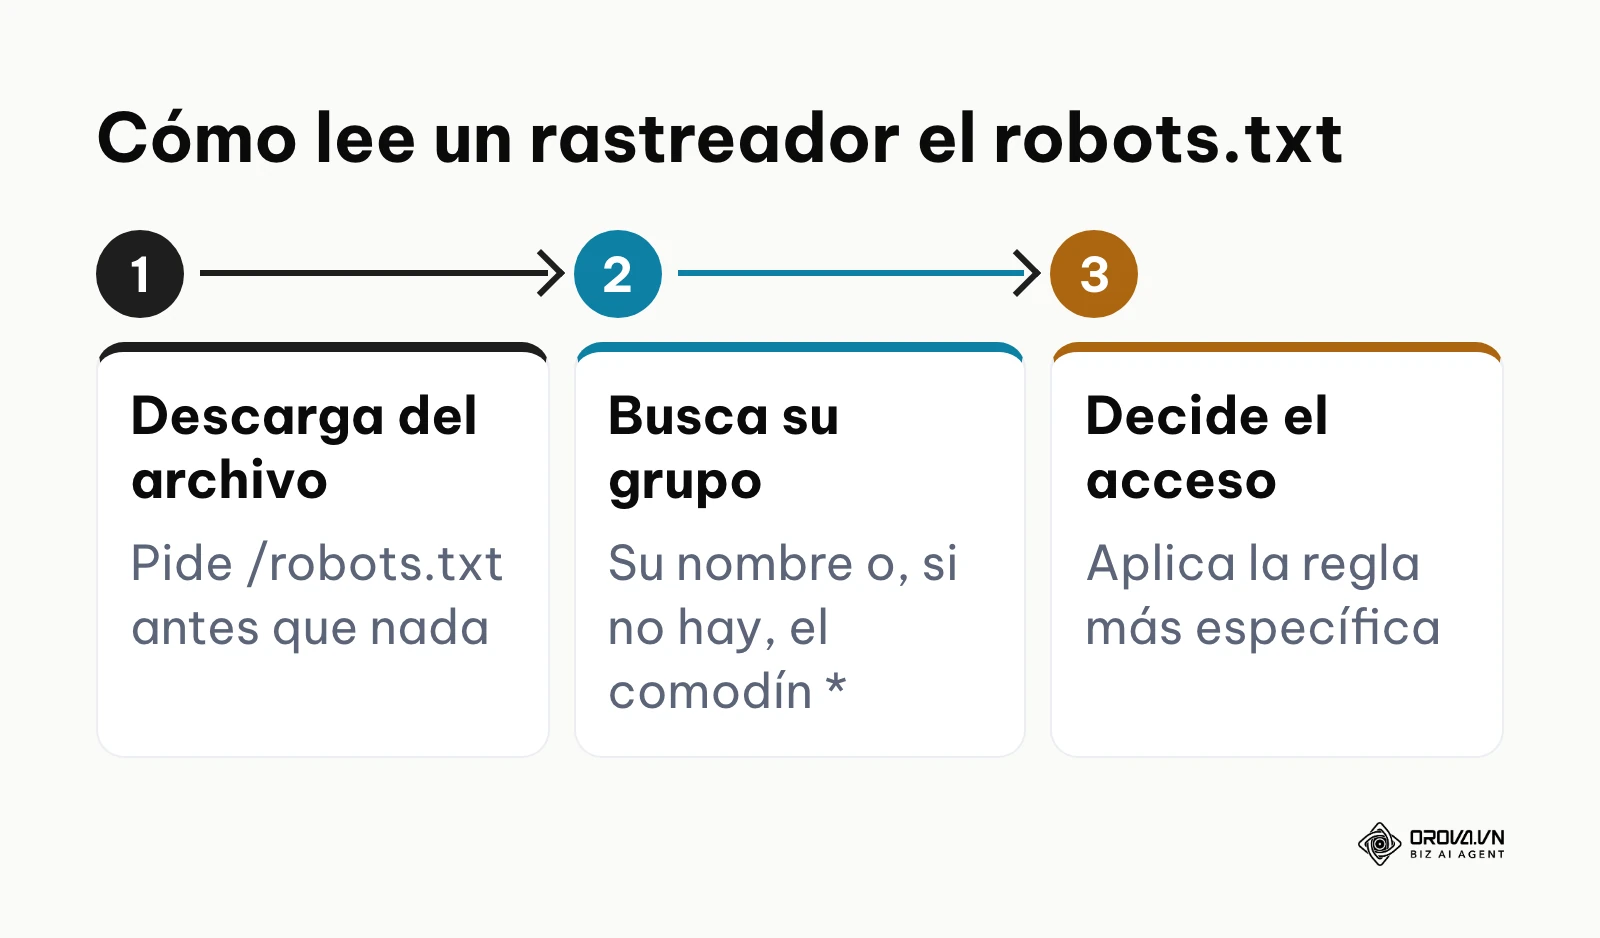
El flujo visual bajo estas líneas ilustra el orden de evaluación del protocolo.
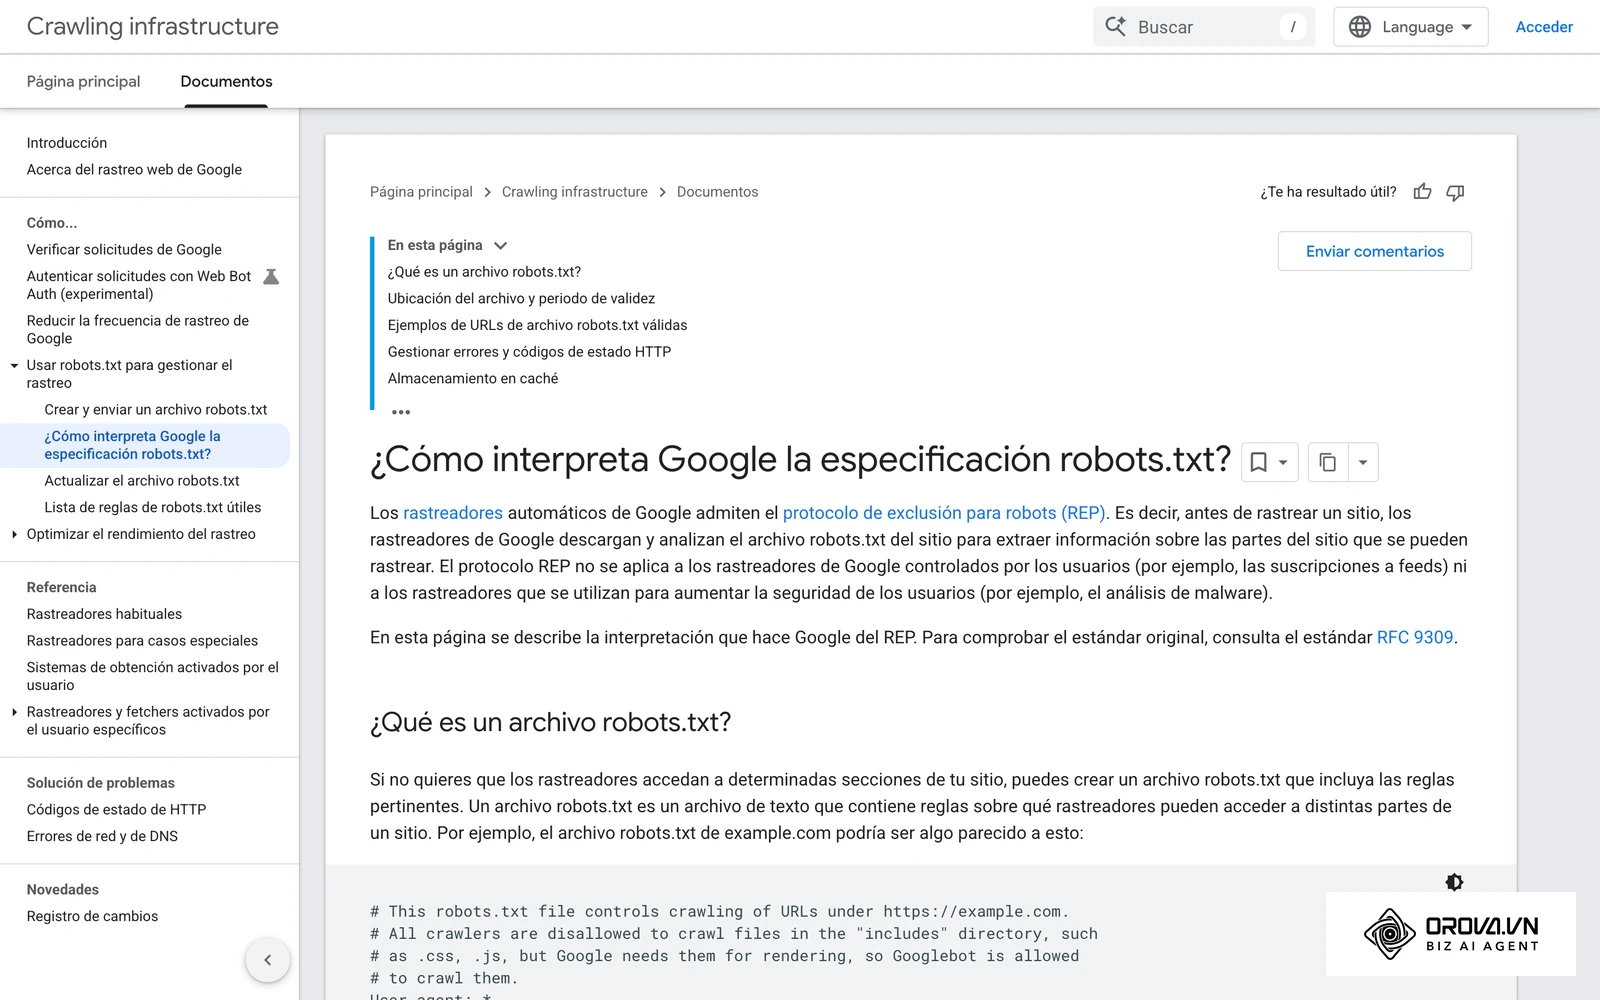
Directrices fundamentales del lenguaje
Toda configuración técnica dentro de este ecosistema se construye orquestando cuatro comandos primarios. Los nombres de las directivas no distinguen mayúsculas y minúsculas, pero las rutas sí: Disallow: /Privado/ no bloquea /privado/.
- User-agent: Define a quién va dirigida la orden. Actúa como el llamado de atención. Puedes nombrar a un programa específico (como Googlebot o Bingbot) o utilizar el famoso comodín asterisco (*) para dirigirte, de manera global e indiscriminada, a cualquier software automatizado del planeta que golpee tu servidor.
- Disallow: El corazón de la restricción técnica. Este comando indica la ruta o directorio relativo exacto al cual el sujeto declarado anteriormente tiene terminantemente prohibido acceder. Un campo vacío en esta línea indica libertad absoluta, mientras que una simple barra inclinada (/) prohíbe el acceso a todo el dominio.
- Allow: La excepción a la regla de restricción. Sirve para crear aberturas quirúrgicas dentro de bloques previamente cerrados. Por norma de coincidencia algorítmica, si existe una restricción amplia pero una regla de permisión es más larga y específica, la permisión anulará la prohibición exclusivamente para esa ruta detallada.
- Sitemap: La única directriz que carece de vinculación jerárquica con las demás. Declara la ubicación absoluta (incluyendo el prefijo HTTPS seguro) del índice general de mapas estructurales de tu ecosistema. Su presencia es crítica para acelerar descubrimientos masivos.
Para aprovechar el verdadero potencial, los especialistas dominan el uso avanzado de patrones comodín. El símbolo del asterisco (*) representa cualquier secuencia de caracteres, mientras que el símbolo de dólar ($) indica que la regla finaliza rígidamente en ese punto, siendo inmensamente útil para restringir tipos de archivos específicos sin afectar directorios que comparten nombres similares.
Plantillas probadas para gestores de contenido (CMS)
En las secciones técnicas de esta guía, encontrarás diversos ejemplos de robots txt listos para ser copiados y adaptados. La arquitectura interna de cada sistema exige un enfoque particular. Son puntos de partida: revisa cada ruta contra la estructura real de tu sitio antes de publicarlas.
El bloque fundacional optimizado para WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/
Sitemap: https://www.midominio.com/sitemap_index.xml
Razonamiento estructural: Bloquear /wp-admin/ es lo habitual. La excepción sobre admin-ajax.php es importante porque muchos plugins y temas dependen de ese archivo para renderizar contenido interactivo que el motor de búsqueda necesita "ver" para juzgar correctamente la experiencia móvil. Bloquear las rutas de búsqueda interna evita que los rastreadores pierdan tiempo en miles de páginas de resultados sin valor. No bloquees /wp-json/ a ciegas: algunos temas lo usan para cargar contenido.
Reglas habituales en Shopify
User-agent: *
Disallow: /admin
Disallow: /cart
Disallow: /orders
Disallow: /checkout
Disallow: /password
Disallow: /*?*ls=*&ls=*
Sitemap: https://www.midominio.com/sitemap.xml
Razonamiento estructural: Shopify genera el robots.txt automáticamente con reglas como estas; si necesitas cambiarlo, se hace editando la plantilla robots.txt.liquid del tema, no subiendo un archivo. Bloquear carrito, pago y pedidos evita que los rastreadores gasten tiempo en procesos transaccionales, y la regla de parámetros ls frena combinaciones repetidas de filtros.
La contención estricta para catálogos masivos Magento (Adobe Commerce)
User-agent: *
Disallow: /index.php/
Disallow: /catalog/product_compare/
Disallow: /catalog/category/view/
Disallow: /catalogsearch/
Disallow: /checkout/
Disallow: /customer/
Disallow: /*?dir*
Disallow: /*?limit=all
Sitemap: https://www.midominio.com/sitemap.xml
Razonamiento estructural: Los catálogos grandes generan muchas versiones de la misma lista. Las dos reglas con parámetros (?dir para el orden y ?limit=all para mostrar todo) evitan que se rastreen copias del mismo catálogo ordenadas o paginadas de otra forma.
La estructura dinámica para aplicaciones modernas Next.js / React
User-agent: *
Disallow: /api/
Disallow: /private/
Sitemap: https://www.midominio.com/sitemap.xml
Razonamiento estructural: Es tentador bloquear también /_next/, pero ahí están el JavaScript, el CSS y las imágenes optimizadas que Google necesita para renderizar la página. Bloquéalo y Google verá una versión incompleta de tu sitio. Basta con cerrar las rutas de API y las zonas privadas.
Errores fatales de configuración y cómo solucionarlos
Un fallo aquí rara vez da avisos visibles al principio, por eso conviene conocer los más comunes.
- Bloqueo accidental de recursos estáticos críticos (CSS, JS, Fuentes): Un error anticuado pero muy frecuente consiste en restringir carpetas enteras de "diseño" o "scripts" bajo la premisa equivocada de ahorrar ancho de banda. Así Google no puede renderizar la página como la ve un usuario y puede interpretar mal su contenido y su versión móvil. Solución: usa la herramienta de inspección de URLs de Search Console para ver cómo Google renderiza la página.
- El exterminador global de un solo carácter: Una línea Disallow: / bajo User-agent: * impide rastrear todo el dominio. Las páginas pueden seguir apareciendo un tiempo, pero sin descripción, y van perdiendo visibilidad. Solución: Mantén un control de versiones y revisa al menos dos veces que no se cuele una barra inclinada solitaria si solo planeabas dejar un espacio en blanco de libre acceso.
- El sangrado radiactivo del entorno de pruebas hacia producción: Es inmensamente común que los equipos técnicos, al migrar un nuevo sitio web desarrollado en un servidor de pre-producción restringido, arrastren por error el archivo de bloqueo total hacia el sitio en producción. Solución: Implementa verificaciones automáticas de despliegue y scripts en los flujos de integración continua que sobrescriban el documento según el ambiente destino.
Cómo bloquear bots de Inteligencia Artificial (2026)
El auge de la minería masiva de datos ha transformado radicalmente las prácticas de administración técnica en los servidores web. Los desarrolladores enfrentan ahora la avalancha incesante de rastreadores extractivos generativos. Sin embargo, la reacción de pánico y prohibición ciega no es inteligente; resulta vital diferenciar entre las entidades que parasitan y los agentes que retroalimentan. Según la documentación oficial de rastreadores web de OpenAI, publicada en 2023, bloquear el agente GPTBot indica que tu contenido no debe usarse para entrenar sus modelos.
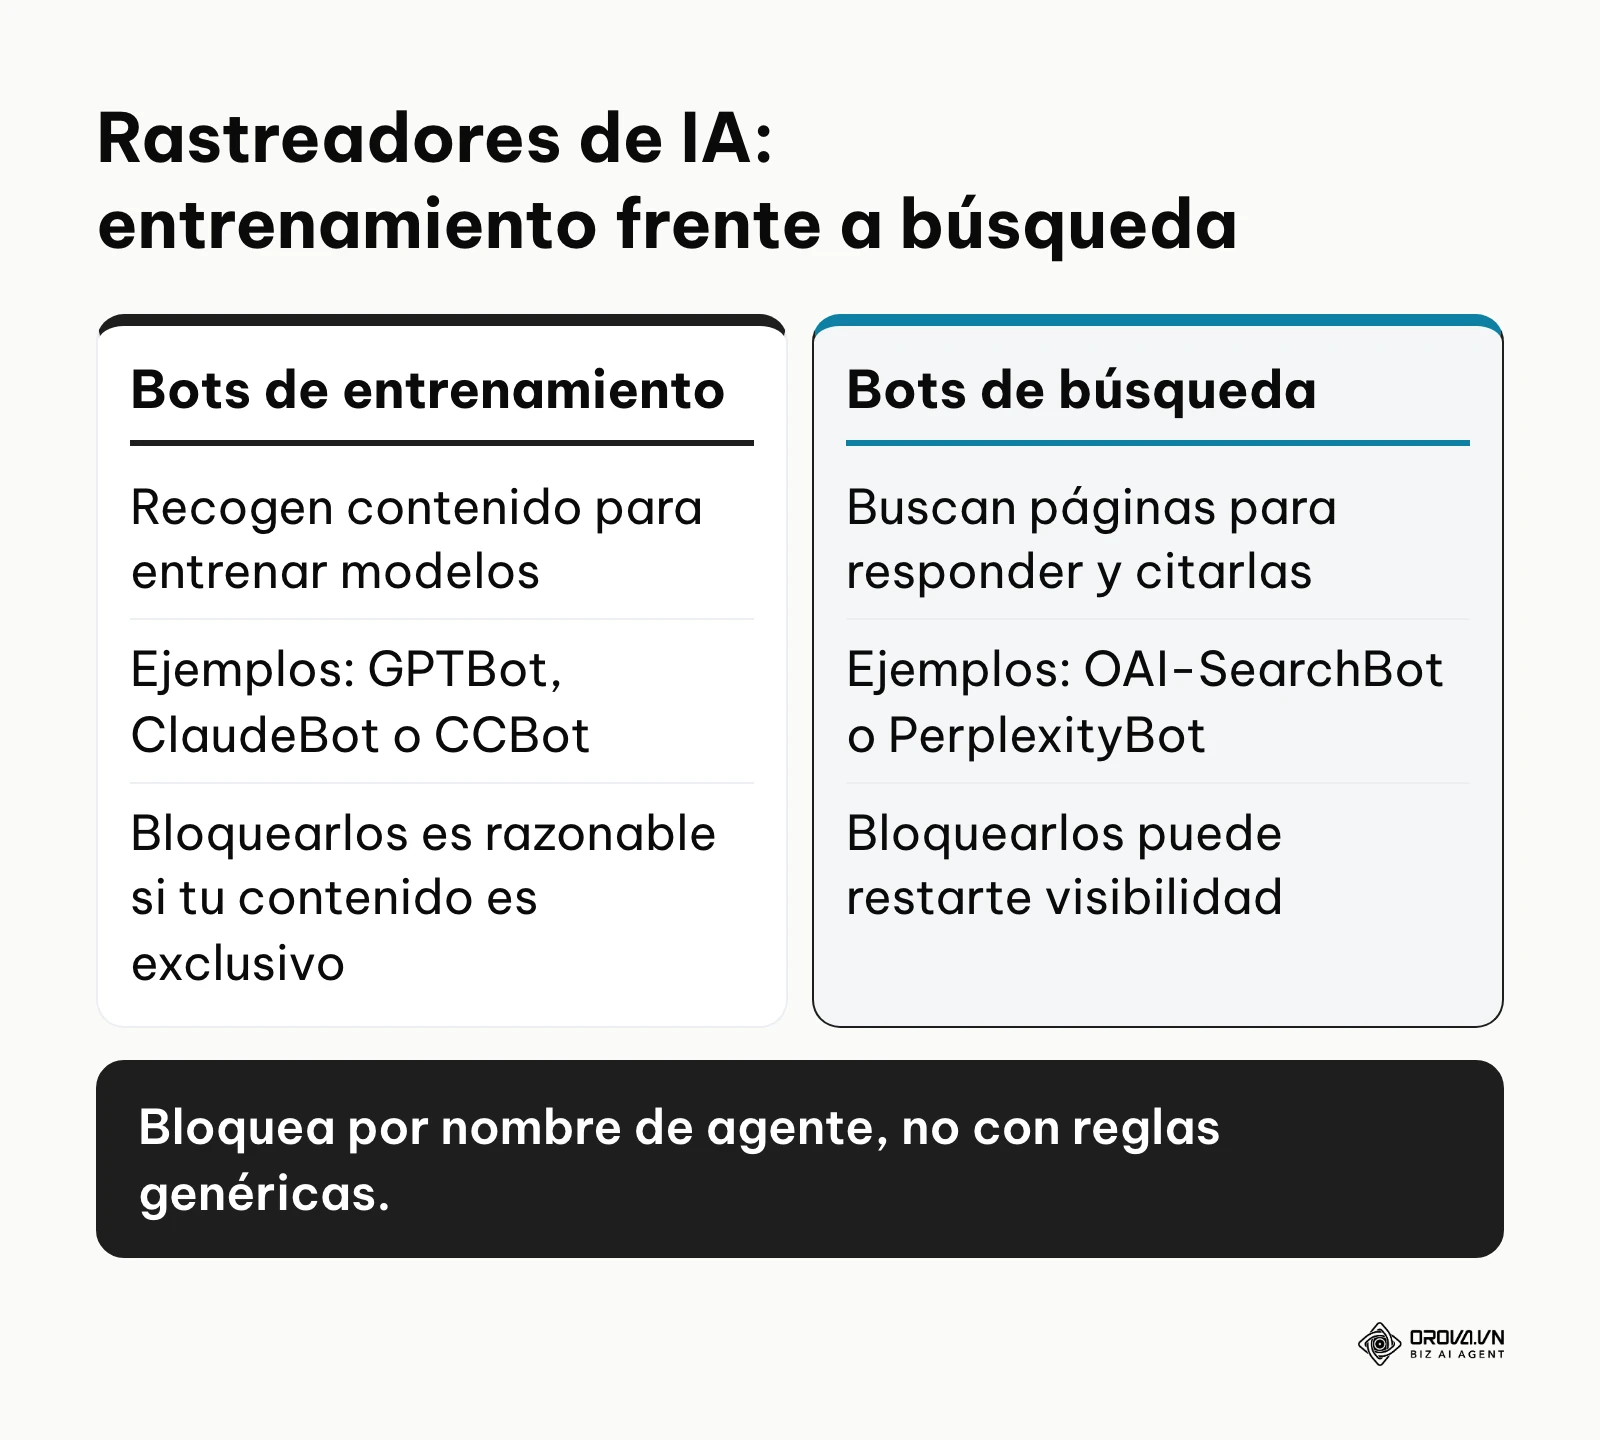
Por un lado, tenemos a los agentes extractores de datos para entrenamiento en masa (ejemplificados por programas como GPTBot, ClaudeBot y el ubicuo explorador histórico CCBot). Recogen grandes volúmenes de contenido para entrenar modelos y apenas devuelven visitas. Si tu contenido es exclusivo, bloquearlos es una decisión razonable.
Por otro lado, se posicionan fuertemente los programas de recuperación, búsqueda interactiva y citas en tiempo real (tales como OAI-SearchBot, Claude-SearchBot o el emergente motor PerplexityBot). Estos agentes buscan páginas para responder a un usuario y suelen citar la fuente con un enlace. Si los bloqueas, tu sitio puede dejar de aparecer en esas respuestas. Por eso conviene bloquear por nombre de agente, no con reglas genéricas:
User-agent: GPTBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: *
Disallow: /wp-admin/
Recuerda que robots.txt es una petición: los rastreadores que no respetan el protocolo pueden ignorarla.
Con OROVA.VN y el módulo OROVA SEO, pones fin definitivamente a las jornadas agotadoras de trabajo manual. En lugar de batallar durante horas para redactar artículos y elaborar informes, todo el proceso queda ahora optimizado y completado en tan solo 5 minutos.
Qué hacer para empezar y adaptar tu sitio
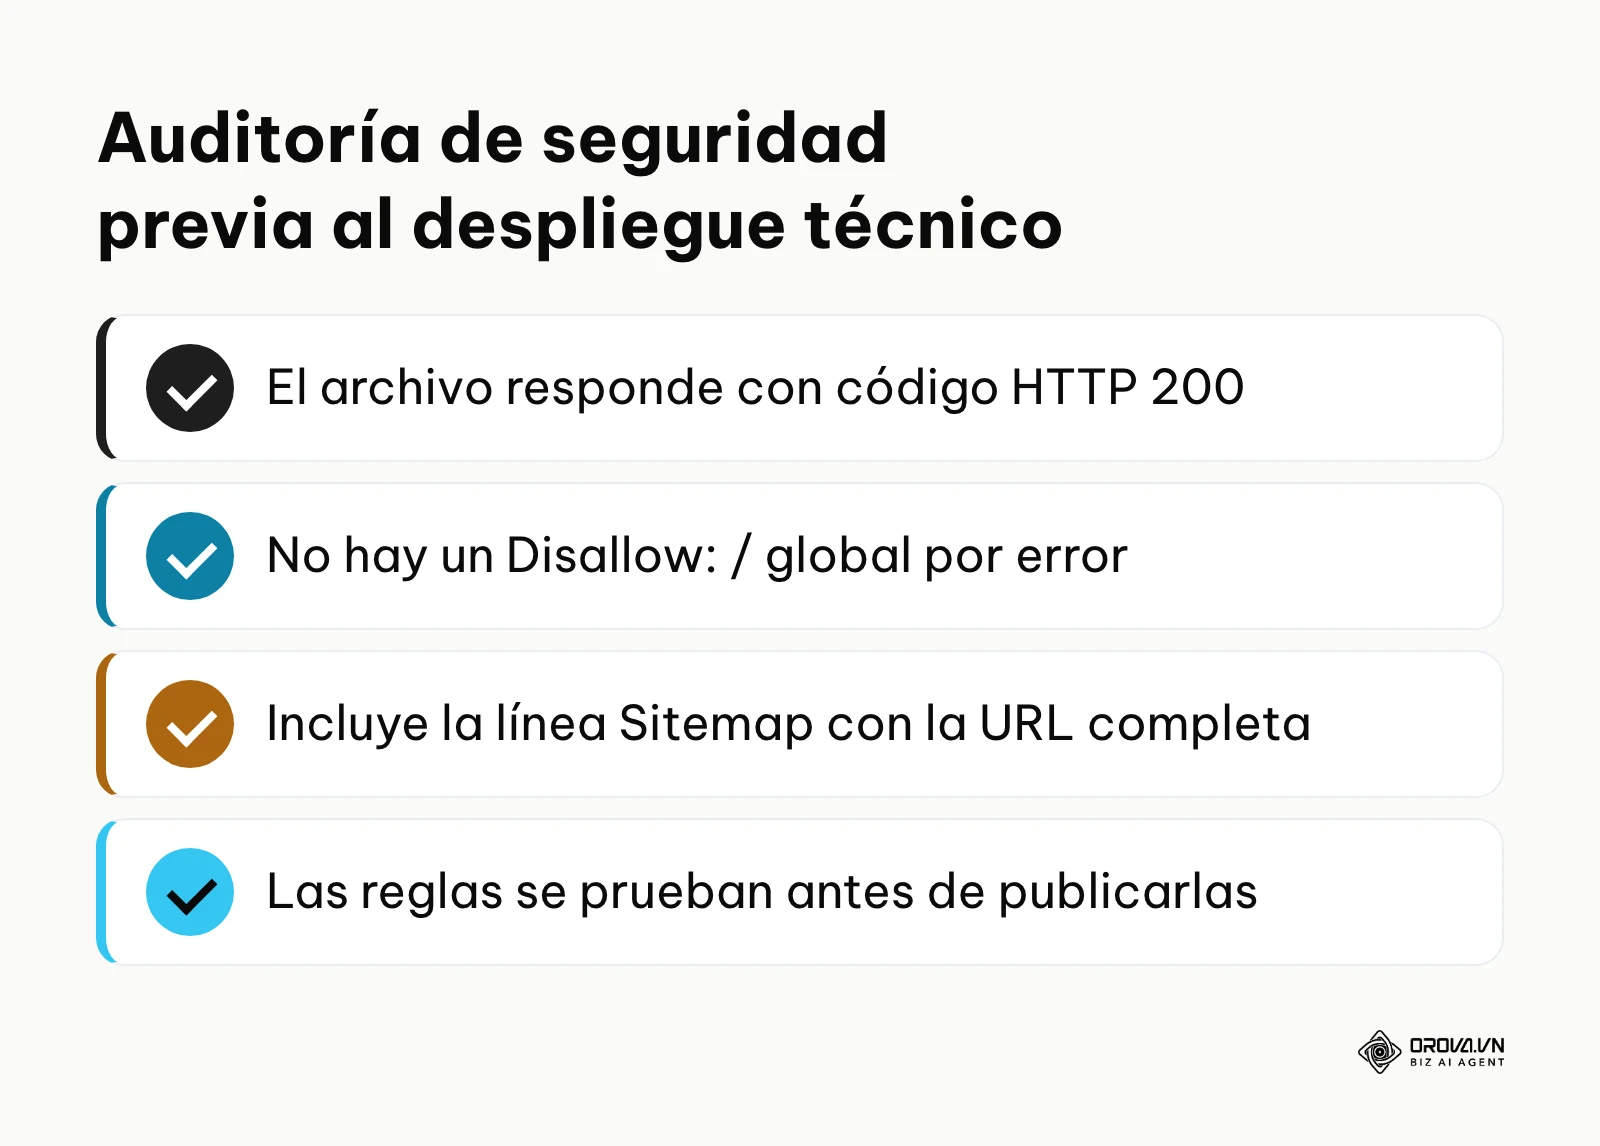
Para adaptar tu sitio con éxito, el primer paso universal es auditar el estado actual de tus permisos antes de inyectar reglas destructivas no verificadas. Esta revisión técnica exige un enfoque muy pragmático, ajustado al nivel operativo de tu infraestructura y tus capacidades organizativas diarias, con tareas asumibles en ventanas de tiempo reales.
Dueños de negocios e iniciativas pequeñas
Si gestionas tu propio sitio en Shopify o WordPress, normalmente no necesitas reglas complejas.
- Confirma la existencia visible añadiendo /robots.txt tras tu nombre de dominio comercial primario, comprobando visualmente que existe un documento allí.
- Si tienes un proveedor SaaS gestionado como plataforma e-commerce en la nube, delega toda la configuración; sus sistemas incluyen reglas estándar robustas y validadas globalmente.
- Comprueba que el archivo incluye una línea Sitemap: con la URL completa de tu mapa del sitio.
Especialistas de optimización y equipos internos
Los estrategas técnicos internos operan con una responsabilidad mucho mayor, debiendo garantizar la fluidez en ecosistemas que albergan cientos o miles de páginas dinámicas, frecuentemente en constante riesgo de saturación paramétrica.
- Revisa en Search Console el informe de robots.txt y el de indexación de páginas para ver qué URL aparecen como "Bloqueada por robots.txt".
- Identifica proactivamente las cadenas de filtrado en tus comercios electrónicos que generen duplicación de contenido perjudicial sin valor, apuntándolas para su posterior bloqueo estructurado.
- Antes de bloquear nada, confirma que esas URL no reciben tráfico orgánico útil; robots.txt es solo una pieza del posicionamiento SEO y una regla mal pensada puede restar visibilidad.
- Evalúa con rigor qué agentes extractores del mercado de inteligencia artificial deseas frenar según la licencia de contenido que maneja legalmente tu marca periodística o formativa.
Consultores independientes y agencias técnicas externas
Quienes heredan infraestructuras rotas o plataformas migratorias deben asumir una postura de arquitectura correctiva agresiva, lidiando con fallos preexistentes muy profundos y con la enorme inercia de equipos de tecnología tradicionalistas.
- Extrae y audita inmediatamente los registros (log files) pesados de acceso en crudo a nivel de servidor base (Apache o Nginx) para ver qué agentes consumen más peticiones y en qué rutas.
- Prueba las reglas nuevas en un entorno de pruebas antes de publicarlas. Robots.txt no admite expresiones regulares, solo los comodines * y $.
- Elimina bloqueos heredados que impidan rastrear las secciones nuevas que publicas según tu calendario de contenidos.
- Desarrolla flujos formales documentados para las secuencias de migración, garantizando por contrato que jamás ocurra el sangrado del entorno privado de pruebas hacia el entorno en vivo productivo en el día del lanzamiento comercial.
Ejemplo ilustrativo: Una agencia técnica especializada asumió repentinamente el control operacional y de diagnóstico de un gigantesco portal de compra y venta de piezas de motocicletas. Los consultores externos detectaron de inmediato, a través de los datos de tráfico, que el portal comercial estaba perdiendo cuota de mercado brutalmente porque el gigantesco entorno de pruebas (que generaba enlaces basura) seguía siendo rastreado de forma paralela por Google, creando canibalización estructural grave. Como primer paso, protegieron el entorno de pruebas con usuario y contraseña y, por separado, aplicaron reglas de limpieza de filtros inútiles en la infraestructura comercial en vivo. En el medio del proceso, enfrentaron resistencia técnica de los desarrolladores reacios a liberar los permisos de sistema; sin embargo, tras convencerlos y desplegar los cambios correctos, las URL duplicadas del entorno de pruebas dejaron de aparecer poco a poco en los informes de Search Console.
Para asegurar un enfoque pragmático frente a las inevitables fricciones operativas que describimos, resulta sumamente útil esquematizar los descuidos prevalentes y cómo contrarrestarlos efectivamente en entornos altamente tensionados.
| Desliz táctico frecuente en la industria | Consecuencia estructural esperada | Estrategia preventiva y correctiva segura |
|---|---|---|
| Confundir exclusión con no indexación. | La URL no se rastrea, pero puede seguir apareciendo en resultados sin descripción. | Usar noindex y dejar la página rastreable, porque si está bloqueada Google no puede leer esa etiqueta. |
| Negar permisos a los recursos de diseño visual móvil (Javascript y Hojas de estilo CSS). | Google no puede renderizar bien la página y puede interpretar mal su versión móvil. | Comprobar con la inspección de URLs de Search Console cómo se ve la página antes y después del cambio. |
| Emplear directivas de exclusión de rastreo como rudimentaria medida de ciberseguridad para proteger entornos ocultos. | El archivo es público y revela qué rutas quieres ocultar. | Proteger las zonas privadas con usuario y contraseña. |
El futuro del rastreo web: mis predicciones (2026-2028)
El robots.txt nació para un internet con pocos rastreadores. Hoy convive con buscadores, asistentes de IA y extractores de datos, y la presión legal sobre el uso de contenidos para entrenar modelos va en aumento. Estas son mis opiniones sobre hacia dónde puede ir, no certezas.
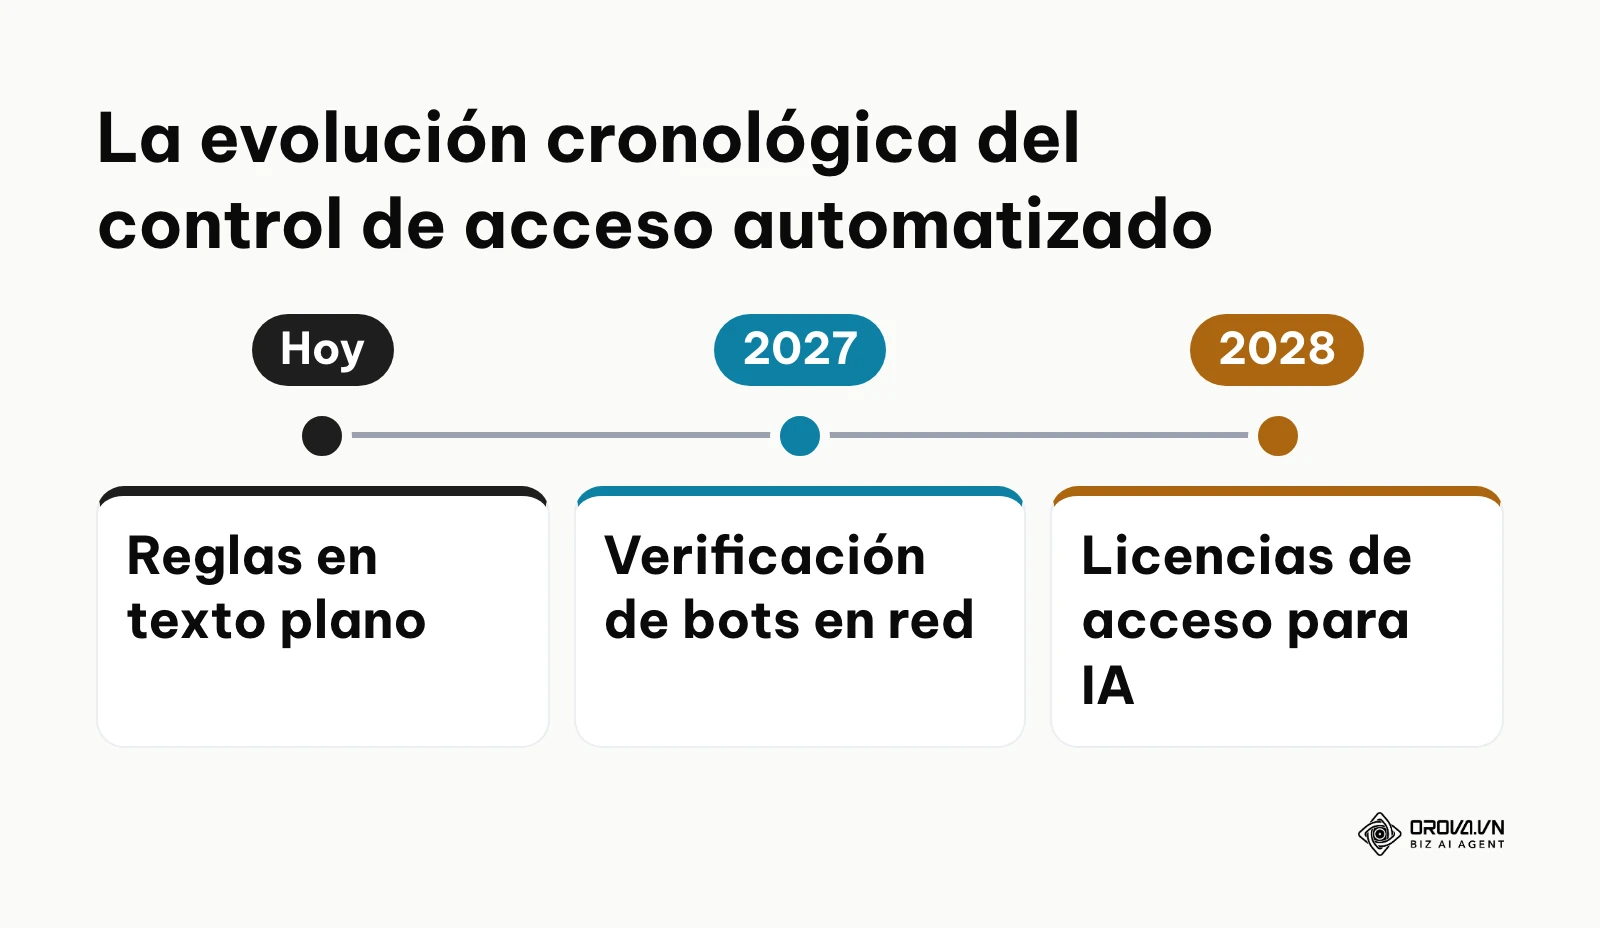
La línea de tiempo resume la evolución que, en mi opinión, es probable.
Transición agresiva hacia reglas y verificaciones en el borde
Creo que el archivo de texto seguirá existiendo, pero perderá protagonismo frente a reglas aplicadas en la red de distribución de contenidos y en los cortafuegos, donde se puede verificar si un bot es quien dice ser antes de servirle la página. Para muchos administradores, gestionar bots pasará a ser una configuración en el panel de seguridad más que unas líneas en un archivo. Puedo equivocarme si la industria decide que el coste de verificar agentes no compensa.
La irrupción de las micro licencias de acceso automatizado en tiempo real
Me parece probable que aparezcan más acuerdos para que los rastreadores de IA paguen por acceder a ciertos contenidos, en lugar del simple permitir o bloquear. Si ocurre, los editores tendrán una opción intermedia entre regalar su contenido y cerrarlo por completo.
Imposición rígida de micro presupuestos focalizados
Pienso que los equipos técnicos repartirán el rastreo de forma más consciente: prioridad para las páginas que generan negocio y menos acceso para secciones secundarias o archivos antiguos. El robots.txt seguirá siendo una de las herramientas para hacer ese reparto.
Preguntas frecuentes sobre robots txt
¿El archivo robots txt es jurídicamente obligatorio para tener éxito comercial?
No. Ninguna ley ni buscador exige tenerlo. Si no existe, Google entiende que puede rastrear todo el sitio. Aun así, conviene crearlo en cuanto el sitio tenga búsqueda interna, filtros o zonas de administración.
¿Realmente puedo asegurar información íntima y secreta prohibiendo accesos aquí?
No. El archivo es público y solo lo respetan los rastreadores que siguen el protocolo. Además, al listar rutas privadas le indicas a cualquiera dónde mirar. Protege esa información con usuario y contraseña.
¿Resulta verdaderamente forzoso o requerido especificar múltiples mapas en el interior de estas reglas?
No es obligatorio, pero sí recomendable. Puedes declarar uno o varios mapas del sitio con líneas Sitemap: usando la URL completa. Si ya los envías desde Search Console, la línea en robots.txt sirve como respaldo para otros buscadores.
¿El archivo robots txt tiene aún alguna utilidad estratégica existiendo la inteligencia artificial?
Sí. Es la forma estándar de indicar a los rastreadores de IA que respetan el protocolo si pueden usar tu contenido, y te permite tratar de forma distinta a los bots de entrenamiento y a los de búsqueda.
¿Cuánto plazo transcurre exactamente antes de que los algoritmos asuman mis rigurosas restricciones de bloqueo general?
Google suele guardar en caché el robots.txt hasta 24 horas, así que los cambios no se aplican al instante. Si necesitas que lo lea antes, puedes solicitar un nuevo rastreo desde el informe de robots.txt de Search Console.
¿Por dónde empezar hoy?
Abre tudominio.com/robots.txt en el navegador y mira qué hay.
Si el archivo no existe, crea uno sencillo: User-agent: *, una línea Disallow: vacía y la línea Sitemap: con la URL completa de tu mapa del sitio. Es un punto de partida que no bloquea nada.
Si el archivo existe pero acumula reglas antiguas, revísalas una por una: elimina las que bloquean rutas que ya no existen o recursos como CSS y JavaScript, comprueba en el informe de robots.txt de Search Console que Google lo lee sin errores y decide, agente por agente, qué rastreadores de IA quieres permitir.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Gestiona tu negocio con AI Agents
Orova es el Biz AI Agent que nunca para: planifica, ejecuta y optimiza el trabajo por ti.
Gana tiempo y multiplica tu productividad.