
Analyse réseaux : le guide pratique 2026 (IT et social) + checklist
Imaginez piloter un avion de ligne les yeux bandés, en vous fiant uniquement au bruit des moteurs pour savoir si vous volez à la bonne altitude. C'est exactement ce que font de nombreuses entreprises lorsqu'elles gèrent leurs infrastructures technologiques ou lancent des campagnes de communication sans mettre en place une véritable analyse réseaux. Face à un ralentissement soudain d'un serveur critique, ou devant une publication sociale qui ne génère aucune interaction, la réaction instinctive consiste souvent à deviner. On redémarre les machines, on change l'heure de publication, ou on augmente précipitamment le budget. Pourtant, cette approche à l'aveugle est coûteuse et inefficace.
Ce dont vous avez besoin, ce n'est pas d'accumuler aveuglément des pétaoctets de données brutes, mais d'une méthodologie rigoureuse pour les trier, les examiner et les interpréter. Que vous tentiez de fluidifier des flux TCP/IP dans un centre de données ou d'optimiser l'engagement de votre marque sur LinkedIn et TikTok, les fondamentaux restent les mêmes : il faut rendre l'invisible visible.
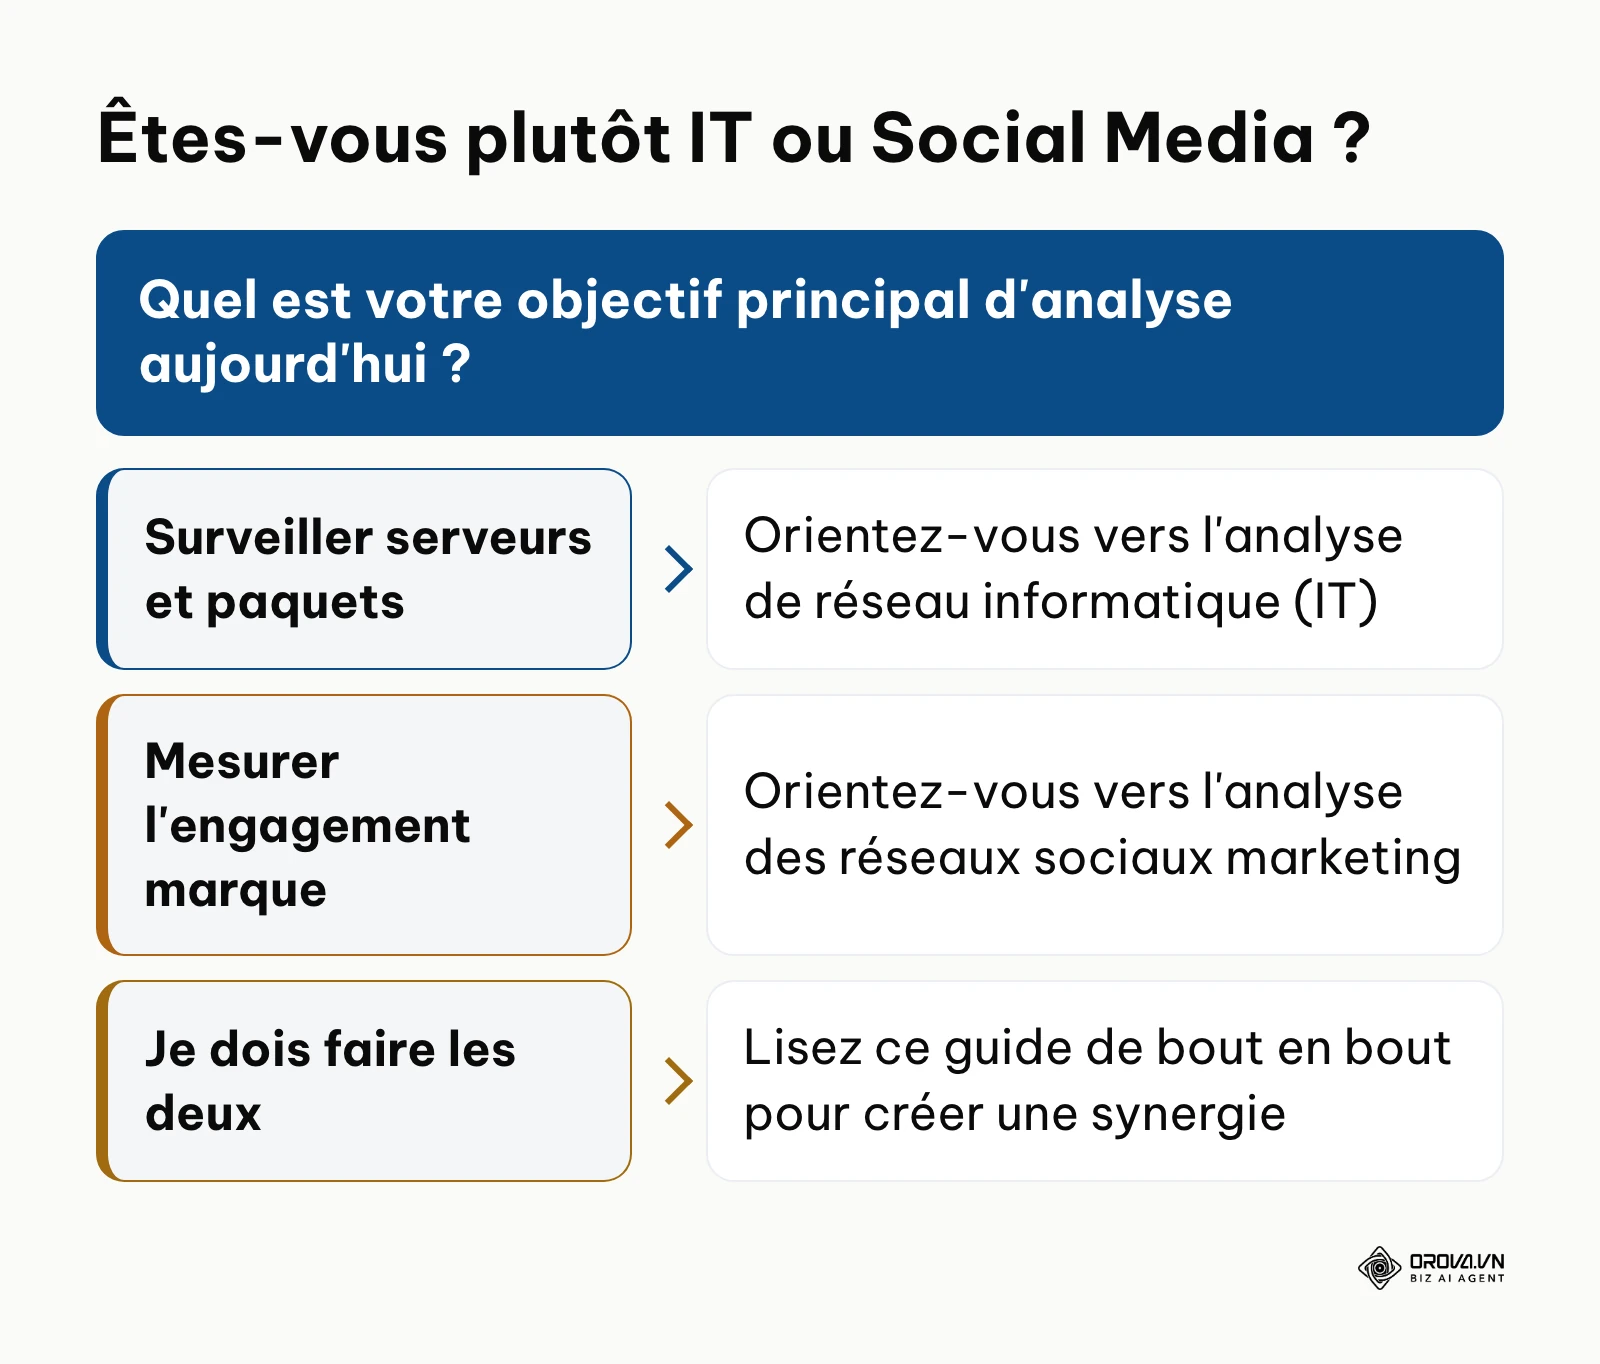
Tableau d'orientation : Quel est votre contexte aujourd'hui ? L'expression "analyse réseaux" est fondamentalement ambiguë en français. Pour vous faire gagner du temps, voici comment lire ce guide :
- Si vous êtes un professionnel de l'IT / Administrateur Système : Vous cherchez des outils d'analyse de réseau informatique. Votre objectif est de surveiller la bande passante, d'analyser les paquets (packet sniffing), de prévenir les pannes matérielles et de sécuriser vos firewalls. Lisez ce guide avec le prisme "Infrastructures IT".
- Si vous êtes un professionnel du Marketing / Social Media Manager : Vous visez l'analyse des réseaux sociaux marketing. Votre but est de décortiquer les algorithmes de portée, de mesurer l'engagement, d'auditer l'e-réputation et de justifier le retour sur investissement de vos contenus. Lisez ce guide avec le prisme "Réseaux Sociaux".
Ce guide profond fusionne l'exigence technique des systèmes d'information avec la finesse d'analyse du marketing digital pour vous offrir une méthode universelle en 2026.
Analyse réseaux : Qu'est-ce que c'est et pour qui ?
L'analyse réseaux est le processus systématique de capture, d'inspection et d'interprétation des données transitant par un environnement interconnecté (qu'il soit matériel ou social) dans le but d'optimiser ses performances, de détecter des anomalies et de guider les décisions stratégiques. Elle s'adresse en priorité aux directeurs informatiques, aux ingénieurs réseau, ainsi qu'aux stratèges marketing et responsables de communication qui gèrent des écosystèmes complexes. En revanche, si vous gérez un blog personnel sans ambition de monétisation ou un réseau local domestique de trois ordinateurs, déployer une usine à gaz analytique est une perte de temps.
La confusion règne souvent entre "Supervision" (Monitoring) et "Analyse" (Analysis). La supervision réseau vous dit : "Le serveur est tombé en panne à 14h" ou "Cette publication a fait un flop". C'est un simple constat d'état. L'analyse réseau, elle, répond à la question du pourquoi et du comment : "Le serveur est tombé en panne parce qu'une attaque DDoS a saturé le port 443 en exploitant une vulnérabilité BGP", ou "La publication a échoué parce que le taux de rétention de la vidéo a chuté drastiquement après les trois premières secondes auprès de l'audience mobile". L'analyse implique une investigation profonde, la corrélation de multiples sources de données et l'extraction de modèles comportementaux.
Chaque heure d'indisponibilité d'un service critique coûte cher, ce qui souligne l'importance de passer d'une simple supervision réactive à une véritable analyse prédictive.
Prérequis pour une analyse réseaux efficace
Avant de foncer tête baissée dans le déploiement d'une solution logicielle hors de prix, il est impératif de préparer le terrain. Le succès de votre démarche dépend de la qualité de vos fondations. Beaucoup d'entreprises achètent des licences logicielles complexes pour finalement ne consulter qu'un seul tableau de bord basique, gaspillant ainsi des milliers d'euros.
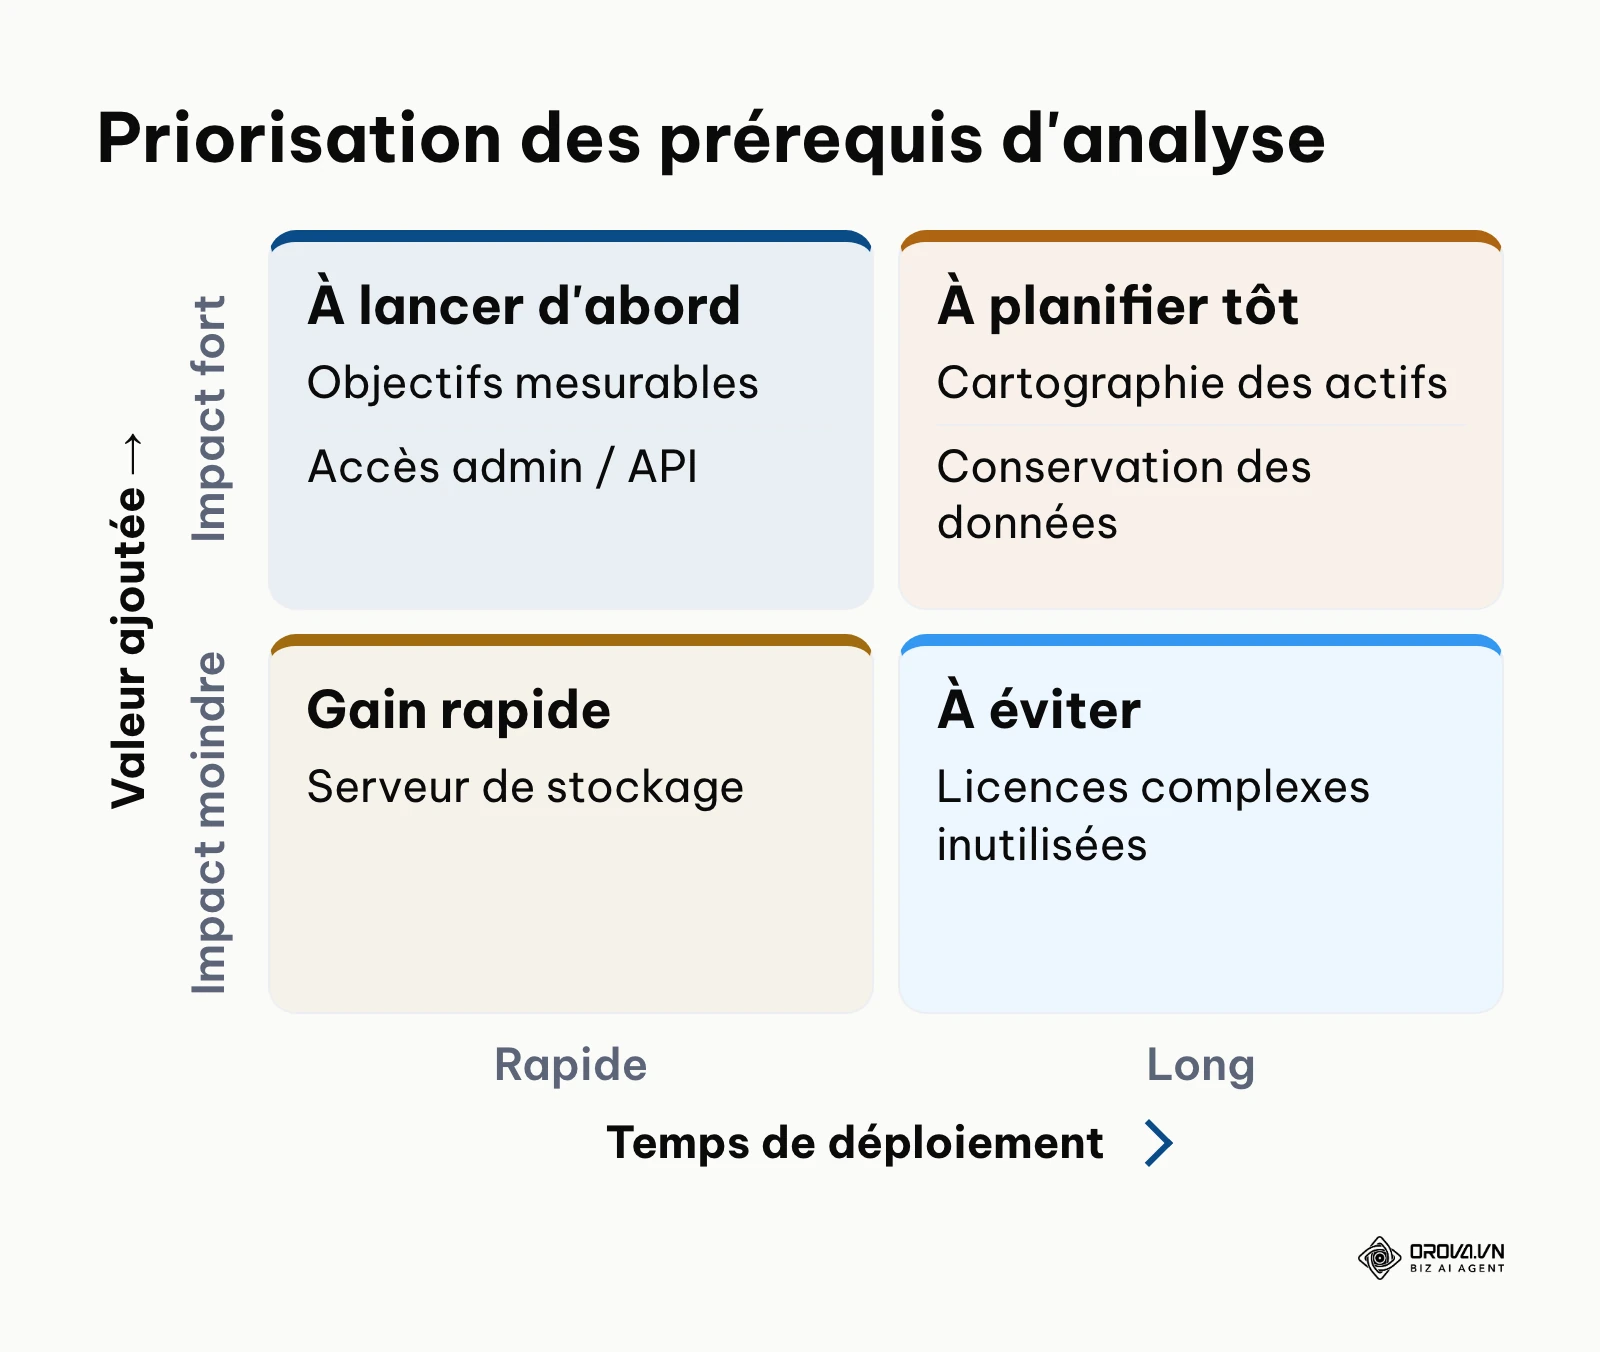
Voici ce que vous devez absolument réunir avant de commencer :
| Ce qu'il faut préparer | Où / Comment l'obtenir | Temps estimé pour la mise en place |
|---|---|---|
| Objectifs mesurables (Business Goals) | Réunions avec la direction. Que cherche-t-on à résoudre ? (Ex: Réduire le temps de latence de 20%, ou augmenter le taux de conversion social de 2 points). | 2 à 4 jours |
| Cartographie des actifs (Asset Inventory) | Export via votre CMDB (pour l'IT) ou l'inventaire de vos comptes officiels, pages et groupes (pour le Social). | 1 à 2 semaines |
| Accès administrateur / Tokens API | Demande formelle au service sécurité IT ou récupération des identifiants API (OAuth) des plateformes Meta, LinkedIn, etc. | 3 à 5 jours |
| Serveur de stockage (Data Lake / Log Server) | Location d'une instance Cloud (AWS S3, Google Cloud Storage) ou serveur NAS local dédié pour archiver l'historique sans saturer le système principal. | 2 à 5 jours |
| Politique de conservation des données | Consultation avec le service juridique (conformité RGPD, durée de rétention des logs techniques ou des données personnelles des utilisateurs sociaux). | 1 à 3 semaines |
Si vous brûlez ces étapes préparatoires, votre projet d'analyse se transformera rapidement en un marécage de données inexploitables. Sans objectif mesurable, vous ne saurez jamais quels filtres appliquer. Sans accès administrateur centralisés, vous aurez des angles morts massifs dans votre architecture.
Étapes pour réaliser une analyse de réseaux (IT et Social)
Voici le cœur du réacteur : un processus itératif, implacable et structuré, pensé pour savoir comment faire une analyse de réseau de manière professionnelle. Bien que les outils diffèrent, la logique d'investigation reste rigoureusement identique entre le monde des routeurs Cisco et celui des algorithmes de TikTok.
Étape 1 : Cartographier l'existant et définir le périmètre
La toute première action consiste à dessiner les frontières de ce que vous allez analyser. Vous ne pouvez pas optimiser ce que vous ne voyez pas.
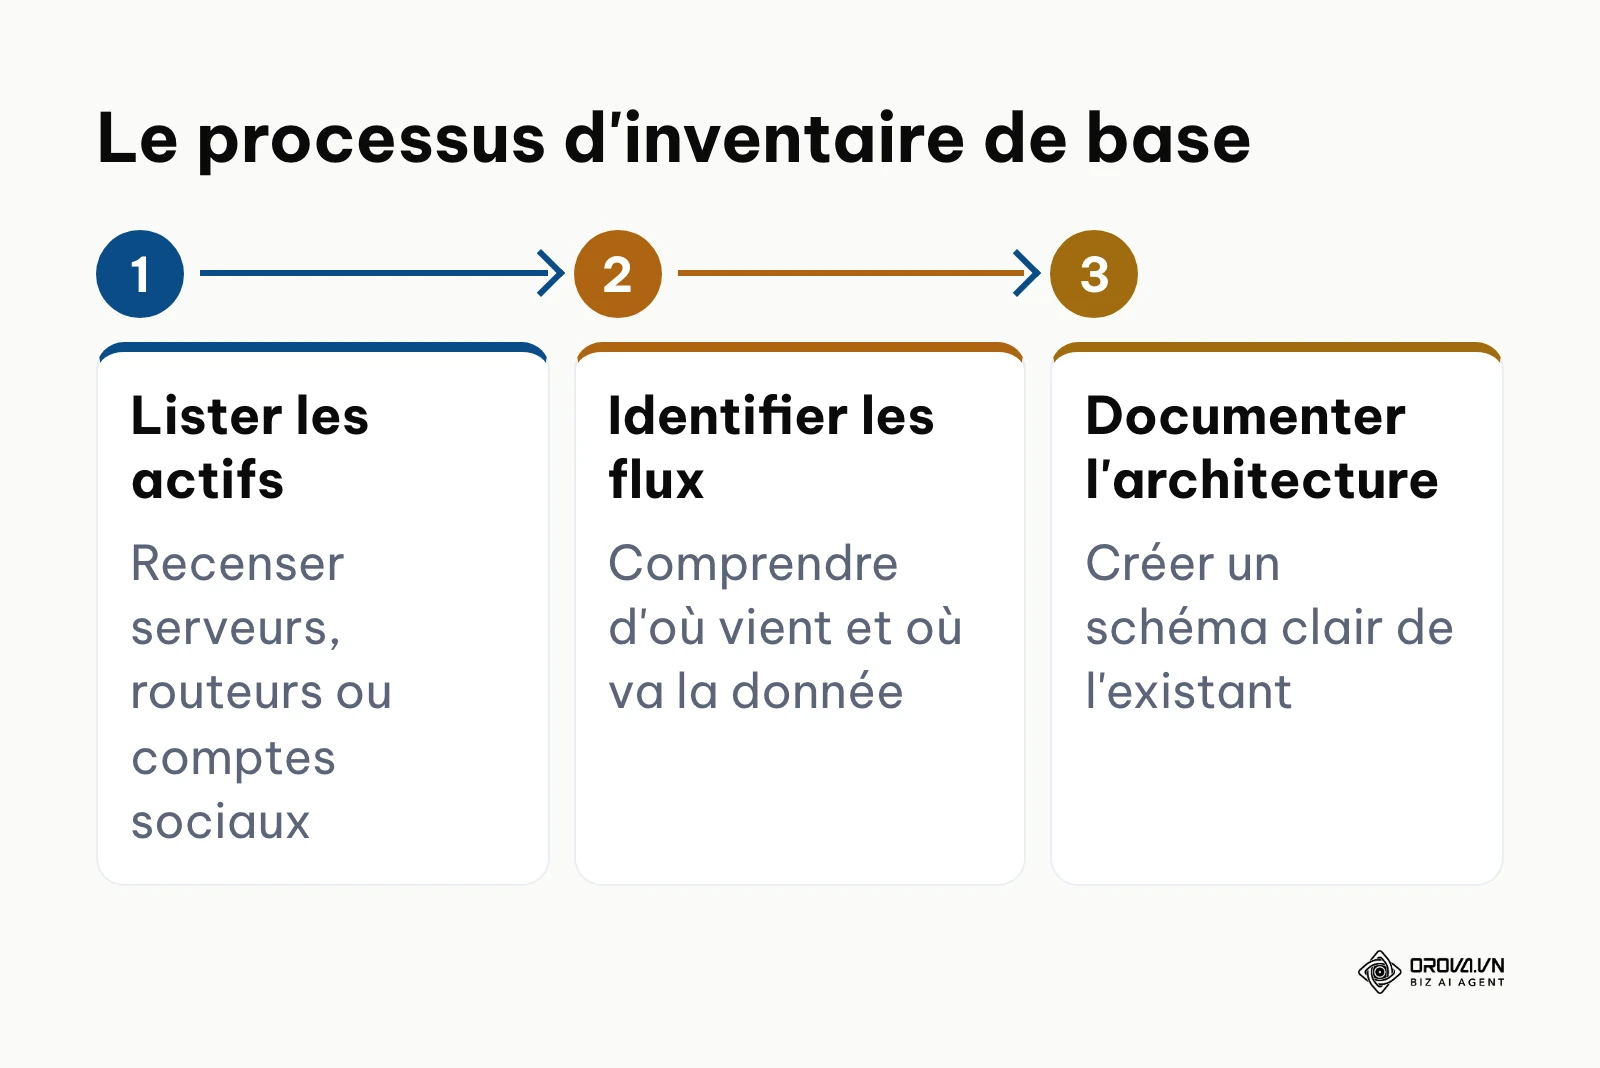
- Ce qu'il faut faire : Dresser un inventaire exhaustif des nœuds de votre réseau.
- Comment faire (IT) : Utilisez un outil de découverte automatique de topologie (comme Nmap ou les modules de SolarWinds) pour scanner vos plages IP. Identifiez les routeurs, les pare-feux, les commutateurs centraux et les serveurs critiques.
- Comment faire (Social) : Listez toutes vos présences en ligne actives, fantômes ou non officielles. Identifiez les "hubs" (pages principales) et les "spokes" (groupes communautaires, comptes de support client).
- Le signe de réussite : Vous possédez un schéma visuel complet (diagramme de topologie) mis à jour, validé par l'ensemble de l'équipe.
- L'erreur classique : Oublier les environnements de "Shadow IT" (serveurs non déclarés montés par des développeurs en urgence) ou les vieux comptes Twitter créés en 2014 dont personne n'a le mot de passe, mais qui nuisent à la marque.
Étape 2 : Déployer les sondes et collecter les données brutes
Une fois le périmètre figé, il faut capter le flux sanguin de votre écosystème. C'est l'étape de la collecte, qui doit être la plus granulaire possible sans pour autant écrouler les performances du système observé.
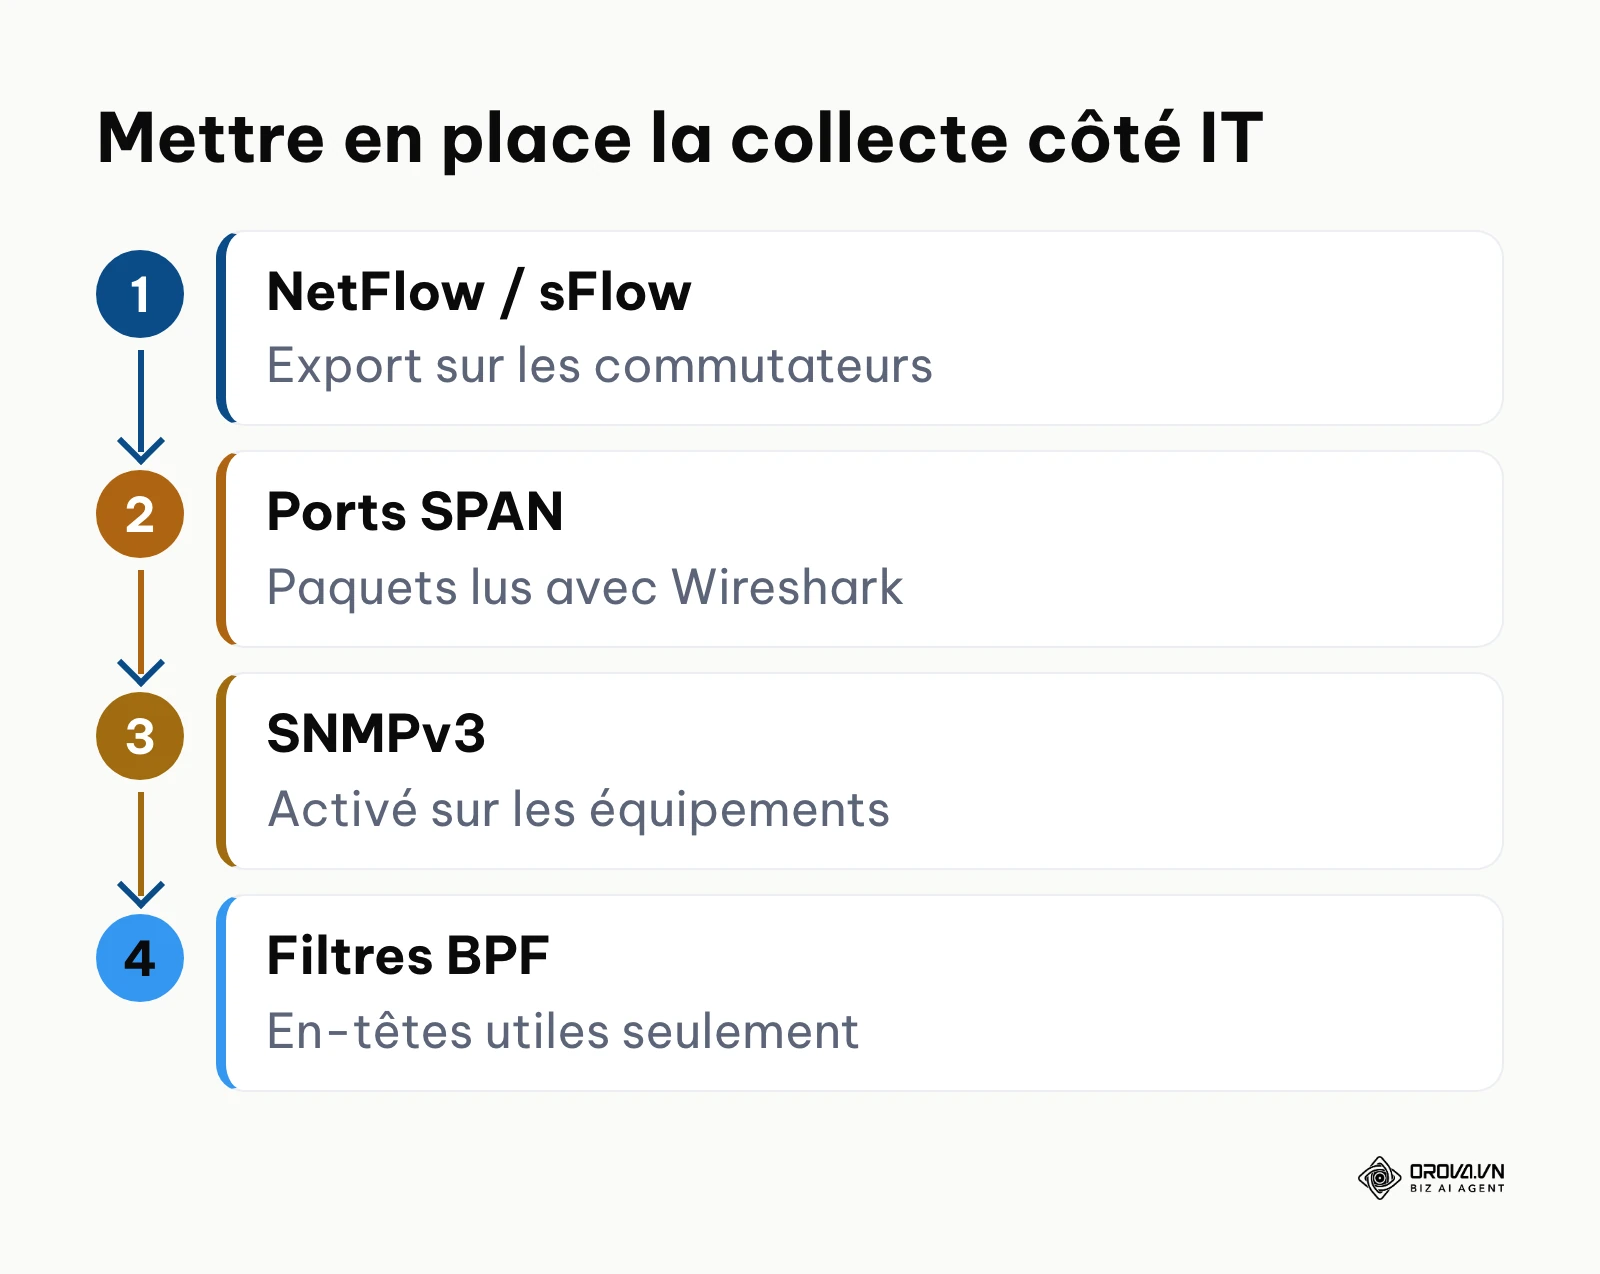
- Ce qu'il faut faire : Installer les mécanismes de capture d'informations.
- Comment faire (IT) : Configurez l'exportation NetFlow/sFlow sur vos commutateurs principaux. Branchez des sondes de capture de paquets (SPAN ports) pour une analyse DPI (Deep Packet Inspection) avec Wireshark sur les goulots d'étranglement stratégiques. Activez le protocole SNMPv3 sur vos équipements matériels.
- Comment faire (Social) : Connectez vos comptes à un outil de gestion centralisé via les API officielles. Configurez des pixels de suivi sur votre site web avec les balises UTM appropriées pour tracer le trafic en provenance des différents réseaux sociaux.
- Le signe de réussite : Les données commencent à affluer en continu vers votre serveur centralisé, sans augmentation notable de la latence de votre infrastructure.
Exemple illustratif :
- Contexte : Le responsable informatique d'une startup de 40 employés gérant une plateforme SaaS très sollicitée.
- Étapes réalisées : Il a déployé des sondes open-source, configuré le "port mirroring" sur le commutateur central, et activé la capture de tout le trafic entrant pour analyser des lenteurs mystérieuses.
- Obstacle et solution : La volumétrie de données était tellement énorme (plusieurs téraoctets par jour) que le serveur d'analyse a planté en moins de 24 heures, saturant le disque dur. Pour corriger le tir, il a implémenté des filtres stricts (BPF) pour ne capturer que les en-têtes TCP des requêtes vers la base de données, ignorant le trafic de sauvegarde interne.
- Résultat : Un flux de données stable de 5 Go par jour, permettant d'afficher un tableau de bord clair qui a immédiatement mis en évidence un problème de configuration DNS au niveau du pare-feu.
Étape 3 : Structurer la base de données et nettoyer les flux
La donnée brute est souvent polluée. Des paquets dupliqués dans le monde réseau, ou des interactions générées par des robots dans le monde social, viennent fausser toutes vos conclusions.
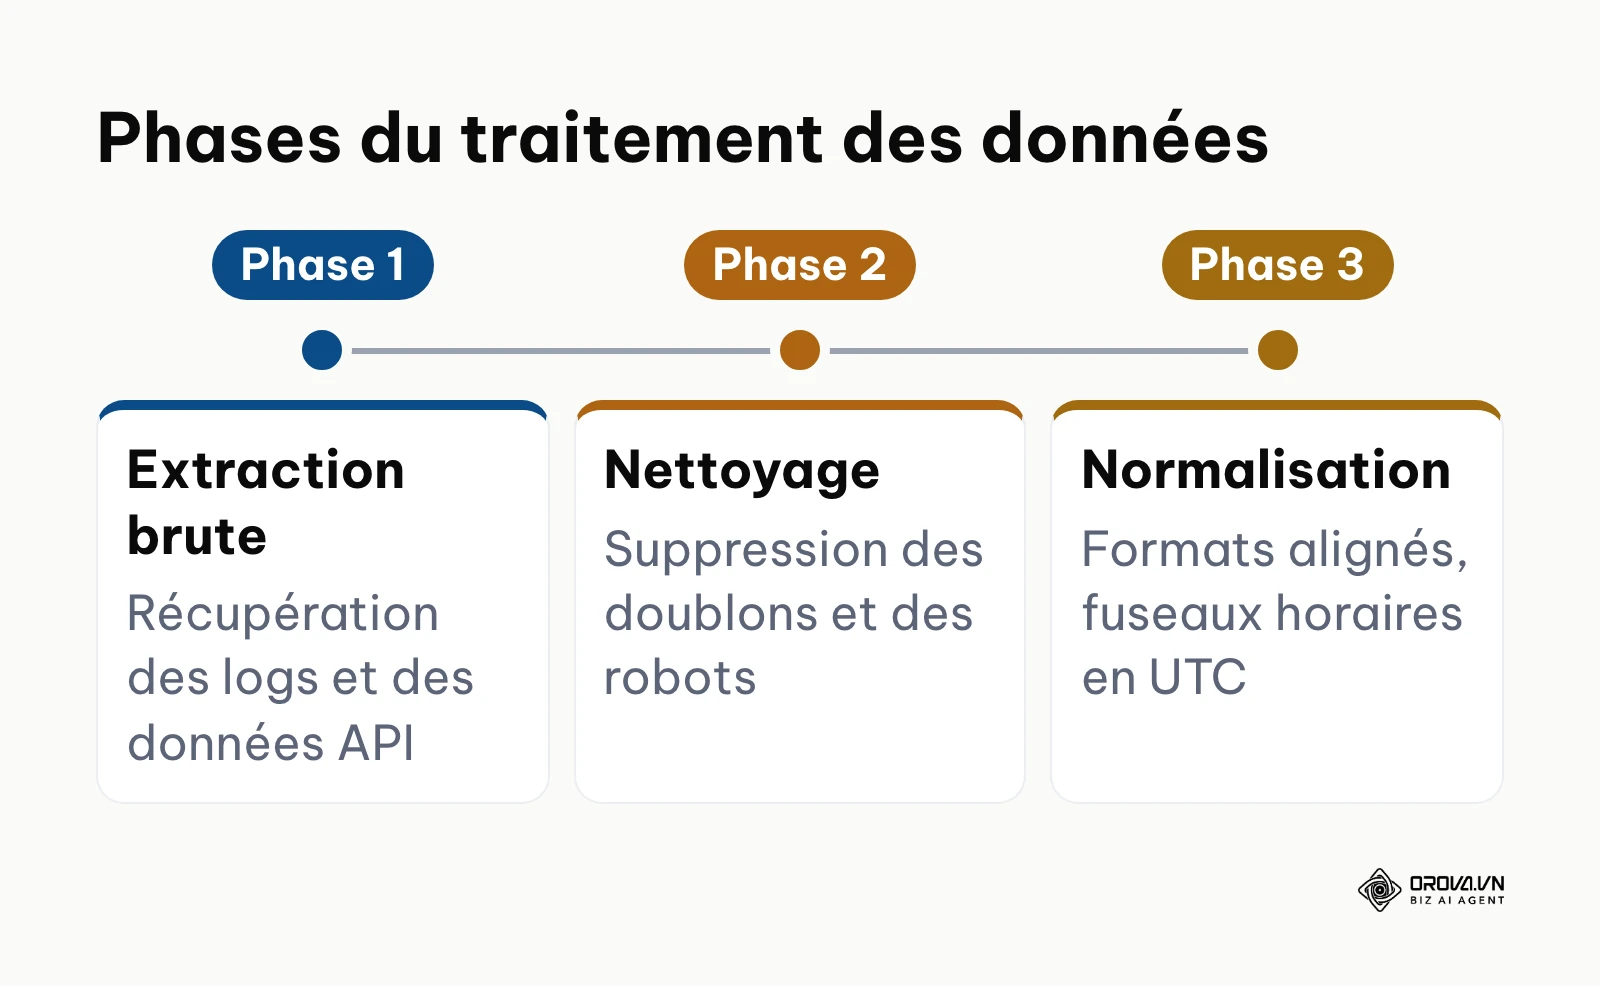
- Ce qu'il faut faire : Filtrer, normaliser et agréger les informations avant de les stocker.
- Comment faire (IT) : Utilisez un outil comme Logstash pour parser vos logs Syslog. Excluez les adresses IP internes connues de vos scanners de vulnérabilité récurrents pour ne pas fausser vos statistiques de trafic.
- Comment faire (Social) : Supprimez les vues de vos propres employés (via le filtrage IP). Identifiez et excluez les pics d'engagement manifestement artificiels causés par des fermes de clics. Alignez les fuseaux horaires de toutes vos plateformes sur une norme unique (UTC).
- Le signe de réussite : Vos requêtes SQL ou vos exports de données s'exécutent rapidement et ne renvoient plus de valeurs absurdes (comme des dates en 1970).
Étape 4 : Paramétrer les tableaux de bord (Dashboards) et les seuils d'alerte
Avoir des données propres est inutile si vous devez écrire des lignes de code à chaque fois que vous voulez connaître l'état de santé du système. La data visualisation est votre meilleur allié, et un tableau de bord marketing bien construit en est la vitrine côté social.
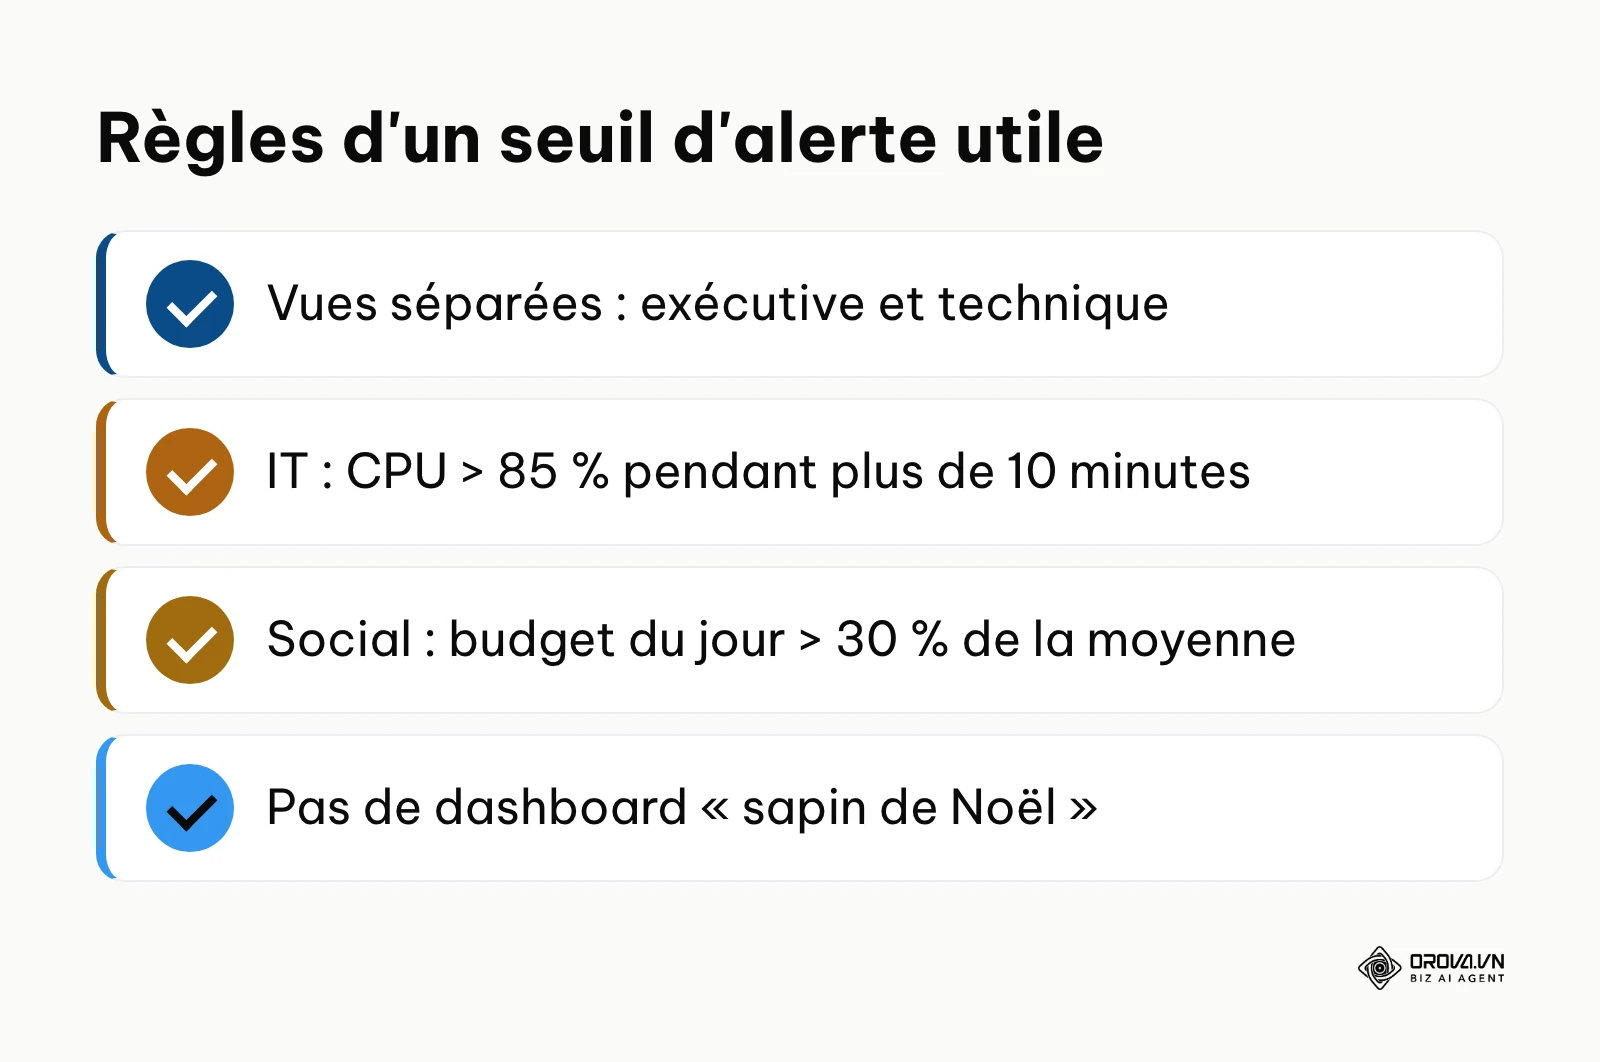
- Ce qu'il faut faire : Construire des vues personnalisées en fonction des rôles (Vue exécutive vs Vue technique) et définir quand le système doit crier "au feu".
- Comment faire (IT) : Dans Grafana ou Kibana, créez un graphique dédié à l'utilisation CPU des serveurs web. Configurez une alerte qui se déclenche uniquement si l'utilisation dépasse 85% pendant plus de 10 minutes consécutives.
- Comment faire (Social) : Montez un tableau de bord comparant le coût par acquisition (CPA) de Facebook avec celui de TikTok, actualisé chaque jour. Mettez en place une alerte e-mail si le budget publicitaire consommé sur une journée dépasse de 30% la moyenne habituelle.
- L'erreur classique : Construire des "dashboards sapins de Noël", surchargés de graphiques en 3D illisibles et de couleurs vives, qui masquent l'information essentielle au lieu de la révéler. Privilégiez toujours la simplicité.
Étape 5 : Croiser les données pour extraire des insights exploitables
C'est ici que s'opère la magie. La supervision s'arrête à l'étape 4. L'analyse réseau commence réellement ici, lorsque vous faites parler des sources de données disparates entre elles.
- Ce qu'il faut faire : Chercher des corrélations, des tendances cachées et des anomalies structurelles.
- Comment faire (IT) : Superposez la courbe du trafic réseau entrant avec la courbe du temps de réponse de la base de données MySQL. Vous découvrirez peut-être que ce n'est pas le volume de trafic qui ralentit le système, mais la nature spécifique de certaines requêtes de recherche lourdes à une heure précise.
- Comment faire (Social) : Croisez le taux d'engagement de vos vidéos LinkedIn avec le taux de conversion sur la page de destination (landing page). Vous pourriez réaliser qu'une vidéo très virale génère un trafic de faible qualité, tandis qu'un article de blog de niche très peu partagé génère 80% de vos contrats signés. Pour comprendre quelles métriques lier, la maîtrise des indicateurs de performance clés est indispensable.
- Le signe de réussite : Vous pouvez formuler des phrases commençant par "Nous avons découvert que lorsque [A] se produit, [B] en résulte, par conséquent nous devons faire [C]".
Étape 6 : Optimiser en continu et ajuster l'architecture
L'analyse réseaux n'est pas un projet avec une date de fin, c'est un cycle de vie. Le réseau évolue, les algorithmes sociaux mutent, vos concurrents changent de stratégie.
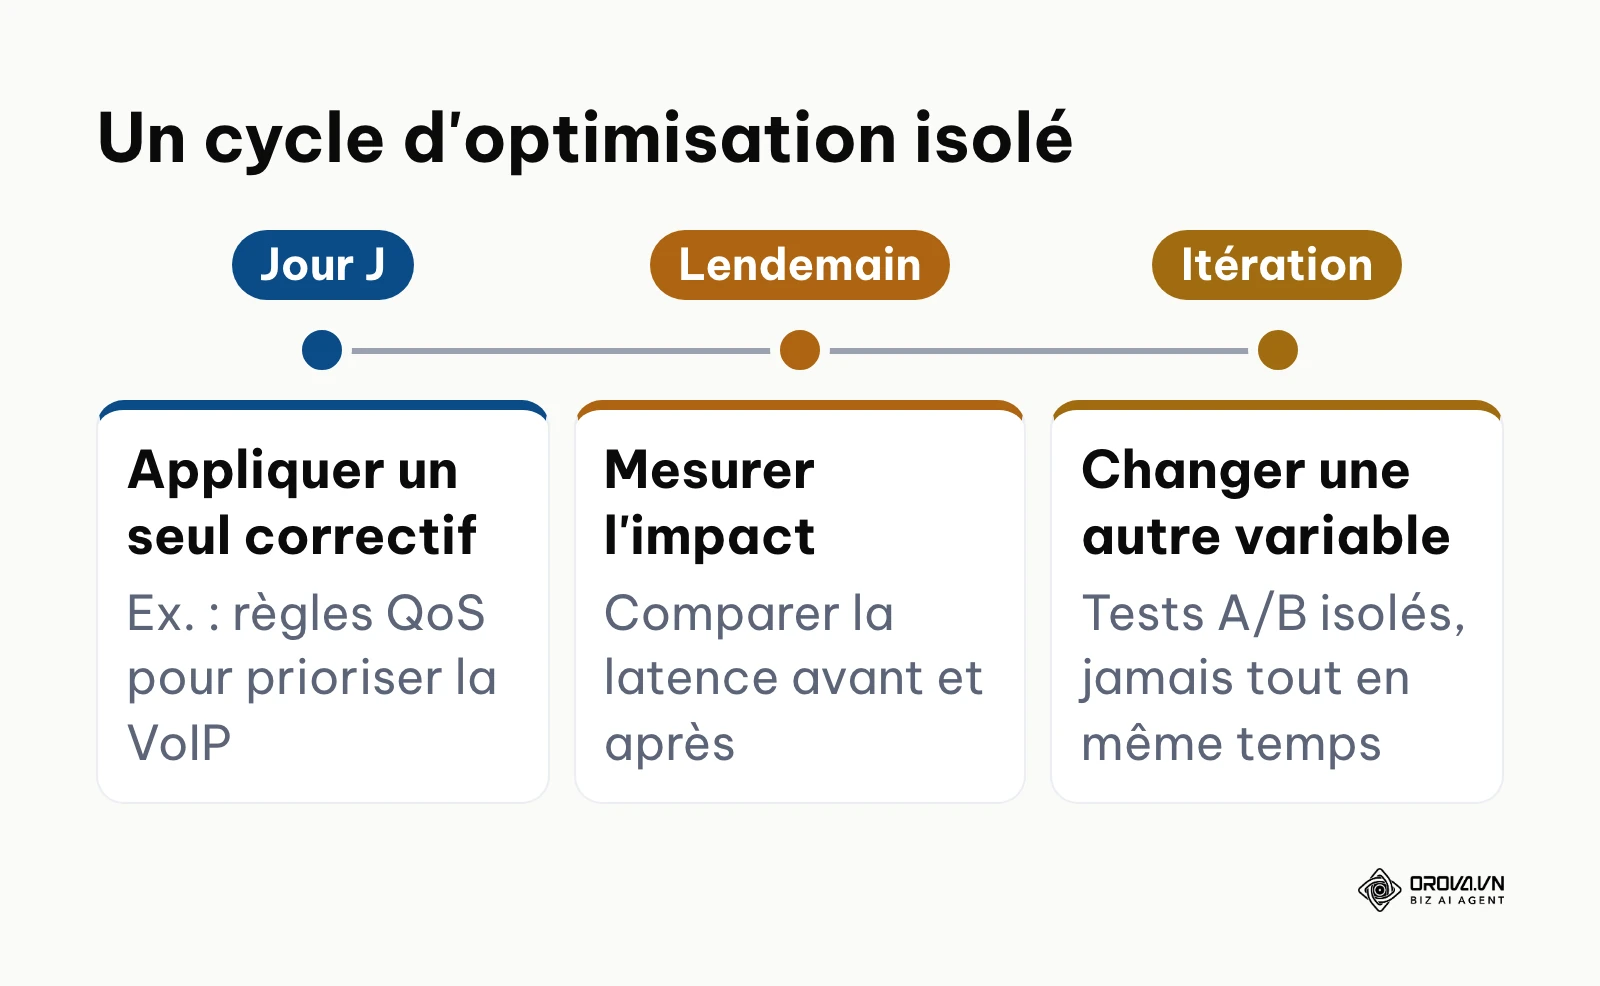
- Ce qu'il faut faire : Appliquer les correctifs basés sur vos découvertes, puis mesurer l'impact de ces correctifs.
- Comment faire (IT) : Mettez à jour les règles de qualité de service (QoS) sur vos routeurs pour prioriser la voix sur IP (VoIP) par rapport au téléchargement de fichiers, suite à la détection de latence lors des réunions Zoom. Mesurez la latence le lendemain.
- Comment faire (Social) : Adaptez votre calendrier de publication après avoir constaté que votre audience réagit mieux aux formats de vidéos courtes le jeudi soir plutôt que le lundi matin.
- L'erreur classique : Tout changer en même temps. Si vous modifiez la configuration de trois serveurs simultanément ou que vous changez la ligne éditoriale de tous vos réseaux en un jour, vous ne saurez jamais quelle action a réellement produit le résultat mesuré. Procédez par itérations isolées (tests A/B).
Vous passez des heures à analyser vos données mais n'avez plus de temps pour publier ? Avec Orova Social, publiez sur 8 canaux simultanément (Facebook, LinkedIn, TikTok, etc.) pendant que l'IA rédige vos légendes. Reprenez le contrôle de votre temps.
Analyse approfondie : Choisir la bonne approche (Matrice de décision)
Le marché regorge de solutions. L'erreur mortelle consiste à choisir un outil en lisant simplement les plaquettes commerciales. Le choix de votre arsenal d'analyse doit être dicté par la maturité de votre équipe, la sensibilité de vos données et bien entendu, votre budget.
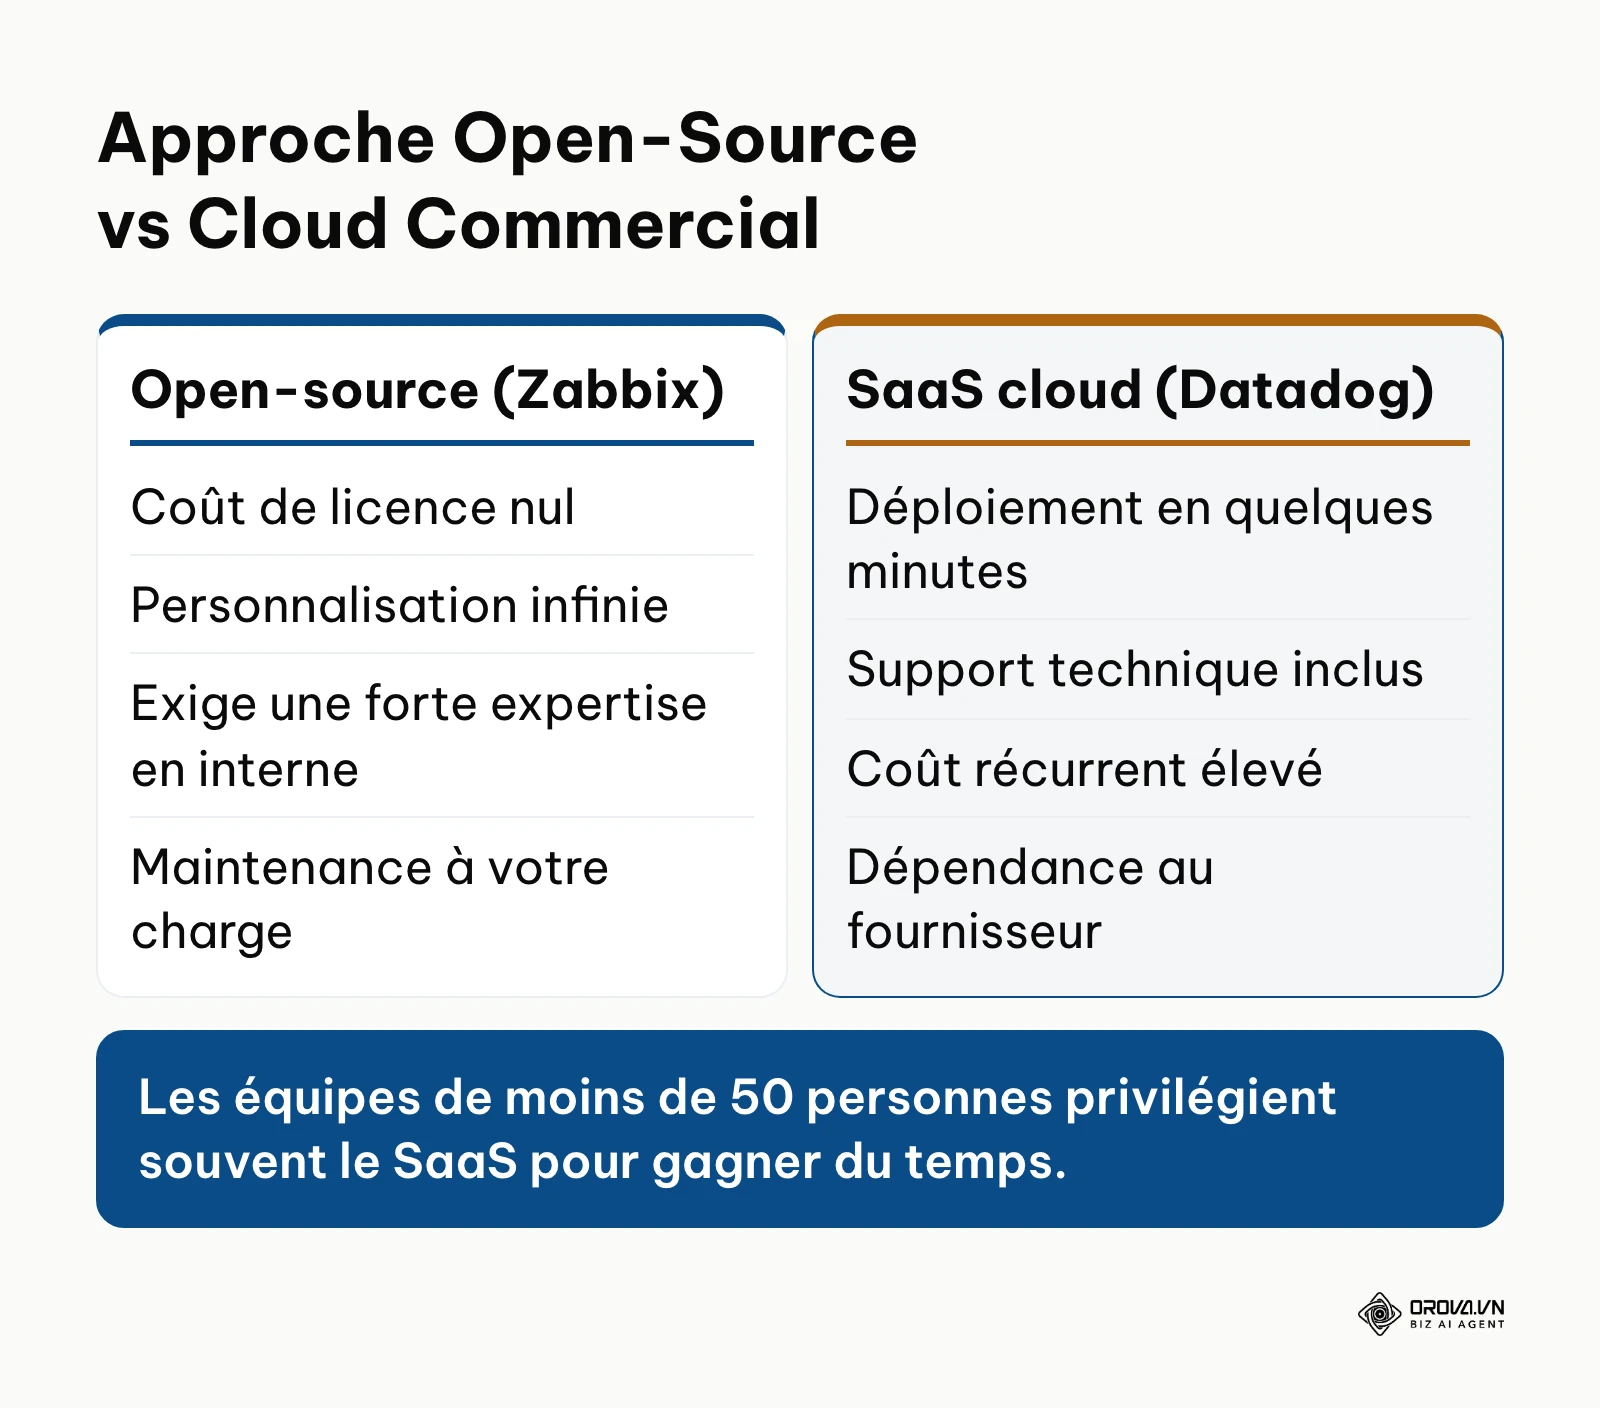
Les entreprises se heurtent généralement à un choix cornélien entre trois grandes familles de solutions :
- L'artisanat manuel (Feuilles de calcul, scripts maison).
- L'approche Open-Source puissante mais exigeante.
- Les solutions Enterprise SaaS clés en main, mais onéreuses.
Voici une matrice de décision approfondie pour vous aider à trancher, particulièrement vitale si vous cherchez le compromis idéal pour une entreprise en pleine croissance.
| Approche / Outil | Idéal pour quelle situation ? | Avantages majeurs | Point faible critique (Le revers de la médaille) |
|---|---|---|---|
| Bricolage Excel / Scripts Python basiques | TPE, Indépendants, agences d'une personne, budgets proches de zéro. | Coût nul. Flexibilité totale. Parfait pour une compréhension intime de ses données avant d'automatiser. | Chronophage à l'extrême. Casse au moindre changement d'API. L'erreur humaine lors du copier-coller est presque inévitable. |
| Solutions Open-Source (Zabbix, Nagios, ELK Stack) | PME technophiles (50+ employés), hébergeurs, équipes avec de forts ingénieurs DevOps en interne. | Pas de coûts de licence. Les données restent sur vos propres serveurs (souveraineté). Puissance d'analyse brute illimitée. | Le coût humain est caché. La maintenance, les mises à jour de sécurité et la configuration initiale demandent des semaines de travail d'ingénieur. |
| SaaS Cloud Standard (Datadog, Hootsuite, Sprout Social) | Startups en hyper-croissance, PME (10 à 200 employés) qui veulent des résultats avant la fin de semaine. | Déploiement en quelques minutes. Tableaux de bord pré-configurés excellents. Maintenance gérée par le fournisseur. Intégrations natives. | Vous êtes locataire de votre outil. Les prix s'envolent rapidement avec l'augmentation du volume de données ou du nombre de pages suivies. |
| Suites Enterprise (Cisco ThousandEyes, Sprinklr) | Multinationales, banques, groupes mondiaux gérant des dizaines de marques ou des datacenters planétaires. | Support 24/7 garanti par SLA. Analyse prédictive par IA très poussée. Couverture fonctionnelle exhaustive (du routeur à la gestion de crise RP). | Contrats d'engagement longs. Coût d'entrée prohibitif. Usine à gaz qui nécessite des mois de formation pour être maîtrisée par les équipes. |
La réponse à la question cruciale : Quelle solution pour une entreprise de moins de 50 personnes ? Si votre organisation compte moins de 50 collaborateurs, la réponse la plus rationnelle aujourd'hui est d'adopter une approche hybride : appuyez-vous sur les outils natifs gratuits des plateformes pour la collecte brute, et centralisez uniquement ce qui a de la valeur dans un SaaS Cloud Standard de niveau d'entrée.
Le piège absolu pour une structure de cette taille serait d'essayer de monter son propre serveur ELK (Elasticsearch, Logstash, Kibana) pour économiser le coût mensuel d'une licence SaaS, alors que cela coûtera la moitié du temps d'un ingénieur (soit plusieurs milliers d'euros de salaire). Votre temps est infiniment plus précieux que le coût d'une licence SaaS bien calibrée.
Mesurer les résultats : Les KPI vitaux à surveiller
Dans un océan de données, l'art de l'analyse réseaux consiste à ignorer 99% des informations pour se concentrer sur les indicateurs de performance (KPI) qui font bouger les lignes. Que vous soyez en train de déboguer un commutateur ou d'analyser le succès de campagnes de publicité Instagram, la loi de Pareto s'applique : 20% des métriques fournissent 80% de la valeur stratégique.
Le tableau ci-dessous, inspiré des meilleures pratiques de l'industrie, vous fournit la liste des KPI vitaux. Vous pouvez littéralement reproduire ce modèle dans une feuille de calcul partagée pour commencer votre suivi dès demain.
| KPI Vital (Indicateur) | Ce que cela signifie concrètement | Où le consulter | Le seuil d'alerte (Quand s'inquiéter ?) |
|---|---|---|---|
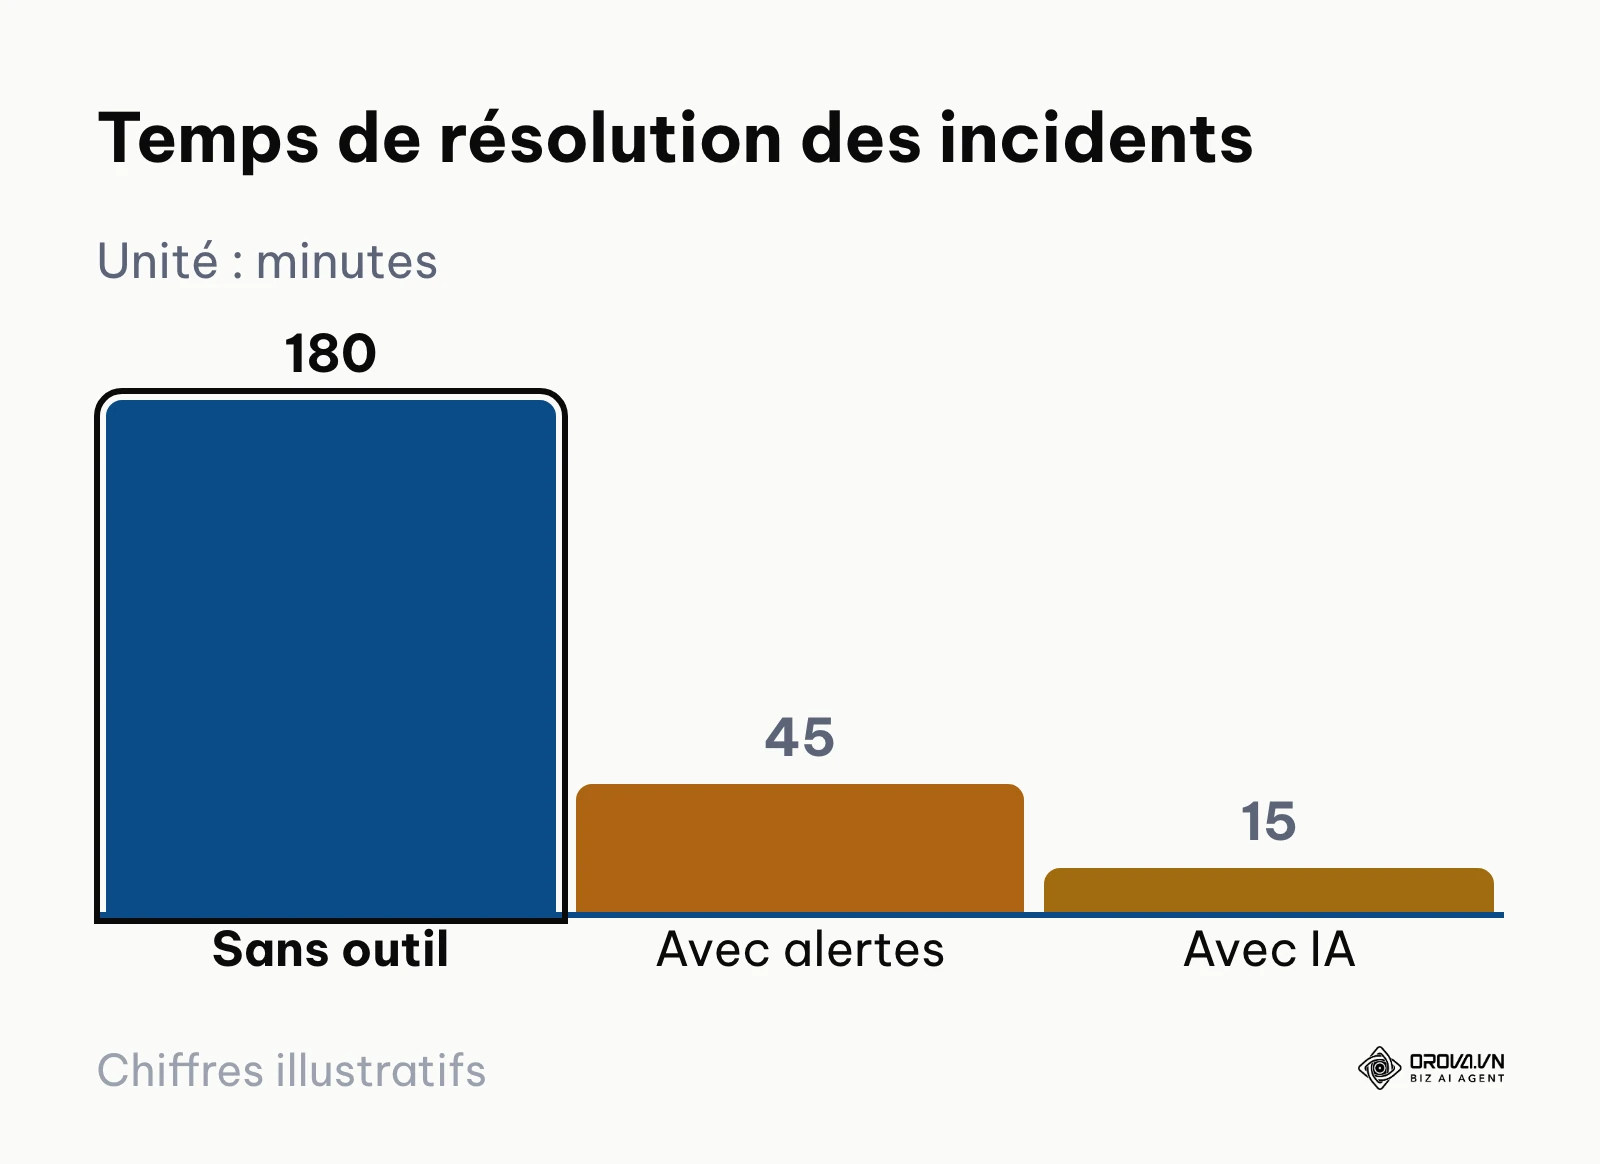
| MTTR (Mean Time To Resolution) | Le temps moyen qu'il faut à votre équipe pour réparer une panne réseau ou répondre à une crise sociale. | Dashboard du système de ticketing (Jira, Zendesk). | Si la courbe augmente pendant deux mois consécutifs. |
| Taux de perte de paquets (Packet Loss) | (IT) Le pourcentage de données qui n'arrivent jamais à destination à cause de l'encombrement du réseau. | Outils de type PRTG ou SolarWinds. | Tolérance zéro. Toute valeur supérieure à 1% sur un réseau local ou 2% sur le WAN justifie une investigation immédiate. |
| Bande passante saturée / Peak Utilization | (IT) Le pourcentage de la capacité maximale de votre lien réseau qui est actuellement utilisé. | Interface du pare-feu ou du routeur principal. | Plus de 85% d'utilisation soutenue pendant plus de 15 minutes. |
| Taux d'engagement qualifié | (Social) Le ratio entre les interactions fortes (commentaires, partages, sauvegardes) et le nombre de vues, en excluant les simples "J'aime". | Outils de statistiques natifs ou solutions d'agrégation. | Une chute brutale de 30% d'une semaine sur l'autre, souvent synonyme d'un changement d'algorithme. |
| Part de Voix (Share of Voice - SOV) | (Social) Le volume de mentions de votre marque par rapport à l'ensemble des mentions de vos concurrents directs. | Outils de social listening (Mention, Brandwatch). | Si votre concurrent principal passe devant vous pendant plus d'un trimestre. |
| Coût par Acquisition (CPA) canalisé | (Social) Combien vous coûte l'acquisition d'un client concret, réseau par réseau. | Google Analytics 4 (Modèle d'attribution). | Dès que le CPA d'un réseau dépasse la valeur à vie (LTV) estimée de votre client. |
Les marques qui centralisent et surveillent quotidiennement un ensemble restreint de KPI gagnent en réactivité stratégique. Ne cherchez pas à suivre 40 indicateurs ; focalisez-vous sur les 6 à 8 qui sont directement liés à vos objectifs commerciaux.
Les pièges courants et comment éviter la fatigue des alertes
Mettre en place une analyse réseaux est un parcours semé d'embûches. Le piège le plus sournois, et paradoxalement le plus répandu chez les équipes techniquement compétentes, est le syndrome de la "Fatigue des alertes" (Alert Fatigue). Voici les erreurs fatales qui ruinent la crédibilité de votre système, et comment les corriger.
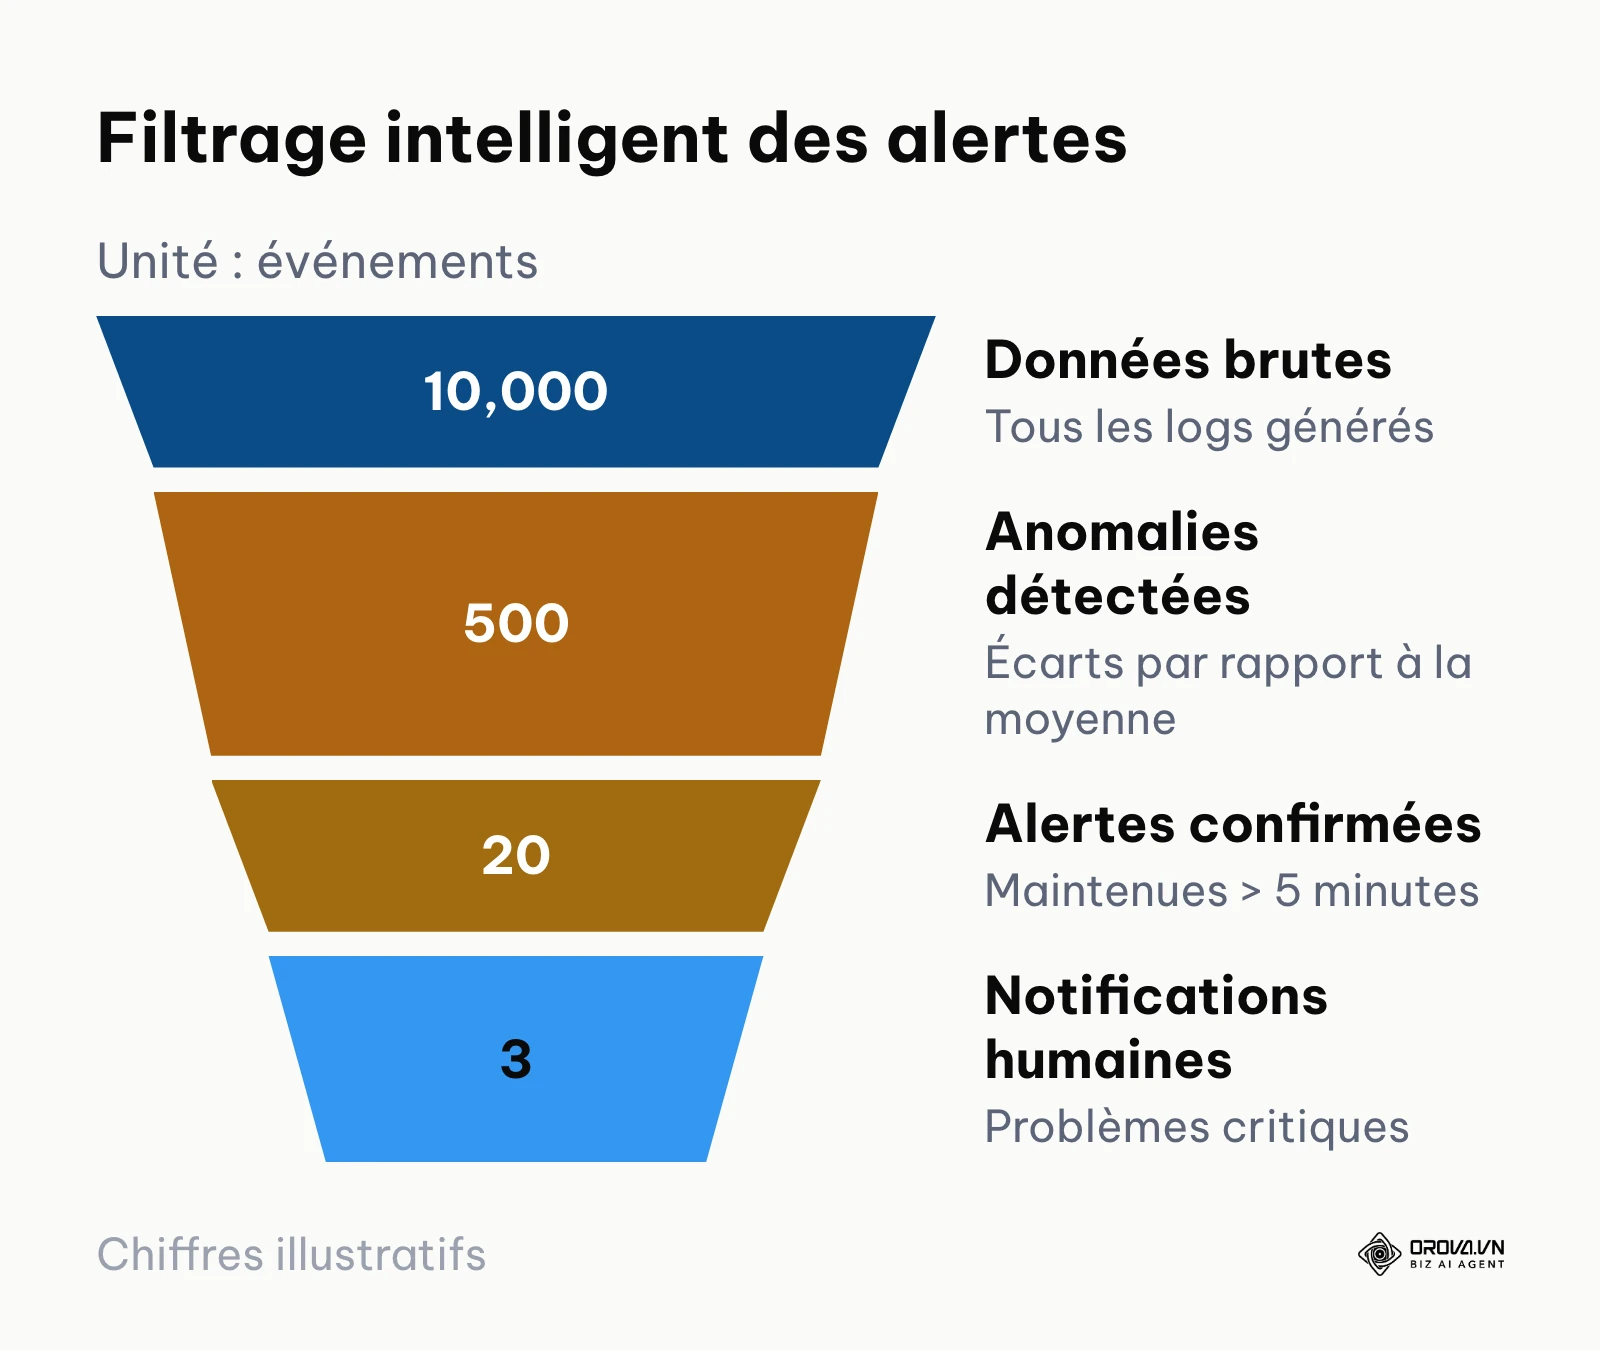
Erreur n°1 : Le syndrome de l'alarme de voiture (La fatigue des alertes)
- Conséquence : Vous avez configuré des alertes pour le moindre écart. Résultat, votre équipe reçoit 300 notifications par jour sur Slack ou sur leur téléphone. Très vite, plus personne ne lit les messages. Le jour où une véritable panne critique survient, elle est noyée dans le bruit et ignorée.
- La correction (Checklist Anti-bruit) :
- Ne paramétrez jamais d'alerte sur des pointes instantanées (ex: CPU à 100% pendant 2 secondes). Utilisez toujours des moyennes glissantes (ex: CPU > 90% pendant 5 minutes continuellement).
- Triez par gravité : Sévérité 1 (réveille l'ingénieur à 3h du matin), Sévérité 2 (notification email pour le lendemain), Sévérité 3 (simple ligne dans le log, aucune notification).
- Supprimez impitoyablement toute règle d'alerte qui s'est déclenchée 10 fois dans le mois sans nécessiter d'action humaine.
Exemple illustratif :
- Contexte : L'ingénieur DevOps d'une entreprise SaaS éditant un logiciel RH.
- Étapes réalisées : Il a mis en place des alertes Slack pour chaque pic de CPU serveur dépassant 70%, envoyées directement sur le canal principal de l'équipe de développement.
- Obstacle et solution : Les développeurs ont rapidement mis le canal en silencieux ("Mute") à cause de la cinquantaine de notifications inutiles reçues chaque jour lors des compilations de routine. Lors d'un véritable blocage de base de données, personne n'a réagi. Pour corriger, il a créé un seuil de persistance (utilisation de la mémoire > 85% maintenue durant 10 minutes) et acheminé cette alerte critique uniquement vers le téléphone de l'ingénieur d'astreinte via PagerDuty.
- Résultat : Zéro incident critique ignoré depuis 6 mois, une réduction de 95% du volume des alertes et un retour immédiat de la sérénité au sein de l'équipe de développement.
Erreur n°2 : Analyser en vase clos (L'aveuglement en silo)
- Conséquence : Le responsable réseau optimise le pare-feu sans parler au développeur web. Le community manager analyse ses métriques Instagram sans jamais regarder les chiffres de vente du site web. Les décisions prises localement dégradent la performance globale.
- La correction : L'analyse réseaux doit être transversale. Forcez les réunions mensuelles où la donnée est partagée. Le trafic web et l'engagement social doivent être analysés sur le même écran de contrôle.
Erreur n°3 : Ignorer la sécurité par souci de performance
- Conséquence : Dans la précipitation, on ouvre les ports SNMP à tous vents, ou on accorde des accès administrateurs définitifs (Tokens API "God mode") à des outils de statistiques tiers pour les réseaux sociaux. C'est une faille béante.
- La correction : Utilisez toujours les principes du moindre privilège. Un outil d'analyse sociale ne devrait avoir que des droits de lecture (Read-only) sur vos statistiques, sans possibilité de supprimer vos pages. Côté IT, utilisez SNMPv3 chiffré et limitez les accès IP stricts aux serveurs de supervision.
Prêt à optimiser votre présence en ligne ? Gérez tous vos contenus avec Orova Social. Découpez vos longues vidéos en clips verticaux, appliquez vos profils de marque et téléchargez vos calendriers d'un simple clic. Profitez-en, c'est gratuit jusqu'au 7/7/2027.
Tendances de l'analyse réseaux : Ma vision pour les prochaines années
En scrutant l'évolution des infrastructures et des algorithmes, de profonds bouleversements se préparent. Dans les prochaines années, la façon dont nous pratiquons l'analyse réseaux ne ressemblera plus à celle de la décennie précédente. Voici mes trois convictions profondes sur l'avenir de cette discipline.
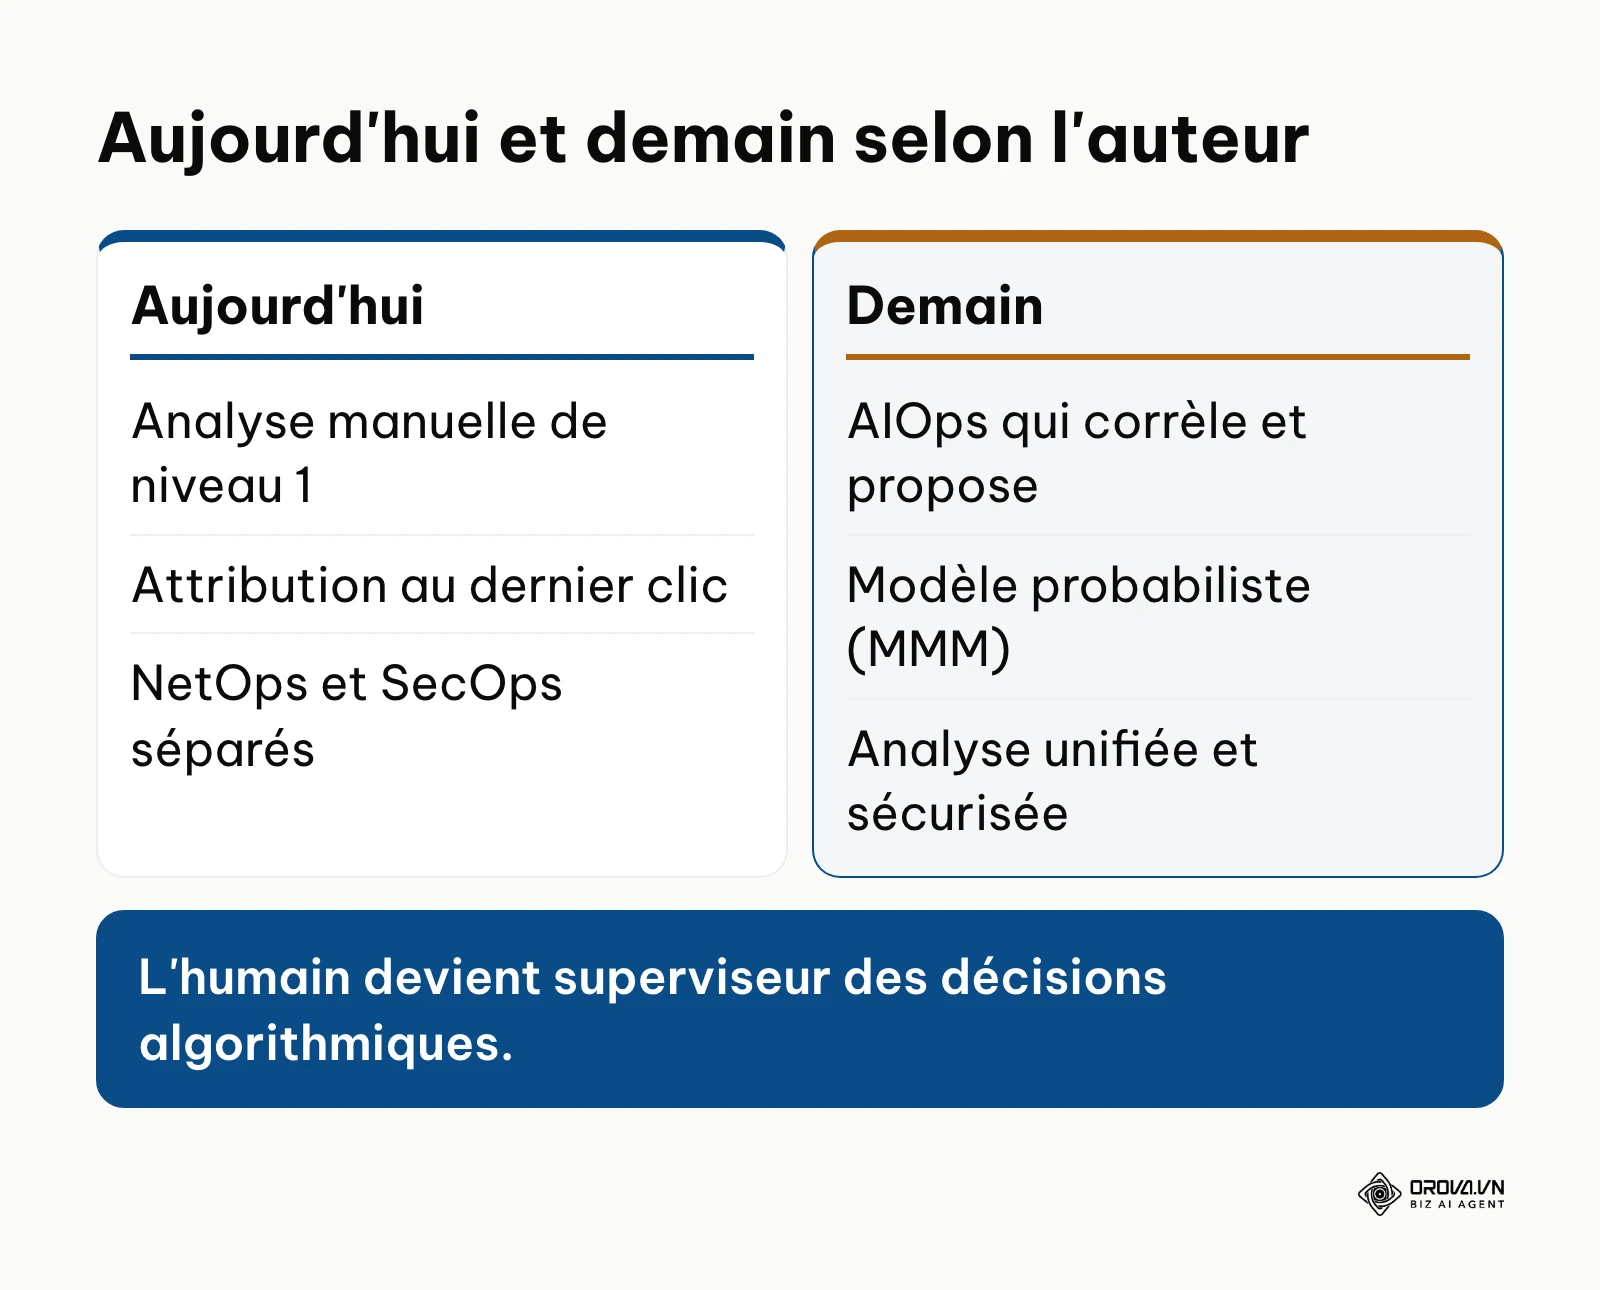
L'avènement de l'AIOps éliminera l'analyse manuelle de niveau 1
Aujourd'hui, nous voyons déjà les prémices d'outils capables de corréler des gigaoctets de logs en quelques secondes. Je choisis de parier que d'ici deux à trois ans, les ingénieurs réseau ne passeront plus des heures à chercher l'origine d'un ralentissement. L'AIOps (Artificial Intelligence for IT Operations) s'imposera. Le système ne se contentera pas de signaler une panne ; il dira : "Le routeur 4 présente une anomalie typique d'une dégradation matérielle imminente, je l'ai isolé et j'ai re-routé le trafic par précaution." L'humain deviendra un superviseur de décisions algorithmiques. Il faut dès à présent se former à la compréhension des modèles de Machine Learning pour ne pas être dépassé.
La mort du "Last Click" redéfinira l'analyse sociale
La traque publicitaire fondée sur les cookies tiers recule sous la pression réglementaire (RGPD) et des restrictions imposées par plusieurs navigateurs. Je suis convaincu que l'analyse des réseaux sociaux marketing va basculer d'un modèle d'attribution déterministe (savoir exactement qui a cliqué sur quoi) à un modèle probabiliste fondé sur l'économétrie (Media Mix Modeling). Nous ne compterons plus les clics, nous analyserons l'impact global d'une campagne sur le volume de requêtes de la marque dans les moteurs de recherche. Les marketeurs doivent impérativement réapprendre à analyser des cohortes de données macroscopiques plutôt que de chercher l'illusion de la précision absolue individuelle. Bien sûr, cette prédiction pourrait être ralentie si de nouvelles normes d'identité unifiée anonymisée venaient à émerger et à être acceptées légalement.
La fusion inévitable du NetOps et du SecOps
Aujourd'hui, l'analyse réseau (NetOps, concentrée sur la performance) et l'analyse de sécurité (SecOps, concentrée sur les menaces) utilisent souvent des outils distincts qui capturent pourtant les mêmes paquets. Selon moi, cette séparation artificielle va disparaître. L'analyse réseaux du futur sera fondamentalement orientée sécurité dès la conception (Secure Access Service Edge - SASE). Un pic d'utilisation de la bande passante sera instantanément analysé tant sous le prisme de la congestion que sous celui de l'exfiltration de données. Les silos budgétaires et techniques dans les entreprises devront être cassés pour unifier ces deux métiers.
Questions fréquentes sur l'analyse réseaux
La diversité du sujet engendre de nombreuses interrogations légitimes. Voici les réponses aux blocages les plus récurrents.
Quelle est la différence fondamentale entre la supervision et l'analyse réseaux ?
La supervision (monitoring) est réactive : elle observe l'état actuel et génère des alertes lorsqu'un seuil est franchi (ex: le serveur est hors ligne). L'analyse réseaux est proactive et investigatrice : elle fouille dans l'historique des données, corrèle les événements (logs, flux de paquets) pour comprendre la cause racine d'un problème complexe ou pour modéliser des optimisations futures.
L'intelligence artificielle va-t-elle remplacer les analystes réseau ?
Non, mais les analystes utilisant l'IA remplaceront ceux qui s'y refusent. Le rôle de l'IA aujourd'hui est d'ingérer le volume surhumain de données, d'éliminer le "bruit" des fausses alertes, et de proposer des hypothèses de résolution de pannes (ou de suggérer le meilleur horaire de publication sur les réseaux sociaux). L'humain reste décisionnaire sur la stratégie et la validation des actions critiques.
Faut-il investir dans des sondes matérielles (Hardware) ou logicielles (Software) pour l'IT ?
Pour la plupart des entreprises modernes exploitant massivement le Cloud ou la virtualisation, les sondes logicielles (et l'analyse de flux type NetFlow/sFlow) sont amplement suffisantes, plus économiques et plus souples. Les sondes matérielles (appliance physique branchée sur un TAP réseau) ne se justifient que pour des environnements extrêmement critiques, des data centers massifs ou des exigences réglementaires strictes de capture complète de paquets (banques, défense).
Un outil de gestion sociale peut-il remplacer Google Analytics ?
Absolument pas. Ils sont complémentaires. Les outils d'analyse des réseaux sociaux mesurent ce qui se passe avant le clic (portée, engagement sur la plateforme, sentiments). Google Analytics 4 (ou Matomo) prend le relais pour mesurer ce qui se passe après le clic (comportement sur votre site web, temps de lecture, acte d'achat). Les deux doivent être croisés pour obtenir une vision complète du parcours utilisateur. Le concept de calendrier éditorial structuré prend tout son sens quand on aligne la production de contenu sur les attentes mesurées sur site.
Par où commencer dès aujourd'hui ?
La plus grande erreur face à un domaine aussi vaste que l'analyse réseaux est la paralysie par l'analyse elle-même. Vouloir tout mettre en place parfaitement du premier coup est la garantie d'échouer. L'approche la plus saine consiste à déclencher des victoires rapides et mesurables.
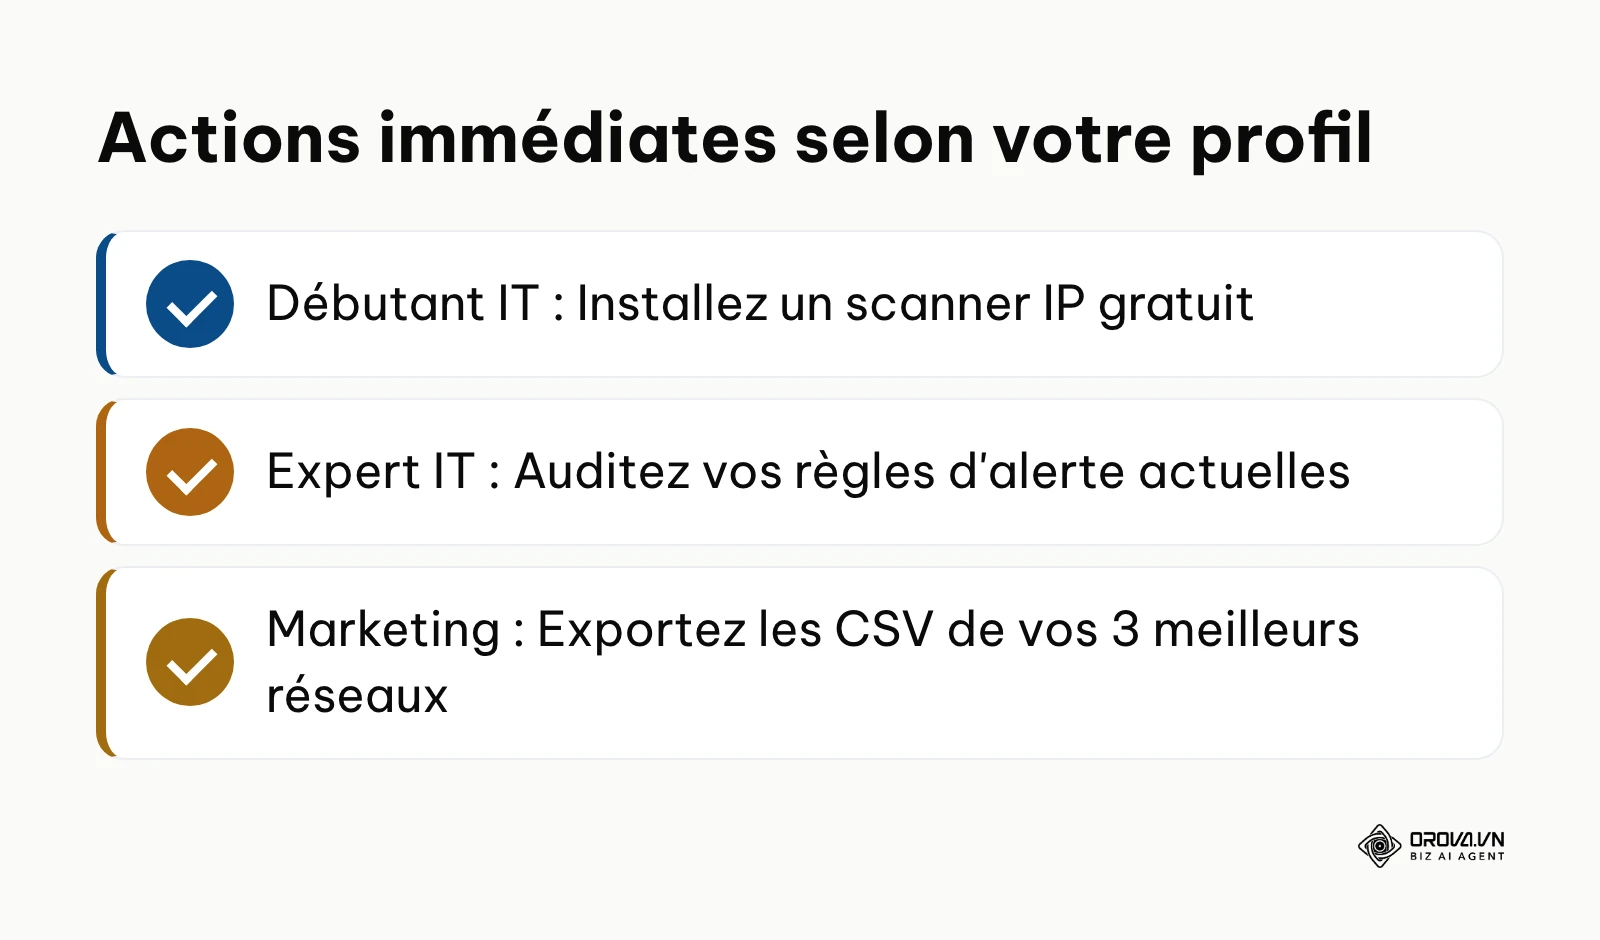
Selon votre situation actuelle, voici la toute première action, simple et gratuite, que vous pouvez accomplir dans l'après-midi :
- Situation 1 : Vous gérez l'IT d'une PME et naviguez à l'aveugle.
Ne cherchez pas à installer un monstre comme Zabbix aujourd'hui. Téléchargez et exécutez un simple scanner d'adresses IP (comme Advanced IP Scanner ou Fing) sur votre réseau de bureau. Vous obtiendrez instantanément la liste de tous les équipements connectés. Cette simple cartographie de base est le kilomètre zéro de toute démarche de sécurisation et d'analyse.
- Situation 2 : Vous êtes saturé par de fausses alertes techniques jour et nuit.
Ouvrez le panneau de configuration de votre outil de supervision actuel. Identifiez l'alerte spécifique qui s'est déclenchée le plus grand nombre de fois la semaine dernière sans qu'aucune action corrective n'ait été requise. Soit vous la désactivez purement et simplement, soit vous augmentez son seuil de tolérance de 50%. Observez le silence revenir.
- Situation 3 : Vous peinez à prouver le ROI de vos réseaux sociaux.
Oubliez les tableaux de bord interactifs pour le moment. Allez sur les trois réseaux sociaux où vous êtes le plus actif, exportez les données brutes des 30 derniers jours au format CSV. Ouvrez-les dans Excel, et créez une simple colonne calculant votre taux d'engagement qualifié (Partages + Commentaires / Vues). Ce fichier rudimentaire sera la fondation de votre futur cahier des charges d'automatisation.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Pilotez votre activité avec des AI Agents
Orova est le Biz AI Agent qui ne s'arrête jamais : il planifie, exécute et optimise le travail à votre place.
Gagnez du temps, gagnez en efficacité.