Entity SEO : qu'est-ce que c'est et comment structurer vos entités
L'entity SEO transforme en profondeur la manière dont les éditeurs de sites conçoivent leur visibilité en ligne. Vous publiez régulièrement des articles ciblés sur des requêtes précises, pourtant vos positions stagnent ou s'effondrent dès qu'une mise à jour algorithmique survient. L'approche classique reposant sur la répétition de mots-clés et l'optimisation brute de la densité textuelle ne suffit plus face à des moteurs de recherche capables d'interpréter le sens global des sujets. Les systèmes d'indexation actuels ne lisent plus de simples chaînes de caractères, mais cartographient des concepts connectés dans d'immenses bases de connaissances. Ce guide décortique les fondations de l'optimisation par entités sémantiques, expose les mécanismes du Knowledge Graph et vous fournit une méthode technique concrète pour structurer votre autorité thématique sur le web.
Qu'est-ce que l'Entity SEO ?
L'Entity SEO est une stratégie d'optimisation sémantique qui structure les contenus web autour d'entités nommées et de leurs relations logiques, plutôt que sur de simples mots-clés isolés. Elle sert à faire comprendre aux moteurs de recherche le contexte réel d'un sujet, différenciant nettement l'expertise technique des contenus textuels génériques.
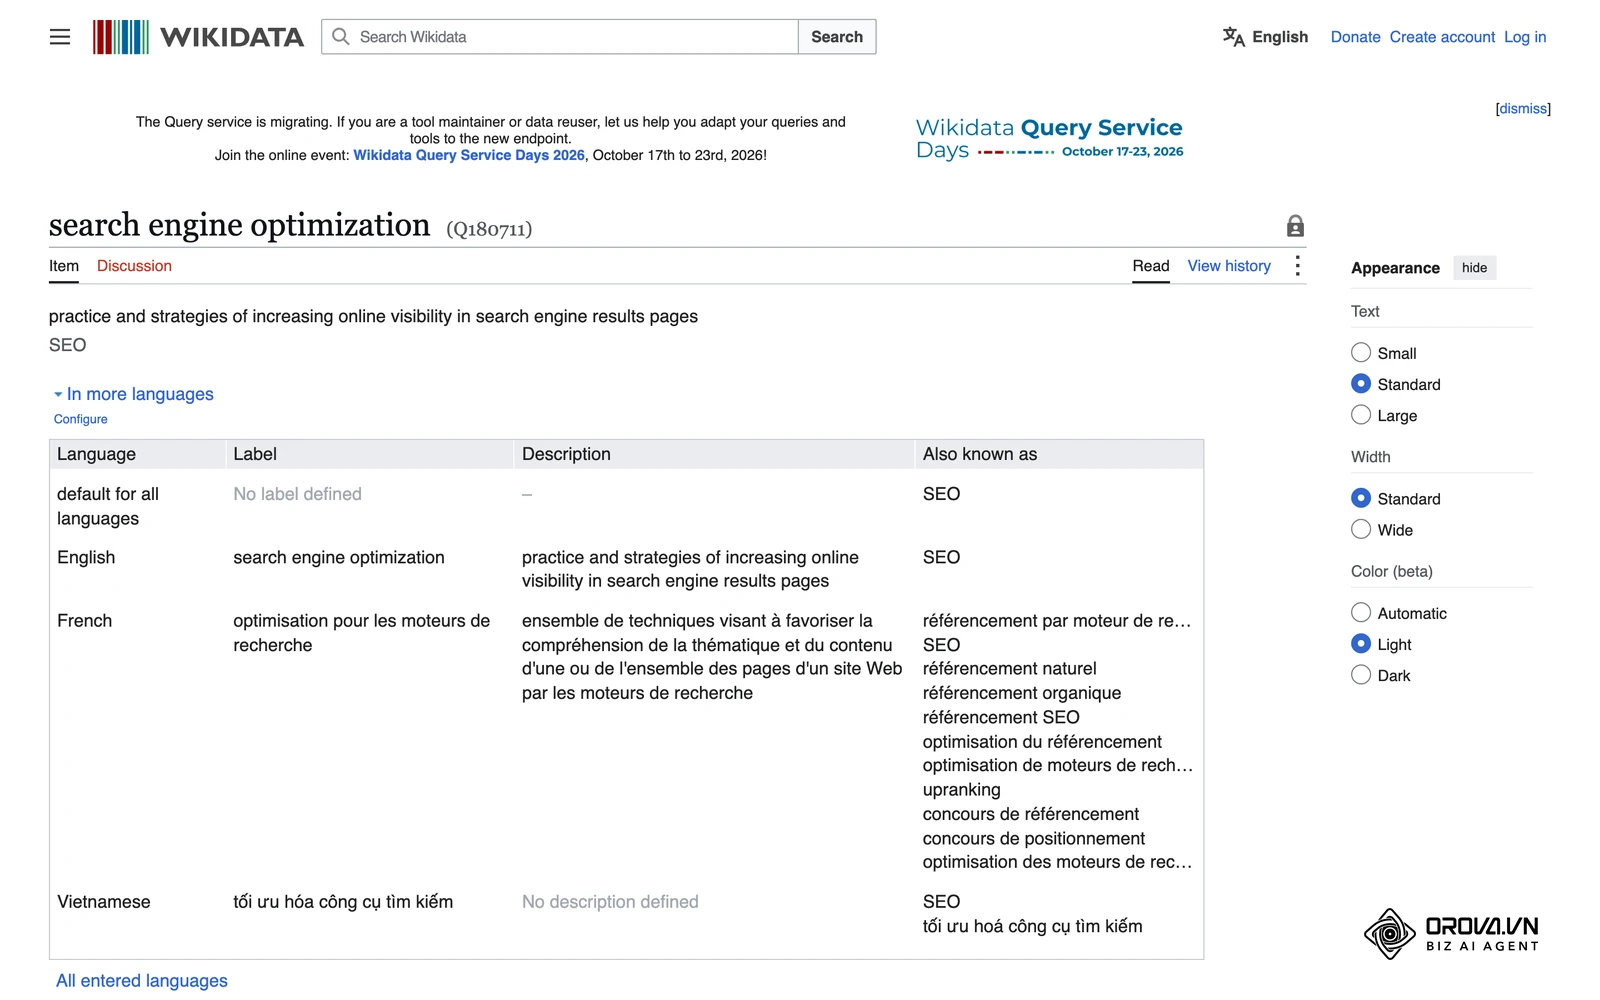
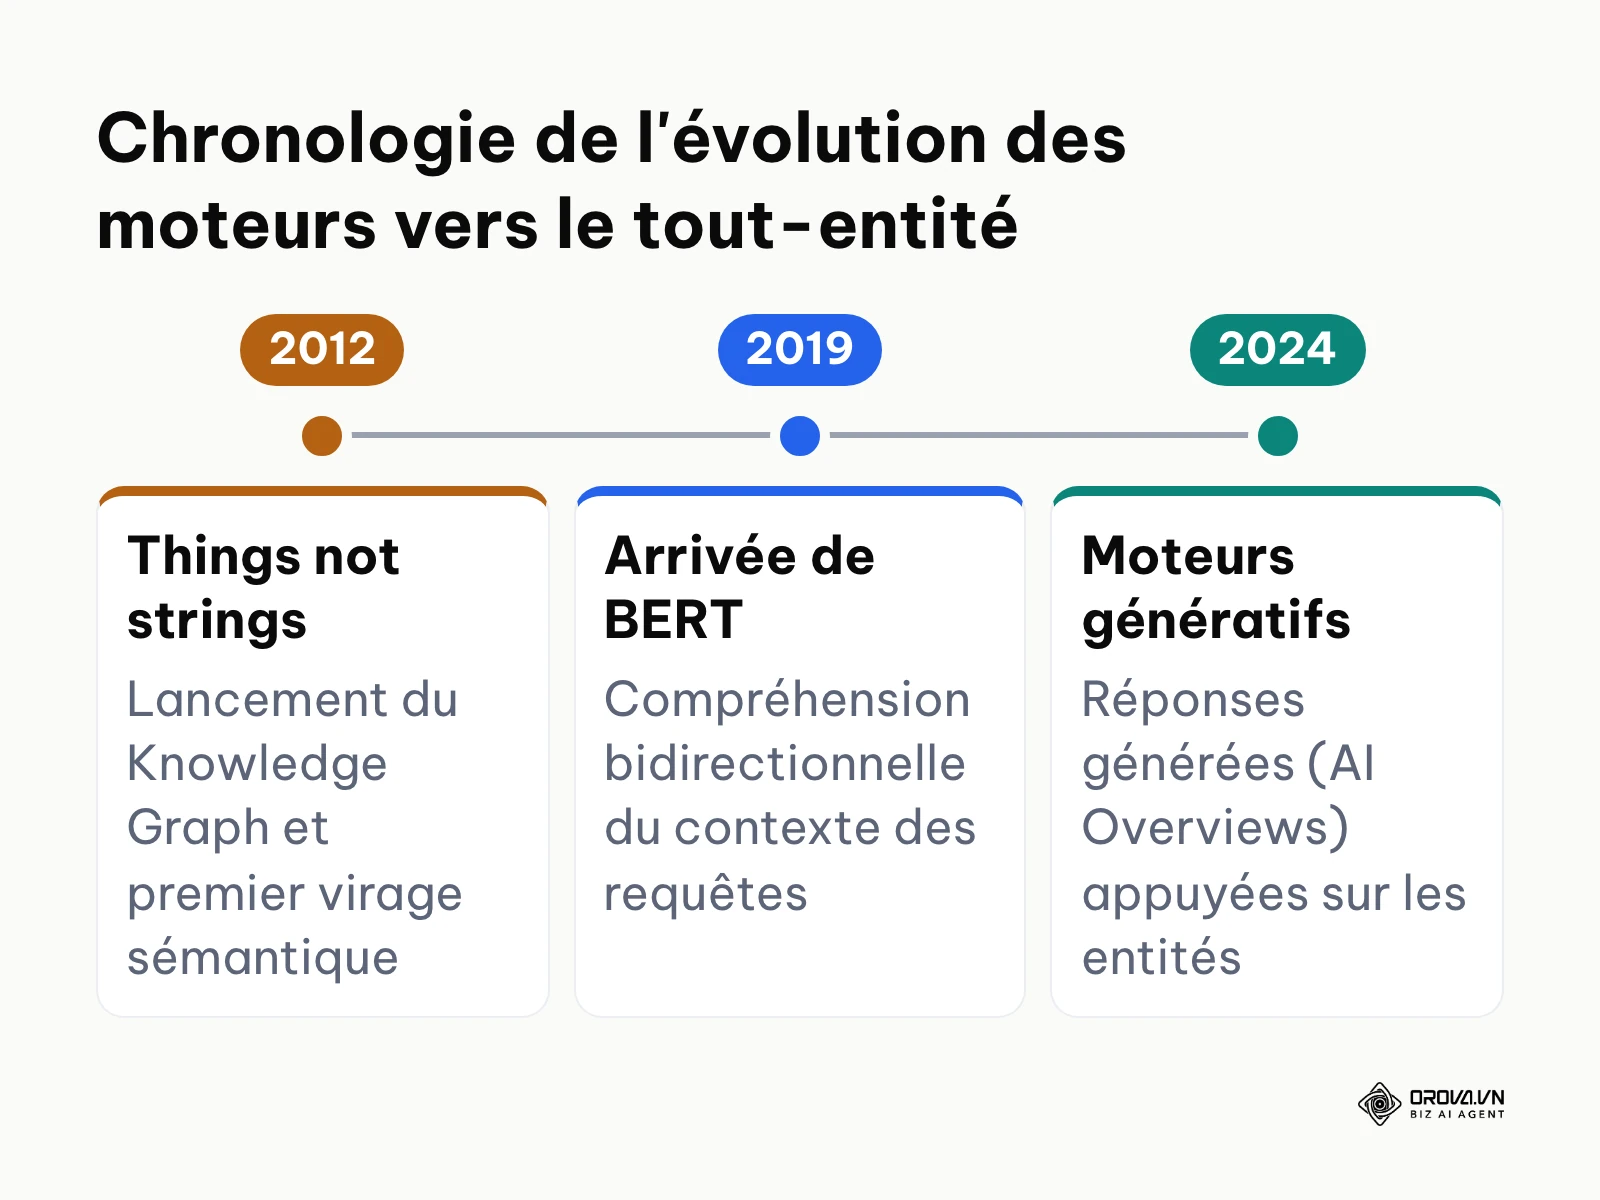
L'origine de cette approche remonte au principe fondamental formulé par Google en 2012 : « Things, not strings » (des choses, pas des chaînes de caractères). Ce changement de paradigme a marqué le passage d'une analyse syntaxique superficielle à une modélisation du monde réel par des graphes de connaissances (Knowledge Graphs). Dans ce modèle, une entité est un objet, une personne, un lieu, une organisation ou un concept abstrait clairement identifiable, universel et non ambigu.
Pour bien situer ce concept, il convient de le distinguer des notions voisines avec lesquelles il est fréquemment confondu :
| Concept | Différence fondamentale avec l'Entity SEO | Exemple concret |
|---|---|---|
| SEO traditionnel par mots-clés | Se concentre sur la chaîne de caractères et le volume de recherche brut, sans comprendre le sujet sous-jacent. | Répéter l'expression « logiciel comptable » six fois dans un texte pour forcer la pertinence lexicale. |
| Topic Cluster (Cocon sémantique) | Organise l'architecture des pages et les liens entre articles, sans obligatoirement déclarer les identifiants uniques des concepts. | Regrouper dix articles autour d'une page pilier sans balisage formel d'entité. |
| Balisage Schema.org basique | Fournit une syntaxe technique brute, mais reste inefficace si les entités ne sont pas reliées à des référentiels reconnus. | Intégrer un schéma Article basique contenant uniquement le titre et la date, sans déclarer l'auteur ni le sujet traité. |
| Entity SEO | Modélise les liens sémantiques entre des concepts certifiés par des identifiants uniques du web de données. | Relier formellement un article sur l'intelligence artificielle à l'élément Wikidata Q11660 via la propriété about. |
Pour illustrer cette mécanique dans la vie courante, imaginez le système de classement d'une bibliothèque municipale. Si vous cherchez un livre sur « Jaguar », un bibliothécaire traditionnel se contenterait de chercher les ouvrages contenant ce mot sur leur couverture, mélangeant les manuels de mécanique automobile britannique, les monographies sur la faune d'Amérique du Sud et les guides du système d'exploitation informatique d'Apple. À l'inverse, un bibliothécaire appliquant les principes de l'Entity SEO consulte immédiatement le fichier d'autorité : il sait que chaque sujet correspond à un numéro d'inventaire unique, rattaché à une classification scientifique précise, éliminant d'emblée toute ambiguïté.
Pourquoi l'Entity SEO est devenu indispensable pour votre visibilité
L'Entity SEO résout une faille majeure de la recherche sur le web : la volatilité des classements causée par l'incompréhension sémantique des algorithmes. Lorsque votre contenu n'est optimisé que sur des mots-clés, le moindre changement dans la formulation des requêtes par les internautes ou dans les modèles d'analyse lexicale peut effacer votre trafic organique.
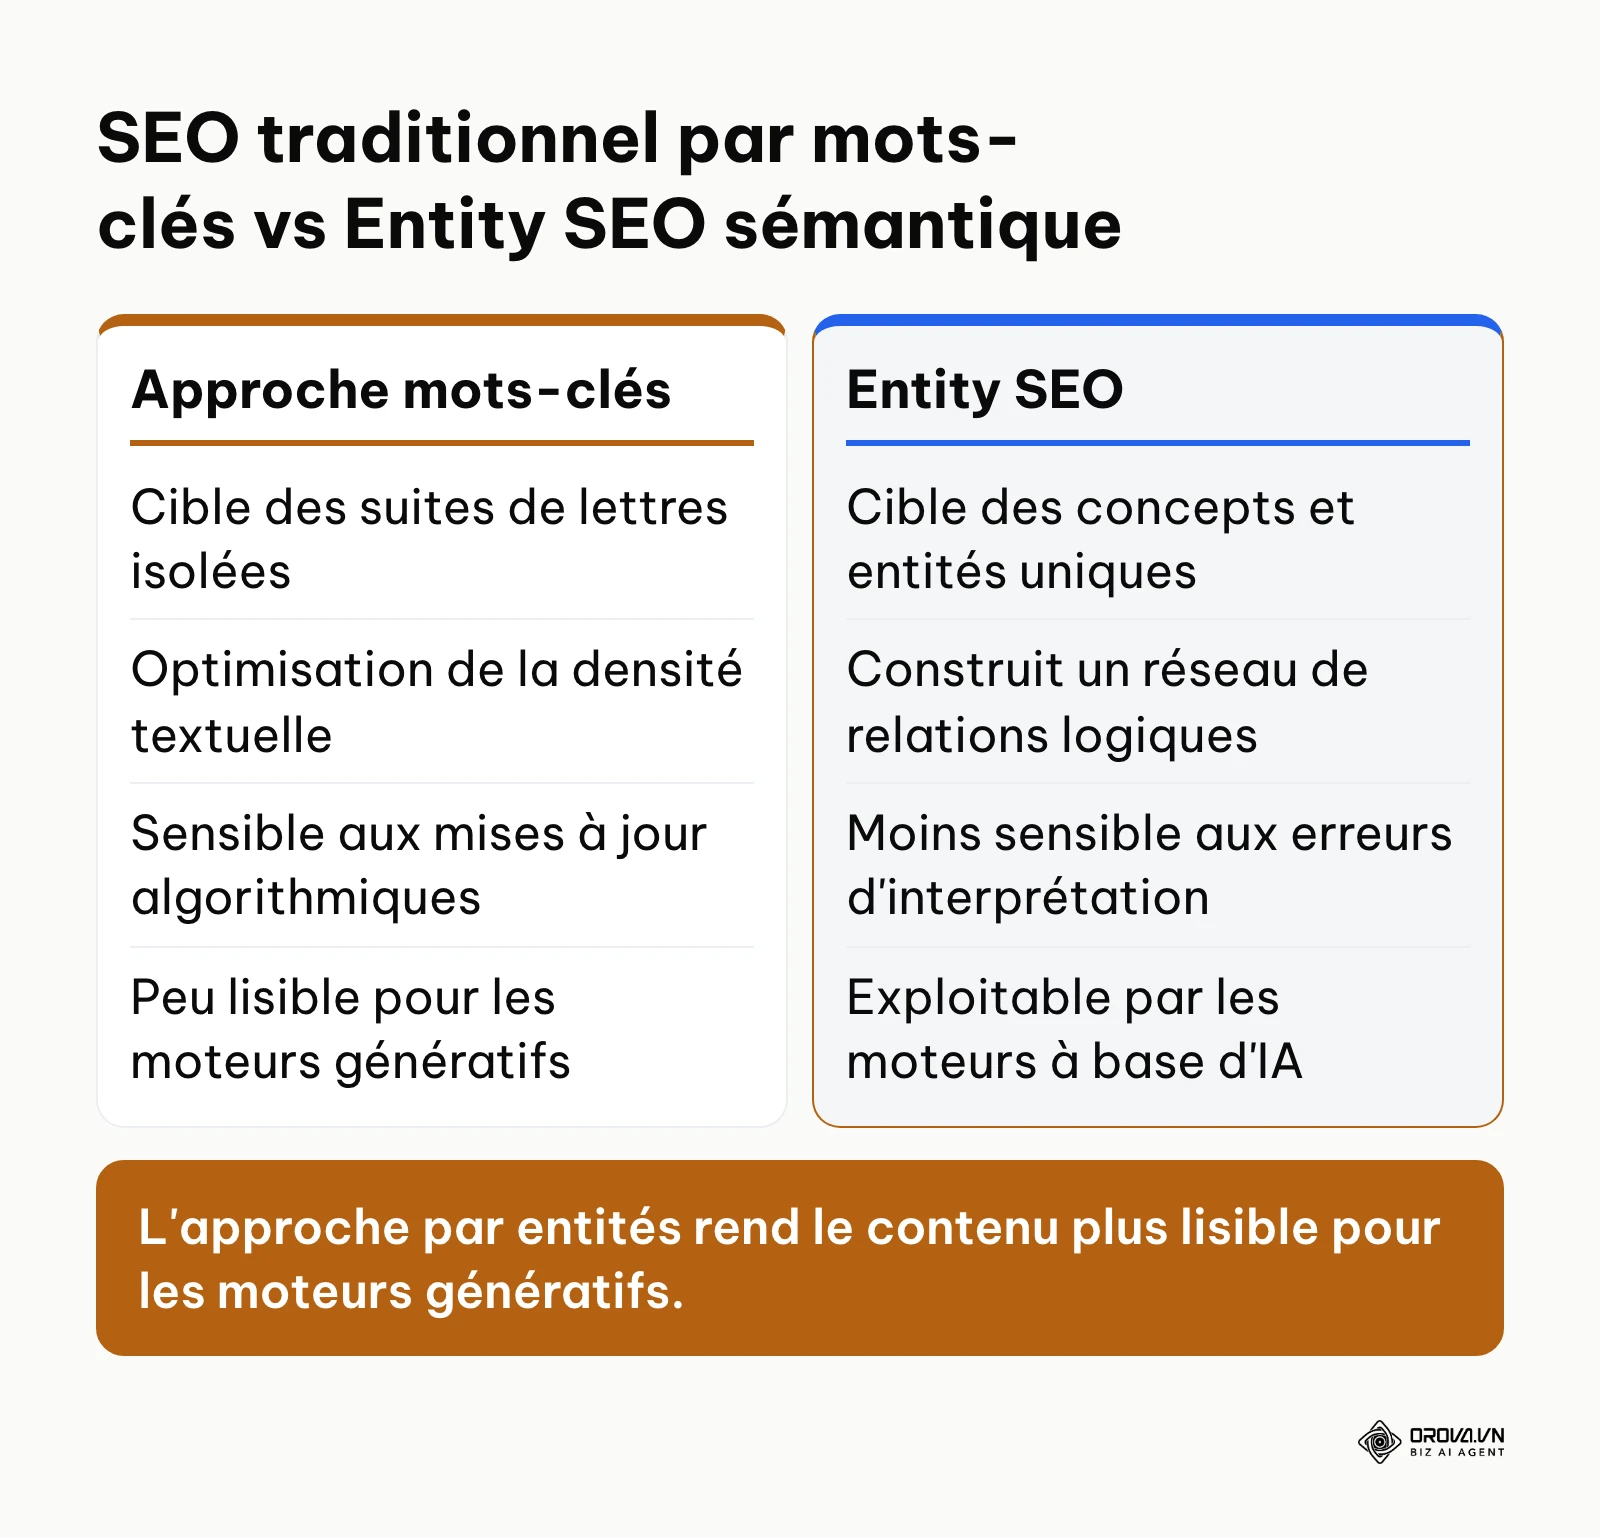
Dans l'architecture globale du référencement, l'optimisation par entités se situe à l'intersection de la structure technique et de l'autorité éditoriale. Les fondations techniques (vitesse de chargement, exploration des robots et indexabilité) interviennent en amont pour permettre la lecture des données. L'Entity SEO intervient immédiatement après : il qualifie la nature exacte de ce qui est exploré. En aval, il alimente directement les scores d'autorité thématique et prépare vos contenus à être cités par les moteurs de recherche génératifs et les assistants conversationnels, un enjeu au cœur de l'évolution du SEO, AEO et GEO.
Le schéma de cette section résume les divergences structurelles entre l'ancienne logique lexicale et la modélisation par entités.
Ignorer cette dimension expose votre site à trois pertes directes :
- La perte d'attribution de vos contenus : les moteurs de recherche peinent à relier vos analyses à l'auteur légitime ou à votre marque, affaiblissant vos signaux de confiance.
- L'exclusion des blocs d'information enrichis (Knowledge Panels) : votre entreprise reste une simple adresse URL sans fiche d'identité reconnue dans la base de connaissances de Google.
- L'invisibilité dans les résumés génératifs : les grands modèles de langage sélectionnent en priorité les sources dont les concepts sont formellement validés et interconnectés.
Quand l'Entity SEO n'est pas encore nécessaire
Déployer un chantier complet d'Entity SEO représente un investissement disproportionné dans certains contextes précis. Si vous lancez une page de vente temporaire pour un événement éphémère d'une durée de dix jours, structurer des graphes de connaissances complexes est inutile. De même, pour un site de test technique sans vocation de marque ou un catalogue mono-produit sans ambition de rayonnement sectoriel, les méthodes de base suffisent.
| Situation | Entity SEO nécessaire ? | Priorité recommandée |
|---|---|---|
| Page de vente temporaire pour un événement de quelques jours | Non | Campagnes publicitaires ciblées et balises de métadonnées soignées |
| Site de test technique sans vocation de marque | Non | Référencement technique propre (exploration, indexation, vitesse) |
| Catalogue mono-produit local sans ambition sectorielle | Pas encore | Profil d'établissement local et pages produits claires |
| Marque durable ou média d'expertise thématique | Oui | Page Entity Home, balisage Organization et liens vers Wikidata |
Les bénéfices concrets de l'Entity SEO pour votre entreprise et vos équipes
L'adoption de l'Entity SEO procure des avantages distincts, répartis entre la rentabilité globale de l'entreprise et l'efficacité opérationnelle des professionnels du marketing digital.
Valeur économique et réduction du risque pour l'entreprise
Sur le plan financier, lier votre marque à des entités reconnues stabilise vos flux de visiteurs. Un site dont les thématiques sont clairement rattachées à des entités reconnues offre moins de prise aux erreurs d'interprétation lors des mises à jour majeures de Google (Core Updates). Cette stabilité recherchée protège le chiffre d'affaires dépendant du canal organique.
Sur le plan du risque, structurer vos entités protège l'identité de votre marque contre les confusions sémantiques avec des concurrents ou des entités homonymes. Vous construisez un actif numérique pérenne : une autorité thématique accumulée qui ne s'évapore pas au premier changement d'algorithme.
Exemple illustratif : une entreprise d'édition logicielle B2B constatait une perte continue de trafic sur ses guides comparatifs face aux réponses générées par les moteurs de recherche. L'équipe a d'abord cartographié les entités associées à chaque solution dans Wikidata, puis a injecté des balises Schema d'attribut about et mentions liant directement leurs comparatifs aux identifiants canoniques des logiciels. La principale difficulté résidait dans les conflits d'homonymie avec des termes techniques génériques, résolus en précisant le champ disambiguatingDescription. L'objectif d'une telle démarche est de rendre ses comparatifs plus faciles à attribuer et à citer par les moteurs, sans garantie de résultat chiffré.
Avantages directs pour les spécialistes SEO et créateurs de contenu
Pour les équipes de rédaction et les consultants en référencement, cette approche élimine le casse-tête de la densité des mots-clés. Il n'est plus nécessaire de contraindre la langue naturelle pour insérer artificiellement des formulations maladroites. Le travail s'oriente vers la couverture exhaustive des sous-concepts nécessaires pour épuiser un sujet donné, renforçant naturellement la conformité aux critères E-E-A-T (expérience, expertise, autorité et confiance).
| Bénéfice | Indicateur de mesure (KPI) | Délai d'observation |
|---|---|---|
| Affichage dans le Knowledge Panel | Apparition de l'encart d'entité lors d'une recherche sur la marque exacte. | 8 à 16 semaines après validation des sources tierces. |
| Résilience aux mises à jour algorithmiques | Stabilité des impressions globales dans Google Search Console lors des Core Updates. | Visible lors de la mise à jour majeure suivante. |
| Capture de requêtes sémantiques larges | Progression du nombre de requêtes uniques générant au moins une impression. | 4 à 8 semaines après refonte sémantique. |
| Éligibilité aux résultats enrichis | Taux de pages valides sans erreur dans le rapport d'état des données structurées. | Immédiat après exploration (3 à 14 jours). |
Découvrez Orova.vn – une plateforme Biz AI Agent dotée de la solution OROVA SEO complète, destinée à tous les sites web. Le système accompagne l'optimisation pour les moteurs de recherche de A à Z, avec les fonctionnalités suivantes : recherche de mots-clés, rédaction de nouveaux articles optimisés pour le SEO, optimisation des contenus existants, suivi des positions, ainsi que l'analyse des concurrents et l'analyse technique approfondie. Inscrivez-vous dès aujourd'hui pour découvrir OROVA SEO entièrement gratuitement (offre valable jusqu'au 7 juillet 2027).
Comment fonctionne l'Entity SEO : anatomie et mise en pratique
Pour comprendre le fonctionnement de l'Entity SEO, il faut décomposer la chaîne par laquelle un moteur de recherche transforme un texte brut en un nœud de connaissances interconnecté.
Extraction et réconciliation des entités par le traitement du langage naturel
Cette première phase extrait les unités de sens d'une page pour lever toute incertitude sur leur signification réelle.
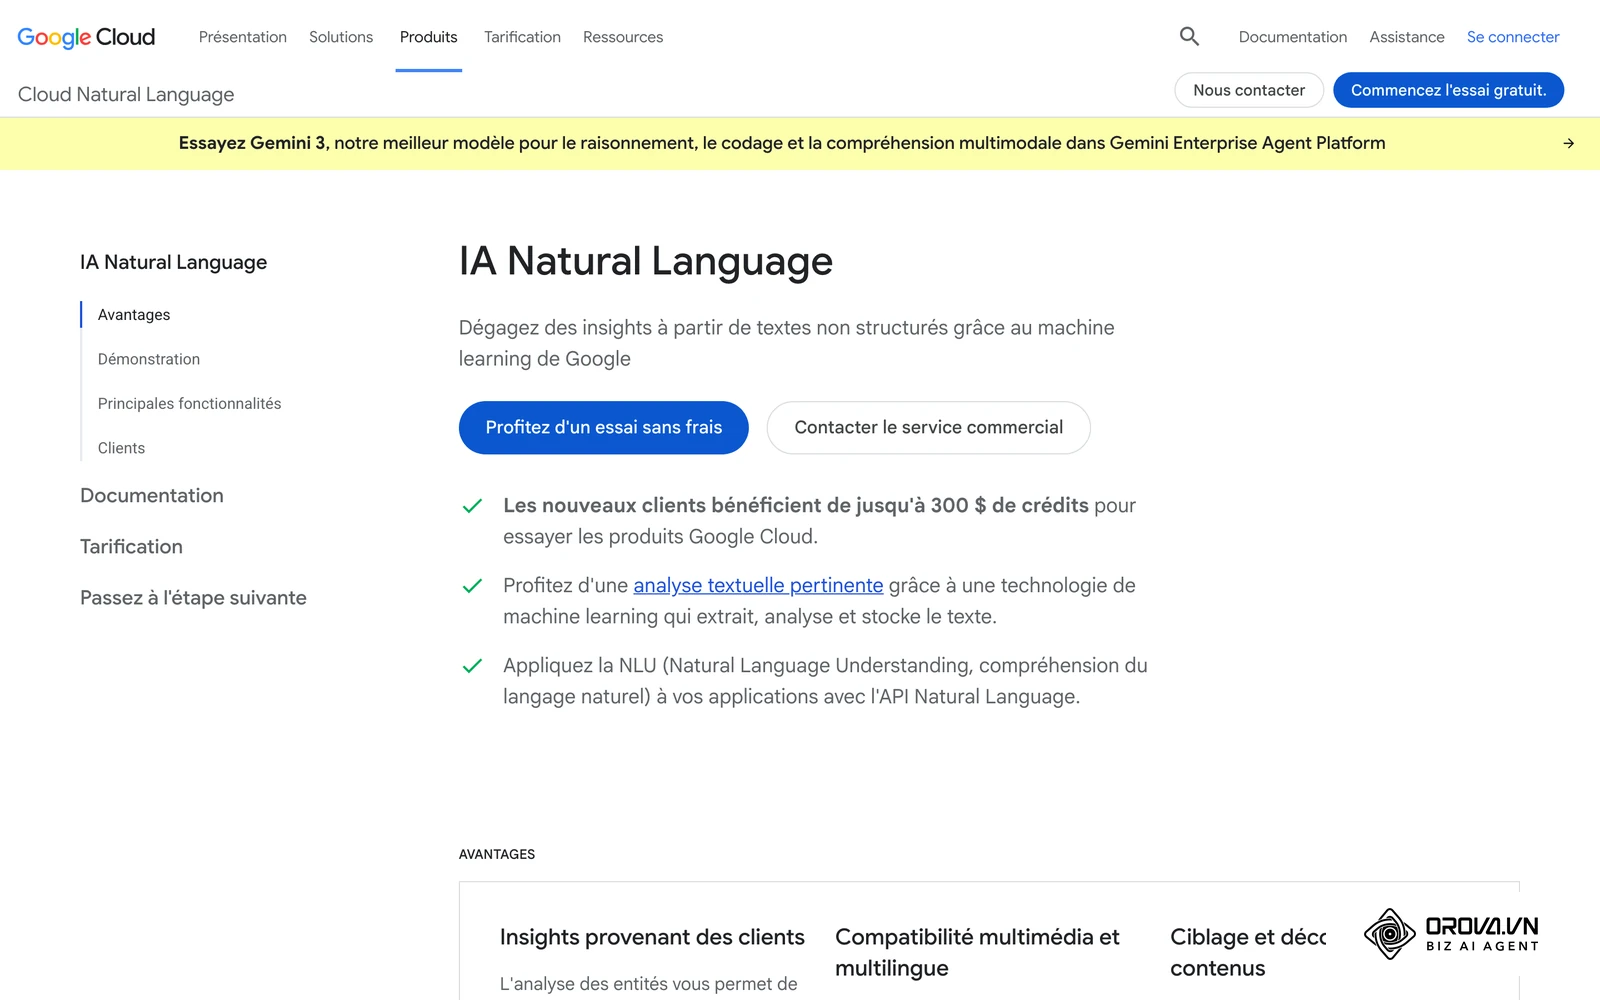
- Rôle : Identifier chaque concept présent dans le texte brut, lui attribuer une catégorie (Personne, Lieu, Organisation, Événement) et calculer sa centralité dans le document.
- Données d'entrée : Le corps de texte HTML non balisé, la structure des titres et les attributs éditoriaux.
- Résultats produits : Une liste d'entités associées à un score de saillance (salience score, compris entre 0,0 et 1,0) et un sentiment contextuel.
- Points de rupture fréquents : Utiliser des termes polysémiques sans fournir leur contexte direct (par exemple, employer « Apple » sans mentionner l'informatique ou l'arboriculture), ce qui provoque une mauvaise catégorisation par les algorithmes de traitement du langage naturel (NLP).
Depuis le lancement du Knowledge Graph, Google décrit sa démarche comme le passage des chaînes de caractères aux « choses » : la pertinence d'un résultat dépend de plus en plus des entités reconnues et de leurs relations dans un graphe de données, plutôt que du simple décompte des occurrences textuelles.
Pour vérifier la manière dont Google analyse vos textes, vous pouvez utiliser l'outil public de démonstration de l'API Google Cloud Natural Language. Lorsque vous collez un texte dans l'interface, le système décompose le contenu et affiche un tableau de données. La colonne maîtresse est le score de saillance : elle indique l'importance relative de l'entité par rapport à l'ensemble du document. Si votre sujet principal obtient un score nettement plus faible qu'une notion secondaire, l'outil vous signale que le texte met davantage en avant ce sujet secondaire. Pour corriger ce biais, placez votre entité principale dès la première phrase, associez-lui des verbes d'action directs et regroupez ses attributs déterminants dans les sous-titres.
Structuration sémantique avancée via Schema.org et JSON-LD
Le balisage technique matérialise les connexions identifiées par le traitement du langage naturel dans un format standardisé et directement assimilable par les robots.
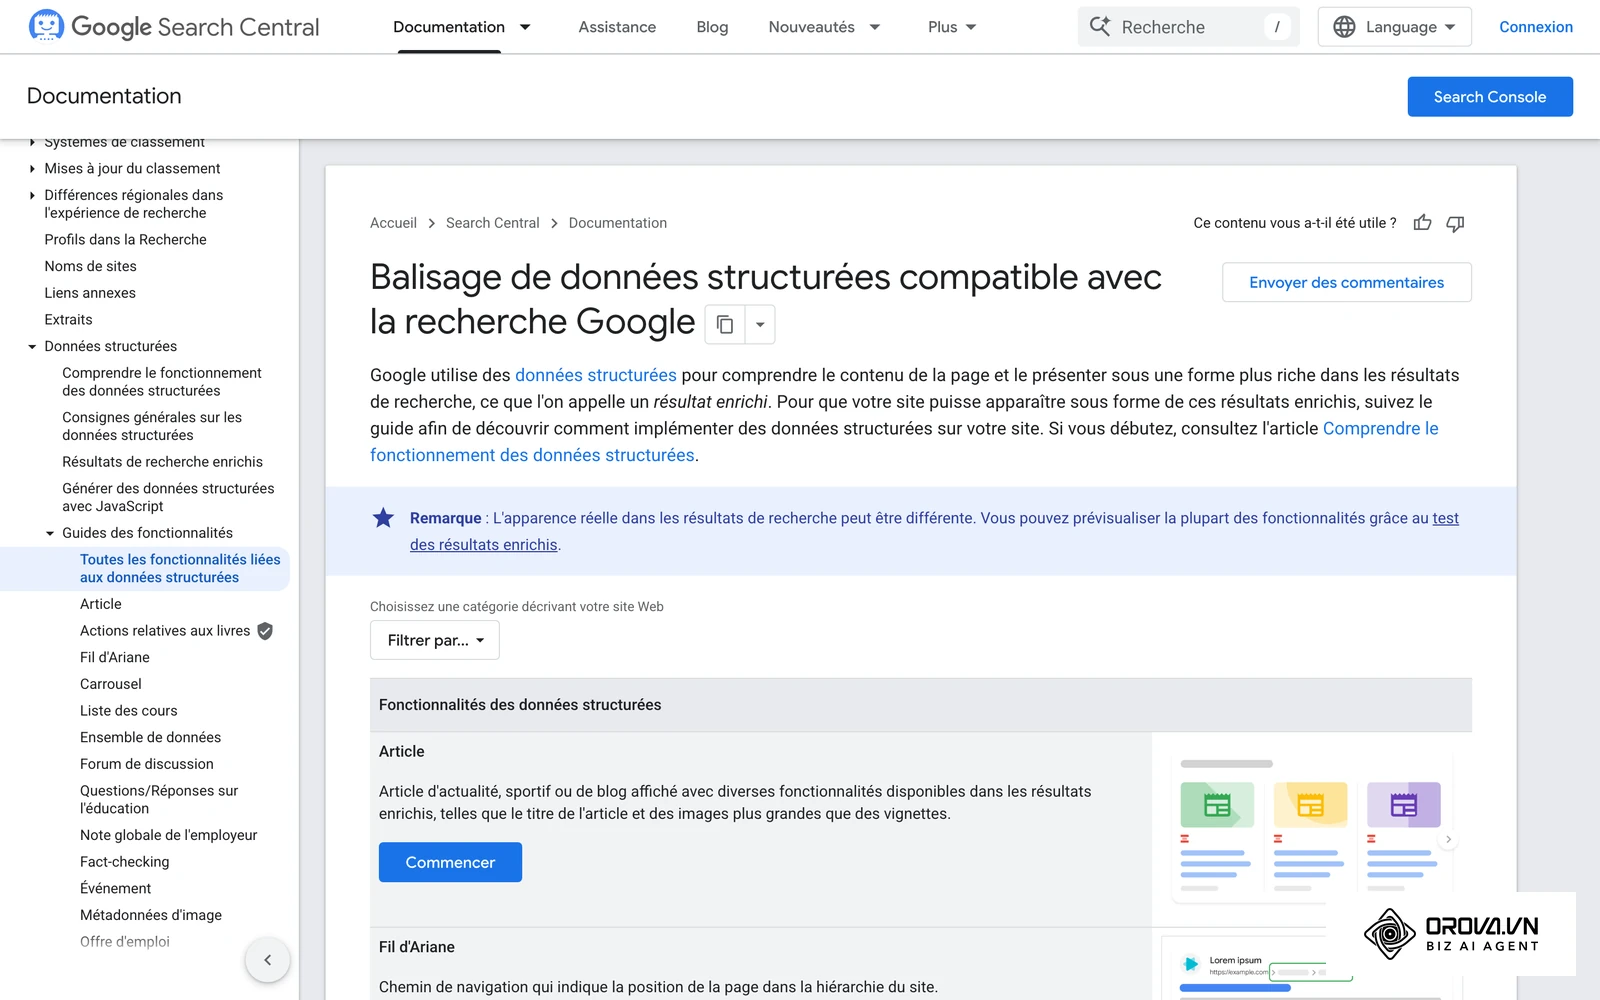
- Rôle : Traduire les relations sémantiques dans la syntaxe formelle Schema.org en utilisant le format JSON-LD (JavaScript Object Notation for Linked Data).
- Données d'entrée : Les identifiants uniques de vos entités (URLs canoniques Wikidata, fiches d'autorités officielles, identifiants d'auteurs).
- Résultats produits : Un bloc de code script inséré dans l'en-tête du document, reliant sans ambiguïté la page aux bases de connaissances mondiales.
- Points de rupture fréquents : Insérer des schémas multiples isolés sans utiliser la propriété @id pour les relier, ou déclarer des URLs de profils sociaux non harmonisées.
D'après la documentation officielle de Schema.org, l'emploi des propriétés sémantiques about, mentions et sameAs permet de lier sans équivoque une ressource web à un identifiant unique issu d'une base de connaissances ouverte comme Wikidata.
Voici un modèle technique complet au format JSON-LD, prêt à être adapté pour un article d'expertise :
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Organization",
      "@id": "https://votresite.com/#organization",
      "name": "Nom de Votre Entreprise",
      "url": "https://votresite.com",
      "logo": {
        "@type": "ImageObject",
        "@id": "https://votresite.com/#logo",
        "url": "https://votresite.com/assets/logo.png"
      },
      "sameAs": [
        "https://www.wikidata.org/wiki/Q11111111",
        "https://fr.linkedin.com/company/votre-entreprise"
      ]
    },
    {
      "@type": "Person",
      "@id": "https://votresite.com/auteurs/jean-dupont/#person",
      "name": "Jean Dupont",
      "jobTitle": "Directeur Technique SEO",
      "worksFor": {
        "@id": "https://votresite.com/#organization"
      },
      "sameAs": [
        "https://www.wikidata.org/wiki/Q22222222",
        "https://twitter.com/jeandupont_seo"
      ]
    },
    {
      "@type": "Article",
      "@id": "https://votresite.com/blog/guide-entity-seo/#article",
      "isPartOf": {
        "@type": "WebPage",
        "@id": "https://votresite.com/blog/guide-entity-seo/#webpage",
        "url": "https://votresite.com/blog/guide-entity-seo",
        "name": "Guide complet de l'Entity SEO"
      },
      "headline": "Entity SEO : principes et mise en pratique de l'optimisation sémantique",
      "inLanguage": "fr-FR",
      "author": {
        "@id": "https://votresite.com/auteurs/jean-dupont/#person"
      },
      "publisher": {
        "@id": "https://votresite.com/#organization"
      },
      "about": [
        {
          "@type": "Thing",
          "name": "Search engine optimization",
          "sameAs": "https://www.wikidata.org/wiki/Q180711"
        },
        {
          "@type": "Thing",
          "name": "Knowledge Graph",
          "sameAs": "https://www.wikidata.org/wiki/Q648625"
        }
      ],
      "mentions": [
        {
          "@type": "Thing",
          "name": "Natural Language Processing",
          "sameAs": "https://www.wikidata.org/wiki/Q30642"
        },
        {
          "@type": "Thing",
          "name": "Schema.org",
          "sameAs": "https://www.wikidata.org/wiki/Q3475322"
        }
      ]
    }
  ]
}
Dans ce bloc de code, l'attribut about désigne le sujet principal du document, tandis que mentions répertorie les concepts secondaires abordés en cours de texte. Chacune de ces entités est rattachée à son identifiant canonique Wikidata grâce à la propriété sameAs, dissipant toute ambiguïté pour les moteurs.
L'analyse des écarts d'entités face aux concurrents
L'audit traditionnel des écarts de mots-clés cherche des expressions absentes dans votre texte. L'analyse des écarts d'entités (Entity Gap Analysis) recherche quant à elle les concepts indispensables dont l'absence dégrade la légitimité sémantique globale de votre document.
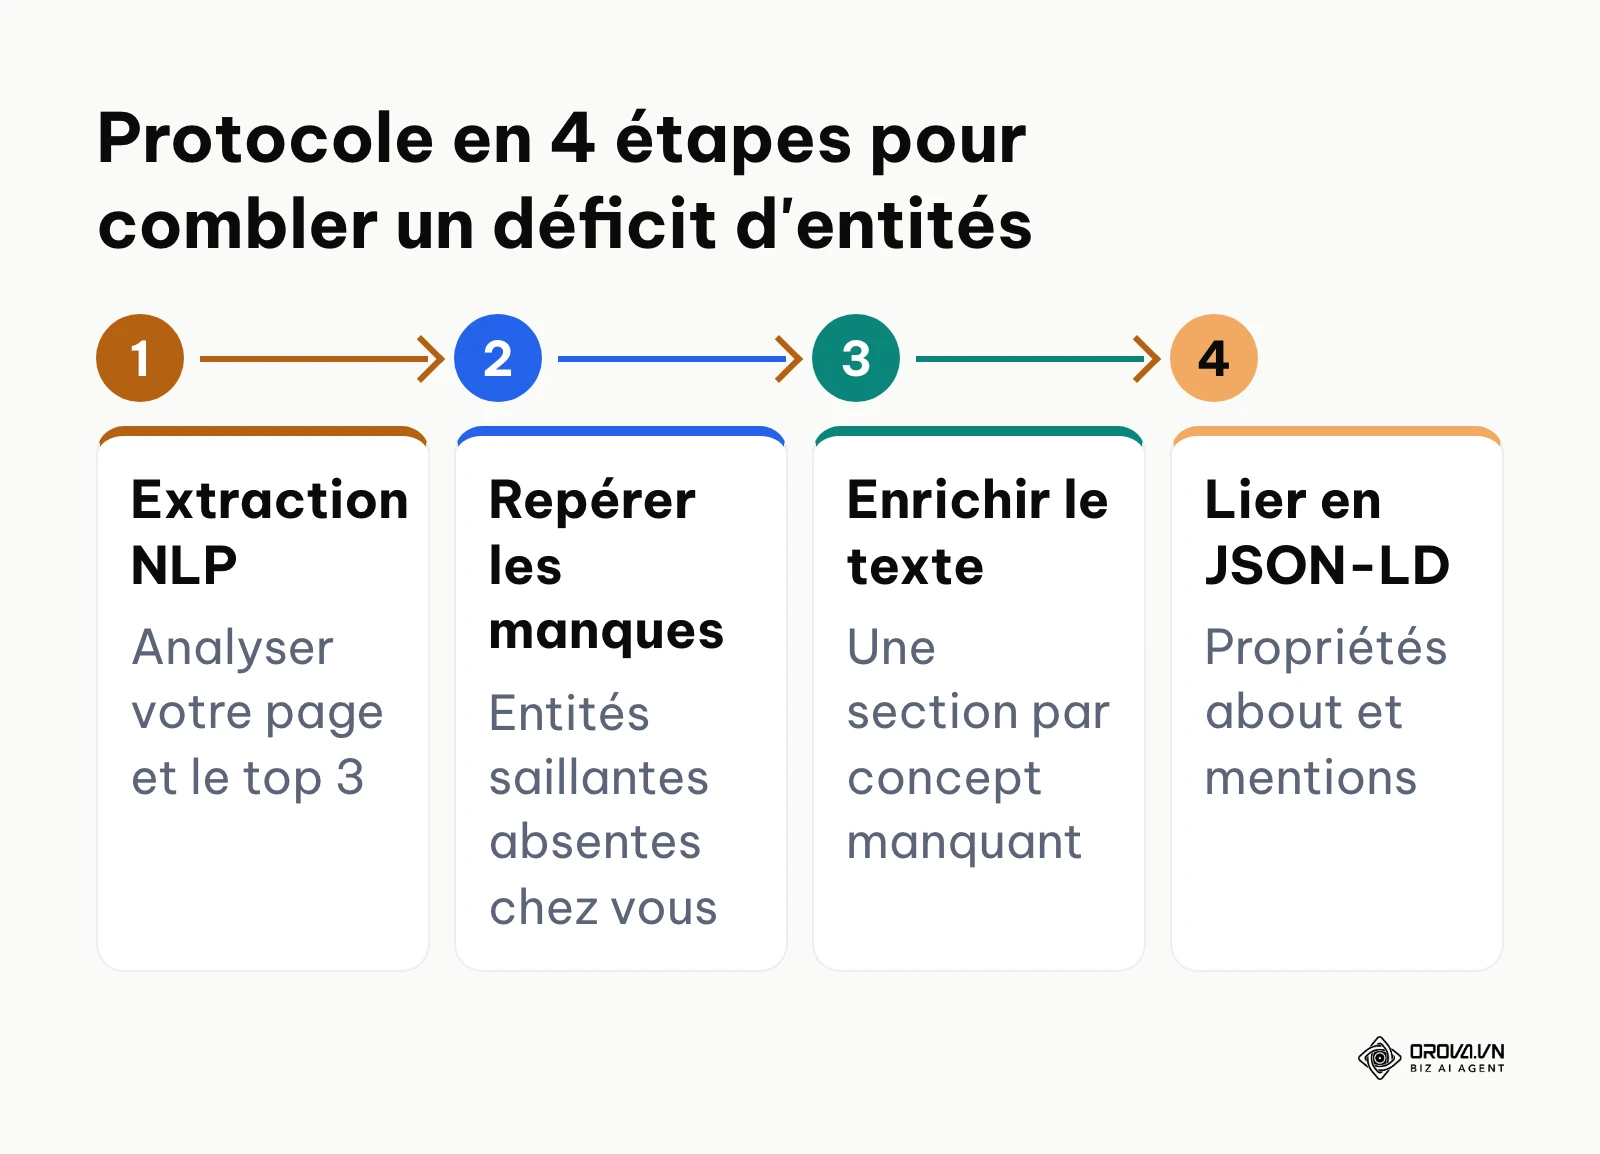
Le schéma de cette section détaille les quatre phases indispensables pour identifier et rattraper les carences sémantiques vis-à-vis des pages concurrentes les mieux positionnées.
Le processus se déroule selon quatre étapes précises :
- Extraction comparative : Soumettez l'URL de votre page et les trois premières URLs concurrentes de la page de résultats à l'outil de démonstration NLP de Google pour extraire l'ensemble des entités reconnues.
- Identification des co-occurrences : Dressez un tableau répertoriant les entités présentes chez vos concurrents avec un score de saillance supérieur à 0,05, mais totalement absentes de votre page.
- Comblement éditorial contextualisé : Rédigez un paragraphe ou une sous-section dédiée pour intégrer chaque concept manquant en explicitant son lien logique avec l'entité centrale de votre article.
- Validation du maillage interne : Créez des liens internes SEO depuis d'autres articles de votre site traitant précisément de ces entités secondaires pour consolider la structure thématique d'ensemble.
Exemple illustratif : un site e-commerce de matériel d'escalade peinait à positionner ses guides d'achat au-delà de la troisième page sur les requêtes à forte intention commerciale. L'équipe technique a extrait les entités des 3 pages concurrentes les mieux positionnées à l'aide de l'outil de traitement du langage naturel de Google, constatant un déficit flagrant sur les entités de normes de sécurité (telles que « UIAA » et « EN 892 »). En restructurant les pages autour d'un nœud sémantique central et en associant chaque modèle à sa norme officielle par des données structurées, le site rend ses pages de conseils plus complètes sur le plan sémantique, sans modifier son budget de liens externes.
Typologie des entités et structuration sémantique
Dans une stratégie de référencement sémantique, toutes les entités ne jouent pas le même rôle au sein de votre écosystème numérique :
| Type d'entité | Caractéristiques sémantiques | Cas d'usage recommandé |
|---|---|---|
| Entité de marque (Brand Entity) | Représente l'entreprise elle-même. Doit posséder un point d'ancrage canonique unique (page À propos officielle). | Page d'accueil, profils institutionnels et mentions légales. |
| Entité d'auteur (Person Entity) | Identifie l'expert physique rédigeant le contenu. Détermine directement l'évaluation de la légitimité thématique. | Pages biographiques des rédacteurs et signatures d'articles. |
| Entité de sujet (Topic/Concept Entity) | Désigne le concept théorique ou technique faisant l'objet du contenu éditorial. | Propriété about des articles de fond et guides méthodologiques. |
| Entité contextuelle (Mention Entity) | Éléments périphériques ou outils cités à titre d'exemples dans le raisonnement global. | Propriété mentions des études de cas et comparatifs d'outils. |
Détection du Knowledge Graph et emprunt d'autorité pour les nouveaux sites
Trois questions techniques restent fréquemment sans réponse pour les praticiens abordant l'Entity SEO :
Comment vérifier si Google reconnaît déjà votre site ou votre auteur comme une entité ? Il ne suffit pas de constater l'absence d'un panneau d'information (Knowledge Panel) sur une recherche nominative. Utilisez directement l'API publique Google Knowledge Graph Search. En soumettant le nom exact de votre marque ou de votre auteur à l'aide d'une requête HTTP, vous saurez si Google lui a déjà attribué un identifiant unique (KGMID, commençant généralement par /m/ ou /g/). Si l'API retourne un résultat associé à un score de résultat (resultScore), votre entité existe dans la base de données, même si son niveau de notoriété ne justifie pas encore un affichage public sur la page de résultats.
Combien de mentions sans lien et de citations externes faut-il pour déclencher un Knowledge Panel ? Il n'existe aucun quota chiffré immuable. Le déclenchement dépend de la concordance des sources d'autorité plutôt que du volume brut. Dans la pratique, Google affiche plus volontiers un Knowledge Panel lorsqu'il peut corroborer l'existence de l'entité sur plusieurs sources tierces fiables et concordantes : registres légaux d'entreprises (INSEE, Infogreffe), bases sectorielles spécialisées (Crunchbase, GitHub, DBLP), profils professionnels vérifiés et revues de presse reconnues.
Comment un site récent peut-il emprunter de l'autorité sémantique sans page Wikipédia ? La méthode de l'ancrage par association (Entity Bridging) permet de surmonter ce handicap. Dans vos publications, liez systématiquement vos concepts aux entités majeures et universellement validées de votre secteur à l'aide des propriétés about et mentions pointant vers Wikidata. En démontrant aux algorithmes que votre jeune marque évolue dans le voisinage immédiat d'entités réputées, vous facilitez son intégration dans le sous-graphe thématique de votre industrie.
Checklist d'audit sémantique en 15 critères avant publication
Avant de mettre en ligne un contenu stratégique, vérifiez la conformité de vos signaux sémantiques à l'aide de cette grille de contrôle :
| Critère de validation | Référentiel ou outil de contrôle | Statut requis |
|---|---|---|
| 1. Sujet central identifiable dès les 60 premiers mots | Traitement du langage naturel (NLP Demo) | Saillance supérieure à 0,20 |
| 2. Déclaration formelle du sujet principal | Propriété Schema.org about | Lien Wikidata valide |
| 3. Déclaration des concepts secondaires | Propriété Schema.org mentions | Identifiants d'autorité conformes |
| 4. Identification de l'auteur physique | Propriété Schema.org Person | Lien vers page profil officiel |
| 5. Rattachement de l'auteur à l'organisation | Propriété Schema.org worksFor | Identifiant @id harmonisé |
| 6. Entité organisationnelle canonique | Propriété Schema.org Organization | Profils sociaux via sameAs |
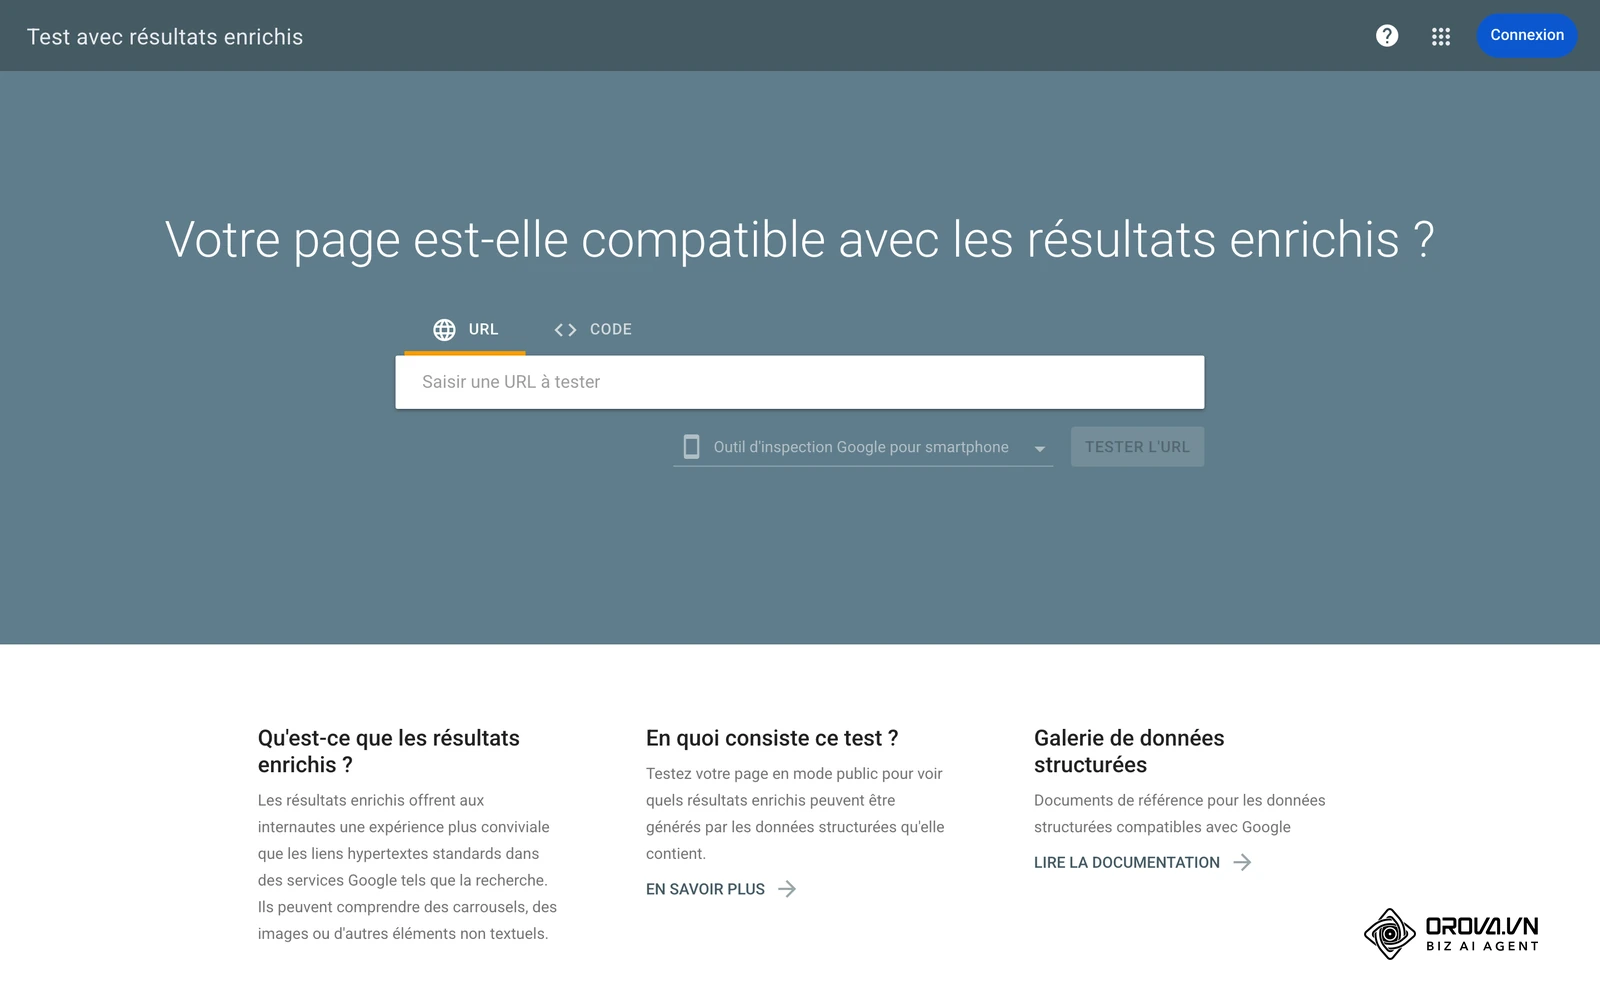
| 7. Absence d'erreurs de syntaxe | Test des résultats enrichis de Google | 0 avertissement bloquant |
| 8. Définition directe sous le premier titre H2 | Format textuel synthétique (40 à 60 mots) | Phrase exploitable par l'IA |
| 9. Concordance des entités concurrentes clés | Audit d'écarts d'entités (Entity Gap) | Écart comblé sur le top 3 |
| 10. Liens internes contextuels vers des pages piliers | Architecture thématique du site | 2 à 4 liens pertinents |
| 11. Ancrage des images dans la thématique | Attribut textuel alternatif des visuels | Entités secondaires nommées |
| 12. Levée des ambiguïtés sémantiques | Propriété disambiguatingDescription | Complétée si terme polysémique |
| 13. Alignement des métadonnées éditoriales | Titre SEO et méta-description | Présence de l'entité centrale |
| 14. Vérification de l'absence de bourrage lexical | Analyse de la fréquence des termes | Distribution naturelle |
| 15. Validation de la page Entity Home liée | URL officielle À propos | Données d'identité identiques |
Comment passer à l'Entity SEO : méthode et plan d'action
La transition vers un référencement par entités ne requiert pas de reconstruire l'intégralité de votre site web en une seule opération. La méthode d'adaptation dépend de votre rôle et de vos prérogatives.
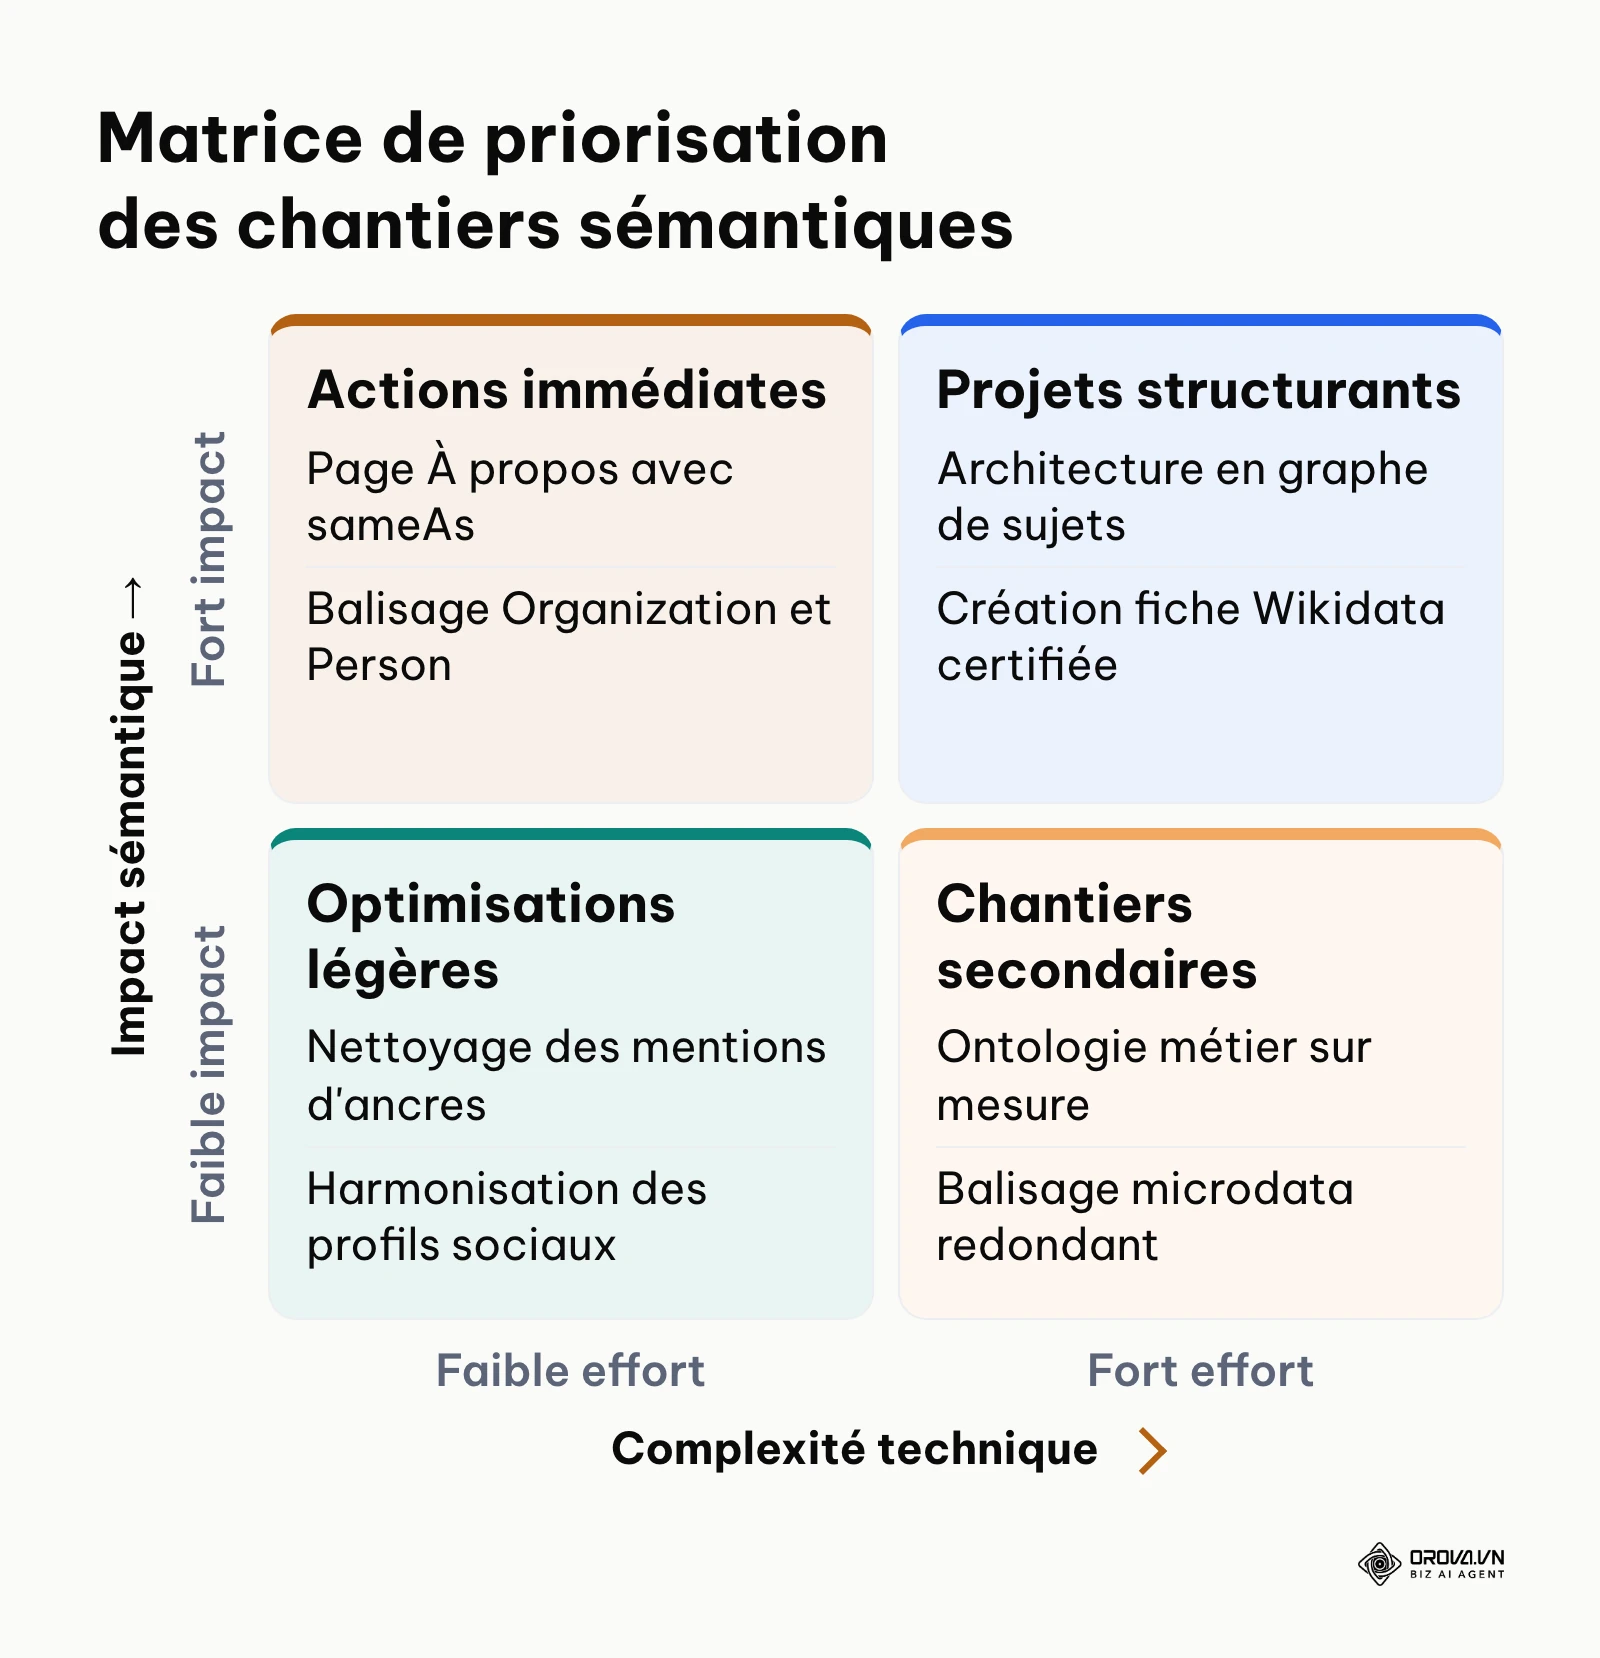
La matrice de cette section permet de classer vos actions prioritaires selon l'effort technique requis et leur portée sur votre graphe de données.
Pour les fondateurs et dirigeants de petites entreprises
Votre priorité consiste à certifier l'existence numérique de votre société avant de produire du volume de contenu.
- Bâtissez une page À propos canonique (Entity Home) : Cette page doit consigner l'ensemble des données d'identité de l'entreprise : raison sociale officielle, numéro d'immatriculation, adresse physique, noms des fondateurs et mission d'activité.
- Harmonisez vos profils d'autorité : Créez ou mettez à jour vos fiches professionnelles (Google Business Profile, LinkedIn, registres sectoriels) en veillant à ce que le nom, l'adresse et le numéro de téléphone soient strictement identiques au caractère près.
- Implémentez un balisage d'organisation basique : Insérez dans l'en-tête de votre page d'accueil le schéma JSON-LD Organization contenant la liste exhaustive de vos profils sociaux via l'attribut sameAs. Cette action peut être réalisée en moins de deux heures au cours de votre première semaine de travail.
Pour les responsables SEO et créateurs de contenu en entreprise
Votre mission consiste à transformer la production éditoriale pour qu'elle réponde aux exigences de l'indexation sémantique.
- Modernisez votre protocole d'analyse de mots-clés : Intégrez systématiquement une étape d'extraction d'entités lors de chaque analyse concurrentielle SEO afin de cartographier les concepts co-occurrents indispensables avant d'entamer la rédaction.
- Standardisez les modèles de données structurées : Créez des gabarits JSON-LD réutilisables dans votre système de gestion de contenu (CMS), configurés pour injecter automatiquement les entités Wikidata correspondant aux catégories de vos articles.
- Optimisez la structure de définition de vos textes : Formulez les réponses aux questions fondamentales sous forme de définitions directes dès les premières phrases suivant vos sous-titres, afin de faciliter leur reprise par les algorithmes de recherche générative.
Pour les consultants indépendants et agences SEO
Votre rôle est d'apporter une valeur technique différenciante à vos clients face à la banalisation des livrables de rédaction automatisée.
- Intégrez l'audit d'entités dans vos diagnostics d'entrée : Présentez à vos clients une cartographie visuelle de leur présence dans le Knowledge Graph et mesurez la saillance sémantique de leurs pages maîtresses.
- Créez et entretenez des profils d'autorité sectoriels : Guidez vos clients dans la soumission de fiches vérifiées sur les répertoires spécialisés de leur branche d'activité afin d'alimenter les sources de corroboration de Google.
- Formez les équipes de rédaction aux relations sémantiques : Sensibilisez les rédacteurs à l'importance des co-occurrences conceptuelles et à l'usage des identifiants pérennes.
Exemple illustratif : une agence de marketing numérique accompagnant un cabinet d'avocats régional cherchait à faire apparaître son client dans les panneaux d'information locaux sans disposer de page Wikipédia. L'équipe a rédigé une page biographique exhaustive (Entity Home) intégrant des liens sameAs pointant vers le barreau officiel, l'annuaire de l'ordre et le registre national du commerce. Le blocage initial venait de données divergentes sur les profils sociaux du cabinet, corrigées en harmonisant strictement les dénominations et coordonnées sur l'ensemble du web. Ce type de mise en cohérence augmente les chances que Google affiche un Knowledge Panel lors des recherches sur la marque, sans que le délai puisse être garanti.
| Erreur fréquente | Conséquence directe | Solution recommandée |
|---|---|---|
| Créer une fiche Wikidata sans sources secondaires | Suppression rapide de l'élément par les modérateurs bénévoles de la plateforme. | Réunir au préalable trois articles de presse nationale centrés sur l'entreprise avant toute publication. |
| Injecter des dizaines de balises Schema sans hiérarchie | Conflits de lecture pour les robots et dilution du signal sémantique principal. | Utiliser un graphe unifié (@graph) reliant l'article à l'organisation et à l'auteur via leurs identifiants @id. |
| Balisage identique sur des pages traitant de sujets différents | Confusion des algorithmes sur la spécialisation réelle de chaque URL. | Personnaliser rigoureusement les attributs about et mentions pour chaque contenu éditorial. |
Avec OROVA.VN et le module OROVA SEO, vous mettez définitivement fin aux journées épuisantes de travail manuel. Au lieu de passer des heures à rédiger des articles et à préparer des rapports, l'ensemble du processus est désormais optimisé et bouclé en seulement 5 minutes.
Tendances de l'Entity SEO dans les prochaines années : l'avis de l'auteur
Les signaux observables aujourd'hui, à l'horizon 2026, montrent que les moteurs de recherche ne se contentent plus d'indexer des pages web : ils synthétisent directement l'information pour formuler des réponses autonomes.
L'érosion programmée de l'indexation basée sur les mots-clés textuels. Selon mon analyse, la prépondérance des chaînes de caractères dans l'évaluation de la pertinence devrait continuer de reculer. Les architectures algorithmiques privilégient déjà les représentations vectorielles denses (embeddings) où chaque entité possède une signature mathématique fixe au sein d'un espace conceptuel. Je m'attends à ce que les mises à jour algorithmiques pénalisent davantage les contenus articulés autour de variations synonymiques artificielles. Pour vous préparer à cette bascule, vous devez concevoir vos pages comme des nœuds d'information répondant à un besoin précis, en liant chaque affirmation à des entités vérifiées. Ce constat pourrait toutefois se révéler inexact si les coûts de calcul nécessaires au traitement sémantique en temps réel devenaient prohibitifs pour les moteurs sur des millions de requêtes quotidiennes.
L'émergence des agents intelligents comme intermédiaires exclusifs. Mon analyse suggère que les moteurs de recherche génératifs (Google AI Overviews, Perplexity, ChatGPT Search) pourraient devenir, pour une part croissante des recherches, l'interface principale d'accès à l'information. Dans ce contexte, l'Entity SEO me semble l'un des leviers les plus solides pour qu'une marque soit citée comme source dans les synthèses des assistants. Une organisation mal identifiée comme entité sur son domaine risque d'être moins souvent reprise par ces moteurs. Il convient donc dès aujourd'hui de documenter minutieusement vos publications avec des données structurées et des sources d'autorité externes.
La décentralisation des bases de connaissances. Je pense que la dépendance quasi-exclusive des moteurs envers Wikipédia et Wikidata va progressivement s'atténuer au profit de graphes de connaissances décentralisés et certifiés par des signatures cryptographiques ou des registres de confiance professionnels. Les entreprises capables de publier leurs propres graphes de données au format linked data (données liées) pourraient en tirer un avantage pour asseoir leur légitimité thématique.
Questions fréquentes sur l'Entity SEO
L'Entity SEO est-il encore nécessaire face au développement des moteurs IA ?
Oui, l'Entity SEO est encore plus indispensable avec l'avènement des moteurs fondés sur l'intelligence artificielle. Les modèles de langage ne lisent pas les pages web comme des utilisateurs humains, mais s'appuient sur des graphes de connaissances pour vérifier la véracité des faits avant de formuler des réponses. Si votre contenu n'est pas structuré autour d'entités reconnaissables, les moteurs génératifs ne pourront pas extraire vos informations avec un niveau de certitude suffisant pour vous citer en référence.
Quelle est la différence concrète entre un mot-clé et une entité sémantique ?
Un mot-clé est une suite de caractères typographiques pouvant avoir plusieurs sens selon le contexte dans lequel il est employé. Une entité est un concept ou un objet unique, non ambigu et rattaché à une définition universelle indépendante de la langue utilisée. Par exemple, le mot-clé « mercure » peut désigner un métal lourd, une planète du système solaire ou une divinité romaine, tandis que l'entité Wikidata Q925 renvoie exclusivement à l'élément chimique.
Faut-il obligatoirement posséder une page Wikipédia pour réussir en Entity SEO ?
Non, posséder une page Wikipédia n'est absolument pas obligatoire pour structurer ses entités. La très grande majorité des entreprises et des spécialistes reconnus ne répondent pas aux critères d'admissibilité stricts de l'encyclopédie collaborative. En revanche, vous pouvez créer un élément sur Wikidata s'il dispose de sources secondaires suffisantes, ou faire reconnaître votre entité en consolidant vos profils sur des registres officiels, des bases professionnelles et une page Entity Home exhaustive sur votre propre site.
Le balisage Schema.org suffit-il à lui seul pour valider une entité ?
Non, le balisage Schema.org n'est qu'un langage de communication servant à déclarer vos entités auprès des robots d'exploration. Si les affirmations contenues dans votre balisage ne sont pas corroborées par des sources externes de confiance et une réputation en ligne concordante, Google n'accordera aucune autorité à vos déclarations. Les données structurées facilitent la lecture des algorithmes, mais ne remplacent pas la légitimité réelle d'une marque.
Comment savoir si Google a attribué un identifiant Knowledge Graph à mon site ?
Vous pouvez interroger l'API publique Google Knowledge Graph Search à l'aide de votre clé d'API Google Cloud en soumettant le nom exact de votre marque. Si la réponse contient un champ itemListElement comportant un identifiant de type @id: "kg:/m/..." ou "kg:/g/...", cela signifie que Google dispose déjà d'un nœud pour votre entité dans sa base de données.
Par où commencer avec l'Entity SEO ?
La mise en application de l'optimisation sémantique doit s'adapter à la situation technique de votre site web. Voici l'unique priorité à accomplir lors d'une première session de travail d'une demi-journée selon votre niveau d'avancement :
Si vous partez de zéro sans aucun balisage sémantique, votre première action consiste à créer ou restructurer votre page À propos en tant que source officielle d'identité. Rédigez-y une présentation factuelle et détaillée de votre entreprise en y intégrant vos mentions légales complètes, puis implémentez un bloc Schema.org Organization reliant directement vos profils professionnels certifiés via la propriété sameAs.
Si vous possédez déjà des contenus mais que vos entités sont fragmentées, votre première action consiste à soumettre votre page éditoriale la plus stratégique à l'outil public de démonstration de Google Cloud Natural Language API. Identifiez l'entité centrale qui s'en dégage et modifiez votre texte ainsi que vos sous-titres pour que son score de saillance devienne le plus élevé du document, avant de lui assigner son identifiant Wikidata au sein d'une propriété about.
Si vous avez déjà déployé des données structurées sans mesurer leur impact, votre première étape consiste à tester l'existence de votre marque dans l'API Google Knowledge Graph Search pour vérifier si un identifiant unique vous a été attribué. Vous pourrez ensuite auditer la cohérence de vos déclarations d'auteurs et d'organisations dans le rapport officiel d'état des données structurées de Google Search Console.
En ancrant vos contenus dans un réseau de concepts vérifiables et interconnectés, vous construisez une autorité durable qui immunise votre site contre la volatilité des moteurs traditionnels et assure votre visibilité sur le long terme grâce à l'entity SEO.
About the author
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Pilotez votre activité avec des AI Agents
Orova est le Biz AI Agent qui ne s'arrête jamais : il planifie, exécute et optimise le travail à votre place.
Gagnez du temps, gagnez en efficacité.