
La cannibalisation SEO : le guide complet (et l'arbre de décision) pour sauver vos classements
La cannibalisation SEO survient quand plusieurs pages d'un même site visent le même mot-clé et la même intention, si bien que Google hésite entre elles et qu'aucune ne se classe bien. Vous avez peut-être passé des mois à rédiger du contenu, à publier de nouveaux articles chaque semaine, et pourtant, votre trafic organique stagne. Pire encore, lorsque vous vérifiez les résultats de recherche, vos pages semblent jouer aux chaises musicales : un jour, c'est votre page de vente qui apparaît, le lendemain, c'est un vieil article de blog qui prend sa place, bien plus bas dans les classements. Ce comportement erratique est le symptôme classique d'un problème technique sévère que de nombreux webmasters ignorent ou gèrent mal.
Pendant longtemps, la croyance populaire consistait à penser qu'avoir plusieurs pages sur le même sujet augmentait les chances d'être visible. C'est faux. Aujourd'hui, cette abondance non structurée perturbe les algorithmes et dilue l'autorité de votre domaine. Ce guide technique approfondi va vous fournir une méthodologie claire, incluant un arbre de décision précis et des modèles d'audit, pour diagnostiquer, comprendre et résoudre définitivement la cannibalisation SEO sur votre site, qu'il s'agisse d'un blog naissant ou d'une plateforme e-commerce complexe.
Qu'est-ce que la cannibalisation SEO ?
La cannibalisation SEO est un phénomène technique où plusieurs pages d'un même site web se font concurrence pour le même mot-clé sur les moteurs de recherche. Elle sert initialement d'indicateur d'un contenu mal structuré et se distingue de la simple duplication par son impact direct sur la division des clics.
Historiquement, le terme vient de l'idée qu'une page "dévore" littéralement le trafic, les impressions et l'autorité d'une autre page appartenant au même domaine. À l'époque où les algorithmes étaient moins sophistiqués, accumuler des mots-clés sur différentes pages fonctionnait. Aujourd'hui, les moteurs exigent une intention unique par page.
Il est fréquent de confondre ce concept avec d'autres erreurs SEO. Voici un tableau pour clarifier les nuances :
| Concept | Différence clé | Exemple concret |
|---|---|---|
| Cannibalisation SEO | Concurrence sur une même intention de mot-clé, divisant le classement. | Deux articles distincts : "Guide des chaussures" et "Comment choisir ses chaussures". |
| Duplicate Content (Contenu dupliqué) | Blocs de texte exactement identiques copiés sur plusieurs URL. | Un même paragraphe de description collé sur 50 fiches produits différentes. |
| Keyword Stuffing (Bourrage) | Répétition abusive et non naturelle d'un mot-clé sur une seule page. | "Achetez nos chaussures pas chères car ces chaussures pas chères sont les meilleures chaussures." |
Pour illustrer de manière simple, imaginez un magasin physique. Vous entrez pour acheter un téléviseur. Si deux vendeurs de la même boutique vous sautent dessus simultanément, chacun essayant de vous convaincre d'acheter le même modèle mais avec des arguments légèrement différents, vous finirez probablement par être confus et quitter le magasin sans rien acheter. Sur Google, les vendeurs sont vos pages web, et le client est le moteur de recherche : face à la confusion, il préférera envoyer le trafic chez votre concurrent qui ne présente qu'une seule page experte et claire.
Pourquoi la cannibalisation SEO est-elle un problème stratégique ?
La cannibalisation SEO existe comme un signal d'alarme. Elle met en lumière un problème fondamental de gouvernance éditoriale et d'architecture technique. Dans la vaste cartographie d'une stratégie SEO, la prévention de la cannibalisation intervient immédiatement après la recherche de mots-clés et avant la phase de production de contenu. Elle s'assure que chaque nouvelle pièce ajoutée à votre site possède un territoire sémantique exclusif.
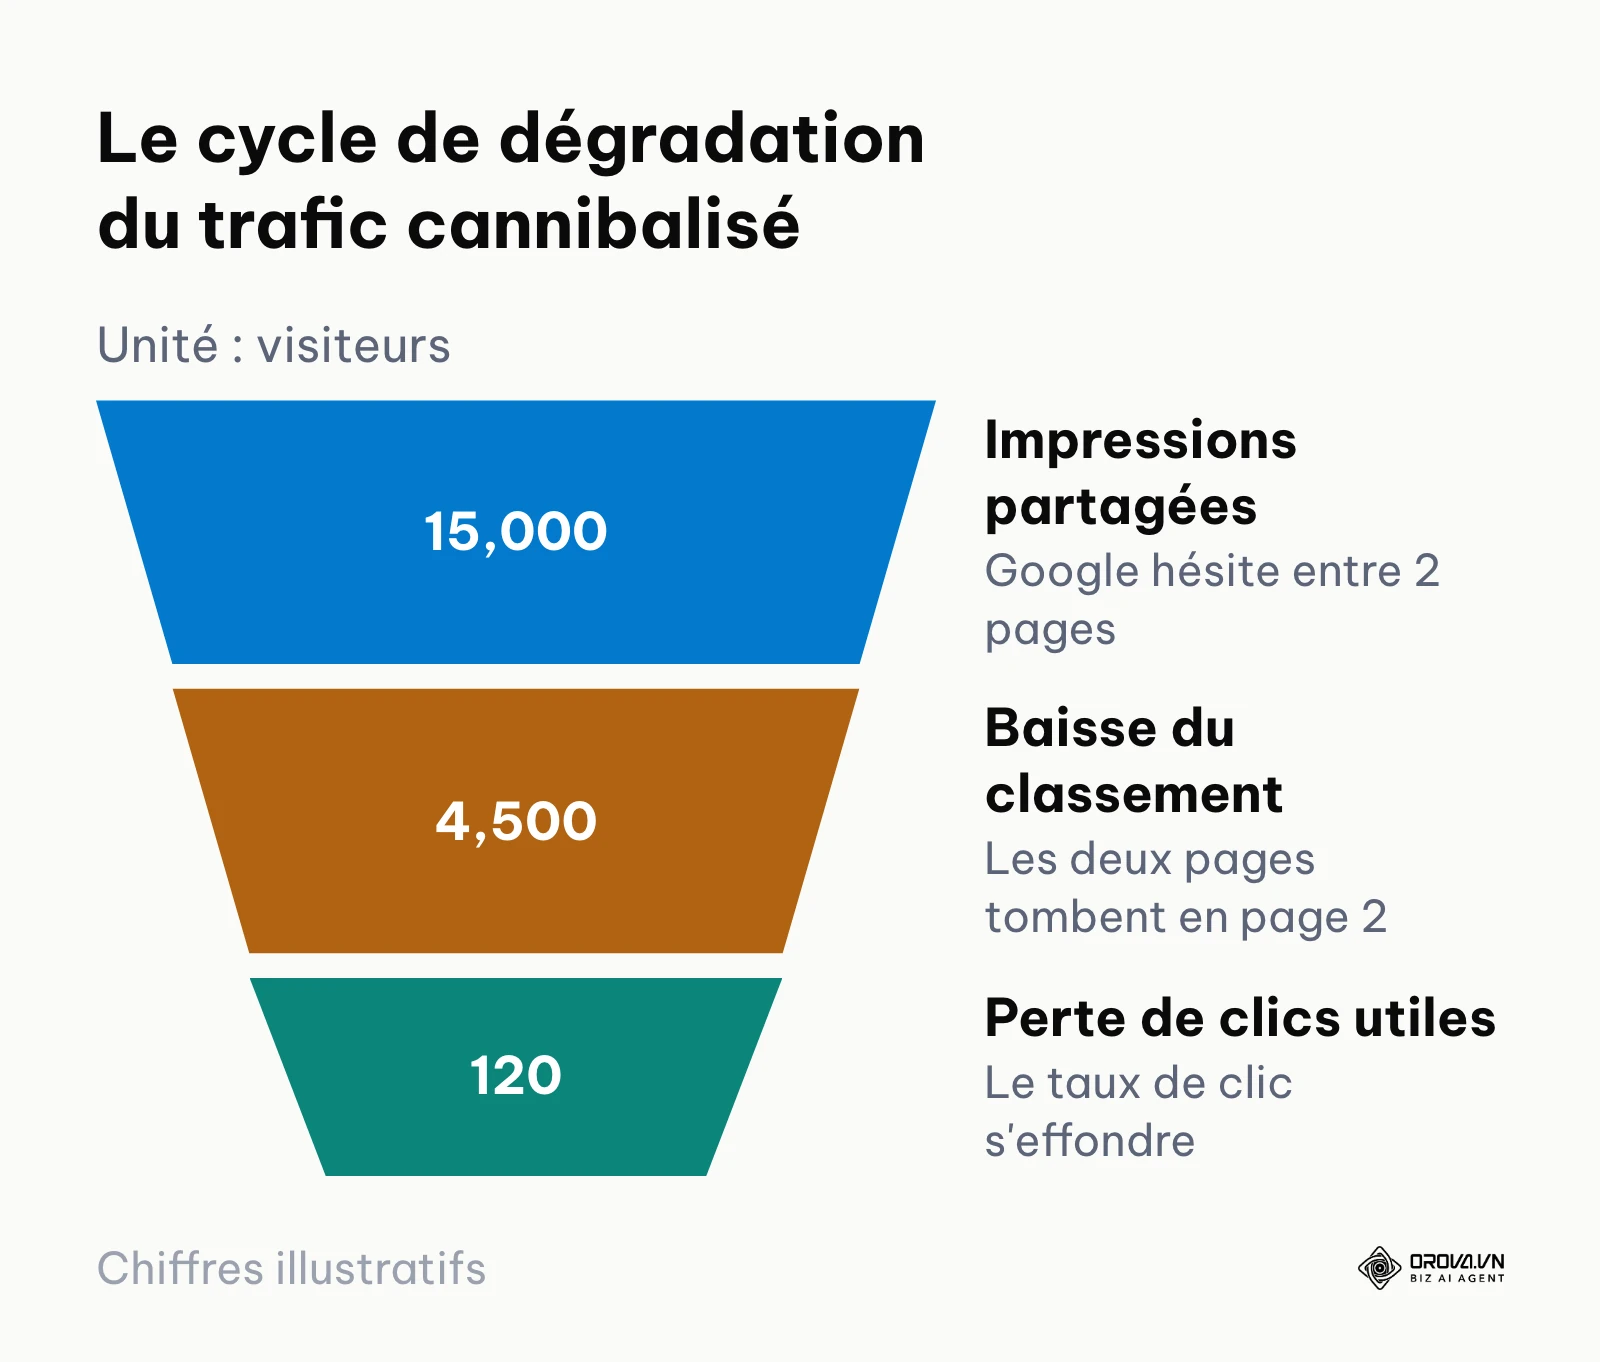
Ce phénomène affecte principalement les responsables marketing, les éditeurs de contenu et les propriétaires de sites e-commerce qui produisent du volume sans cartographie préalable. Le moteur de recherche, disposant d'un budget d'exploration (crawl budget) limité pour votre domaine, perd un temps précieux à analyser de multiples pages similaires. Au lieu de comprendre rapidement quelle est votre page "pilier" ultime, l'algorithme divise les signaux de pertinence.
Si vous ignorez ce problème, les conséquences sont désastreuses. Vous perdez la synergie de vos liens entrants (backlinks) : si le site A fait un lien vers votre article 1, et le site B fait un lien vers votre article 2, la puissance est divisée par deux. Vous subissez également une baisse drastique du taux de conversion, car la page qui se classe par accident n'est souvent pas celle optimisée pour vendre. En fin de compte, vous gaspillez vos ressources à maintenir en vie des pages parasites qui tirent l'ensemble de votre domaine vers le bas.
Quand ne pas s'en soucier ? Il existe des cas où corriger la cannibalisation n'est pas prioritaire. Premièrement, pour les requêtes liées à votre propre marque, occuper plusieurs positions dans le top 3 est stratégique pour dominer l'espace visuel et repousser les concurrents. Deuxièmement, si deux pages se font concurrence sur un mot-clé à très faible volume de recherche, le temps investi techniquement pour les fusionner dépassera largement le gain de trafic attendu. Dans ces scénarios, laissez les pages telles quelles et concentrez-vous sur des mots-clés commerciaux à fort enjeu.
Bénéfices d'une résolution de la cannibalisation SEO
Traiter les conflits d'URL ne consiste pas seulement à faire le ménage ; c'est une opération chirurgicale visant à restaurer la rentabilité de votre acquisition organique. Les avantages se ressentent à deux niveaux distincts : une amélioration directe des indicateurs financiers pour l'entreprise et un soulagement opérationnel majeur pour les équipes techniques et éditoriales.
Réduction drastique du gaspillage de budget de crawl (Bénéfice Entreprise)
Pour une entreprise, particulièrement dans le secteur du e-commerce, chaque ressource compte. Les moteurs de recherche allouent un temps limité à l'exploration d'un site. Avant la résolution, les robots d'indexation perdent un temps infini à visiter des milliers d'URL générées par des filtres ou des articles redondants, retardant ainsi la découverte de vos nouveaux produits à forte marge. Après avoir purgé et fusionné les pages cannibales, le budget de crawl est concentré sur les pages génératrices de revenus. Le retour sur investissement technique est massif, car les nouveaux contenus sont indexés beaucoup plus rapidement, réduisant le délai de mise sur le marché (Time to Market) de vos offres.
Consolidation de l'autorité et hausse du taux de conversion (Bénéfice Entreprise)
La division des signaux est un risque financier. Avant la résolution, un internaute cherchant à acheter un logiciel peut atterrir sur un vieil article de blog informatif sans bouton d'achat, simplement parce que cet article "cannibalise" la page de tarification. Le trafic est là, mais les ventes sont nulles. En redirigeant stratégiquement l'autorité de l'article vers la page commerciale ou en redéfinissant l'intention de recherche, vous canalisez le flux de visiteurs directement vers le tunnel de vente. L'entreprise observe souvent une baisse du trafic global (car les pages inutiles disparaissent) compensée par une explosion du taux de conversion.
Exemple illustratif : Un responsable SEO interne pour un éditeur de logiciels B2B.
- Le contexte : Le site possédait 5 articles de blog moyens, générant chacun quelques visites par mois sur la thématique de la facturation électronique, mais aucun ne dépassait la page 2 de Google. Le taux de rebond était de 85%.
- Les étapes réalisées : Le responsable a extrait les données de trafic, sélectionné l'article le plus performant, et a réécrit son contenu pour inclure les informations des 4 autres. Il a ensuite configuré des redirections 301 définitives des 4 anciens articles vers le nouveau "Guide Ultime". Il a mis à jour les liens internes pointant vers les anciennes URL.
- Les obstacles et solutions : L'obstacle principal fut la peur de supprimer du contenu. Pour rassurer la direction, il a procédé par étapes sur un petit groupe d'articles d'abord.
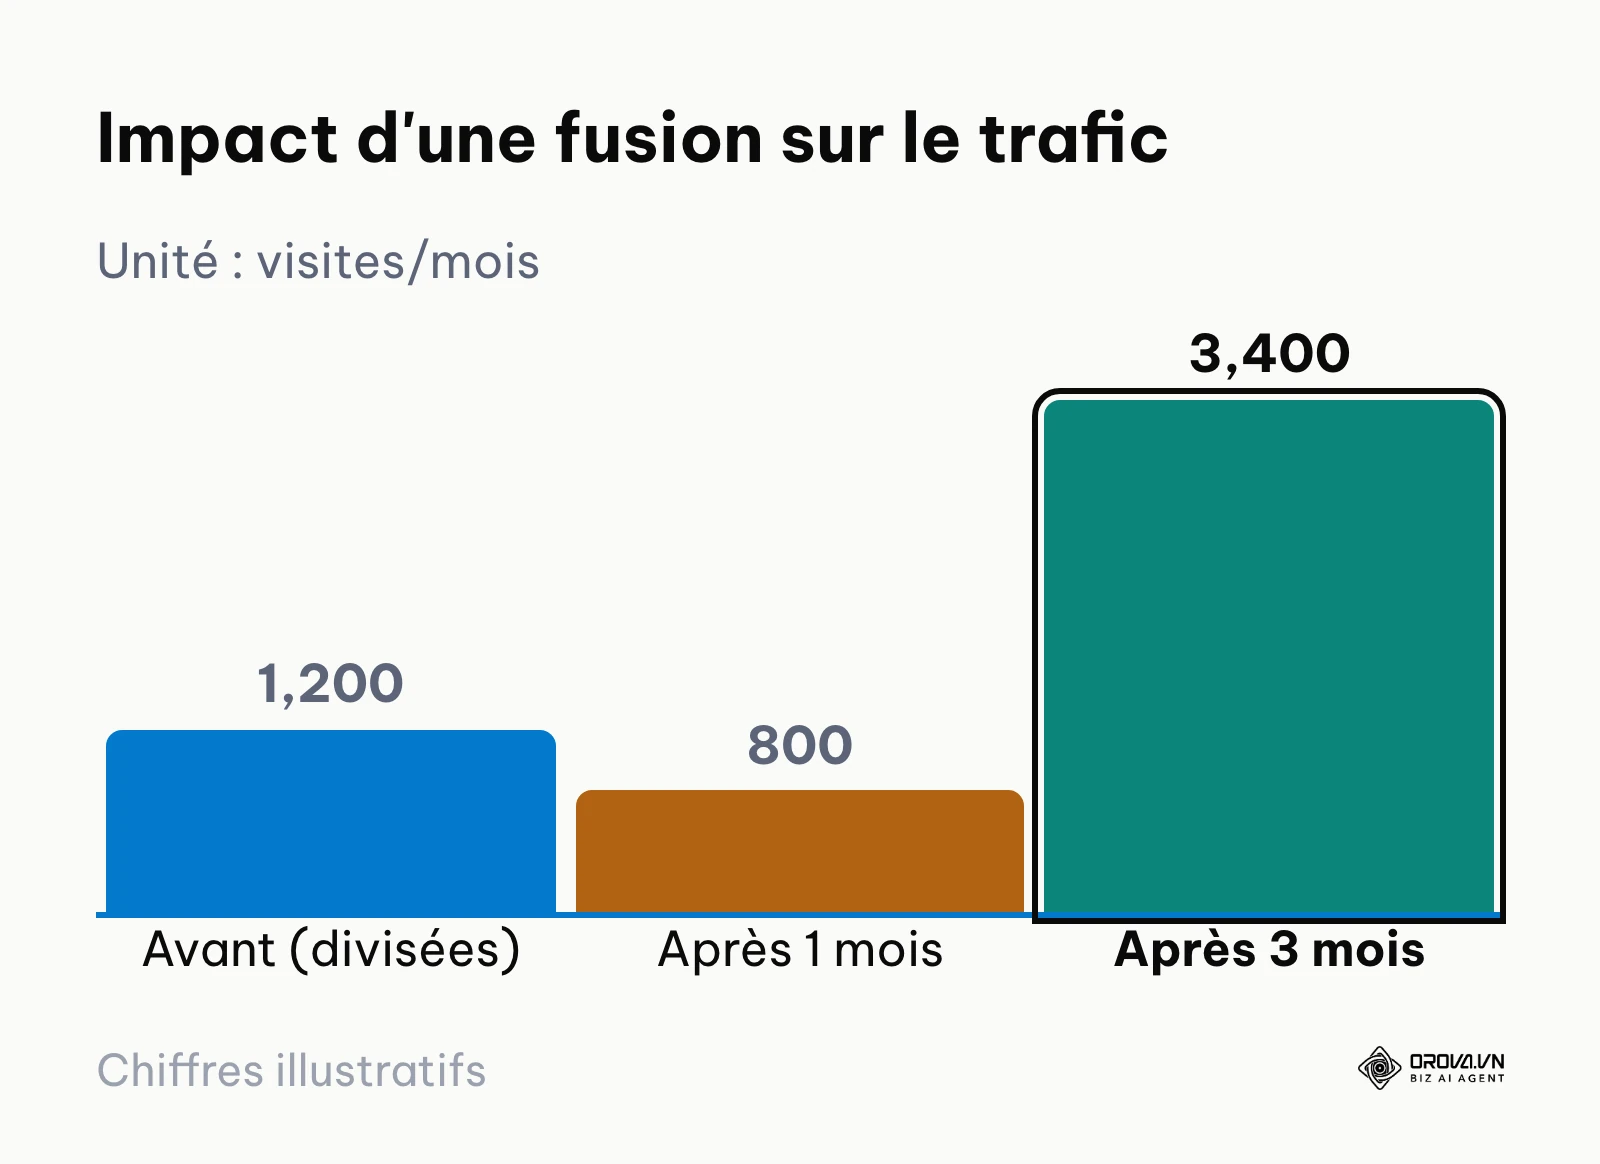
- Le résultat : Après trois mois, au lieu d'avoir 5 articles invisibles, le nouveau guide unique a atteint le top 3 national, multipliant par quatre le nombre de formulaires de contact générés.
Clarté éditoriale et gain de temps analytique (Bénéfice Opérationnel)
Pour les rédacteurs et les référenceurs, la cannibalisation crée un chaos quotidien. Avant de nettoyer le site, l'équipe passe des heures chaque mois à analyser des rapports de trafic incompréhensibles, se demandant pourquoi une page performe un jour et s'effondre le lendemain. La prise de décision est paralysée. Après la résolution et la mise en place d'une gouvernance stricte (une intention = une page), la création de contenu devient fluide. Les rédacteurs savent exactement quels sujets ont déjà été couverts et comment s'intégrer dans le maillage interne sans détruire le travail passé.
Voici comment mesurer l'impact de ces bénéfices :
| Bénéfice | Indicateur de mesure | Délai d'observation |
|---|---|---|
| Efficacité de l'indexation | Fréquence de passage (Log files), Pages crawlées par jour | 2 à 4 semaines |
| Amélioration du classement | Position moyenne sur un mot-clé précis (Search Console) | 1 à 3 mois |
| Rentabilité du trafic | Taux de conversion (Objectifs GA4), Chiffre d'affaires organique | 3 à 6 mois |
Découvrez Orova.vn – une plateforme Biz AI Agent dotée de la solution OROVA SEO complète, destinée à tous les sites web. Le système accompagne l'optimisation pour les moteurs de recherche de A à Z, avec les fonctionnalités suivantes : recherche de mots-clés, rédaction de nouveaux articles optimisés pour le SEO, optimisation des contenus existants, suivi des positions, ainsi que l'analyse des concurrents et l'analyse technique approfondie. Inscrivez-vous dès aujourd'hui pour découvrir OROVA SEO entièrement gratuitement (offre valable jusqu'au 7 juillet 2027).
Comment fonctionne la détection et la correction : Méthodologie complète
Cette section détaille le cœur de l'intervention technique. La gestion de la cannibalisation s'apparente à un audit SEO technique profond, et elle trouve naturellement sa place dans un audit SEO complet de votre site. Il ne s'agit pas de supprimer des pages au hasard, mais de suivre un processus scientifique basé sur la donnée. Nous décomposerons chaque élément, de l'extraction de données brutes jusqu'aux cas complexes de l'e-commerce et de l'intelligence artificielle.
L'extraction des données via Google Search Console
L'intuition n'a pas sa place ici. Le point de départ consiste à extraire les données fiables de Google Search Console (GSC).
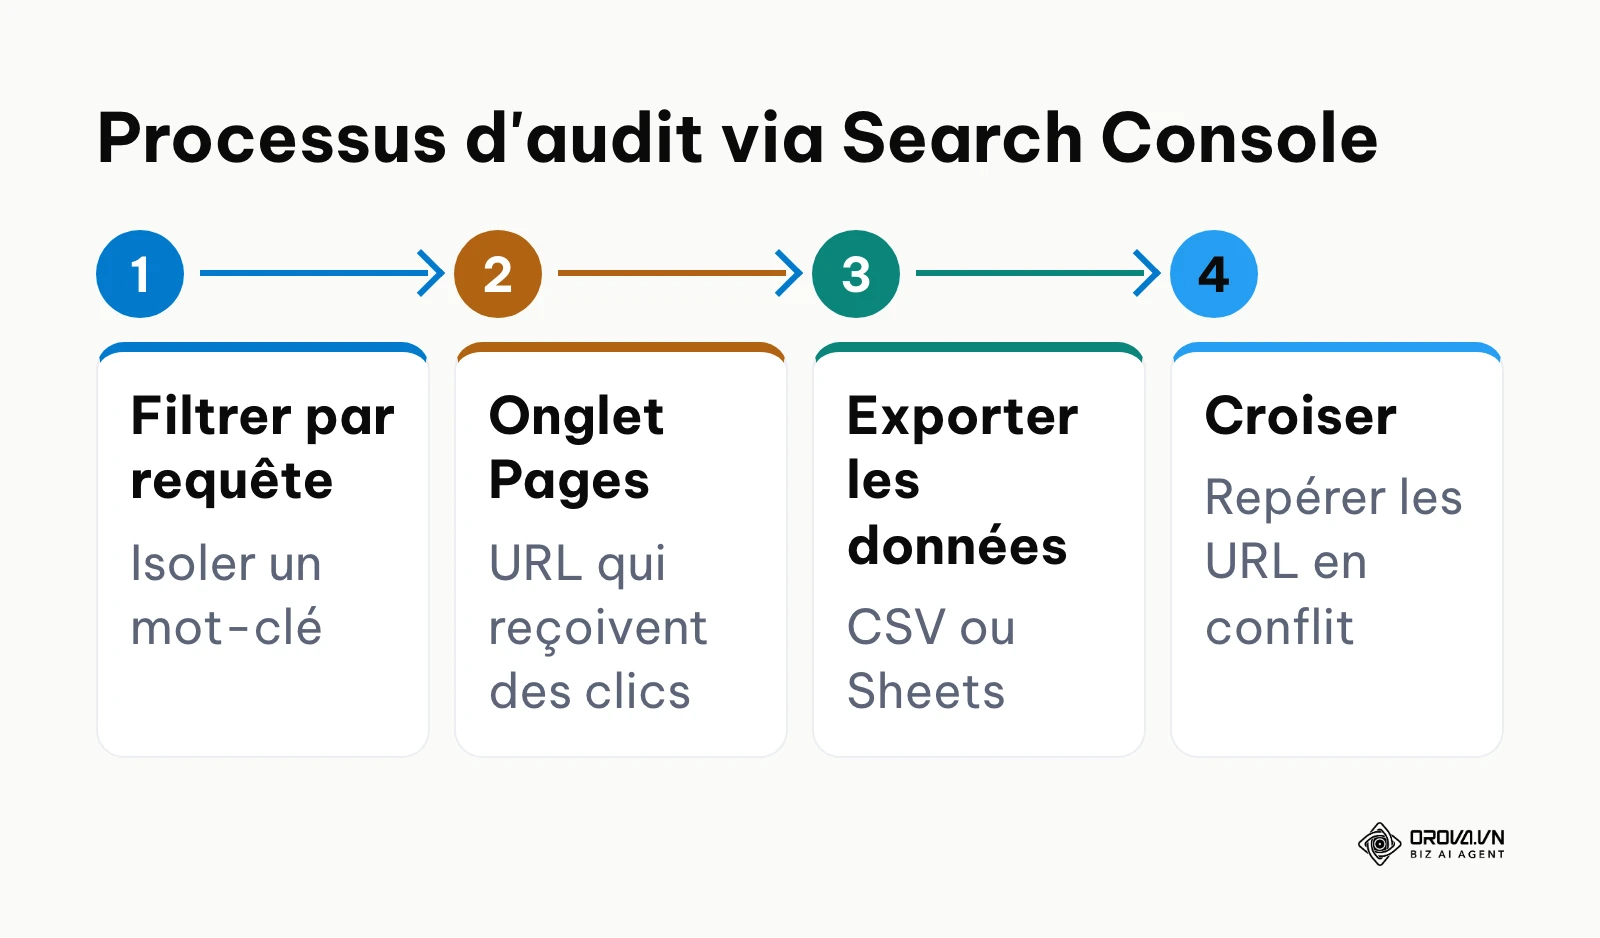
- L'action à réaliser : Vous devez exporter les données de performance pour identifier mathématiquement quelles URL se disputent les mêmes impressions pour un mot-clé donné.
- Les données d'entrée : Une extraction complète (souvent via l'API GSC pour dépasser la limite des 1000 lignes de l'interface) sur les 3 à 6 derniers mois. Vous créez un fichier Google Sheets de type "Audit". Les colonnes essentielles sont : Mot-clé (Query), URL de la page, Impressions, Clics, CTR, Position moyenne, et une colonne vide "Action à prendre".
- Le résultat obtenu : En utilisant un tableau croisé dynamique (Pivot Table) où le mot-clé est la ligne et les URL sont les sous-lignes, vous obtenez une vue instantanée. Si pour la requête "chaussure de course", vous voyez 4 URL différentes générant chacune des impressions significatives mais peu de clics, le diagnostic est posé.
- Le point de défaillance : L'erreur classique est de se concentrer sur une courte période (ex: 7 jours). Les fluctuations normales de l'algorithme peuvent imiter une cannibalisation. Il faut toujours analyser sur plusieurs mois pour repérer un vrai conflit chronique.
Le logigramme de décision : Que faire des pages cannibales ?
Une fois les URL conflictuelles identifiées, l'erreur fatale est de tout supprimer en masse. Le choix de l'action dépend strictement d'un logigramme précis basé sur l'intention et l'autorité.
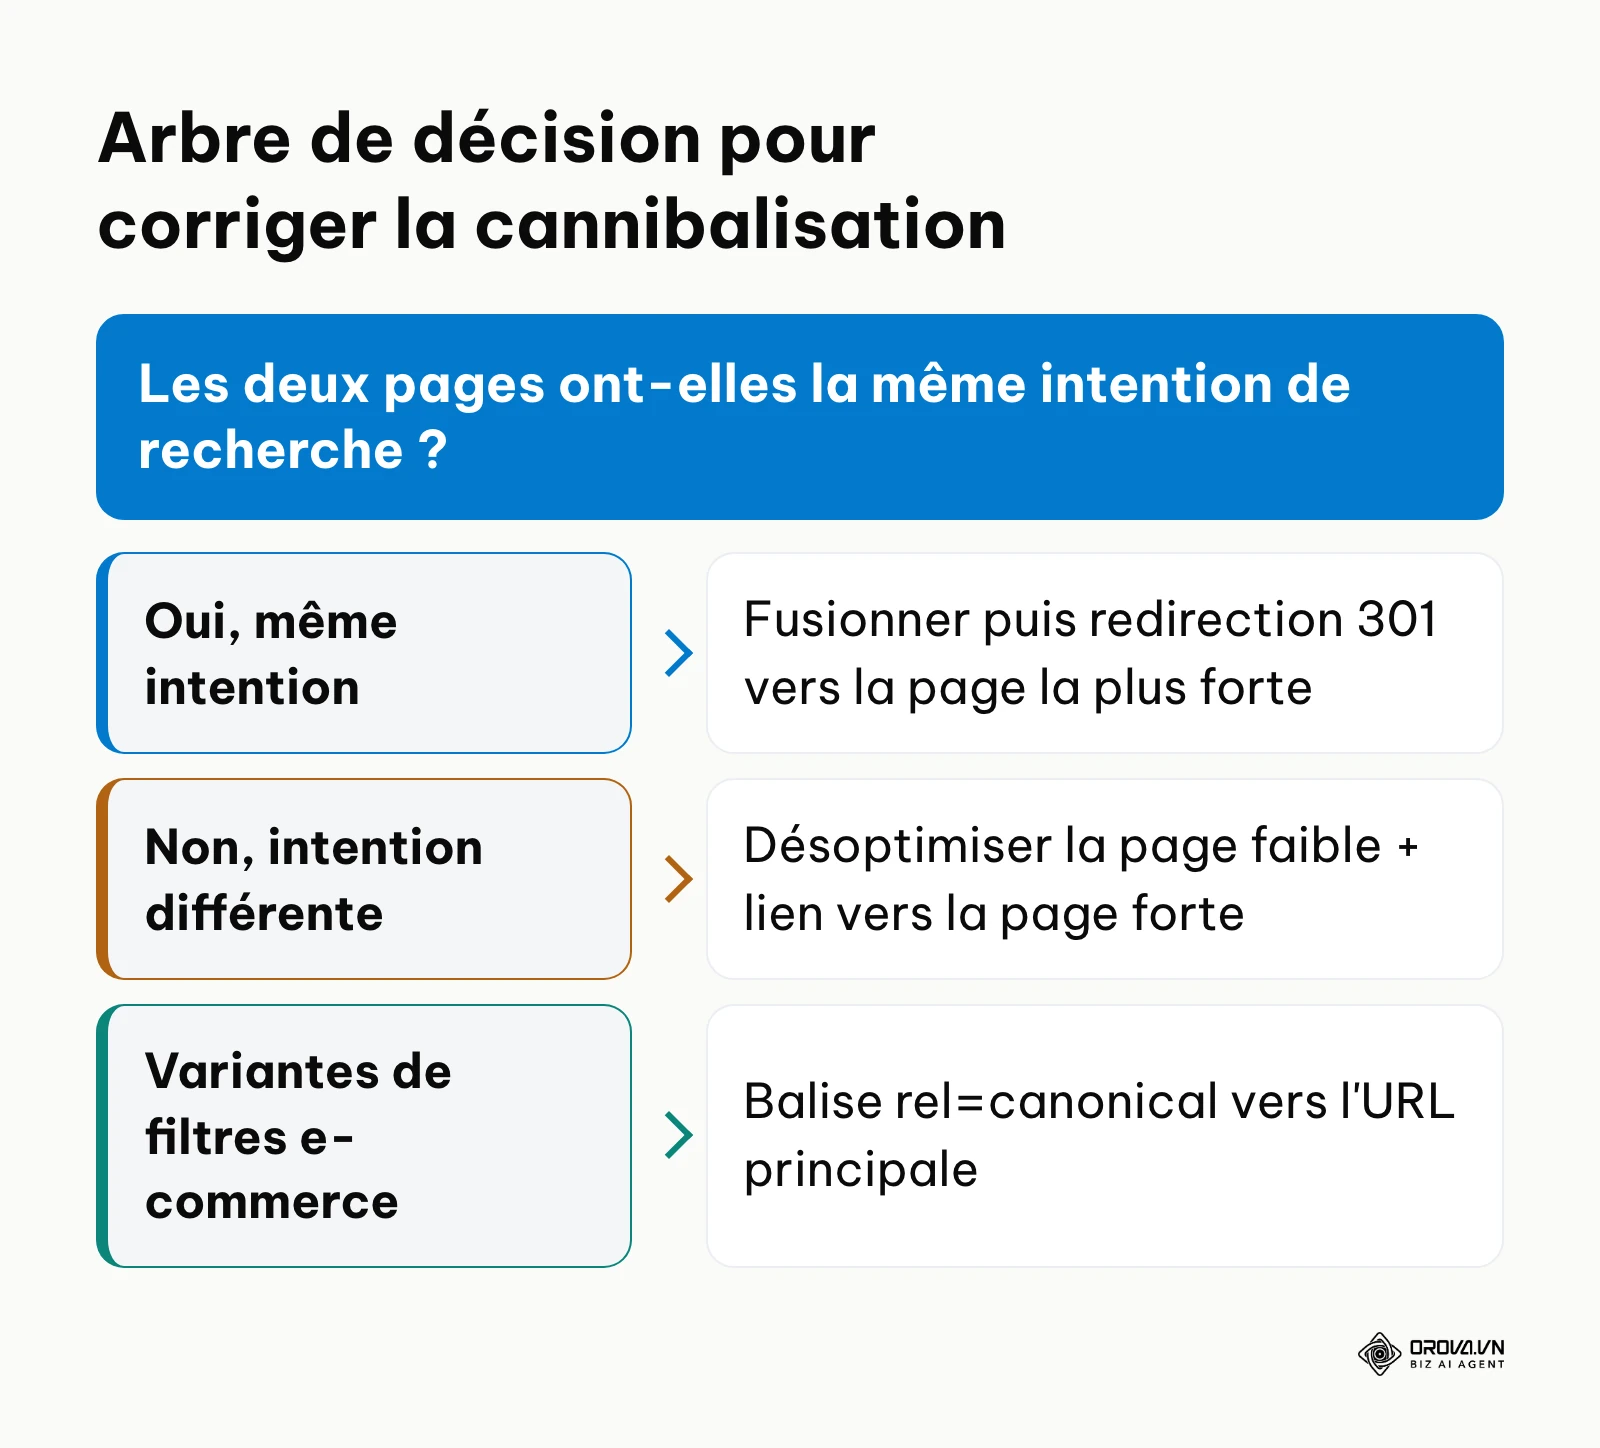
- L'action à réaliser : Choisir entre la redirection 301, la balise canonique, la suppression (404/410), ou la désoptimisation.
- Les données d'entrée : L'analyse manuelle du contenu des deux pages conflictuelles (Page A, plus forte ; Page B, plus faible) et l'analyse de leurs backlinks externes.
- Le résultat obtenu : Une action technique documentée pour chaque ligne de votre tableur.
- Scénario 1 : L'intention est 100% identique. Les deux pages parlent de la même chose. Vous prenez le meilleur contenu de la Page B, vous l'ajoutez à la Page A. Puis vous appliquez une redirection 301 de B vers A. La Page B disparaît, son autorité est transférée.
- Scénario 2 : L'intention est différente, mais le moteur se trompe. La Page A est commerciale, la Page B est un article de blog. Elles se battent. Vous devez désoptimiser la Page B : changez sa balise Title, retirez le mot-clé commercial exact de ses titres H2, et ajoutez un lien interne très fort depuis la Page B vers la Page A avec un texte d'ancrage optimisé.
- Scénario 3 : Les pages sont des variantes de filtres (E-commerce). L'intention est identique au produit, mais l'URL change selon la couleur. Vous devez utiliser une balise Rel=Canonical pointant de toutes les variantes vers l'URL principale du produit.
- Le point de défaillance : Réaliser une redirection 301 vers une page non pertinente, ou créer une chaîne de redirections (A vers B vers C), ce qui dilue l'autorité et provoque des erreurs de serveur. Une redirection 301 ne transmet bien les signaux que si le contenu de destination répond à la même intention que le contenu d'origine.
Le cas complexe de l'E-commerce : Navigation à facettes et paramètres d'URL
Les sites marchands sont les plus grandes victimes de la cannibalisation, souvent sans que l'équipe éditoriale ne rédige un seul mot de trop. Le problème provient du système de gestion de contenu (CMS).
- L'action à réaliser : Dompter les URL dynamiques générées par le tri, les filtres et les paginations (ex: ?couleur=rouge&taille=M, ?sort=price_asc).
- Les données d'entrée : Un crawl complet du site avec un outil comme Screaming Frog pour détecter toutes les URL comportant des paramètres.
- Le résultat obtenu : Une architecture assainie. Lorsqu'un utilisateur clique sur le filtre "Bleu" pour un t-shirt, le CMS génère une nouvelle URL. Si cette URL est indexée, elle cannibalise la page produit principale. La solution technique consiste à utiliser une stratégie combinée : implémenter des balises canoniques autoréférentielles sur la page principale, et configurer des balises noindex ou des règles de blocage dans le fichier robots.txt pour bloquer l'exploration des URL à paramètres n'ayant aucun potentiel de recherche (personne ne cherche "t shirt trié par prix croissant"). Une mauvaise utilisation des balises canoniques dans l'e-commerce fait aussi partie des causes fréquentes de gaspillage du budget de crawl.
- Le point de défaillance : Bloquer accidentellement la navigation principale via le fichier robots.txt, désindexant ainsi des catégories entières au lieu de cibler uniquement les facettes problématiques.
Exemple illustratif : Un propriétaire de boutique e-commerce sous Magento vendant des équipements de sport.
- Le contexte : Le site possédait 2000 produits, mais Google indexait plus de 45 000 URL. La page catégorie "Chaussures de course" chutait dans les classements, concurrencée par des pages comme categorie/chaussures?pointure=42&marque=nike.
- Les étapes réalisées : Le propriétaire a d'abord extrait la liste des paramètres d'URL générant des doublons. Il a ensuite configuré la plateforme pour ajouter dynamiquement une balise canonique sur toutes les pages filtrées, pointant vers la catégorie racine. Il a également ajouté une directive Disallow: /?pointure= dans le robots.txt pour préserver le crawl.
- Les obstacles et solutions : L'obstacle était de savoir quels filtres garder indexables. Il a analysé les volumes de recherche et a réalisé que les gens cherchaient la marque, mais pas la pointure. Il a donc bloqué l'indexation des pointures mais conservé les URL de marques comme pages d'atterrissage spécifiques.
- Le résultat : Le nombre de pages indexées est tombé à 3500 en six semaines, libérant une charge serveur immense, et la catégorie principale est remontée dans les deux premières positions nationales.
Le piège du contenu généré par l'IA en masse (Mass AI Content)
Avec l'avènement de l'IA, le problème de la cannibalisation a pris une dimension terrifiante. La vitesse de production excède la capacité de planification.
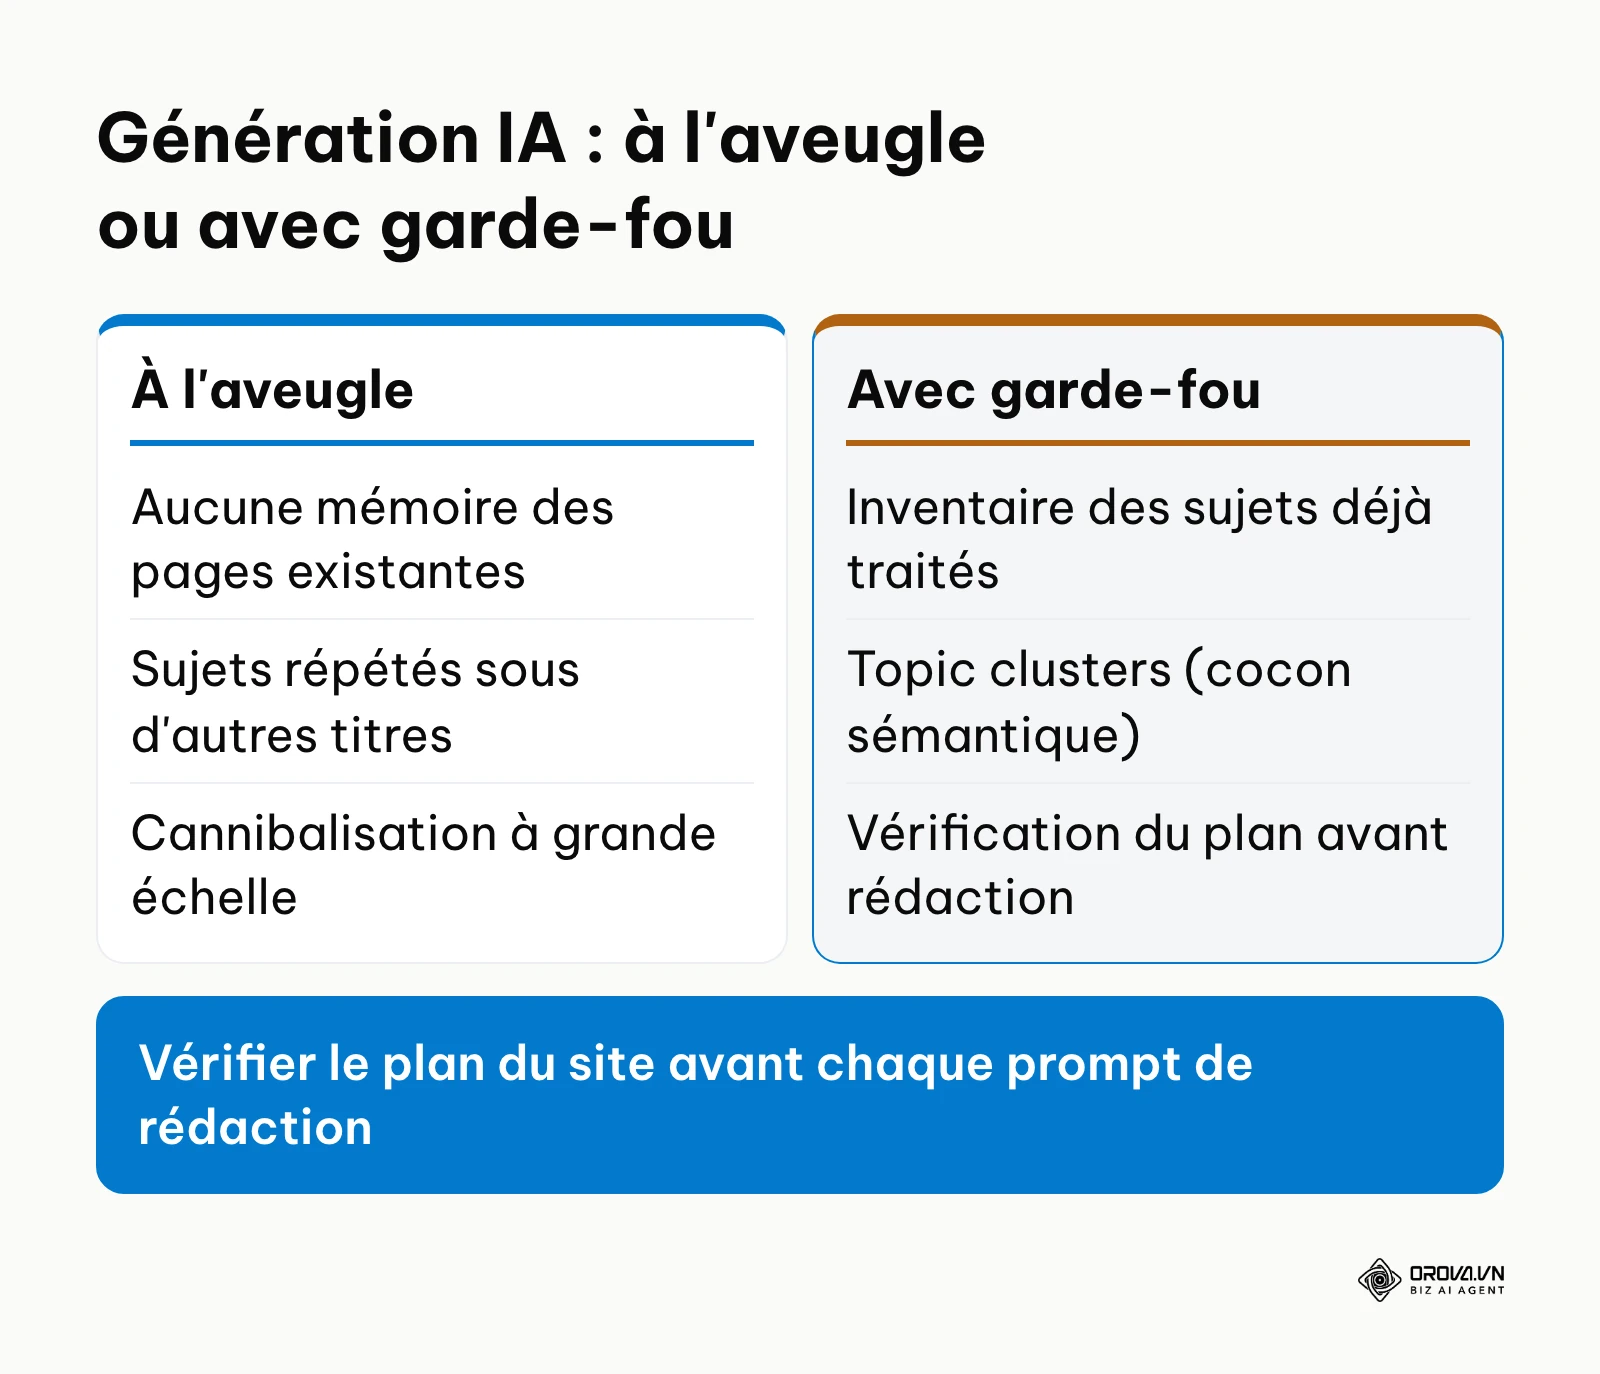
- L'action à réaliser : Mettre en place un garde-fou sémantique avant la génération de texte.
- Les données d'entrée : Une base de données ou un inventaire strict de tous les sujets déjà traités par le site.
- Le résultat obtenu : Lorsqu'on demande à une IA basique de générer 50 articles sur "l'investissement immobilier", elle n'a pas la mémoire de votre site. Elle va inévitablement créer un article "Guide pour investir" lundi, et "Comment bien investir" vendredi. Ces deux articles sont structurellement différents mais sémantiquement identiques pour Google. L'IA va cannibaliser votre site à une vitesse industrielle. La solution est de passer d'un agent IA SEO basique à un système structuré par "Topic Clusters" (cocon sémantique). Avant qu'un prompt ne lance la rédaction, il doit vérifier le plan du site pour s'assurer qu'aucune page existante ne cible déjà cette grappe sémantique précise.
- Le point de défaillance : Faire confiance aveuglément à la génération de mots-clés par l'IA sans valider les volumes réels et la similarité des requêtes (SERP overlap) au préalable.
Exemple illustratif : Une agence web gérant le blog d'une entreprise de cybersécurité.
- Le contexte : L'agence a utilisé des scripts d'IA pour générer et publier 300 articles en un mois afin d'augmenter le trafic. Le trafic global a baissé de 30% le mois suivant.
- Les étapes réalisées : En utilisant un outil d'audit, ils ont découvert que 15 articles différents parlaient de "comment créer un mot de passe fort" sous des angles très légèrement distincts. Ils ont stoppé la publication automatisée. Ils ont créé une carte mentale des sujets existants et consolidé les 15 articles médiocres en un seul guide complet de 3000 mots, redirigeant les 14 autres.
- Les obstacles et solutions : Le défi technique fut de mapper massivement les redirections sans créer de boucle. Ils ont utilisé une feuille de calcul automatisée pour générer les règles de redirection .htaccess d'un seul coup.
- Le résultat : En stabilisant la base de contenu, la page unifiée a capté à elle seule plus de trafic que les 15 articles originaux combinés, prouvant que la qualité bat toujours la quantité brute.
Il existe différentes facettes de ce problème. Voici une typologie pour vous aider à les identifier :
| Type de cannibalisation | Caractéristique | Qui est le plus touché |
|---|---|---|
| Interne (Classique) | Plusieurs articles de blog visant le même mot-clé informatif. | Blogs, Médias, Sites de contenu éditorial. |
| Architecturale (Filtres) | Le CMS génère des URL multiples pour le même produit via la navigation. | Boutiques en ligne (E-commerce), Catalogues B2B. |
| Sous-domaine (Subdomain) | Le domaine principal (site.com) et le sous-domaine (blog.site.com) se concurrencent. | Entreprises SaaS, Grandes marques avec sites écosystémiques. |
| Internationale (Hreflang) | Une page FR-France et une page FR-Suisse entrent en conflit sans balise hreflang correcte. | Sites multinationaux, Exportateurs. |
Comment structurer votre approche face à la cannibalisation
Corriger la cannibalisation demande une rigueur d'exécution qui varie selon votre rôle et la taille de l'infrastructure que vous gérez. L'approche doit être méthodique pour éviter de détruire l'existant.
Pour le propriétaire de site e-commerce (Gérer l'architecture technique)
Le défi principal est l'automatisation du système de gestion de contenu.
- Auditez les URL indexées : Tapez site:votresite.com dans Google. Si le nombre de résultats est 10 fois supérieur à votre nombre de produits réels, vous avez un problème de filtres.
- Configurez les balises canoniques : Assurez-vous que chaque page produit possède une balise canonique pointant vers elle-même, et que les pages filtrées pointent vers la catégorie mère.
- Optimisez le maillage interne : Depuis la page d'accueil, créez des liens clairs avec des ancres exactes vers vos catégories principales pour dicter au moteur quelles pages sont prioritaires.
- Révisez le fichier robots.txt : Bloquez le passage des robots sur les paramètres de tri (ex: ordre alphabétique, filtres de prix multiples) dès cette semaine.
Pour le responsable SEO en interne (Gérer le calendrier éditorial)
L'enjeu est de nettoyer le passé et de sécuriser l'avenir des publications.
- Établissez une cartographie (Content Mapping) : Listez toutes vos pages existantes et associez à chacune un mot-clé principal unique et son intention de recherche.
- Exécutez le grand nettoyage : Fusionnez les articles obsolètes ou concurrents. Choisissez toujours de conserver l'URL qui a l'historique de liens entrants (backlinks) le plus fort.
- Standardisez les ancres de liens : Vérifiez que lorsque vous faites un lien interne vers votre page "Logiciel CRM", l'ancre n'est pas utilisée ailleurs pour pointer vers une page différente.
- Instaurez une étape de validation pré-publication : Avant toute rédaction, effectuez une recherche sur votre propre site pour prouver que le sujet n'a pas déjà été couvert.
Pour l'agence ou le consultant indépendant (Gérer les ressources client)
Votre rôle est d'apporter des preuves chiffrées et de guider les décisions complexes, souvent face aux réticences du client.
- Prouvez la perte financière : Utilisez les données de suivi de positionnement pour montrer au client comment les fluctuations d'URL lui coûtent des conversions potentielles.
- Préparez un plan de redirection sans faille : Fournissez un tableur de correspondance (URL A vers URL B) avant toute intervention sur les serveurs.
- Surveillez les erreurs 404 consécutives : Après la fusion de pages, utilisez un crawler pour vous assurer qu'aucun ancien lien interne ne mène vers une page supprimée.
- Formez les équipes de rédaction du client : Créez des directives claires sur la différence entre créer un nouvel article et mettre à jour un article existant.
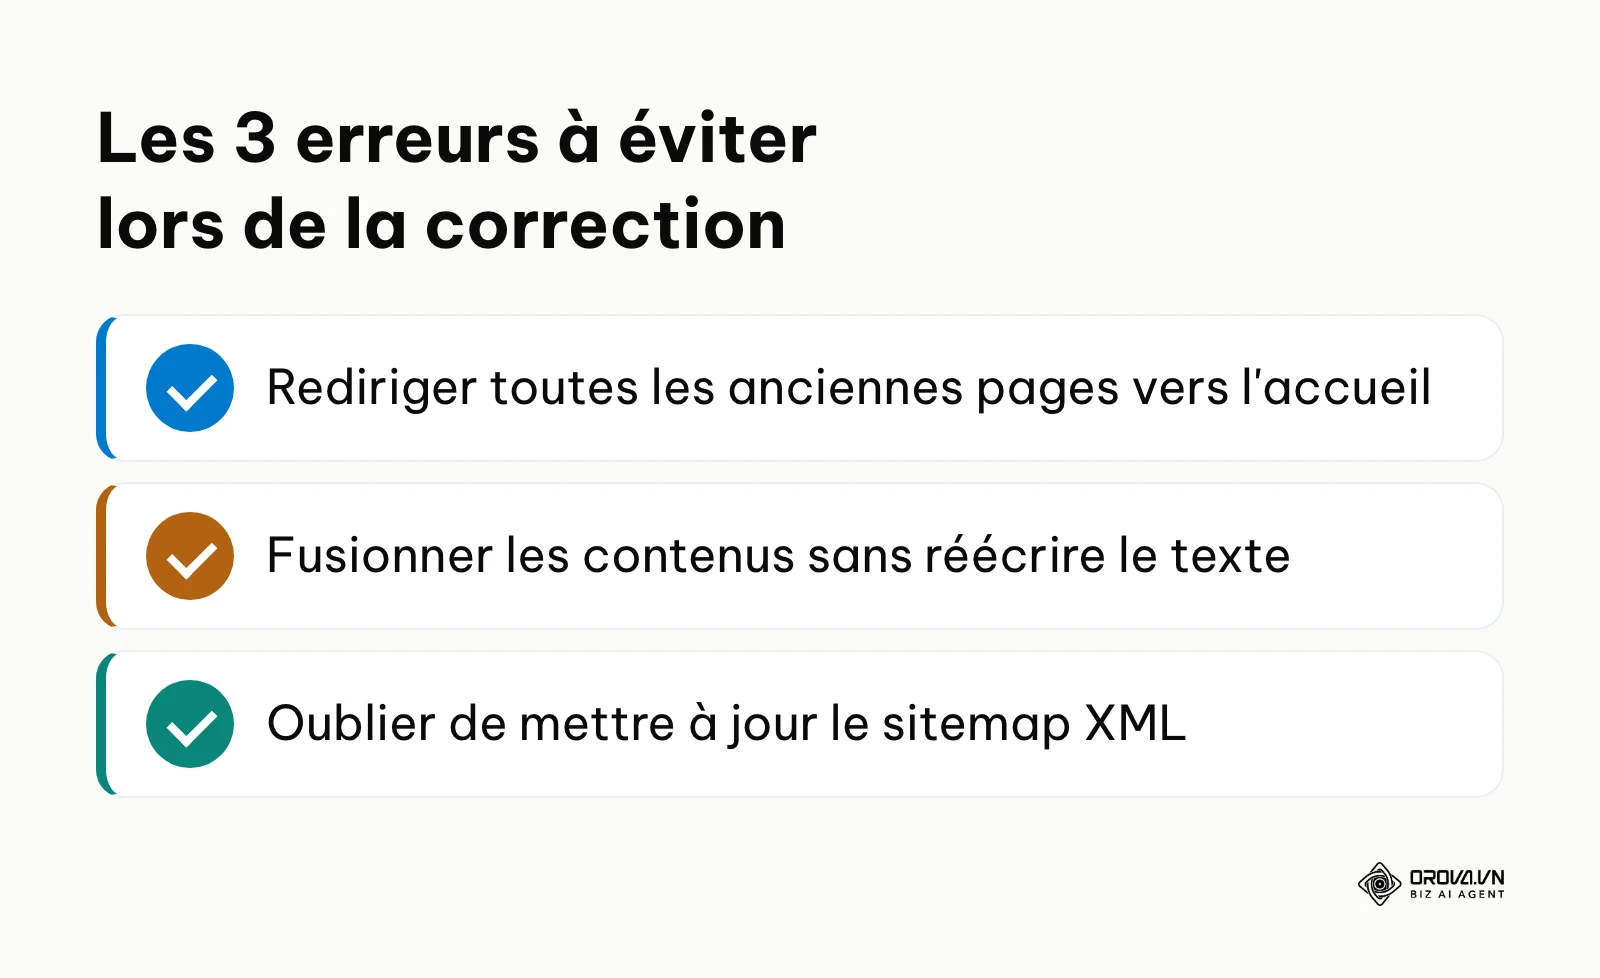
La correction technique est parsemée de pièges. Voici les plus graves :
| Erreur courante | Conséquence | Comment l'éviter |
|---|---|---|
| Mettre toutes les anciennes pages en redirection vers la page d'accueil (Soft 404). | Google annule le transfert d'autorité car la pertinence thématique est rompue. | Rediriger systématiquement vers la page la plus sémantiquement proche de l'originale. |
| Fusionner les contenus sans réécrire le texte pour la cohérence. | Le taux de rebond explose car la nouvelle méga-page est confuse et indigeste. | Synthétiser et hiérarchiser les idées des anciennes pages avec de nouveaux titres H2/H3. |
| Oublier de mettre à jour le sitemap XML. | Les moteurs continuent de chercher les anciennes pages supprimées, ralentissant le crawl. | Régénérer et soumettre le fichier sitemap immédiatement après les fusions d'URL. |
Avec OROVA.VN et le module OROVA SEO, vous mettez définitivement fin aux journées épuisantes de travail manuel. Au lieu de passer des heures à rédiger des articles et à préparer des rapports, l'ensemble du processus est désormais optimisé et bouclé en seulement 5 minutes.
Tendances de la cannibalisation SEO : l'avis de l'auteur
En observant l'évolution des algorithmes de recherche et le comportement des éditeurs de sites, le paysage technique de la gestion de contenu s'apprête à connaître des mutations profondes. Les méthodes artisanales d'aujourd'hui ne suffiront plus face aux volumes de demain.
La prolifération des IA génératives va exiger une cartographie sémantique stricte
Je constate aujourd'hui que la barrière à l'entrée pour la création de contenu a disparu. N'importe quel site peut générer des centaines de pages par semaine grâce aux grands modèles de langage (LLM). Cependant, sans mémoire structurelle, ces outils recrachent des variantes du même sujet. Je pense que, à terme, les sites qui ne déploieront pas de bases de données vectorielles (Knowledge Graphs internes) pour dicter à leur IA ce qui a déjà été écrit s'effondreront sous leur propre poids. L'IA produira de la cannibalisation à l'échelle industrielle. Dès à présent, il devient impératif de cesser la génération "aveugle" par lots et d'implémenter des règles de validation algorithmiques avant chaque rédaction.
Les AI Overviews de Google pénaliseront la redondance d'information
Actuellement, nous voyons Google expérimenter activement avec des réponses générées par l'IA en haut des résultats de recherche, synthétisant l'information issue de plusieurs sources. Je crois fermement que dans les années à venir, l'algorithme sera de moins en moins tolérant envers les sites qui forcent l'exploration de dix pages pour transmettre une seule idée. Ces résumés générés par l'IA privilégieront la densité et la concision. Si votre site présente cinq articles médiocres sur un sujet au lieu d'une entité informationnelle unique et exhaustive, vous serez purement et simplement exclu des résumés génératifs. Les webmasters doivent commencer dès aujourd'hui à consolider leurs articles fragmentés en "Hubs" documentaires massifs et structurés.
L'automatisation de l'audit technique deviendra la norme absolue
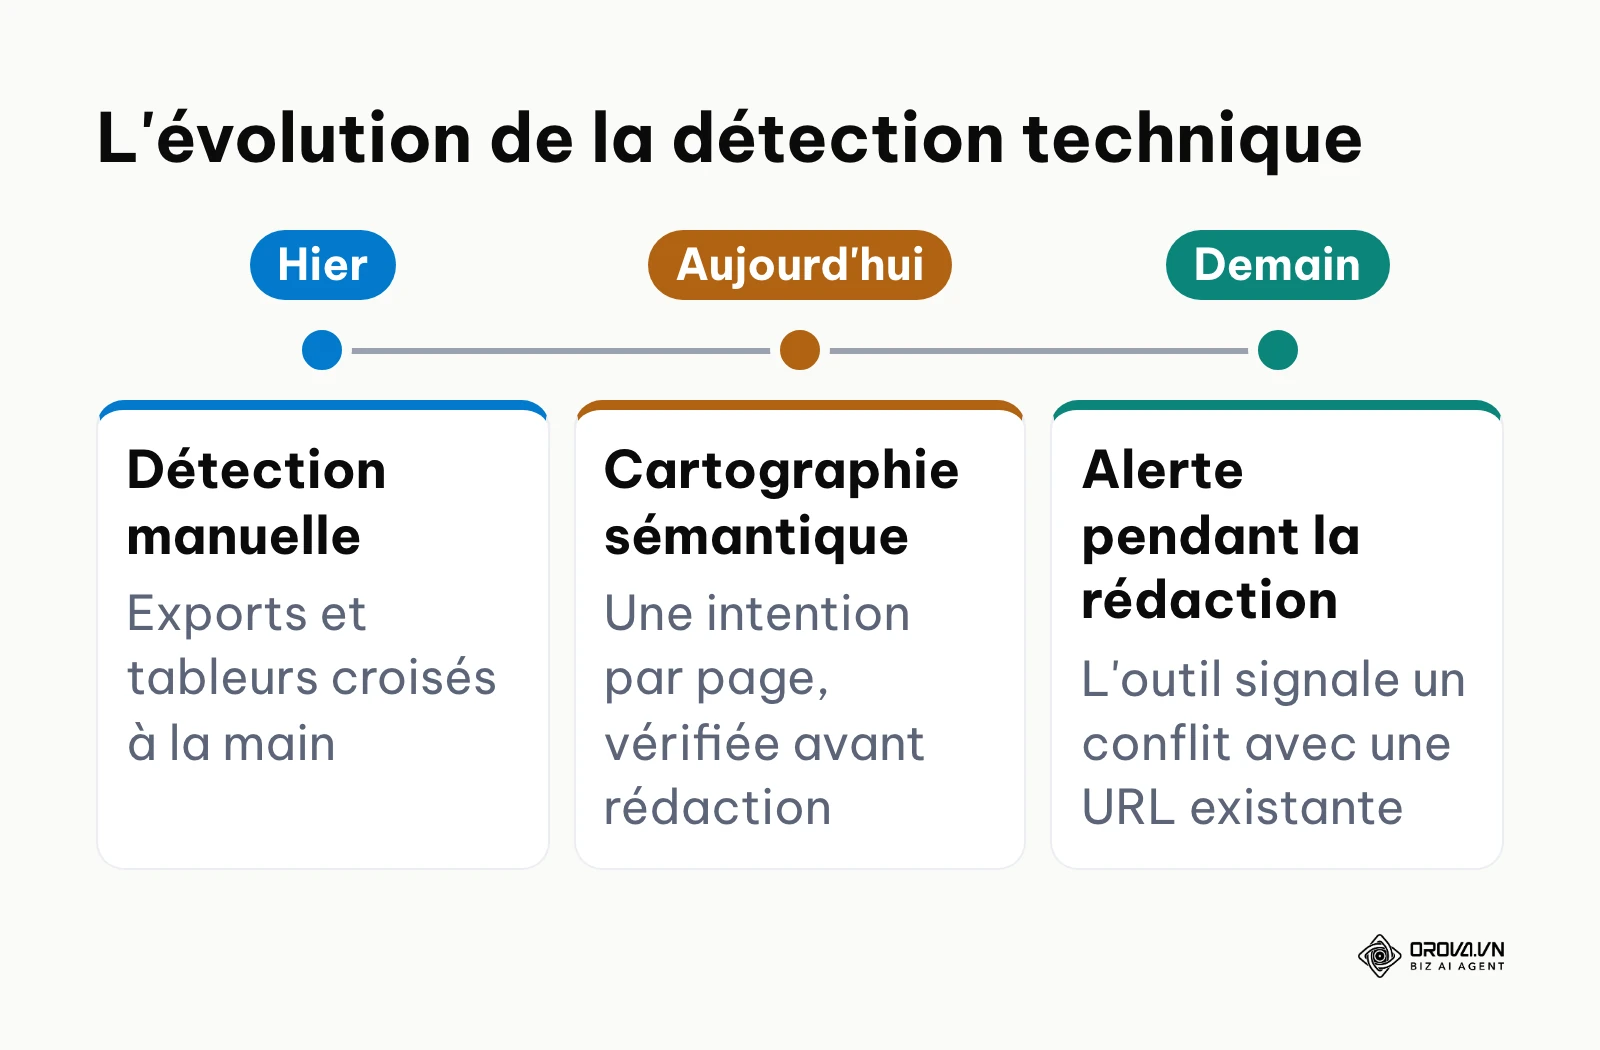
Aujourd'hui, l'analyse de la cannibalisation repose encore largement sur des exports manuels vers Excel ou Google Sheets, croisant laborieusement des VLOOKUP pour identifier les conflits. À mon avis, dans les prochaines années, ces processus manuels paraîtront dépassés. Les outils alerteront probablement les équipes éditoriales pendant la rédaction si le brouillon risque d'interférer avec une URL existante. Les CMS pourraient aussi proposer d'eux-mêmes les balises canoniques adaptées. Il me semble utile d'adopter dès maintenant des outils SEO intégrés capables de surveiller l'intégrité de l'architecture en toile de fond, plutôt que de réaliser des audits trimestriels mortuaires.
Questions fréquentes sur la cannibalisation SEO
L'application technique de ces concepts soulève de nombreuses interrogations pratiques. Voici les réponses aux situations les plus courantes.
La résolution de ce problème est-elle encore nécessaire avec l'IA ?
Absolument, et plus que jamais. Bien que les algorithmes basés sur l'IA, comme ceux de Google, soient de plus en plus intelligents pour comprendre le contexte, ils restent dépendants de l'architecture technique que vous leur fournissez. L'IA n'est pas là pour corriger votre mauvaise structuration. Au contraire, si vous lui donnez des signaux contradictoires (deux pages ciblant exactement le même besoin), l'IA de recherche doutera de votre autorité globale sur le sujet. Nettoyer la cannibalisation, c'est faciliter le travail des modèles d'analyse sémantique.
Combien de temps pour récupérer son classement après une redirection 301 ?
La patience est cruciale lors d'une refonte architecturale. Généralement, après avoir fusionné deux pages et appliqué une redirection 301, vous observerez une période de "danse" (fluctuations des classements) pouvant durer de 2 à 4 semaines. Google doit recrawler les anciennes URL, découvrir la redirection, explorer la nouvelle page cible, et recalculer le poids des liens. Pour des sites bénéficiant d'un budget de crawl important, les résultats (hausse du trafic de la page consolidée) peuvent être visibles en moins de 15 jours.
La cannibalisation interne réduit-elle l'autorité de domaine (DA) globale ?
Non, la cannibalisation SEO n'affecte généralement pas la métrique théorique de l'Autorité de Domaine de manière directe. Elle agit de façon ponctuelle et localisée. Elle empêche l'autorité existante de votre domaine de se concentrer sur les bonnes pages. Cependant, un site composé à 60% de pages cannibalisées, de faible qualité et redondantes, finira par voir son budget d'exploration réduit, ce qui limitera la capacité globale du domaine à générer du trafic à long terme.
Comment gérer les conflits entre le domaine principal et un sous-domaine ?
Ce cas est complexe (par exemple site.com vs blog.site.com). Google traite souvent les sous-domaines comme des entités distinctes, mais ils peuvent tout à fait se cannibaliser sur les résultats de recherche. Si votre page de service commerciale (domaine principal) est supplantée par un article de blog (sous-domaine), la solution technique exige de définir une frontière sémantique stricte. Utilisez le maillage interne inter-domaines : le sous-domaine doit lier fortement la page commerciale du domaine principal avec l'ancre exacte, indiquant au moteur que le domaine principal est l'entité finale et prioritaire pour ce mot-clé précis.
Par où commencer votre audit ?
Face à un site comportant des centaines ou des milliers d'URL, la paralysie de l'analyse est fréquente. Plutôt que de lancer des chantiers massifs sans filet, identifiez l'état actuel de votre infrastructure pour déterminer l'action immédiate, réalisable en une seule demi-journée de travail.
Situation 1 : Vous n'avez encore rien fait (Aucun diagnostic technique). Votre priorité n'est pas de supprimer des pages, mais d'observer. Votre toute première action doit être d'ouvrir Google Search Console, de vous rendre dans le rapport "Performances" et de filtrer les données pour afficher uniquement vos 5 mots-clés les plus stratégiques (ceux qui rapportent de l'argent). Pour chacun, cliquez dessus puis basculez sur l'onglet "Pages". Si vous voyez plus d'une URL recevoir des clics réguliers pour une seule de ces requêtes vitales, vous venez de trouver votre premier chantier prioritaire.
Situation 2 : Vous avez déjà du contenu, mais la structure est désorganisée et éparpillée. Vous savez que vous souffrez de redondance, probablement due à des années d'articles de blog non planifiés. Votre première étape concrète est de réaliser un mapping sémantique (la démarche d'un audit sémantique) de vos 20 pages générant le plus de trafic. Ouvrez un tableur simple, listez ces 20 URL et assignez-leur à la main le sujet unique et principal qu'elles doivent traiter. Toute autre URL du site qui empiète sur l'un de ces 20 sujets deviendra immédiatement une cible potentielle pour une redirection ou une réécriture. Ne touchez pas aux serveurs avant d'avoir clarifié sur le papier le rôle de vos pages championnes.
Situation 3 : Vous avez fusionné des pages, mais vous ne mesurez pas l'impact des corrections. Vous avez appliqué des redirections 301, mais vous naviguez à l'aveugle concernant la récupération du trafic. L'action immédiate est de configurer des annotations claires dans Google Analytics 4 (via un fichier de suivi externe ou un connecteur de données) à la date exacte de vos modifications techniques. Ensuite, isolez le suivi de positionnement spécifique de l'URL cible (la page renforcée) pour observer sa progression sur les 30 prochains jours. Ne procédez à aucune nouvelle modification d'URL tant que vous n'avez pas confirmé que votre première série de redirections 301 a correctement mis fin à la cannibalisation seo.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Pilotez votre activité avec des AI Agents
Orova est le Biz AI Agent qui ne s'arrête jamais : il planifie, exécute et optimise le travail à votre place.
Gagnez du temps, gagnez en efficacité.