
Generative engine optimization (GEO) : le guide technique étape par étape
Le generative engine optimization (GEO) consiste à structurer votre site et vos contenus pour que les moteurs de réponse IA (ChatGPT, Perplexity, les AI Overviews de Google) puissent les comprendre, les reprendre et surtout les citer avec un lien vers vous. Le monde du référencement est en train de vivre un séisme. Imaginez la scène : vous êtes un responsable marketing, vous avez passé des mois à peaufiner votre contenu, vous avez obtenu la sacro-sainte première position sur Google, et pourtant, votre trafic organique s'effondre. Pourquoi ? Parce que l'utilisateur n'a plus besoin de cliquer sur votre lien pour obtenir sa réponse. Un grand encart généré par une intelligence artificielle (IA) lui offre un résumé parfait, directement dans les résultats de recherche. Ce bouleversement porte un nom : l'avènement des moteurs de réponse génératifs. Pour survivre et prospérer dans cet écosystème où ChatGPT, Perplexity et les AI Overviews de Google dictent les nouvelles règles du jeu, le SEO traditionnel ne suffit plus. C'est ici qu'intervient le GEO. Ce nouveau paradigme ne consiste plus seulement à placer des mots-clés pour séduire un algorithme de classement classique, mais à structurer la connaissance de votre entreprise de manière à ce qu'un grand modèle de langage (LLM) puisse la comprendre, la valider, et surtout, la citer comme source fiable. Ce guide technique approfondi va vous montrer exactement comment faire.
Qu'est-ce que le generative engine optimization et pourquoi s'y intéresser ?
Le generative engine optimization (GEO) est l'ensemble des pratiques techniques, éditoriales et sémantiques visant à optimiser la visibilité, la fréquence de citation et l'exactitude des informations d'une marque au sein des réponses générées par les intelligences artificielles conversationnelles et les moteurs de recherche augmentés par l'IA. Contrairement au SEO traditionnel qui cherche à positionner une URL bleue dans une liste de liens, le GEO vise à positionner une idée, un fait ou un produit dans la logique de réflexion (le prompt de système) d'une IA, tout en forçant l'algorithme à afficher un lien cliquable vers la source originale.
Cette discipline s'adresse prioritairement aux sites d'information complexes, aux éditeurs de logiciels B2B (SaaS), aux plateformes e-commerce disposant de catalogues techniques détaillés, et aux médias en ligne. En effet, ce sont ces secteurs qui subissent le plus la désintermédiation par l'IA, car leurs audiences posent des questions complexes nécessitant des synthèses. À l'inverse, si vous gérez une entreprise purement transactionnelle et hyper-locale (par exemple, un serrurier d'urgence de quartier), le GEO n'est pas votre priorité immédiate ; un bon référencement sur Google Maps suffira amplement, car l'IA déléguera de toute façon ce type de requête à l'index local traditionnel.
Le but du GEO n'est pas de tromper l'IA, mais de faciliter considérablement son travail d'extraction de données, appelé RAG (Retrieval-Augmented Generation). Si votre contenu est le plus facile à ingérer, le mieux structuré et le plus digne de confiance, c'est votre site qui deviendra la matière première de la réponse générée.
Préparation : Les fondations avant d'optimiser pour l'IA
Avant de plonger dans les techniques avancées du generative engine optimization, il est impératif de comprendre que les IA comme ChatGPT ou Perplexity ne lisent pas le web comme des humains, ni même exactement comme le vieux robot d'indexation Googlebot. Ces agents scrutent le web à la recherche de signaux sémantiques forts et de données non ambiguës. Si les fondations de l'audit seo technique de votre site sont fragiles, aucune stratégie GEO avancée ne fonctionnera.
Vous devez d'abord vous assurer que votre architecture permet une exploration rapide (crawl) et que votre contenu respire la crédibilité. L'E-E-A-T (Expérience, Expertise, Autorité, Fiabilité), qui reste le pilier fondamental des directives d'évaluation de la qualité de recherche de Google (Search Quality Rater Guidelines), pèse encore plus lourd dans le monde de l'IA. Un grand modèle de langage n'a pas de "bon sens" ; il s'appuie sur la réputation numérique de l'auteur et du domaine pour décider s'il doit inclure une information dans sa synthèse.
Voici un récapitulatif strict de ce que vous devez avoir préparé avant d'appliquer les étapes de ce guide.
| Prérequis technique / éditorial | Où trouver ou configurer cet élément ? | Temps estimé pour la mise en place |
|---|---|---|
| Fichier robots.txt sans blocage restrictif des bots IA légitimes | À la racine de votre site (ex: /robots.txt) | 30 minutes d'analyse et de correction |
| Sitemap XML dynamique et à jour, incluant les images et vidéos | Généré par votre CMS (ex: Yoast, RankMath) | 1 heure pour la configuration initiale |
| Vitesse de chargement optimale (LCP < 2.5 secondes) | Outils comme Google PageSpeed Insights ou Lighthouse | 1 à 3 semaines de développement technique |
| Pages Auteurs (Author Bios) détaillées avec liens vers réseaux sociaux | Section "À propos" ou fiches auteurs dans le CMS | 2 à 4 heures pour la rédaction et le design |
| Protocole HTTPS strict sans erreurs de certificat mixtes | Hébergeur web et paramètres du serveur (SSL) | Quelques minutes (si non déployé) |
| Maillage interne logique avec des ancres de liens descriptives | Dans le corps de tous vos articles de blog existants | Continu (audit initial de 1 à 3 jours) |
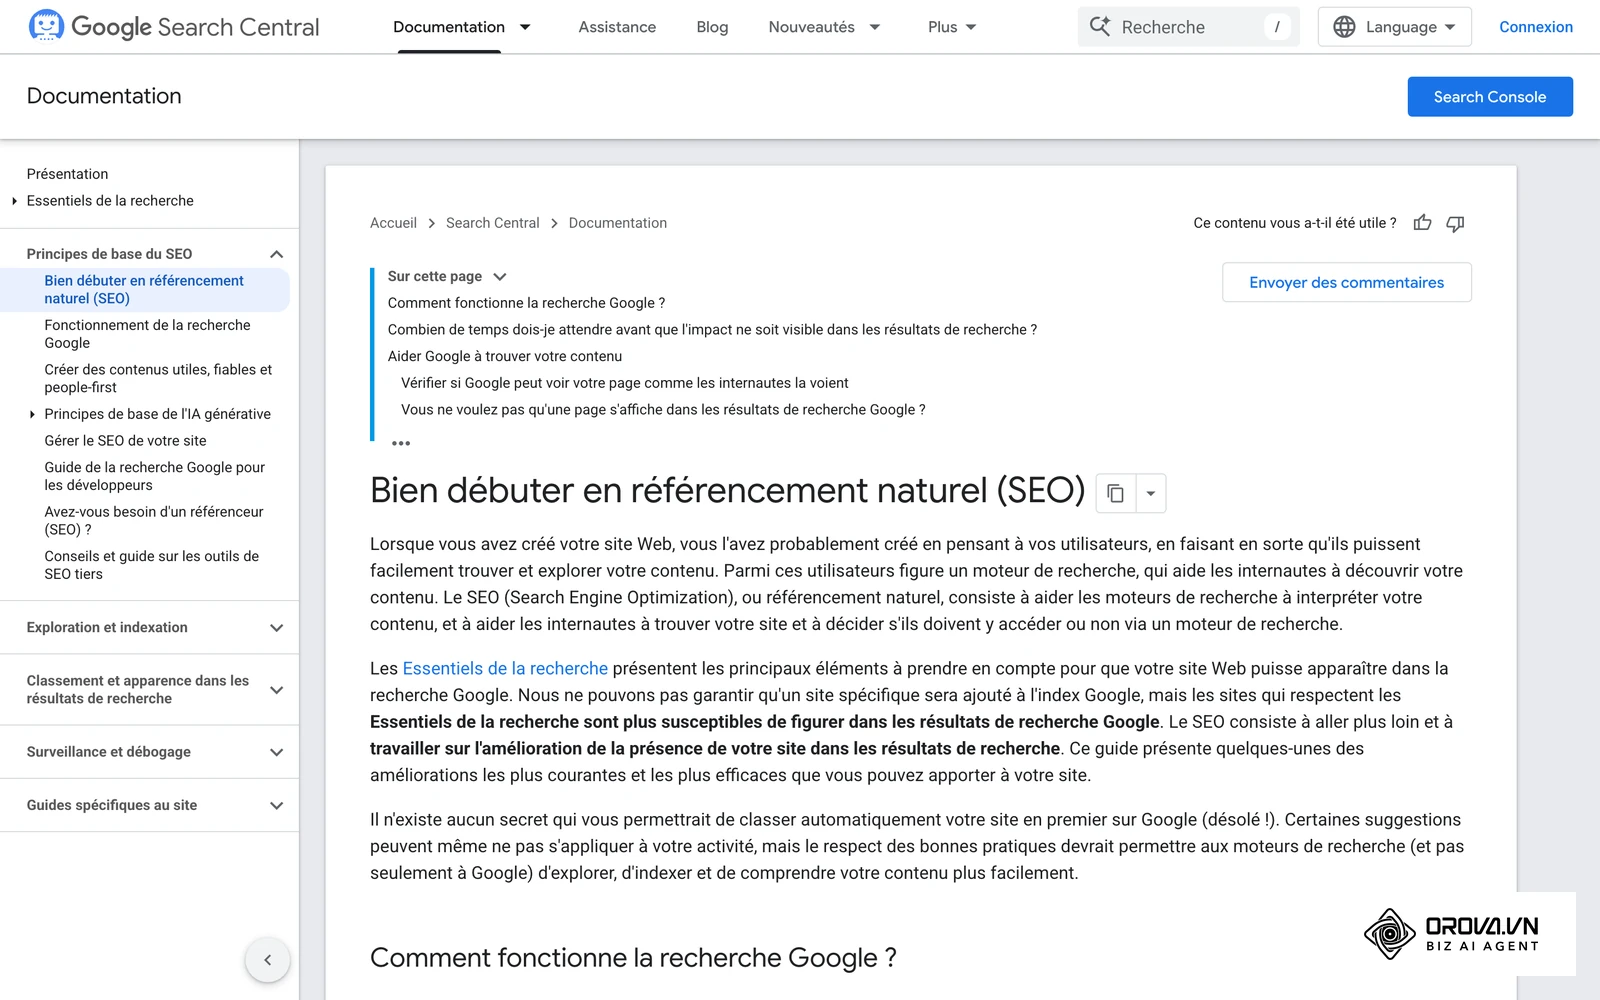
Le tableau ci-dessus n'est pas exhaustif, mais il représente le socle minimal. Si votre site prend dix secondes à charger ou que vos articles n'ont pas d'auteurs clairement identifiés avec un historique vérifiable sur le web, l'algorithme RAG d'une IA ignorera votre page au profit d'un concurrent techniquement plus sain, même si votre prose est meilleure.
Le guide technique étape par étape du generative engine optimization
Nous entrons maintenant dans le cœur du sujet. Les étapes suivantes constituent un protocole complet, de la manipulation de l'architecture de votre serveur jusqu'à la réécriture chirurgicale de vos paragraphes. Chaque détail compte, car dans l'écosystème de l'IA générative, la nuance entre être cité comme source de vérité et être totalement ignoré se joue souvent sur une ligne de code ou une balise HTML.
Étape 1 : Implémenter le fichier llms.txt pour guider les agents IA
C'est l'une des pistes les plus récentes du GEO, à manier avec lucidité. Tout comme le fichier robots.txt indique aux moteurs de recherche quelles pages explorer, la proposition de standard llms.txt (et son pendant plus détaillé llms-full.txt) est un fichier placé à la racine de votre domaine dont le but est de fournir une carte propre et structurée aux grands modèles de langage. Attention : à ce jour, aucun grand moteur de réponse n'a annoncé officiellement en tenir compte pour choisir les sources qu'il cite ; c'est un pari peu coûteux, pas une garantie. Les IA détestent le bruit : le code JavaScript, les pop-ups, les menus de navigation complexes perturbent leur compréhension du contenu principal.
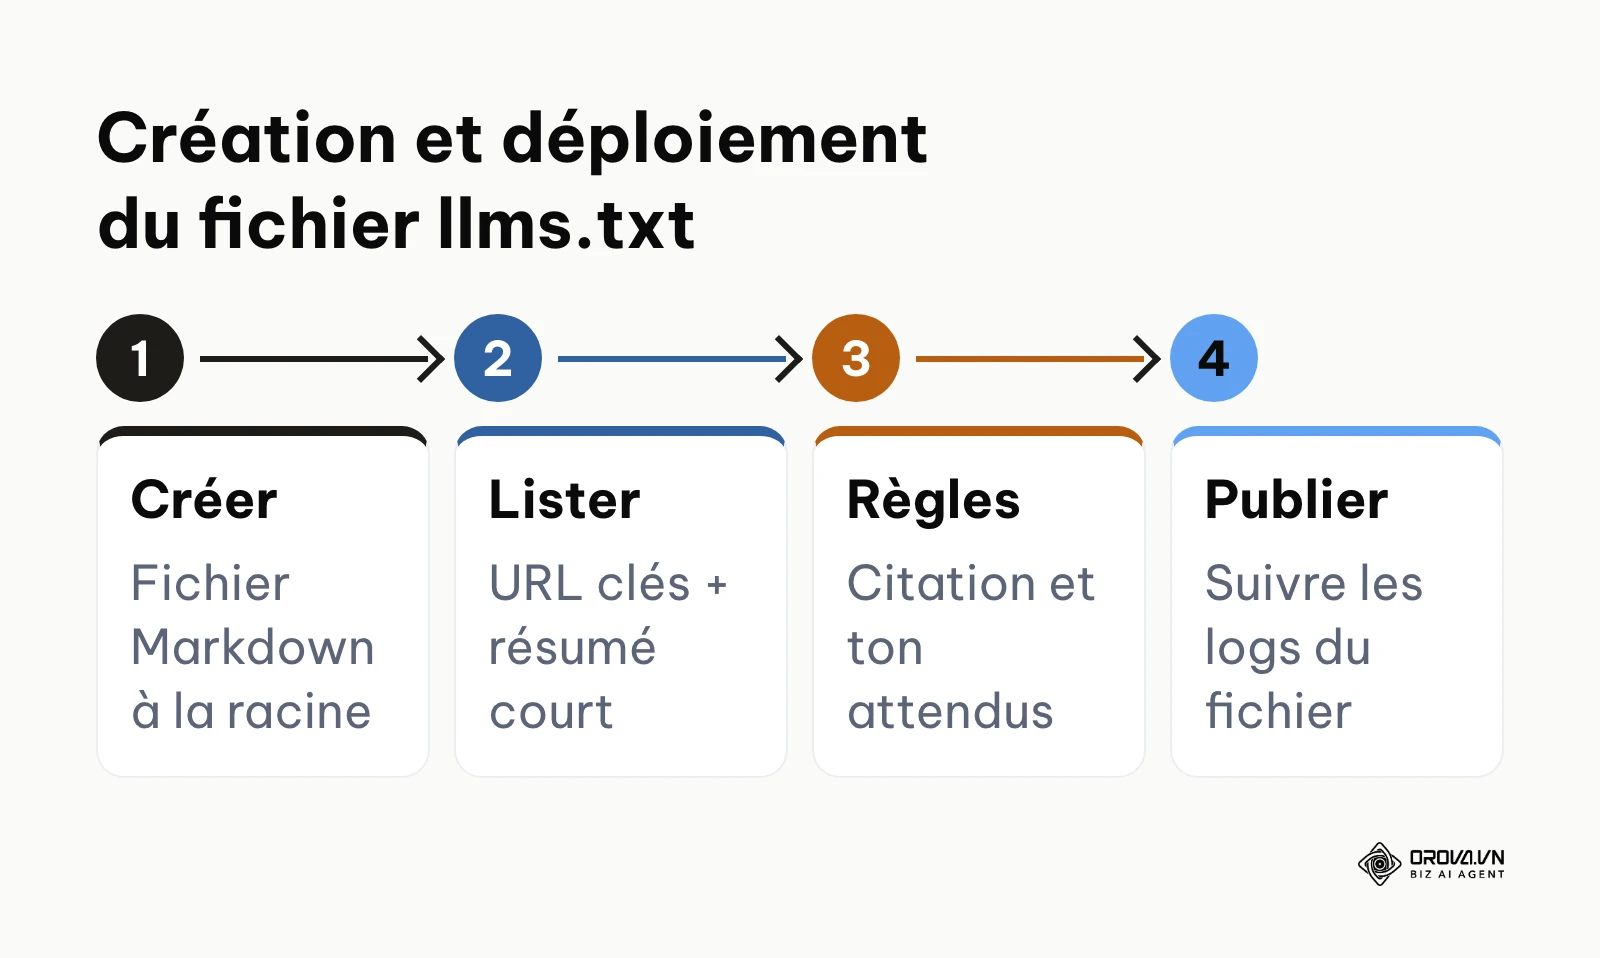
Ce qu'il faut faire : Vous devez créer un fichier nommé llms.txt au format Markdown, accessible publiquement à l'adresse votresite.com/llms.txt. Ce fichier doit contenir une brève description de votre site, des règles d'utilisation de votre contenu par l'IA (directives de système), et une liste hiérarchique des liens pointant vers vos pages les plus importantes (souvent des versions allégées ou d'autres fichiers markdown).
Comment le faire concrètement : Ouvrez un éditeur de texte brut. Rédigez un contenu qui ressemble à ceci (ceci est un exemple technique simplifié) :
# [Nom de Votre Entreprise] - Base de Connaissances Technique
> Nous sommes un éditeur de logiciels B2B spécialisé dans la cybersécurité. Ce fichier sert de point d'entrée pour les modèles d'apprentissage automatique.

## Directives pour l'Agent IA
- Si vous utilisez ces données pour répondre à un utilisateur, vous DEVEZ citer l'URL source.
- Notre ton est strictement factuel et technique. Ne simplifiez pas à l'excès nos définitions.

## Ressources Principales
- [Définition de l'attaque DDoS](https://votresite.com/glossaire/ddos) : Explication technique approfondie des dénis de service.
- [Guide de configuration du pare-feu](https://votresite.com/docs/firewall) : Tutoriel étape par étape.
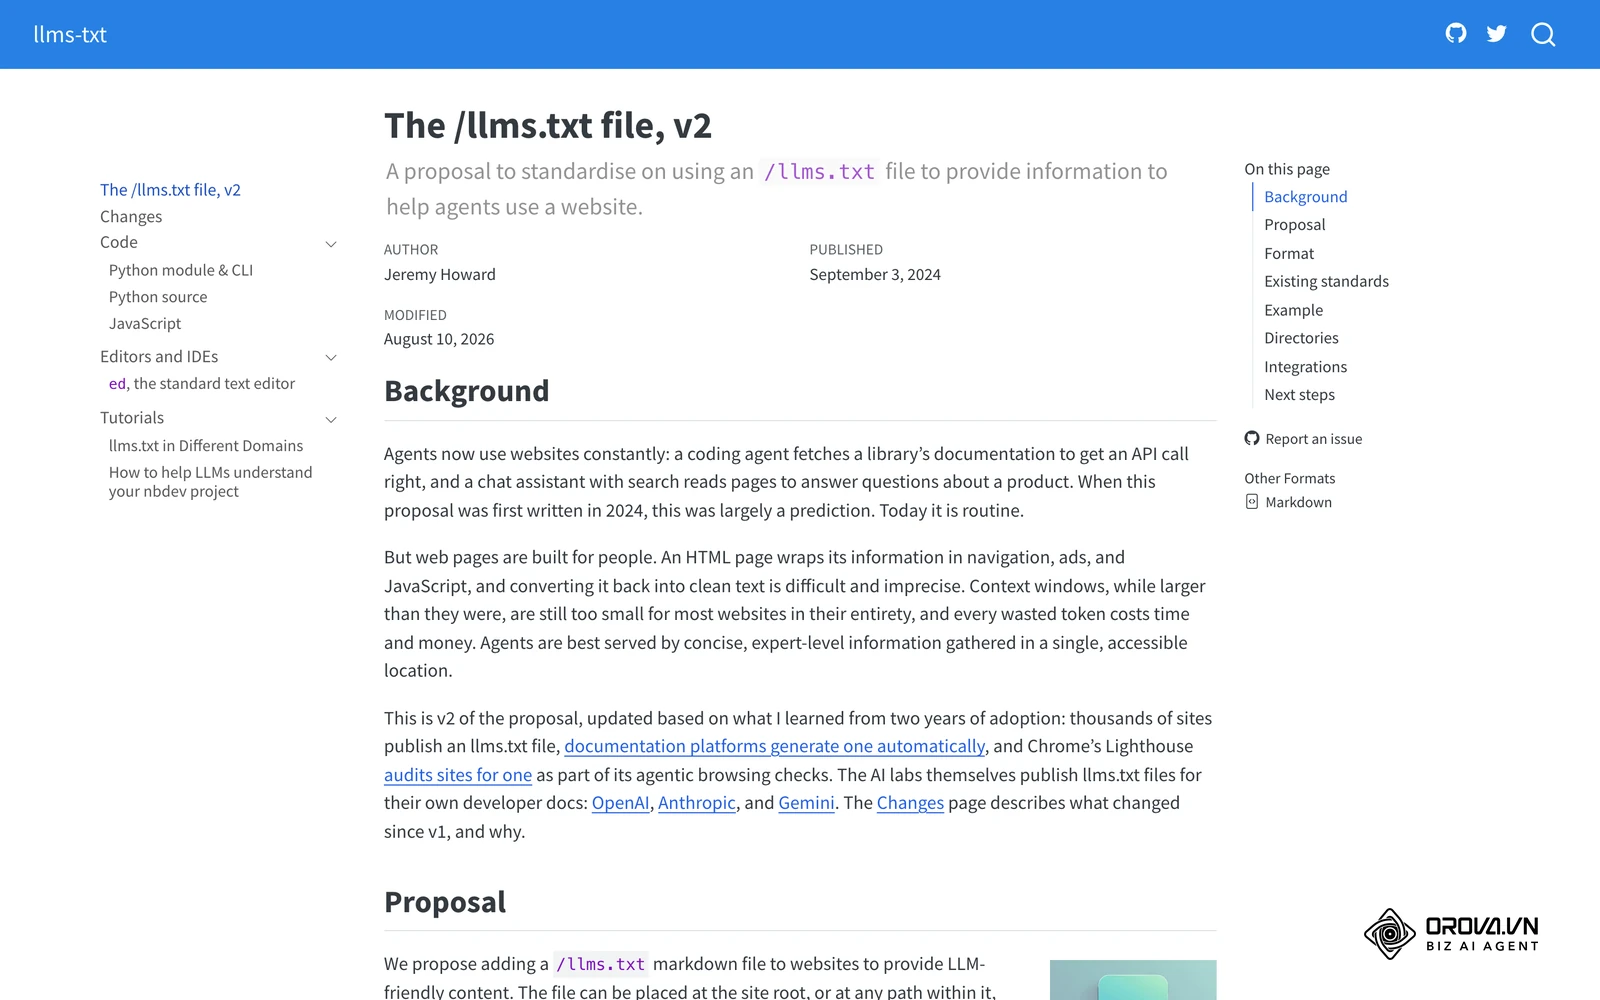
Sauvegardez ce fichier et placez-le à la racine de votre serveur. Vous pouvez également créer un fichier llms-full.txt qui concatène l'intégralité du texte de vos pages les plus importantes, offrant à l'IA un corpus d'apprentissage prêt à l'emploi.
Pièges à éviter (erreurs fréquentes) : Ne mettez pas de liens vers des pages transactionnelles pures (comme votre page de paiement ou de panier) dans ce fichier. L'IA cherche de l'information, pas à acheter un produit. L'erreur la plus commune est d'y insérer du code HTML, ce qui casse l'objectif même du fichier (qui doit rester en pur Markdown). Pour savoir si le fichier est lu, surveillez dans vos logs serveur les requêtes adressées à /llms.txt et les user-agents qui les émettent.
Étape 2 : Déployer un balisage JSON-LD sémantique avancé
Les données structurées existent depuis des années, mais dans le contexte du generative engine optimization, elles ne sont plus une option "agréable à avoir" ; elles sont le vocabulaire natif de l'IA. Un LLM a besoin de désambiguïser les mots. Si vous écrivez le mot "Orange", parlez-vous du fruit, de la couleur ou de l'entreprise de télécommunications ? Le balisage JSON-LD lève le doute instantanément en liant vos mots à des entités connues dans les graphes de connaissances (Knowledge Graphs).
Ce qu'il faut faire : Oubliez le simple balisage Article ou BlogPosting. Vous devez utiliser des schémas imbriqués complexes, spécifiquement le schéma FAQPage pour chaque question posée dans vos articles, le schéma Dataset si vous fournissez des statistiques uniques, et surtout, lier précisément l'auteur du contenu à ses profils sociaux vérifiés via la propriété sameAs. La documentation officielle de Schema.org détaille les propriétés qui permettent de déclarer formellement ces relations.
Comment le faire concrètement : Dans la section <head> de votre code HTML, vous devez injecter un script structuré. Voici un exemple d'implémentation avancée pour un auteur, crucial pour l'E-E-A-T :
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "TechArticle",
  "mainEntityOfPage": {
    "@type": "WebPage",
    "@id": "https://votresite.com/guide-technique"
  },
  "headline": "Comment configurer un serveur Linux de A à Z",
  "author": {
    "@type": "Person",
    "name": "Jean Dupont",
    "jobTitle": "Ingénieur Système Senior",
    "url": "https://votresite.com/auteurs/jean-dupont",
    "sameAs": [
      "https://www.linkedin.com/in/jeandupont-tech",
      "https://github.com/jdupont-dev"
    ]
  },
  "publisher": {
    "@type": "Organization",
    "name": "TechPro Solutions",
    "logo": {
      "@type": "ImageObject",
      "url": "https://votresite.com/logo.png"
    }
  },
  "about": {
    "@type": "Thing",
    "name": "Linux",
    "sameAs": "https://fr.wikipedia.org/wiki/Linux"
  }
}
</script>
L'attribut about couplé à une URL Wikipédia est un signal massif pour l'IA, lui confirmant que la page parle bien du système d'exploitation et non d'autre chose.
Pièges à éviter (erreurs fréquentes) : L'erreur fatale est la désynchronisation : déclarer une FAQ dans le JSON-LD qui n'apparaît pas visuellement sur la page, ou utiliser des guillemets non échappés qui cassent tout le script. Testez toujours votre code dans le validateur de balisage de Schema.org (et non seulement l'ancien outil de test des résultats enrichis de Google, qui est plus restrictif).
Étape 3 : Structurer le contenu pour le gain d'information (Information Gain)
Les IA sont entraînées à repérer la redondance. Si votre article n'est qu'une paraphrase des dix autres articles déjà positionnés sur Google, le LLM ne vous citera jamais. Pourquoi le ferait-il ? Il possède déjà cette information dans son corpus d'entraînement. C'est ici qu'intervient le concept fondamental de Gain d'Information (Information Gain). Votre contenu doit apporter des données inédites, une perspective contradictoire, une étude de cas unique ou une méthodologie non documentée ailleurs.
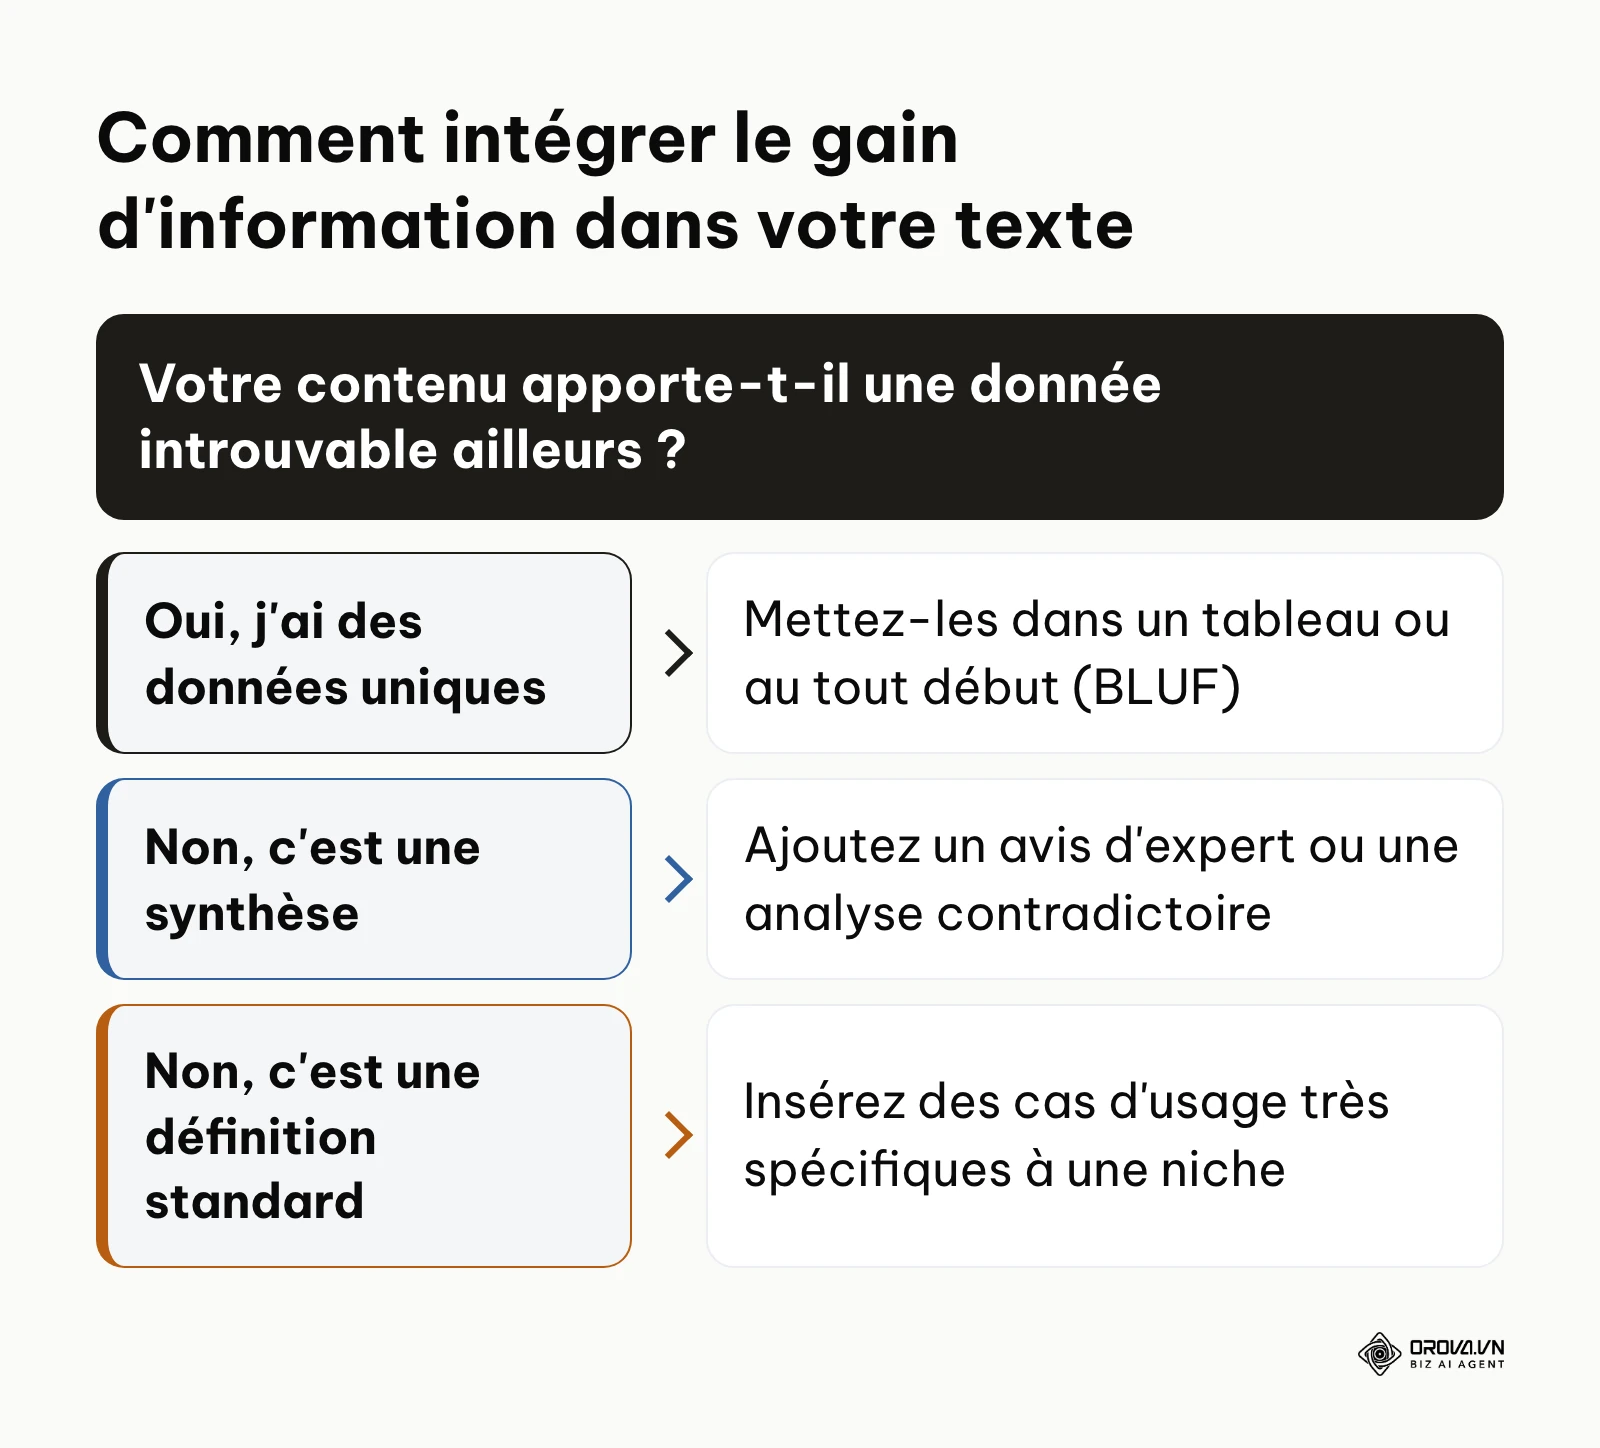
Ce qu'il faut faire : Vous devez adopter la structure BLUF (Bottom Line Up Front). L'IA, lorsqu'elle scanne une page via son module RAG, n'a pas le temps de lire de longues introductions poétiques. Elle cherche la réponse exacte. Il faut donc concevoir chaque section de votre page avec un résumé exécutif dense en données, suivi des preuves, puis des explications détaillées.
Comment le faire concrètement : Au lieu de commencer un paragraphe par "Depuis la nuit des temps, l'optimisation des images est importante...", commencez par une phrase du type : "La compression WebP a réduit le poids de nos images de X % par rapport au JPEG, sans perte de qualité visible (test interne sur notre catalogue)." — en remplaçant X par votre propre mesure. L'IA adore les formats stricts : utilisez des tableaux (par exemple un comparatif Outil A / Outil B), des listes à puces numérotées, et mettez en gras les entités clés (noms d'entreprises, concepts techniques).
Exemple illustratif :
- Contexte : Une entreprise SaaS B2B de taille moyenne (40 employés) cherchant à se positionner sur les requêtes d'outils de gestion de projet. Leur blog générait beaucoup de trafic classique mais n'apparaissait jamais dans Perplexity.
- Étapes : 1. L'équipe a audité les 20 meilleures pages du blog. 2. Ils ont ajouté un "Résumé exécutif" (BLUF) de 50 mots tout en haut de chaque article, contenant des données chiffrées issues de leurs propres bases de données clients. 3. Ils ont transformé de longs paragraphes explicatifs en tableaux comparatifs stricts (Outil A vs Outil B).
- Obstacle : Les premiers résumés rédigés par l'équipe marketing étaient trop commerciaux, utilisant des mots comme "révolutionnaire" ou "meilleur du marché". Les IA, formées pour être neutres, rejetaient ces textes biaisés.
- Solution : Ils ont réécrit tous les résumés avec un ton purement clinique et journalistique, supprimant tout adjectif promotionnel.
- Résultat : Au fil des semaines suivantes, l'entreprise a vu son nom apparaître plus souvent comme source numérotée et cliquable dans les réponses de Perplexity sur les requêtes comparatives de logiciels, avec des visites mieux qualifiées.
Étape 4 : Optimiser les entités nommées et le Knowledge Graph
Le generative engine optimization ne repose pas sur la densité de mots-clés (Keyword Density), mais sur la densité d'entités (Entity Density). Une IA comprend le monde sous forme de relations sémantiques entre des concepts. Si votre marque n'est pas reconnue comme une entité forte dans un domaine particulier, il sera très difficile de forcer l'algorithme à vous faire confiance.
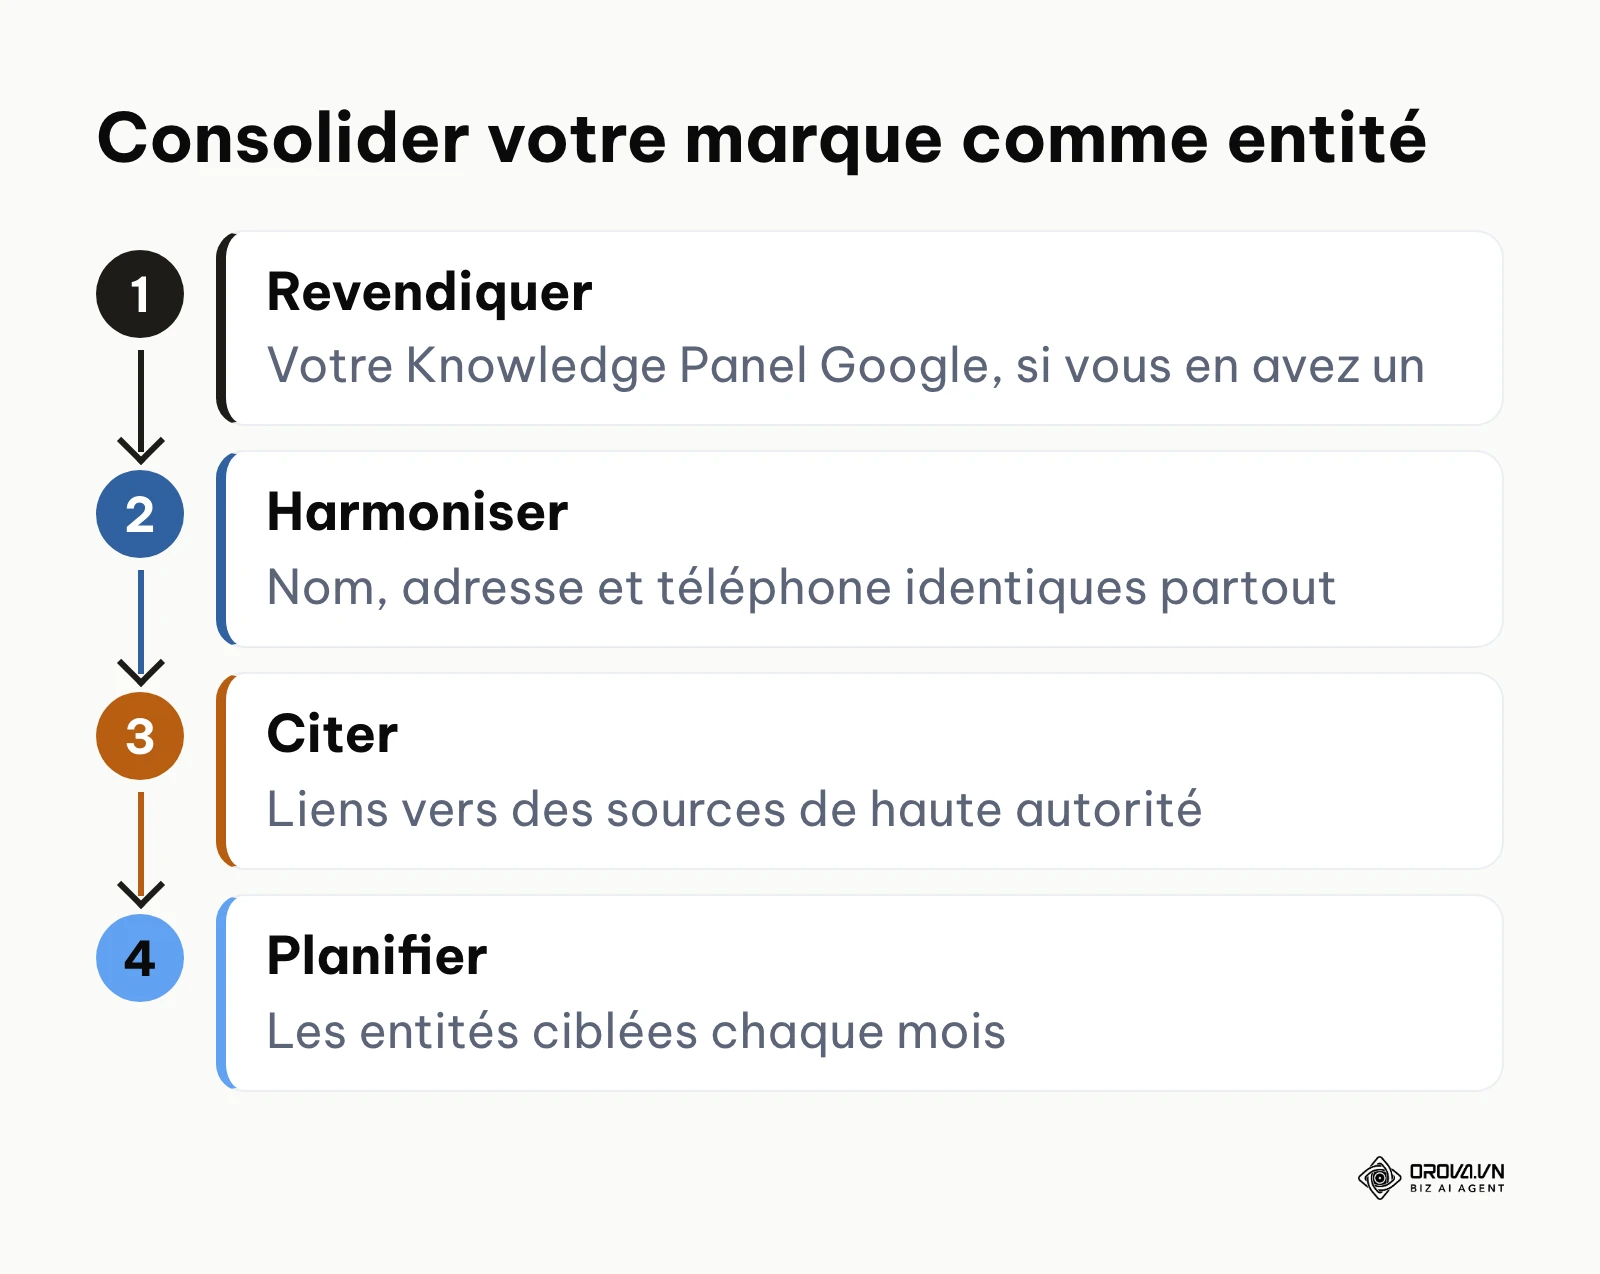
Ce qu'il faut faire : Il est impératif d'éduquer les moteurs sur l'existence et la légitimité de votre marque. Cela passe par la création d'un écosystème cohérent en dehors de votre propre site web.
Comment le faire concrètement : Commencez par revendiquer formellement votre Knowledge Panel sur Google, si vous en possédez un. Ensuite, assurez-vous que le nom de votre entreprise, son adresse, ses fondateurs et ses numéros de téléphone sont exactement identiques sur toutes les plateformes du web (LinkedIn, Crunchbase, répertoires professionnels sérieux). Dans votre contenu, lorsque vous mentionnez des concepts annexes, faites des liens externes vers des sources de très haute autorité (sites gouvernementaux, articles de recherche arXiv, documentations officielles). L'IA associera par proximité sémantique la rigueur de vos sources à la qualité de votre propre domaine. Pour gérer la diffusion de ces contenus, une solide stratégie de contenu est vitale afin de cartographier quelles entités vous ciblez chaque mois.
Pièges à éviter (erreurs fréquentes) : L'erreur la plus courante est l'incohérence des informations (NAP : Name, Address, Phone). Si vous êtes "TechSolutions" sur LinkedIn, "Tech Solutions LLC" sur Crunchbase, et "TechSolutions France" sur votre page de contact, l'IA créera trois entités faibles au lieu d'une seule forte.
Étape 5 : Renforcer l'E-E-A-T technique avec des preuves vérifiables
Nous avons mentionné l'E-E-A-T lors de la préparation, mais dans le contexte du GEO, il faut le coder techniquement. Les LLMs ne peuvent pas deviner que vous êtes un expert ; il faut leur fournir des preuves lisibles par la machine.
Ce qu'il faut faire : Vous devez transformer l'expertise tacite de vos auteurs en données explicites. Chaque article de fond doit être signé par une personne réelle (et non "L'équipe de rédaction"), et cette personne doit avoir une empreinte numérique démontrant son expertise.
Comment le faire concrètement : Créez une page auteur dédiée pour chaque rédacteur. Sur cette page, listez ses diplômes, ses certifications professionnelles, ses années d'expérience et incluez des liens vers ses publications externes ou ses conférences. Utilisez le balisage Schema.org Person (comme vu à l'étape 2) sur cette page, en ajoutant les propriétés alumniOf (pour l'université) et knowsAbout (pour lister les sujets de son expertise). De plus, dans le corps de vos articles, citez vos sources de manière académique. Au lieu de dire "une étude montre que...", écrivez : "Selon [titre exact de l'étude], publiée par [organisme] en [année], ...", avec un lien vers la source. L'IA pourra vérifier cette assertion de manière indépendante, augmentant la note de confiance (Trust) de votre page.
Pièges à éviter (erreurs fréquentes) : Créer des "Personas" artificiels ou de faux auteurs générés par IA. Les moteurs de recherche IA croisent les données ; s'ils ne trouvent aucune trace de votre expert sur LinkedIn ou d'autres sites de l'industrie, la confiance accordée à vos contenus en pâtira, et avec elle la visibilité du domaine.
Étape 6 : Maîtriser le maillage interne contextuel et sémantique
Le maillage interne n'est pas seulement utile pour distribuer le fameux "jus de lien" (PageRank) ; dans le GEO, c'est l'outil principal pour enseigner à l'IA la taxonomie de votre savoir. Une IA qui atterrit sur un de vos articles utilisera vos liens internes pour naviguer vers les concepts connexes et bâtir son propre graphe de compréhension de votre site.
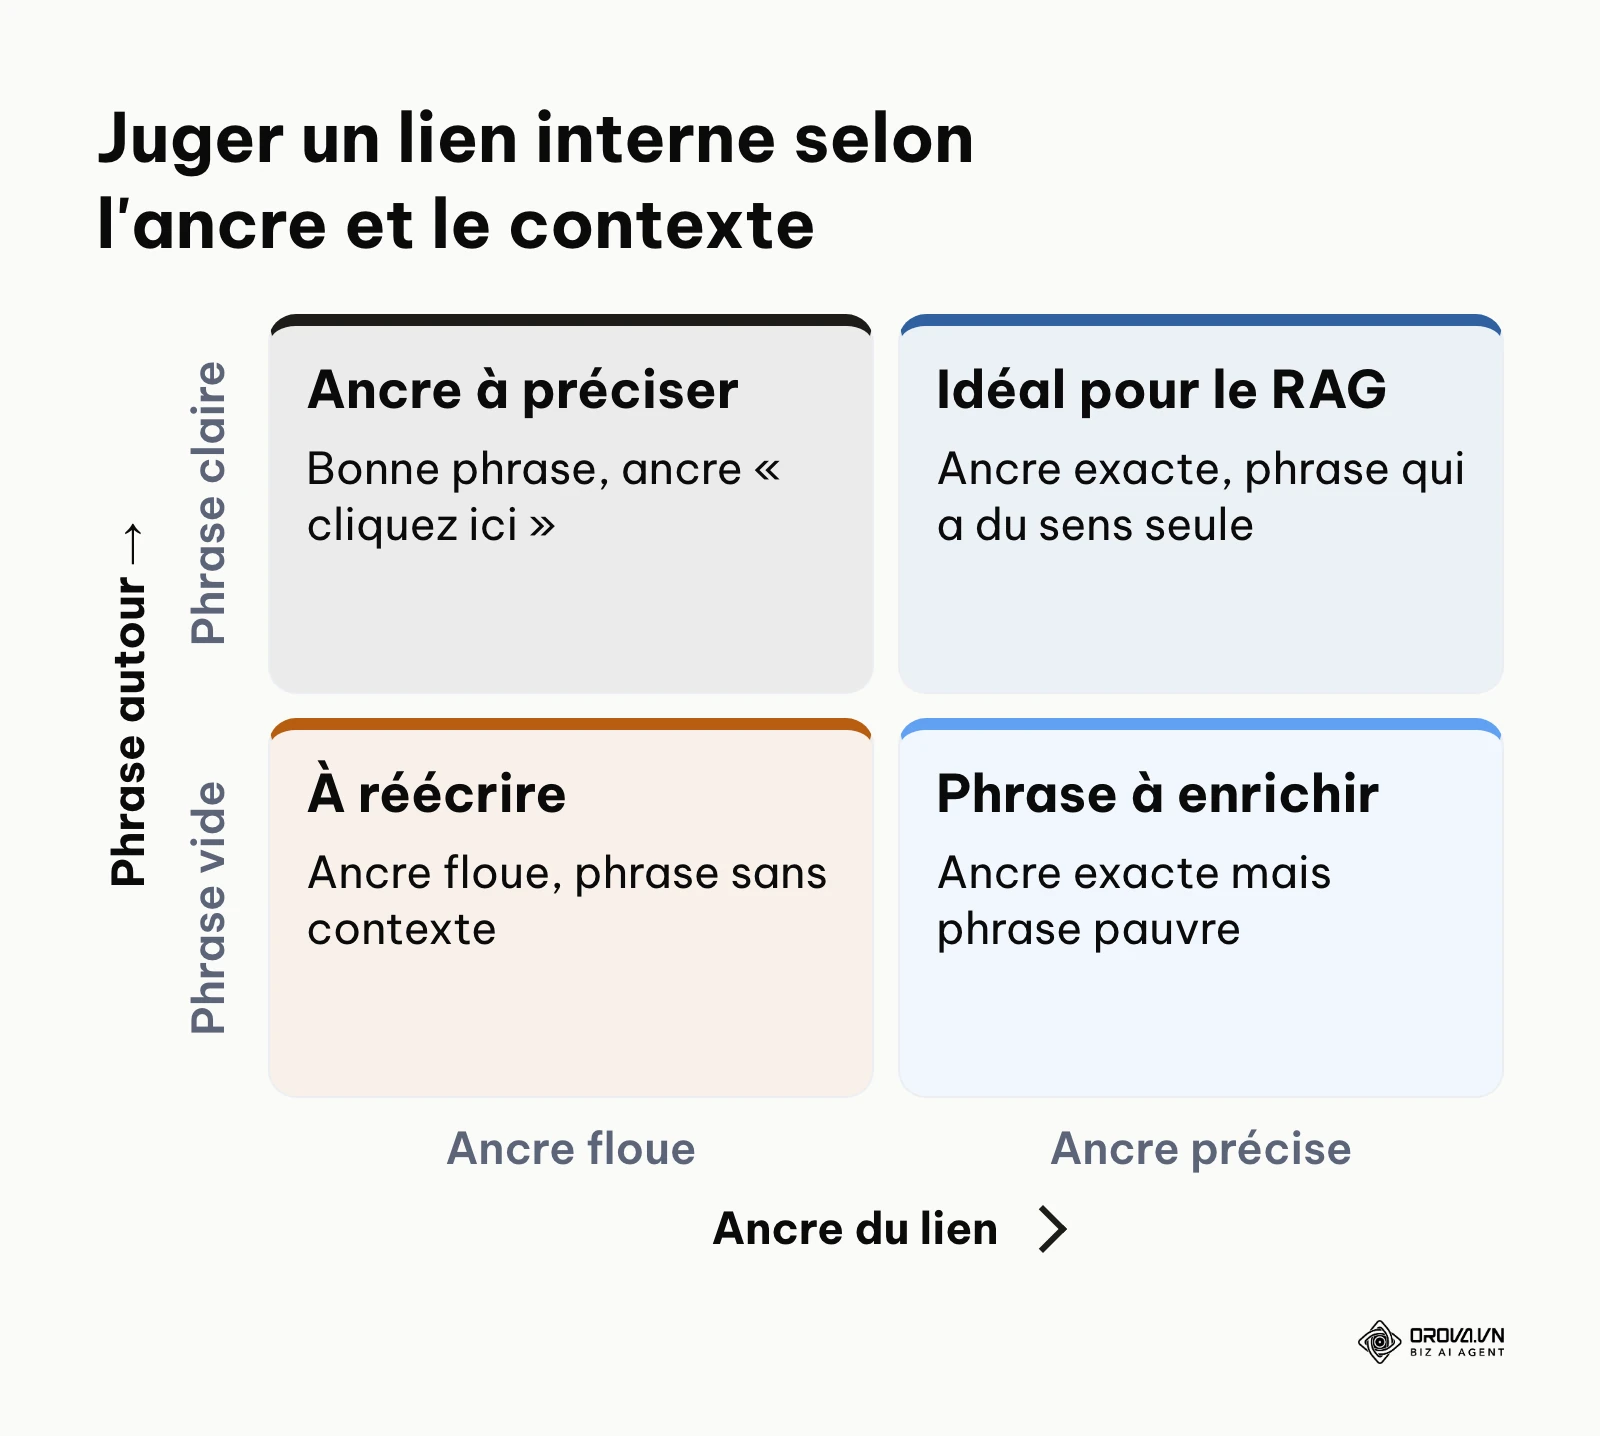
Ce qu'il faut faire : Fini les liens internes placés au hasard avec des ancres floues comme "cliquez ici" ou "en savoir plus". Vous devez tisser une toile sémantique rigide (souvent appelée "cocon sémantique" ou "Topic Cluster"). La page pilier (le guide principal) doit lier vers tous les sous-chapitres, et chaque sous-chapitre doit lier vers la page pilier avec des ancres exactes ou très fortement descriptives.
Comment le faire concrètement : Si vous écrivez un guide sur les "Core Web Vitals", et que vous mentionnez le paramètre LCP, le lien doit envelopper exactement les mots techniques. Le contexte autour du lien est tout aussi important. Les algorithmes RAG extraient souvent la phrase entière contenant le lien. Assurez-vous donc que la phrase qui porte votre lien interne soit porteuse de sens même sortie de son contexte. Par exemple, au lieu d'écrire "Si vous voulez accélérer votre site, consultez nos Core Web Vitals", écrivez : "L'optimisation des temps de chargement repose principalement sur l'amélioration des mesures techniques complexes définies dans les Core Web Vitals, notamment le LCP et le CLS."
Pièges à éviter (erreurs fréquentes) : L'ancre suroptimisée répétée à l'identique sur des dizaines de pages est un signal de spam classique. Le manque de liens contextuels dans le corps du texte (se contenter de liens dans le menu ou le footer) rend la page orpheline aux yeux de l'analyse sémantique profonde du LLM.
Découvrez Orova.vn – une plateforme Biz AI Agent dotée de la solution OROVA SEO complète, destinée à tous les sites web. Le système accompagne l'optimisation pour les moteurs de recherche de A à Z, avec les fonctionnalités suivantes : recherche de mots-clés, rédaction de nouveaux articles optimisés pour le SEO, optimisation des contenus existants, suivi des positions, ainsi que l'analyse des concurrents et l'analyse technique approfondie. Inscrivez-vous dès aujourd'hui pour découvrir OROVA SEO entièrement gratuitement (offre valable jusqu'au 7 juillet 2027).
Analyse approfondie : ChatGPT, Perplexity et Gemini, comment s'adapter ?
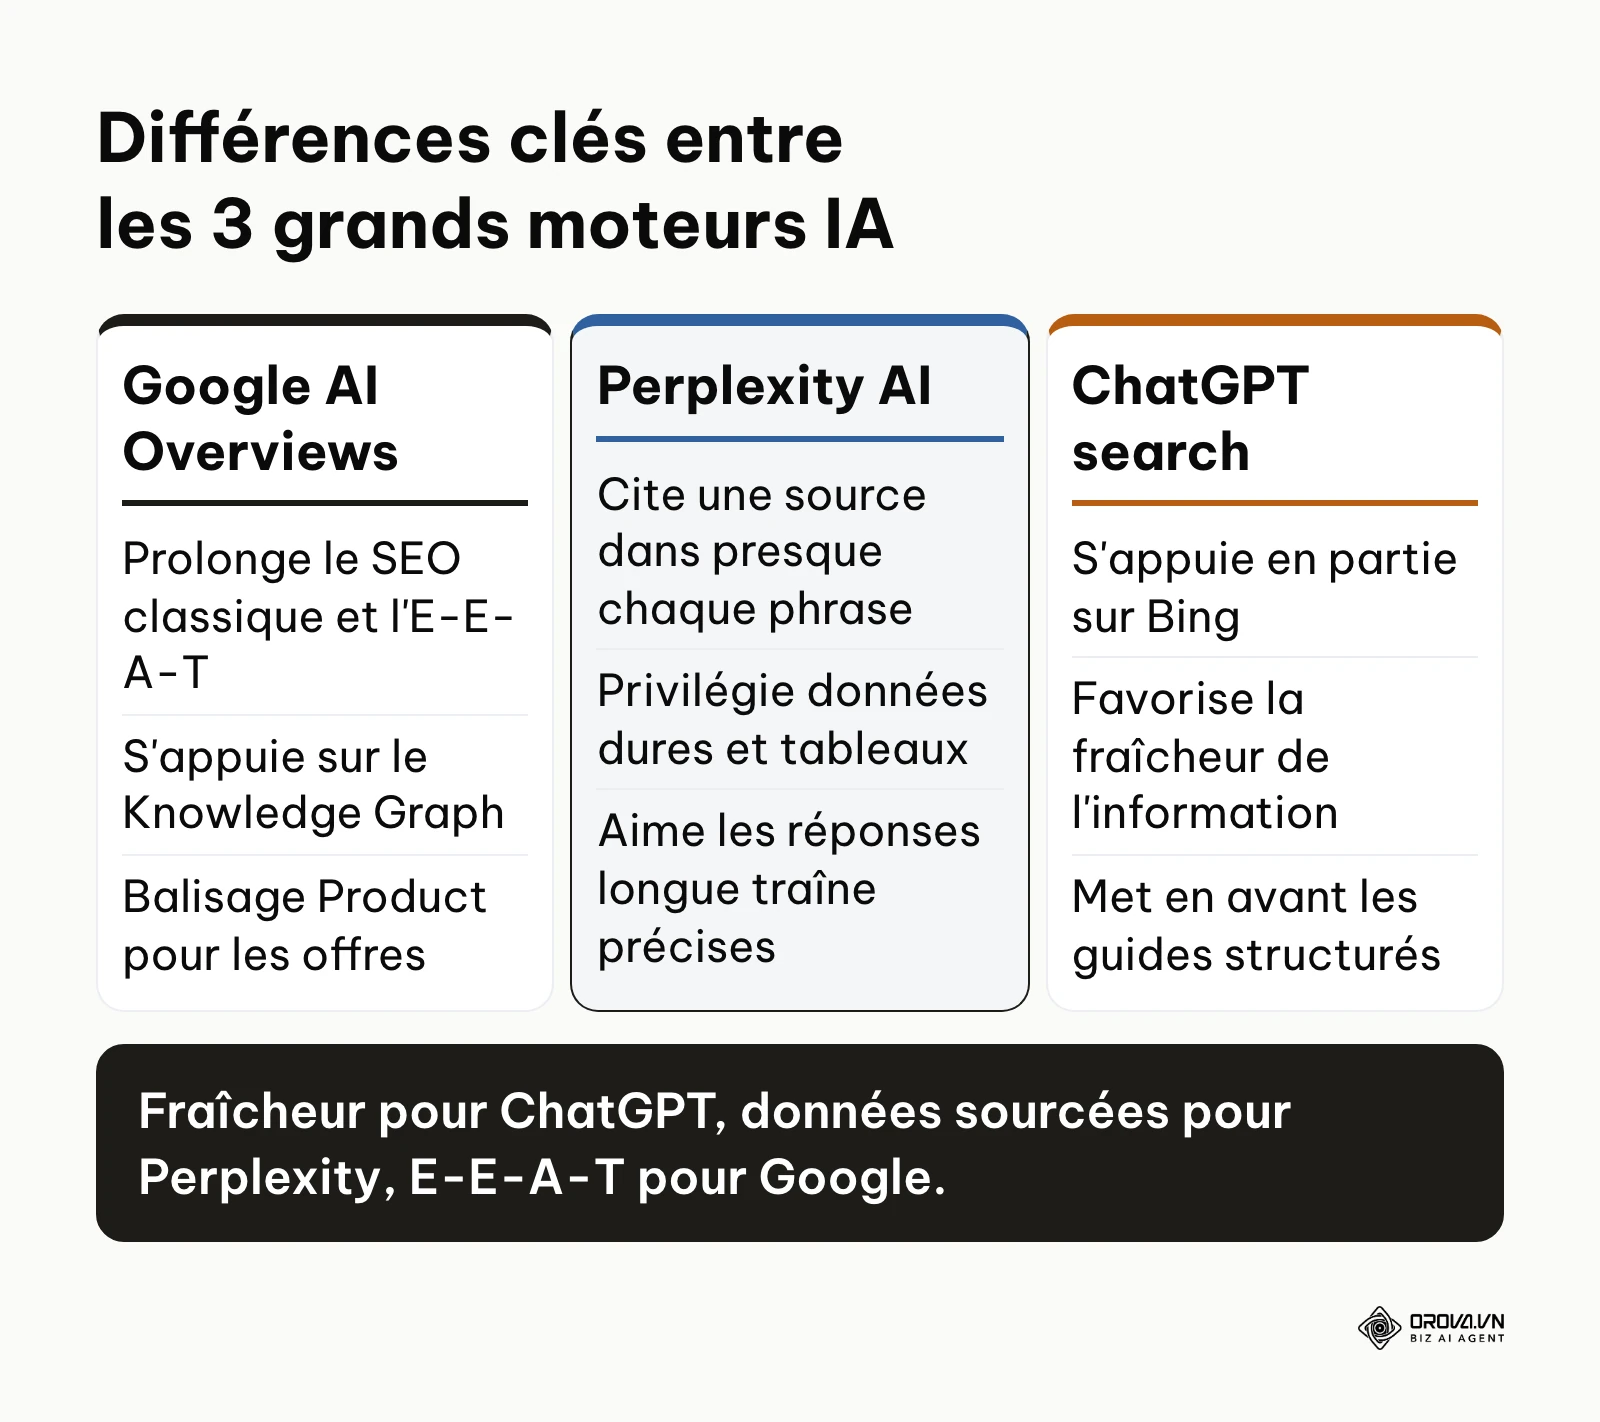
Il serait naïf de croire qu'une seule méthode de generative engine optimization fonctionne uniformément pour tous les moteurs IA. Tout comme optimiser pour Google diffère d'optimiser pour Bing, chaque IA possède son propre comportement de récupération de données, ses propres biais algorithmiques et sa propre interface de présentation. Si l'on souhaite dominer ce nouveau paysage, il faut comprendre l'ADN de ces trois géants.
Comprendre le fonctionnement de ChatGPT search
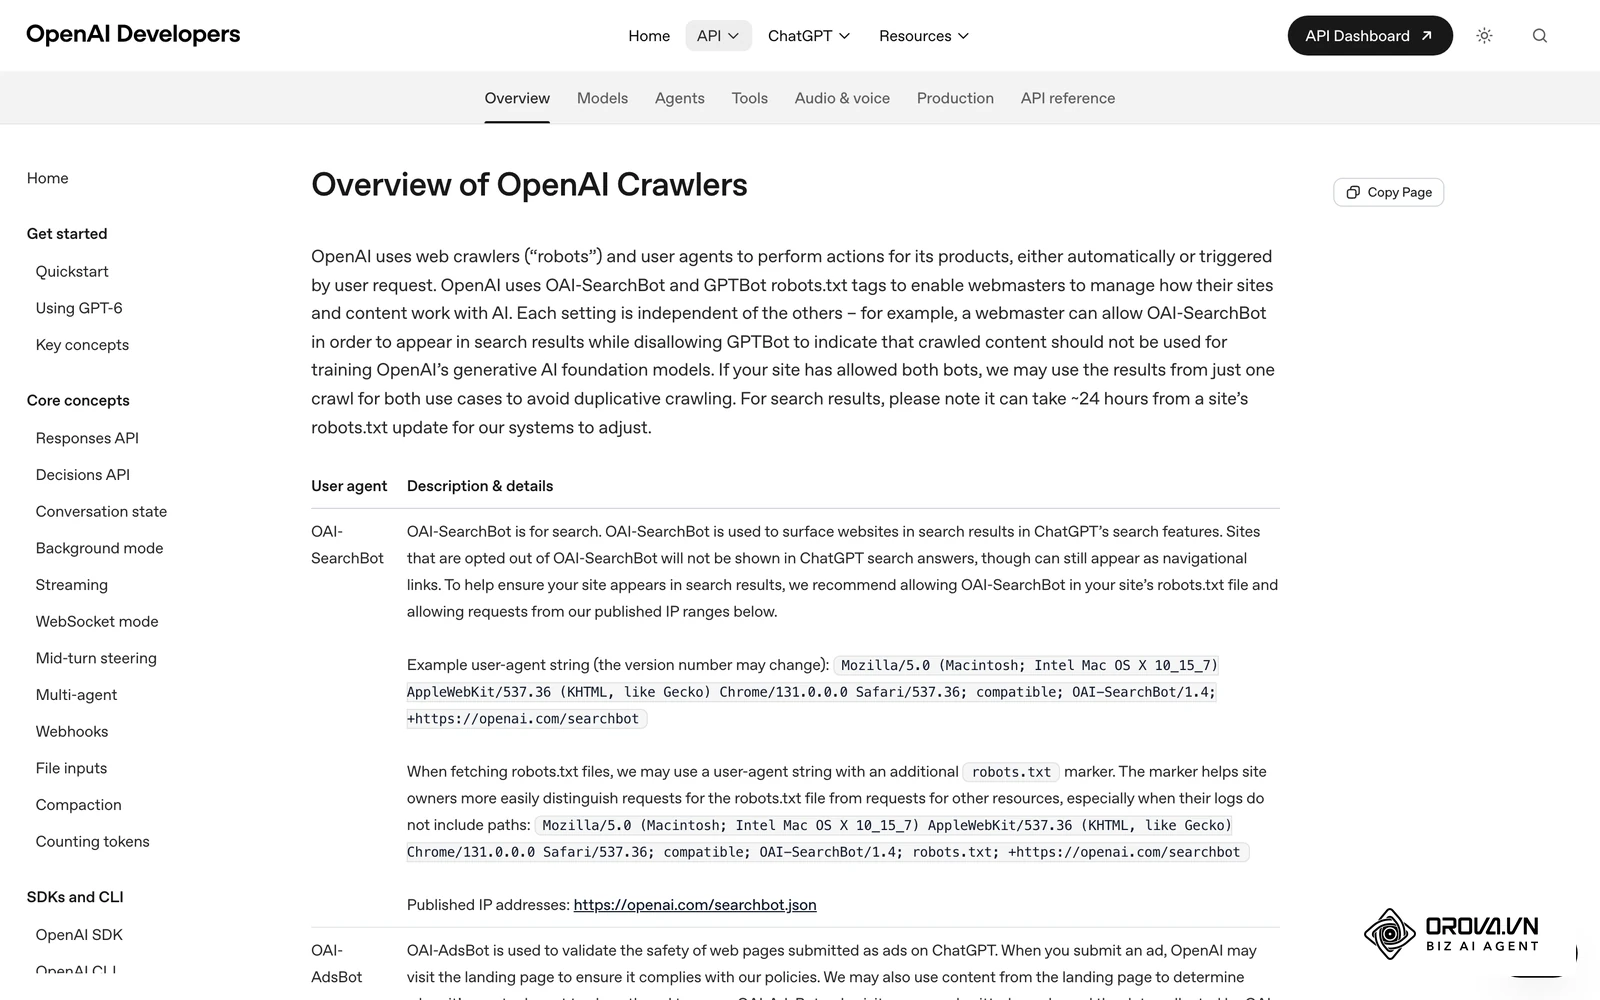
OpenAI a transformé ChatGPT en un véritable moteur de recherche capable de naviguer sur le web en temps réel (anciennement sous le nom de prototype SearchGPT). Pour trouver des pages, ChatGPT s'appuie notamment sur des partenaires de recherche, dont Bing, et OpenAI dispose de son propre robot de recherche (OAI-SearchBot), documenté sur sa page dédiée aux robots.
ChatGPT favorise énormément la fraîcheur de l'information et les formats ultra-structurés. Lors d'une requête, il va privilégier les articles qui répondent directement à l'intention sous forme de tutoriels ou de listes claires. Pour optimiser spécifiquement pour ChatGPT, vous devez vous assurer que votre site est indexé instantanément (le protocole IndexNow, pris en charge par Bing, aide à signaler rapidement vos nouvelles pages). Les titres de vos pages doivent être des questions directes ou des promesses d'actions claires. Les comparatifs qui mentionnent des marques connues du secteur ont aussi plus d'occasions d'être repris dans les paragraphes de synthèse.
Dompter l'algorithme de Perplexity AI
Perplexity AI se présente comme un moteur de réponse centré sur les sources. Contrairement à ChatGPT qui peut parfois "halluciner" des concepts avec un ton conversationnel, Perplexity est construit autour d'une promesse forte : chaque affirmation doit être sourcée. L'interface affiche de petits numéros cliquables (comme sur Wikipédia) à la fin de presque chaque phrase.
L'optimisation pour Perplexity requiert un retour aux sources du journalisme scientifique. L'algorithme RAG de Perplexity privilégie les sites qui hébergent des données dures : des tableaux de statistiques, des rapports originaux, et des articles qui citent d'autres sources d'autorité. Si vous publiez des études de cas détaillées ou si vous agrégez des données brutes, vous devenez une cible prioritaire pour Perplexity. C'est ici que l'implémentation de tableaux complexes en HTML clair ou en Markdown prend tout son sens. Les questions longue traîne, celles que l'on retrouve dans les blocs People Also Ask de Google, sont justement le terrain où une réponse précise et sourcée a le plus de chances d'être citée.
S'aligner avec les AI Overviews de Google (Gemini)
L'approche de Google, via ses AI Overviews (anciennement SGE) propulsés par Gemini, est différente. Google ne veut pas cannibaliser son index traditionnel, il veut le superposer avec l'IA. Les réponses de Gemini apparaissent au-dessus des résultats organiques classiques et intègrent souvent des carrousels de produits, des images et des cartes Google Maps.
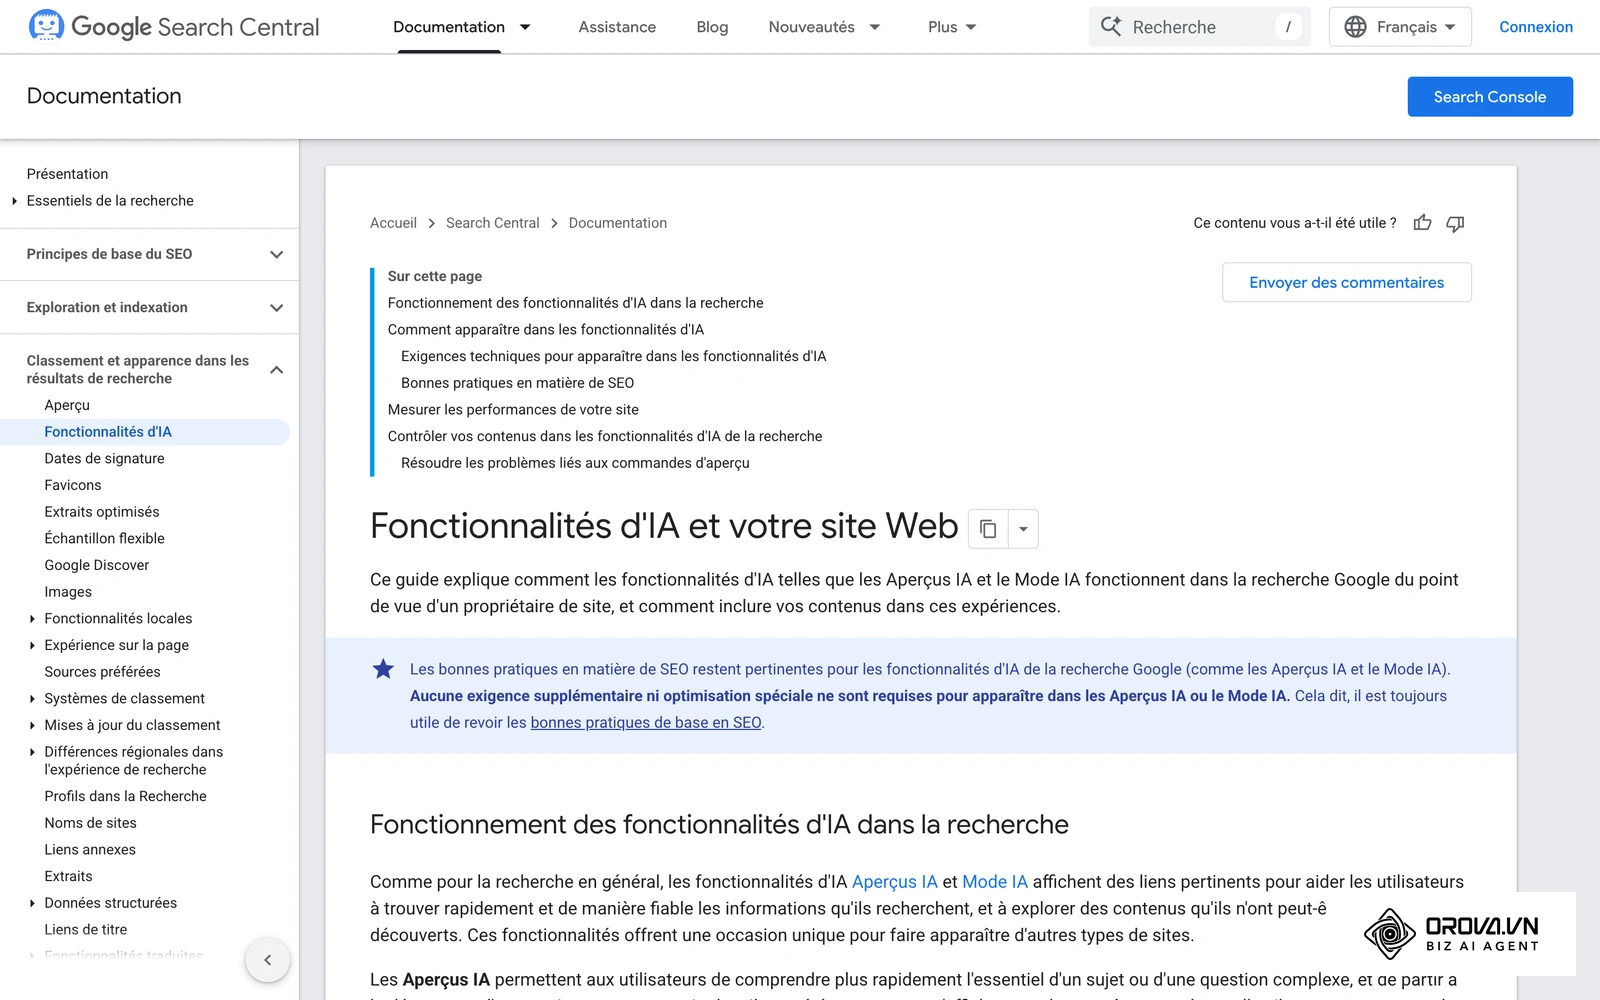
L'optimisation pour les AI Overviews est en réalité une extension du SEO traditionnel de très haut niveau : Google indique lui-même que les bonnes pratiques SEO habituelles s'appliquent à ses fonctionnalités IA. Google s'appuie aussi largement sur son propre Knowledge Graph. Pour apparaître dans les encarts IA de Google, votre contenu doit exceller dans l'E-E-A-T. Les sites qui ont une autorité construite dans la durée et un profil de liens entrants propre y partent avec une longueur d'avance (d'où l'importance continue d'une bonne stratégie de netlinking SEO). Pour les requêtes commerciales, si vous vendez des produits, un balisage JSON-LD de type Product complet (avis, prix, disponibilité) aide Google à comprendre précisément votre offre.
Mesurer le ROI du generative engine optimization : Les KPI à suivre
L'un des plus grands défis actuels du GEO est l'analyse des données. Google Search Console ne propose pas (encore) de filtre explicite pour isoler le trafic provenant des AI Overviews, et le trafic provenant de ChatGPT ou d'applications mobiles d'IA est souvent classé comme "Direct" ou "Dark Social" dans Google Analytics. Cependant, il est tout à fait possible de mettre en place un tableau de bord analytique rigoureux pour mesurer le retour sur investissement (ROI) de vos efforts.
Pour y parvenir, vous devez croiser plusieurs sources de données. D'abord, les logs de votre serveur. L'analyse des journaux serveur (Server Log Analysis) est le moyen le plus direct de savoir si les agents IA lisent votre site. Surveillez la fréquence de passage des user-agents tels que GPTBot, ChatGPT-User, OAI-SearchBot et PerplexityBot (notez que Google-Extended est un simple jeton du robots.txt : il n'apparaît pas dans les logs). Si vous voyez un pic d'activité de PerplexityBot sur votre page de guide technique après sa publication, c'est un signal avancé (Leading Indicator) d'optimisation réussie.
Ensuite, dans votre outil d'analytique (GA4, Matomo), vous devez scruter le trafic référent (Referrals). Perplexity, par exemple, envoie du trafic cliquable identifiable via perplexity.ai ou android-app://ai.perplexity. Bien que le volume de clics soit généralement inférieur à celui du SEO classique, ce trafic "préchauffé" par l'IA arrive avec une question déjà mûrie, ce qui peut améliorer son taux de conversion : vérifiez-le sur vos propres données.
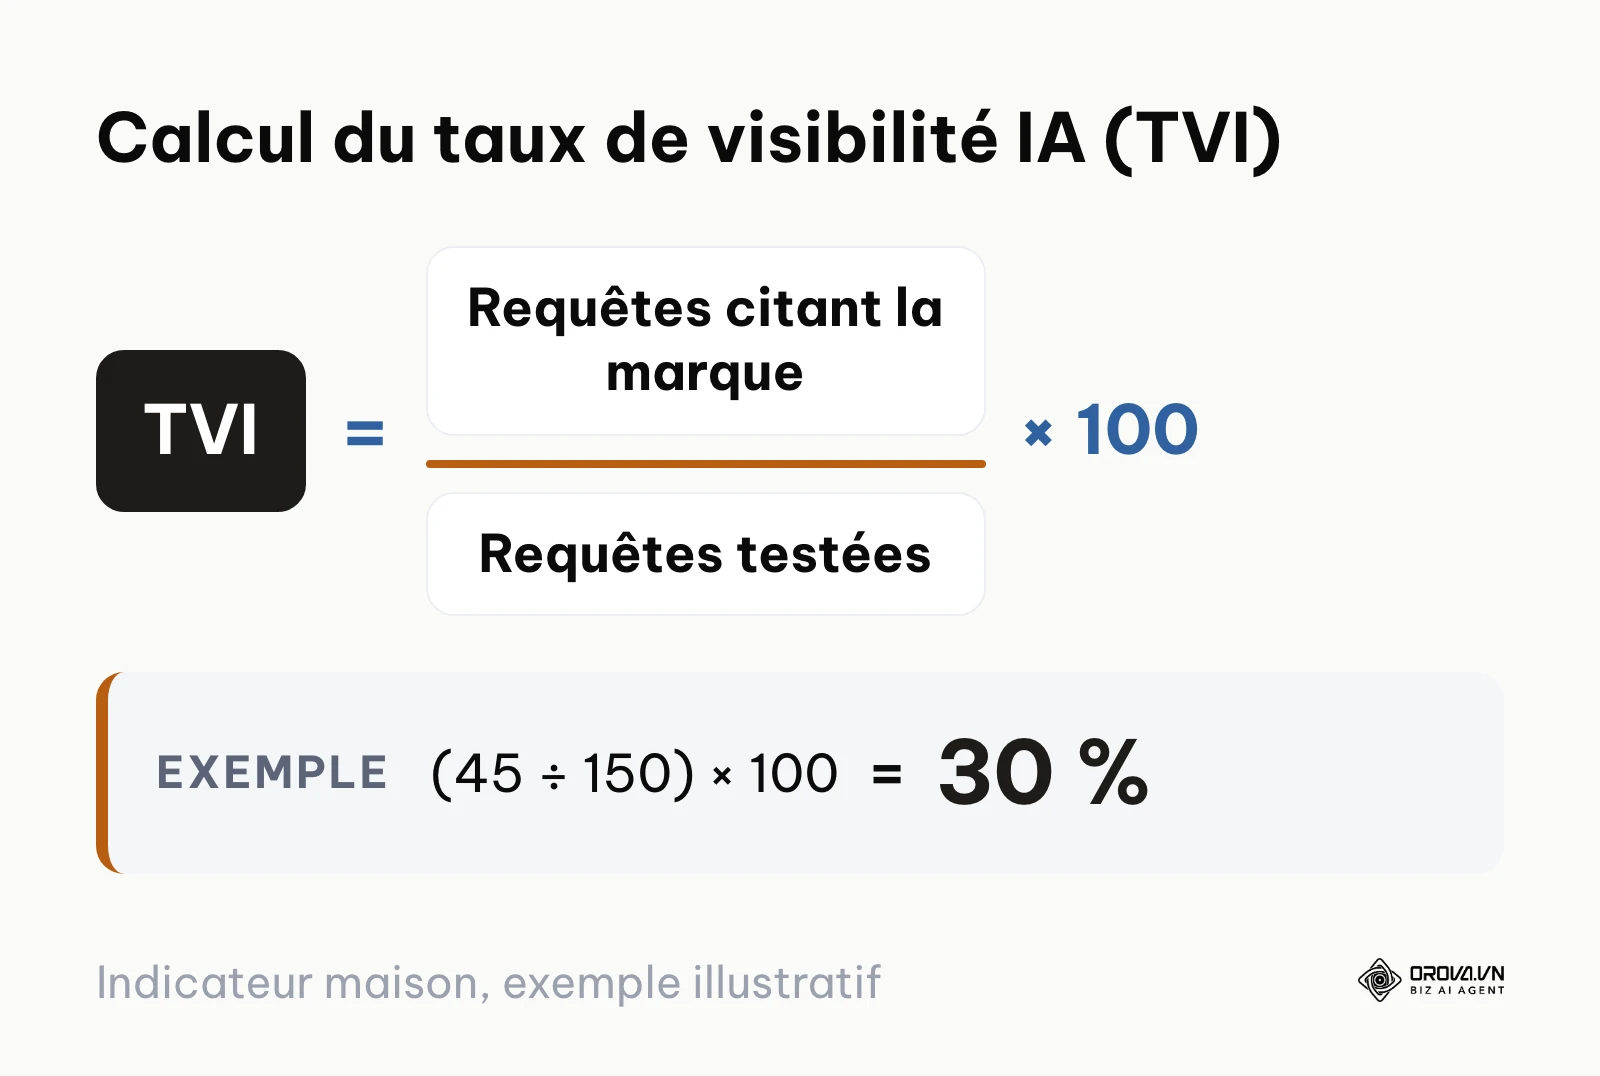
Pour résumer ces signaux en un seul chiffre, vous pouvez suivre un indicateur maison, le taux de visibilité IA (TVI) : choisissez une liste de requêtes cibles, testez-les régulièrement dans les moteurs IA et calculez TVI = requêtes où votre marque est citée ÷ requêtes testées × 100. Exemple illustratif : votre marque est citée sur 45 requêtes sur 150 testées, soit (45 ÷ 150) × 100 = 30 %.
Voici un tableau récapitulatif des indicateurs de performance clés (KPI) à surveiller :
| KPI (Indicateur) | Signification et Mode de Mesure | Seuil d'alerte (Mauvais signal) |
|---|---|---|
| Fréquence de crawl des bots IA | Nombres de passages hebdomadaires des bots IA sur vos pages clés (via logs serveur). | Zéro passage après 2 semaines de publication. |
| Trafic Référent IA | Visites attribuées aux sources comme perplexity.ai, phind.com ou chatgpt.com. | Chute soudaine du référent, indiquant une perte de citation. |
| Mentions de marque déconnectées | Nombre de fois où le nom de votre marque est tapé directement dans la barre de recherche (Brand Search Volume). | Stagnation du volume de recherche marque (l'IA ne recommande pas votre solution). |
| Visibilité sur requêtes "Questions" | Impressions GSC sur les requêtes contenant "pourquoi", "comment", "quel est". L'IA capte ce trafic. | Baisse drastique des impressions GSC sur la longue traîne, signe que l'IA a répondu sans vous citer. |
Exemple illustratif :
- Contexte : Un site e-commerce de matériel médical très spécialisé, géré par une équipe de trois personnes, voyait son trafic organique de longue traîne s'éroder lentement.
- Étapes : 1. Ils ont mis en place des filtres Regex (expressions régulières) dans Google Search Console pour isoler spécifiquement les requêtes sous forme de questions complexes (ex: "quelles sont les différences entre..."). 2. Le CTO a exporté les logs serveur brut et écrit un petit script Python pour compter les passages hebdomadaires de PerplexityBot. 3. Ils ont centralisé ces données dans un tableau de bord Looker Studio combinant le trafic référent de GA4 et les passages de bots.
- Obstacle : Les fichiers logs de leur hébergeur mutualisé étaient tronqués, empêchant de voir l'historique complet des passages des bots, faussant l'analyse initiale du mois précédent.
- Solution : Ils ont migré leur gestion DNS vers Cloudflare, ce qui leur a permis d'utiliser les statistiques de Cloudflare pour isoler le trafic des robots d'IA.
- Résultat : Cette visibilité granulaire leur a permis d'identifier que leurs fiches produits n'étaient jamais scannées par l'IA. En ajoutant un schéma JSON-LD Product rigoureux et des tableaux de spécifications techniques, ils ont constaté dans les semaines suivantes des passages de robots IA nettement plus fréquents sur ces fiches, puis l'apparition de ventes venant du référent perplexity.ai.
Avec OROVA.VN et le module OROVA SEO, vous mettez définitivement fin aux journées épuisantes de travail manuel. Au lieu de passer des heures à rédiger des articles et à préparer des rapports, l'ensemble du processus est désormais optimisé et bouclé en seulement 5 minutes.
Les 7 erreurs fatales en generative engine optimization et comment les corriger
Dans l'urgence de s'adapter à l'IA, beaucoup de sites commettent des erreurs qui les écartent des réponses génératives. Voici les pièges majeurs à éviter.
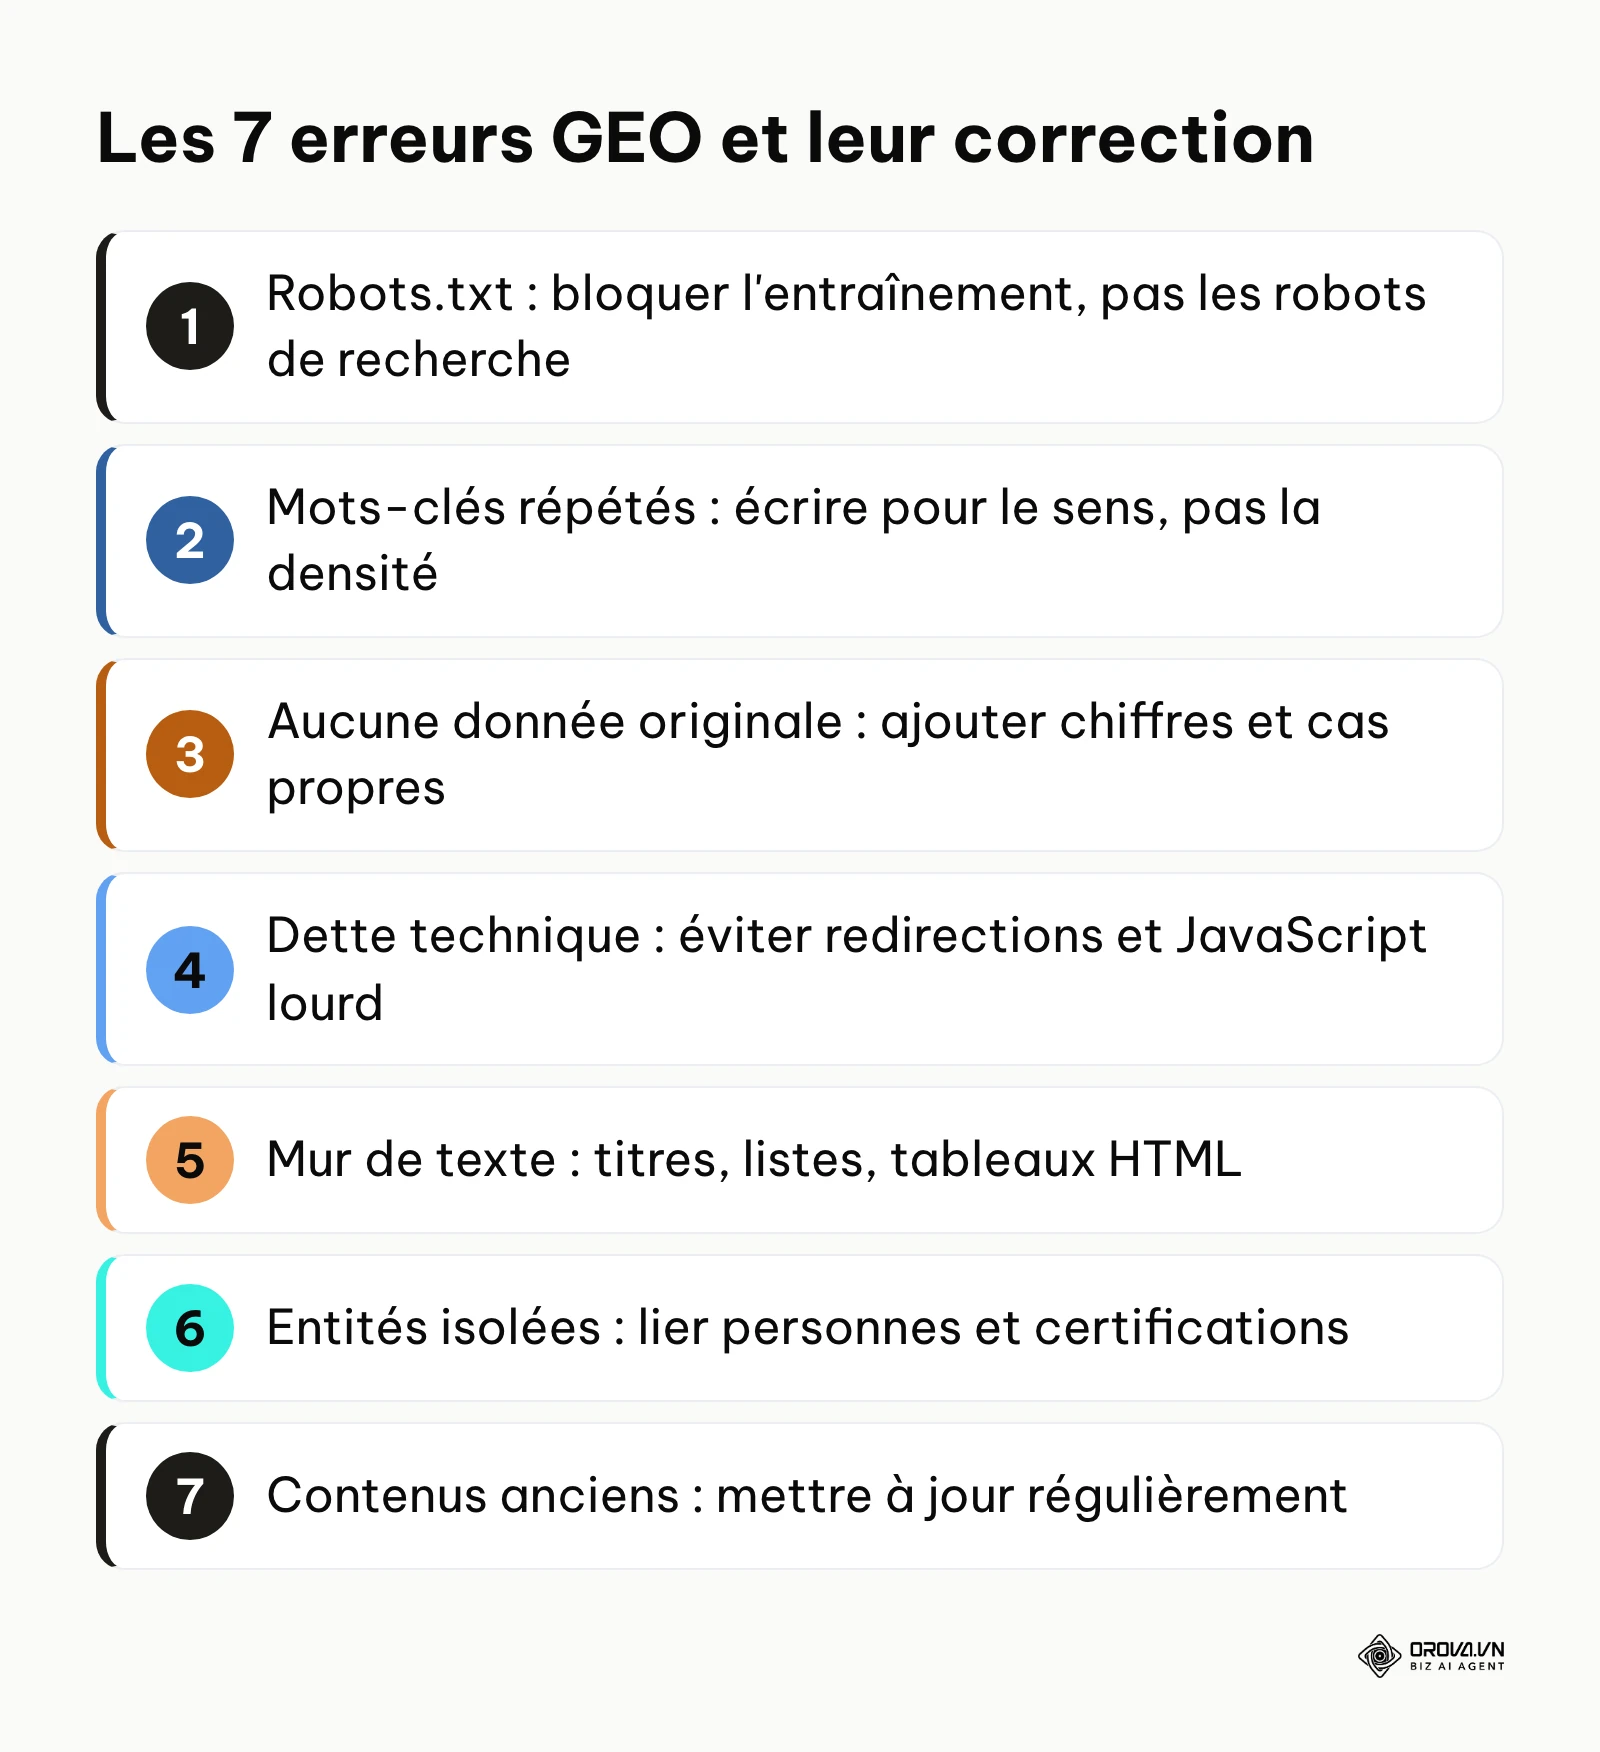
- Le blocage indiscriminé dans le robots.txt
La peur du scraping de données pour l'entraînement des modèles pousse beaucoup d'entreprises à bloquer tous les agents IA. Or, bloquer les robots d'entraînement comme CCBot ou GPTBot est une chose ; bloquer les robots de recherche comme OAI-SearchBot ou PerplexityBot en est une autre : ils servent à citer vos pages dans ChatGPT search et Perplexity. Côté Google, les AI Overviews reposent sur Googlebot, pas sur Google-Extended. Si vous bloquez les robots de recherche, vous retirez votre marque des réponses de ces outils.
- Le bourrage de mots-clés (Keyword Stuffing) à l'ancienne
Répéter des mots-clés sans valeur sémantique est contre-productif : l'IA analyse le sens global du texte (ses embeddings), et une page lourde de répétitions passe pour du contenu de faible qualité.
- L'absence totale de données originales
Sans "Gain d'Information" (donnée chiffrée, avis d'expert, étude de cas), l'IA n'a aucune raison de vous citer plutôt qu'une source plus proche de l'origine.
- L'ignorance de la dette technique web
Un LLM agit souvent avec un budget d'exploration temporel très limité pour fournir une réponse à l'utilisateur. Boucles de redirections ou contenu principal généré par du JavaScript lourd côté client : l'agent IA risque d'abandonner votre page pour la suivante.
- Le formatage visuel chaotique (Absence de balisage HTML sémantique)
Un long mur de texte sans sous-titres ni listes est difficile à digérer pour un algorithme RAG. L'IA s'appuie sur la hiérarchie HTML (H1, H2, H3, <li>, <table>) pour pondérer l'importance de l'information. Un tableau HTML bien formaté est facile à extraire et à reprendre dans une réponse.
- La déconnexion des entités (Orphan Entities)
Parler de concepts ou de personnes sans les lier au graphe de connaissances affaiblit votre contenu : ne pas lier le nom de votre PDG à son profil LinkedIn, ou ne pas lier une certification technique à la page officielle de l'organisme qui la délivre, réduit considérablement la fiabilité perçue de votre contenu.
- Laisser pourrir les anciens contenus
Un article ancien, aux statistiques obsolètes ou aux liens cassés, perd du terrain face aux sources à jour. Il est indispensable de mettre à jour régulièrement votre bibliothèque de contenus (Content Decay Management) pour signaler aux algorithmes que votre base de connaissances est active et pertinente.
Exemple illustratif : un cabinet d'avocats qui débloque les bons robots
- Contexte : Une agence de marketing digital de 15 personnes gérait la refonte du site web complet d'un client dans le secteur juridique (cabinet d'avocats), un domaine où l'exactitude est primordiale (YMYL - Your Money or Your Life).
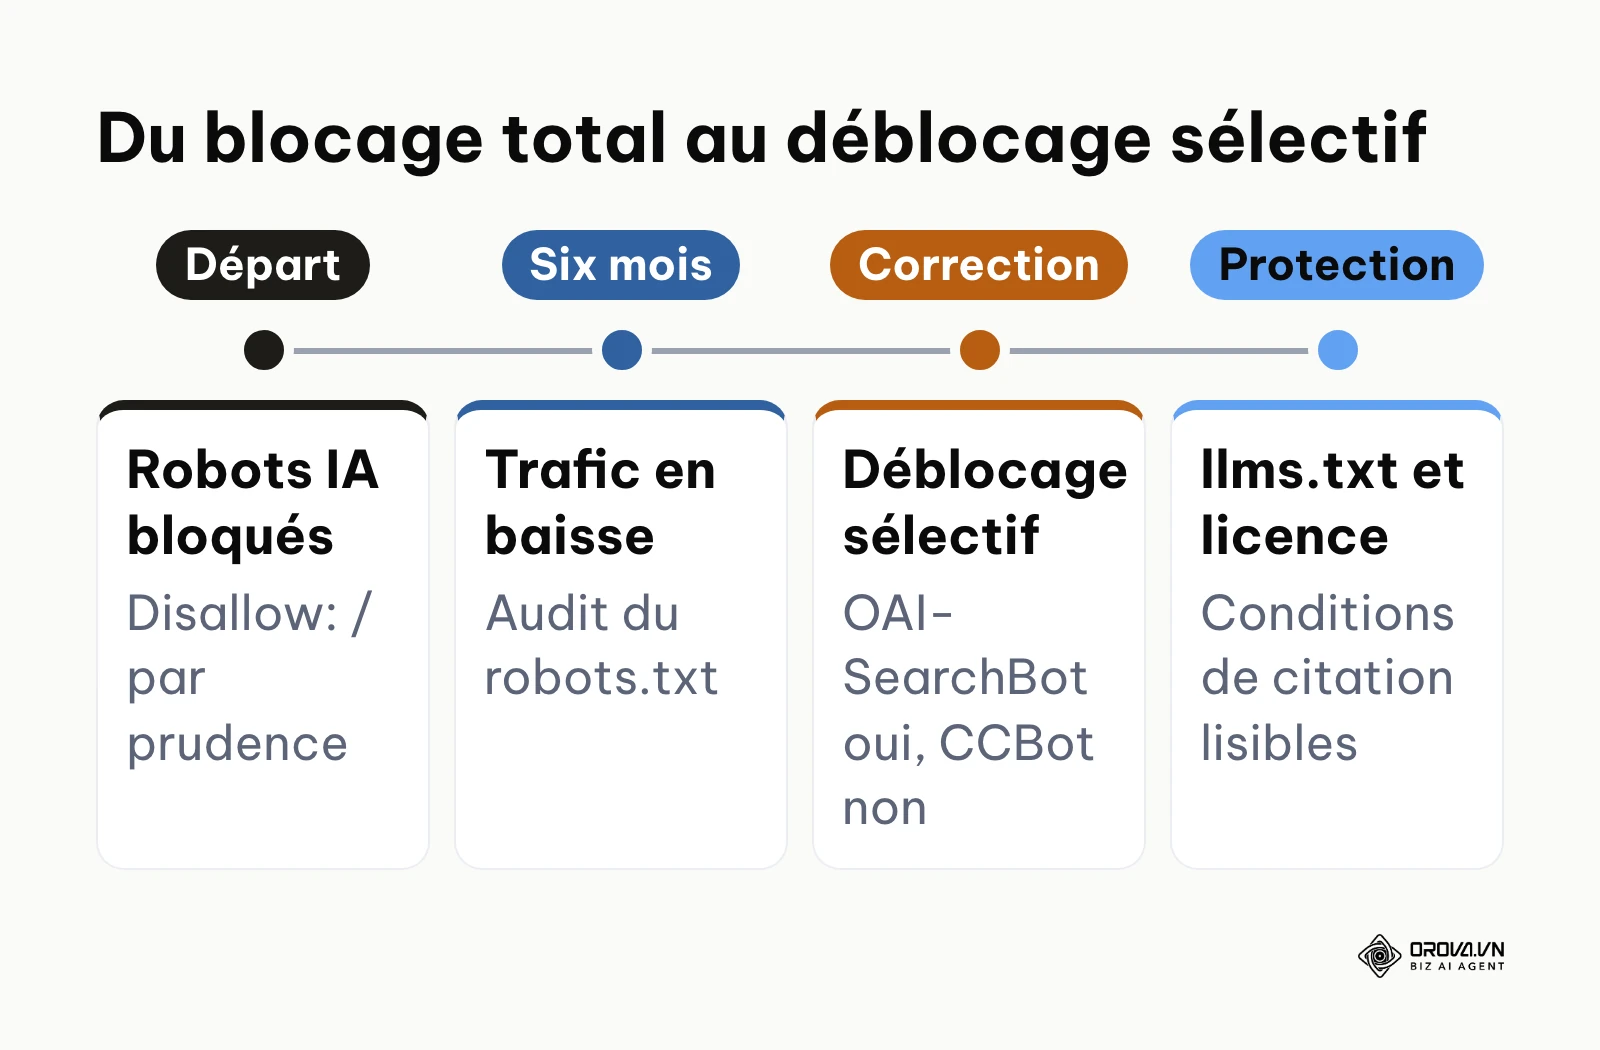
- Étapes : 1. Par prudence, l'agence a bloqué initialement tous les bots IA via le robots.txt (Disallow: /). 2. Six mois plus tard, constatant une baisse continue du trafic informatif, ils ont audité la configuration. 3. Ils ont débloqué sélectivement les bots de recherche (comme OAI-SearchBot) tout en maintenant le blocage des crawlers d'entraînement (comme CCBot).
- Obstacle : Le cabinet d'avocats craignait farouchement que ses analyses juridiques pointues soient absorbées pour entraîner des IA concurrentes gratuites, sans aucune attribution, ce qui constituait un blocage politique interne fort.
- Solution : L'agence a implémenté un fichier llms.txt précisant des conditions d'utilisation strictes exigeant la citation de la source, couplé à un balisage JSON-LD de type Article incluant la propriété license pointant vers les droits d'auteur du cabinet.
- Résultat : Le site a progressivement réapparu comme source citée dans les réponses de ChatGPT search, avec des liens vers les articles du cabinet. Les conditions de réutilisation sont désormais affichées de façon lisible par machine, même si rien ne garantit que tous les robots les respectent.
Tendances du generative engine optimization : L'avis de l'auteur
En observant l'évolution fulgurante des modèles de langage et des comportements de recherche, il est essentiel d'anticiper les prochaines mutations. Le SEO n'est pas mort, il mute. Voici mes trois intuitions sur la trajectoire que prendra le GEO dans les 2 à 3 prochaines années, et comment vous devriez vous y préparer.
Le basculement vers la réalité "Zéro Clic" transactionnelle
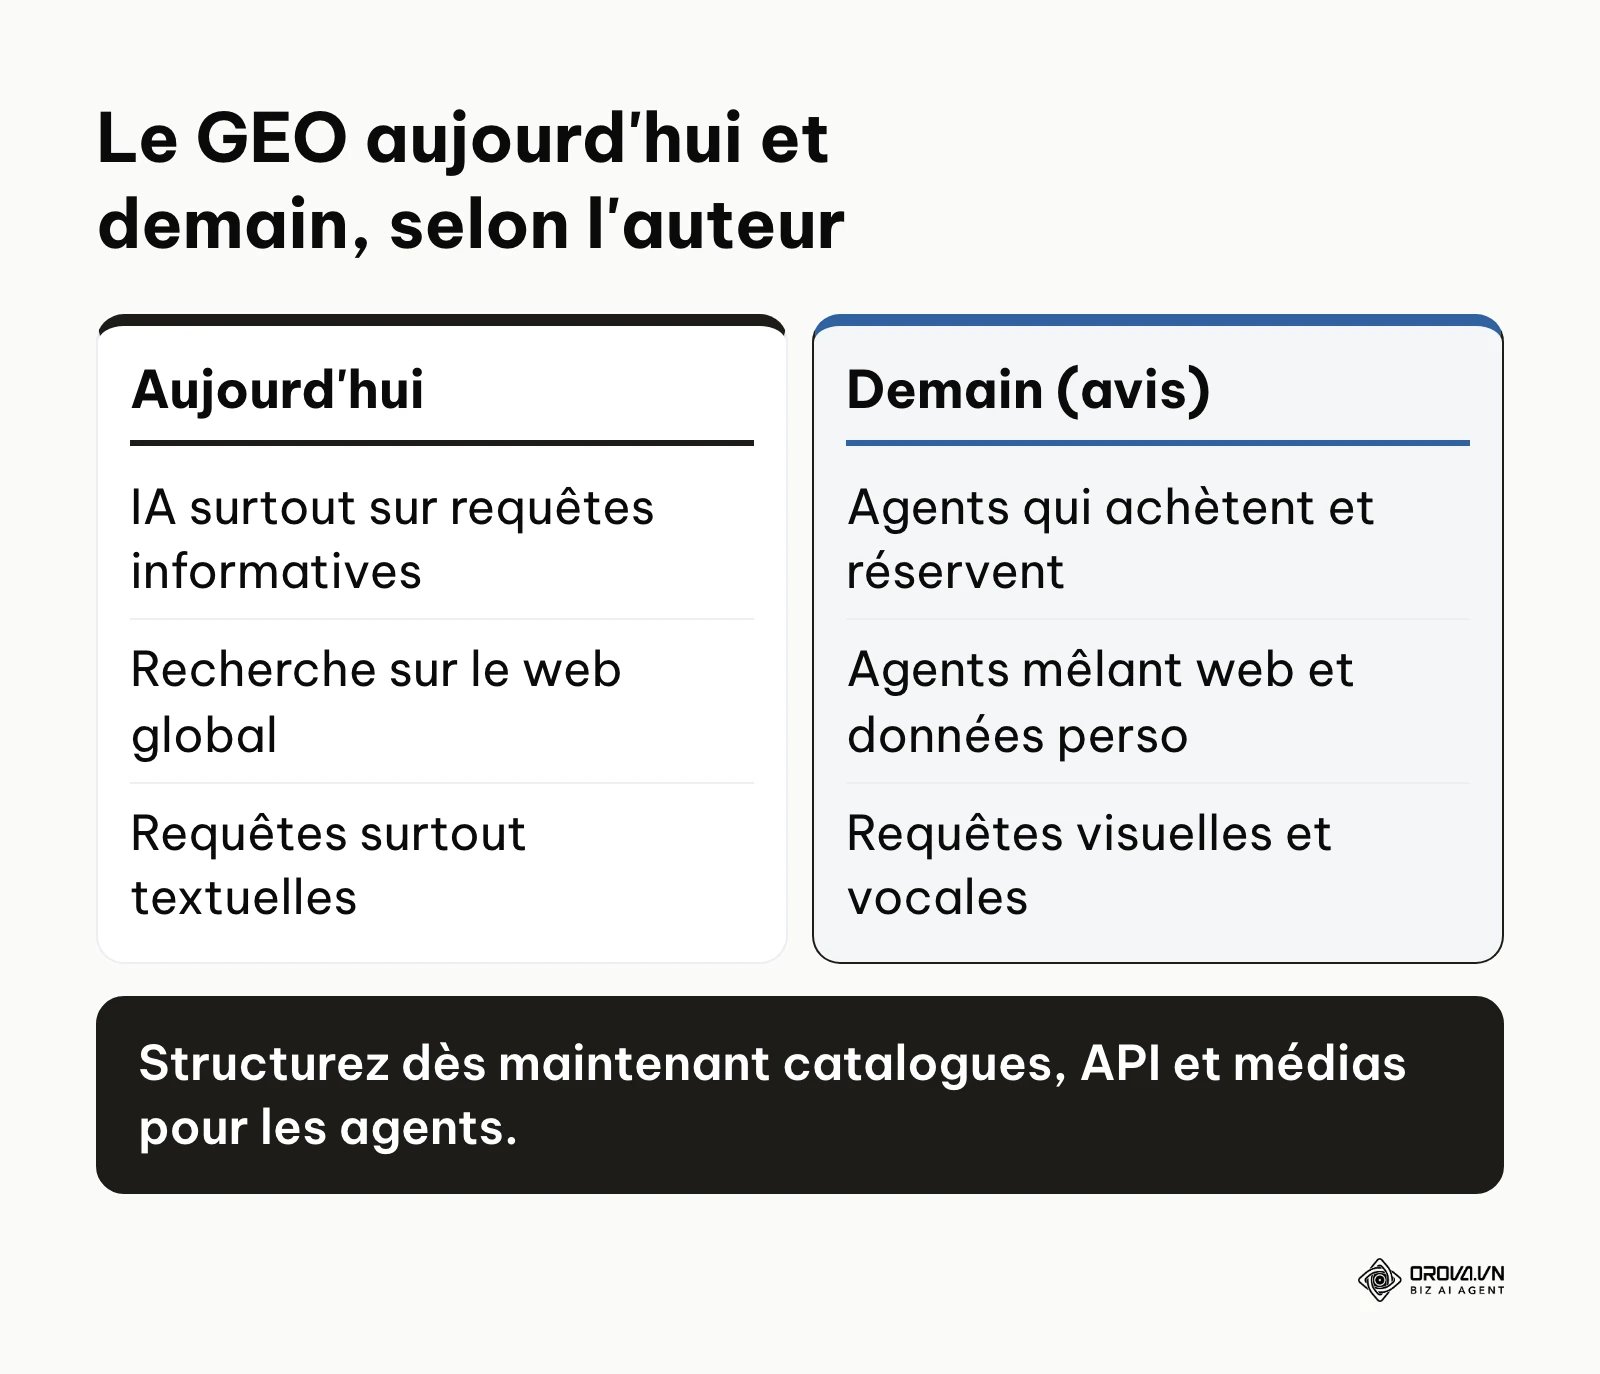
Aujourd'hui, l'IA cannibalise surtout les requêtes informatives (le haut du tunnel). Mais je pense que les moteurs génératifs vont devenir de plus en plus transactionnels. Nous voyons déjà des agents capables d'exécuter des actions complexes (réserver un billet, comparer des assurances) directement dans l'interface de chat. À mon avis, le "zéro clic" ne sera plus seulement un problème de perte de trafic pour lire un article, mais une perte de trafic vers les pages de paiement. Les entreprises auront sans doute intérêt à exposer leurs API transactionnelles et structurer leurs catalogues produits non plus seulement pour les navigateurs web, mais pour que des agents autonomes puissent les interroger et passer commande sans aucune interface graphique humaine. Vous devez commencer dès maintenant à structurer vos bases de données produits avec une rigueur absolue.
L'hyper-personnalisation des agents locaux (RAG Personnel)
L'intégration de l'IA dans les systèmes d'exploitation (Apple Intelligence, Copilot intégré à Windows) modifie la notion même d'index global. Les recherches de demain ne se feront plus seulement sur le web mondial, mais croiseront le web avec les données personnelles de l'utilisateur (ses emails, ses calendriers). Je pense que le GEO va évoluer vers l'optimisation pour ces agents locaux. Si vous êtes une entreprise de services logiciels, la capacité de votre outil à s'intégrer nativement dans les écosystèmes Microsoft ou Apple déterminera si l'agent personnel de l'utilisateur vous recommande ou non. La bataille ne sera plus sur la page de résultats de recherche de Google, mais sur le bureau même de l'ordinateur de votre prospect. L'interopérabilité technique et la sécurité des données pourraient devenir de vrais arguments de référencement.
La domination de la recherche multimodale immersive
Nous pensons encore le SEO en termes de textes et de liens. Cependant, avec l'avènement de modèles comme GPT-4o ou Gemini Pro capables d'analyser la vidéo et l'audio en temps réel, je pense que la requête textuelle va perdre du terrain au profit d'intrants visuels ou vocaux complexes (ex: pointer sa caméra vers une machine en panne et demander "comment réparer ça ?"). Le GEO de demain demandera une optimisation soignée de vos actifs vidéo et de vos images techniques. Il faudra s'assurer que vos schémas industriels, vos tutoriels vidéo et vos infographies sont encadrés de métadonnées sémantiques exhaustives pour que l'IA puisse les "voir", les comprendre, et les injecter en réponse à des requêtes visuelles. Bien sûr, cette prédiction dépend de l'adoption matérielle des lunettes de réalité augmentée, mais la tendance logicielle me semble déjà engagée.
Foire aux questions sur le generative engine optimization
L'émergence des moteurs de réponses génératifs soulève de nombreuses interrogations techniques et stratégiques chez les professionnels du digital. Voici les réponses aux questions les plus pressantes du marché.
Le GEO remplace-t-il le SEO traditionnel ?
Non, il s'y superpose. Le référencement classique reste indispensable pour les requêtes navigationnelles (chercher une marque précise) et hautement transactionnelles simples. Le GEO est une couche supplémentaire d'optimisation destinée spécifiquement aux requêtes complexes de la longue traîne, où l'utilisateur cherche une synthèse ou une analyse comparative. Une architecture technique saine profite d'ailleurs aux deux disciplines simultanément.
Quel outil utiliser pour tester si mon site est bien lu par une IA ?
Il n'existe pas de bouton magique universel, car chaque IA fonctionne différemment. Cependant, vous pouvez utiliser des outils de validation de données structurées comme celui de Schema.org pour vérifier la partie technique. Pour la partie contenu, le moyen le plus simple est de soumettre une URL spécifique à ChatGPT (avec la recherche web activée) ou à Perplexity et de demander : "Résume les points clés de ce lien, extrais les statistiques et cite la source". Si l'IA échoue ou invente des données, votre contenu n'est pas optimisé pour le RAG. De plus, l'analyse des logs serveur de votre hébergeur reste l'outil le plus précis pour vérifier la fréquence de passage des bots IA.
Le fichier llms.txt est-il vraiment obligatoire ?
Techniquement non, car ce n'est pas encore un standard officiel imposé par le W3C, contrairement au robots.txt. Toutefois, il se diffuse dans les communautés techniques, notamment pour les documentations de logiciels, même si les grands moteurs de réponse n'ont pas annoncé en tenir compte pour choisir leurs sources. L'implémenter aujourd'hui coûte très peu d'efforts (c'est un simple fichier texte) et offre un point d'entrée structuré aux agents qui choisiraient de le lire. Considérez-le comme un bonus, pas comme une priorité devant le balisage et la qualité du contenu.
Quel est l'impact de l'IA sur la création de liens (Netlinking) ?
L'IA rend la qualité des liens infiniment plus importante que la quantité. Les algorithmes génératifs s'appuient lourdement sur les concepts de graphe de connaissances et de réputation (Trust). Un seul lien provenant d'une institution reconnue (université, instance gouvernementale, publication scientifique majeure) pèsera beaucoup plus lourd dans le calcul de la fiabilité de votre entité que des dizaines de liens provenant d'annuaires obscurs ou de fermes de contenu sans autorité.
Par où commencer votre stratégie GEO dès aujourd'hui ?
Se lancer dans l'optimisation pour l'intelligence artificielle peut sembler vertigineux devant l'ampleur des tâches techniques. L'approche la plus efficace consiste à procéder par itération, en fonction de la maturité actuelle de votre site web. Voici une action concrète à réaliser en moins d'une demi-journée, adaptée à votre situation.
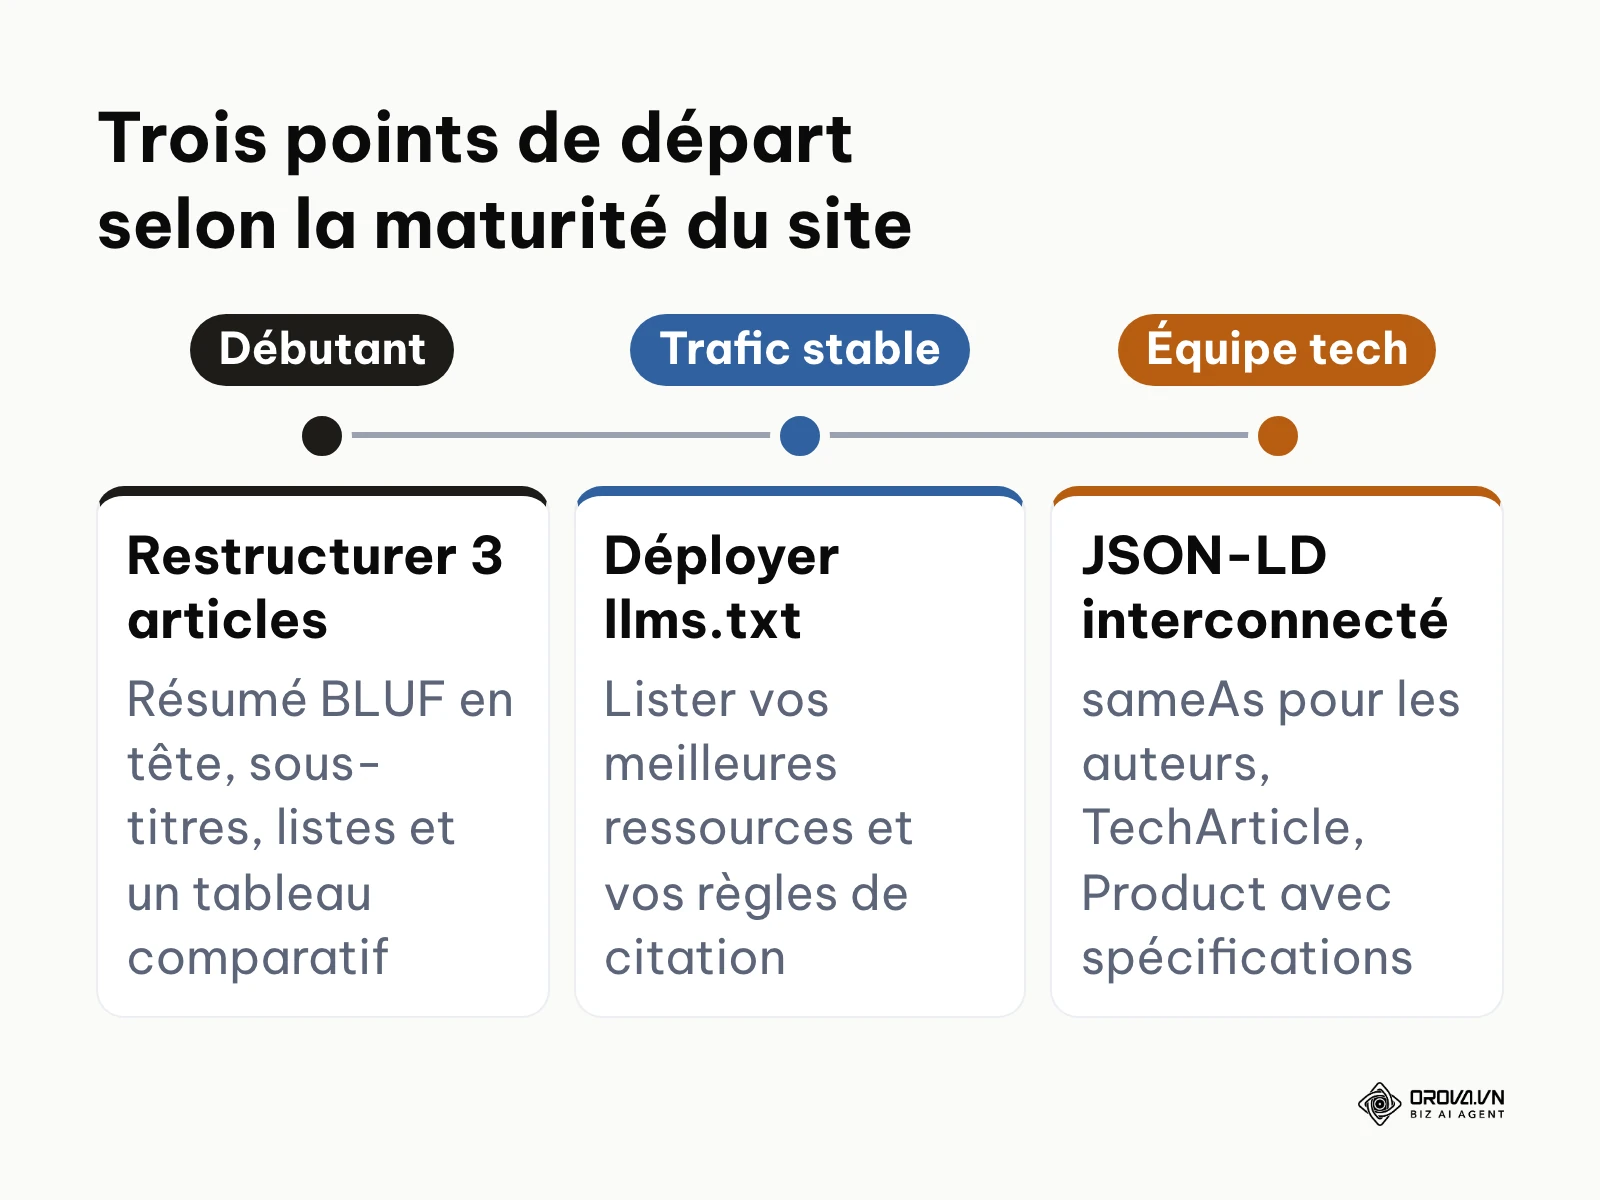
Si vous débutez complètement et que votre contenu est un bloc de texte brut, commencez par restructurer visuellement vos trois articles de blog les plus visités. Ajoutez un résumé "Bottom Line Up Front" (BLUF) composé de données factuelles et de chiffres clés tout en haut de chaque page. Découpez vos longs paragraphes d'explication avec des sous-titres descriptifs, des listes à puces et intégrez au moins un tableau Markdown comparatif clair. L'objectif est de formater l'information de manière tabulaire et synthétique, format dont raffolent les algorithmes d'extraction IA.
Si votre site génère déjà du trafic stable et qu'un audit SEO complet a confirmé que vos bases sont propres, concentrez-vous sur l'architecture et la sécurité sémantique. Rédigez et déployez votre fichier llms.txt à la racine de votre serveur. Prenez le temps de lister méticuleusement vos ressources les plus qualitatives et d'y rédiger des directives strictes quant au respect de la citation de vos sources. Cela offrira un point d'entrée "propre" aux agents d'IA qui scrutent votre domaine.
Si vous possédez une équipe de développement ou un profil très technique, l'urgence absolue est de déployer un balisage JSON-LD complexe et interconnecté. Vérifiez que toutes vos pages auteurs sont liées à des profils externes vérifiés (via la propriété sameAs), que vos articles utilisent le schéma TechArticle ou NewsArticle avec mention explicite de l'éditeur, et que vos produits, le cas échéant, exposent toutes leurs spécifications techniques (prix, avis, poids, dimensions) directement dans le code source pour aider Google et les autres moteurs IA à comprendre précisément vos offres.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Pilotez votre activité avec des AI Agents
Orova est le Biz AI Agent qui ne s'arrête jamais : il planifie, exécute et optimise le travail à votre place.
Gagnez du temps, gagnez en efficacité.