Pages orphelines : comment les corriger en 6 étapes (2026)
Les pages orphelines représentent l'un des freins techniques les plus insidieux pour la performance SEO d'un site web, car elles existent sur votre serveur sans qu'aucun lien interne ne permette aux robots ni aux internautes de les découvrir. En suivant ce guide pas à pas, vous allez obtenir une cartographie intégrale de ces URL invisibles, assainir votre arborescence et restaurer la transmission du PageRank vers vos contenus stratégiques. Pour mener à bien cet audit, vous aurez besoin d'un accès administrateur à Google Search Console, d'un compte Google Analytics 4, d'un logiciel de crawl technique et des accès à votre serveur ou CMS, pour une intervention d'une durée estimée entre deux et quatre heures. Si votre site compte moins de vingt pages statiques gérées sans arborescence complexe, cette démarche approfondie ne vous est pas indispensable.
Pages orphelines : définition et enjeux pour votre référencement naturel
Résoudre la présence de pages orphelines permet de récupérer du budget d'exploration gaspillé et de rediriger l'autorité de vos liens vers vos pages génératrices de chiffre d'affaires. L'ensemble de la démarche se structure en six étapes techniques et requiert généralement deux à quatre heures d'intervention pour un catalogue de taille moyenne.
Une page orpheline est une page web accessible via son URL directe (code HTTP 200), mais vers laquelle ne pointe aucun lien hypertexte interne depuis l'ensemble de votre domaine. Pour les moteurs de recherche, le maillage interne, c'est-à-dire l'organisation des liens reliant les pages d'un même site, constitue la voie principale de découverte et d'évaluation de la popularité d'un contenu. Lorsqu'une URL se retrouve coupée de cette structure, elle devient invisible pour un robot qui explore le site en suivant les liens de page en page.
Selon le guide de Google Search Central consacré à la gestion du budget de crawl des grands sites, Googlebot alloue une capacité d'exploration limitée en fonction de la vitesse de réponse du serveur et de l'intérêt perçu des URL. Lorsqu'un robot explore un site, chaque requête allouée à une page orpheline inutile est une opportunité perdue d'indexer un nouveau produit ou de rafraîchir un article de blog stratégique. De plus, si une page orpheline possède des backlinks, c'est-à-dire des liens entrants provenant d'autres domaines web, l'autorité transmise par ces sites tiers reste emprisonnée dans une impasse, incapable de se diffuser au reste de votre architecture.
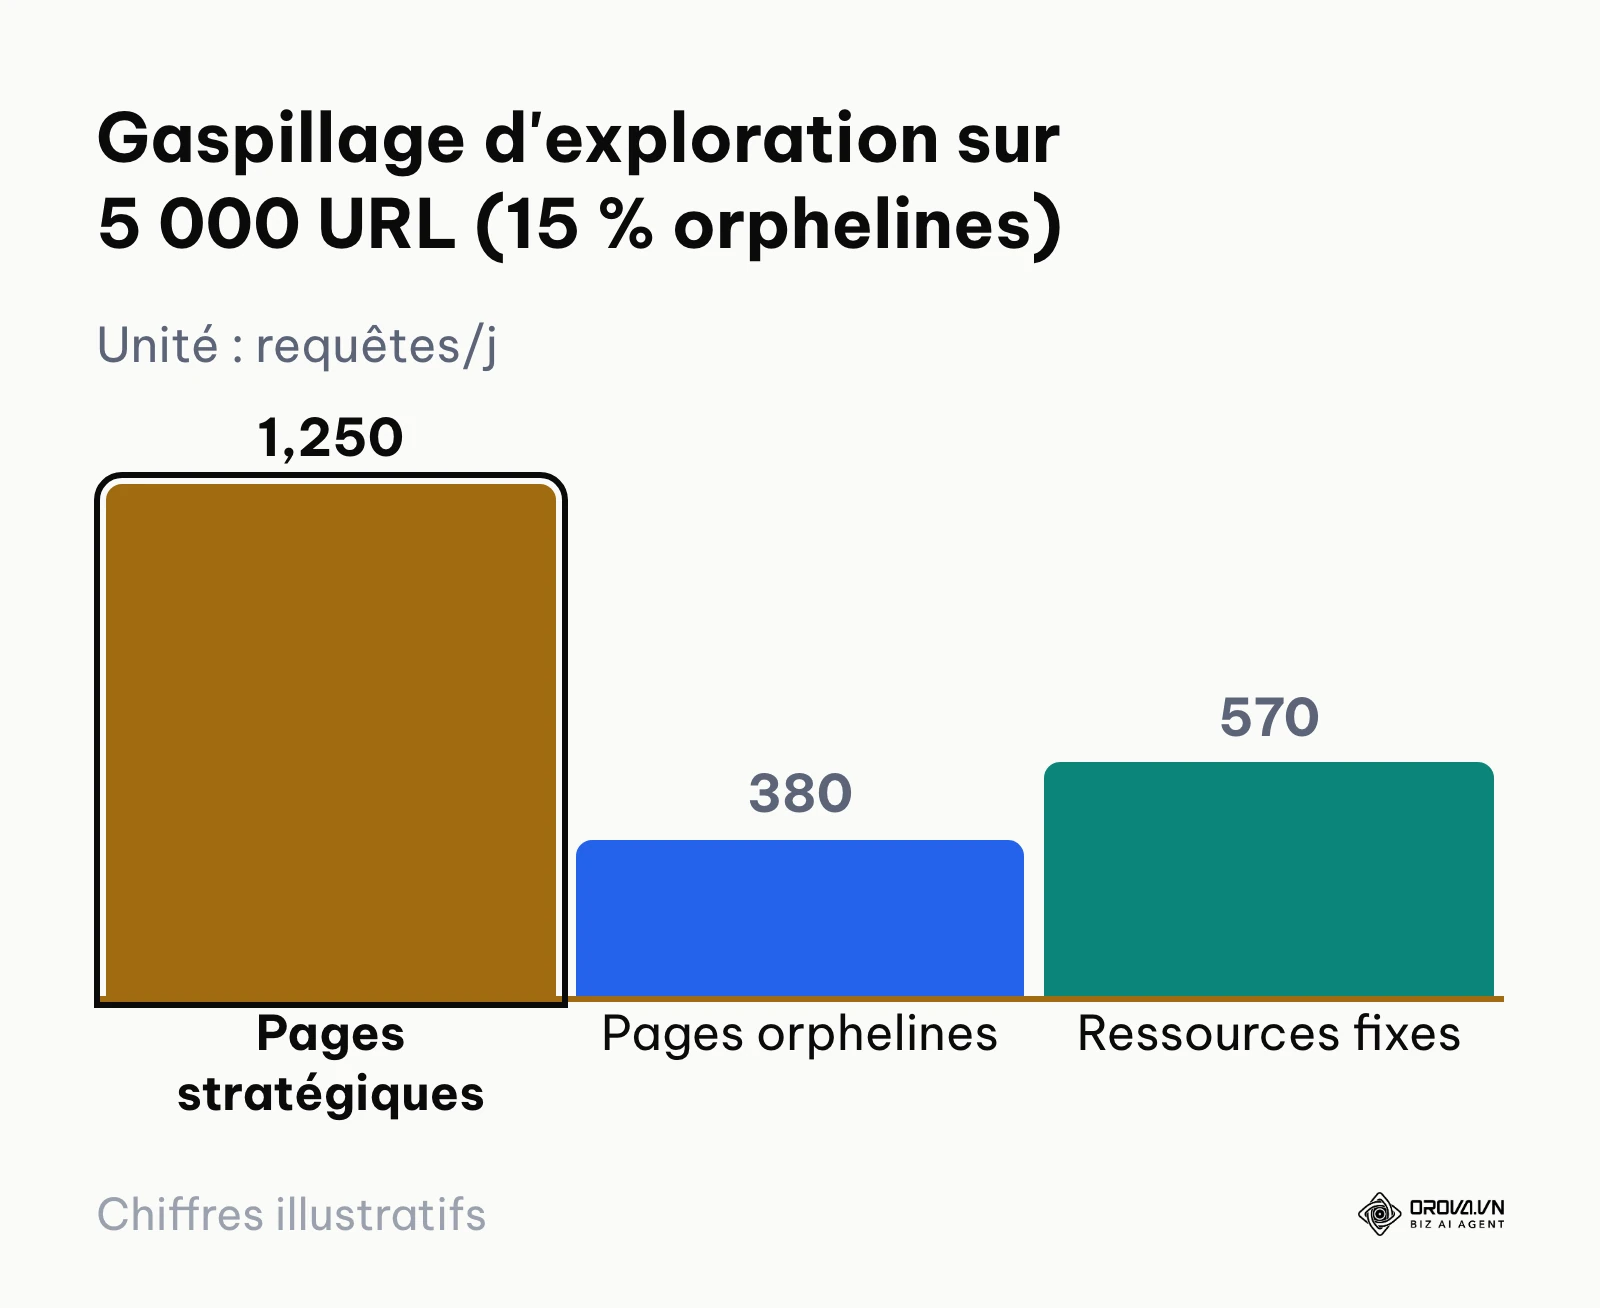
Pour mesurer concrètement cette déperdition, prenons un exemple hypothétique : un catalogue e-commerce comptant 5 000 URL publiées, au sein duquel 15 % des adresses se retrouvent isolées, soit 750 pages orphelines issues d'anciens produits dépubliés de la navigation. Lors des passages quotidiens de Googlebot, le serveur enregistre environ 2 200 requêtes de crawl par jour. Sur ce total, supposons que les fichiers journaux révèlent que 380 requêtes sont gaspillées sur ces 750 URL sans issue, soit plus de 17 % des ressources d'exploration du moteur. Ce phénomène peut ralentir l'indexation des nouveaux articles et immobilise une part substantielle de l'équité de lien (le link equity, ou la valeur d'autorité transmise d'une page à une autre).
Préparer l'audit des pages orphelines avant de commencer
Avant de lancer le moindre outil d'analyse, rassemblez l'ensemble des sources de données nécessaires pour comparer ce que votre serveur héberge et ce que votre navigation propose réellement.
Le tableau ci-dessous liste les prérequis indispensables pour croiser les données sans générer de faux positifs.
| Élément à préparer | Où le récupérer | Temps requis | Conséquence en cas d'absence |
|---|---|---|---|
| Propriété Google Search Console | Paramètres de compte GSC (accès propriétaire délégué ou complet) | 5 minutes | Impossibilité de repérer les URL orphelines générant encore des impressions |
| Flux de données Google Analytics 4 | Interface Admin GA4 > Flux de données (accès lecteur ou supérieur) | 5 minutes | Perte de visibilité sur les pages orphelines visitées via signets ou liens externes |
| Fichiers sitemaps XML actifs | Fichier robots.txt ou CMS (/sitemap.xml, /sitemap_index.xml) | 5 minutes | Incapacité à détecter les pages déclarées à Google mais absentes des menus |
| Licence de crawler technique | Screaming Frog SEO Spider, Sitebulb ou OnCrawl | 10 minutes | Analyse limitée aux 500 premières URL, bloquant l'audit des sites volumineux |
| Export des URL publiées du CMS | Back-office WordPress, Shopify ou Magento (export catalogue CSV) | 15 minutes | Absence de point de référence pour les URL orphelines jamais visitées |
| Fichiers journaux du serveur (logs) | Accès FTP/SSH à /var/log/nginx/ ou tableau de bord d'hébergement | 20 minutes | Détection partielle des passages réels des robots sur les URL masquées |
Une fois ces sources réunies, vous pouvez entamer la phase opérationnelle de collecte des données brutes.
Étape 1 : Extraire la cartographie complète des pages orphelines via le sitemap et le CMS
L'objectif de cette étape est de constituer la liste de référence de toutes les URL que votre entreprise considère comme existantes, indépendamment de leur maillage interne actuel.
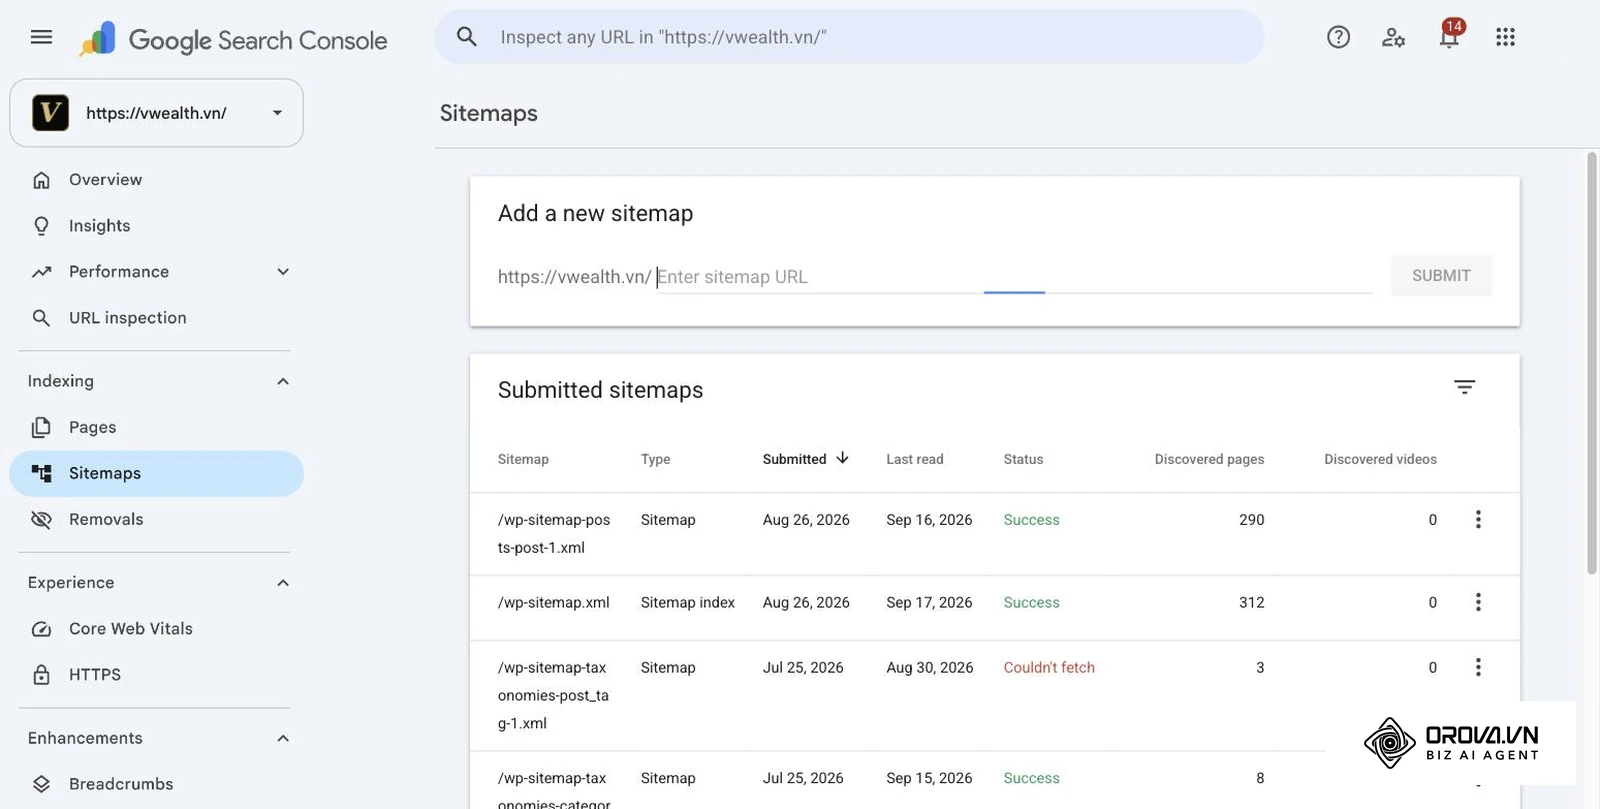
Où et comment manipuler
Rendez-vous dans votre CMS pour exporter l'intégralité des publications ayant le statut publié. Si vous utilisez WordPress, accédez à la section Outils, puis cliquez sur Exporter et choisissez Tous les contenus, ou utilisez une extension de gestion de catalogue pour générer un fichier CSV regroupant les permaliens des articles, pages et fiches produits. Pour les plateformes sur mesure, interrogez directement la base de données via une requête SQL simple extrayant les URL canoniques actives.
Dans un second temps, ouvrez votre navigateur et tapez l'adresse de votre fichier récapitulatif de plan de site, habituellement situé à l'adresse votresite.com/sitemap_index.xml ou votresite.com/sitemap.xml. Copiez l'ensemble des URL de sous-sitemaps (articles, catégories, produits). Si vous pilotez l'acquisition de trafic payant, vérifiez si vos pages d'atterrissage conçues pour des campagnes display figurent par mégarde dans ce fichier, car ces pages isolées ne doivent pas toujours être indexées par les robots d'exploration.
Ouvrez un tableur vierge et collez ces adresses dans une première colonne intitulée URL_Sitemap_et_CMS. Nettoyez les éventuels paramètres de suivi d'URL pour ne conserver que les adresses canoniques pures.
https://votresite.com/categorie/produit-alpha
https://votresite.com/categorie/produit-beta
https://votresite.com/blog/guide-technique-complet
https://votresite.com/landing-page-acquisition-b2b
Résultat vérifiable visuellement
Vous devez visualiser une feuille de calcul contenant une liste unique d'adresses commençant toutes par le même protocole (https://) et le même sous-domaine. Aucun doublon ne doit subsister après avoir appliqué la fonction Dédupliquer les données de votre tableur.
Erreurs fréquentes à cette étape
L'erreur la plus récurrente consiste à extraire un sitemap généré automatiquement qui contient des URL redirigées en code 301 ou des pages renvoyant une erreur 404. Si vous intégrez des URL mortes dans votre base de référence, votre futur crawl croisé signalera de fausses pages orphelines. Pour y remédier, passez rapidement cette liste dans un vérificateur d'en-tête HTTP avant de poursuivre.
Étape 2 : Connecter l'API Google Search Console et GA4 pour débusquer les pages orphelines
L'objectif est d'autoriser votre logiciel de crawl à interroger directement les interfaces de programmation (API) de Google afin d'extraire les URL que les robots visitent déjà, mais qui ne possèdent aucun lien dans votre code HTML.
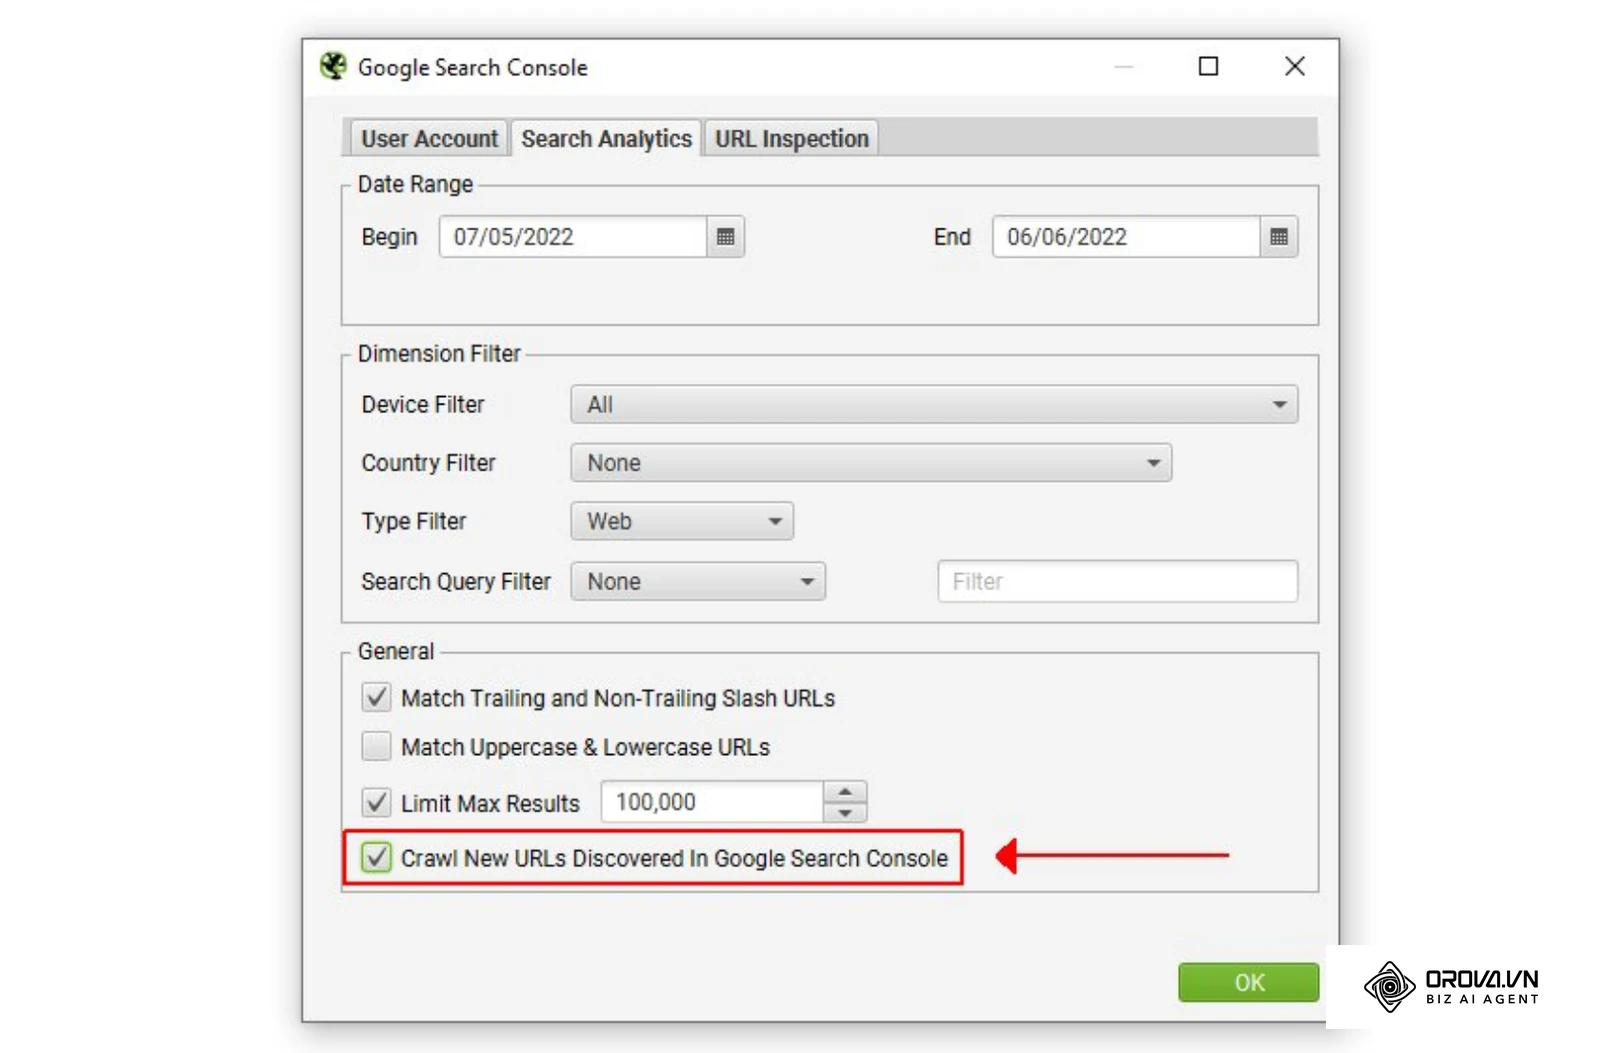
Où et comment manipuler
Dans le logiciel Screaming Frog SEO Spider, cliquez sur le menu supérieur Configuration, descendez sur Accès API, puis sélectionnez Google Search Console. Dans la fenêtre modale qui apparaît, cliquez sur Ajouter un compte, ce qui ouvre une fenêtre d'authentification OAuth dans votre navigateur par défaut. Choisissez l'adresse email détenant les droits administrateur sur la propriété concernée et validez les autorisations de lecture.
Une fois le compte associé, restez dans l'onglet Général de la fenêtre de configuration de l'API Search Console. Dans le menu déroulant Propriété, sélectionnez l'adresse exacte correspondant à votre site (privilégiez la propriété de domaine de type sc-domain:votresite.com). Cochez impérativement la case intitulée Découvrir de nouvelles URL (ou Crawl New URLs Discovered), qui ordonne au logiciel d'ajouter à son plan d'exploration les pages remontées par l'API mais introuvables via la navigation interne. Réglez la période d'analyse sur les 6 derniers mois afin de capter la saisonnalité de vos requêtes.
Effectuez immédiatement la même manipulation pour Google Analytics 4 en retournant dans Configuration > Accès API > Google Analytics. Connectez votre propriété GA4 et cochez également l'option d'exploration des nouvelles URL découvertes sur une période de 90 jours.
Résultat vérifiable visuellement
Dans la fenêtre de configuration de chaque API, le compte connecté et la propriété sélectionnée apparaissent dans le menu déroulant, et la case d'exploration des nouvelles URL découvertes reste cochée. Au lancement du crawl, l'onglet API du panneau de droite indique la progression des requêtes envoyées à Google.
Erreurs fréquentes à cette étape
Il arrive fréquemment que la connexion échoue en renvoyant une erreur d'autorisation 403. Ce blocage survient lorsque le compte Google connecté possède un droit d'accès limité ou lorsque la propriété sélectionnée utilise le protocole http:// au lieu de https://. Vérifiez dans l'interface en ligne de Google Search Console que votre profil utilisateur dispose bien des autorisations complètes avant de relancer l'authentification dans le logiciel.
Étape 3 : Lancer le crawl croisé et isoler les pages orphelines
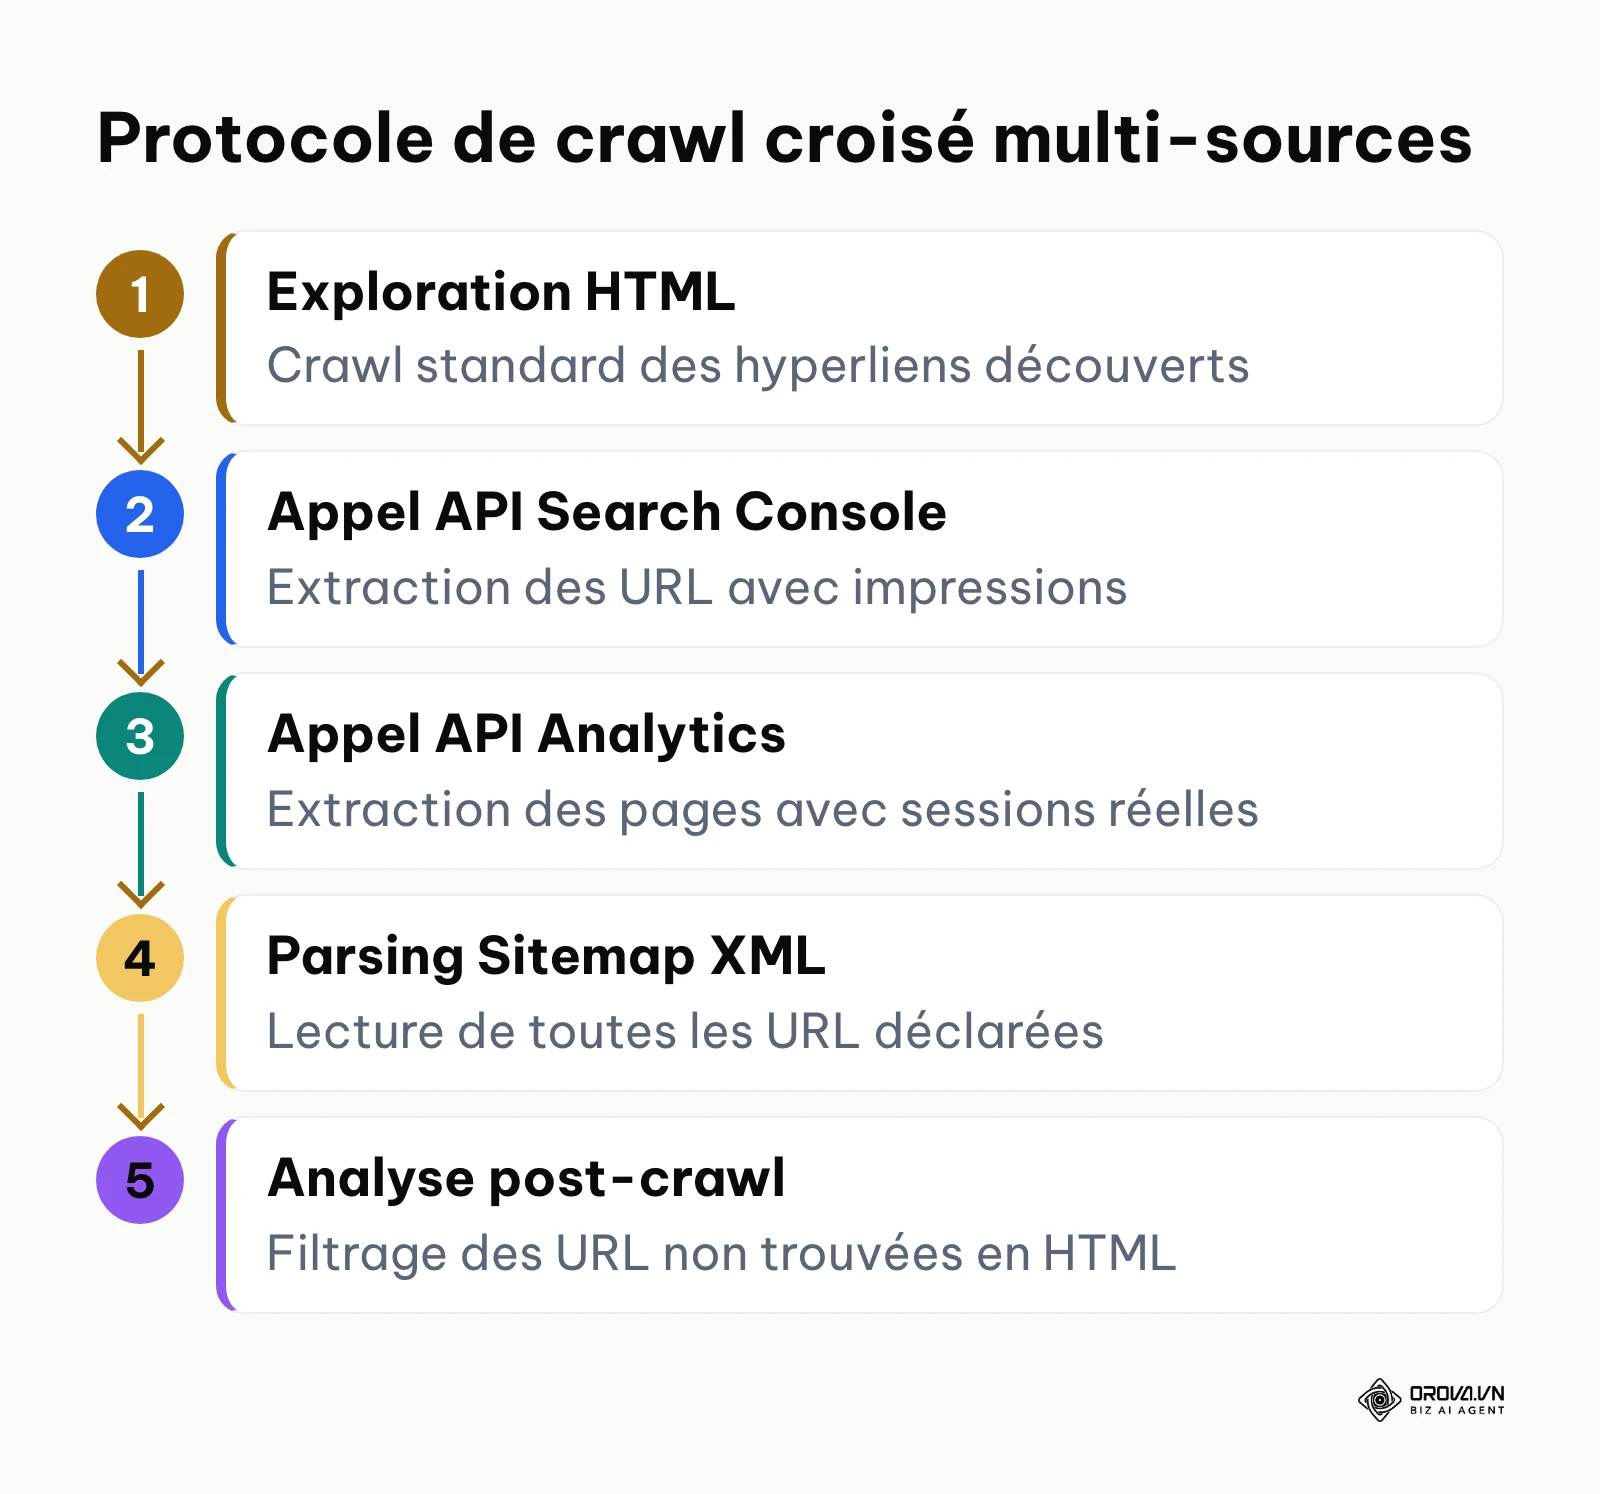
Cette étape consiste à exécuter le moteur d'exploration pour confronter la structure de liens réels de votre site aux listes externes fournies par les API et les sitemaps XML.
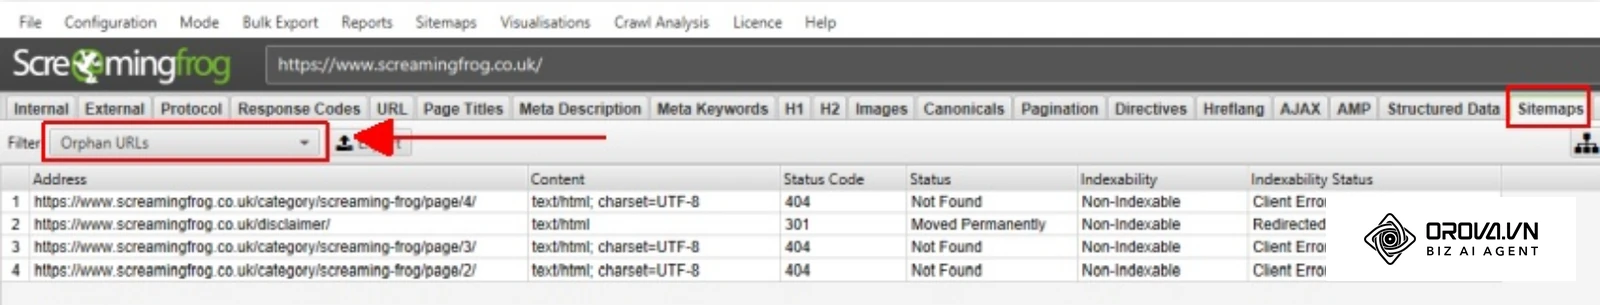
Où et comment manipuler
Avant d'appuyer sur le bouton de démarrage, assurez-vous que la prise en compte des sitemaps est active. Cliquez sur Configuration > Spider, ouvrez l'onglet Sitemaps, cochez la case Explorer les sitemaps XML et saisissez l'URL de votre plan de site principal. Cliquez sur OK pour refermer les réglages.
Dans la barre supérieure principale intitulée Saisir l'URL à explorer, tapez l'adresse de votre page d'accueil avec son protocole complet (par exemple https://votresite.com/), puis cliquez sur le bouton Démarrer. Laissez l'exploration progresser jusqu'à 100 %. Une fois l'exploration terminée, le travail n'est pas achevé : vous devez impérativement vous rendre dans le menu supérieur Analyse et cliquer sur Démarrer l'analyse post-crawl. Cette opération déclenche le calcul algorithmique des liens internes et fait ressortir les URL orphelines.
Une fois l'analyse terminée, observez le panneau latéral droit dans la section Onglets. Déroulez le menu contextuel de Google Search Console, puis cliquez sur le filtre intitulé URL orphelines. Répétez l'observation dans l'onglet Sitemaps en filtrant par URL orphelines de sitemap.
Résultat vérifiable visuellement
Dans la fenêtre principale, une liste d'URL s'affiche avec la valeur zéro dans la colonne Liens internes uniques. Ces adresses sont accompagnées de données chiffrées de clics, d'impressions ou de sessions issues des API, prouvant qu'elles sont vivantes mais totalement exclues de votre arborescence.
Erreurs fréquentes à cette étape
L'omission de l'analyse post-crawl constitue l'écueil le plus classique. Si vous oubliez de cliquer sur Démarrer l'analyse dans le menu Analyse, le filtre des URL orphelines reste désespérément vide, vous laissant faussement croire que votre site est exempt de tout défaut architectural. Prenez le réflexe de toujours vérifier que la barre de progression de l'analyse post-crawl a atteint son terme.
Découvrez Orova.vn – une plateforme Biz AI Agent dotée de la solution OROVA SEO complète, destinée à tous les sites web. Le système accompagne l'optimisation pour les moteurs de recherche de A à Z, avec les fonctionnalités suivantes : recherche de mots-clés, rédaction de nouveaux articles optimisés pour le SEO, optimisation des contenus existants, suivi des positions, ainsi que l'analyse des concurrents et l'analyse technique approfondie. Inscrivez-vous dès aujourd'hui pour découvrir OROVA SEO entièrement gratuitement (offre valable jusqu'au 7 juillet 2027).
Étape 4 : Classifier chaque URL selon l'arbre de décision pour pages orphelines
L'objectif est d'analyser méthodiquement chaque URL isolée afin de lui attribuer un traitement technique précis sans risquer de supprimer du trafic existant.
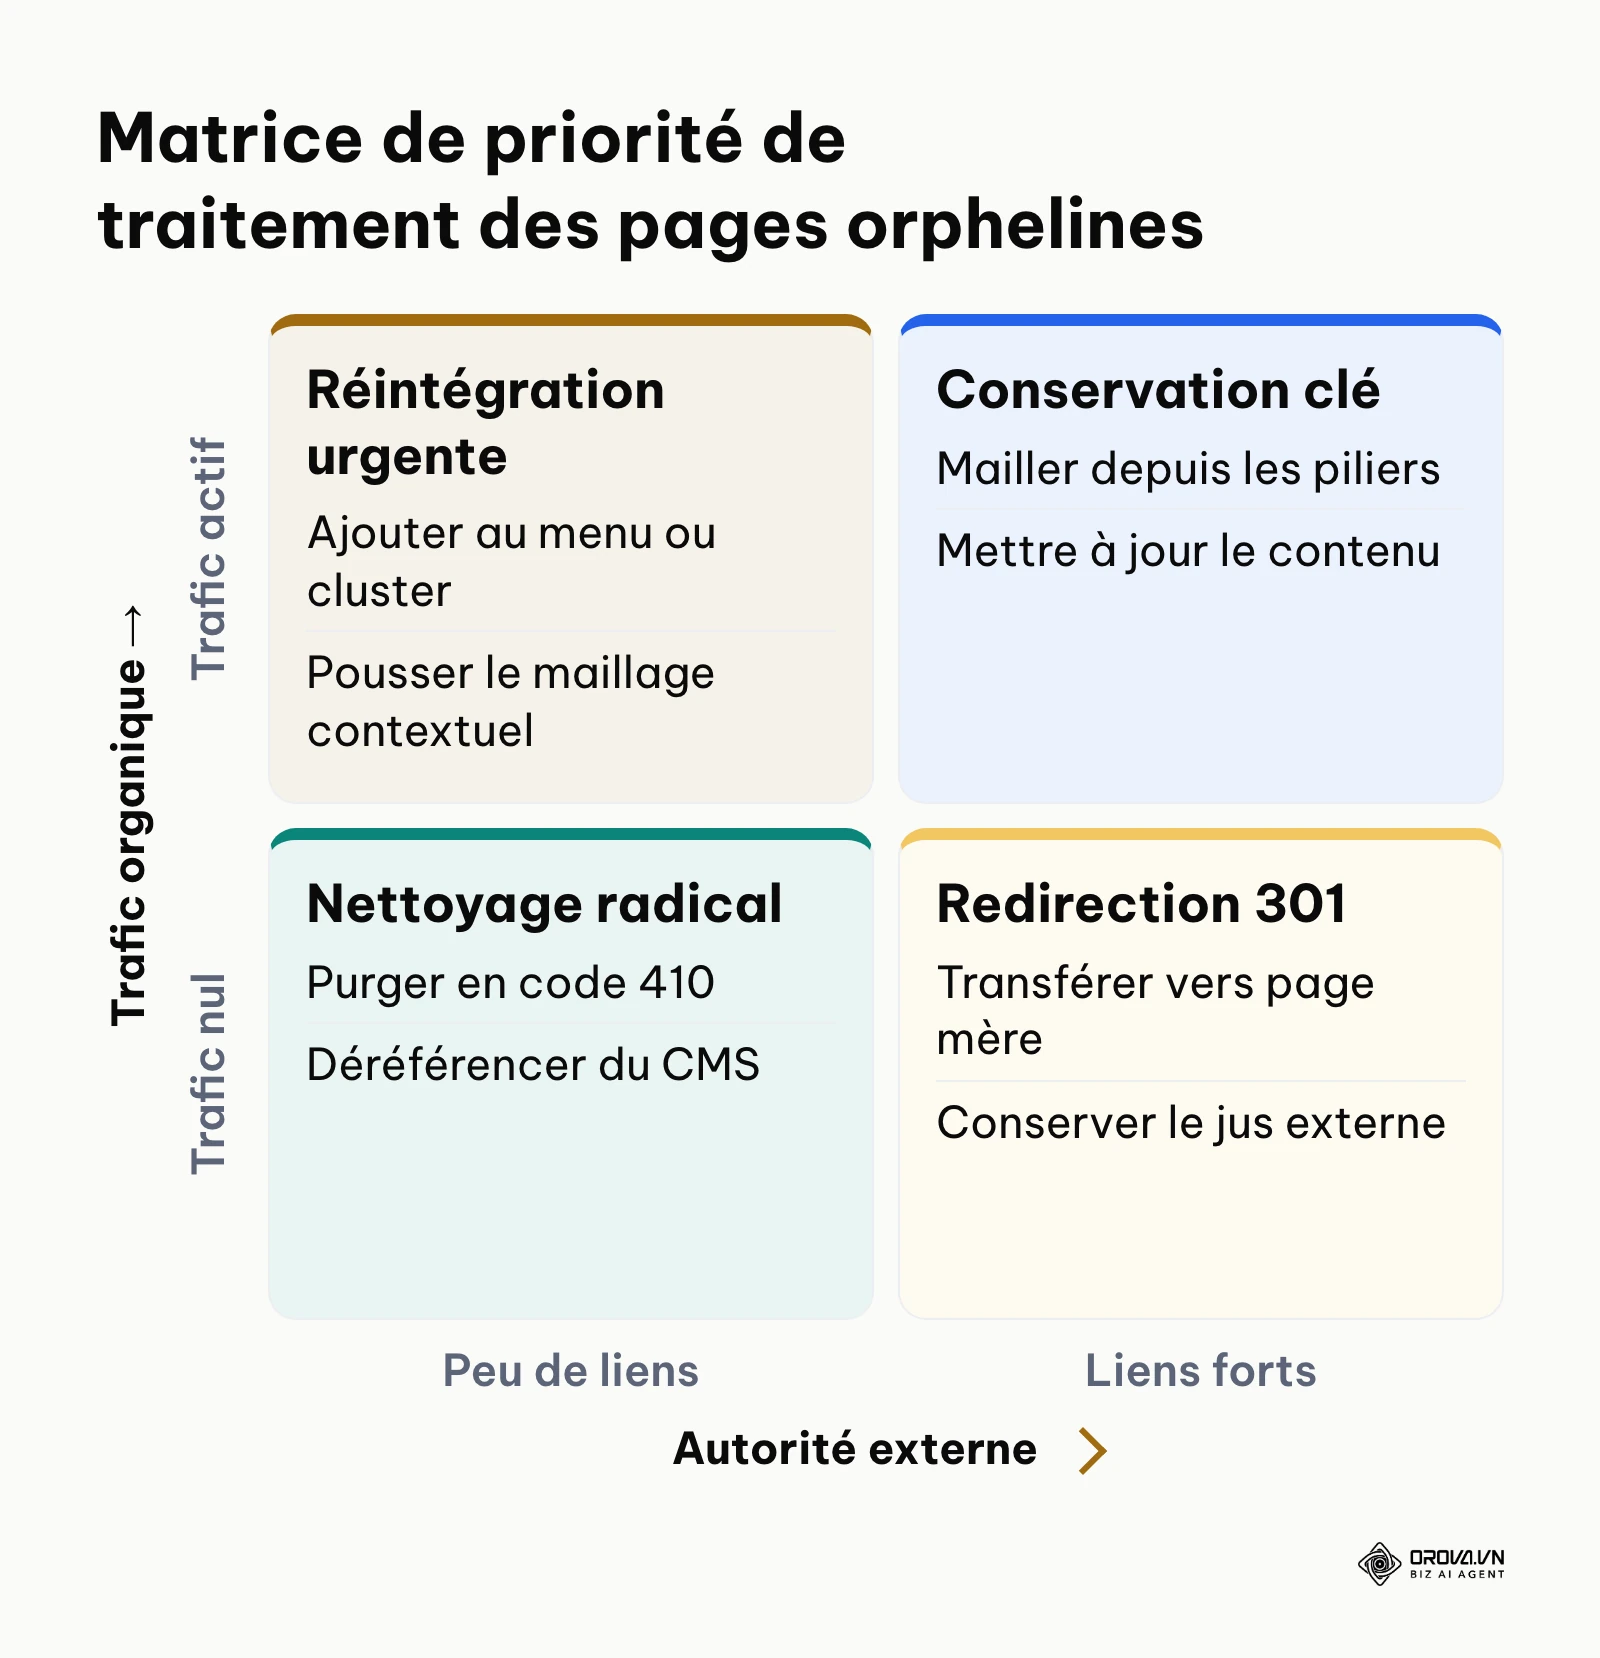
Chaque page orpheline doit être passée au crible de quatre questions successives :
- La page génère-t-elle des visites organiques ou des conversions directes lors des six derniers mois ?
- Reçoit-elle des backlinks de qualité provenant de sites externes reconnus ?
- Le sujet traité correspond-il à un besoin informationnel ou commercial toujours pertinent pour l'entreprise ?
- La page a-t-elle été volontairement isolée pour des impératifs marketing spécifiques ?
Le tableau ci-dessous résume l'arbre de décision à quatre branches que vous appliquez à chaque ligne de votre export.
| Situation de la page orpheline | Questions concernées | Traitement à appliquer |
|---|---|---|
| Trafic organique ou conversions récentes, sujet toujours pertinent | Questions 1 et 3 : oui | Réintégrer au maillage interne par un lien contextuel |
| Backlinks externes de qualité, mais contenu obsolète ou produit supprimé | Question 2 : oui, question 3 : non | Redirection 301 vers la page active la plus proche |
| Aucun trafic, aucun backlink, aucun intérêt commercial | Questions 1, 2 et 3 : non | Supprimer avec un code 410 Gone |
| Page isolée volontairement (landing page publicitaire, confirmation) | Question 4 : oui | Balise noindex, follow et retrait du sitemap XML |
Si une URL répond positivement aux questions 1 et 3, elle doit être conservée et réintégrée dans votre arborescence. Si elle dispose de backlinks externes puissants (question 2) mais propose un contenu obsolète ou un produit supprimé, elle doit faire l'objet d'une redirection permanente vers une page active équivalente. Si elle ne répond à aucun critère de valeur, sa suppression pure et simple est requise. Enfin, si vous avez déployé un générateur de lead sur une page d'atterrissage privée, cette isolation relève d'un choix délibéré et nécessite une gestion dédiée via les balises méta.
Pour vous aider à arbitrer rapidement lors du traitement de gros volumes, la matrice ci-après positionne les priorités d'action selon deux axes majeurs : le volume de trafic organique et l'autorité externe acquise.
Exemple illustratif (hypothétique) :
- Contexte : Une entreprise d'édition logicielle B2B de 45 salariés hébergeant un site de 1 200 pages découvre 140 URL orphelines issues d'une refonte survenue huit mois plus tôt.
- Étapes réalisées : Le responsable marketing extrait les données de clics de Search Console, isole 35 articles de blog à fort trafic et identifie 80 anciennes fiches fonctionnalités abandonnées sans aucune visite. Il utilise ensuite un vérificateur de liens pour constater que 12 anciennes fiches possèdent des liens entrants depuis des blogs d'actualité tech.
- Point de blocage et résolution : L'équipe hésitait à supprimer massivement les 80 fiches par peur d'endommager le référencement global. En appliquant l'arbre de décision, ils ont conservé et remaillé les 35 articles majeurs, redirigé les 12 URL dotées de backlinks vers la nouvelle page produit générique, et purgé les fiches restantes.
- Résultat observable visuellement : Dans Search Console, la courbe des impressions globales s'est stabilisée sans aucune perte de trafic, tandis que le taux d'exploration quotidien de Googlebot s'est concentré sur les nouvelles fonctionnalités stratégiques de la marque.
Étape 5 : Appliquer le traitement technique pour chaque typologie de pages orphelines
Cette étape vous permet d'exécuter la correction directement sur votre serveur web ou dans l'interface de votre gestionnaire de contenu.
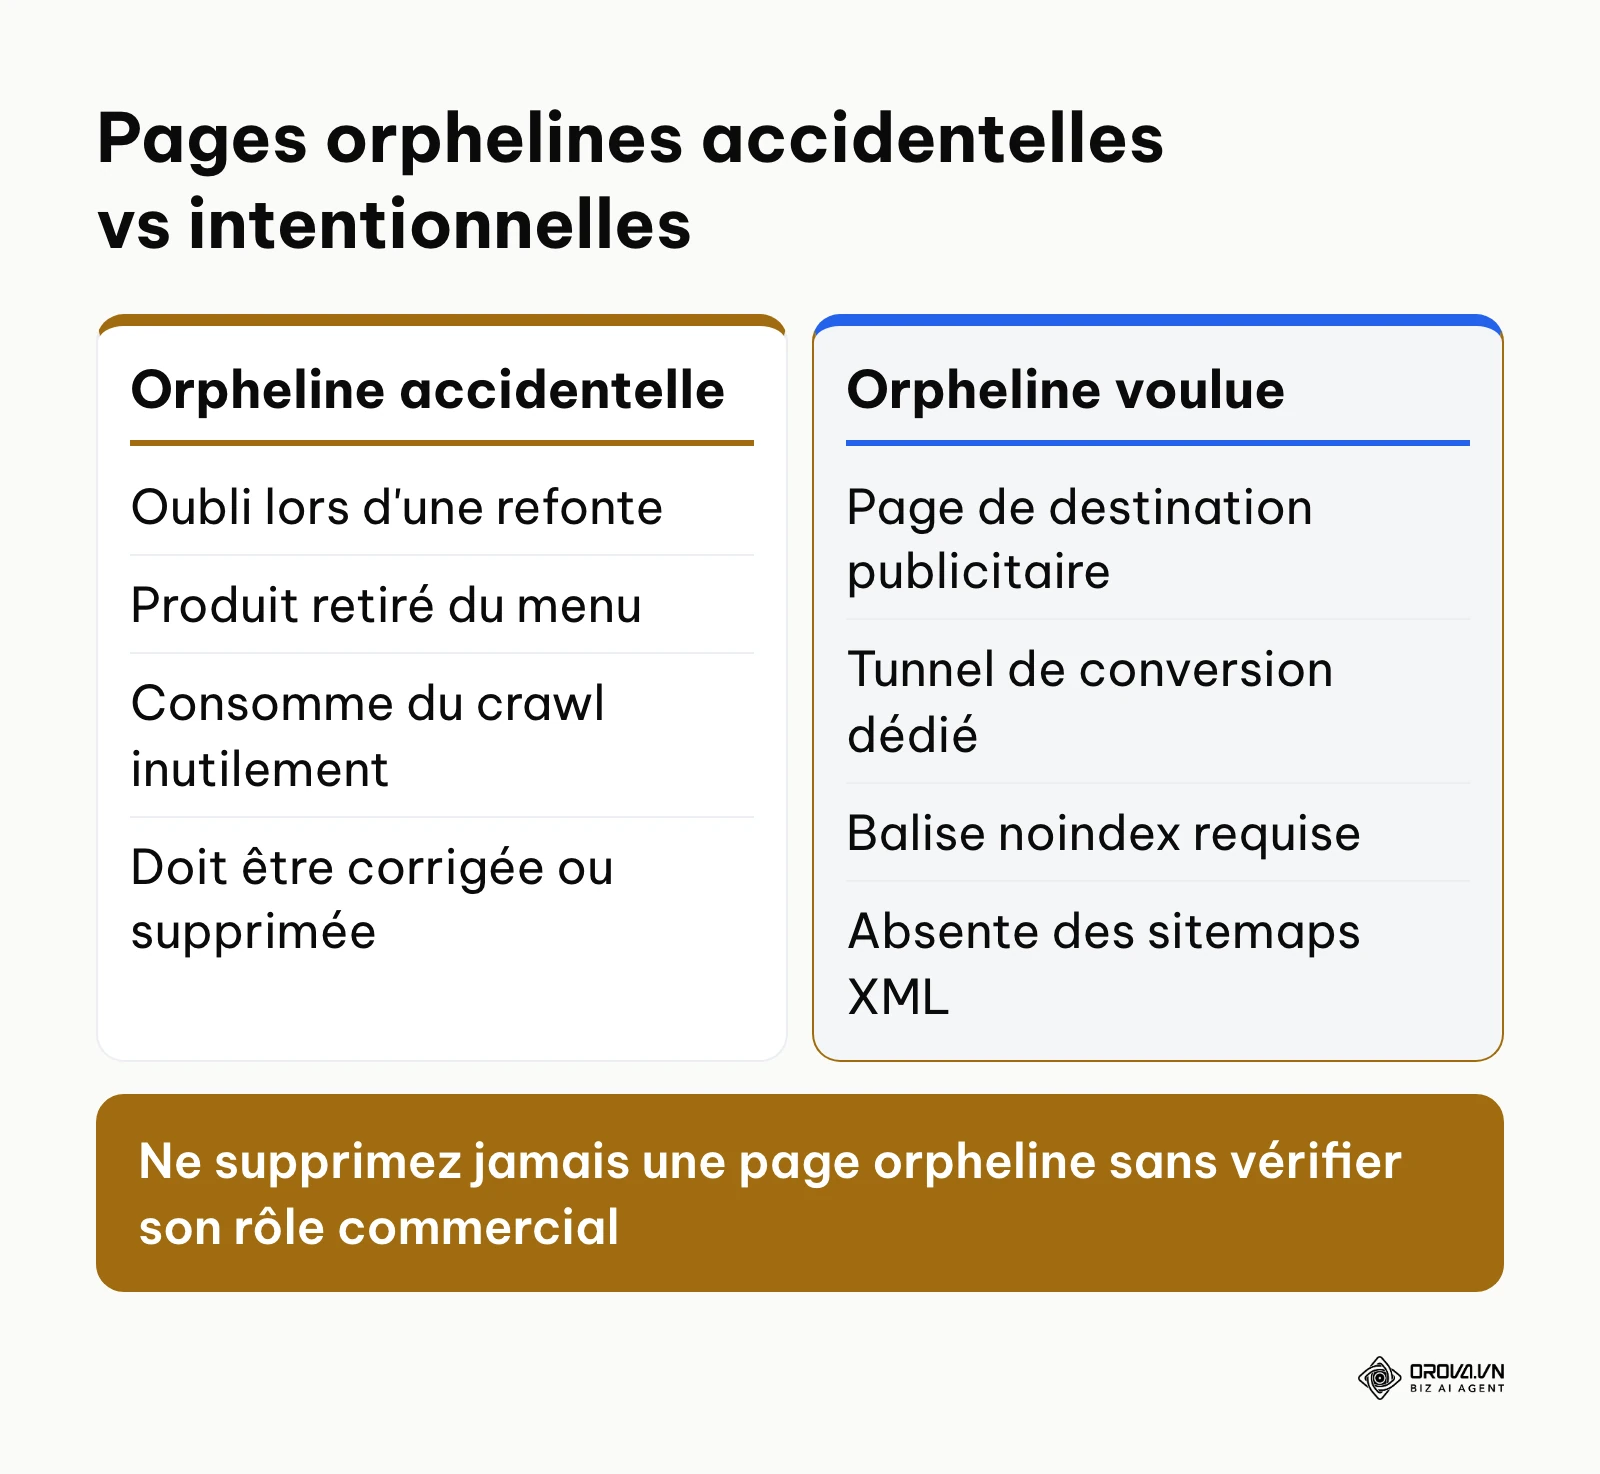
Quatre solutions techniques coexistent pour résoudre le statut d'une page orpheline, chacune répondant à des règles d'ingénierie web strictes.
| Option de traitement | Cas d'application | Risque technique | Action CMS / Serveur |
|---|---|---|---|
| Réintégration au maillage | Contenu pertinent, générant du trafic ou ciblant un mot-clé stratégique | Dilution du PageRank si le lien est inséré hors contexte thématique | Ajouter un lien contextuel dans un article parent, un menu ou un fil d'Ariane |
| Redirection 301 (Moved Permanently) | Page obsolète ou produit épuisé possédant des backlinks externes | Boucle de redirection ou perte d'équité si la cible n'a aucun rapport sémantique | Configurer une règle de redirection permanente dans le fichier .htaccess ou Nginx |
| Code 410 (Gone) | Page sans valeur, sans trafic, sans backlink, définitivement abandonnée | Supprimer par erreur une URL utile générant des conversions directes | Renvoyer l'en-tête HTTP 410 via le serveur ou supprimer définitivement du CMS |
| Balise noindex + canonical | Landing page payante, page de confirmation ou tunnel privé | Consommation résiduelle de budget de crawl si l'URL reste dans le sitemap | Ajouter <meta name="robots" content="noindex, follow"> et retirer du sitemap |
Cas 1 : Réintégrer la page dans le maillage interne
Ouvrez le back-office de votre site et identifiez deux ou trois articles traitant d'une thématique étroitement liée à la page orpheline à sauver. Insérez un lien hypertexte naturel au sein du corps du texte, en utilisant une ancre de texte explicite et variée. Si la page orpheline est une catégorie ou un service fondamental, ajoutez son lien dans le menu de navigation principal ou dans le pied de page du site.
Cas 2 : Configurer une redirection permanente 301
Accédez au fichier de configuration de votre serveur (par exemple le fichier .htaccess pour Apache ou le bloc server sous Nginx). Ajoutez une instruction de redirection pointant vers l'URL la plus proche sur le plan thématique :
# Redirection d'une ancienne page orpheline vers la catégorie parente
RedirectPermanent /ancienne-categorie/produit-orphelin https://votresite.com/categorie-principale/
Cas 3 : Renvoyer un code d'état HTTP 410 Gone
D'après la spécification RFC 9110 de l'IETF (2022), le code d'état HTTP 410 Gone indique que la ressource cible n'est plus disponible sur le serveur et que cette absence est probablement définitive. Contrairement à une erreur 404 standard qui incite les moteurs à repasser plusieurs fois pour vérifier la disponibilité future du contenu, le code 410 signale clairement une suppression volontaire, ce qui aide Google à retirer l'URL de son index sans revenir la vérifier aussi souvent.
Dans Apache, configurez l'en-tête suivant pour les URL à supprimer sans équivalent :
# Suppression définitive d'une page orpheline inutile
Redirect gone /dossier/page-orpheline-inutile
Résultat vérifiable visuellement
Ouvrez une fenêtre de terminal ou un outil d'inspection d'en-têtes HTTP en ligne et interrogez l'URL modifiée. Pour une page réintégrée, vérifiez que le code de réponse est bien 200 OK et que le lien entrant apparaît lors d'un nouveau crawl partiel. Pour une redirection ou une suppression, constatez immédiatement le renvoi du statut 301 Moved Permanently ou 410 Gone.
curl -I https://votresite.com/dossier/page-orpheline-inutile
# Réponse attendue :
# HTTP/2 410
# date: Thu, 15 Oct 2026 12:45:00 GMT
Erreurs fréquentes à cette étape
L'erreur la plus fréquente consiste à rediriger toutes les pages orphelines supprimées en masse vers la page d'accueil du site. Google assimile ce comportement à des erreurs 404 douces (les fameuses erreurs Soft 404), neutralisant le transfert d'autorité des éventuels backlinks et perturbant l'expérience de navigation de vos utilisateurs. Redirigez toujours vers une page sémantiquement équivalente, ou assumez pleinement le code 410.
Étape 6 : Automatiser la détection des pages orphelines et valider la réindexation
L'objectif final est de vérifier que Google a bien pris en compte vos modifications architecturales et de prévenir l'apparition de nouvelles URL orphelines lors des futures publications.
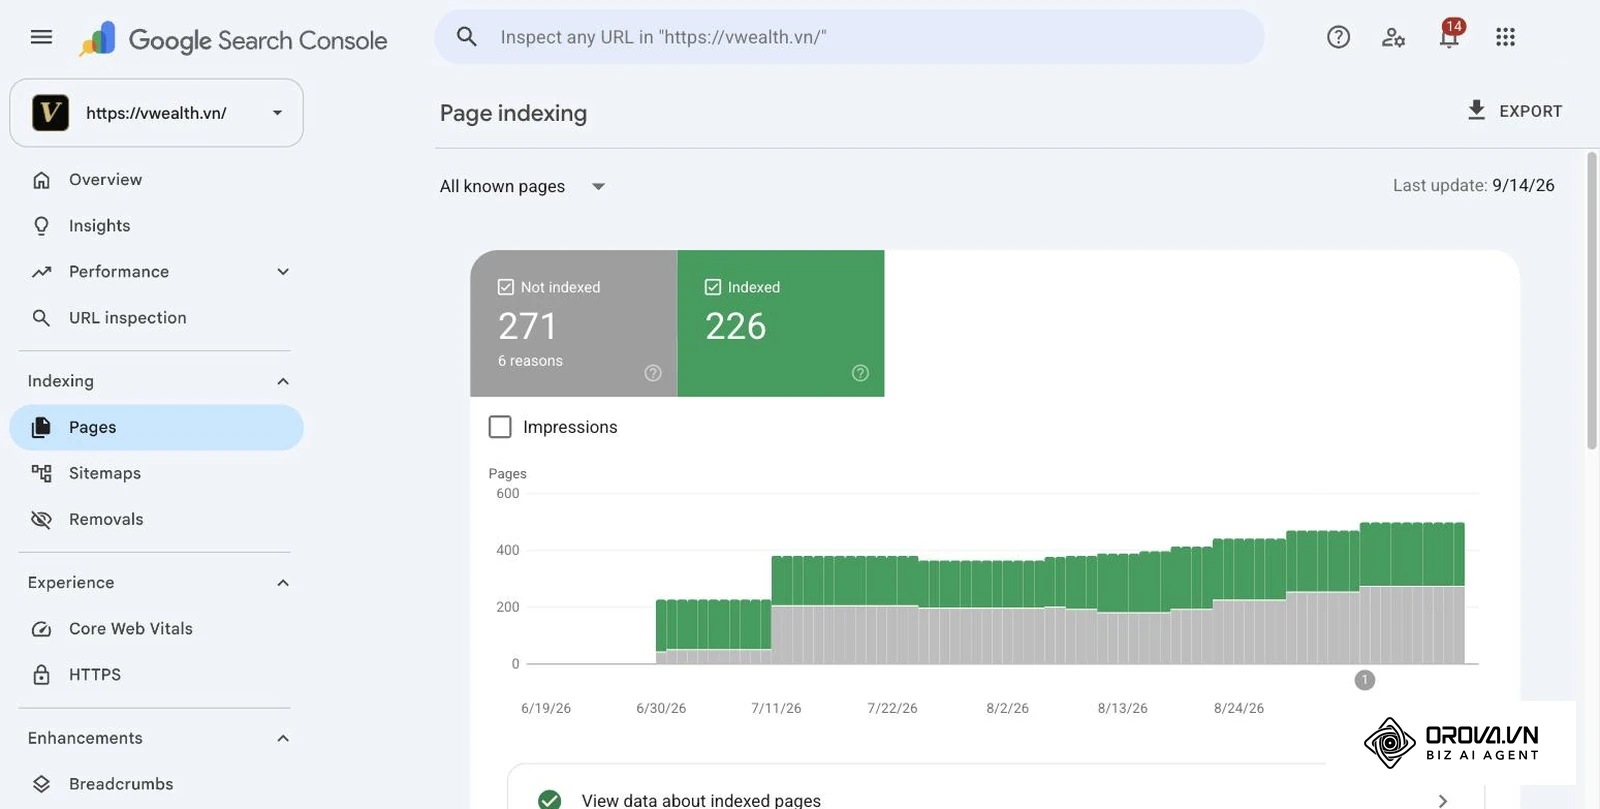
Où et comment manipuler
Rendez-vous dans Google Search Console, ouvrez l'outil d'Inspection de l'URL situé dans la barre supérieure et saisissez l'adresse des pages orphelines que vous venez de raccorder au maillage interne. Cliquez sur Tester l'URL en direct pour vérifier que le robot parvient à explorer le document sans obstacle technique, puis cliquez sur Demander une indexation.
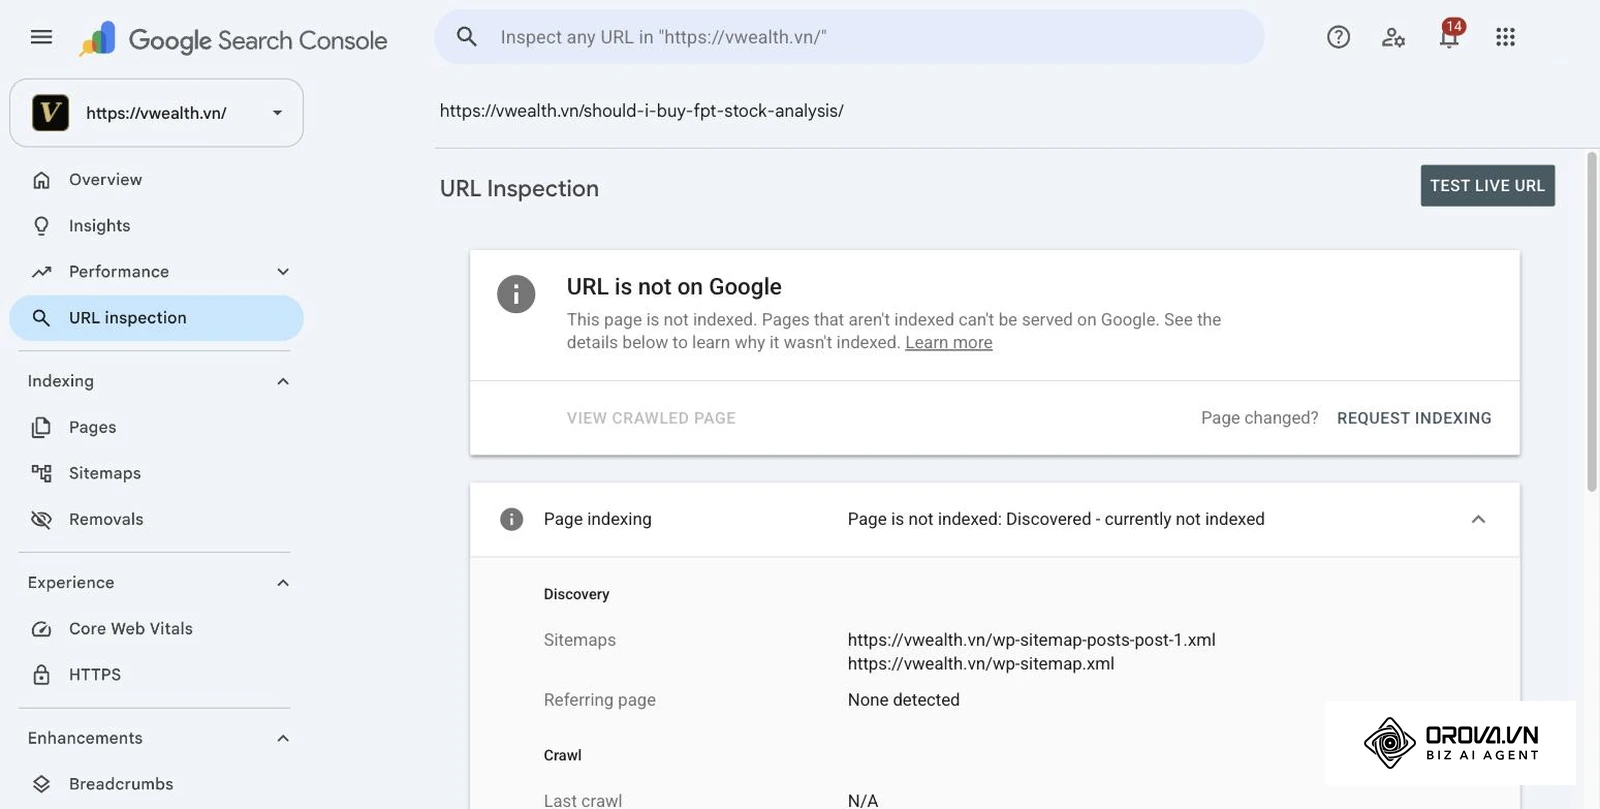
Consultez ensuite le rapport Indexation des pages dans le menu de gauche de la Search Console. Surveillez attentivement l'évolution de la catégorie Détectée - actuellement non indexée. Cette mention caractérise fréquemment les pages orphelines que Google a découvertes (par exemple via un sitemap XML ou un lien externe ancien) mais qu'il refuse d'indexer en raison de l'absence de signaux de popularité interne. Dès que vos liens internes sont reconnus, ces URL doivent glisser progressivement vers la catégorie Valides.
Pour pérenniser ce contrôle sans répéter un audit manuel laborieux chaque semaine, mettez en place des indicateurs pour vos tableaux de bord techniques en connectant vos fichiers journaux ou les métriques d'exploration de l'API Search Console à un outil de suivi automatisé.
Résultat vérifiable visuellement
Dans le rapport d'inspection d'URL de Google Search Console, le statut passe au vert avec la mention L'URL est sur Google. Dans la section Pages d'origine faisant référence, vous devez voir apparaître l'URL de la page interne depuis laquelle vous avez inséré votre nouveau lien contextuel lors de l'étape précédente.
Erreurs fréquentes à cette étape
Demander l'indexation de centaines d'URL manuellement via l'interface de Search Console en quelques minutes déclenche un blocage temporaire de votre quota journalier de soumission. Laissez Googlebot découvrir naturellement vos nouveaux liens en mettant simplement à jour votre fichier sitemap XML et en veillant à ce que vos pages mères soient fréquemment visitées par les robots.
Checklist récapitulatif pour traiter les pages orphelines sans risque
Le tableau ci-dessous récapitule l'ensemble du processus afin que vous puissiez valider chaque jalon lors de vos audits réguliers.
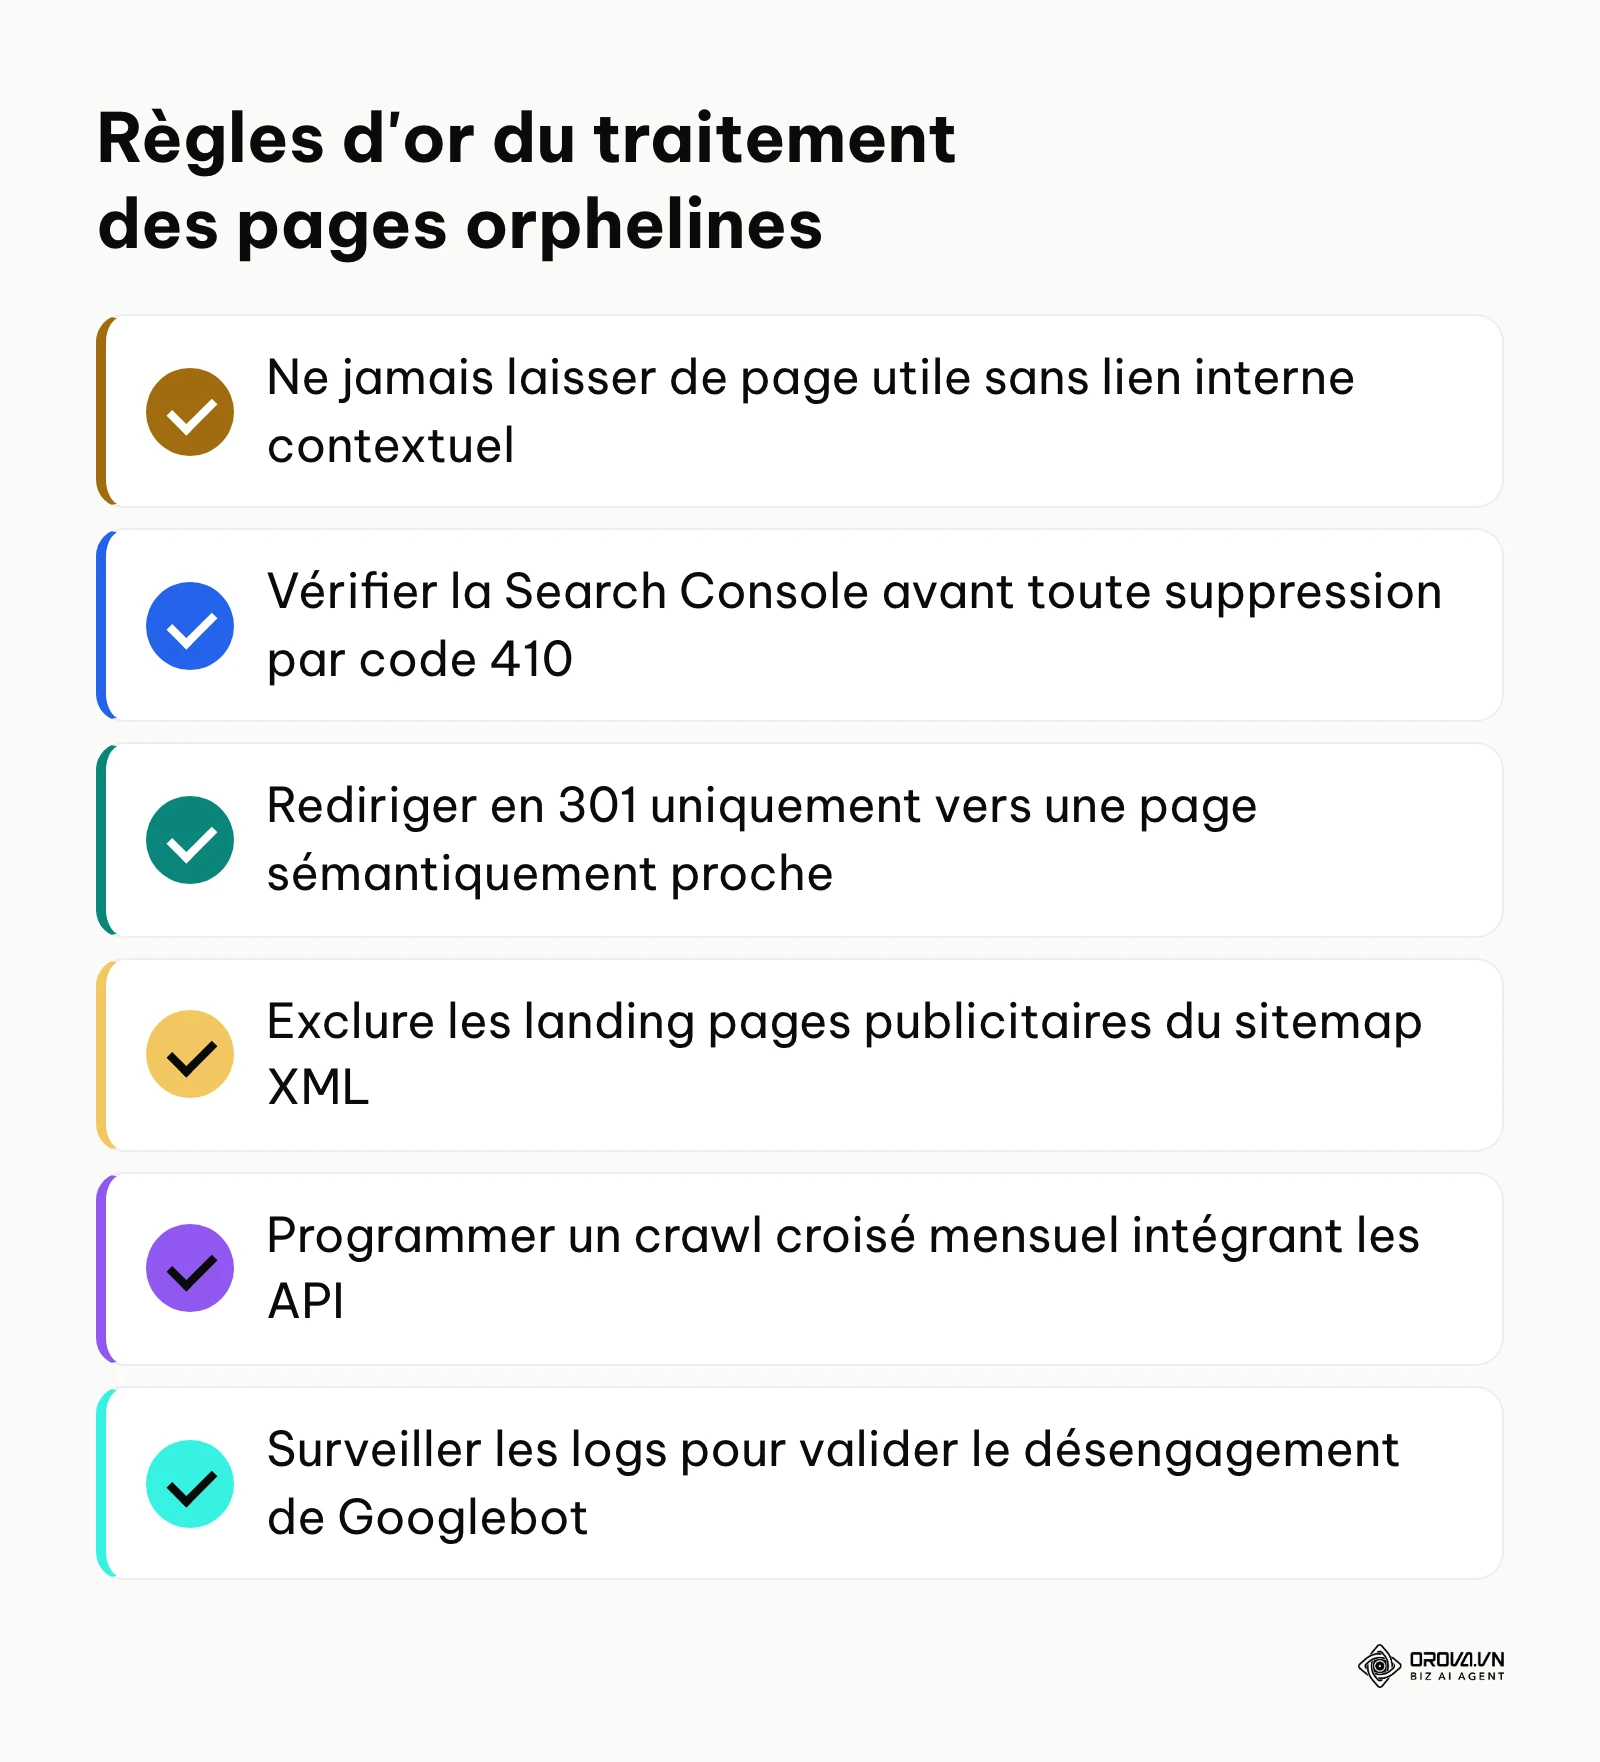
| Étape | Action principale | Critère de validation visuelle | Temps estimé |
|---|---|---|---|
| 1. Extraction | Extraire les URL du sitemap XML et l'inventaire complet du CMS | Fichier CSV dédupliqué sans paramètre de suivi | 20 minutes |
| 2. Connexion API | Authentifier les API Search Console et Google Analytics 4 | Voyants verts d'accès API validés dans le logiciel de crawl | 15 minutes |
| 3. Crawl croisé | Exécuter le crawl complet et lancer l'analyse post-crawl | Présence d'adresses filtrées sous l'onglet URL orphelines | 45 minutes |
| 4. Classification | Appliquer l'arbre de décision selon le trafic et les backlinks | Répartition des URL dans le tableur (Conserver, 301, 410, Noindex) | 30 minutes |
| 5. Traitement | Remailler les pages utiles, rediriger ou appliquer le code 410 | En-têtes HTTP validés par commande curl ou outil d'en-tête | 40 minutes |
| 6. Suivi & Indexation | Inspecter les URL dans GSC et vérifier la baisse des non-indexées | Rapport d'inspection affichant la page référente interne | 20 minutes |
Erreurs fréquentes autour des pages orphelines et solutions correctives
Lors de la gestion de structures de sites volumineuses, plusieurs pièges techniques peuvent compromettre la réussite de votre assainissement d'arborescence.
Le tableau ci-dessous recense les défaillances les plus répandues constatées sur les sites d'entreprises.
| Erreur fréquente | Cause sous-jacente | Solution corrective |
|---|---|---|
| Déclarer les pages orphelines dans le sitemap sans lien HTML | Tentative d'indexer des pages isolées en les injectant de force dans le sitemap | Retirer l'URL du sitemap ou créer un lien contextuel depuis une page de niveau supérieur |
| Bloquer les pages orphelines via le fichier robots.txt | Volonté de bloquer le crawl de pages inutiles sans les supprimer | Supprimer la directive Disallow pour laisser Googlebot lire le code 410 ou la balise noindex |
| Laisser des landing pages payantes indexables | Oubli de balisage sur les pages de conversion isolées de la navigation | Insérer la balise <meta name="robots" content="noindex, follow"> sur toutes les pages dédiées aux annonces |
| Créer des liens orphelins uniquement dans un méga-menu | Volonté de mailler rapidement 500 pages orphelines d'un seul coup | Privilégier des liens contextuels insérés au sein de paragraphes de contenu thématiquement proches |
| Ignorer les URL orphelines renvoyant des erreurs 404 | Refus de traiter les pages d'erreur sous prétexte qu'elles sont déjà cassées | Poser une redirection 301 si l'URL a des backlinks, ou confirmer la suppression par un code 410 |
Avec OROVA.VN et le module OROVA SEO, vous mettez définitivement fin aux journées épuisantes de travail manuel. Au lieu de passer des heures à rédiger des articles et à préparer des rapports, l'ensemble du processus est désormais optimisé et bouclé en seulement 5 minutes.
Mesurer l'impact de la correction des pages orphelines sur le SEO
Pour attester de l'efficacité de vos corrections, surveillez trois indicateurs majeurs au sein de vos outils d'analyse au cours des semaines suivant l'intervention.
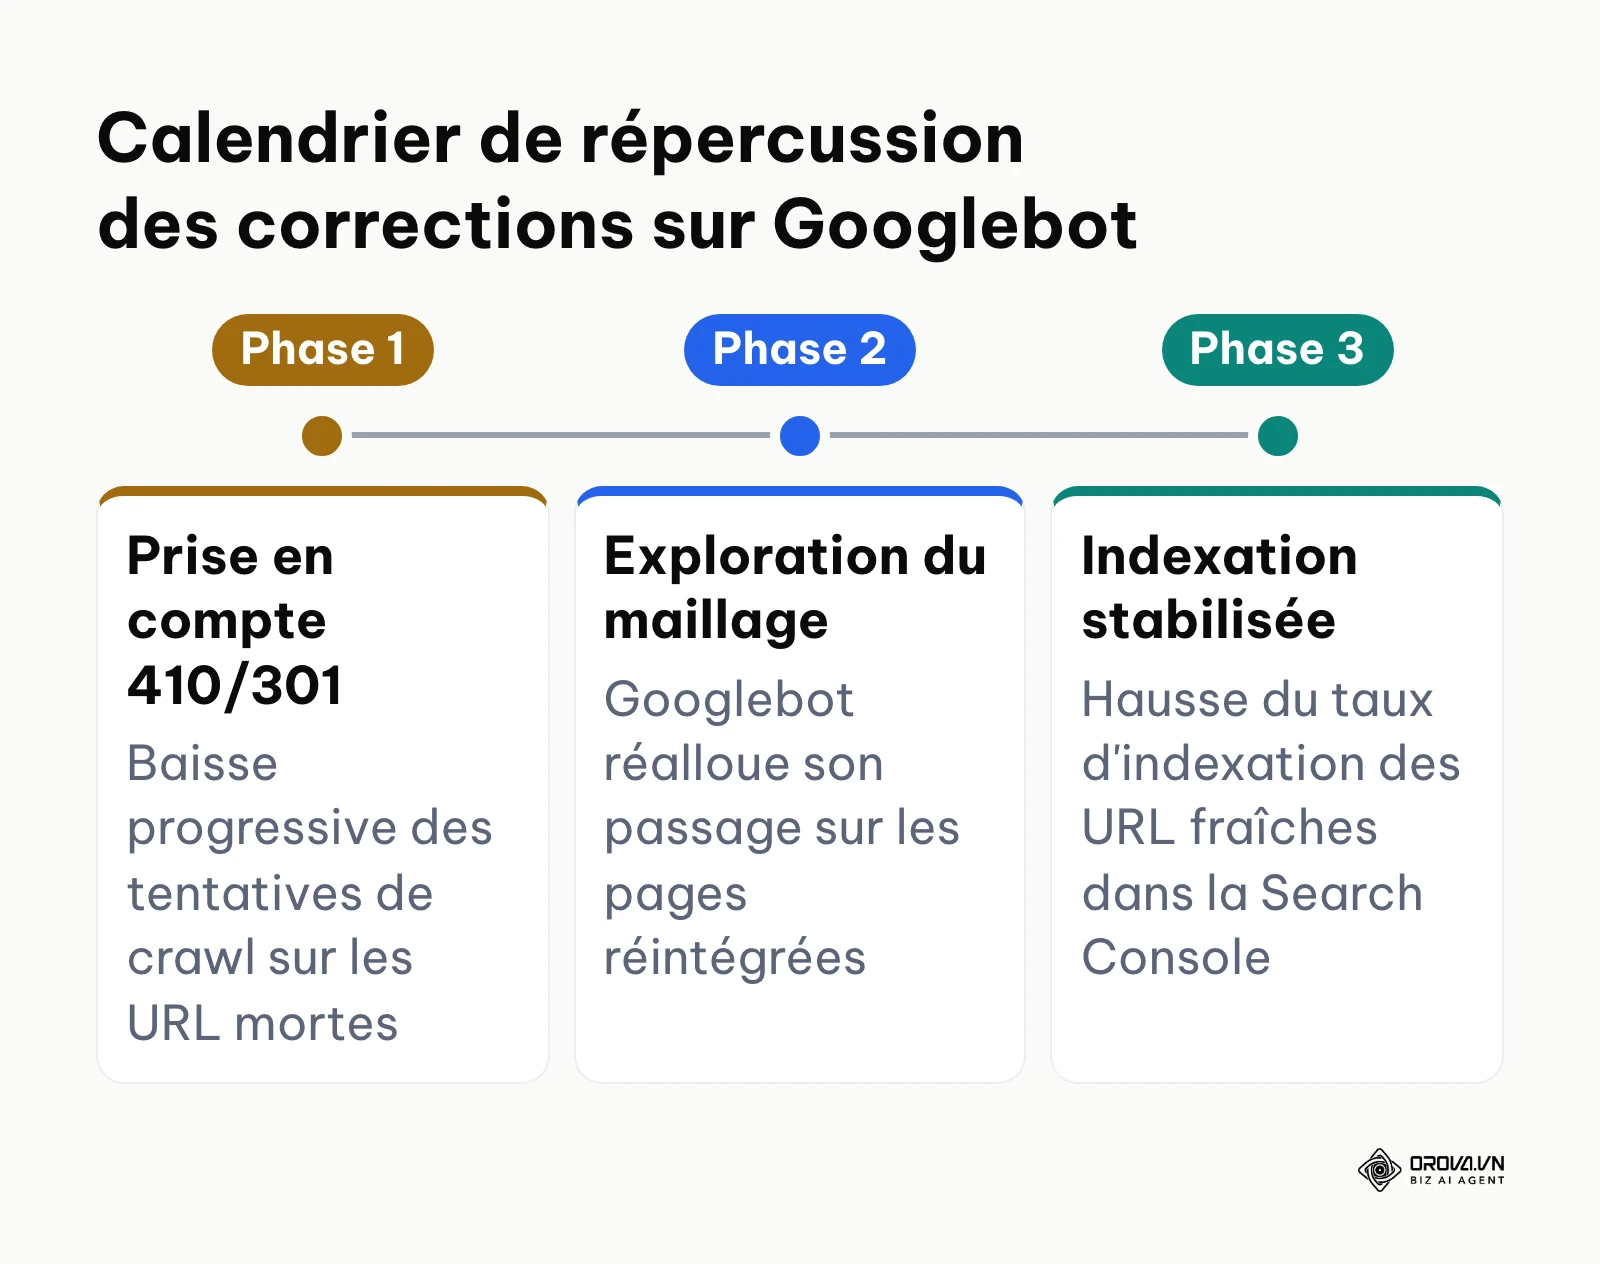
Dans Google Search Console, ouvrez les Statistiques sur l'exploration (situées dans Paramètres > Statistiques sur l'exploration). Observez le graphique Répartition des demandes d'exploration : la part des requêtes absorbées par le statut 200 OK doit se stabiliser sur vos pages importantes, tandis que les requêtes consacrées aux URL supprimées doivent décroître nettement après une phase transitoire de détection du code 410.
Consultez ensuite le rapport Indexation des pages. Vous devez constater une diminution progressive du volume d'adresses classées sous l'état Détectée - actuellement non indexée, au profit de la courbe des pages indexées. Enfin, dans votre outil d'analyse d'audience, observez le trafic organique des pages que vous avez reconnectées au maillage : une hausse des impressions de mots-clés devient souvent visible au bout de quelques semaines après l'ajout des liens contextuels, selon la fréquence de crawl de votre site.
Tendances des pages orphelines et de l'architecture web : l'avis de l'auteur
En observant l'évolution des architectures de sites jusqu'en 2026, je constate que l'essor massif des frameworks front-end modernes et des architectures découplées de type headless CMS multiplie involontairement l'apparition de micro-états de pages orphelines. De nombreuses interfaces dynamiques chargent des blocs de contenu via des flux JavaScript asynchrones sans intégrer de véritables balises d'ancrage <a> navigables dans le document HTML d'origine. Selon moi, dans les deux à trois ans à venir, les moteurs d'exploration durciront drastiquement leurs critères de budget de crawl pour limiter l'empreinte énergétique de l'indexation web, pénalisant lourdement les sites qui laissent errer des fragments de catalogue sans navigation structurée. Les gestionnaires de sites doivent dès à présent auditer le rendu HTML statique généré côté serveur pour s'assurer qu'aucun lien fonctionnel ne dépend d'une interaction utilisateur au clic.
Je prévois également une mutation profonde du rôle de l'intelligence artificielle dans la régulation du maillage interne. Aujourd'hui, l'analyse des nœuds d'un graphe web demeure une opération périodique manuelle. J'estime qu'à l'horizon 2028, les moteurs de recherche exploiteront directement des modèles d'analyse topologique capables d'interpréter le contexte sémantique d'un site sans dépendre exclusivement du parcours linéaire des hyperliens. Toutefois, ce pronostic pourrait se révéler inexact si les coûts de calcul des grands modèles d'apprentissage forcent Google à maintenir le PageRank classique et l'exploration par liens comme filtre économique incontournable.
Enfin, je considère que les spécialistes du référencement doivent cesser de considérer les sitemaps XML comme des pansements destinés à pallier les carences de maillage. La dépendance excessive aux sitemaps pour faire découvrir des pages isolées constitue une faiblesse méthodologique que les algorithmes identifient désormais sans difficulté. Vous devez bâtir vos arborescences selon une logique de cocons thématiques hermétiques où chaque URL enfant dispose d'une affiliation claire avec son parent, garantissant une circulation fluide du jus de lien sans intervention externe artificielle.
Questions fréquentes sur les pages orphelines
Comment réintégrer une page orpheline qui génère du trafic sans perturber le cocon sémantique existant ?
Si une page orpheline enregistre déjà des visites régulières et se positionne sur des mots-clés stratégiques, vous devez lui trouver une page parente naturelle au sein de votre arborescence. Identifiez l'article pilier ou la catégorie thématiquement la plus proche et insérez un lien hypertexte contextuel dans un paragraphe pertinent du contenu existant. Évitez de placer ce lien dans une zone globale comme le pied de page ou la barre latérale pour ne pas brouiller le champ lexical de vos autres sections.
Pourquoi une URL présente dans le sitemap XML reste-t-elle « Détectée - actuellement non indexée » dans Search Console ?
La présence d'une adresse dans un sitemap XML informe Google de son existence, mais ne lui confère aucun gage d'importance ou de qualité. Si cette URL ne reçoit aucun lien interne depuis le reste de votre domaine, le moteur de recherche juge qu'elle ne présente pas un intérêt suffisant pour mobiliser des ressources d'exploration et d'indexation. La résolution de ce statut impose d'intégrer l'URL au maillage interne éditorial de votre site.
Les landing pages payantes (Google Ads) doivent-elles être traitées comme des pages orphelines ?
Oui, sur le plan strictement architectural, les pages de destination publicitaires sont presque toujours des pages orphelines voulues, car on évite de les lier à la navigation pour maximiser le taux de conversion sans fuite d'attention. En revanche, pour éviter qu'elles ne soient auditées comme des anomalies SEO néfastes, vous devez impérativement leur associer une balise méta robots noindex, follow et vous assurer de leur exclusion absolue de vos fichiers sitemaps XML.
Quel est le rôle de l'intelligence artificielle dans la gestion des pages orphelines ?
L'intelligence artificielle intervient aujourd'hui pour accélérer l'analyse sémantique des URL orphelines et proposer automatiquement les ancres de texte les plus adaptées pour les rattacher aux pages existantes. Des algorithmes de traitement automatique du langage naturel comparent le contenu de la page isolée avec le corpus global du site afin d'identifier instantanément le meilleur emplacement contextuel pour y faire pointer un nouveau lien interne.
Faut-il supprimer systématiquement toutes les pages orphelines détectées ?
Non, la suppression systématique est une erreur majeure qui peut détruire des pans entiers de votre visibilité historique. Une page orpheline peut abriter d'excellents contenus malencontreusement décrochés du menu lors d'une mise à jour de thème ou d'une refonte. Vous ne devez supprimer définitivement une page via le code HTTP 410 qu'après avoir validé qu'elle n'enregistre aucun trafic, ne dispose d'aucun lien externe d'autorité et ne présente plus d'intérêt commercial.
Comment gérer les pages orphelines de produits en rupture de stock sur un site e-commerce ?
Lorsqu'un produit sort temporairement du catalogue, ne supprimez pas son URL et ne coupez pas ses liens internes : conservez la page accessible en mentionnant la rupture temporaire et en proposant des produits alternatifs similaires. Si le produit est abandonné définitivement par le fournisseur, retirez le lien du catalogue et posez immédiatement une redirection 301 vers la catégorie parente directe afin de conserver la puissance des liens historiques.
Par où commencer face à vos pages orphelines ?
La prise en charge de votre architecture dépend directement de la taille de votre site et de l'historique de vos refontes éditoriales.
Si vous gérez un site vitrine ou un blog comptant moins de 500 pages, commencez par ouvrir votre compte Google Search Console et parcourez le rapport Indexation des pages. Filtrez les URL sous le statut Détectée - actuellement non indexée : si vous y découvrez des articles utiles rédigés par le passé, consacrez votre première demi-journée à ouvrir vos cinq meilleurs articles de blog pour y insérer deux liens contextuels pointant vers ces contenus oubliés.
Si vous pilotez une boutique e-commerce avec plusieurs milliers de références, votre priorité immédiate réside dans la configuration d'un crawl croisé connectant l'API Search Console dans Screaming Frog. Téléchargez la liste des URL orphelines issues du sitemap et vérifiez la présence d'anciens produits dépubliés qui absorbent inutilement vos passages de crawl quotidiens. Configurez une première série de redirections 301 vers les sous-catégories mères pour soulager vos serveurs.
Si vous préparez ou venez d'achever une refonte complète de votre site web, réalisez un audit de vos fichiers journaux d'accès serveur pour repérer les requêtes de robots ciblant des URL invisibles dans votre nouvelle navigation. Appliquez sans délai notre arbre de décision pour nettoyer votre base d'adresses et assainir la transmission de votre PageRank en traitant définitivement vos pages orphelines.
About the author
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Pilotez votre activité avec des AI Agents
Orova est le Biz AI Agent qui ne s'arrête jamais : il planifie, exécute et optimise le travail à votre place.
Gagnez du temps, gagnez en efficacité.