
Cómo indexar una página en Google: guía para URLs sin indexar
Saber cómo indexar una página en Google se resume en cinco comprobaciones: que la URL responda con código 200, que robots.txt no la bloquee, que no lleve noindex, que su etiqueta canónica apunte a sí misma y que Google pueda descubrirla por el sitemap y por enlaces internos. Cuando todo eso está en orden, la herramienta de inspección de URLs de Search Console permite pedir el rastreo; si aun así la página queda en «Descubierta» o «Rastreada: actualmente sin indexar», el problema ya no es técnico de acceso, sino de prioridad o de calidad. Esta guía recorre ese proceso en orden, con lo que conviene revisar en cada paso y cómo leer los estados del informe «Páginas».
Qué significa y cómo indexar una página en Google de forma predecible
Indexar una página significa que Google la ha descubierto, la ha rastreado, ha interpretado su contenido y ha decidido guardarla en su índice, la base de datos de la que salen los resultados de búsqueda. Solo a partir de ese momento la URL puede aparecer para alguna consulta.
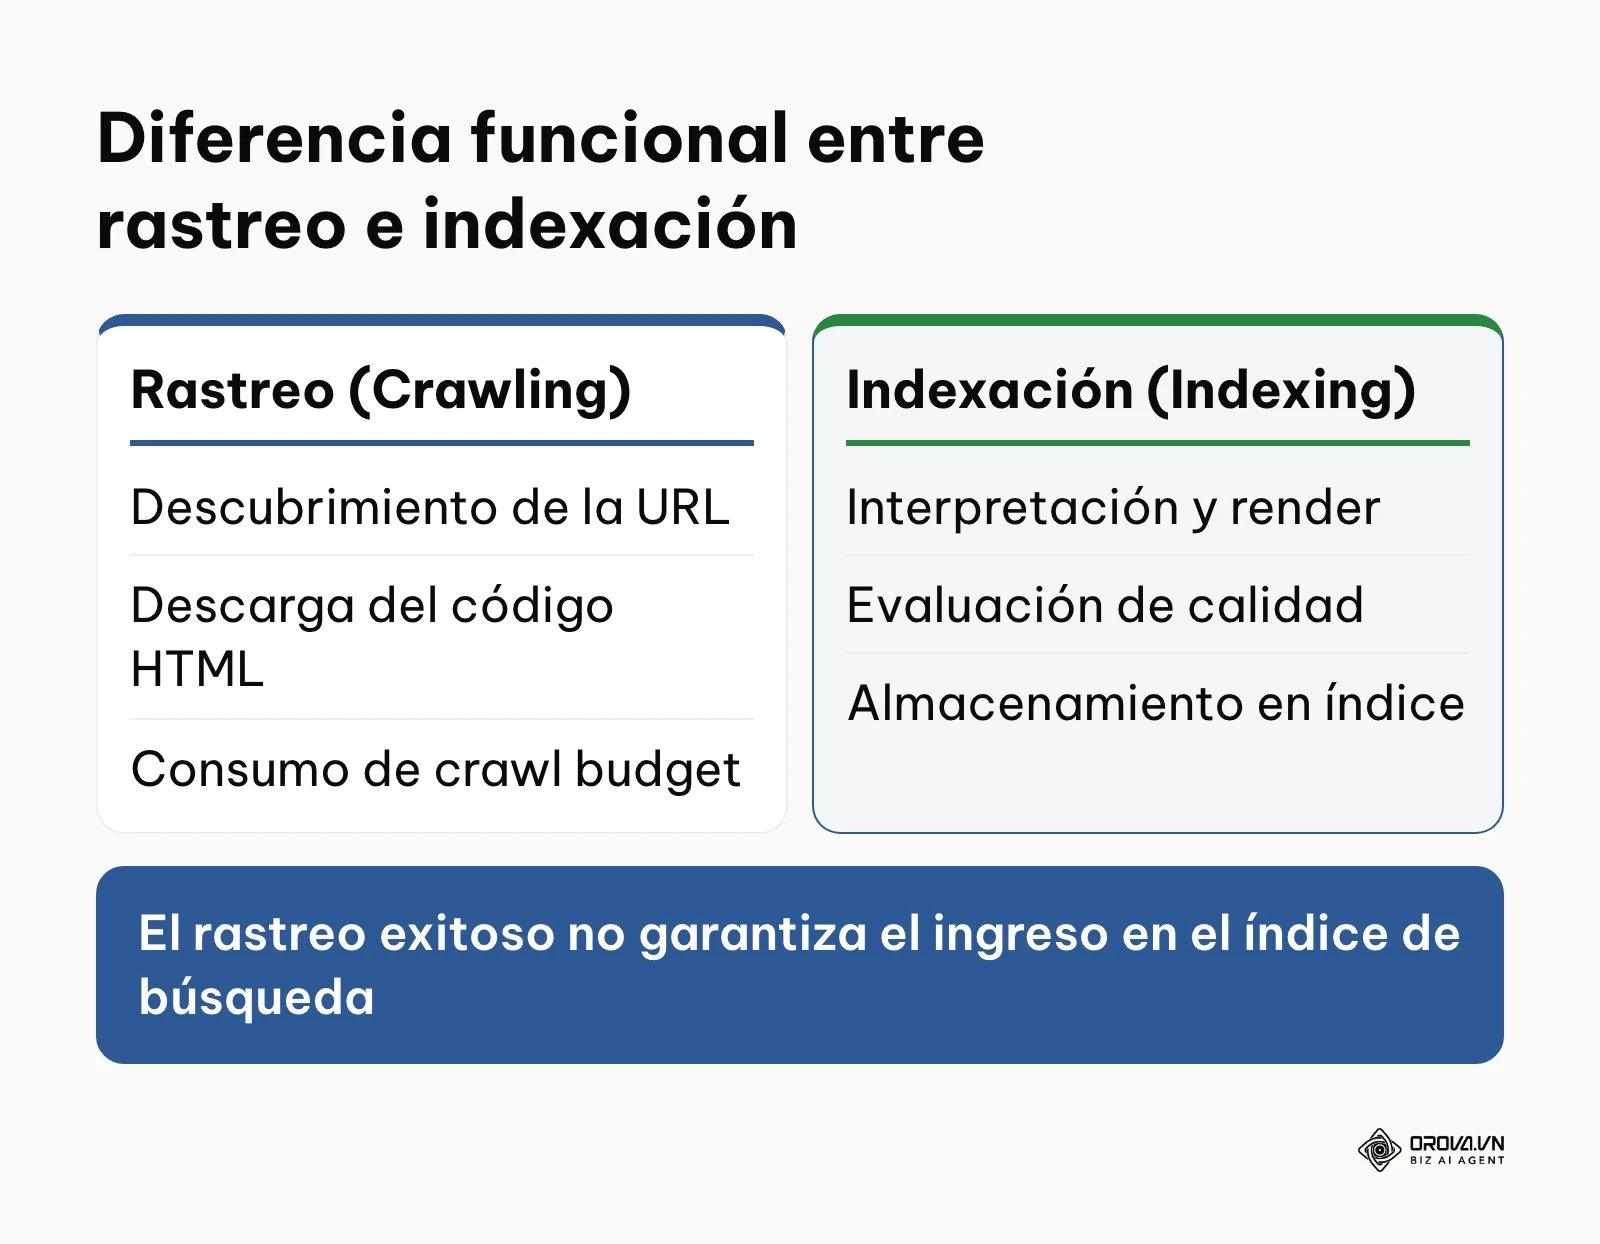
Conviene separar dos fases que a menudo se confunden. El rastreo es la parte mecánica: Googlebot solicita la URL y descarga el HTML y sus recursos. La indexación es la parte de decisión: Google renderiza la página, evalúa si aporta algo distinto de lo que ya tiene y elige si la guarda y con qué URL canónica. Una visita de Googlebot en los registros del servidor no garantiza que la página vaya a entrar en el índice.
No todas las URLs deben indexarse. Las páginas de confirmación de pago, los paneles privados, los entornos de prueba (staging), los resultados de búsqueda interna o las páginas con muy poco contenido conviene dejarlas fuera. Cuantas menos URLs inútiles ofrezca un sitio, más fácil le resulta a Google centrarse en las que sí importan.
Preparativos técnicos antes de solicitar la indexación
Antes de pedirle nada a Google, revisa que la base técnica no tenga obstáculos silenciosos. Solicitar la indexación de una URL con directivas contradictorias solo produce diagnósticos confusos.
Lo primero es tener la propiedad verificada en Google Search Console. La verificación a nivel de dominio mediante un registro DNS de tipo TXT cubre todos los subdominios y las variantes http/https de una vez. Si es tu primera vez en el panel, la guía de Google Search Console explica la configuración y las secciones principales. Después, el servidor debe responder con código 200 en las páginas públicas y redirigir con un 301 directo la versión sin HTTPS hacia la versión segura, sin cadenas de saltos intermedios.
| Componente | Dónde se revisa | Qué debe cumplirse |
|---|---|---|
| Propiedad en Search Console | Registrador de dominio (registro TXT) | Propiedad verificada a nivel de dominio |
| robots.txt | https://tudominio.com/robots.txt | Sin Disallow sobre la URL ni sobre CSS/JS necesarios |
| Sitemap XML | CMS o generador (/sitemap.xml) | Accesible con código 200 y solo con URLs canónicas |
| Etiqueta canónica | <head> de cada página | Autorreferencial en las páginas originales |
| Meta robots y cabeceras | Código fuente y cabeceras HTTP | Sin noindex ni X-Robots-Tag: noindex en producción |
| HTTPS | Hosting o CDN | Certificado válido y sin contenido mixto |
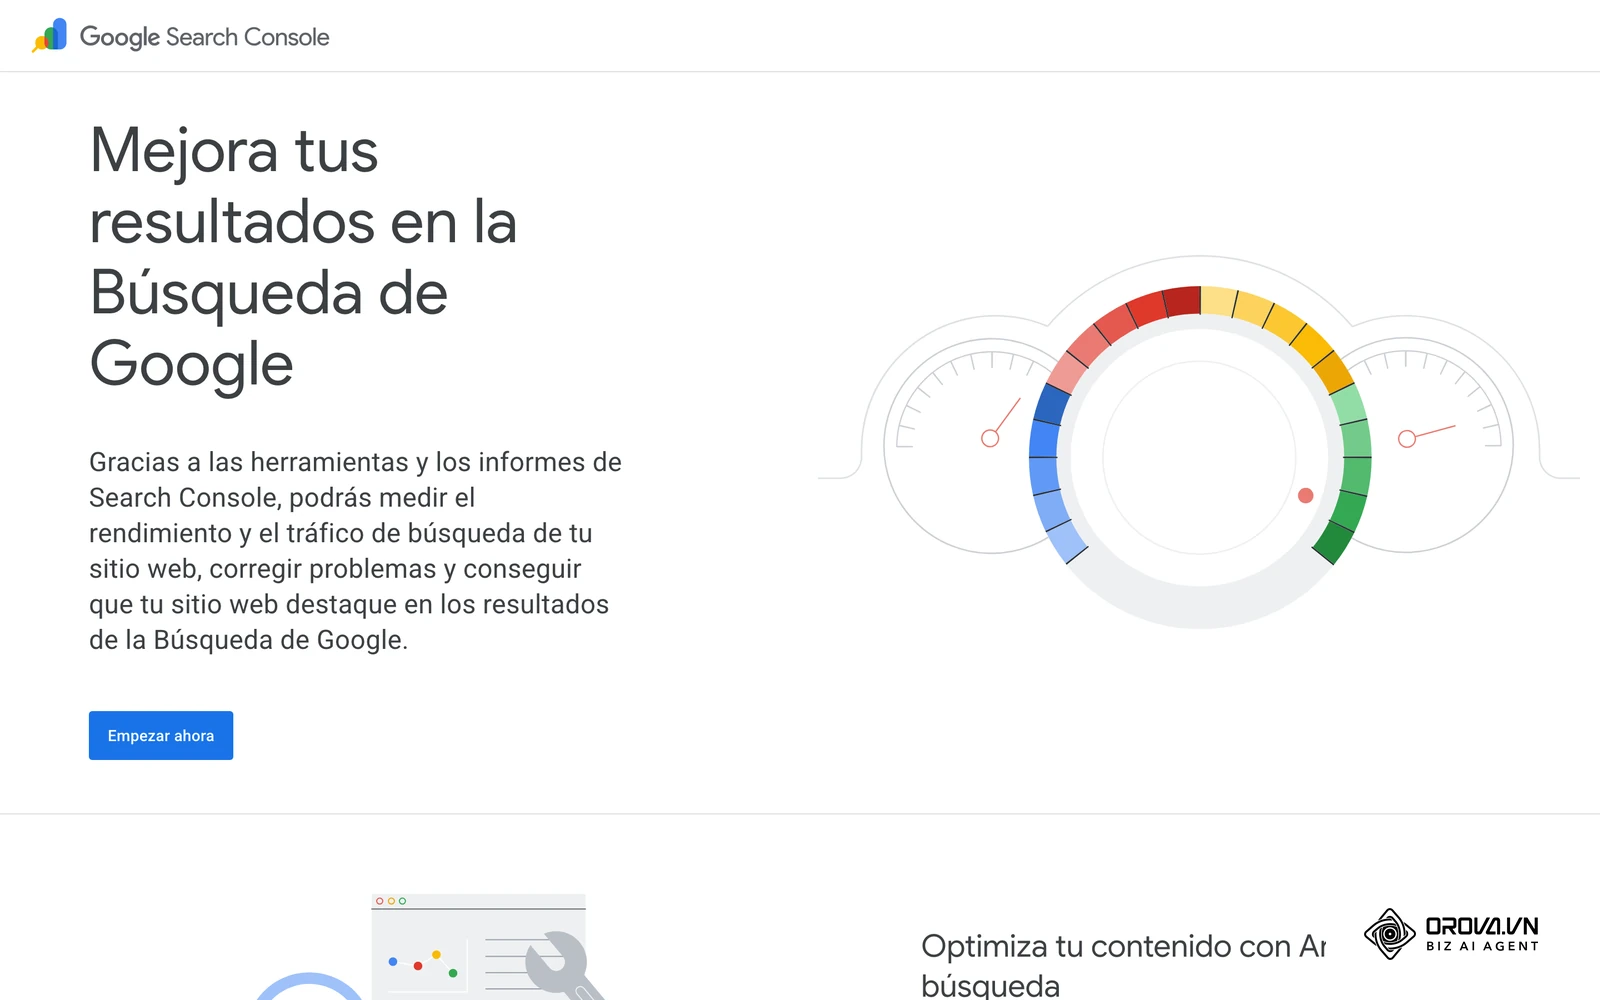
Con estos seis puntos en orden, el rastreador tiene un camino despejado. Si alguno falla, cualquier solicitud posterior de indexación tiende a fracasar sin un mensaje de error claro.
Cómo indexar una página en Google paso a paso: protocolo técnico integral
El orden importa: primero se eliminan los bloqueos, después se declara la URL y solo al final se pide el rastreo. Saltarse pasos suele terminar en solicitudes repetidas que no cambian nada.
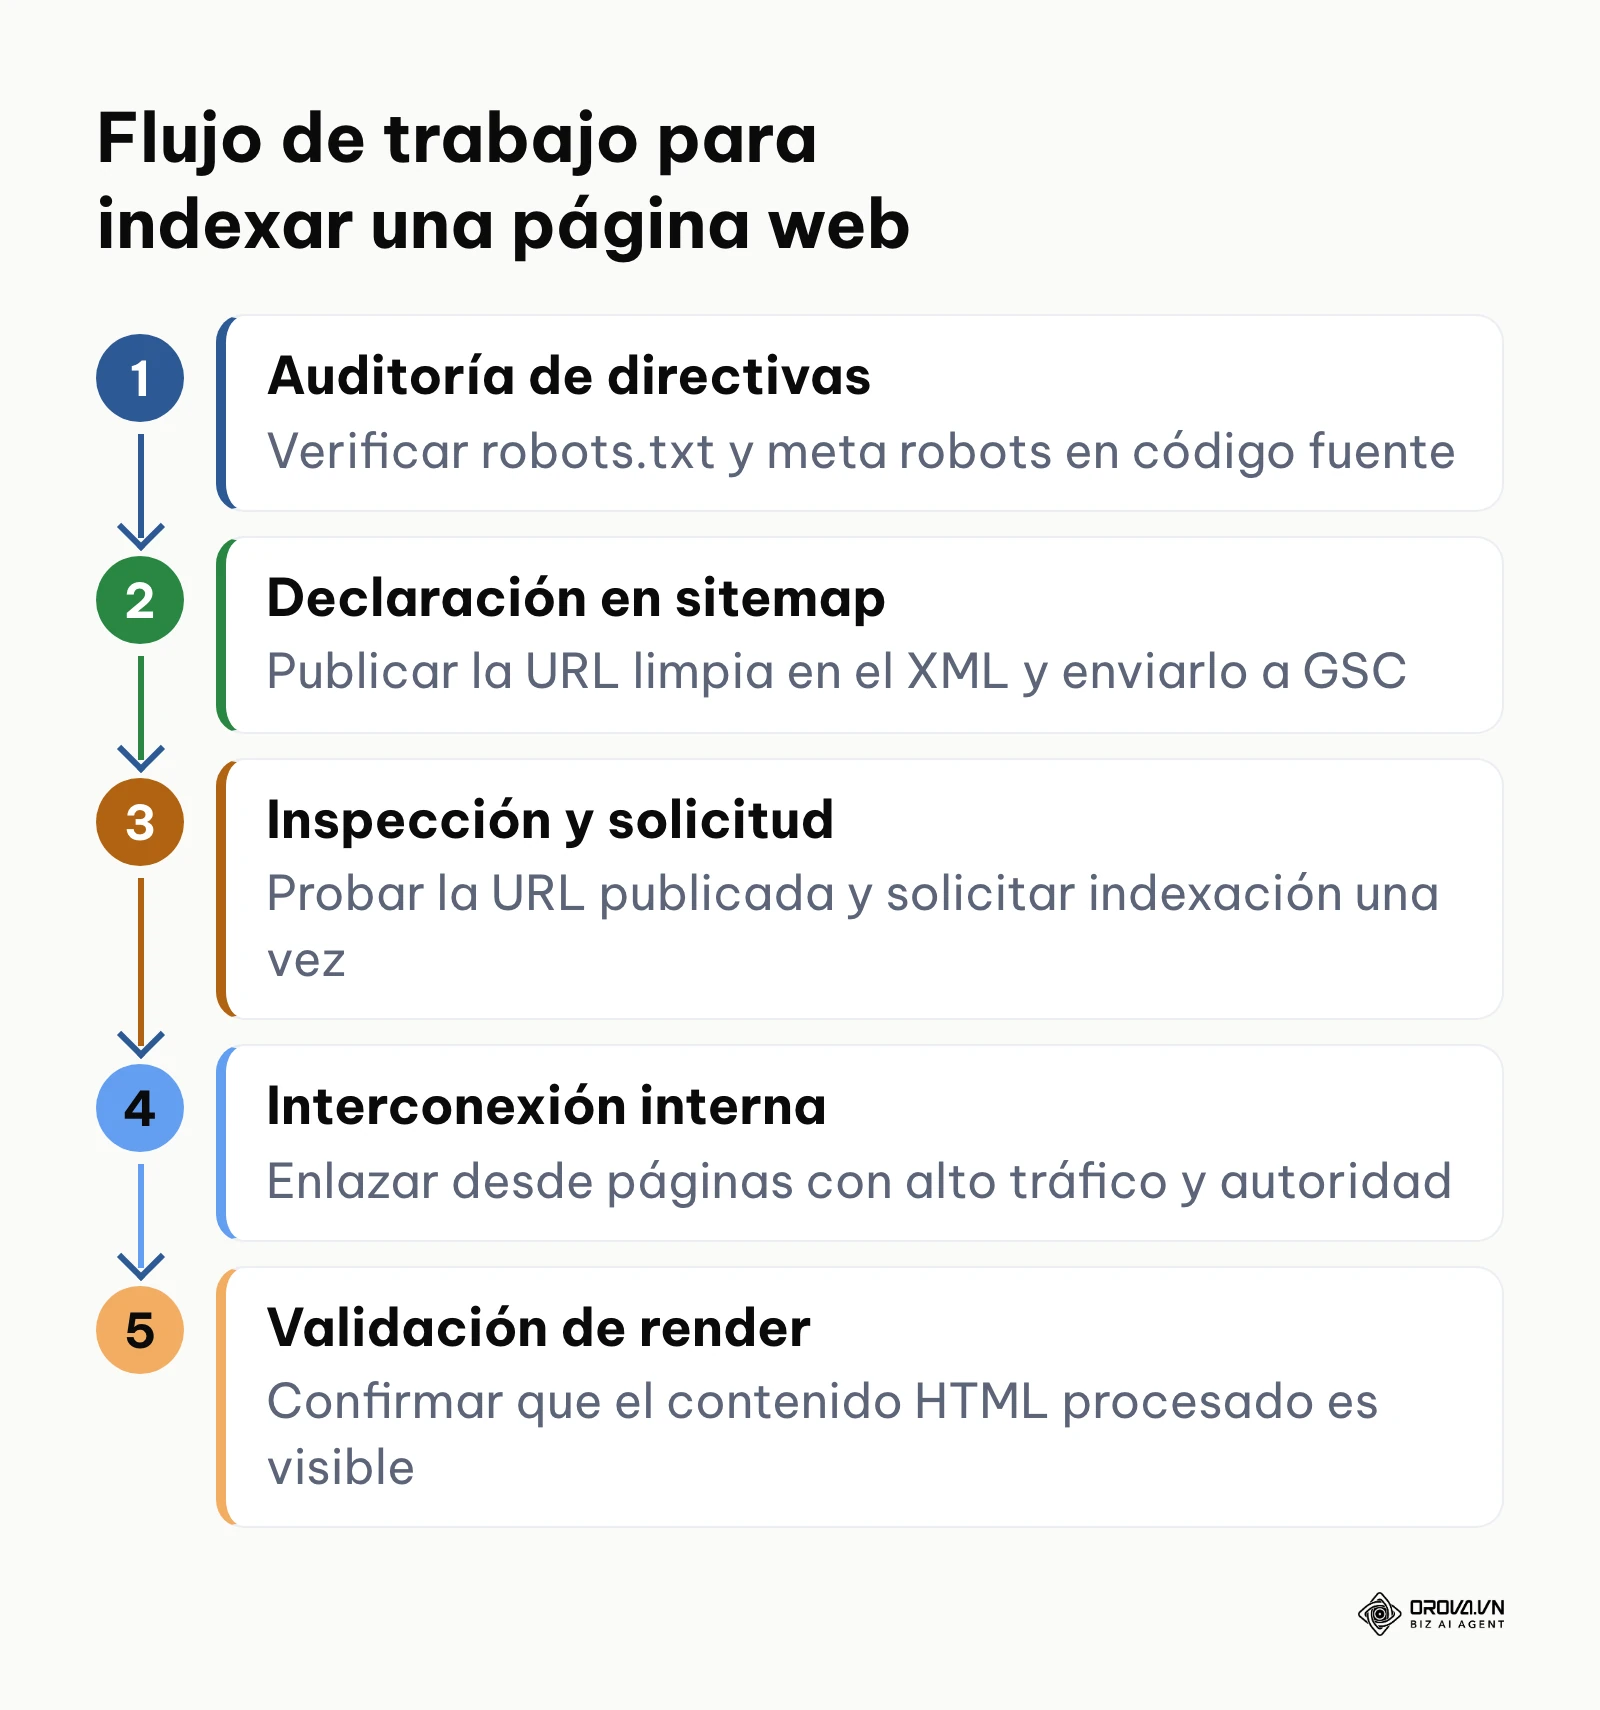
Paso 1: Configuración y validación del archivo robots.txt y directivas canónicas
El archivo robots.txt es lo primero que consulta un rastreador al llegar a tu dominio. Sirve para evitar que Googlebot pierda tiempo en zonas sin valor para la búsqueda, como el área de administración, el carrito o el proceso de pago. Un esquema base para un sitio WordPress con tienda podría ser:
User-agent: *
Disallow: /wp-admin/
Disallow: /checkout/
Disallow: /cart/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://tudominio.com/sitemap_index.xml
El Protocolo de exclusión de robots está estandarizado en el RFC 9309 (IETF, 2022), y Google lo respeta: una línea Disallow: / añadida por error bloquea el rastreo de todo el sitio.
Comprueba además que la página tenga una canónica autorreferencial en el <head>: una etiqueta link con rel="canonical" cuyo destino sea exactamente la URL de la propia página, con HTTPS y sin parámetros.
La señal de que este paso está bien es doble: el archivo robots.txt responde con código 200 y el informe de robots.txt de Search Console (en Ajustes) no muestra errores de lectura. El fallo más común es combinar un Disallow en robots.txt con una etiqueta noindex en el HTML para sacar una página del índice: como Googlebot no puede rastrearla, nunca llega a leer el noindex, y la URL puede seguir apareciendo sin título ni descripción si recibe enlaces.
Paso 2: Generación y envío del mapa del sitio XML dinámico en Google Search Console
El sitemap XML es la lista formal de las URLs canónicas que quieres que Google conozca. Debe actualizarse solo cada vez que publicas, editas o eliminas una página; en WordPress lo generan los propios plugins de SEO, y conviene revisarlo junto con el resto de la configuración de SEO para WordPress para que no incluya adjuntos ni taxonomías vacías.
Para enviarlo, entra en Search Console, abre Sitemaps, escribe la ruta del archivo (por ejemplo, sitemap_index.xml) y pulsa Enviar. Un registro mínimo tiene este aspecto:
<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://tudominio.com/ruta-de-la-pagina/</loc>
    <lastmod>2026-10-11</lastmod>
  </url>
</urlset>
Google utiliza lastmod cuando es fiable y ignora los campos priority y changefreq, así que no merece la pena ajustarlos. El envío está bien hecho cuando el estado aparece como Correcto y el número de URLs descubiertas coincide aproximadamente con las páginas que de verdad quieres indexar. El error habitual es incluir URLs que redirigen, que devuelven 404 o que llevan noindex: el sitemap pierde fiabilidad como fuente.
Paso 3: Inspección manual de URL y solicitud de indexación selectiva en Search Console
Cuando una página importante acaba de publicarse o ha cambiado mucho, la herramienta de inspección de URLs es la forma más directa de avisar a Google.
Pega la URL completa en la barra superior de Search Console. Primero verás lo que Google sabe de ella según su índice. Después pulsa Probar URL publicada: la prueba comprueba en ese momento si la página responde, si es indexable y si sus recursos cargan. Si el resultado indica que la URL puede indexarse, pulsa Solicitar indexación.
La solicitud entra en una cola de rastreo prioritaria, pero no garantiza la indexación ni un plazo concreto. Además, Search Console limita el número de solicitudes por propiedad y día, así que pulsar el botón varias veces para la misma URL no acelera nada y consume solicitudes que podrías necesitar para otras páginas.
Ejemplo ilustrativo: un medio digital con varios redactores notaba que sus artículos tardaban en aparecer. Algunos redactores enviaban la misma URL varias veces al día y agotaban el cupo de la propiedad. El equipo acordó un protocolo sencillo: publicar, probar la URL publicada una sola vez, solicitar la indexación solo si la prueba salía limpia y enlazar el artículo desde la portada. Las noticias empezaron a aparecer con más regularidad porque el cupo quedaba libre para las piezas que de verdad lo necesitaban.
Paso 4: Indexing API e IndexNow: qué aceleran y qué no
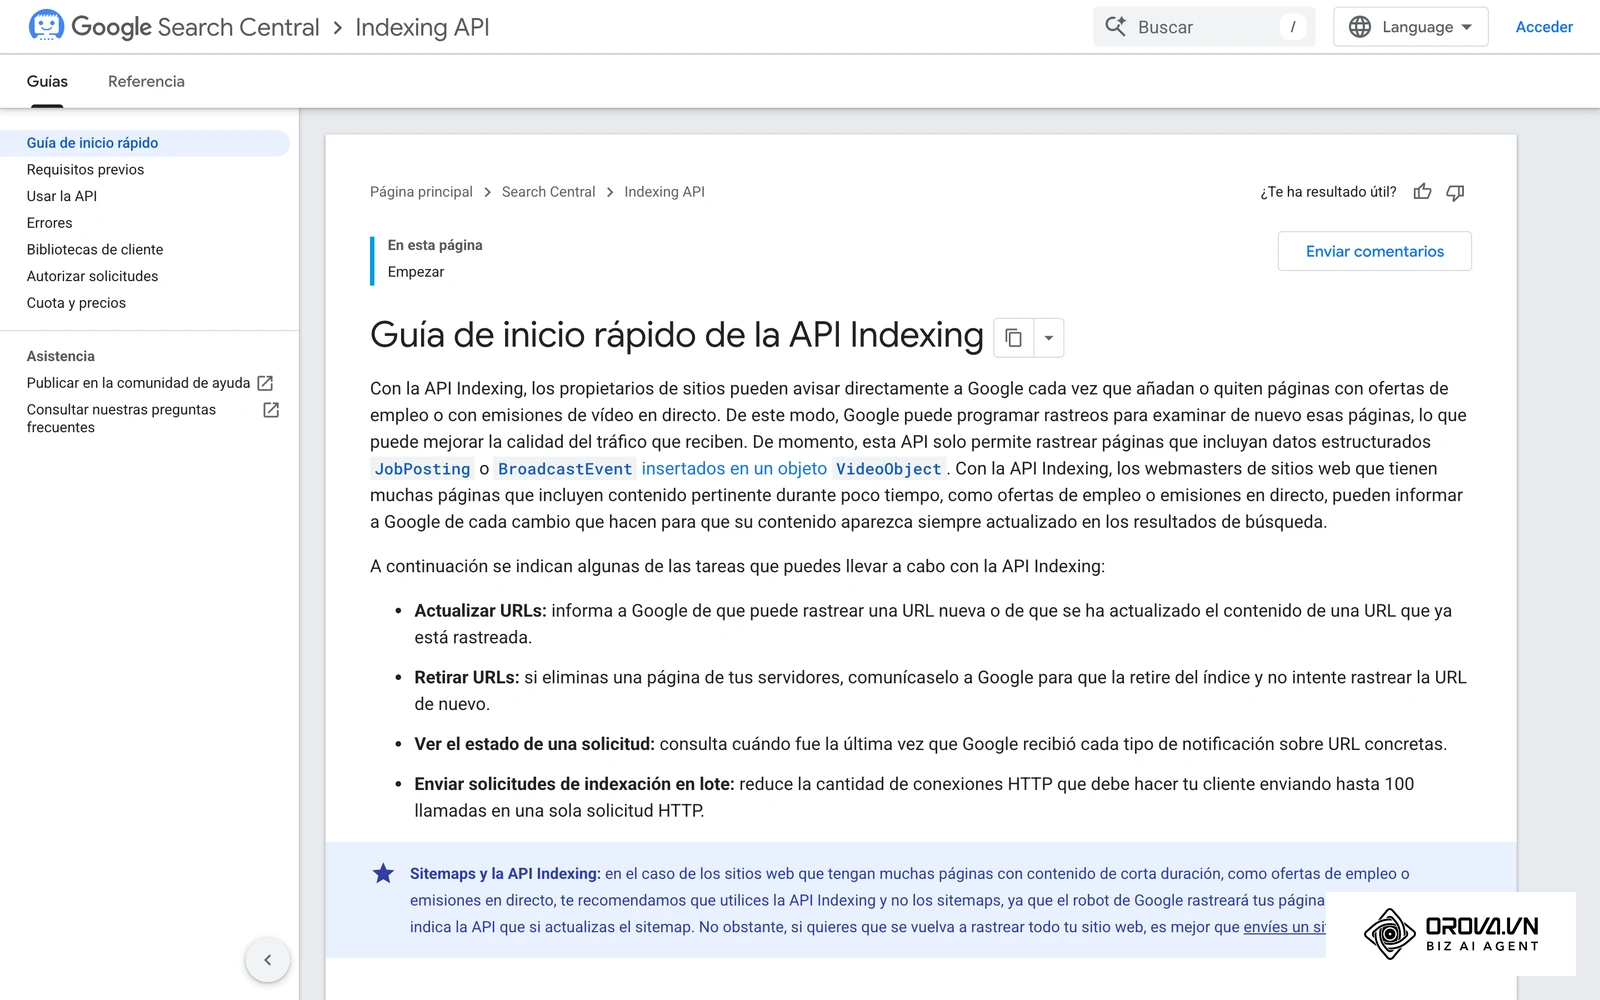
Muchas guías recomiendan la Google Indexing API para «forzar» la indexación de cualquier URL. Según la documentación oficial de Google Search Central, esta API solo admite páginas con datos estructurados JobPosting (ofertas de empleo) o BroadcastEvent incrustado en un VideoObject (emisiones en directo). Usarla para artículos, fichas de producto o páginas de servicio está fuera de sus condiciones de uso, y Google ha advertido que puede revocar el acceso a quien la utilice indebidamente. Los plugins que prometen indexar cualquier entrada a través de ella entran en ese uso no admitido.
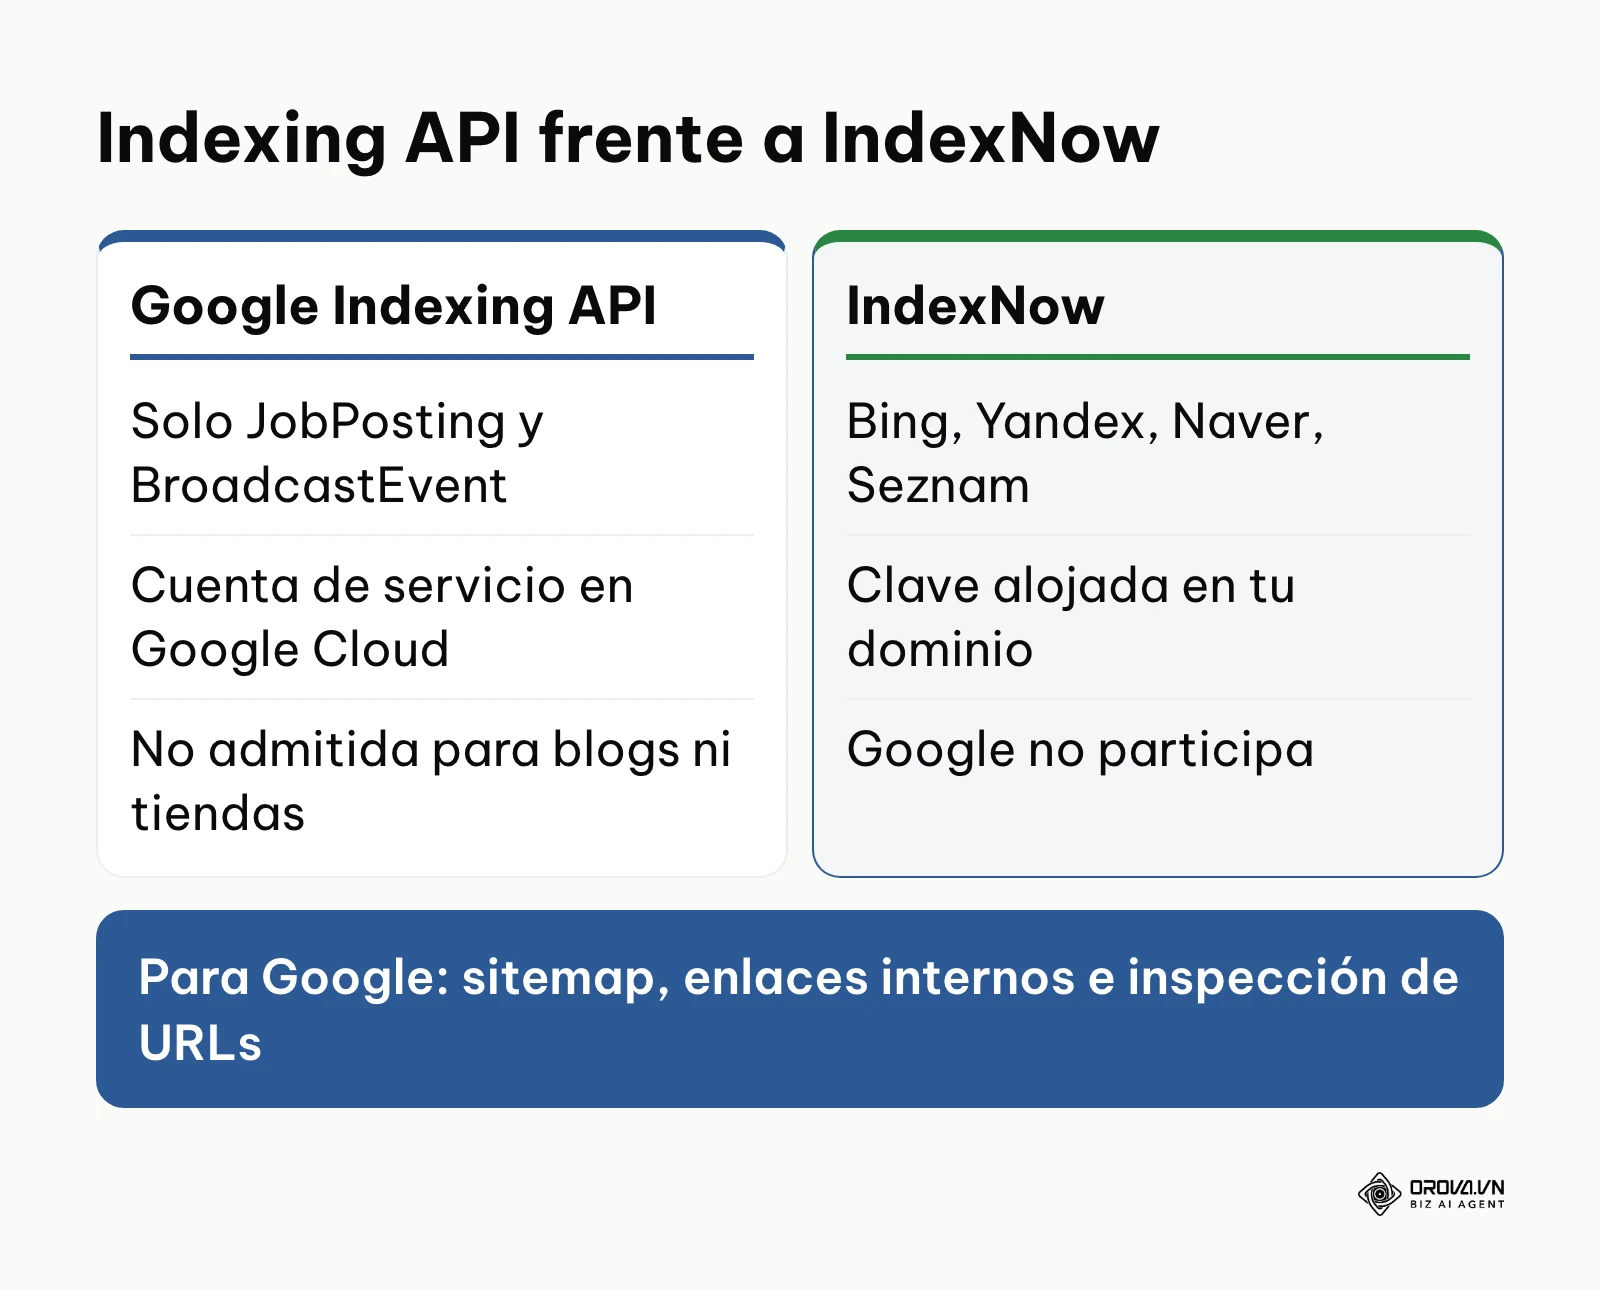
Si tu sitio publica ofertas de empleo o emisiones en directo, la integración se hace desde Google Cloud con una cuenta de servicio, que después se añade como propietaria de la propiedad en Search Console. Para el resto de páginas, las vías válidas siguen siendo el sitemap, los enlaces internos y la inspección de URLs.
IndexNow es otro protocolo distinto: permite notificar cambios a buscadores como Bing, Yandex, Naver o Seznam mediante una clave alojada en tu dominio y una simple petición HTTP:
curl "https://api.indexnow.org/indexnow?url=https://tudominio.com/nueva-pagina/&key=tu-clave"
Google no forma parte de IndexNow, de modo que este protocolo no influye en la indexación en Google. Es útil si te interesa la visibilidad en esos otros buscadores, pero no sustituye ninguno de los pasos de esta guía.
Paso 5: Optimización de la arquitectura de enlaces internos para canalizar el PageRank
Googlebot descubre buena parte de las páginas siguiendo enlaces. Una URL nueva que no recibe ningún enlace interno es una página huérfana: aunque esté en el sitemap, Google tiene pocas señales de que sea importante.
Localiza las páginas de tu sitio que más tráfico orgánico y enlaces externos reciben y añade desde ellas enlaces contextuales hacia la nueva URL, con un texto ancla que describa su contenido. Usa enlaces HTML estándar (etiqueta <a> con atributo href); los botones que navegan con eventos JavaScript del tipo onclick="window.location=..." no son enlaces rastreables.
Sabrás que funciona cuando la inspección de URLs muestre páginas de referencia internas en el apartado de descubrimiento. El fallo típico es confiar solo en el pie de página o en barras laterales genéricas: los enlaces dentro del cuerpo del texto transmiten mucho mejor el contexto.
Paso 6: Diagnóstico de renderizado en sitios con JavaScript y Single Page Applications
Los sitios construidos con React, Vue o Angular añaden un reto. Google procesa JavaScript en tres fases, rastreo, renderizado e indexación, y según sus directrices de SEO para JavaScript el renderizado puede quedar en cola hasta que haya recursos disponibles. Si el HTML inicial solo contiene un contenedor vacío como <div id="root"></div>, el contenido real depende de esa fase posterior.
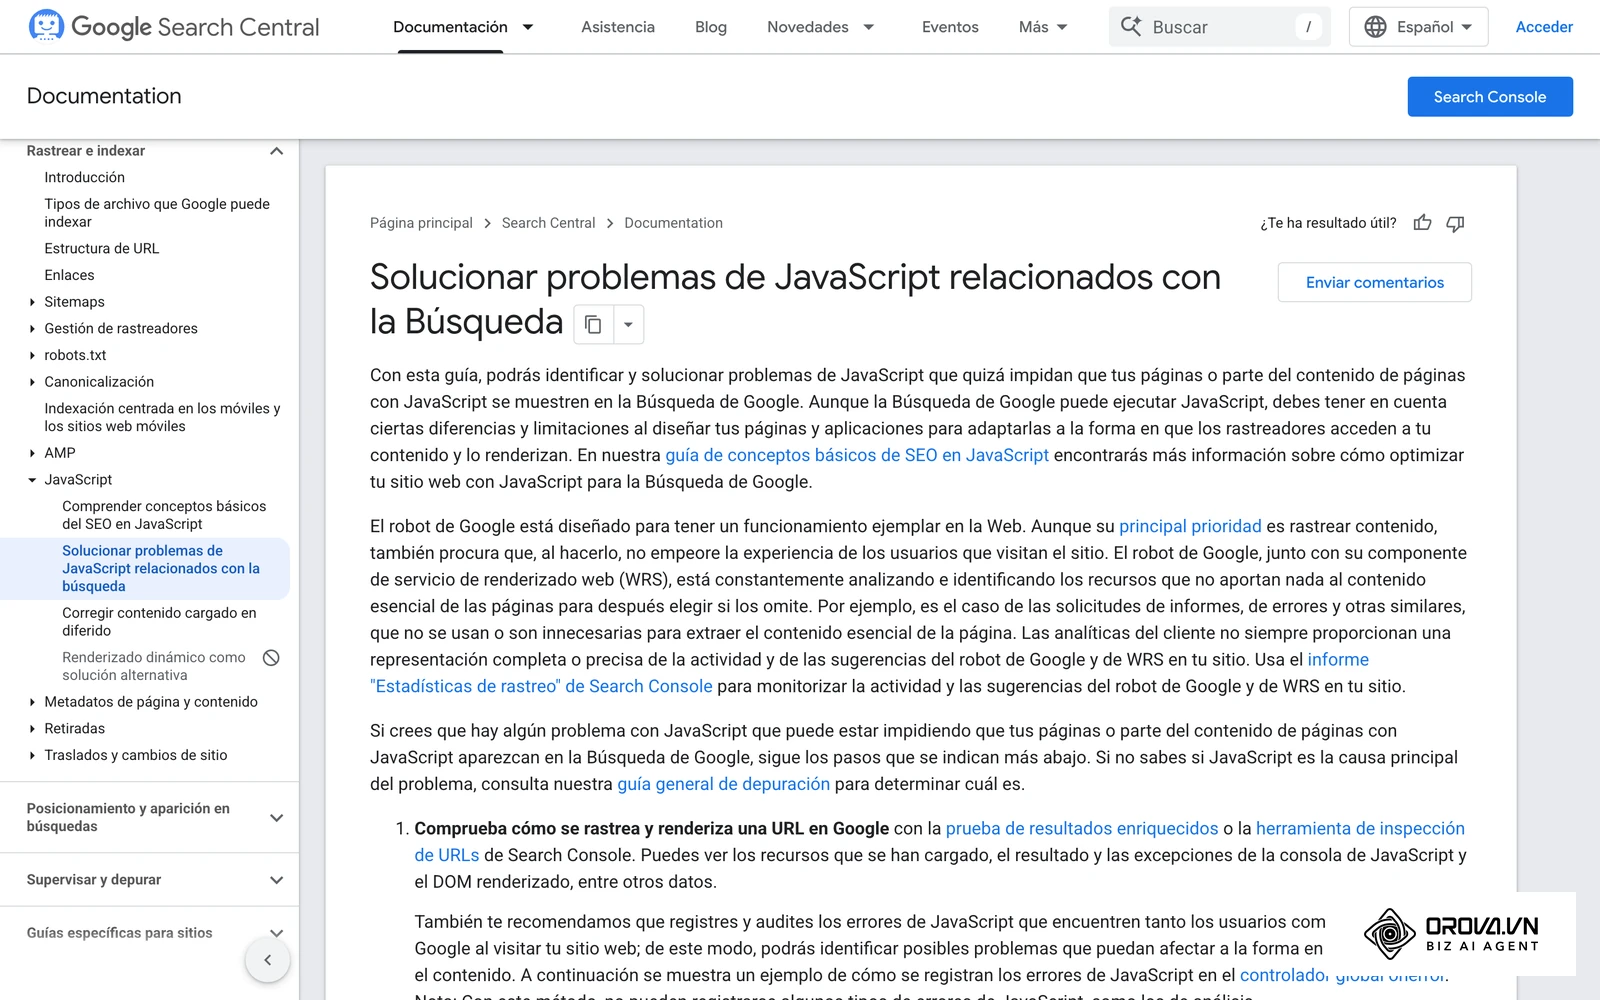
Para diagnosticarlo:
- Inspecciona la URL en Search Console y pulsa Probar URL publicada.
- Abre Ver página probada y revisa las pestañas HTML y Captura de pantalla.
- Compara ese HTML renderizado con el código fuente que entrega tu servidor.
Si la captura aparece en blanco o el HTML no contiene los textos y enlaces principales, Googlebot no está ejecutando bien los scripts. Las causas típicas son archivos .js bloqueados en robots.txt, tiempos de carga excesivos o errores de hidratación.
La solución de fondo es entregar el contenido en el HTML desde la primera respuesta, ya sea con renderizado en el servidor (SSR) mediante Next.js o Nuxt o con generación estática (SSG). Esta decisión conviene tomarla en la fase de diseño web y posicionamiento, porque corregirla después suele implicar rehacer parte del sitio.
Paso 7: Auditoría y poda de contenidos para superar el umbral de calidad del dominio
Google decide con qué frecuencia rastrea un sitio y cuántas de sus páginas indexa también en función de la calidad del conjunto. Un dominio lleno de artículos obsoletos, categorías vacías, textos generados sin revisión o traducciones pobres hace que muchas URLs nuevas terminen en «Rastreada: actualmente sin indexar».
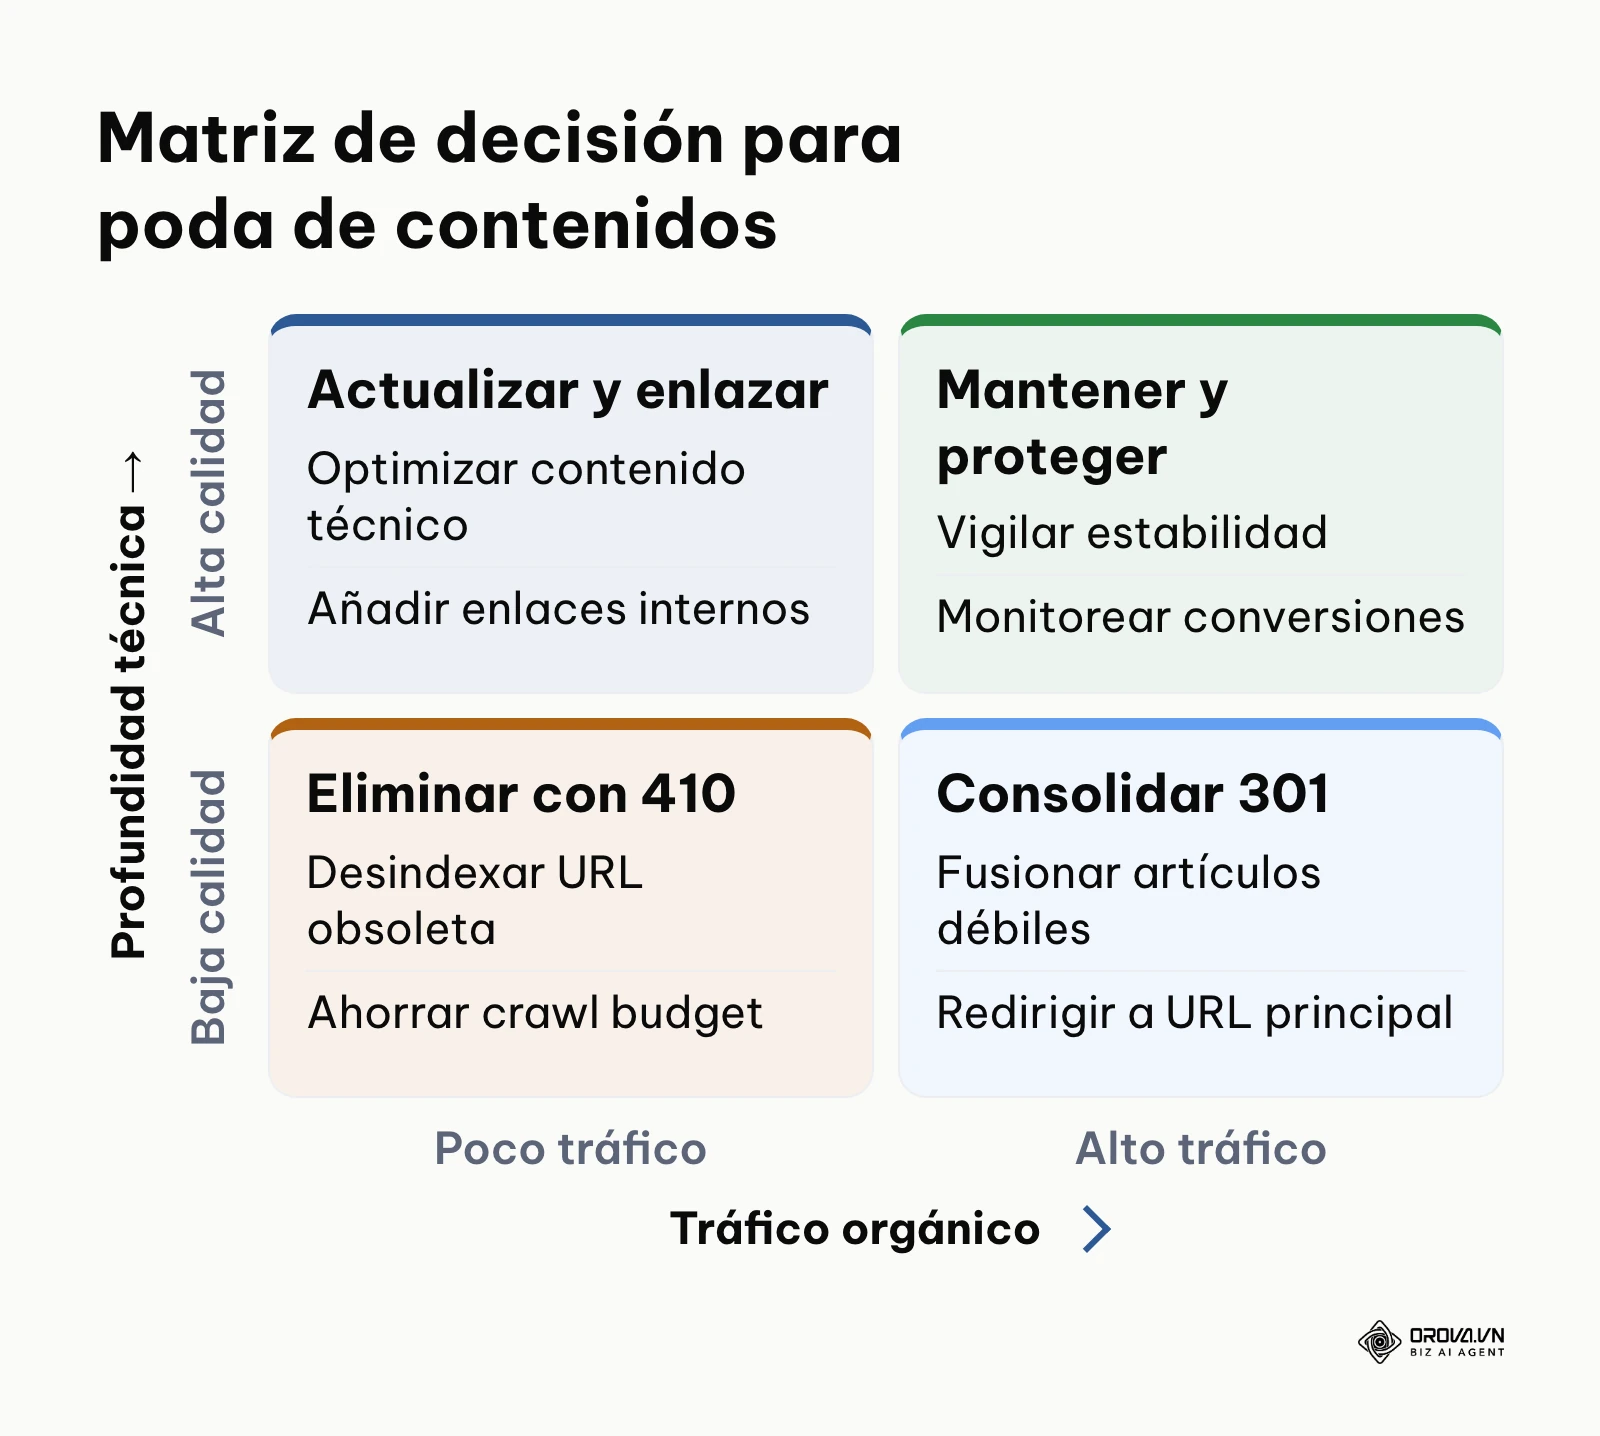
La poda de contenidos consiste en revisar periódicamente el inventario de URLs y sanearlo en cuatro etapas:
- Cruce de datos: exporta las URLs del informe «Páginas» y crúzalas con el tráfico orgánico de los últimos doce meses.
- Detección de páginas zombi: localiza las que no reciben visitas orgánicas, no tienen enlaces entrantes y aportan contenido genérico.
- Decisión por página:
- Si el tema sigue siendo relevante pero está desactualizado, reescríbelo y amplíalo.
- Si hay varios artículos que responden a la misma búsqueda, fusiónalos en una sola guía y redirige los secundarios con un 301; es la forma de resolver la canibalización SEO, que además confunde a Google sobre qué URL indexar.
- Si la página ya no tiene vigencia (ofertas vencidas, eventos pasados), elimínala y devuelve un código 410.
- Actualización del sitemap: retira las URLs eliminadas o redirigidas.
El código 410 indica que el recurso se ha eliminado de forma deliberada, y Google lo trata como una señal más clara que un 404 genérico. Para auditar cada URL candidata, esta lista de comprobación cubre los puntos que más bloquean la indexación:
| Punto de control | Estado esperado | Acción si falla |
|---|---|---|
| robots.txt | CSS, JS e imágenes accesibles | Retirar los Disallow que impiden el renderizado |
| Meta robots / X-Robots-Tag | Sin noindex en producción | Corregir la plantilla o la configuración del servidor |
| Canónica | Coincide con la URL solicitada | Corregir canónicas cruzadas o en bucle |
| Respuesta HTTP | 200 sin cadenas de redirección | Apuntar los enlaces al destino final |
| Sitemap | URL presente con lastmod correcto | Regenerar y reenviar el sitemap |
| Enlaces internos | Varios enlaces contextuales entrantes | Enlazar desde páginas con tráfico |
| Contenido renderizado | Texto y enlaces visibles en la inspección | Pasar a SSR o HTML estático |
| Parámetros de URL | Variantes ?utm o ?orden con canónica limpia | Forzar la canónica de la versión principal |
Ejemplo ilustrativo: un portal educativo con miles de fichas de cursos veía que las nuevas tardaban semanas en indexarse. Al cruzar datos, descubrió que la mayoría de su inventario eran temarios caducados sin visitas desde hacía años. Devolvió un 410 en los cursos sin vigencia y fusionó con redirecciones 301 los que se solapaban. En las semanas siguientes, el rastreo se concentró en el contenido vigente y las fichas nuevas empezaron a indexarse mucho antes.
Descubre Orova.vn – una plataforma Biz AI Agent con la solución OROVA SEO completa, destinada a todos los sitios web. El sistema acompaña la optimización para motores de búsqueda de A a Z con las siguientes funciones: investigación de palabras clave, redacción de nuevos artículos optimizados para SEO, optimización de los contenidos existentes, seguimiento de posiciones, además del análisis de la competencia y el análisis técnico en profundidad. Regístrate hoy mismo para descubrir OROVA SEO de forma totalmente gratuita (oferta válida hasta el 7 de julio de 2027).
Factores determinantes y matriz comparativa de métodos de indexación
La rapidez con la que Google indexa una página depende de varios factores que se combinan:
- Capacidad de rastreo: cuántas páginas puede y quiere explorar Googlebot en tu dominio. Depende de la velocidad del servidor y del interés que despierta el contenido.
- Popularidad del sitio: los dominios con enlaces externos sólidos y menciones frecuentes suelen rastrearse con más frecuencia que uno recién registrado.
- Frecuencia de actualización: los sitios que publican y mejoran contenido con regularidad acostumbran a Googlebot a volver más a menudo.
- Salud del servidor: caídas o respuestas lentas hacen que Google reduzca el ritmo de rastreo para no sobrecargarlo.
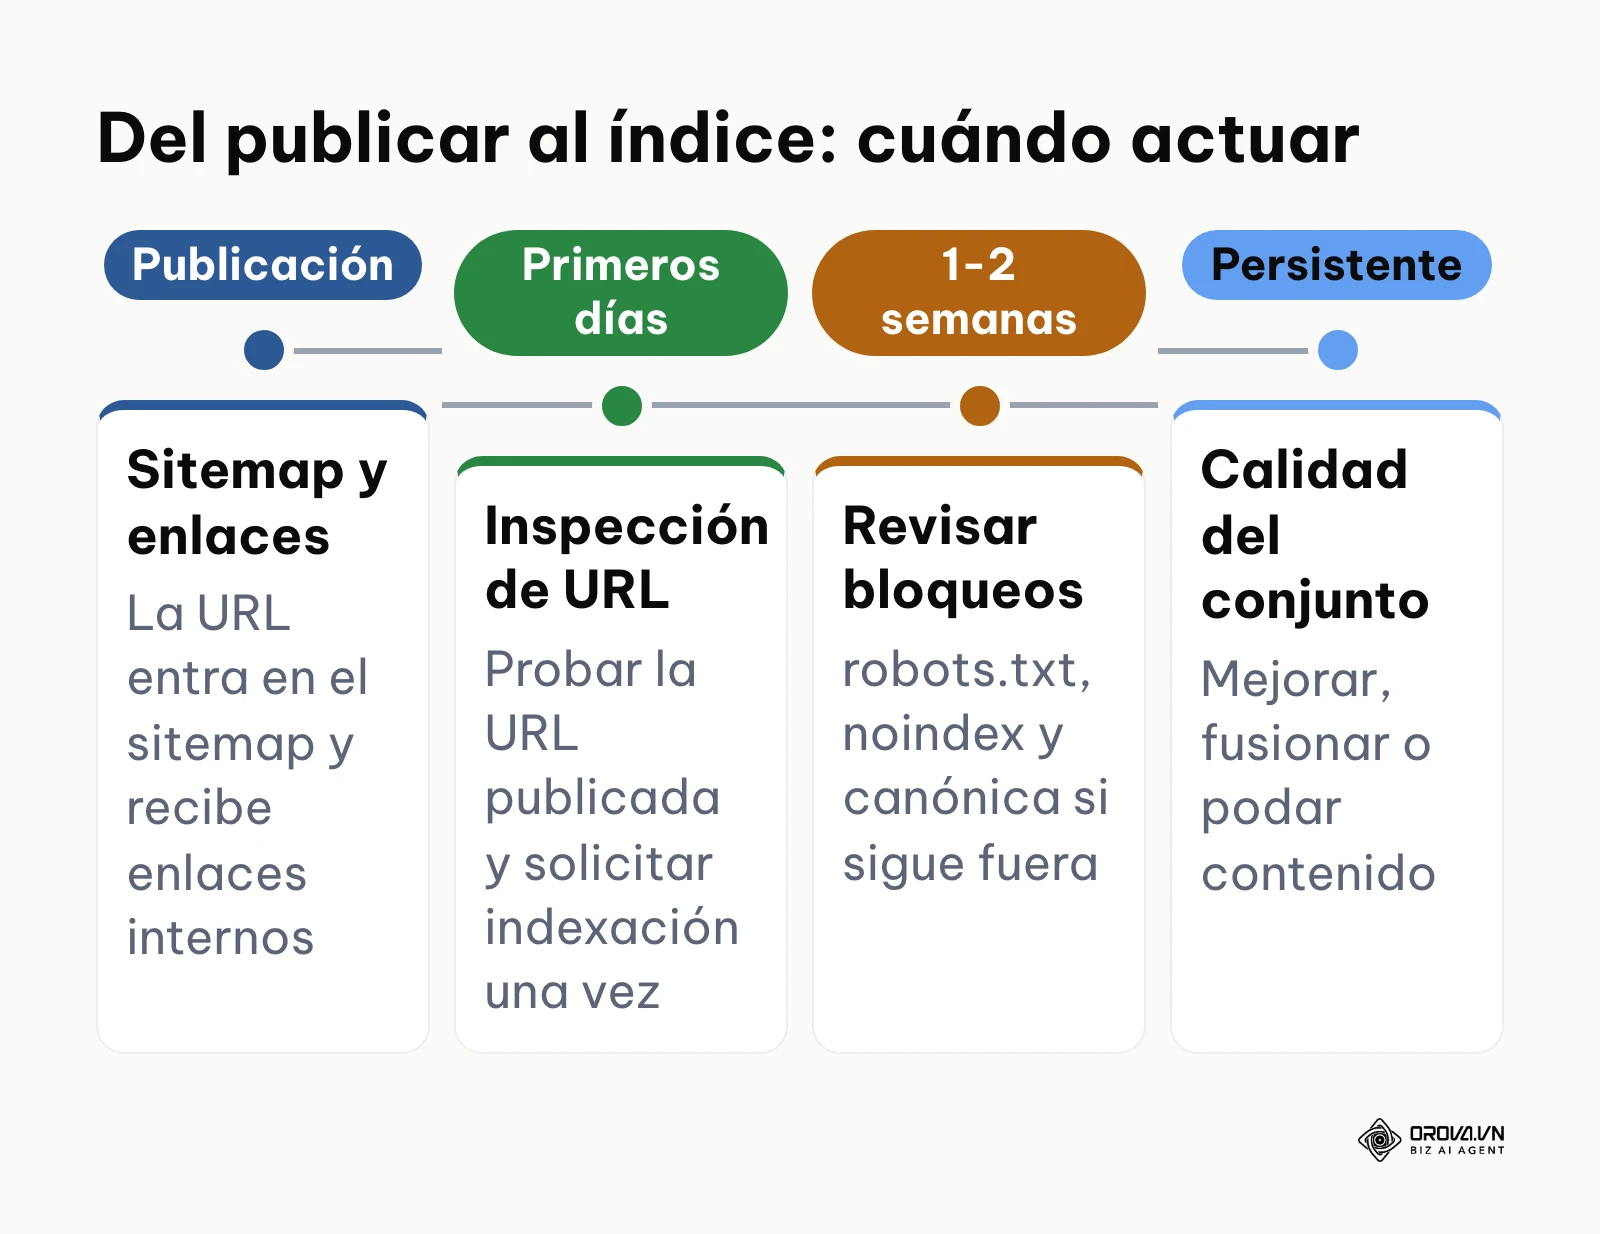
Por eso no existe un plazo fijo. En un sitio sano con publicaciones regulares, una página nueva bien enlazada suele indexarse en pocos días; en un dominio nuevo o con muchas URLs de poco valor puede tardar semanas. Lo razonable es publicar, comprobar a los pocos días con la inspección de URLs y, si al cabo de una o dos semanas sigue fuera, revisar los bloqueos y reforzar los enlaces internos antes de volver a solicitar nada.
| Método | Cuándo conviene | Limitaciones |
|---|---|---|
| Solicitud en Search Console | Páginas sueltas nuevas o con cambios importantes | Cupo diario por propiedad; manual y lento para catálogos grandes |
| Sitemap XML | Cualquier sitio, como base permanente | No da inmediatez; Google decide cuándo rastrear |
| Enlaces internos | Siempre, sobre todo para páginas nuevas | Exige planificar la arquitectura y mantener páginas antiguas |
| Google Indexing API | Solo ofertas de empleo y emisiones en directo | No admitida para otros tipos de página |
| IndexNow | Visibilidad en Bing, Yandex y otros participantes | No afecta a Google |
| SSR / SSG | Sitios en React, Vue o Angular | Despliegue más complejo y más carga en el servidor |
El método adecuado depende del tamaño del sitio y de la urgencia de cada tipo de contenido, pero en todos los casos el sitemap y los enlaces internos son la base.
Medición del rendimiento de indexación y métricas de salud en Search Console
Aplicar los cambios no basta: hay que comprobar qué parte del sitio está realmente indexada y detectar problemas antes de que afecten al tráfico. Para saber si una página concreta está indexada hay tres métodos:
- Búsqueda con site:: escribe site:tudominio.com/ruta-exacta/ en Google. Es una comprobación rápida, pero no exhaustiva.
- Inspección de URLs: es el método fiable para una URL concreta. Si aparece La URL está en Google, está en el índice.
- Informe «Páginas»: en Search Console, dentro de Indexación, el informe «Páginas» (que sustituyó al antiguo informe de Cobertura) clasifica todas las URLs conocidas en indexadas y no indexadas, con el motivo de cada exclusión.
Estar indexada no equivale a recibir tráfico. Para ver si las páginas indexadas empiezan a generar impresiones y en qué consultas, revisa la posición de tu web en Google en el informe de Rendimiento.
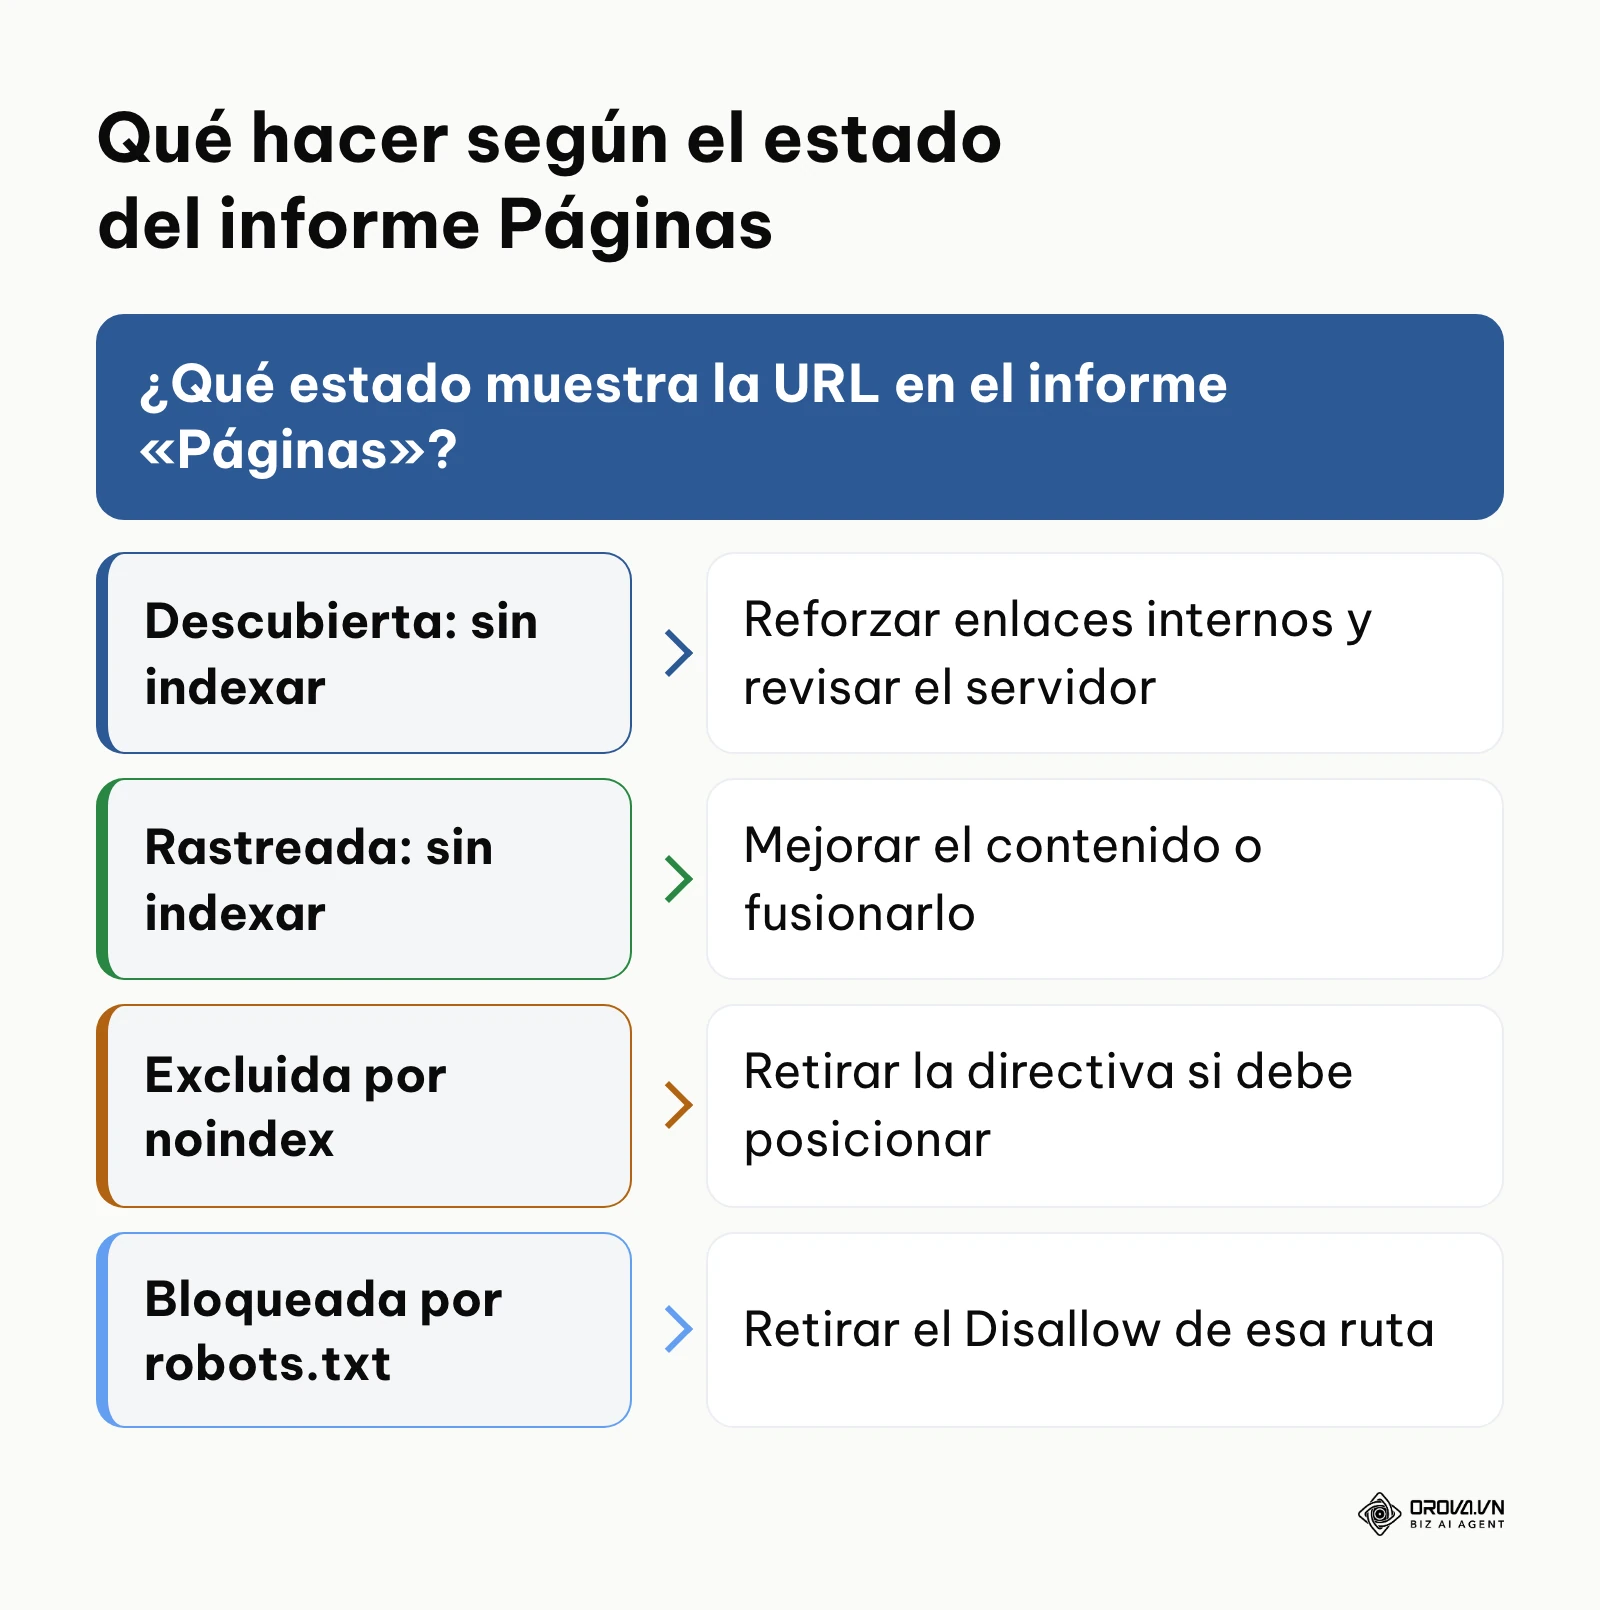
Los estados del informe «Páginas» que más conviene vigilar son estos:
| Estado en el informe «Páginas» | Qué significa | Primera acción |
|---|---|---|
| Descubierta: actualmente sin indexar | Google conoce la URL pero aún no la ha rastreado | Reforzar enlaces internos y revisar la salud del servidor |
| Rastreada: actualmente sin indexar | Google la rastreó y decidió no indexarla por ahora | Mejorar el contenido o fusionarlo con una página más fuerte |
| Excluida por la etiqueta «noindex» | La página pide no ser indexada | Retirar la directiva si la página debe posicionar |
| Página con redirección | La URL redirige a otra | Sacarla del sitemap y enlazar al destino final |
| No se ha encontrado (404) | La URL no existe | Restaurar, redirigir o eliminar los enlaces que apuntan a ella |
| Duplicada: el usuario no ha indicado ninguna versión canónica | Google ve varias versiones y no hay canónica declarada | Añadir la canónica en la versión principal |
| Bloqueada por robots.txt | robots.txt impide el rastreo | Retirar el Disallow si la página debe indexarse |
Revisar estos estados cada semana permite ver tendencias: si el número de páginas en «Rastreada: actualmente sin indexar» crece de forma sostenida, el problema es de calidad del conjunto y no se resolverá solicitando indexaciones una a una.
Con OROVA.VN y el módulo OROVA SEO, pones fin definitivamente a las jornadas agotadoras de trabajo manual. En lugar de batallar durante horas para redactar artículos y elaborar informes, todo el proceso queda ahora optimizado y completado en tan solo 5 minutos.
Errores críticos que bloquean la indexación y cómo corregirlos
Cuando una página no se indexa, la causa rara vez es un capricho del algoritmo. Casi siempre hay una configuración que le dice a Google que la descarte o que no la priorice. Estos son los siete errores más frecuentes.
Error 1: Directiva noindex olvidada en la etiqueta meta o cabecera HTTP
Durante el desarrollo es habitual añadir <meta name="robots" content="noindex, nofollow"> para que el sitio en construcción no aparezca en Google. Al pasar a producción, la directiva se queda olvidada.
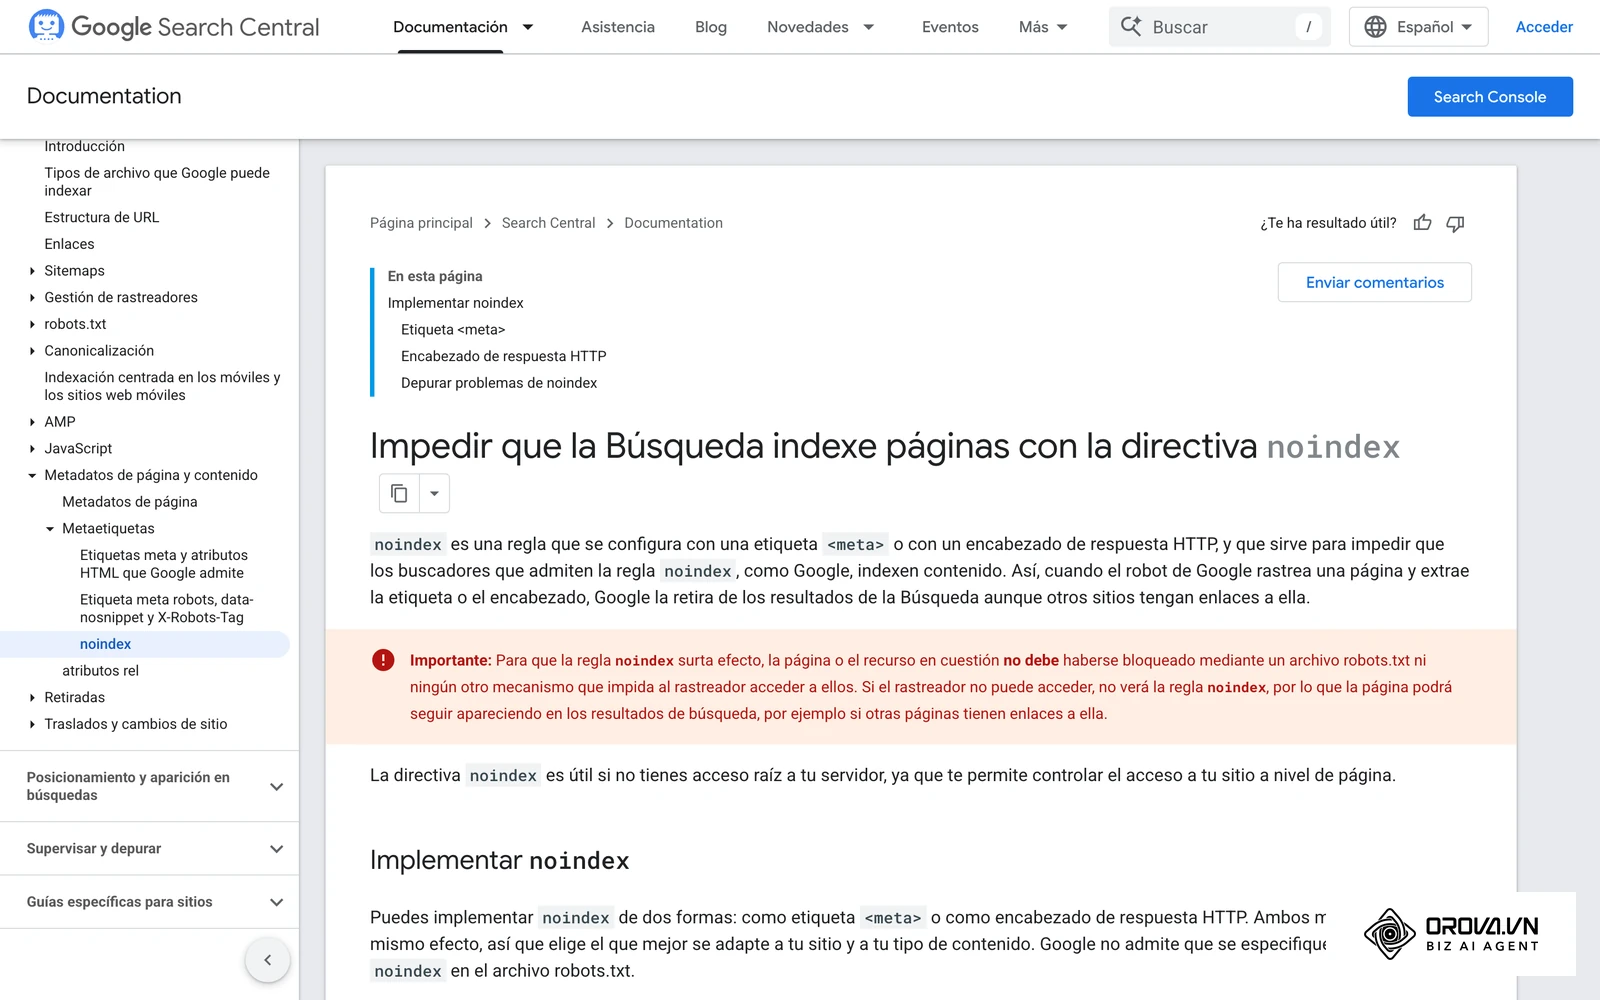
- Consecuencia: Google respeta la orden y deja la página fuera del índice.
- Cómo corregirlo: abre el código fuente (Ctrl + U o Cmd + Option + U), busca noindex y corrige la plantilla. Revisa también las cabeceras HTTP en la pestaña Red de las herramientas de desarrollo para descartar un X-Robots-Tag: noindex enviado por el servidor. En WordPress, comprueba además que no esté marcada la opción «Disuadir a los motores de búsqueda» en Ajustes > Lectura.
Error 2: Bloqueo de archivos CSS, JavaScript o fuentes en robots.txt
Algunas configuraciones de robots.txt bloquean carpetas como /assets/, /dist/ o /js/. La página HTML está permitida, pero Google no puede descargar lo necesario para renderizarla.
- Consecuencia: Google ve la página incompleta o vacía y puede considerarla de poco valor.
- Cómo corregirlo: retira las reglas que impiden el acceso a archivos .css, .js o fuentes necesarias para mostrar el contenido.
Error 3: Enlaces canónicos cruzados o conflictivos
Una canónica que apunta a otra URL le dice a Google que la página actual es una copia. Si esto ocurre por error en una página original, desaparece del índice.
- Consecuencia: el informe la muestra como duplicada, con Google eligiendo otra URL como canónica.
- Cómo corregirlo: cada página original debe tener una canónica autorreferencial, con HTTPS y sin parámetros de seguimiento.
Error 4: Contenido delgado, duplicado o marcado como Soft 404
Un Soft 404 se produce cuando el servidor devuelve código 200 pero la página muestra un mensaje del tipo «Producto no disponible», una categoría vacía o un par de líneas genéricas.
- Consecuencia: Google la clasifica como Soft 404 o la deja en «Rastreada: actualmente sin indexar».
- Cómo corregirlo: amplía el contenido con información original y útil; si la página ya no tiene sentido, devuelve un 404 o un 410 reales.
Error 5: Presupuesto de rastreo agotado por bucles de redirección y cadenas 301
Encadenar redirecciones, por ejemplo de http:// a https://, después a la versión con www y luego a la URL con barra final, obliga a Googlebot a hacer varias peticiones para llegar a una sola página.
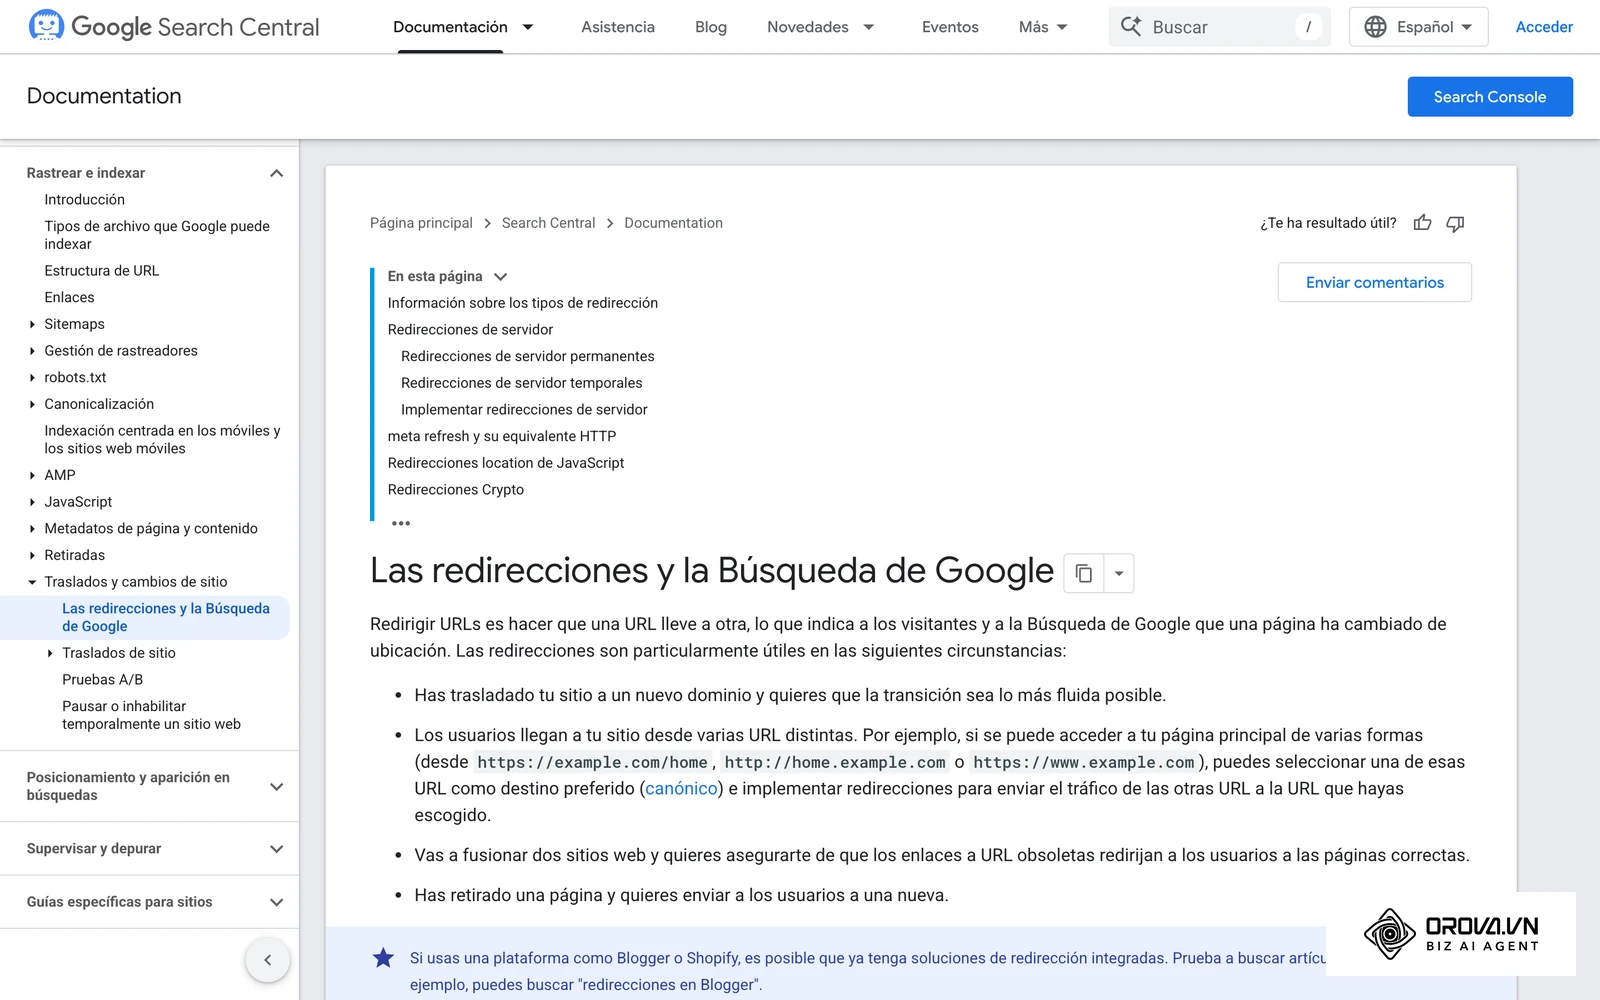
- Consecuencia: se desperdicia capacidad de rastreo y las páginas nuevas tardan más en descubrirse; los bucles impiden llegar al destino.
- Cómo corregirlo: unifica las reglas en un único salto hacia la versión canónica y actualiza los enlaces internos para que apunten directamente al destino final.
Error 6: Páginas huérfanas sin enlaces internos entrantes
Publicar una página sin enlazarla desde ninguna otra la deja aislada, aunque figure en el sitemap.
- Consecuencia: suele quedarse en «Descubierta: actualmente sin indexar» durante mucho tiempo.
- Cómo corregirlo: cada vez que publiques, añade enlaces hacia la página nueva desde dos o tres contenidos relacionados ya consolidados.
Error 7: Latencia excesiva y caídas de servidor durante el rastreo
Si el servidor tarda mucho en responder o devuelve errores 500 y 503 cuando Googlebot hace varias peticiones seguidas, Google interpreta que el sitio no aguanta más carga.
- Consecuencia: Googlebot reduce el ritmo de rastreo y las páginas pendientes esperan más.
- Cómo corregirlo: activa caché en el servidor, usa una CDN y optimiza las consultas a la base de datos. El informe de estadísticas de rastreo de Search Console muestra el tiempo medio de respuesta y los errores de servidor.
Tendencias de indexación en los próximos años: opinión del autor
En mi opinión, la indexación va a ser cada vez más selectiva. Google ya explica abiertamente que no indexa todo lo que rastrea, y creo que esa selección se endurecerá a medida que crece el volumen de páginas publicadas, muchas de ellas generadas con IA sin revisión humana. Publicar más no servirá de mucho si cada página no aporta algo propio.
También pienso que el valor de las señales técnicas limpias va a pesar más, no menos. Un sitio sin páginas zombi, con canónicas coherentes y contenido visible desde el primer HTML le pone las cosas fáciles a cualquier sistema que tenga que decidir qué guardar, y esa ventaja se acumula con el tiempo.
Por último, creo que veremos más protocolos de notificación como IndexNow, aunque no me atrevo a predecir si Google se sumará ni cuándo. Mientras tanto, mi consejo es no depender de atajos: el sitemap, los enlaces internos y un contenido que merezca estar en el índice siguen siendo lo que funciona.
Preguntas frecuentes sobre cómo indexar una página en Google
¿Por qué mi página sigue en "Descubierta: actualmente sin indexar" a pesar de pulsar "Solicitar indexación"?
Ese estado indica que Google conoce la URL, normalmente por el sitemap o por un enlace, pero ha pospuesto su rastreo. Pulsar el botón de nuevo no cambia la causa, que suele ser una prioridad baja: pocos enlaces internos hacia esa página, un servidor lento o un sitio con muchas URLs de poco valor. Añade enlaces contextuales desde páginas con tráfico y reduce las páginas zombi.
¿Puedo usar la Google Indexing API para un blog o una tienda online?
No. Google indica que la API solo admite páginas de ofertas de empleo (JobPosting) y de emisiones en directo (BroadcastEvent). Para el resto de páginas, utiliza el sitemap, los enlaces internos y la inspección de URLs de Search Console.
¿Cómo sé si Googlebot renderizó bien el JavaScript de mi página?
En la inspección de URLs, pulsa Probar URL publicada y después Ver página probada. Compara la pestaña HTML con tu código fuente y revisa la captura de pantalla. Si falta el contenido principal o la captura sale en blanco, Googlebot no pudo ejecutar los scripts.
¿Cuánto tiempo debo esperar antes de actuar si una URL no se indexa?
No hay un plazo oficial. En un sitio sano, una página bien enlazada suele indexarse en pocos días. Si tras una o dos semanas sigue fuera, revisa robots.txt, noindex y canónica, añade enlaces internos y valora si el contenido aporta algo distinto de lo que ya existe.
¿Cuándo uso canonical y cuándo noindex para páginas duplicadas?
Usa rel="canonical" cuando hay varias versiones de la misma página (parámetros de orden, variantes de color, URLs con y sin barra final) y quieres concentrar las señales en una. Usa noindex en páginas que no deben aparecer nunca en los resultados, como el carrito, las páginas de agradecimiento o los paneles privados.
¿Por dónde deberías empezar?
La primera acción depende de en qué situación está tu sitio. Elige la que más se parezca a la tuya y haz solo esa tarea en tu próxima sesión de trabajo.
Si acabas de lanzar un sitio y ninguna página aparece en Google, empieza por la base: verifica la propiedad de dominio en Search Console con el registro TXT y envía tu sitemap_index.xml. Con eso, Google ya tiene una vía oficial para conocer la estructura del sitio.
Si tu sitio ya tiene historial pero las publicaciones nuevas se quedan en «Descubierta: actualmente sin indexar», el cuello de botella son los enlaces internos. Identifica los tres artículos con más tráfico orgánico de los últimos meses y añade en el cuerpo de cada uno un enlace relevante hacia la página nueva.
Si gestionas un sitio grande y una parte importante de las URLs figura como «Rastreada: actualmente sin indexar», el problema es la calidad del conjunto. Exporta el informe «Páginas», filtra las URLs sin visitas en el último año y empieza por un primer lote: fusiona las que se solapan y devuelve un 410 en las que ya no tienen sentido. Es el paso que más cambia la forma en que Google trata el resto del sitio y, en la práctica, la respuesta más completa a cómo indexar una página en Google cuando lo básico ya está hecho.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Gestiona tu negocio con AI Agents
Orova es el Biz AI Agent que nunca para: planifica, ejecuta y optimiza el trabajo por ti.
Gana tiempo y multiplica tu productividad.