Cómo funciona el buscador de Google: guía técnica para tu indexación
Entender con exactitud cómo funciona el buscador de Google marca la diferencia entre publicar contenidos a ciegas y construir una arquitectura digital que atraiga visibilidad orgánica sostenible. En resumen, Google funciona en tres grandes fases: rastrea la web con su robot Googlebot, indexa (procesa y almacena) lo que logra entender y, ante cada consulta, clasifica las páginas indexadas para mostrar las más útiles. Muchos creadores y responsables técnicos asumen que basta con redactar artículos extensos, pulsar el botón de publicar y esperar a que las visitas lleguen de forma automática a sus páginas. Sin embargo, cuando los registros de tráfico permanecen planos o las URLs quedan atrapadas durante semanas en estados de exclusión dentro de las herramientas para webmasters, queda en evidencia que los conceptos superficiales sobre palabras clave resultan insuficientes. La web moderna exige comprender qué ocurre desde el instante en que un robot detecta un hipervínculo hasta que los modelos de inteligencia artificial generan resúmenes dinámicos en la cabecera de las páginas de resultados. En este análisis exhaustivo desglosaremos cada fase del motor de búsqueda, exploraremos los cuellos de botella en el renderizado y te proporcionaremos marcos de diagnóstico prácticos para asegurar que tu proyecto sea rastreado, interpretado y valorado por el algoritmo.
Cómo funciona el buscador de Google: principios y objetivos centrales
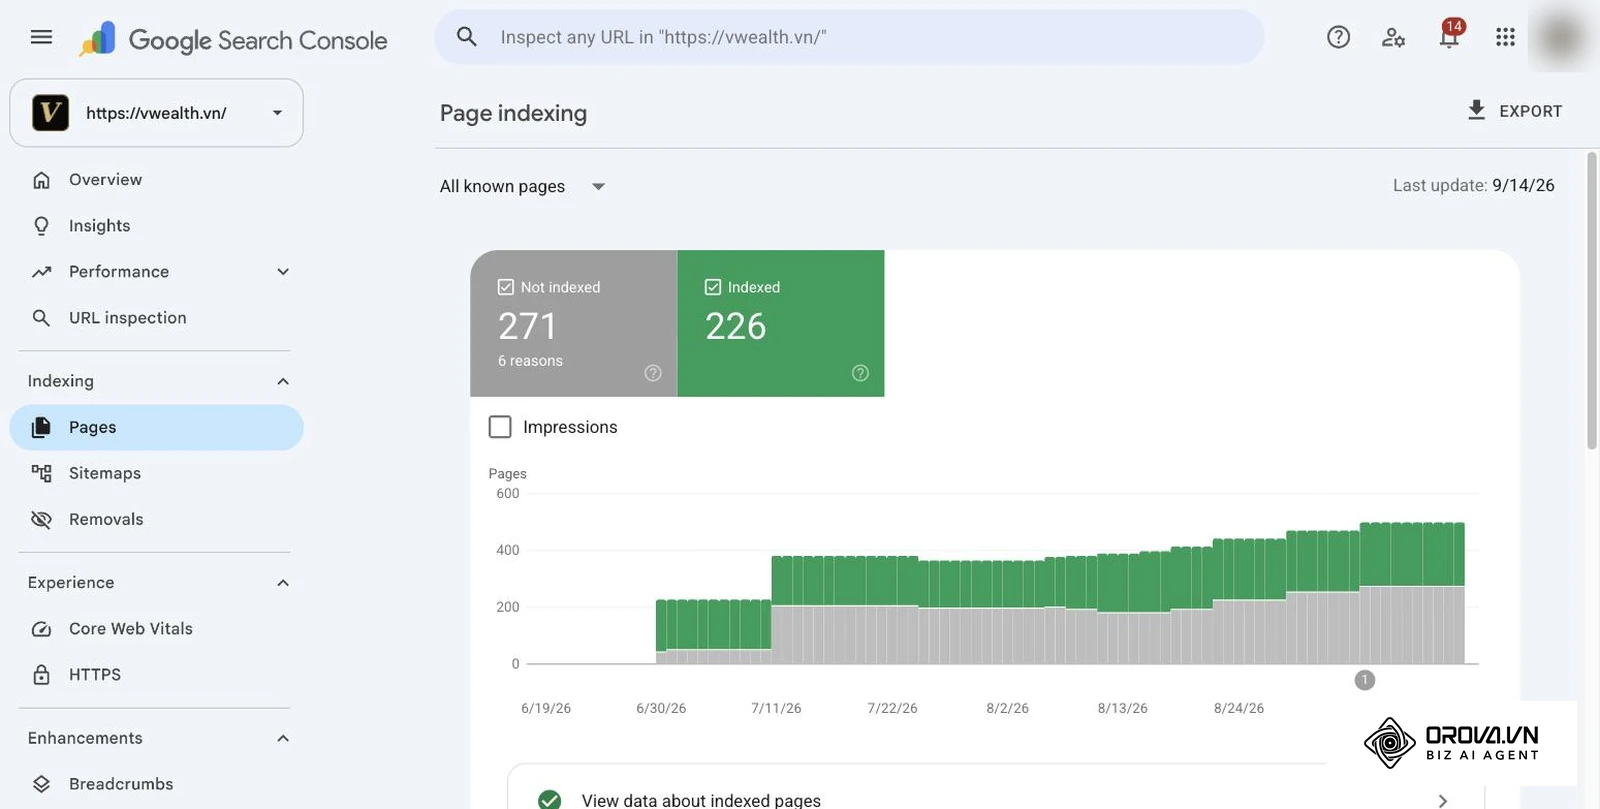
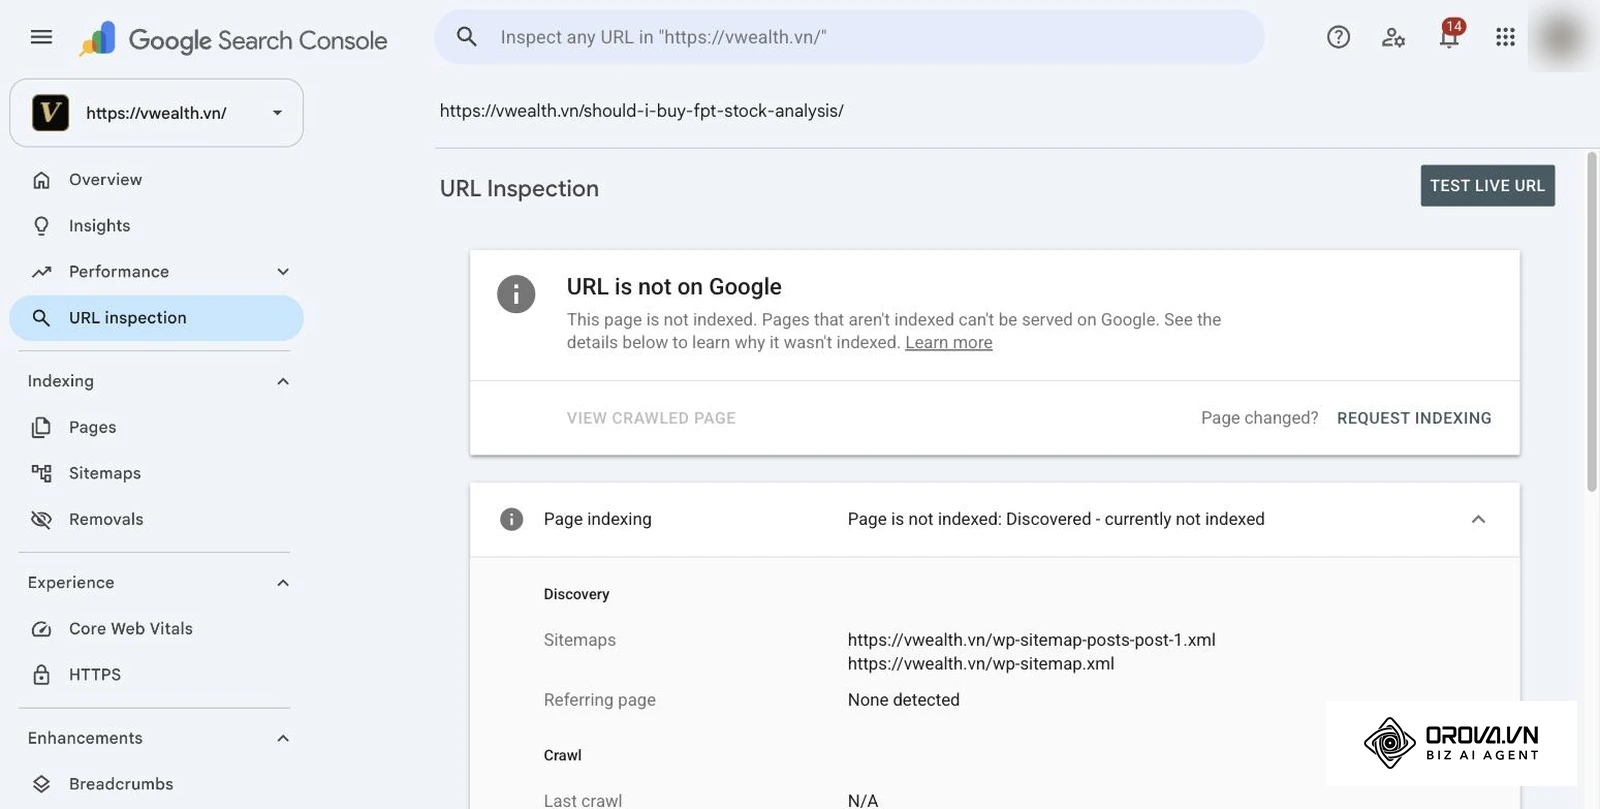
El buscador de Google es un sistema distribuido que rastrea, procesa e indexa miles de millones de páginas web para ordenar y entregar la información más relevante en milisegundos ante la consulta de un usuario. Comprender este mecanismo permite estructurar sitios técnicamente legibles y competitivos para captar tráfico cualificado de forma predecible. La captura siguiente, tomada del informe de indexación de páginas de Search Console de un sitio real (vwealth.vn), muestra cómo Google separa las URLs que ya están en su índice de las que todavía no lo están.
¿Quién debe aplicar esta optimización técnica? Todo profesional, desarrollador o responsable de negocio que dependa de la visibilidad orgánica para adquirir usuarios o clientes. Por el contrario, no debes forzar la indexación en aplicaciones privadas protegidas por contraseña, entornos de desarrollo o páginas transaccionales internas donde la exposición pública comprometa la seguridad o genere contenido duplicado innecesario.
A diferencia de una base de datos estática tradicional, el motor opera como un ecosistema dinámico de tres componentes interconectados: rastreo continuo mediante robots automáticos, procesamiento y almacenamiento estructurado de contenidos, y evaluación algorítmica en tiempo real para determinar el orden de respuesta. De acuerdo con la Guía de optimización en motores de búsqueda (SEO) para principiantes publicada por Google en 2024, el rastreo no garantiza la indexación ni la entrega preferente en los resultados de búsqueda. La infraestructura evalúa la utilidad técnica y semántica de cada documento antes de asignarle un espacio en su índice global.
Preparación técnica antes de optimizar para el buscador de Google
Antes de desplegar páginas y esperar que el buscador de Google las procese correctamente, es indispensable preparar una base técnica que permita verificar la comunicación entre tu servidor y los sistemas de rastreo. Si omites estos preparativos, no tendrás visibilidad sobre los errores de solicitud ni sabrás si tus páginas están siendo leídas por los agentes automáticos.
La siguiente tabla resume los recursos técnicos esenciales que debes configurar antes de iniciar cualquier estrategia de optimización web.
| Recurso técnico | Dónde obtenerlo | Tiempo estimado de configuración |
|---|---|---|
| Propiedad verificada en Search Console | search.google.com/search-console | 15 a 30 minutos (mediante registro DNS) |
| Mapa del sitio estructurado (sitemap.xml) | Generado por CMS o script de build (/sitemap.xml) | 10 a 20 minutos |
| Archivo de directivas robots.txt | Raíz del servidor web público (/robots.txt) | 15 minutos |
| Acceso a registros del servidor (Server Logs) | Panel de alojamiento web o CDN (Cloudflare, Nginx) | 30 a 60 minutos |
| Plataforma de analítica digital (Google Analytics 4) | analytics.google.com | 20 minutos |
Contar con estos componentes operativos garantiza que dispongas de canales de telemetría inmediatos para diagnosticar bloqueos de acceso, errores de servidor y discrepancias entre lo que publicas y lo que el motor almacena en su índice.
Las etapas técnicas de cómo funciona el buscador de Google: del rastreo a la entrega
El recorrido de una página web a través de la infraestructura de Google abarca varias fases sucesivas y dependientes entre sí. Si un fallo interrumpe cualquiera de estas etapas, el contenido simplemente no existirá para los usuarios en la página de resultados. A continuación, desglosamos las etapas de rastreo e indexacion de google paso a paso.
Paso 1: Descubrimiento de URLs y gestión de enlaces
El proceso arranca cuando el motor descubre la existencia de una nueva dirección web. Google no monitorea la red de forma omnisciente; necesita encontrar un hipervínculo que apunte hacia el recurso o recibir una notificación estructurada por parte del propietario del sitio.
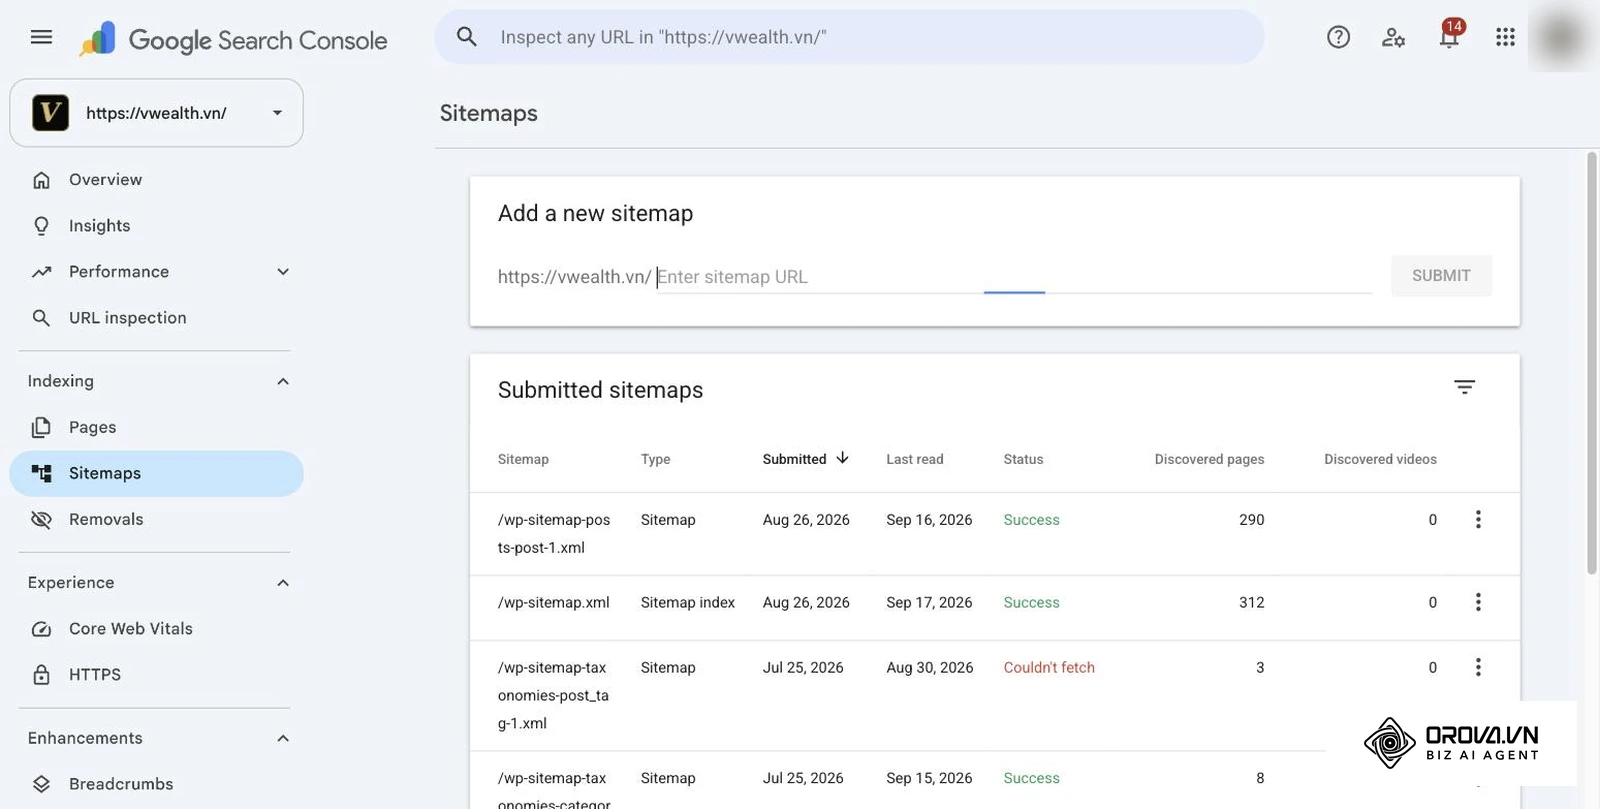
El descubrimiento técnico se apoya en tres vías principales: enlaces encontrados en documentos que el buscador ya conoce, sitemaps XML enviados activamente por los administradores y la configuración del archivo robots txt que orienta las rutas accesibles. Cada vez que Googlebot procesa un documento HTML, extrae todos los atributos href presentes en las etiquetas <a> y los añade a una cola de programación llamada cola de rastreo (crawl queue).
La captura del informe de sitemaps de Search Console de un sitio real muestra cómo Google lee cada sitemap enviado, cuántas páginas descubre en él y qué archivo no pudo obtener.
Para operar correctamente en este paso, debes asegurarte de que cada página nueva cuente con al menos dos enlaces internos contextuales procedentes de categorías o artículos afines. La señal de ejecución correcta se confirma cuando la URL aparece clasificada en el informe de páginas de Google Search Console bajo la categoría de descubrimiento. El error más común en esta etapa consiste en generar URLs huérfanas, es decir, páginas publicadas que no reciben ningún enlace interno desde la navegación del sitio ni figuran en el sitemap XML.
Paso 2: Rastreo por Googlebot y administración del presupuesto de rastreo
Una vez que una URL ingresa a la cola de procesamiento, interviene Googlebot, el agente de rastreo automatizado de Google. Este software opera primordialmente bajo dos perfiles: Googlebot Smartphone (que simula un dispositivo móvil y ejecuta la mayor parte del rastreo moderno) y Googlebot Desktop.
Googlebot realiza una solicitud HTTP GET a tu servidor para descargar el código fuente HTML base. Sin embargo, el robot no descarga páginas de manera ilimitada. Aplica un concepto denominado presupuesto de rastreo (crawl budget), compuesto por el límite de tasa de rastreo (crawl rate limit) y la demanda de rastreo (crawl demand). Según la documentación oficial de Google sobre el informe de estadísticas de rastreo, cuando el servidor devuelve errores HTTP 5xx de forma sostenida o responde con lentitud, Googlebot reduce automáticamente su ritmo de rastreo. Si tu servidor tarda en responder o arroja errores de sobrecarga, el robot reduce la frecuencia de sus visitas para no degradar la experiencia de tus usuarios reales.
La señal de ejecución correcta en esta fase es un código de estado HTTP 200 devuelto de forma limpia con un tiempo de descarga bajo y estable. El fallo habitual radica en consumir el presupuesto en miles de páginas con parámetros de filtros vacíos, cadenas de redirección 301 innecesarias o enlaces rotos con código 404.
Paso 3: Renderizado web y procesamiento de JavaScript en dos fases
Descargar el HTML inicial no equivale a comprender la página completa, especialmente en la web contemporánea construida con marcos de trabajo como React, Angular o Vue. Aquí entra en juego el Web Rendering Service (WRS), un componente que ejecuta el código cliente mediante una instancia sin interfaz gráfica de Chromium.
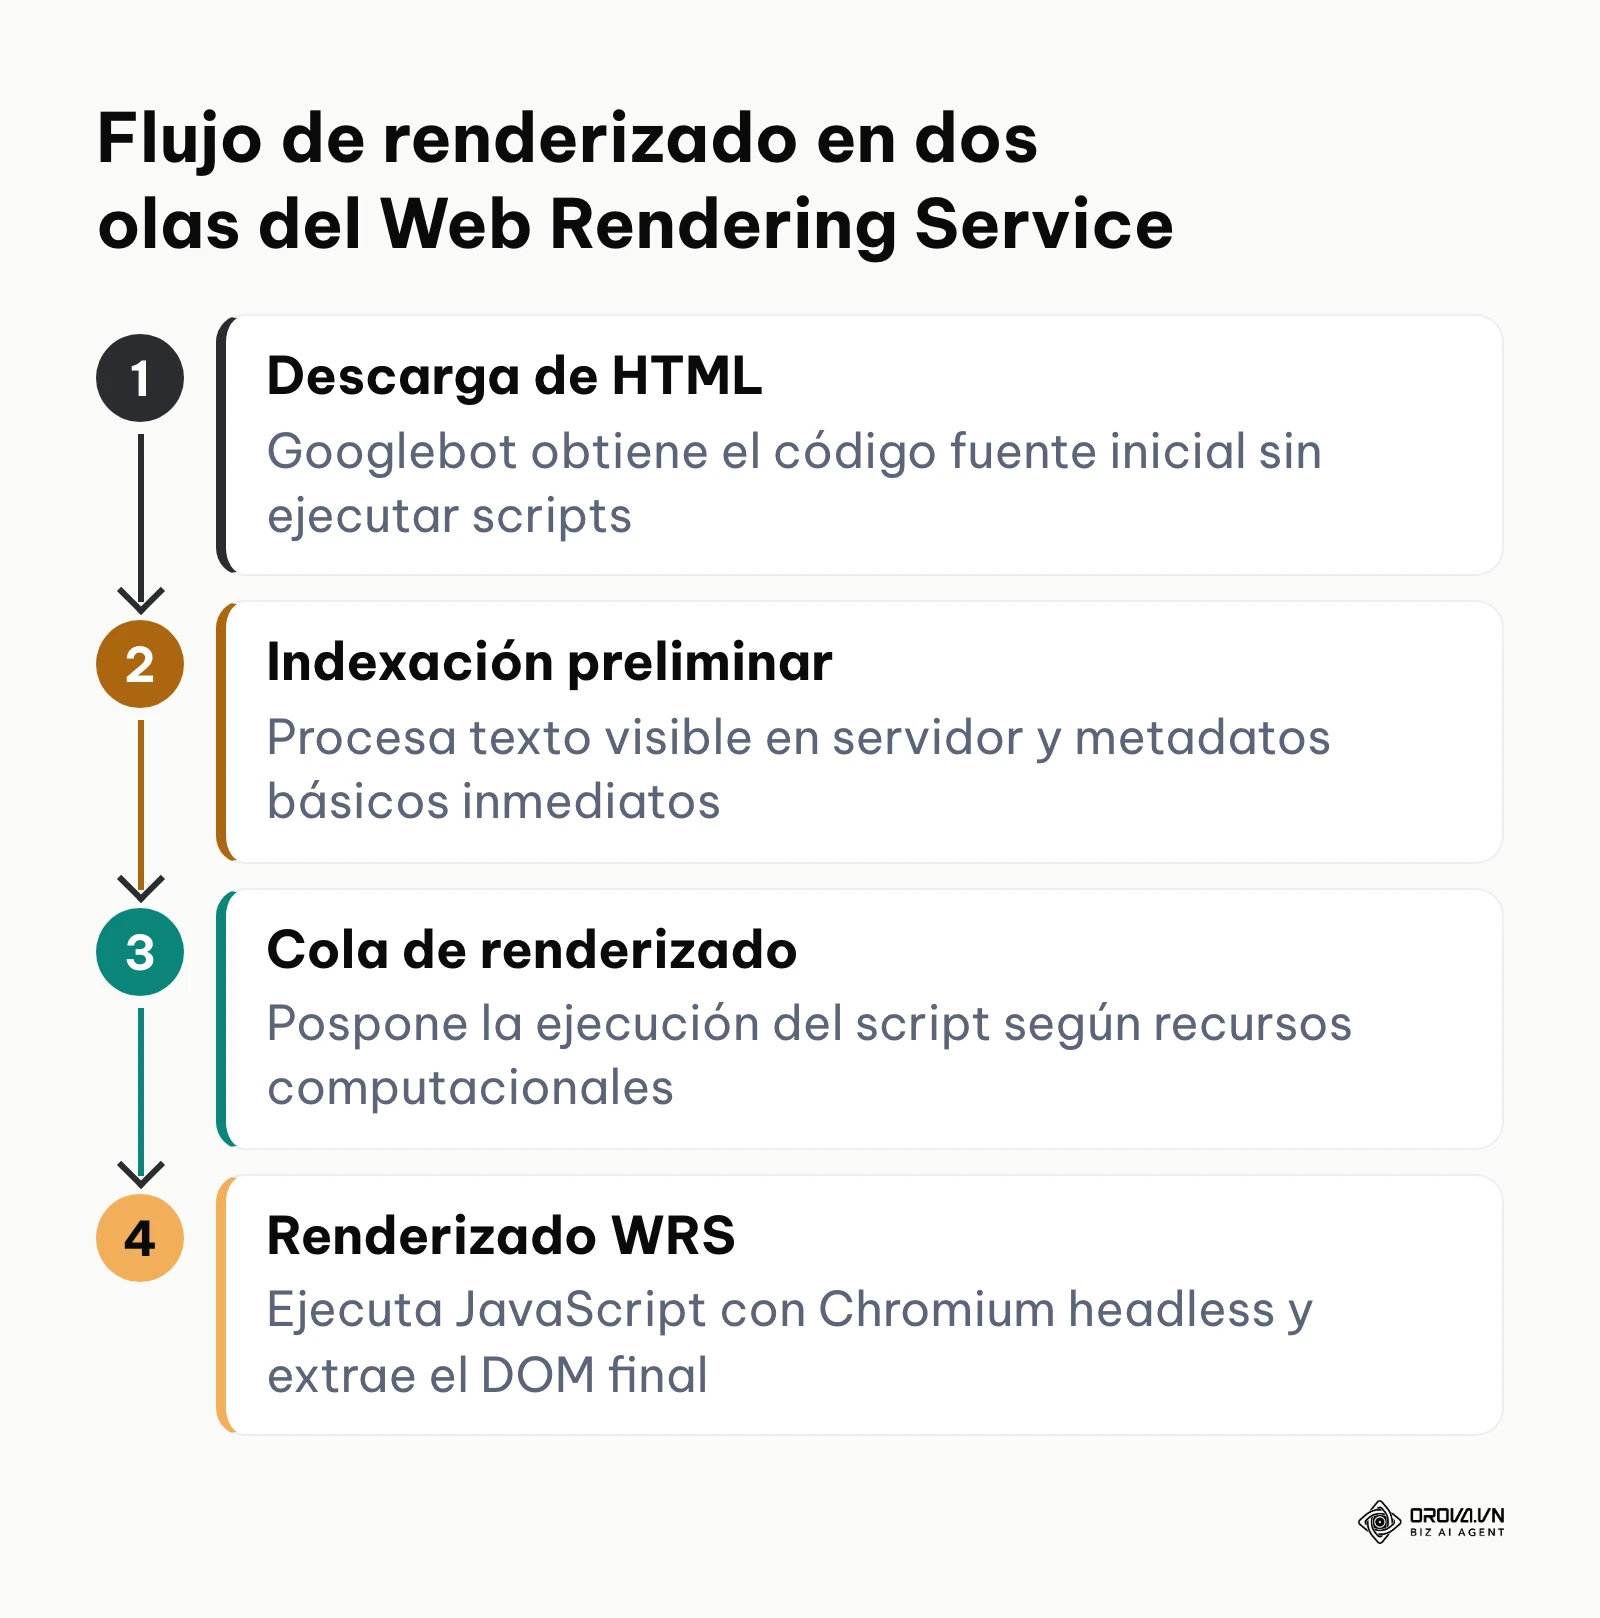
Este renderizado no ocurre de forma inmediata tras la descarga; funciona en un esquema de dos olas (two-wave indexing). En la primera ola, el motor analiza el HTML estático devuelto por el servidor y extrae textos e hipervínculos inmediatos. Si la página requiere ejecutar JavaScript para mostrar su contenido principal o sus enlaces, la URL entra en una cola secundaria de renderizado. Esta espera puede ser breve o prolongarse, dependiendo de la disponibilidad de recursos de cómputo de Google.
El esquema de esta sección resume este flujo de renderizado en dos fases ejecutado por el Web Rendering Service.
La señal de que este paso opera sin fricciones es que el texto principal, las imágenes y las etiquetas de encabezado aparezcan visibles tanto en la vista de código fuente como en la prueba de URL en vivo de Search Console. El error frecuente consiste en bloquear recursos críticos de JavaScript o CSS en el archivo robots.txt, lo que impide que el motor renderice el árbol DOM completo y provoca que la página sea percibida como un documento vacío.
Ejemplo ilustrativo: Un sitio de comercio electrónico con 15.000 productos gestionado por un equipo de dos desarrolladores frontend y un especialista SEO migró su catálogo a una arquitectura basada en React renderizada enteramente en el cliente (CSR), configuró el sitemap XML y solicitó la inspección manual de URLs principales. Googlebot descargaba el HTML inicial de cada producto, pero como el paquete de scripts tardaba en ejecutarse en la cola de renderizado, las fichas quedaban catalogadas como 'Rastreada: actualmente sin indexar' sin extraer las descripciones ni los precios. Para solucionarlo, implementaron renderizado en el servidor (SSR) mediante Next.js, asegurando que el HTML entregado al primer contacto del robot incluyera las descripciones completas, las etiquetas canónicas y los datos estructurados. Tras el despliegue, las URLs se reflejaron como 'Indexadas' en el informe de cobertura y el texto completo apareció sin demoras en la inspección de código renderizado.
Paso 4: Indexación semántica y almacenamiento en el índice Caffeine
Cuando el contenido ha sido renderizado y transformado en un Document Object Model (DOM) estable, el sistema pasa a la indexación propiamente dicha, alojada en el índice distribuido denominado Caffeine. En este punto se analiza cómo rastrea e indexa google una pagina web para convertir texto no estructurado en entradas computables.
Durante la indexación, Google analiza el texto, identifica entidades semánticas mediante procesamiento de lenguaje natural, procesa las etiquetas de metadatos, interpreta los datos estructurados en formato JSON-LD y descarta contenido duplicado o repetitivo (boilerplate). Además, el sistema selecciona una URL canónica: si detecta que la misma página es accesible con y sin barra final, o mediante variantes HTTP y HTTPS, elige una sola versión representativa y descarta las demás para el índice público. Para profundizar en cómo forzar la inclusión de contenidos complejos, consulta nuestra guía sobre como indexar una pagina en Google.
La señal inequívoca de que la indexación se ha completado es que la URL arroje el estado 'La URL está en Google' en la herramienta de inspección oficial. El fallo recurrente consiste en incluir directivas contradictorias, como apuntar una etiqueta canonical hacia una página que contiene una directiva noindex.
Paso 5: Clasificación algorítmica y evaluación de señales de calidad
Estar indexado significa que tu documento existe en la biblioteca de Google, pero no implica que aparezca en las primeras posiciones. La clasificación (ranking) es el proceso mediante el cual algoritmos complejos determinan qué páginas responden con mayor precisión a la consulta que un usuario escribe en el cajetín de búsqueda.
En esta fase intervienen los factores de posicionamiento del buscador de google más determinantes. El sistema evalúa el PageRank (fuerza y relevancia del perfil de enlaces entrantes e internos), modelos de aprendizaje profundo como RankBrain (que interpreta la intención detrás de consultas ambiguas) y sistemas lingüísticos como BERT y MUM (que analizan las relaciones contextuales entre palabras y conceptos). Asimismo, los algoritmos valoran la experiencia de usuario a través de las Core Web Vitals y verifican las señales de experiencia, conocimiento especializado, autoridad y confianza (E-E-A-T). Para auditar tu visibilidad frente a la competencia, puedes verificar la posición de mi web en Google con regularidad.
La señal de una clasificación saludable es la obtención de impresiones continuas y clics crecientes para consultas de palabras clave principales y de cola larga. El error habitual es intentar manipular el algoritmo sobrecargando palabras clave de forma artificial en lugar de estructurar respuestas completas y verificables.
Paso 6: Síntesis en AI Overviews mediante generación aumentada por recuperación (RAG)
En 2026, la experiencia del usuario en las páginas de resultados ha evolucionado sustancialmente con el despliegue masivo de AI Overviews. Este mecanismo transforma la manera en que el motor utiliza su índice, pasando de devolver únicamente una lista de enlaces a sintetizar respuestas directas en la parte superior de la interfaz.
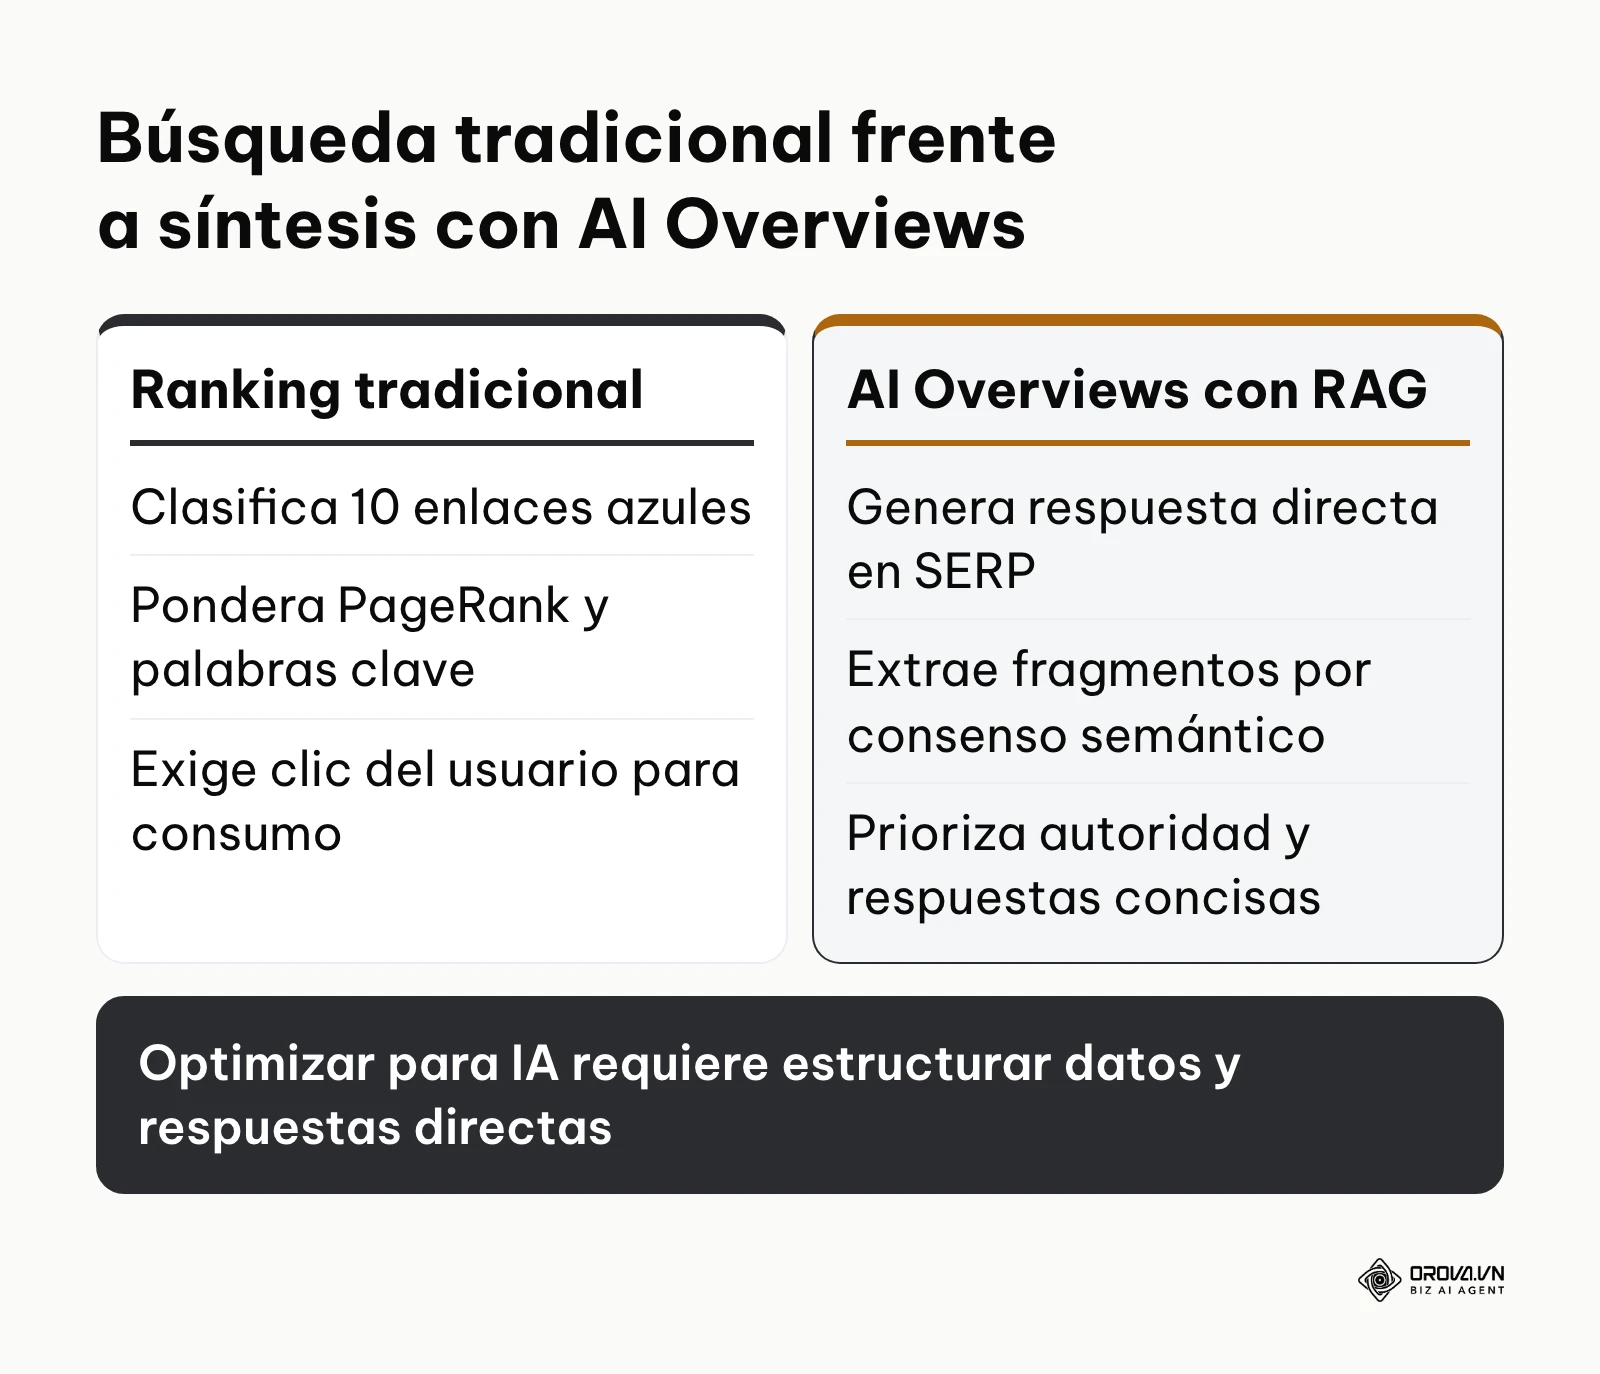
Técnicamente, este sistema se basa en una arquitectura de generación aumentada por recuperación (Retrieval-Augmented Generation o RAG). Cuando el usuario realiza una consulta informativa compleja, el motor no inventa datos mediante un modelo de lenguaje aislado. En su lugar, el algoritmo ejecuta una búsqueda interna ultrarrápida en el índice Caffeine, recupera los fragmentos de páginas web que demuestran mayor autoridad semántica y consistencia factual, y utiliza un modelo multimodal de la familia Gemini para estructurar un resumen unificado. Los sitios seleccionados como fuentes citadas en las tarjetas del resumen no siempre coinciden con los tres primeros enlaces azules tradicionales; el sistema prioriza documentos que contienen afirmaciones directas, datos contrastables y definiciones libres de ambigüedad.
El esquema de esta sección compara el funcionamiento de la clasificación tradicional con la síntesis basada en AI Overviews.
La señal de selección en este entorno es la aparición del dominio en los carruseles de fuentes vinculadas dentro del bloque sintético. El fallo técnico común consiste en esconder las respuestas principales tras párrafos introductorios difusos o bloques de scripts que dificultan la extracción rápida de fragmentos semánticos.
Paso 7: Publicación y entrega de resultados en milisegundos
La última etapa ocurre en el plano de la entrega en tiempo real. Cuando una persona pulsa la tecla Enter en el buscador, una máquina de servicio (serving system) recibe la consulta, aplica filtros de personalización geográfica y lingüística, consulta los servidores de índice invertido y devuelve la página de resultados terminada en una fracción de segundo.
En este instante, el sistema decide la composición final de la SERP: determina si la intención de búsqueda exige mostrar paquetes locales de mapas, carruseles de vídeo, bloques de compras patrocinadas, la respuesta de AI Overviews o los diez enlaces orgánicos estándar. Tal como establece el consorcio W3C en su especificación Arquitectura de la World Wide Web, Volumen Uno de 2004, los identificadores uniformes de recursos deben resolver de manera consistente para permitir la navegación determinista de agentes automáticos.
La señal de que esta entrega opera en favor de tu proyecto es una tasa de clics (CTR) sólida acorde a tu posición promedio. El fallo recurrente consiste en no adaptar los títulos y meta descripciones a la intención real del usuario, provocando que los fragmentos mostrados en la página de resultados resulten irrelevantes o truncados.
Descubre Orova.vn – una plataforma Biz AI Agent con la solución OROVA SEO completa, destinada a todos los sitios web. El sistema acompaña la optimización para motores de búsqueda de A a Z con las siguientes funciones: investigación de palabras clave, redacción de nuevos artículos optimizados para SEO, optimización de los contenidos existentes, seguimiento de posiciones, además del análisis de la competencia y el análisis técnico en profundidad. Regístrate hoy mismo para descubrir OROVA SEO de forma totalmente gratuita (oferta válida hasta el 7 de julio de 2027).
Análisis técnico: dilemas de arquitectura y factores de éxito en el buscador de Google
Construir un sitio web que dialogue eficazmente con el buscador de Google exige tomar decisiones técnicas de arquitectura. No existe una solución perfecta para todos los escenarios; cada modelo de entrega de código implica compromisos entre costes de infraestructura, agilidad de desarrollo y facilidad de rastreo para los robots.
A continuación, examinamos las tres arquitecturas principales de desarrollo web y su impacto directo en el ciclo de vida de rastreo e indexación.
| Enfoque arquitectónico | Cuándo conviene implementar | Desventajas técnicas |
|---|---|---|
| Server-Side Rendering (SSR) | Catálogos dinámicos extensos, medios de noticias y comercio electrónico con cambios frecuentes de stock | Mayor consumo de CPU en el servidor y latencia de respuesta si no existe capa de caché sólida |
| Static Site Generation (SSG) | Blogs corporativos, sitios de documentación técnica y páginas de servicios con contenido estable | Tiempos de compilación largos ante miles de URLs y necesidad de regenerar archivos ante cambios mínimos |
| Client-Side Rendering (CSR) | Paneles privados de administración, herramientas SaaS tras autenticación e intranets corporativas | Desfase severo en la cola de renderizado de Googlebot y riesgo de pérdida de indexación de contenido dinámico |
La elección entre estos modelos repercute directamente en la rapidez con la que el motor asimila tus actualizaciones. Mientras que un sitio basado en SSG o SSR entrega el código HTML listo para la primera ola de indexación, un entorno CSR obliga a Googlebot a programar el renderizado en su cola secundaria de Chromium, demorando la visibilidad pública.
Para entender con precisión cómo han cambiado los requisitos entre la búsqueda clásica y la nueva capa de inteligencia artificial, la siguiente tabla desglosa las diferencias fundamentales de procesamiento.
| Criterio de evaluación | Ranking tradicional (10 enlaces azules) | AI Overviews (Síntesis RAG con Gemini) |
|---|---|---|
| Criterio primario de selección | Autoridad de dominio, PageRank y concordancia de palabras clave en títulos y encabezados | Coherencia semántica, consenso factual entre fuentes y densidad de respuestas directas |
| Formato de presentación | Título con hipervínculo, URL visible y fragmento textual descriptivo (snippet) | Párrafo explicativo sintético con enlaces en tarjetas desplegables y citas integradas |
| Impacto en la interacción | Fomenta el clic directo del usuario para consumir la información completa en el sitio | Resuelve la duda en la SERP (cero clics) o genera clics altamente cualificados hacia la fuente |
| Tratamiento de datos estructurados | Utilizado para fragmentos enriquecidos (estrellas, recetas, preguntas frecuentes) | Utilizado para validar entidades semánticas y corroborar atributos del conocimiento |
Para garantizar que tu sitio web no sufra bloqueos silenciosos en ninguna de estas fases, te recomendamos aplicar el siguiente protocolo de diagnóstico técnico. Si necesitas un marco integral de optimización, revisa nuestro checklist SEO técnico.
A continuación se presenta el checklist de 10 puntos de indexabilidad técnica categorizado por nivel de criticidad.
| Punto de control | Componente técnico evaluado | Nivel de severidad | Método de verificación recomendado |
|---|---|---|---|
| 1. Directiva noindex no intencionada | Metaetiqueta robots y cabecera HTTP X-Robots-Tag | Crítica | Inspección del código HTML fuente y análisis de cabeceras de respuesta con cURL |
| 2. Bloqueo en robots.txt | Rutas críticas de contenido o carpetas de scripts | Crítica | Informe de robots.txt de Search Console |
| 3. Disponibilidad del servidor | Tasa de respuestas con errores HTTP 5xx | Crítica | Informe de estadísticas de rastreo de Search Console y registros Nginx/Apache |
| 4. Dependencia de renderizado | Contenido principal renderizado en cliente sin SSR | Alta | Comparar código fuente descargado frente al DOM renderizado en Live Test |
| 5. Consistencia canónica | Etiquetas canonical autorreferenciales o cruzadas | Alta | Comprobar campo 'Canónica declarada por el usuario' en herramienta de inspección |
| 6. Integridad del sitemap XML | URLs en sitemap devuelven código HTTP 200 limpio | Alta | Validar que no contenga páginas 404, redirecciones 301 ni URLs noindex |
| 7. Enlazado interno y URLs huérfanas | Accesibilidad de páginas mediante enlaces href rastreables | Media | Auditoría de enlaces internos y verificación de profundidad de clics |
| 8. Cadena de redirecciones | Máximo una redirección hacia la versión final de la URL | Media | Comprobación de saltos HTTP mediante herramientas de cabecera |
| 9. Bloqueo de recursos estáticos | Reglas que impiden descargar archivos CSS o JS esenciales | Media | Mensajes de 'No se han podido cargar los recursos' en prueba de URL en vivo |
| 10. Velocidad de respuesta (TTFB) | Tiempo hasta el primer byte menor a 600 milisegundos | Media | Métricas de rendimiento de red y registros de rendimiento de servidor |
Métricas clave y diagnóstico de indexación en el buscador de Google
Comprender la teoría resulta estéril si no sabes interpretar los paneles de diagnóstico oficiales. Google Search Console es el canal de comunicación primario donde el buscador refleja exactamente qué opina de tu arquitectura técnica y qué problemas ha encontrado al intentar procesar tus páginas.
El informe de páginas de Search Console clasifica las URLs que no forman parte del índice público en categorías diagnósticas muy específicas. La siguiente tabla detalla los estados más comunes, su trasfondo técnico y la secuencia exacta de resolución.
| Estado en Google Search Console | Significado técnico | Causa habitual | Pasos de resolución técnica |
|---|---|---|---|
| Descubierta: actualmente sin indexar | Googlebot conoce la URL pero aún no la ha descargado ni rastreado | Saturación del presupuesto de rastreo o arquitectura de enlaces internos muy pobre | 1. Enlazar la página desde secciones con tráfico. 2. Añadir la URL al sitemap XML. 3. Reducir URLs superfluas en el sitio. 4. Evitar solicitar indexación masiva manual. |
| Rastreada: actualmente sin indexar | Googlebot descargó el HTML pero decidió no incluirlo en el índice | Calidad percibida insuficiente, contenido duplicado o página con poco valor único | 1. Comparar el contenido frente a los competidores top. 2. Añadir datos originales y análisis profundo. 3. Fusionar con otra URL afín mediante 301 si es redundante. 4. Solicitar reevaluación tras editar. |
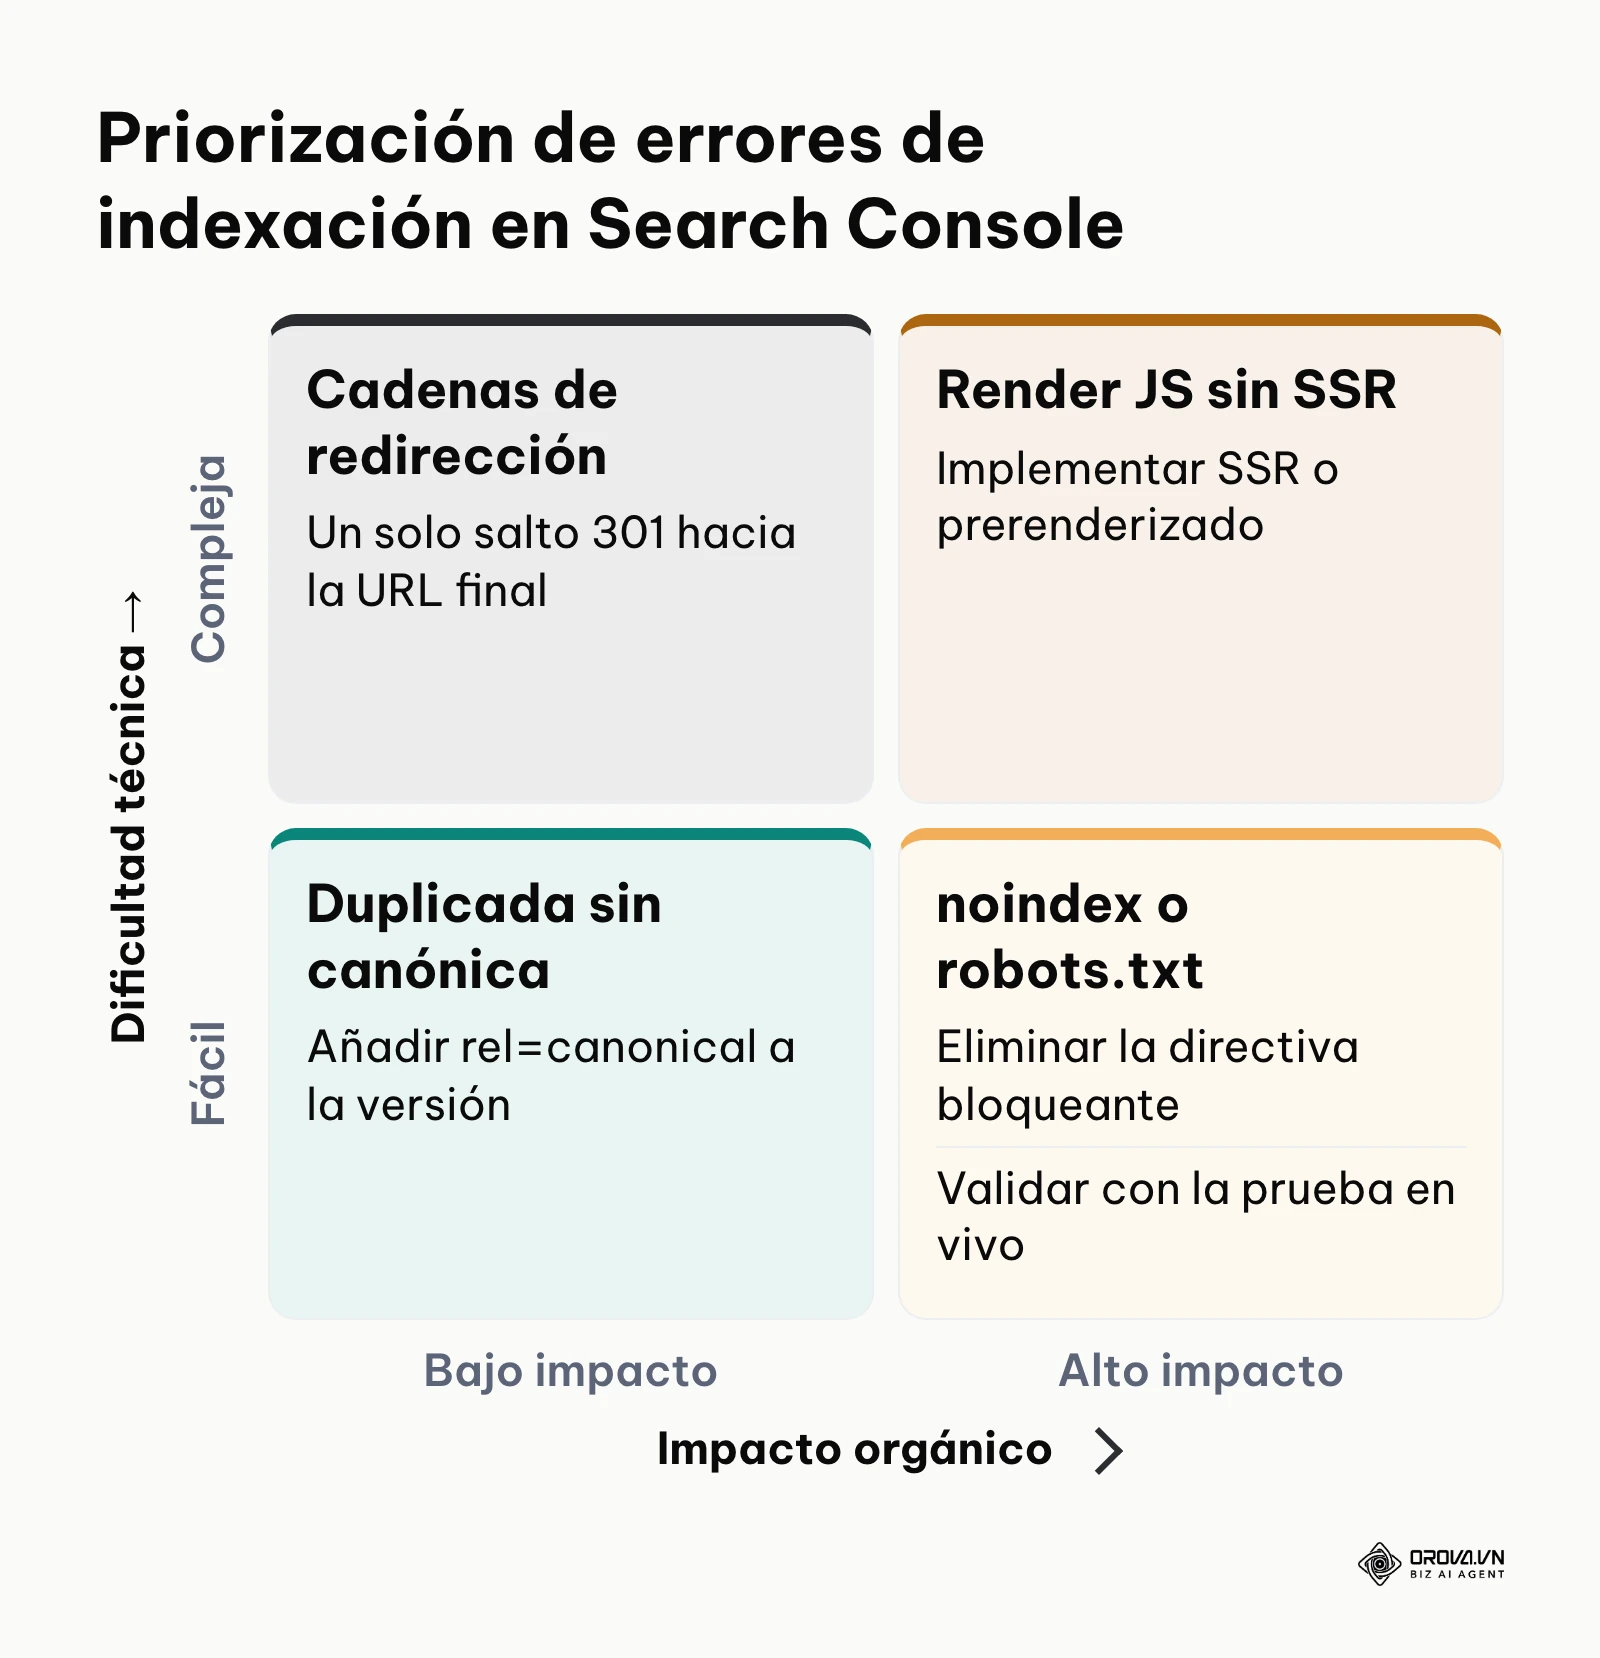
| Excluida por etiqueta 'noindex' | La página contiene una instrucción explícita de no inclusión | Presencia de <meta name="robots" content="noindex"> o cabecera HTTP X-Robots-Tag | 1. Revisar el código fuente HTML. 2. Comprobar la configuración del plugin SEO o del CMS. 3. Eliminar la directiva si la página debe ser pública. 4. Inspeccionar URL en vivo. |
| Página duplicada sin etiqueta canónica | Existen múltiples versiones de la misma página sin referencia declarada | Parámetros de ordenación, versiones con protocolo HTTP mixto o variantes con barra | 1. Insertar una etiqueta link con rel="canonical" apuntando a la versión preferida. 2. Configurar redirecciones 301 de variantes secundarias. 3. Actualizar enlaces internos hacia la URL limpia. |
| Error 404 no encontrado o 404 blando | La página no existe pero el servidor responde con contenido genérico o vacío | Fichas de producto eliminadas que devuelven código 200 en lugar de un código 404 real | 1. Asegurar que URLs eliminadas devuelvan código 404 o 410. 2. Si existe un reemplazo directo, aplicar redirección 301. 3. Eliminar enlaces internos rotos que apunten a esa ruta. |
| Bloqueada por el archivo robots.txt | Googlebot no puede descargar la página debido a una regla de exclusión | Directiva Disallow en el archivo robots.txt sobre la ruta específica | 1. Abrir /robots.txt y localizar la directiva que coincide con la ruta. 2. Modificar la regla para permitir el acceso si se requiere indexar. 3. Validar con la prueba en vivo. |
La matriz de esta sección ayuda a jerarquizar la intervención de estos errores según su impacto y su dificultad técnica.
Ejemplo ilustrativo: Un portal inmobiliario con más de 80.000 páginas de filtros dinámicos supervisado por un analista técnico detectó una pérdida progresiva de posiciones en sus categorías principales. Al revisar el informe de estadísticas de rastreo en Google Search Console, descubrieron que Googlebot dedicaba el 65% de sus solicitudes a combinaciones infinitas de filtros de búsqueda que generaban errores 404 blandos. Para resolverlo, bloquearon los parámetros de filtrado superfluos en el archivo robots.txt, implementaron etiquetas canónicas estrictas hacia las páginas de municipios principales y limpiaron el menú de navegación para eliminar enlaces hacia combinaciones sin inmuebles disponibles. En el transcurso de tres semanas, el informe de rastreo reflejó que las visitas del robot se concentraron en las fichas válidas y el volumen de páginas indexadas en Search Console creció de manera constante.
Para mantener bajo control la relación técnica con los rastreadores, debes supervisar con frecuencia los indicadores de rendimiento de rastreo dentro del panel de Google Search Console. La siguiente tabla reúne las métricas críticas y unos umbrales de alerta orientativos: no son cifras oficiales de Google, ajústalos al historial de tu propio sitio.
| Métrica técnica | Dónde monitorearla | Umbral de alerta orientativo |
|---|---|---|
| Tiempo medio de respuesta del servidor | Search Console > Estadísticas de rastreo | Promedio superior a 1.000 ms durante más de 3 días consecutivos |
| Solicitudes con código HTTP 5xx | Search Console > Estadísticas de rastreo > Por código | Porcentaje de respuestas 5xx superior al 1% del total de solicitudes |
| URLs 'Rastreadas: sin indexar' | Search Console > Indexación de páginas | Representan más del 15% del total de URLs enviadas en sitemaps |
| Caída repentina de solicitudes de rastreo | Search Console > Estadísticas de rastreo > Total | Reducción superior al 40% del volumen habitual sin cambios en el sitio |
Con OROVA.VN y el módulo OROVA SEO, pones fin definitivamente a las jornadas agotadoras de trabajo manual. En lugar de batallar durante horas para redactar artículos y elaborar informes, todo el proceso queda ahora optimizado y completado en tan solo 5 minutos.
Errores críticos al interactuar con el buscador de Google y cómo solucionarlos
A lo largo de auditorías técnicas frecuentes, se identifican patrones de error que sabotean la indexación incluso en proyectos con contenido de alta calidad. La mayoría de estos fallos se originan en una mala coordinación entre el equipo de desarrollo de software y los responsables de marketing.
- Bloquear recursos CSS y JavaScript en el archivo robots.txt: Históricamente se recomendaba restringir el acceso a carpetas de scripts para ahorrar ancho de banda. Hoy en día, esta práctica impide que el Web Rendering Service procese el diseño visual y el contenido dinámico, provocando que Google considere el sitio defectuoso o inaccesible para móviles. La solución radica en eliminar las directivas Disallow que apunten a carpetas de assets públicos.
- Depender de renderizado en cliente sin contingencia de servidor: Publicar aplicaciones en las que el primer paquete HTML contiene únicamente una etiqueta <div id="root"></div> vacía confina el sitio a la segunda ola de renderizado. Si los recursos de Googlebot están saturados, la página puede pasar semanas sin que su contenido textual sea extraído. La solución consiste en implementar Server-Side Rendering (SSR) o prerenderizado estático de rutas públicas.
- Generar cadenas y bucles de redirección: Encadenar varias redirecciones sucesivas (por ejemplo, de HTTP a HTTPS, luego de sin www a con www, y finalmente un cambio de slug) agota las solicitudes permitidas por petición y hace que Googlebot aborte el rastreo de la URL de destino. La solución exige actualizar la base de datos para que cada redirección apunte en un único salto directo (código 301) hacia la URL canónica final.
- Desatender los parámetros de URLs en catálogos extensos: La navegación por facetas suele crear millones de combinaciones de URLs con contenido idéntico o ligeramente reordenado. Si no se gestionan, devoran el presupuesto de rastreo y diluyen la relevancia del dominio. La corrección exige aplicar etiquetas canonical hacia la categoría raíz y bloquear parámetros irrelevantes en robots.txt.
- Permitir errores de servidor 5xx intermitentes: Si tu infraestructura colapsa bajo cargas moderadas y devuelve errores 500, 502 o 503 a los robots, Googlebot asumirá que el sitio es inestable y disminuirá drásticamente la frecuencia de visitas. La solución pasa por optimizar las consultas a la base de datos, configurar capas de almacenamiento en caché en el servidor web y emplear redes de distribución de contenido (CDN).
- Desplegar cabeceras noindex por error desde entornos de prueba: Uno de los incidentes más graves consiste en clonar configuraciones del servidor de pruebas (staging) al servidor de producción manteniendo activa la cabecera X-Robots-Tag: noindex. Esto provoca la desindexación masiva del catálogo en cuestión de días. La solución exige auditar las cabeceras HTTP de producción mediante herramientas de línea de comandos antes de cada lanzamiento.
La siguiente tabla resume dónde detectar cada uno de estos errores y la primera acción a tomar.
| Error | Dónde se detecta | Primera acción |
|---|---|---|
| Recursos CSS o JS bloqueados | Prueba de URL en vivo de Search Console (recursos no cargados) | Quitar el Disallow sobre carpetas de assets públicos |
| Contenido solo en el cliente (CSR) | Código renderizado frente a código fuente en la inspección de URLs | Activar SSR o prerenderizado en rutas públicas |
| Cadenas o bucles de redirección | Comprobación de saltos HTTP con cURL o un comprobador de cabeceras | Dejar un único salto 301 hacia la URL canónica |
| Parámetros de facetas sin control | Informe de estadísticas de rastreo (solicitudes por URL con parámetros) | Canonical a la categoría raíz y bloqueo de parámetros irrelevantes |
| Errores 5xx intermitentes | Estadísticas de rastreo > Por respuesta | Caché en servidor, CDN y optimización de consultas |
| Cabecera noindex heredada de staging | Inspección de URLs (indexación no permitida) y cabeceras HTTP | Eliminar X-Robots-Tag: noindex y solicitar indexación |
Ejemplo ilustrativo: Una plataforma de servicios para empresas con 400 páginas corporativas administrada por un webmaster independiente experimentó una desaparición repentina de sus páginas en los resultados tras un rediseño general. Tras investigar el código HTML y verificar que no había metaetiquetas sospechosas, el analista ejecutó una petición mediante la consola de comandos y detectó la cabecera HTTP X-Robots-Tag: noindex introducida por una regla descuidada en el archivo de configuración de Nginx. El equipo eliminó la cabecera del servidor, purgó la caché de la red de distribución de contenidos y utilizó la herramienta de inspección de URLs de Search Console para solicitar la reindexación de las páginas principales. Tras 72 horas, las alertas de exclusión por directiva noindex desaparecieron del informe y el tráfico comenzó su recuperación hacia los niveles previos.
Tendencias en el buscador de Google para los próximos años: mi perspectiva
El comportamiento de los motores de búsqueda está experimentando su mayor transformación estructural desde la introducción del algoritmo PageRank original. A continuación, comparto tres perspectivas analíticas sobre el rumbo que tomará la tecnología de búsqueda en los próximos años.
En primer lugar, considero que la interfaz tradicional basada en diez enlaces azules pasará a un segundo plano para la gran mayoría de las consultas de carácter informativo y comparativo. A fecha de 2026 vemos cómo los resúmenes generados por inteligencia artificial ocupan el primer pliegue de la pantalla, respondiendo a la necesidad inmediata del usuario sin requerir navegación externa. A mi juicio, en los próximos años los buscadores operarán como motores de respuesta y síntesis conversacional más que como índices de documentos estáticos. Esto obligará a los creadores a replantear sus métricas de visibilidad: el valor ya no residirá en captar clics superficiales de usuarios que buscan definiciones breves, sino en posicionarse como la entidad citada que valida los datos del resumen. Para prepararte, debes estructurar tus contenidos con datos unívocos, tablas comparativas explícitas y una atribución de autoría inatacable.
En segundo lugar, estimo que Googlebot racionará aún más sus recursos de rastreo, elevando la barrera de entrada para la indexación de páginas web. Hoy observamos que el volumen de contenido generado automáticamente por inteligencia artificial satura la red a una velocidad sin precedentes, multiplicando los costes de almacenamiento y computación de los centros de datos de Google. Según mi análisis, en el futuro próximo el buscador podría restringir aún más el rastreo de sitios nuevos que no demuestren una demanda orgánica genuina o un enlazado externo previo consolidado. Creo que la época en la que cualquier dominio podía indexar miles de artículos en pocas semanas se está terminando. Los equipos técnicos deben anticiparse optimizando de forma milimétrica el presupuesto de rastreo y eliminando cualquier página delgada o redundante de sus estructuras.
En tercer lugar, preveo un declive acelerado del contenido genérico y una revalorización radical de las fuentes que aporten datos primarios y experiencia de primera mano. Con modelos capaces de resumir información común al instante, los artículos que se limitan a recopilar lo que otros ya dijeron tendrán cada vez menos incentivo algorítmico para ser indexados. Considero que Google premiará con visibilidad preferente a las marcas que demuestren autoría contrastable, metodología propia y opiniones técnicas argumentadas. Por supuesto, este escenario podría experimentar demoras si las disputas regulatorias sobre derechos de autor o los costes energéticos de inferencia en los centros de datos obligan a moderar el despliegue de las respuestas generativas en ciertos mercados.
Preguntas frecuentes sobre cómo funciona el buscador de Google
¿Por qué Googlebot rastrea una página pero decide no indexarla?
Este fenómeno ocurre generalmente porque el sistema considera que el documento no aporta valor diferencial suficiente frente a páginas ya existentes en su índice, o porque la estructura de enlaces internos del sitio no le transmite suficiente autoridad. También sucede cuando el contenido depende de código JavaScript que falló al ejecutarse durante la fase de renderizado en el Web Rendering Service.
¿Bajo qué criterios selecciona AI Overviews las fuentes citadas a diferencia del ranking tradicional?
A diferencia de los diez enlaces orgánicos que priorizan la autoridad del dominio y los enlaces externos, el sistema de AI Overviews busca fragmentos semánticos precisos que resuelvan la duda con coherencia y exactitud factual. El modelo selecciona fuentes que presentan respuestas estructuradas, lenguaje directo y coincidencia temática con el consenso de otras fuentes fiables del índice.
¿Cuánto tarda Googlebot en reflejar cambios tras actualizar contenido antiguo y cómo acelerarlo?
El tiempo de actualización varía desde unas pocas horas en medios de comunicación con alta frecuencia de rastreo hasta varias semanas en blogs o catálogos estáticos. Para acelerar el proceso, debes actualizar la fecha de modificación en el sitemap XML, incluir un enlace interno desde la portada o un artículo reciente y solicitar la reindexación mediante la herramienta de inspección de URLs en Search Console.
¿Qué papel desempeña la inteligencia artificial en el funcionamiento general del buscador de Google?
La inteligencia artificial interviene en múltiples etapas críticas: en la interpretación de consultas complejas mediante RankBrain y BERT, en la detección de spam y manipulación de enlaces mediante SpamBrain, y en la generación de resúmenes estructurados mediante modelos multimodales como Gemini dentro de las experiencias de AI Overviews.
¿Se puede pagar a Google para aparecer primero en los resultados orgánicos del motor?
No existe ningún mecanismo de pago para alterar los resultados de búsqueda orgánica ni para garantizar la indexación de páginas en el buscador de Google. Los anuncios patrocinados mediante Google Ads funcionan en una subasta publicitaria completamente independiente y no influyen en el rastreo, la indexación ni el posicionamiento orgánico de tu sitio web.
¿Cuál es la diferencia técnica entre presupuesto de rastreo e indexabilidad?
El presupuesto de rastreo representa el número de peticiones que Googlebot puede y desea realizar a tu servidor en un período determinado sin saturarlo. La indexabilidad es la aptitud técnica y cualitativa de una página para ser almacenada y presentada en los resultados de búsqueda tras haber sido descargada e interpretada por el motor.
¿Por dónde empezar a optimizar para el buscador de Google?
Si te encuentras ante el desafío de alinear tu presencia digital con los requisitos del motor, la clave consiste en ejecutar acciones secuenciales de alto impacto en lugar de dispersar esfuerzos en tácticas aisladas. A continuación, se detallan tres situaciones habituales y el paso inicial que debes llevar a cabo en una sola jornada de trabajo.
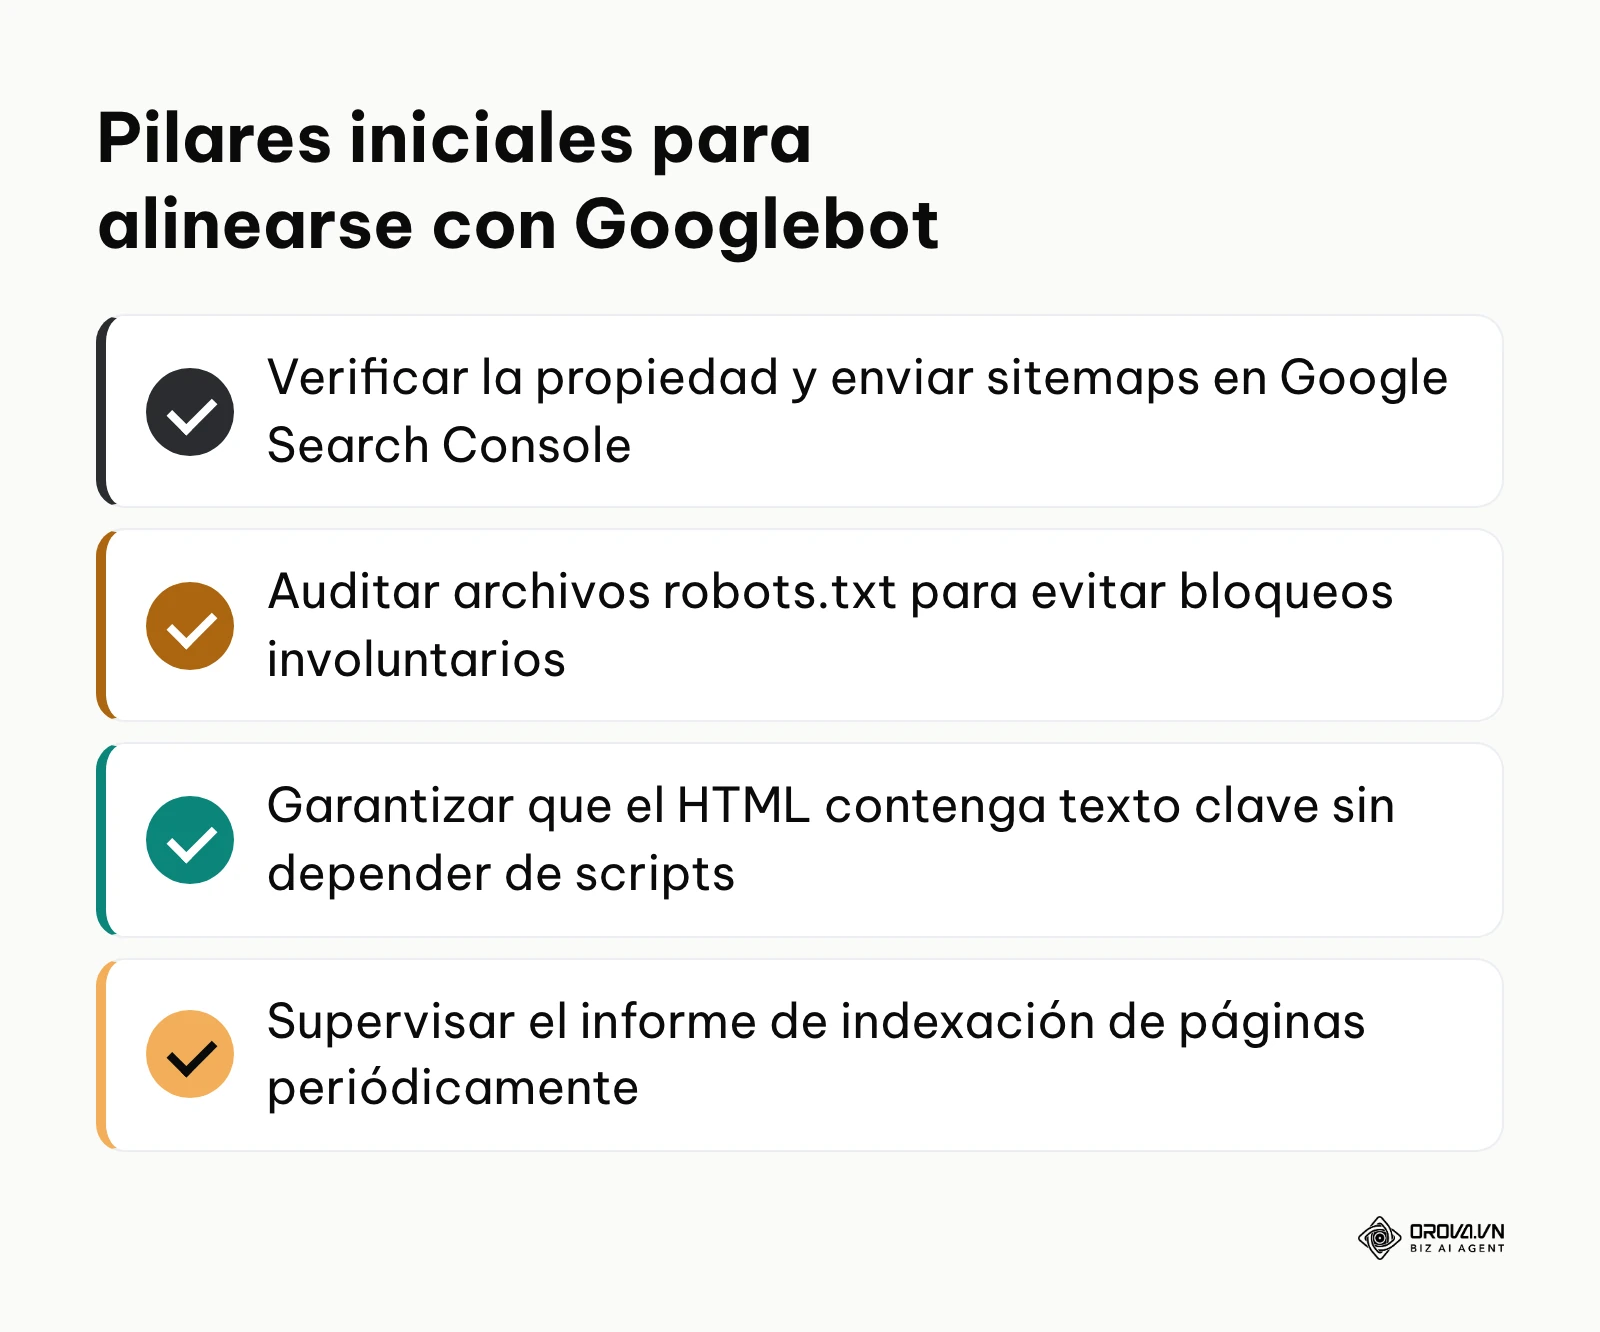
Si tienes un sitio web nuevo que aún no registra tráfico orgánico ni impresiones, tu prioridad absoluta es la accesibilidad básica. Accede al panel de tu registrador de dominios, verifica la propiedad de tu sitio en Google Search Console mediante un registro DNS TXT y envía la dirección de tu sitemap.xml. Con esta única acción abrirás la puerta de comunicación formal para que Googlebot descubra tus páginas primarias sin depender exclusivamente de enlaces externos.
Si dispones de un sitio consolidado pero sufres por URLs atascadas en estados no indexados dentro de Search Console, tu primera medida debe ser una auditoría de directivas y código renderizado. Selecciona cinco de las URLs más importantes excluidas en el informe, somételas a la prueba de URL en vivo y revisa la pestaña de código renderizado. Comprueba que el texto principal no dependa de scripts bloqueados y que no existan etiquetas noindex accidentales ni canonicals apuntando hacia rutas erróneas.
Si gestionas un portal extenso o una tienda online con miles de productos y caídas de visibilidad, el primer movimiento técnico consiste en sanear el presupuesto de rastreo. Descarga el informe de estadísticas de rastreo de Search Console, identifica las rutas de parámetros de filtros o búsquedas internas que consumen la mayoría de las solicitudes de Googlebot y bloquéalas de inmediato en el archivo robots.txt.
El siguiente resumen sintetiza las comprobaciones inmediatas que consolidan esta rutina de trabajo técnico.
Dominar estas etapas técnicas, desde el envío del código fuente hasta la entrega en milisegundos, te otorgará el control necesario sobre tu infraestructura web para entender en profundidad cómo funciona el buscador de Google.
About the author
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Gestiona tu negocio con AI Agents
Orova es el Biz AI Agent que nunca para: planifica, ejecuta y optimiza el trabajo por ti.
Gana tiempo y multiplica tu productividad.