Comment fonctionne Google : le guide en 7 étapes pour son SEO (2026)
Comprendre comment fonctionne Google est le prérequis indispensable pour quiconque souhaite rendre les pages de son site visibles auprès de ses futurs visiteurs. En bref : Googlebot explore le web en suivant les liens et les sitemaps, Google affiche (rend) les pages, JavaScript compris, enregistre dans son index celles qu'il juge utiles, puis classe ces pages à chaque requête, en résumant parfois les meilleures réponses dans les AI Overviews. À la fin de ce tutoriel, vous disposerez d'un diagnostic clair de votre site, de fichiers techniques configurés pour guider les robots, et d'un tableau de bord Google Search Console sans anomalies d'indexation bloquantes.
Pour appliquer cette méthode, préparez un accès administrateur à votre hébergement ou CMS, un compte Google Search Console validé sur votre domaine, et prévoyez environ deux heures de travail technique. Ce guide ne s'adresse pas aux gestionnaires d'intranets privés ou de pages éphémères qui n'ont aucune vocation à générer du trafic sur le web public.
Comment fonctionne Google et son moteur de recherche
Google fonctionne comme un immense catalogue dynamique qui explore le web, analyse le code, enregistre les contenus dans son index et calcule leur pertinence pour chaque requête. Pour agir sur chacune de ces phases, ce guide découpe le travail en 7 étapes opérationnelles, qui demandent environ deux heures de configuration initiale.
Contrairement à une idée reçue, l'internaute ne lance pas sa recherche sur le web en direct lors de la saisie d'un mot-clé, mais interroge une copie stockée sur les serveurs du moteur de recherche. Selon la documentation technique de Google Search Central intitulée « How Search Works », le moteur de recherche décompose son fonctionnement en trois grandes étapes opérationnelles que sont l'exploration, l'indexation et la diffusion des résultats. En comprenant cette mécanique fondamentale, vous pouvez intervenir directement sur les blocages techniques qui empêchent vos pages d'apparaître sur les écrans de vos prospects.
Préparer les prérequis techniques avant de commencer
Avant de modifier vos paramètres de visibilité, vous devez réunir plusieurs éléments techniques d'accès et d'analyse. Le tableau suivant récapitule les accès nécessaires pour mener l'ensemble du processus sans interruption.
| Élément requis | Où le trouver | Temps nécessaire | Conséquence en cas d'absence |
|---|---|---|---|
| Propriété Google Search Console | search.google.com/search-console | 10 minutes | Impossibilité de surveiller le crawl et les erreurs d'indexation |
| Fichier robots.txt | Racine du serveur web (votresite.com/robots.txt) | 15 minutes | Risque de blocage involontaire de Googlebot ou de gaspillage de requêtes |
| Fichier sitemap XML | Extension SEO ou CMS (votresite.com/sitemap.xml) | 15 minutes | Découverte tardive ou incomplète des nouvelles URL par les robots |
| Accès aux en-têtes HTTP et code source | Outils de développement du navigateur (F12) | Immédiat | Difficulté à diagnostiquer les redirections et les balises noindex |
| Journal des logs serveur | Panneau d'hébergement (cPanel, Nginx, Apache) | 20 minutes | Absence de visibilité sur les passages réels des adresses IP Googlebot |
Une fois ces cinq accès validés, vous disposez des leviers nécessaires pour contrôler la chaîne de traitement complète du moteur de recherche.
Étape 1 : Configurer l'accès et guider Googlebot avec le robots.txt
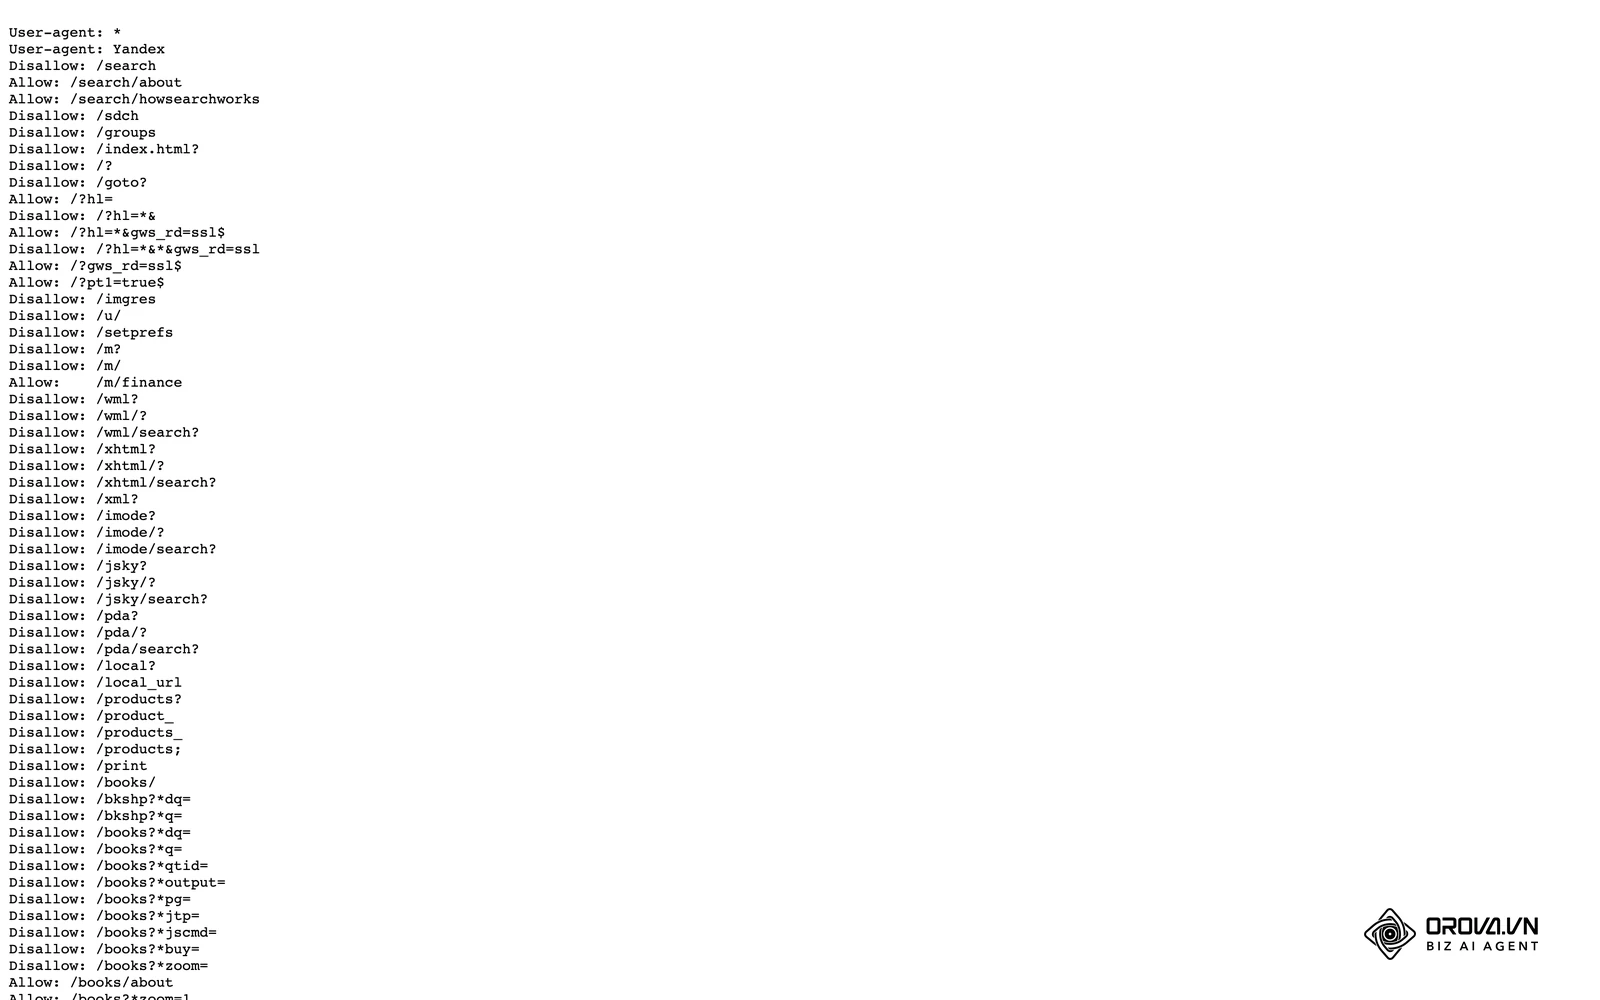
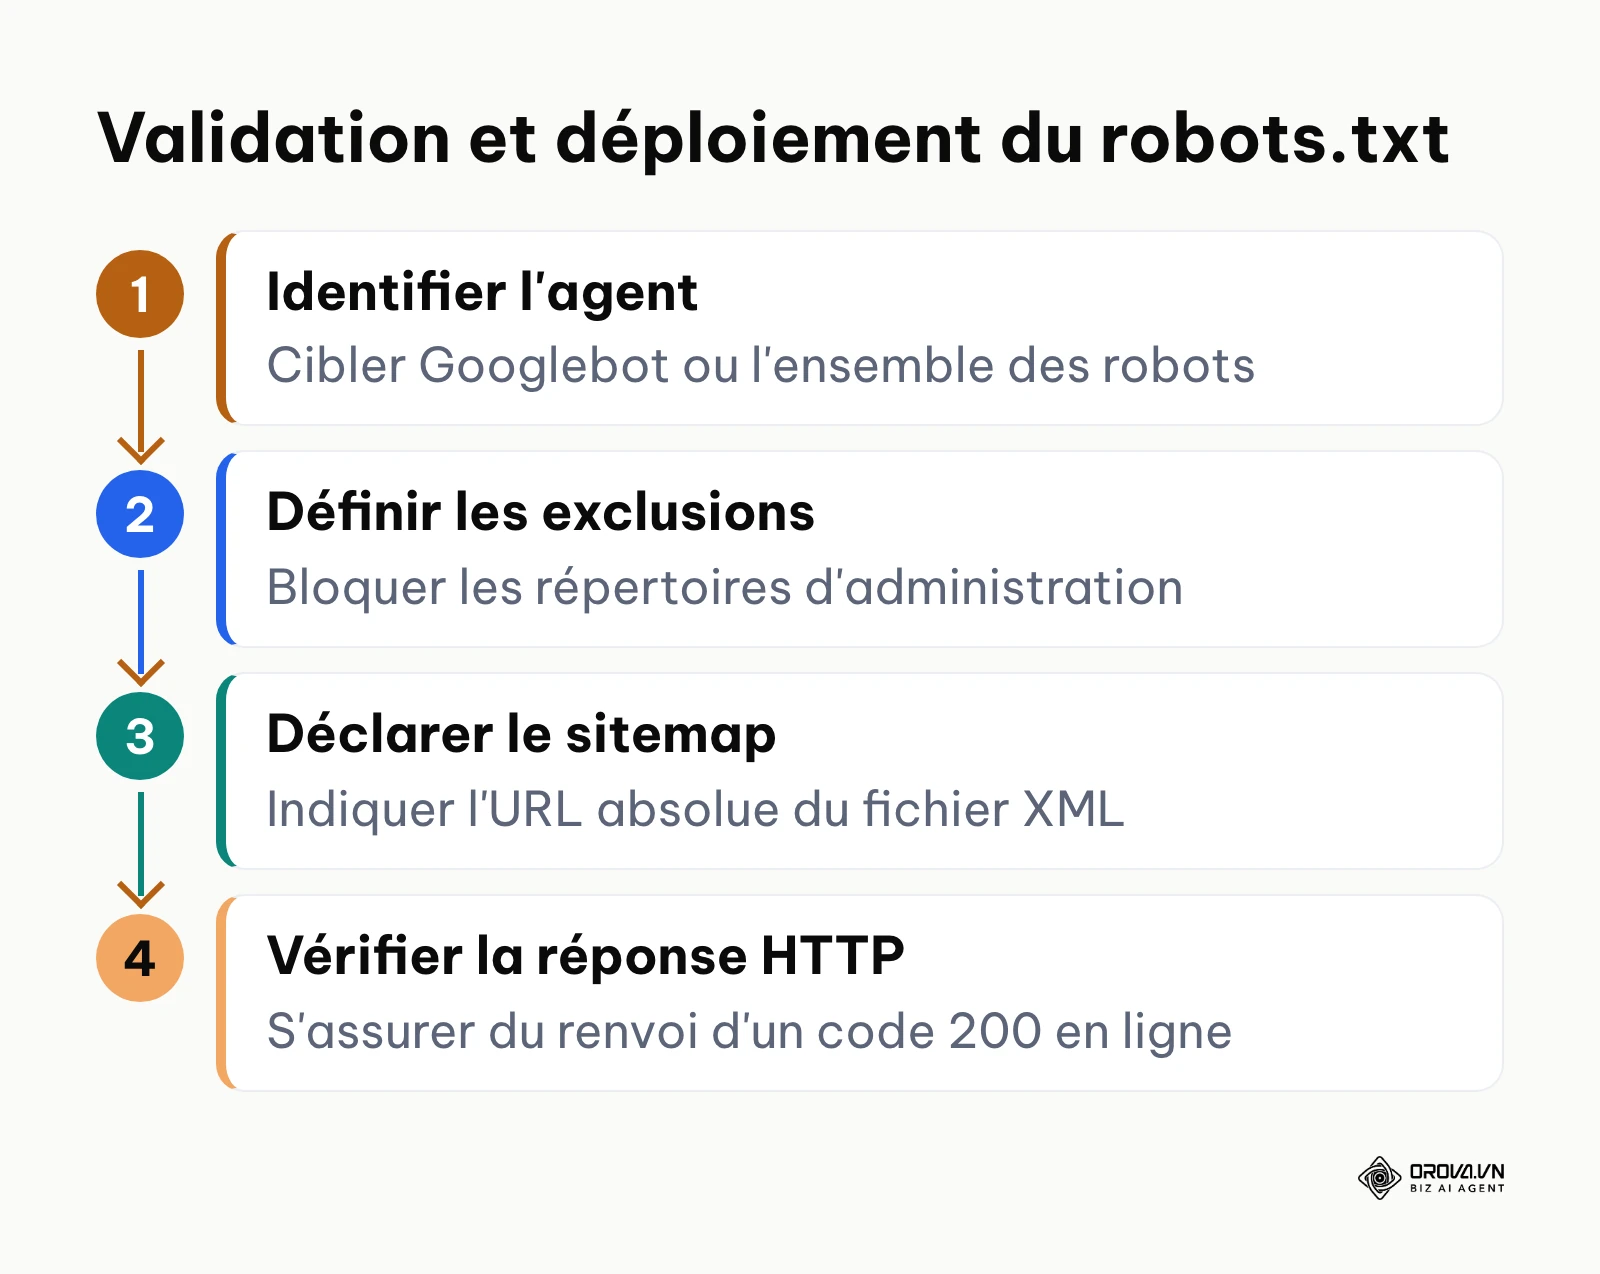
L'objectif de cette étape est de définir clairement les zones de votre serveur que les robots d'exploration ont le droit de visiter et celles qui leur sont interdites. Le schéma ci-dessous résume le parcours méthodique de vérification de votre fichier de guidage.
Accéder au fichier et rédiger les directives
Pour manipuler ce document, connectez-vous au gestionnaire de fichiers de votre hébergement web ou utilisez un client FTP pour ouvrir le fichier robots.txt situé à la racine publique de votre domaine (souvent dans le dossier public_html ou www).
Rédigez ou ajustez les instructions en respectant la casse et la syntaxe standard. D'après la norme internationale de l'IETF définie dans le document RFC 9309 relatif au Robots Exclusion Protocol en 2022, la directive Disallow appliquée à un chemin indique expressément aux agents automatisés de ne pas accéder aux ressources concernées. Indiquez la directive User-agent: Googlebot ou User-agent: * pour cibler l'ensemble des agents. Ajoutez les lignes Disallow: /wp-admin/ ou Disallow: /panier/ pour protéger les scripts privés, puis renseignez l'emplacement de votre plan de site à la fin du fichier avec la mention Sitemap: https://votresite.com/sitemap.xml.
Vérifier la prise en compte visuelle
Pour contrôler le résultat, ouvrez un nouvel onglet dans votre navigateur et tapez l'adresse directe votresite.com/robots.txt. Vous devez voir s'afficher votre texte brut sans mise en page HTML, avec un code de réponse HTTP 200 visible dans l'onglet Réseau de votre console de développement. Vous pouvez également ouvrir le rapport robots.txt de la Search Console (menu Paramètres) pour vérifier la version que Google a récupérée et confirmer qu'aucune page stratégique n'est bloquée.
Erreurs fréquentes et solutions
L'erreur la plus destructive consiste à laisser la directive Disallow: / active. Cette ligne indique à Googlebot de quitter immédiatement le domaine sans analyser la moindre URL. Si votre trafic organique est à zéro après une refonte, supprimez immédiatement ce slash solitaire pour rétablir les accès.
Exemple illustratif (cas hypothétique) :
- Contexte : Une entreprise de conseil B2B de 30 pages constate une absence totale de pages indexées deux mois après la mise en ligne de son nouveau site web.
- Actions menées : Ouverture de l'adresse du fichier robots.txt dans le navigateur, constat de la directive Disallow: / laissée par le prestataire, suppression de la directive et remplacement par Disallow: /admin/, soumission de l'URL du fichier dans la console d'administration.
- Point de blocage et solution : Google conserve en général une copie du fichier robots.txt en cache jusqu'à 24 heures ; une demande de nouvelle exploration depuis le rapport robots.txt de la Search Console a permis à Googlebot de relire plus vite le fichier corrigé.
- Résultat visible : Le rapport Pages de la Google Search Console a commencé à enregistrer les premières explorations sous 72 heures, passant de 0 à 28 URL explorées en une semaine.
Étape 2 : Déclarer la structure du site via un sitemap XML propre
Cette étape vise à transmettre aux algorithmes une liste hiérarchisée et propre de toutes vos URL canoniques prêtes à être indexées.
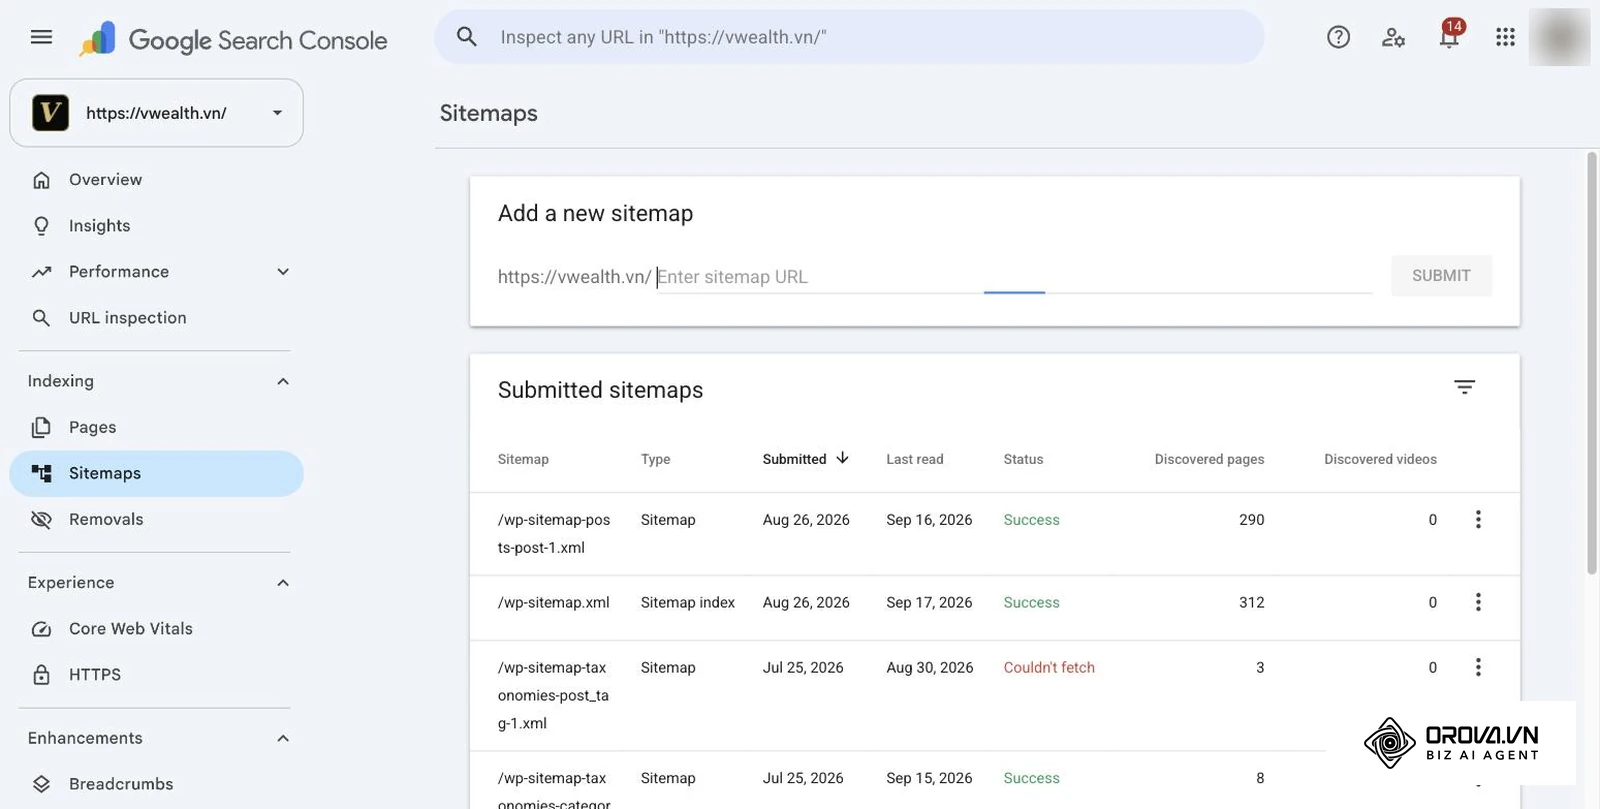
Pour effectuer cette démarche, rendez-vous dans l'interface de la Google Search Console, puis cliquez sur le menu Indexation, puis sur le sous-menu Sitemaps dans la colonne latérale gauche. Dans le champ texte intitulé « Ajouter un sitemap », saisissez le suffixe de votre plan de site (par exemple sitemap.xml ou sitemap_index.xml) et validez en cliquant sur le bouton bleu Envoyer.
Après quelques minutes ou quelques heures selon la taille de votre site, la ligne du sitemap apparaît dans le tableau inférieur avec la mention de statut en vert « Opération effectuée ». Le nombre d'URL découvertes doit correspondre au nombre réel d'articles et de pages publiques de votre catalogue. Si vous souhaitez approfondir la méthode pour comment indexer une page sur Google, le sitemap constitue la première porte d'entrée utilisée par les robots pour planifier leurs passages.
Parmi les anomalies classiques, la présence d'URL redirigées (codes 301) ou d'URL introuvables (codes 404) dans le sitemap crée des signaux contradictoires. Si la Search Console affiche le message « Impossible de récupérer le sitemap », vérifiez que l'URL soumise renvoie bien un code HTTP 200 et que votre serveur ne bloque pas l'accès aux adresses IP de Google via un pare-feu trop agressif.
Étape 3 : Surveiller le crawl et le budget d'exploration sur la Search Console
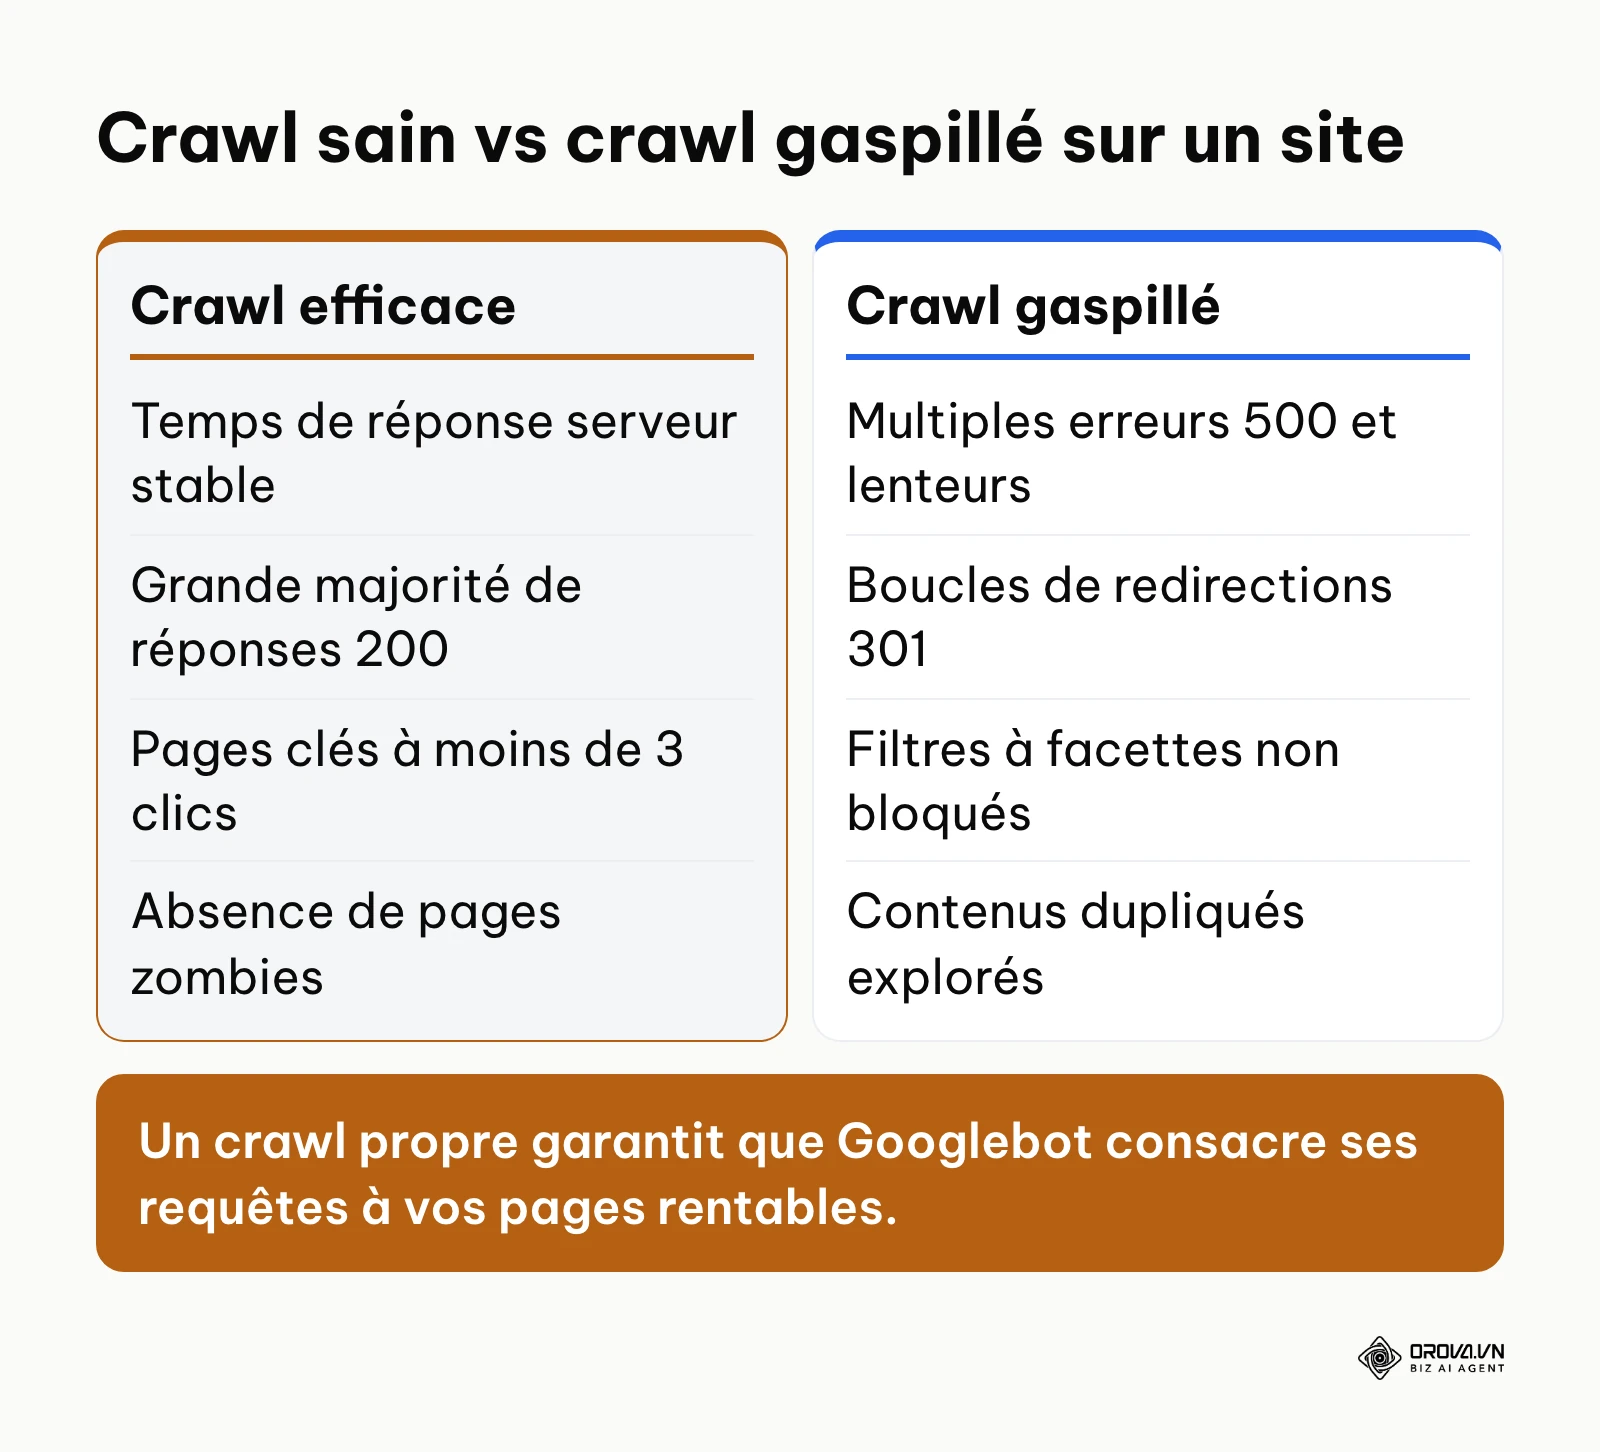
L'objectif consiste ici à mesurer la fréquence de passage de Googlebot sur vos serveurs et à vérifier que le temps alloué à votre domaine n'est pas dilapidé. Le schéma ci-dessous résume les signaux distinctifs d'un budget de crawl parfaitement maîtrisé.
Consulter les statistiques d'exploration
Dans la Google Search Console, descendez tout en bas du menu de gauche et cliquez sur Paramètres, puis cherchez la section Exploration et cliquez sur le lien Ouvrir le rapport à côté de Statistiques sur l'exploration.
Sur cette page, vous observez trois courbes temporelles sur 90 jours : le nombre total de demandes d'exploration, la taille totale des téléchargements et le temps de réponse moyen de l'hôte. Descendez plus bas pour examiner deux tableaux analytiques cruciaux :
- Par réponse : cette répartition classe les requêtes par code d'état HTTP. Votre objectif est que la grande majorité des réponses soient des codes « OK (200) ». Si la part des codes « Déplacé de façon permanente (301) » ou des erreurs serveur (5xx) grimpe, votre site gaspille des ressources d'exploration.
- Par type de Googlebot : vous visualisez la proportion entre Googlebot pour smartphone et Googlebot pour ordinateur. Depuis le passage au Mobile-First Indexing, la version mobile doit représenter l'immense majorité des passages.
Optimiser les facteurs limitants du Crawl Budget
Le budget d'exploration désigne le nombre d'URL que Googlebot peut et veut explorer sur votre site lors d'une période donnée. Google précise que ce sujet concerne surtout les très grands sites (plus d'un million de pages, ou plus de 10 000 pages modifiées chaque jour). Si votre site entre dans ce cas, appliquez une discipline stricte :
- Réduisez le temps de réponse de votre serveur : un hôte rapide et stable permet à Googlebot d'explorer davantage de pages.
- Empêchez l'exploration des pages de tri, des filtres dynamiques à facettes et des résultats de recherche interne via le robots.txt (une balise noindex n'économise pas le budget, car Googlebot doit explorer la page pour la lire).
- Éliminez les chaînes de redirections successives qui forcent le robot à effectuer plusieurs requêtes HTTP pour une seule page cible.
- Corrigez immédiatement les erreurs 5xx : une hausse des erreurs serveur incite Googlebot à ralentir son rythme de visite pour ne pas surcharger votre machine.
Étape 4 : Gérer le rendu JavaScript et le Web Rendering Service
L'objectif est d'assurer que les pages construites avec des technologies dynamiques (comme React, Vue ou des scripts de mise en page modernes) sont lisibles par le moteur sans perte d'information.
Comprendre le fonctionnement en deux vagues
Googlebot ne traite pas le web comme un simple navigateur de bureau instantané. Lorsqu'il visite une URL, il télécharge immédiatement le fichier HTML brut : c'est la première vague d'indexation. Si votre contenu textuel est injecté par JavaScript côté client, le robot ne le voit pas immédiatement. Il place alors la page dans une file d'attente pour le Web Rendering Service (WRS).
Ce service dédié utilise une version headless du navigateur Chromium pour exécuter les scripts, charger les feuilles de style et générer le DOM (Document Object Model) final. Le rendu demande beaucoup de puissance de calcul : il peut donc être différé après le crawl initial. Google indique que ce délai est souvent court, mais il peut s'allonger lorsque ses ressources sont sollicitées.
Flux d'exécution technique :
[URL découverte] -> [Crawl HTML brut (Vague 1)] -> [File d'attente WRS] -> [Rendu Chromium (Vague 2)] -> [Index inversé]
Le mode de rendu choisi pour votre site détermine ce que Googlebot reçoit dès la première vague :
| Mode de rendu | Ce que Googlebot reçoit au premier passage | Risque pour l'indexation | Quand le choisir |
|---|---|---|---|
| Rendu côté client (CSR) | Un HTML presque vide, le texte arrive après exécution du JavaScript | Contenu indexé plus tard, ou partiellement si un script échoue | Espaces membres et tableaux de bord qui n'ont pas besoin d'être indexés |
| Rendu côté serveur (SSR) | Le HTML complet avec le texte et les liens | Faible, à condition que le serveur réponde vite | Fiches produits, articles, pages de catégories |
| Génération statique (SSG, pré-rendu) | Des fichiers HTML déjà prêts | Très faible, pages légères et rapides | Blogs, documentation, pages vitrines |
| Rendu dynamique (version spéciale pour les robots) | Une version pré-rendue servie aux seuls robots | Maintenance lourde ; Google la présente comme une solution de contournement | Uniquement en transition, en attendant le SSR ou le SSG |
Tester le rendu en direct
Pour vérifier ce que Googlebot voit réellement, copiez l'adresse d'une page dynamique, collez-la dans la barre supérieure « Inspecter n'importe quelle URL » de la Search Console et appuyez sur Entrée. Sur l'écran de résultat, cliquez sur le bouton blanc Tester l'URL en direct.
Une fois le test terminé, cliquez sur Afficher la page testée. Vous disposez de deux onglets de contrôle :
- L'onglet Capture d'écran montre le rendu visuel tel qu'affiché par le moteur. Vérifiez que les images, le texte principal et les menus ne sont pas remplacés par une zone blanche ou un indicateur de chargement infini.
- L'onglet HTML affiche le code source généré après exécution du JavaScript. Utilisez le raccourci Ctrl+F pour rechercher un fragment de votre texte. S'il est présent dans ce code rendu, Googlebot est capable de l'indexer.
Exemple illustratif (cas hypothétique) :
- Contexte : Une boutique de prêt-à-porter de 500 références utilise un framework JavaScript avec rendu côté client ; les descriptions de produits restent invisibles sur les moteurs.
- Actions menées : Lancement d'un test en direct dans la Search Console, constat que le texte des fiches produits est absent du code rendu car l'appel API asynchrone dépasse le délai de traitement accordé aux scripts.
- Point de blocage et solution : Mise en place d'un rendu côté serveur (Server-Side Rendering ou SSR) sur les gabarits produits pour livrer le texte directement dans le flux HTML initial sans attendre l'exécution client.
- Résultat visible : Lors du test d'inspection suivant, le code HTML rendu contenait l'intégralité des 300 mots de description dès la première vague, permettant l'indexation de 100 % du catalogue en dix jours.
Découvrez Orova.vn – une plateforme Biz AI Agent dotée de la solution OROVA SEO complète, destinée à tous les sites web. Le système accompagne l'optimisation pour les moteurs de recherche de A à Z, avec les fonctionnalités suivantes : recherche de mots-clés, rédaction de nouveaux articles optimisés pour le SEO, optimisation des contenus existants, suivi des positions, ainsi que l'analyse des concurrents et l'analyse technique approfondie. Inscrivez-vous dès aujourd'hui pour découvrir OROVA SEO entièrement gratuitement (offre valable jusqu'au 7 juillet 2027).
Étape 5 : Valider l'indexation et arbitrer les balises canoniques
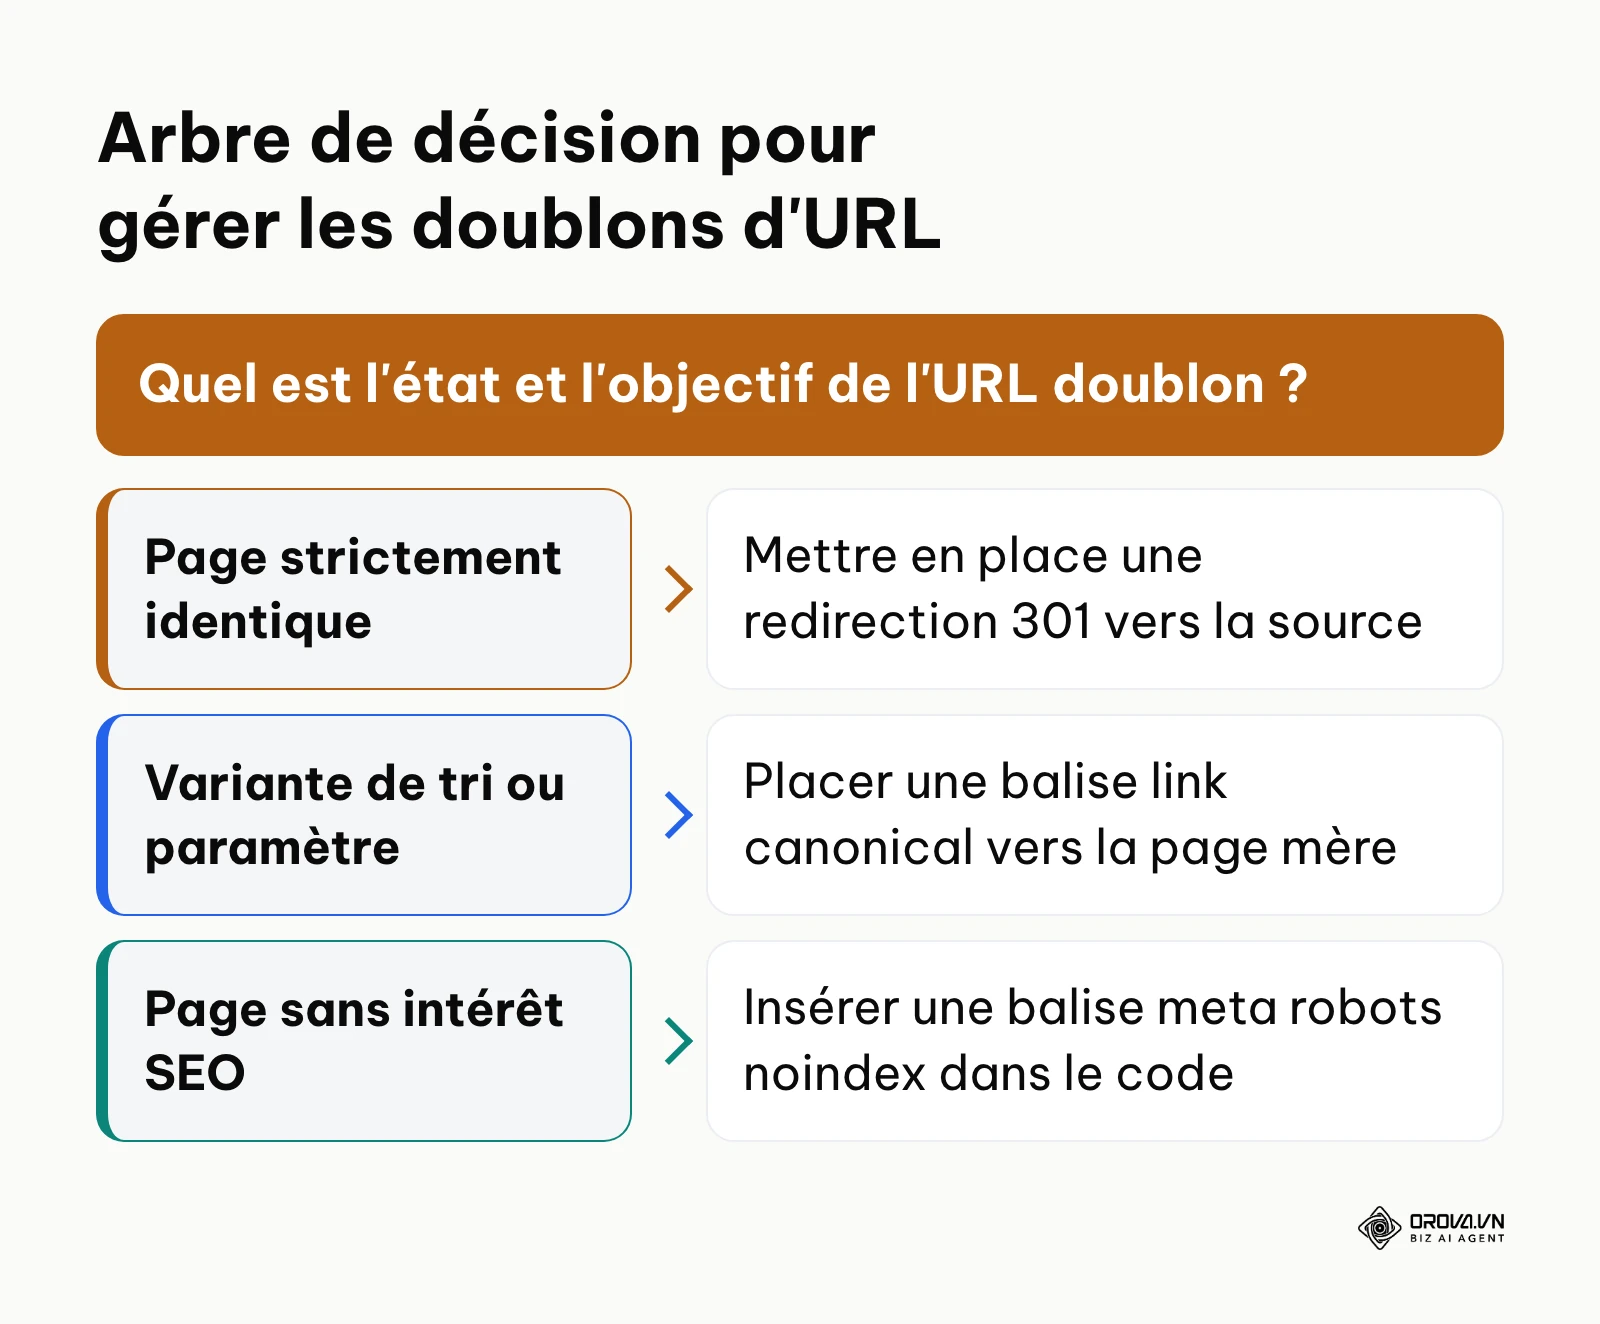
Cette étape consiste à vérifier que Google attribue la propriété du contenu à la bonne adresse URL et intègre celle-ci dans son index inversé. Le schéma ci-dessous résume la méthode d'arbitrage face à des contenus similaires ou dupliqués.
Inspecter l'indexation et les balises
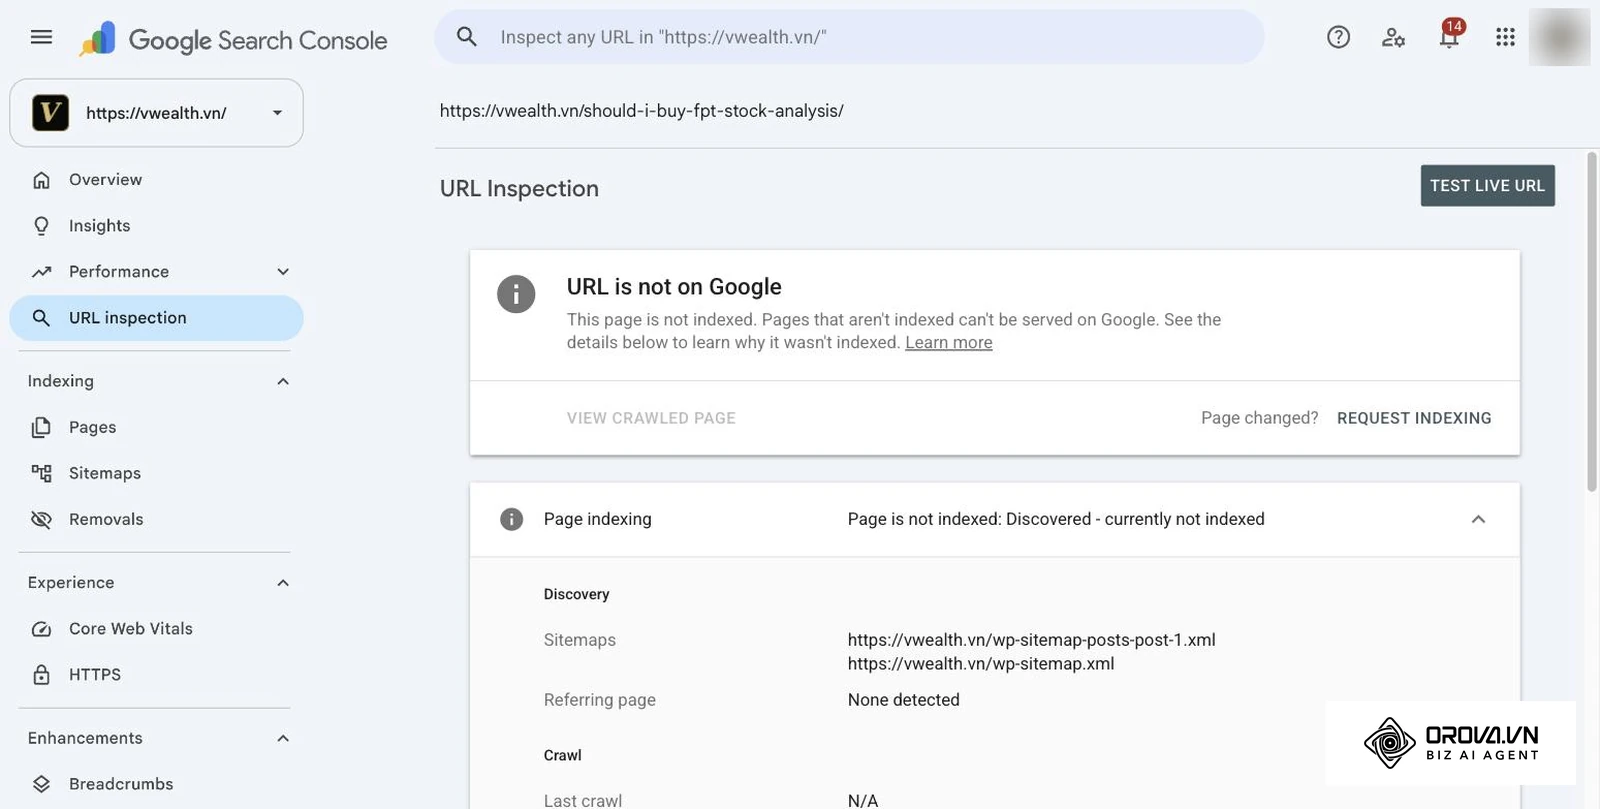
Dans la Search Console, lancez une inspection de votre page d'accueil ou d'un article stratégique. Le panneau supérieur doit indiquer en vert « L'URL est sur Google ».
Descendez dans la sous-section intitulée Indexation des pages pour auditer les paramètres d'équivalence :
- Page canonique déclarée par l'utilisateur : indique l'URL que vous avez inscrite dans la balise canonique (rel="canonical") de votre en-tête HTML.
- Page canonique sélectionnée par Google : indique l'URL que l'algorithme a choisi de retenir comme source originale.
Si ces deux lignes affichent la même adresse, l'arbitrage est parfait. En revanche, si Google sélectionne une autre URL que celle que vous avez déclarée, cela signifie que vos signaux internes sont discordants (par exemple, des liens internes qui pointent massivement vers une version non sécurisée en http ou avec des paramètres d'URL non nettoyés). Pour aller plus loin dans la structuration globale, consultez notre guide complet sur le référencement de site web.
Les conflits majeurs proviennent souvent d'une balise canonical pointant vers une page redirigée en 301 ou vers une page renvoyant un code 404. Veillez à ce que chaque balise canonique pointe exclusivement vers une URL finale, accessible directement en code HTTP 200.
Étape 6 : Structurer le contenu pour les algorithmes de classement
L'objectif de cette étape est de faciliter le travail des systèmes de classement de Google (comme RankBrain, PageRank et les signaux d'utilité du contenu désormais intégrés aux systèmes de classement principaux) en injectant des signaux sémantiques clairs.
Mettre en œuvre le balisage sémantique et les données structurées
La spécification HTML définit les éléments de titre h1 à h6 pour exprimer la hiérarchie d'un document : une structure claire aide les analyseurs à comprendre le contexte. Une bonne pratique consiste à utiliser un titre H1 décrivant le sujet central, suivi d'une structure logique d'intertitres H2 et H3 sans saut de niveau.
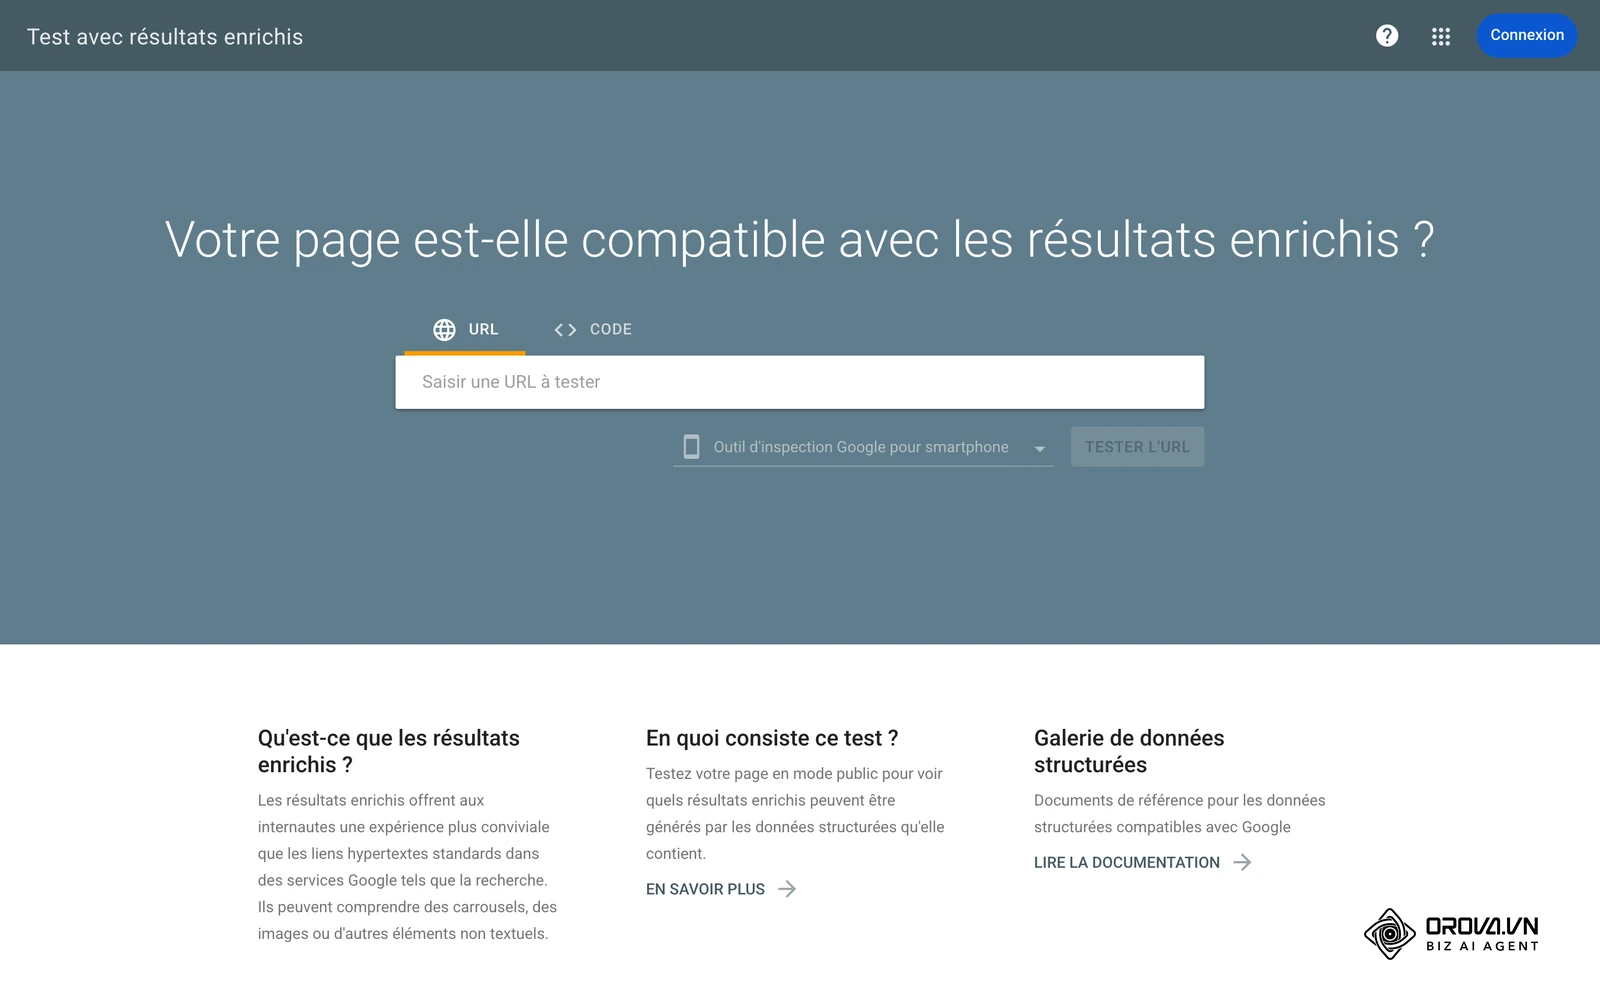
Intégrez ensuite des données structurées au format JSON-LD (format recommandé par Google) dans le code de vos pages. Pour un article d'information, utilisez le schéma Article ou BlogPosting contenant les propriétés headline, datePublished, author et publisher. Vous pouvez valider l'absence d'erreurs de syntaxe en utilisant l'outil officiel de test des résultats enrichis de Google.
Optimiser le maillage interne
Le PageRank continue de circuler à travers les liens hypertextes ordinaires munis d'un attribut href. Pour qu'une page transmette de la puissance à une autre :
- Utilisez des ancres textuelles descriptives de 2 à 5 mots, en bannissant les mentions vagues comme « cliquez ici ».
- Reliez vos articles traitant d'une même thématique au sein d'un cocon sémantique fermé.
- Assurez-vous qu'aucune page importante ne se trouve isolée à plus de trois clics de navigation depuis votre page d'accueil.
Exemple illustratif (cas hypothétique) :
- Contexte : Un média sectoriel publiant 150 guides techniques voit ses positions stagner en milieu de deuxième page malgré des textes approfondis.
- Actions menées : Audit de la profondeur de clics révélant que les pages piliers étaient situées à 6 clics de l'accueil, création d'un bloc de navigation contextuel sur les articles connexes et ajout d'un balisage JSON-LD TechArticle complet.
- Point de blocage et solution : Plusieurs liens internes contenaient un attribut rel="nofollow" inséré par défaut par un composant d'affichage ; le retrait de cet attribut a rétabli la circulation normale du PageRank interne.
- Résultat visible : Les pages mises à jour sont remontées de la position moyenne 18 à la position 6 dans la Search Console sur leurs requêtes cibles en l'espace de six semaines.
Étape 7 : Adapter son contenu aux AI Overviews et à l'extraction sémantique
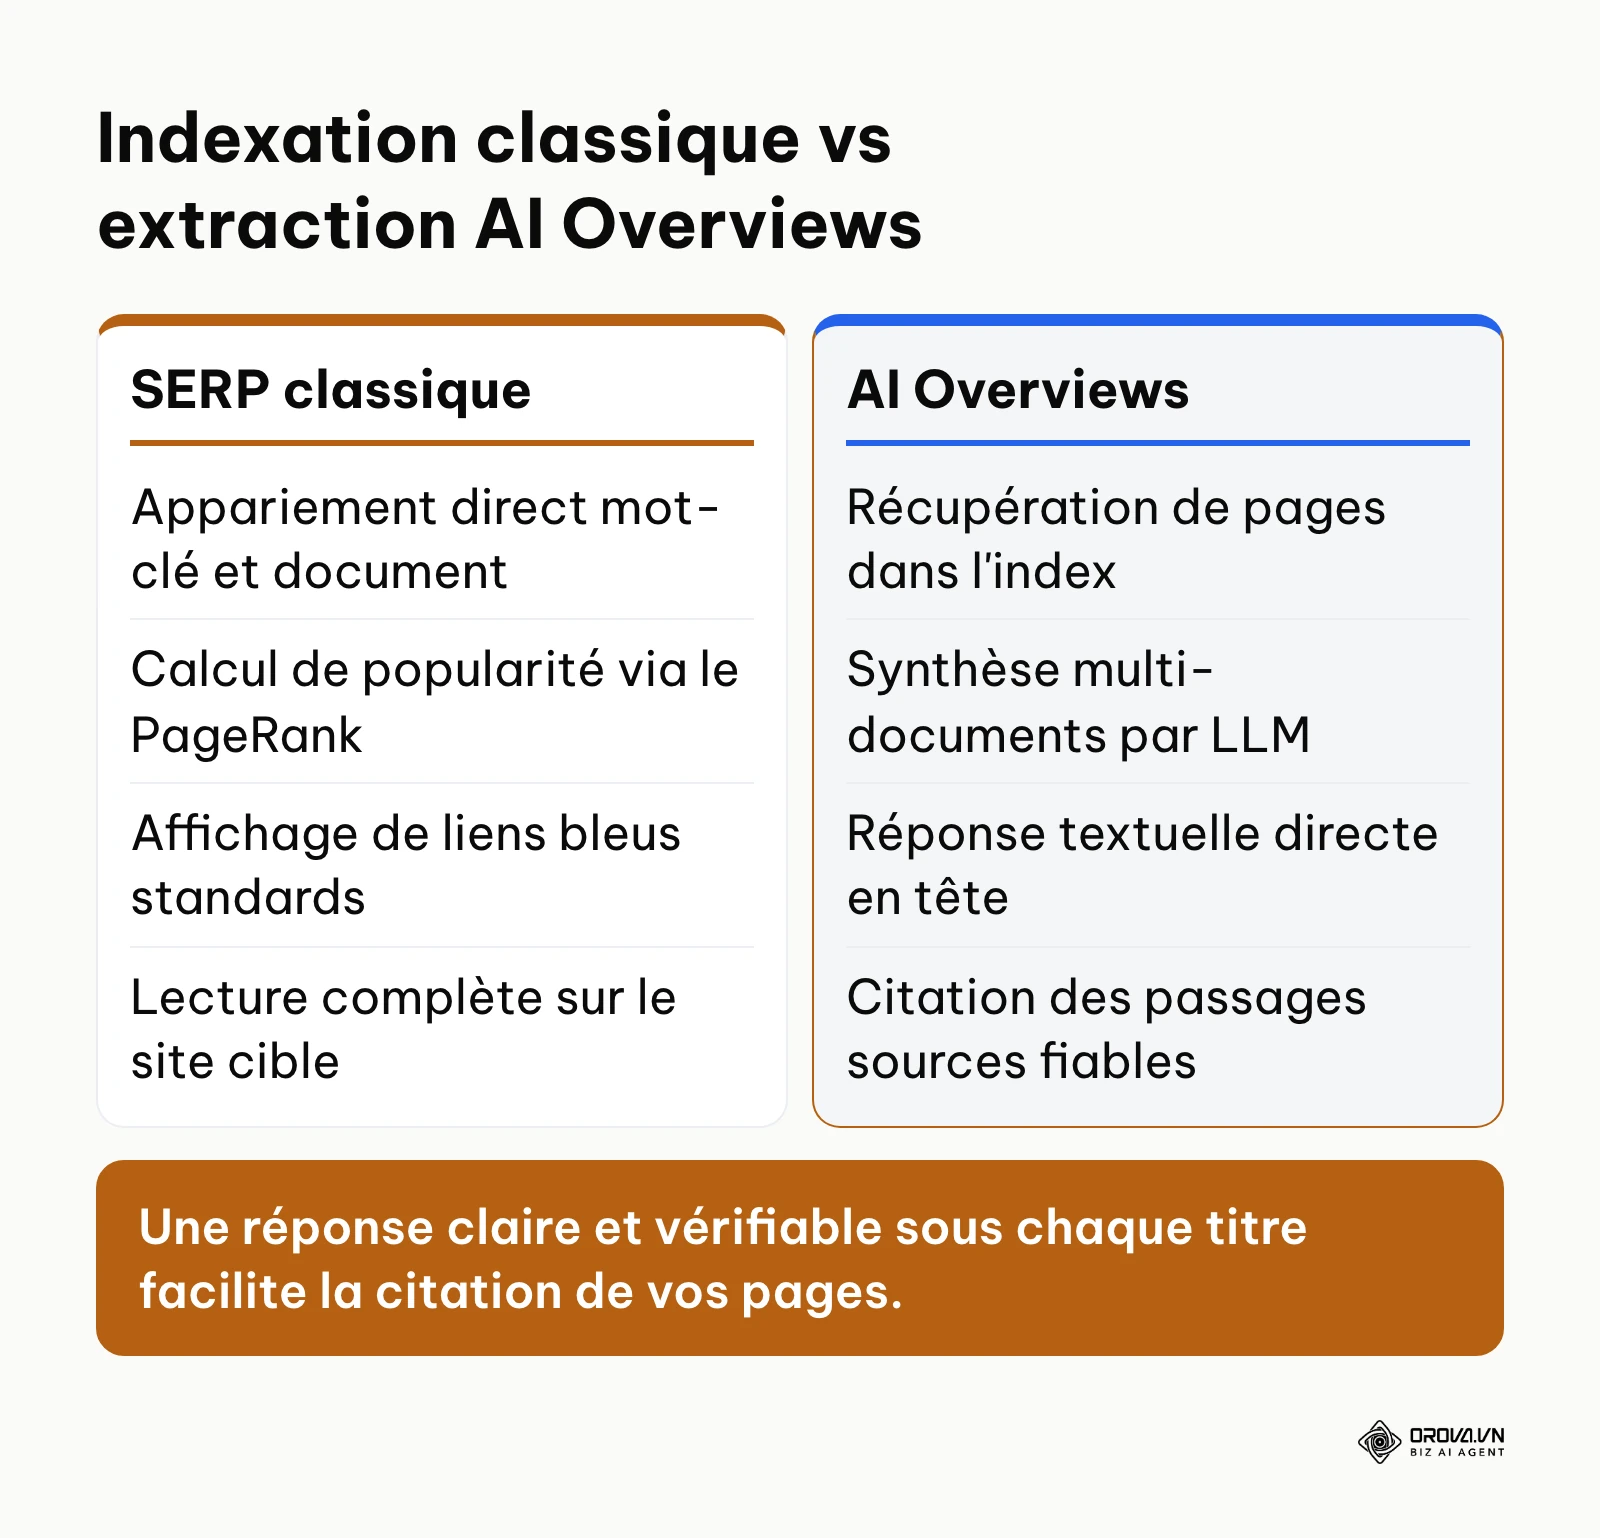
L'objectif consiste à optimiser vos textes pour qu'ils soient sélectionnés comme sources de synthèse par les modèles d'intelligence artificielle de Google. Le schéma ci-dessous résume l'évolution du moteur vers un modèle de synthèse générative.
Le fonctionnement du mécanisme RAG chez Google
Google indique que les AI Overviews s'appuient sur un modèle Gemini personnalisé, associé à ses systèmes de recherche : la synthèse est ancrée dans les résultats issus de l'index, et des liens renvoient vers les pages sources. Ce fonctionnement s'apparente à ce que les ingénieurs appellent le RAG (Retrieval-Augmented Generation) : le moteur récupère d'abord des pages pertinentes dans son index, puis un grand modèle de langage rédige une synthèse directe en haut de la page de résultats.
Pour étudier les caractéristiques de ce format d'affichage, examinez les mécanismes détaillés dans notre analyse sur l'AI Overview de Google.
| Critère d'évaluation | Recherche organique traditionnelle | Extraction pour AI Overviews |
|---|---|---|
| Unité d'analyse principale | Document web complet (page HTML) | Passage textuel autonome (quelques phrases) |
| Facteur de sélection clé | Systèmes de classement (pertinence, qualité, liens) | Pages déjà bien classées dont un passage répond clairement à la question |
| Mode de consommation | L'utilisateur clique sur le lien pour lire | L'utilisateur lit la synthèse générée sur la SERP |
| Visibilité accordée | Titre bleu, URL et court extrait | Lien source cliquable à côté ou sous la synthèse |
Rédiger pour l'extraction de données
Pour maximiser vos chances d'apparaître dans les sources citées par ces blocs d'intelligence artificielle :
- Placez une définition ou une réponse factuelle de quelques phrases immédiatement sous chaque titre H2 formulé sous forme de question.
- Utilisez des listes à puces ordonnées pour les procédures séquentielles et des tableaux markdown pour les données comparatives.
- Évitez les formules de remplissage et les métaphores floues qui perturbent l'extraction automatique des entités nommées.
Checklist récapitulative des étapes techniques
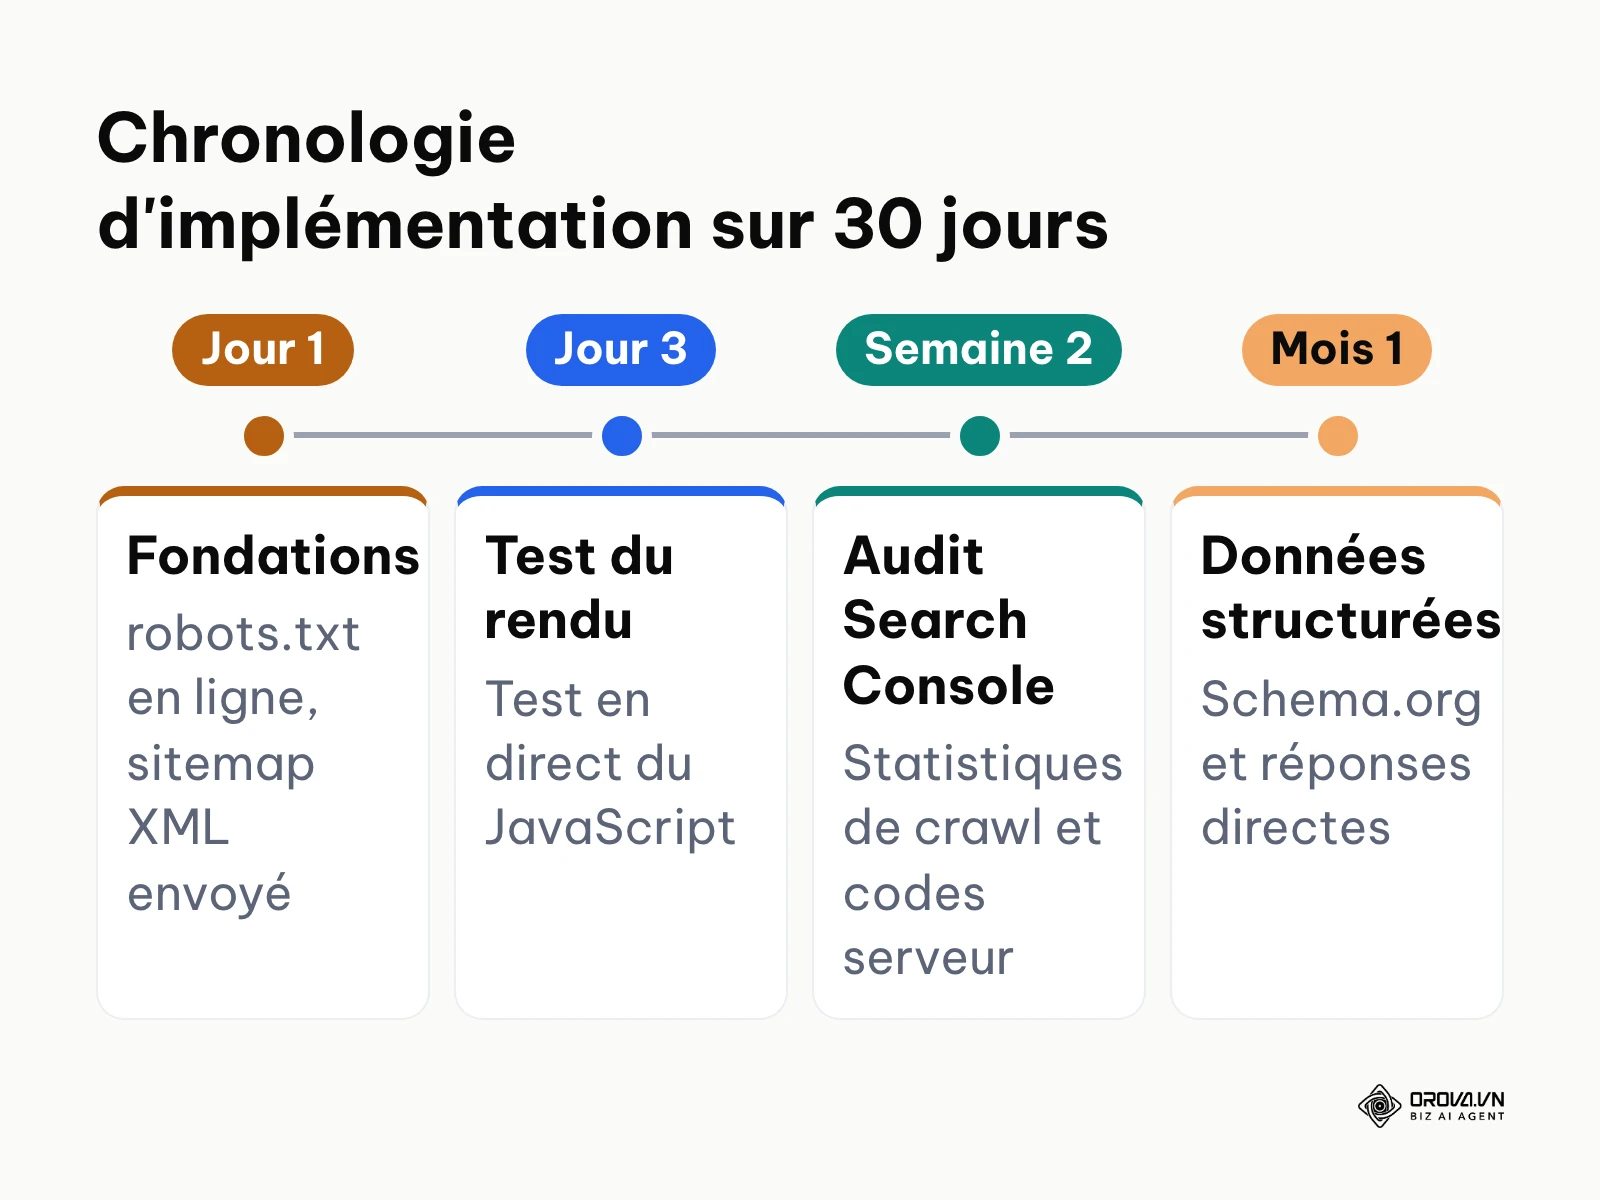
Ce tableau de synthèse vous permet de valider le bon déroulement de chaque phase technique et de vérifier les critères de réussite. Le schéma ci-dessous résume le cadencement recommandé pour appliquer l'ensemble des optimisations.
| Étape | Action principale | Critère de validation visuel | Temps estimé |
|---|---|---|---|
| 1. Robots.txt | Configurer les autorisations d'exploration | Affichage en texte brut avec code 200 sur votresite.com/robots.txt | 20 minutes |
| 2. Sitemap XML | Soumettre le plan de site dans la Search Console | Statut vert « Opération effectuée » et nombre d'URL détectées | 15 minutes |
| 3. Statistiques de crawl | Auditer les codes HTTP serveur et le budget | Grande majorité de codes 200 et temps de réponse moyen stable | 30 minutes |
| 4. Rendu JavaScript | Tester l'exécution du code dynamique | Présence du texte complet dans l'onglet HTML du test en direct | 25 minutes |
| 5. Balises canoniques | Aligner les versions déclarées et sélectionnées | Concordance parfaite entre URL déclarée et URL choisie par Google | 20 minutes |
| 6. Données structurées | Intégrer les balises Schema.org et le maillage | Validation sans avertissement sur l'outil officiel des résultats enrichis | 30 minutes |
| 7. Format AI Overviews | Structurer les réponses directes sous les titres | Réponse directe de quelques phrases identifiable sous chaque H2 | 25 minutes |
Avec OROVA.VN et le module OROVA SEO, vous mettez définitivement fin aux journées épuisantes de travail manuel. Au lieu de passer des heures à rédiger des articles et à préparer des rapports, l'ensemble du processus est désormais optimisé et bouclé en seulement 5 minutes.
Erreurs courantes sur la Search Console et solutions
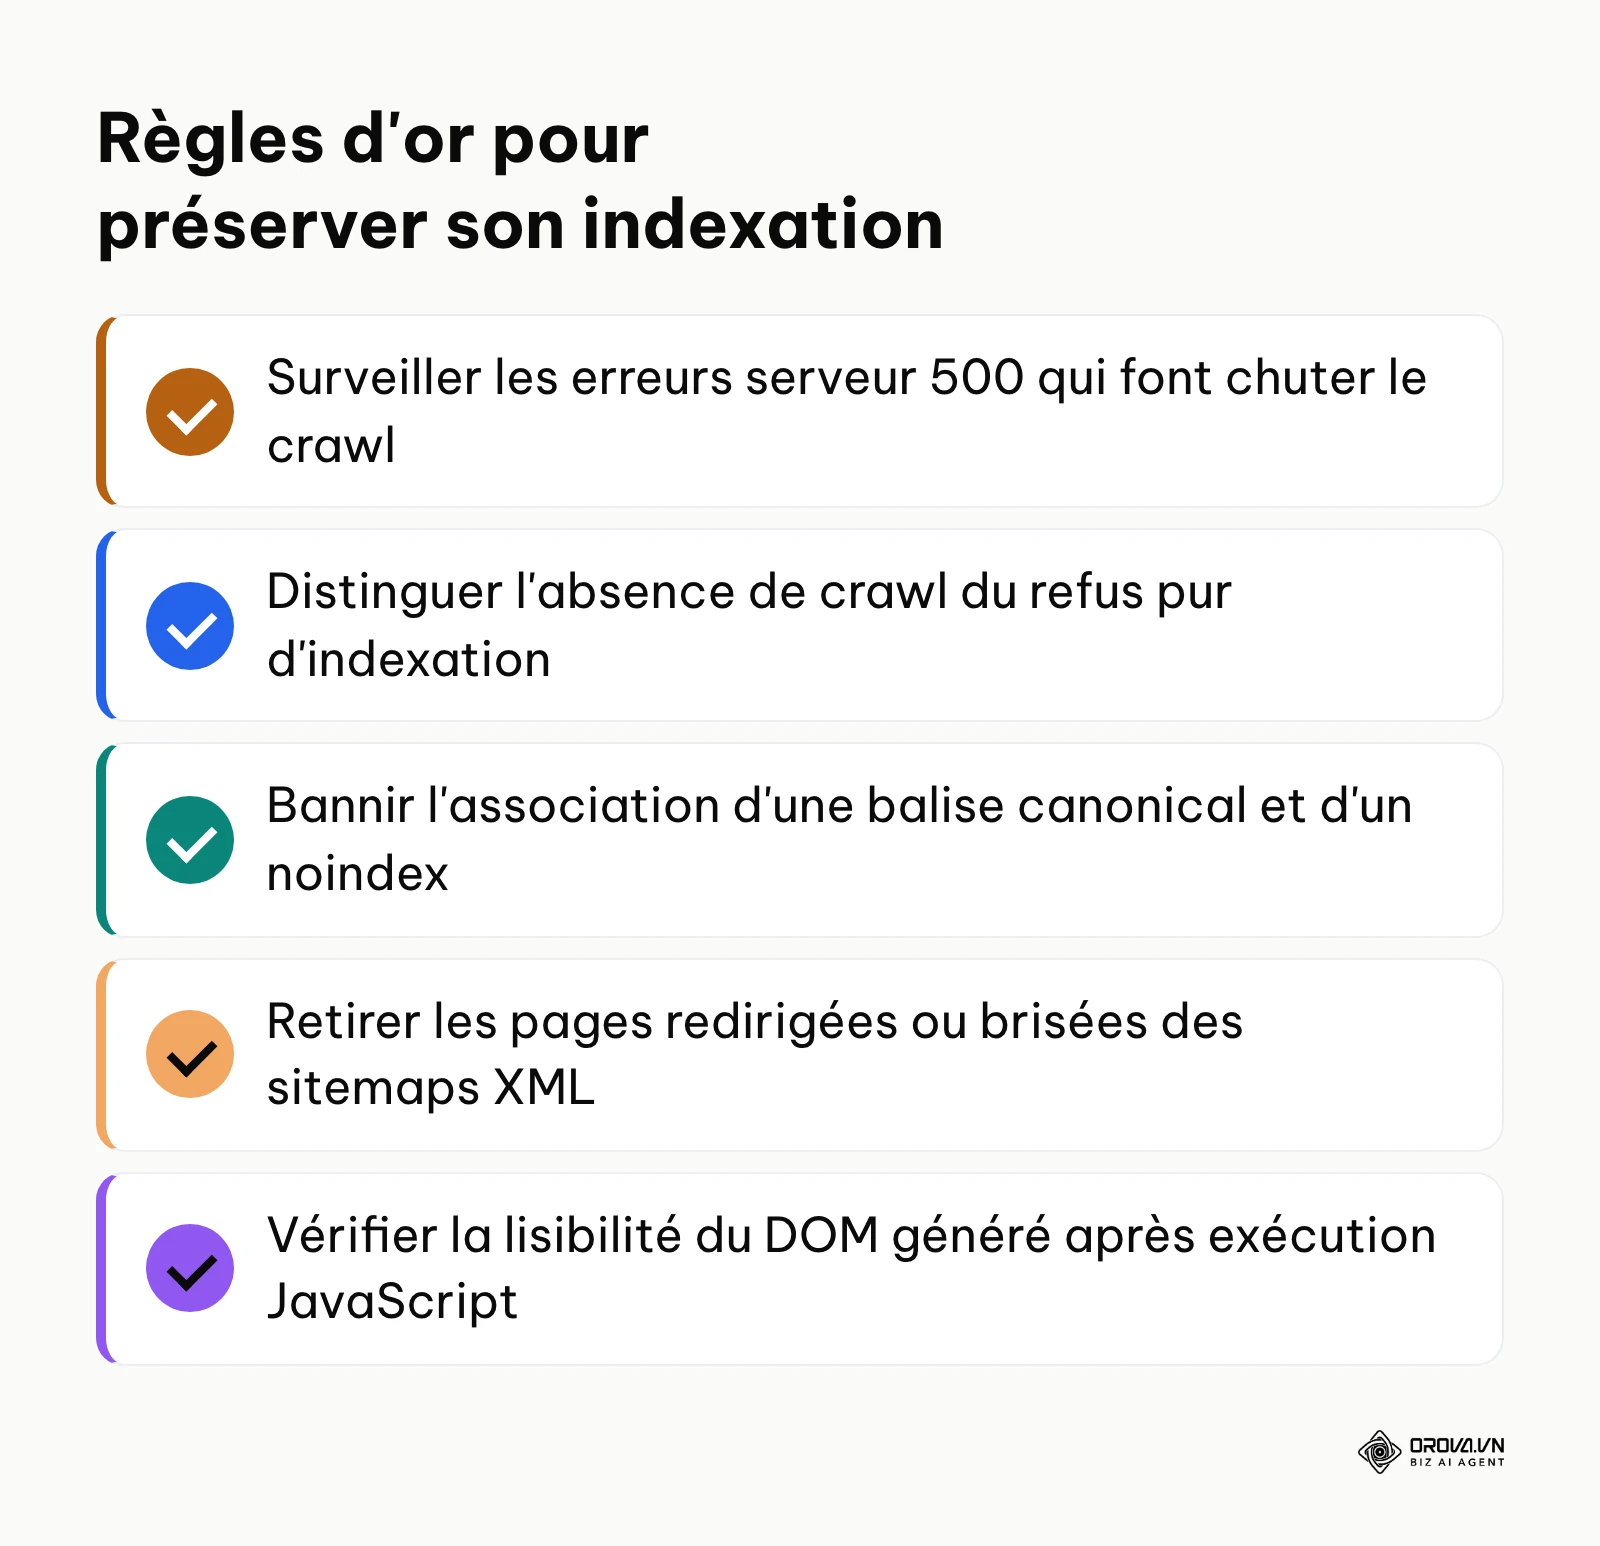
Le tableau ci-dessous répertorie les six anomalies techniques les plus fréquentes relevées dans les rapports de la Google Search Console, avec leur stade d'apparition et leur protocole de correction. Le schéma ci-dessous résume les bonnes pratiques pour éliminer durablement les erreurs d'exploration.
| Erreur Search Console | Étape technique | Cause racine | Action corrective |
|---|---|---|---|
| Détectée, actuellement non indexée | Exploration (Crawl) | Googlebot a découvert l'URL mais a reporté l'exploration par manque de budget ou qualité perçue trop faible | Renforcer les liens internes pointant vers la page depuis des contenus populaires et améliorer la valeur informative du texte |
| Explorée, actuellement non indexée | Indexation (Index) | Le robot a lu le code source mais a jugé le contenu trop pauvre, dupliqué ou dépourvu d'intérêt | Réécrire le contenu pour apporter des données uniques ou rediriger l'URL en 301 si elle fait doublon avec une autre page |
| Page avec redirection | Exploration / Indexation | Une URL soumise dans le sitemap XML renvoie un code de redirection 301 ou 302 vers une autre adresse | Mettre à jour le fichier sitemap pour n'y conserver que les URL finales de destination répondant en code 200 |
| Bloquée par le fichier robots.txt | Exploration (Crawl) | Une directive Disallow empêche explicitement Googlebot d'accéder au document | Éditer le fichier robots.txt pour retirer le chemin de la page ou vérifier la portée des caractères génériques |
| Exclue par la balise noindex | Indexation (Index) | Présence d'une balise meta robots noindex dans le code source ou d'un en-tête X-Robots-Tag serveur | Supprimer la directive noindex dans les réglages de votre extension SEO ou dans la configuration du serveur |
| Introuvable (404) | Exploration (Crawl) | Le robot suit un lien interne cassé ou un lien externe pointant vers une ressource supprimée | Restaurer la page d'origine, corriger le lien source ou créer une redirection 301 vers un contenu étroitement équivalent |
Mesurer les résultats après le déploiement
Pour vérifier que vos ajustements portent leurs fruits, surveillez deux rapports fondamentaux dans votre Google Search Console :
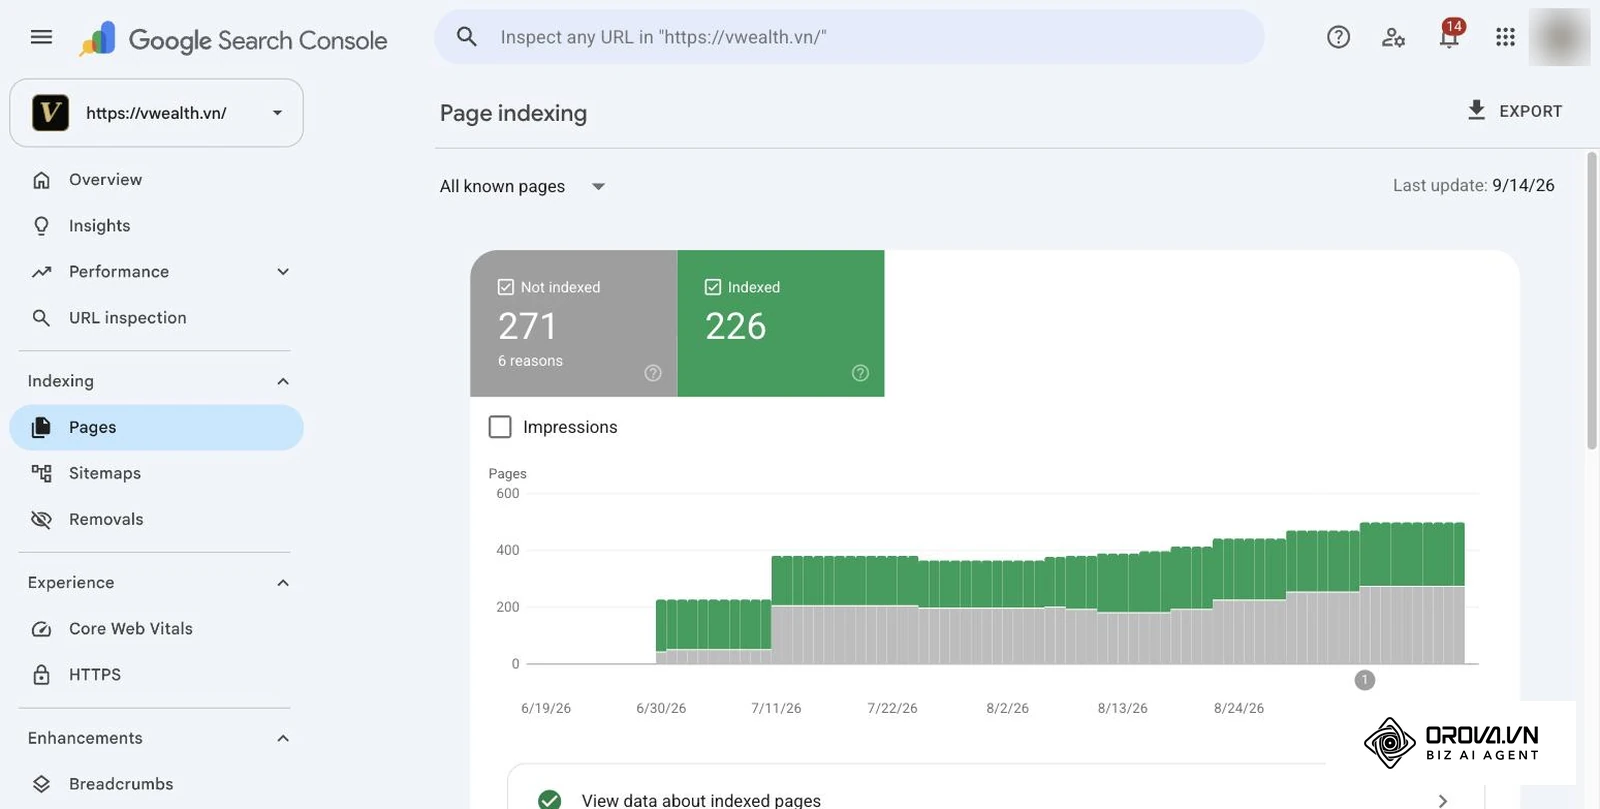
- Le rapport Indexation > Pages : suivez la courbe des pages indexées. Les corrections d'anomalies se traduisent par une augmentation graduelle du nombre de pages valides et une résorption des catégories d'exclusion en l'espace de deux à quatre semaines.
- Le rapport Performances : observez les impressions totales et le taux de clic moyen (CTR). Une meilleure prise en compte des données structurées génère souvent une hausse des impressions dès les premiers recalculs d'indexation.
Le rythme de traitement dépend directement de la notoriété de votre domaine. Alors qu'un site établi voit souvent ses modifications explorées rapidement, un site jeune doit généralement patienter plusieurs semaines avant que les systèmes de classement réévaluent l'ensemble de ses signaux de qualité.
Tendances du fonctionnement de Google dans les prochaines années : avis de l'auteur
Selon moi, la transformation du moteur de recherche vers un système de réponse conversationnelle directe va profondément modifier l'équilibre du trafic web dans les années à venir.
Je constate d'abord aujourd'hui une accélération sans précédent des recherches sans clic (« zero-click searches »). Alors que Google se contentait autrefois d'aiguiller les internautes vers des sites tiers, il extrait désormais la substantifique moelle des textes pour la présenter au sein même de la SERP via les AI Overviews. À mon sens, d'ici deux à trois ans, le modèle économique de l'indexation traditionnelle ne suffira plus à maintenir le volume de clics organiques des sites généralistes d'information. Pour préserver leur visibilité, les créateurs de contenu devront se positionner comme des sources de données primaires indiscutables que les modèles de langage sont contraints de citer nommément pour garantir leur propre exactitude.
Je pense également que le coût énergétique et computationnel du web rendering va forcer Google à durcir drastiquement ses quotas d'exploration sur les sites lents ou mal optimisés. Les plateformes reposant sur des architectures JavaScript monolithiques et lourdes sans rendu côté serveur risquent de voir leurs délais d'indexation passer de quelques jours à plusieurs semaines. Les webmasters doivent impérativement rationaliser leur code et privilégier la distribution de pages pré-rendues légères dès aujourd'hui.
Enfin, j'estime que le concept historique de PageRank fondé uniquement sur les rétroliens va progressivement s'effacer au profit d'un score de réputation d'entité sémantique calculé par intelligence artificielle. Si cette transition se confirme, l'acquisition artificielle de liens perdra toute efficacité face à la cohérence de l'expertise démontrée sur un sujet précis. Cette analyse pourrait toutefois s'avérer inexacte si les contraintes juridiques liées aux droits d'auteur ou les régulations antitrust internationales imposaient à Google de limiter l'exposition de ses modules génératifs.
Foire aux questions sur comment fonctionne Google
Comment Googlebot découvre-t-il les nouvelles pages web ?
Googlebot découvre de nouvelles pages principalement en suivant les liens hypertextes présents sur les sites qu'il connaît déjà et en analysant les fichiers sitemaps XML soumis par les propriétaires de sites. Une page qui n'est reliée par aucun lien et absente du sitemap reste souvent invisible pour le robot ; l'outil d'inspection d'URL de la Search Console permet aussi de demander l'exploration d'une adresse précise.
Pourquoi ma page affiche-t-elle le statut « Détectée, actuellement non indexée » ?
Cette notification indique que Googlebot a bien identifié l'URL dans un lien ou un sitemap, mais qu'il a choisi de ne pas allouer de ressources d'exploration immédiates pour la visiter. Cette situation survient généralement lorsque le serveur présente des temps de chargement trop longs ou lorsque l'autorité globale du site ne justifie pas un passage prioritaire.
Quelle est la différence entre l'exploration (crawl) et l'indexation ?
L'exploration consiste pour le robot à parcourir le web pour télécharger le code source et les ressources d'une page afin d'en prendre connaissance. L'indexation est l'étape ultérieure où le moteur analyse, classe et stocke le contenu textuel et sémantique de cette page dans sa gigantesque base de données centrale appelée l'index inversé.
Comment Google traite-t-il les sites développés en JavaScript ?
Googlebot prend en charge les applications développées en JavaScript via son Web Rendering Service qui exécute les scripts à l'aide d'un moteur Chromium headless. Toutefois, cette opération est différée dans une seconde vague d'indexation qui peut retarder la prise en compte du contenu généré dynamiquement par rapport au code HTML statique.
Quel est l'impact de l'intelligence artificielle sur le classement des résultats ?
L'intelligence artificielle intervient à tous les niveaux de l'algorithme, notamment à travers RankBrain pour décoder le sens des requêtes et des signaux d'utilité du contenu, aujourd'hui intégrés aux systèmes de classement principaux. Elle génère également les résumés AI Overviews à partir de pages indexées, avec des liens vers les sources.
Combien de temps Google met-il pour indexer un nouveau site web ?
Le délai d'indexation d'un nouveau site varie généralement de quelques jours à environ quatre semaines selon la qualité de l'architecture technique et la présence de liens externes pointant vers le domaine. La soumission manuelle d'un sitemap XML validé dans la Search Console permet d'accélérer significativement la découverte des premières pages.
Par quoi commencer ?
Pour passer à l'action sans vous disperser, identifiez d'abord la situation qui correspond à votre projet parmi les trois cas de figure ci-dessous.
Si vous venez de publier un site web entièrement neuf qui ne reçoit aucun trafic, votre unique priorité pour cette première demi-journée est de valider votre propriété dans la Google Search Console et de soumettre votre sitemap XML. Vérifiez dans la foulée que votre fichier robots.txt ne comporte aucune directive de blocage globale.
Si vous exploitez déjà un site existant mais que vous faites face à une stagnation de vos pages indexées, concentrez votre effort sur l'audit du rapport Pages de la Search Console. Isolez les URL marquées comme « Explorées, actuellement non indexées » pour réécrire leurs paragraphes d'introduction et supprimer les balises de duplication qui parasitent vos signaux.
Si vous gérez un catalogue de grande taille comportant des milliers de pages dont le crawl semble ralenti, consacrez votre après-midi à l'analyse des statistiques d'exploration dans les paramètres de votre console. Bloquez immédiatement l'accès des robots aux facettes de tri inutiles via votre robots.txt et supprimez les chaînes de redirections pour soulager votre serveur.
En appliquant avec rigueur cette séquence de vérifications techniques, vous alignez précisément votre plateforme sur les exigences réelles dictant comment fonctionne Google.
About the author
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Pilotez votre activité avec des AI Agents
Orova est le Biz AI Agent qui ne s'arrête jamais : il planifie, exécute et optimise le travail à votre place.
Gagnez du temps, gagnez en efficacité.