
Comment indexer une page sur Google : robots, sitemap, canonical et inspection
Vous venez de passer des heures à structurer et rédiger un article parfait, optimisé et hautement pertinent, mais après plusieurs jours d'attente, il reste obstinément invisible dans les moteurs de recherche. Savoir comment indexer une page sur google est la compétence fondamentale en SEO, car sans cette étape, aucun trafic organique n'est possible. La plupart des tutoriels en ligne se contentent de recommandations passives, comme soumettre un sitemap et attendre. Cependant, cette approche passive ne suffit plus face à un écosystème web saturé et à des algorithmes de plus en plus sélectifs concernant le budget d'exploration. Cet article technique approfondi s'adresse aux professionnels et aux éditeurs de sites qui veulent comprendre les mécanismes profonds des robots d'exploration. Nous allons suivre le parcours complet d'une URL, de robots.txt au sitemap, de la balise canonical à l'inspection d'URL et au maillage interne, et surtout vous fournir une méthodologie précise pour débloquer les erreurs techniques les plus frustrantes qui maintiennent vos pages dans l'ombre. Si vous refusez de laisser la visibilité de votre contenu au hasard, ce guide vous redonne le contrôle.
Comment indexer une page sur Google : Les principes fondamentaux
Indexer une page consiste à demander aux robots de Google d'explorer votre contenu, de l'analyser et de l'ajouter à leur base de données. Vous devez agir activement lorsque le site est récent, que le budget de crawl est limité, ou qu'une mise à jour stratégique doit être reflétée immédiatement.
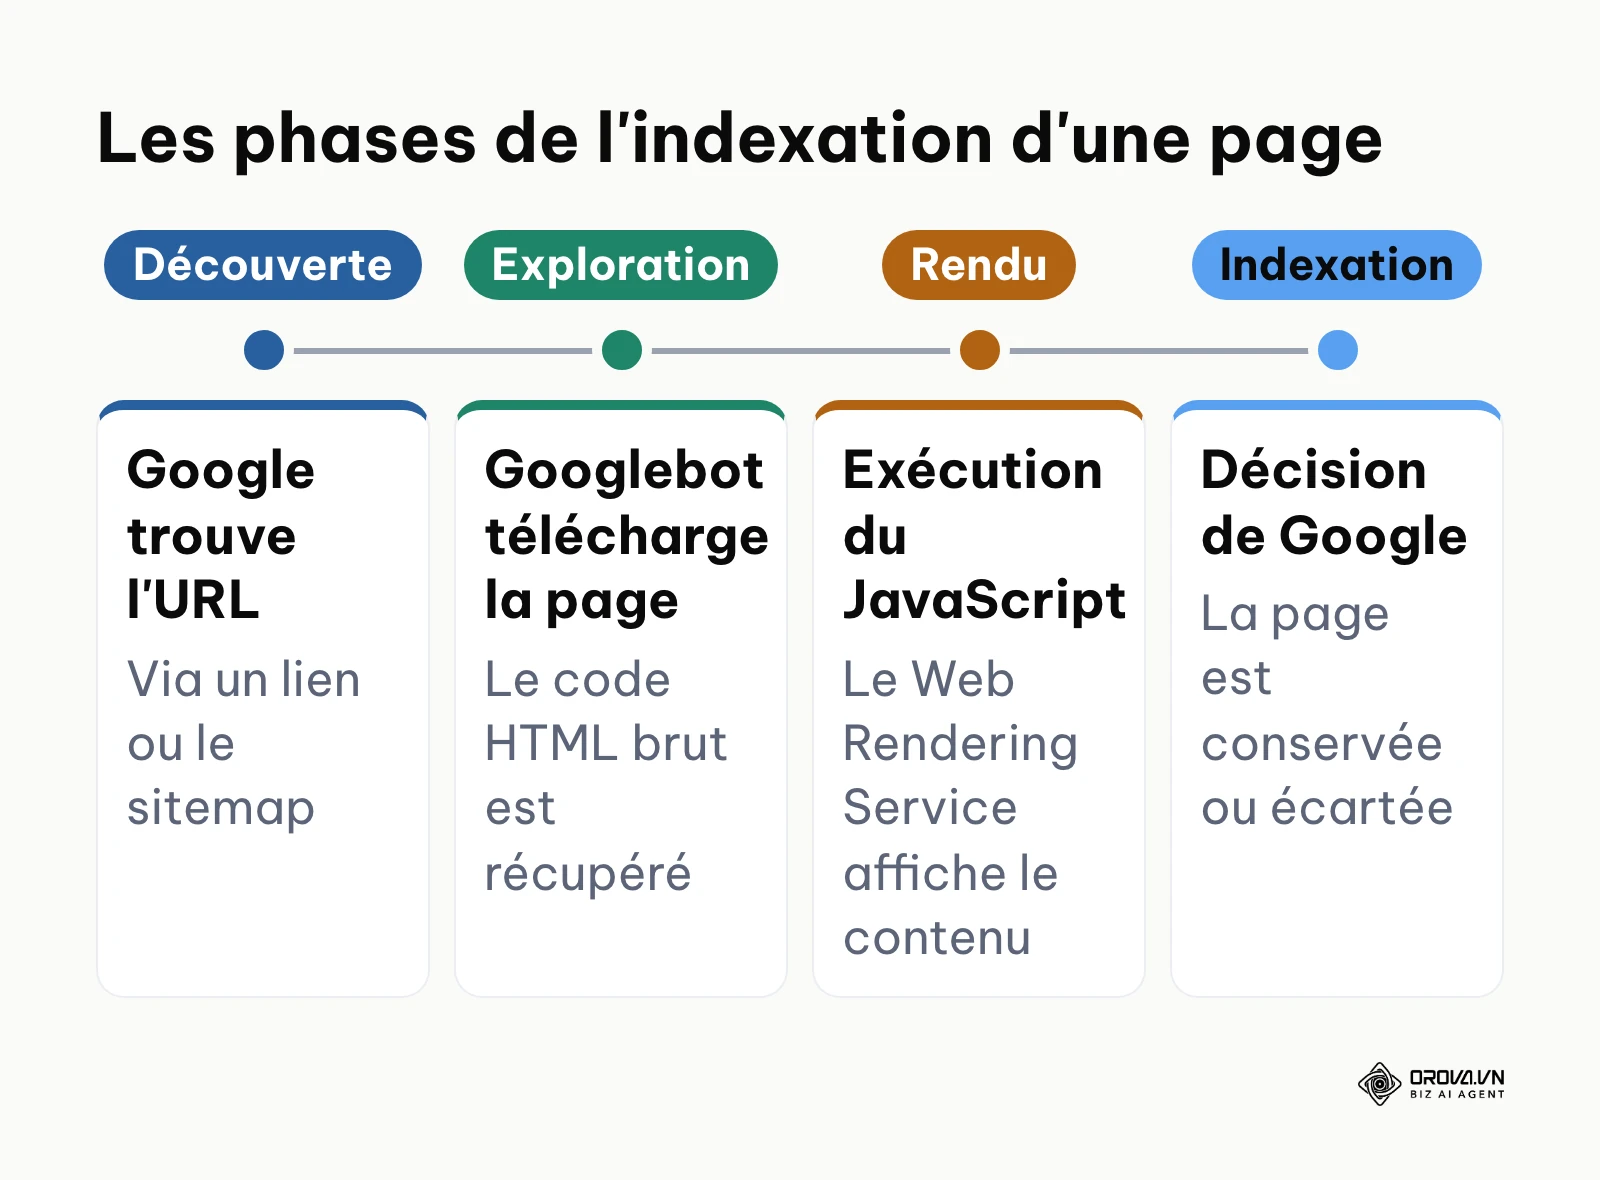
L'indexation n'est pas un droit automatique, c'est un privilège accordé par le moteur de recherche après une évaluation stricte de votre contenu et de votre infrastructure. Le processus se déroule en trois phases distinctes : la découverte, l'exploration (crawl) et l'indexation. Lors de la découverte, Googlebot trouve l'existence de votre URL via un lien ou un sitemap. Lors de l'exploration, il télécharge le code source de la page. Enfin, lors de l'indexation, il analyse le sens du contenu, exécute le JavaScript éventuel, et décide si la page mérite d'être conservée dans l'index principal.
Ce que beaucoup de webmasters ignorent, c'est le concept de l'indexation en deux vagues (two-wave indexing). Dans la première vague, Googlebot indexe rapidement le code HTML brut. Si votre site dépend massivement du JavaScript pour afficher son contenu principal, la page est placée dans une file d'attente pour le service de rendu web (Web Rendering Service). Selon les ressources disponibles, ce rendu peut retarder la prise en compte du contenu principal. Comprendre ces principes fondamentaux est essentiel pour diagnostiquer pourquoi une page stagne et pour choisir la méthode d'accélération la plus appropriée.
Préparation : Les prérequis avant de forcer l'indexation
Avant de chercher à forcer indexation google avec des méthodes agressives, vous devez absolument vérifier que votre environnement technique ne bloque pas silencieusement les robots. Sans cette préparation, toutes vos requêtes seront rejetées en amont.
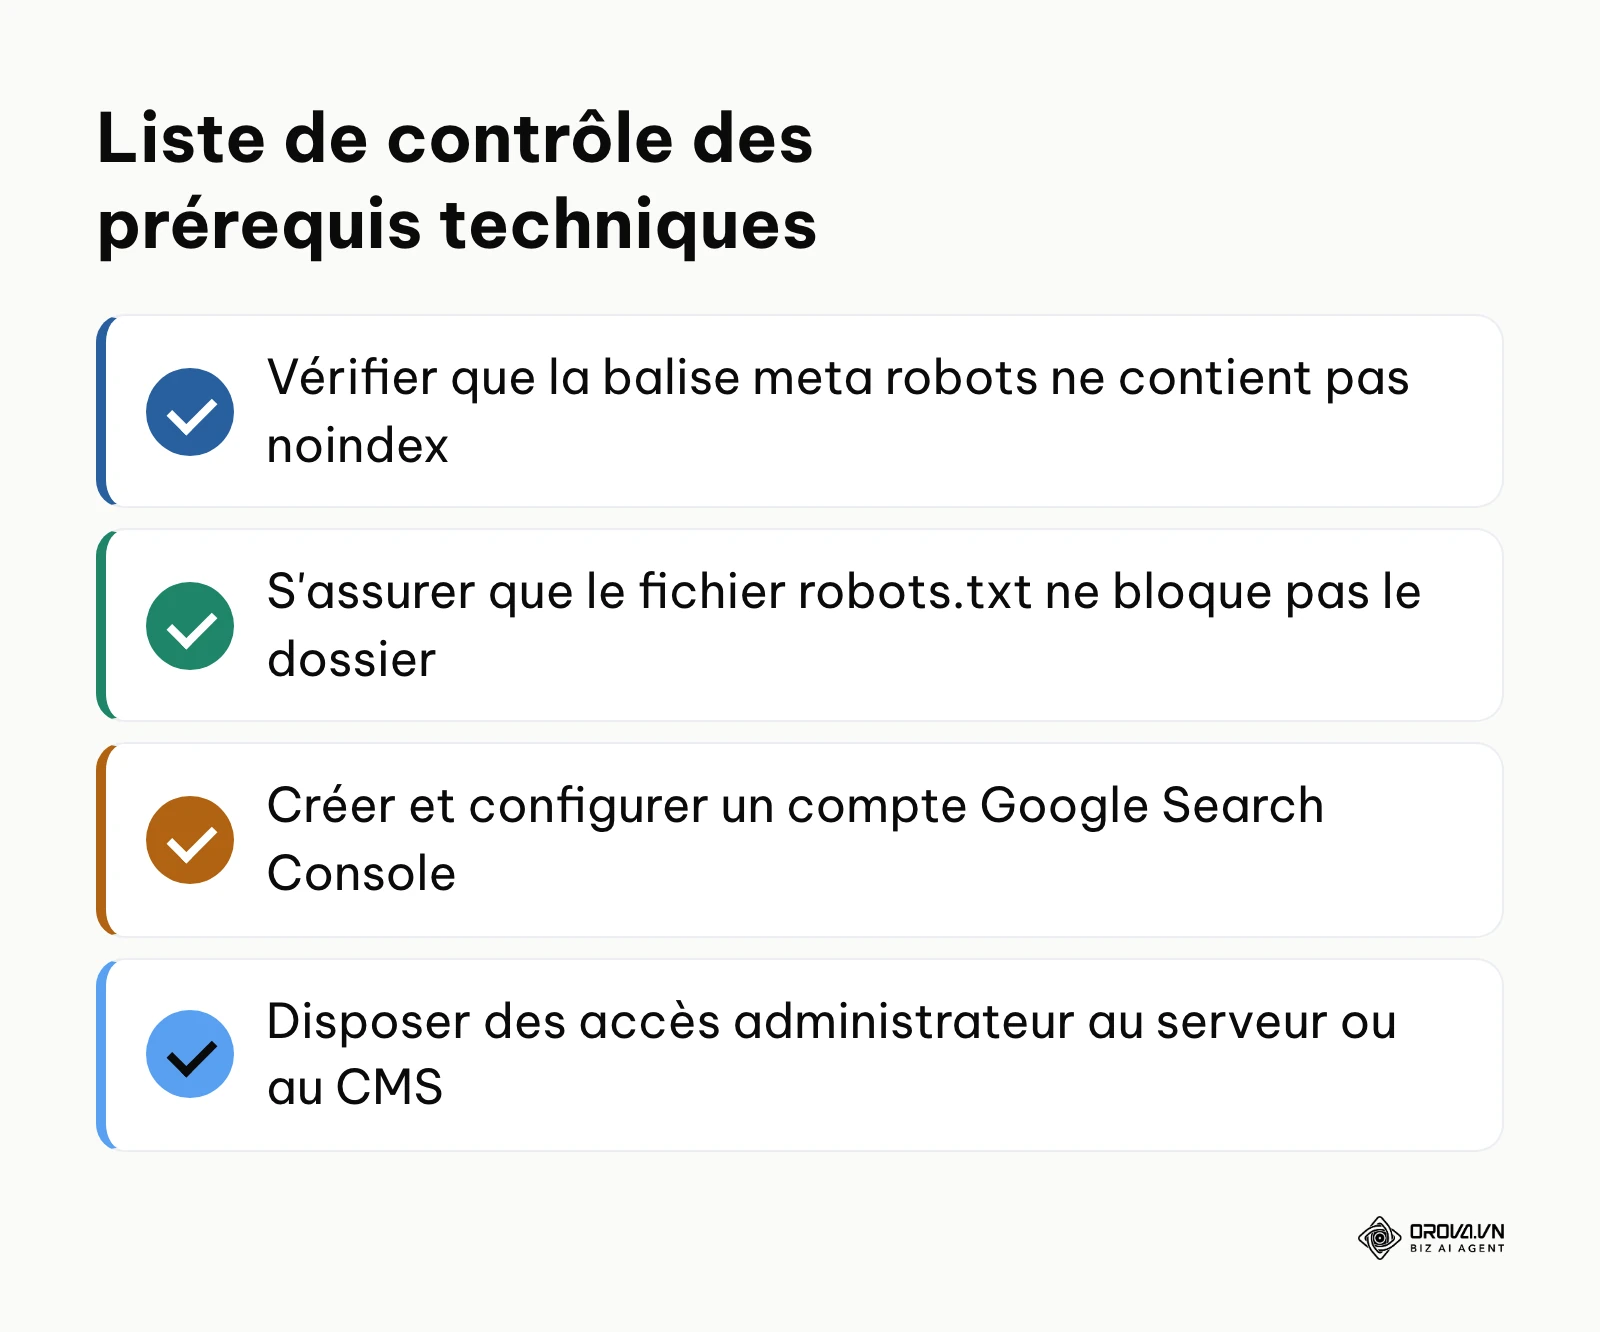
Le blocage le plus commun provient de directives contradictoires. Vous devez vous assurer que votre serveur, votre système de gestion de contenu (CMS) et vos en-têtes HTTP envoient des signaux clairs et positifs aux moteurs de recherche. Si vous demandez à Google d'indexer une page alors que votre fichier de configuration lui interdit techniquement l'accès, vous gaspillez votre budget de crawl et réduisez la confiance que le moteur accorde à votre domaine. Il est impératif de réaliser un audit seo technique régulier pour s'assurer que ces fondations restent solides au fil du temps.
| Élément à préparer | Où le vérifier ou l'obtenir | Temps estimé |
|---|---|---|
| Fichier robots.txt permissif | À la racine de votre site (votresite.com/robots.txt) | 5 minutes |
| Absence de balise "noindex" | Dans le code source HTML (section <head>) | 2 minutes |
| Compte Google Search Console | Créer un compte sur search.google.com et valider la propriété | 15 minutes |
| Architecture sans liens cassés | Outil d'exploration (crawler) type Screaming Frog ou équivalent | 30 minutes |
| En-tête X-Robots-Tag propre | Dans les réponses HTTP du serveur (via l'inspecteur réseau du navigateur) | 10 minutes |
| Vitesse de réponse du serveur | Outil PageSpeed Insights (objectif : TTFB inférieur à 200ms) | 10 minutes |
Cette liste de contrôle garantit que lorsque vous ouvrirez les portes, aucun obstacle invisible ne viendra bloquer le chemin de Googlebot. Si l'un de ces éléments est défaillant, les étapes suivantes seront totalement inefficaces. Assurez-vous que votre page renvoie bien un code HTTP 200 (Succès) et non un code 404 (Introuvable) ou 500 (Erreur serveur) au moment où vous lancez vos actions.
Les 7 étapes pour indexer et forcer l'indexation de vos URL
La maîtrise de l'indexation repose sur une combinaison de méthodes manuelles, d'automatisation technique et de signaux de popularité. Chaque étape ci-dessous joue un rôle spécifique, de la simple notification à l'optimisation profonde de votre structure.
Étape 1 : Soumettre l'URL via l'Inspection d'URL dans Google Search Console
L'utilisation de la google search console est la première étape et la méthode la plus directe pour communiquer avec Google. L'outil d'inspection d'URL permet de vérifier le statut exact d'une page spécifique et de demander explicitement son passage.
Pour procéder, connectez-vous à votre propriété dans la Search Console. Dans la barre de recherche supérieure, collez l'URL exacte que vous souhaitez faire indexer et validez. L'outil interrogera l'index en temps réel. Si la page affiche "L'URL n'est pas sur Google", cliquez sur le bouton "Demander l'indexation". Le système effectuera un test rapide en direct pour s'assurer qu'il n'y a pas d'erreurs techniques bloquantes (comme un noindex ajouté récemment), puis ajoutera votre URL à sa file d'attente d'exploration. Le signe que l'action a réussi est l'apparition du message confirmant l'ajout à la file d'attente.
Cependant, cette méthode a ses limites. Google impose des quotas stricts sur le nombre de requêtes manuelles que vous pouvez effectuer quotidiennement pour éviter les abus. De plus, une erreur courante consiste à cliquer frénétiquement sur ce bouton tous les jours. Si la page n'est pas indexée après une première demande, répéter l'action ne changera rien. Ce bouton ne force pas l'indexation finale, il force seulement le crawl de découverte.
Étape 2 : Vérifier la balise canonical et l'URL retenue par Google
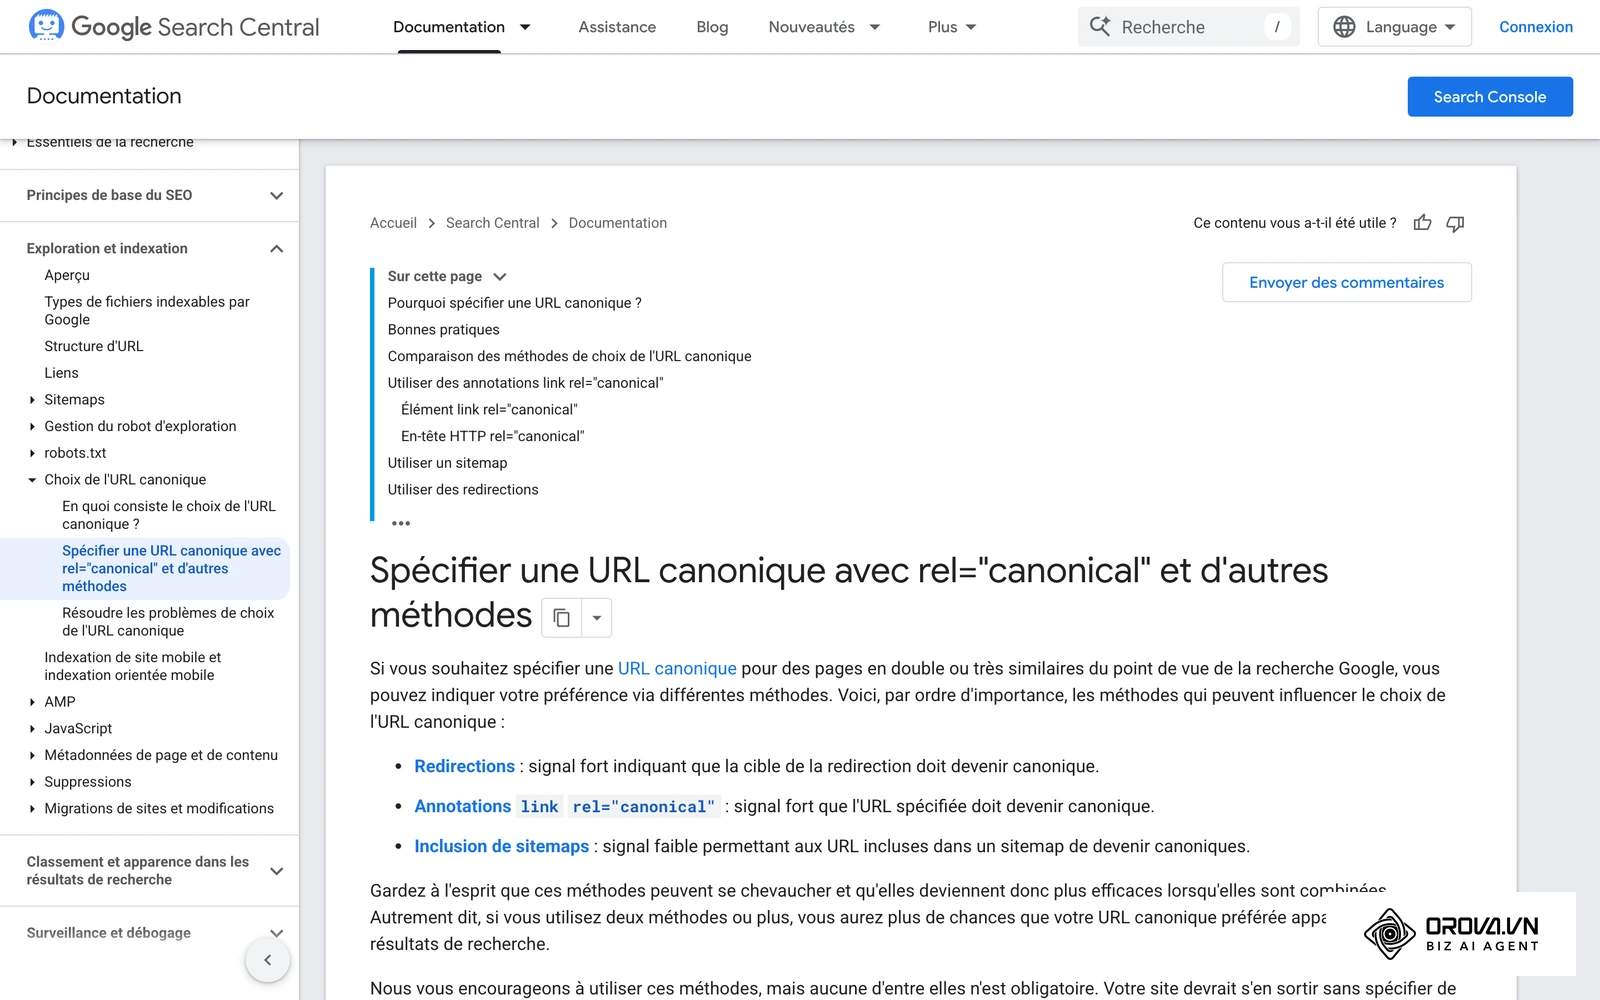
Une page ne peut pas être indexée sous sa propre adresse si elle désigne une autre URL comme version principale. Avant d'aller plus loin, assurez-vous que la balise canonical de la page pointe vers elle-même et que Google retient bien cette URL.
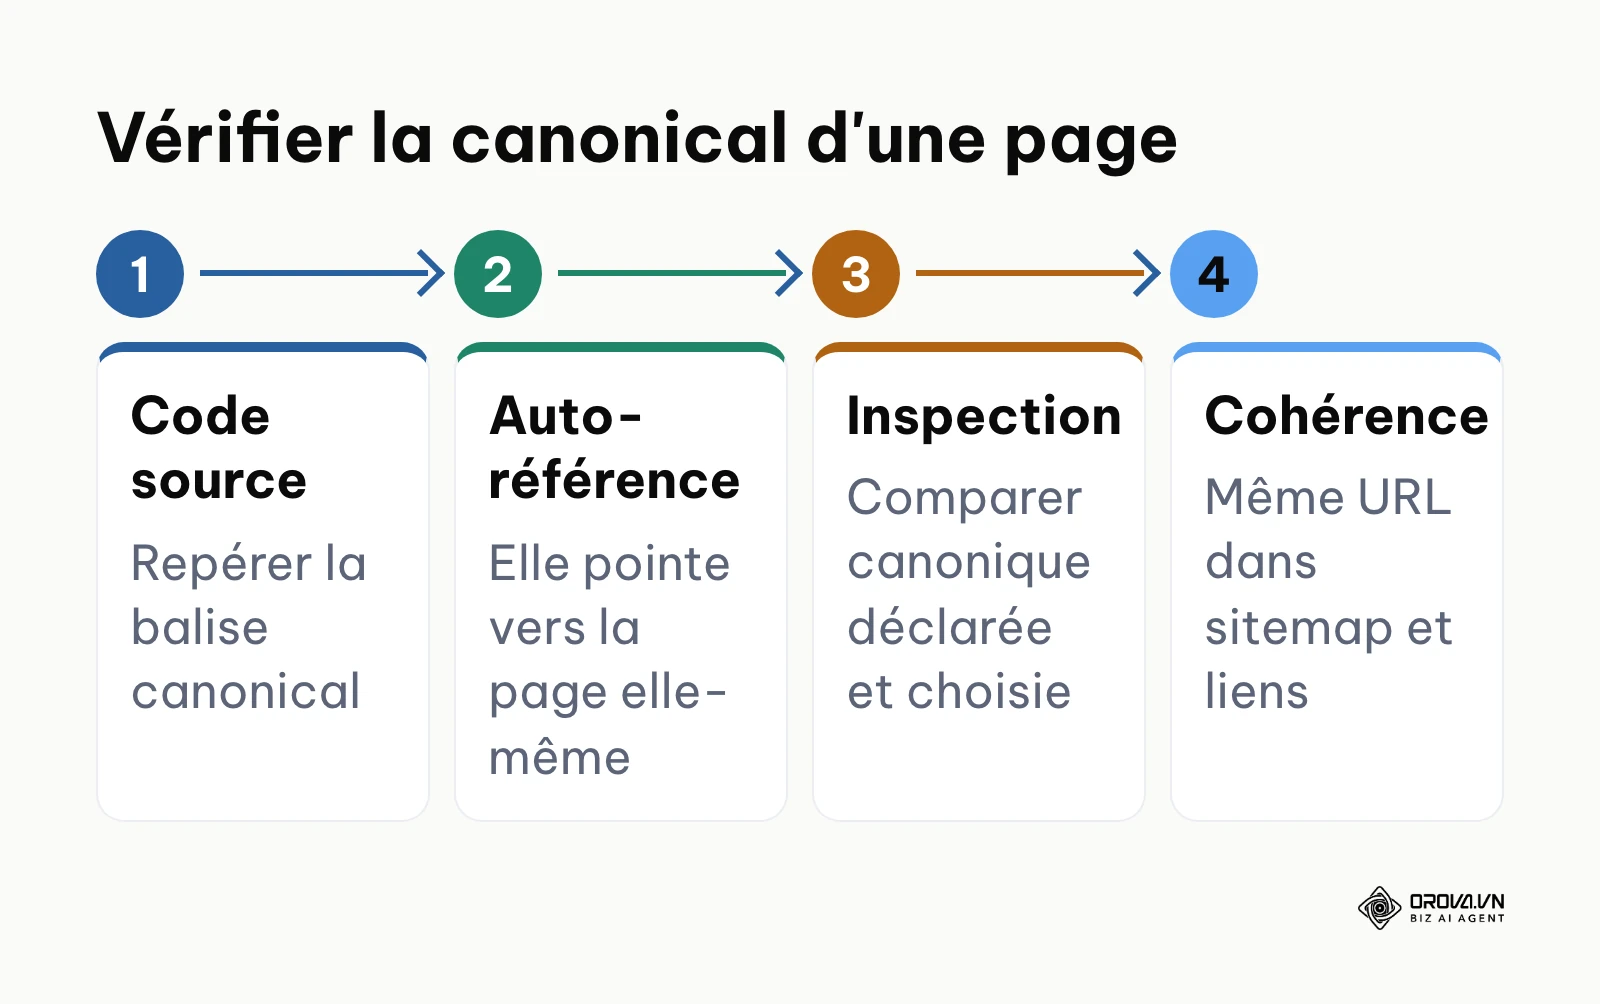
Ouvrez le code source et repérez la balise rel="canonical" dans la section <head>. L'adresse indiquée doit être exactement celle de la page : même protocole (https), même domaine (avec ou sans www), même barre oblique finale. Lancez ensuite l'inspection d'URL dans la Search Console et comparez deux lignes : « URL canonique déclarée par l'utilisateur » et « URL canonique sélectionnée par Google ». Si elles diffèrent, Google considère votre page comme un doublon d'une autre et indexera celle-ci à sa place. Ce cas est fréquent lorsque plusieurs pages ciblent le même sujet, un phénomène décrit dans notre guide sur la cannibalisation seo.
Exemple illustratif :
- Contexte : Une boutique en ligne publie une fiche produit accessible à la fois avec et sans paramètre de couleur dans l'URL.
- Étapes réalisées : L'éditeur inspecte la fiche dans la Search Console et constate que Google a choisi la variante avec paramètre comme URL canonique.
- Obstacle et solution : Le thème du site générait une balise canonical vers la variante. Après correction du modèle de page, la canonical pointe vers l'URL propre, qui est aussi la seule présente dans le sitemap et dans les liens internes.
- Résultat visible : Lors de l'inspection suivante, l'URL canonique déclarée et celle sélectionnée par Google sont identiques.
Un mot sur l'API d'indexation de Google : elle est réservée aux pages contenant des offres d'emploi (JobPosting) ou des vidéos en direct (BroadcastEvent intégré dans un VideoObject). Elle ne sert pas à faire indexer un article ou une page classique. De même, le protocole IndexNow n'est pas utilisé par Google.
Étape 3 : Créer, valider et déclarer votre Sitemap XML
Le sitemap est la carte routière de votre site web. Bien qu'il ne force pas l'indexation immédiate, il est la base de la découverte systématique par les moteurs de recherche, particulièrement pour les sites profonds et complexes.
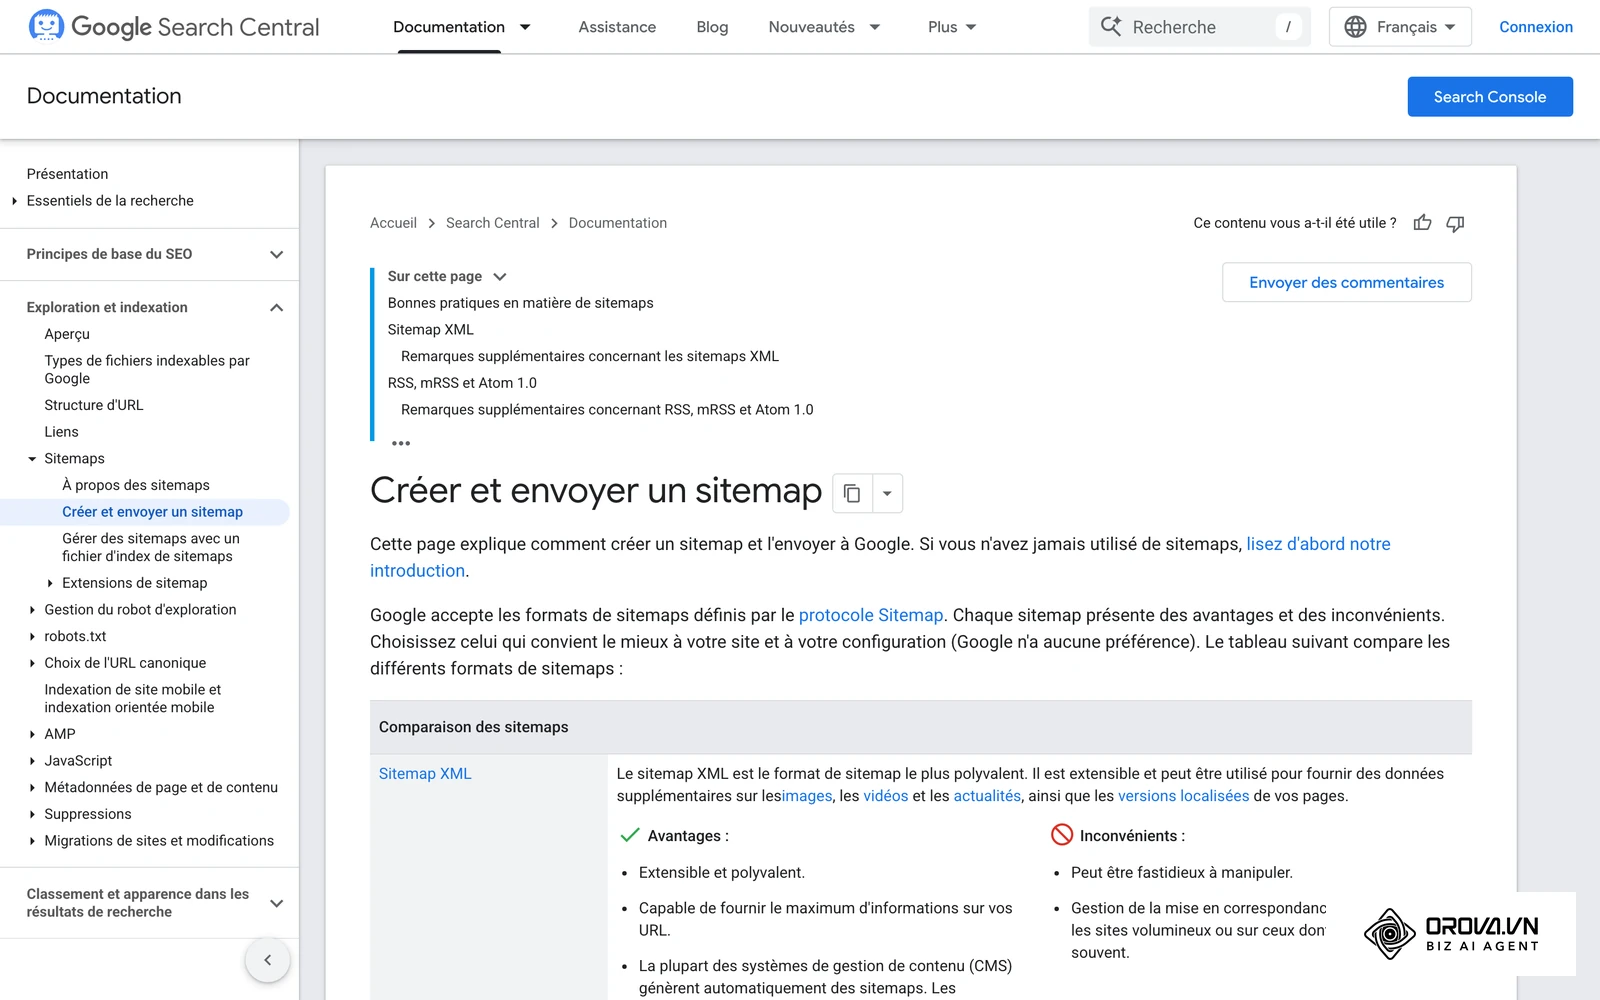
Un sitemap est un fichier structuré, généralement au format XML, qui liste toutes les URL importantes de votre domaine. Pour qu'il soit efficace, il ne doit contenir que des URL canoniques qui renvoient un code 200, sans redirections ni pages bloquées. Vous pouvez le générer via votre CMS ou des outils externes. Il doit inclure des balises spécifiques comme <loc> (l'adresse de la page) et <lastmod> (la date de dernière modification). Les balises <priority> et <changefreq> existent dans le protocole, mais Google indique qu'il les ignore ; seule une valeur <lastmod> fiable lui est utile. Une fois créé, le fichier doit être soumis dans la section "Sitemaps" de la Google Search Console.
Un signe de bonne configuration est l'indication "Opération effectuée" en vert dans la Search Console, avec le décompte exact des URL découvertes. L'erreur la plus pénalisante à cette étape est d'inclure des URL en noindex ou des erreurs 404 dans le sitemap. Selon la documentation de Google Search Central, le processus d'indexation commence par la découverte des URL via les sitemaps et les liens, avant que le robot ne décide si le contenu mérite d'être stocké. Un sitemap pollué par des pages inutiles signale à Googlebot que votre architecture technique est négligée, ce qui n'aide pas Google à repérer vos pages réellement importantes.
Étape 4 : Obtenir des liens depuis des pages publiques déjà explorées
Google découvre la plupart des nouvelles URL en suivant des liens. Un lien vers votre page depuis une page publique que Googlebot visite déjà régulièrement est donc un moyen de découverte supplémentaire, à côté du sitemap.
Concrètement, cela peut être une mention dans une newsletter archivée en ligne, une page partenaire, un annuaire professionnel sérieux ou une publication sur un réseau social dont les pages sont accessibles sans connexion. Le texte qui accompagne le lien doit décrire honnêtement le contenu de la page cible. Ces liens servent à la découverte : ils ne garantissent ni l'indexation ni un meilleur classement, et ceux placés en « nofollow » ne transmettent pas d'autorité.
Le signe de réussite n'est pas que Google indexe la publication elle-même, mais que Googlebot suive le lien vers votre serveur, ce que vous pouvez vérifier dans les logs. L'erreur à éviter est de publier dans des groupes privés ou fermés, inaccessibles aux robots, ou d'acheter des liens en masse : c'est contraire aux règles de Google et cela expose le site à une action manuelle.
Étape 5 : Créer un maillage interne depuis une page pilier d'autorité
Le maillage interne est le transfert d'autorité (le flux de PageRank) au sein de votre propre domaine. Si une nouvelle page est isolée, orpheline ou enfouie à dix clics de la page d'accueil, les robots ne la trouveront pas, ou pire, jugeront qu'elle n'a aucune importance stratégique.
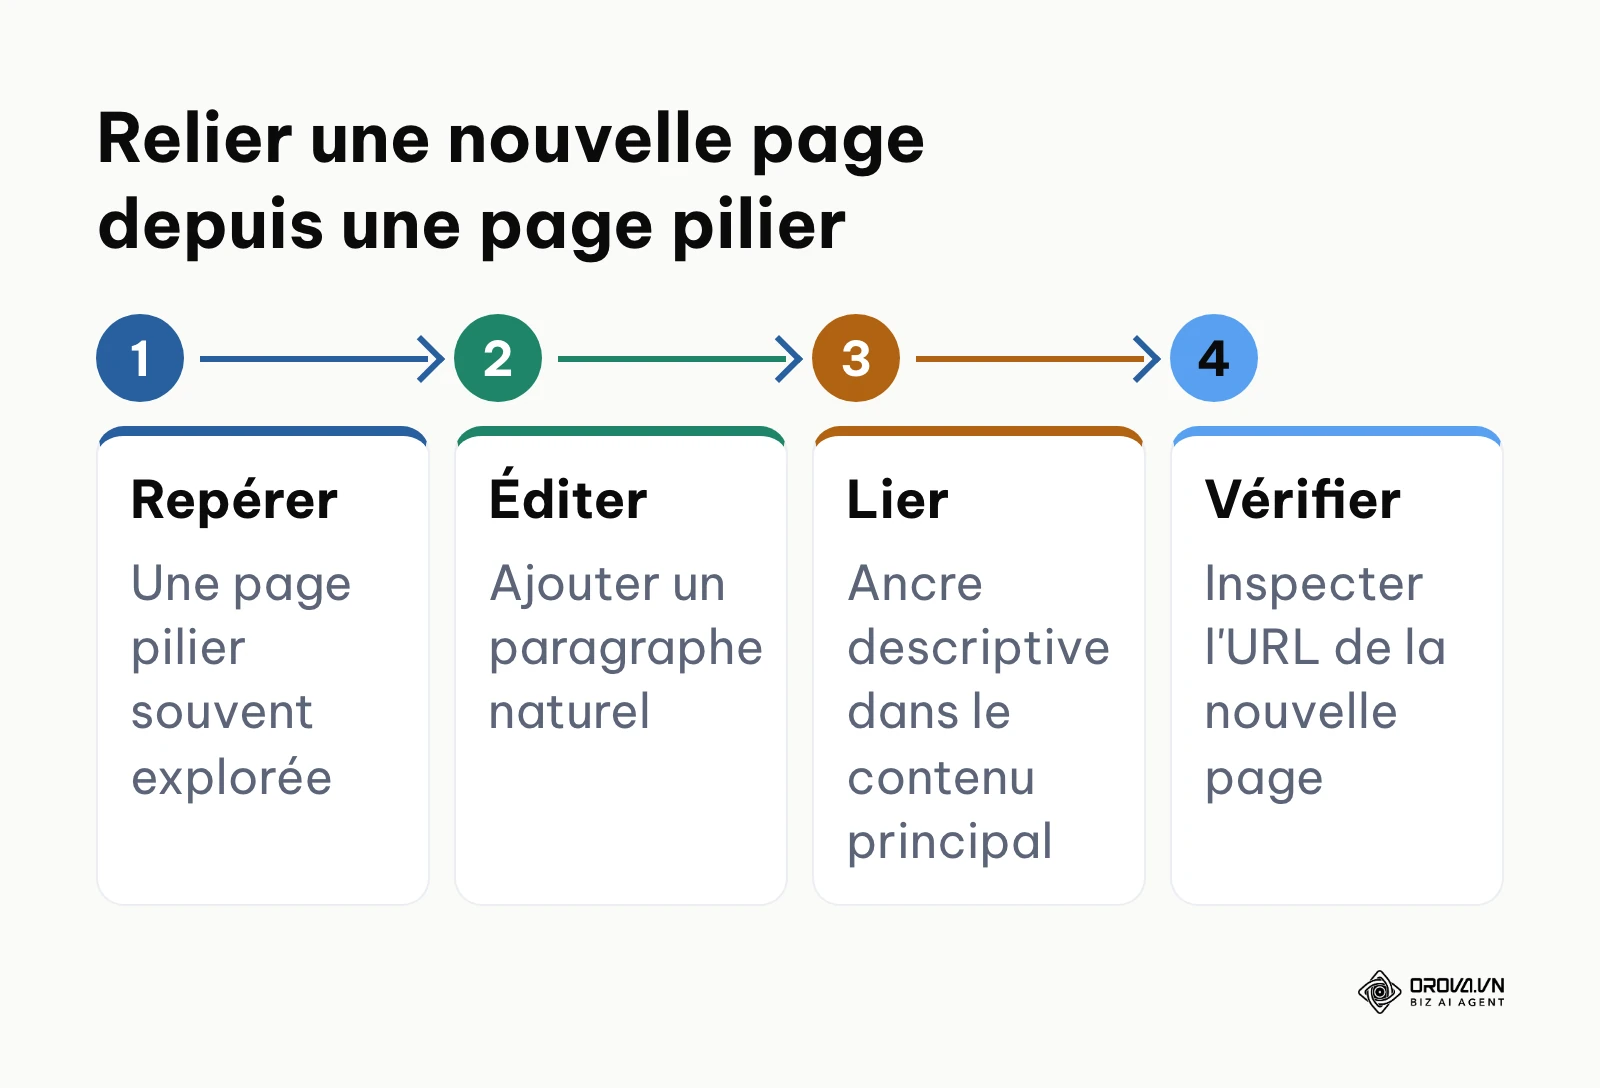
Pour forcer l'attention de Google, vous devez lier votre nouvel article depuis une page de votre site qui reçoit déjà beaucoup de trafic et qui est fréquemment crawlée. La stratégie optimale consiste à repérer une page pilier puissante traitant d'un sujet connexe. Éditez cette page, ajoutez un paragraphe naturel et insérez un lien dofollow pointant vers votre nouvelle URL. L'optimisation de l'ancre de lien est vitale : utilisez un texte descriptif exact pour aider Google à comprendre immédiatement le sujet du nouveau contenu avant même de l'explorer.
Exemple illustratif :
- Contexte : Un blog d'entreprise proposant des formations professionnelles a publié un article détaillé sur le management hybride, mais la page refusait de s'indexer après trois semaines malgré une soumission manuelle.
- Étapes réalisées : L'éditeur a identifié l'article phare du site ("Guide du leadership", générant 10 000 visites mensuelles). Il y a ajouté un nouveau sous-titre abordant brièvement le travail à distance, incluant un lien hypertexte riche en mots-clés pointant directement vers le nouvel article récalcitrant.
- Obstacle et solution : L'article source étant très long, le lien a d'abord été placé dans le pied de page, ce qui n'a eu aucun effet. La solution a été de remonter le lien dans le premier tiers du contenu principal (au-dessus de la ligne de flottaison), là où le poids algorithmique est le plus fort.
- Résultat visible : Le lendemain de la mise à jour de la page pilier, l'outil d'inspection d'URL a confirmé l'indexation de l'article sur le management hybride, qui a commencé à capter des impressions sur ses mots-clés cibles.
Une structure où chaque page importante reste accessible en peu de clics depuis la page d'accueil facilite sa découverte par les robots d'exploration. Une erreur classique est de se contenter de lier la nouvelle page depuis la page d'accueil (qui tourne rapidement) sans l'ancrer de manière permanente dans la hiérarchie thématique du site.
Étape 6 : Traiter les statuts « Détectée » et « Explorée, actuellement non indexée »
C'est le cas le plus redouté dans le rapport « Pages » de la Search Console : « Détectée, actuellement non indexée », souvent appelé page découverte non indexée. Ce statut signifie que Google sait que l'URL existe, il a probablement vu un lien vers elle, mais il a délibérément décidé de reporter l'exploration. Ce n'est pas une erreur technique, c'est un arbitrage sur le budget d'exploration ou la qualité globale du domaine. Le statut voisin, « Explorée, actuellement non indexée », indique que Google a bien visité la page mais a choisi de ne pas l'indexer pour l'instant.
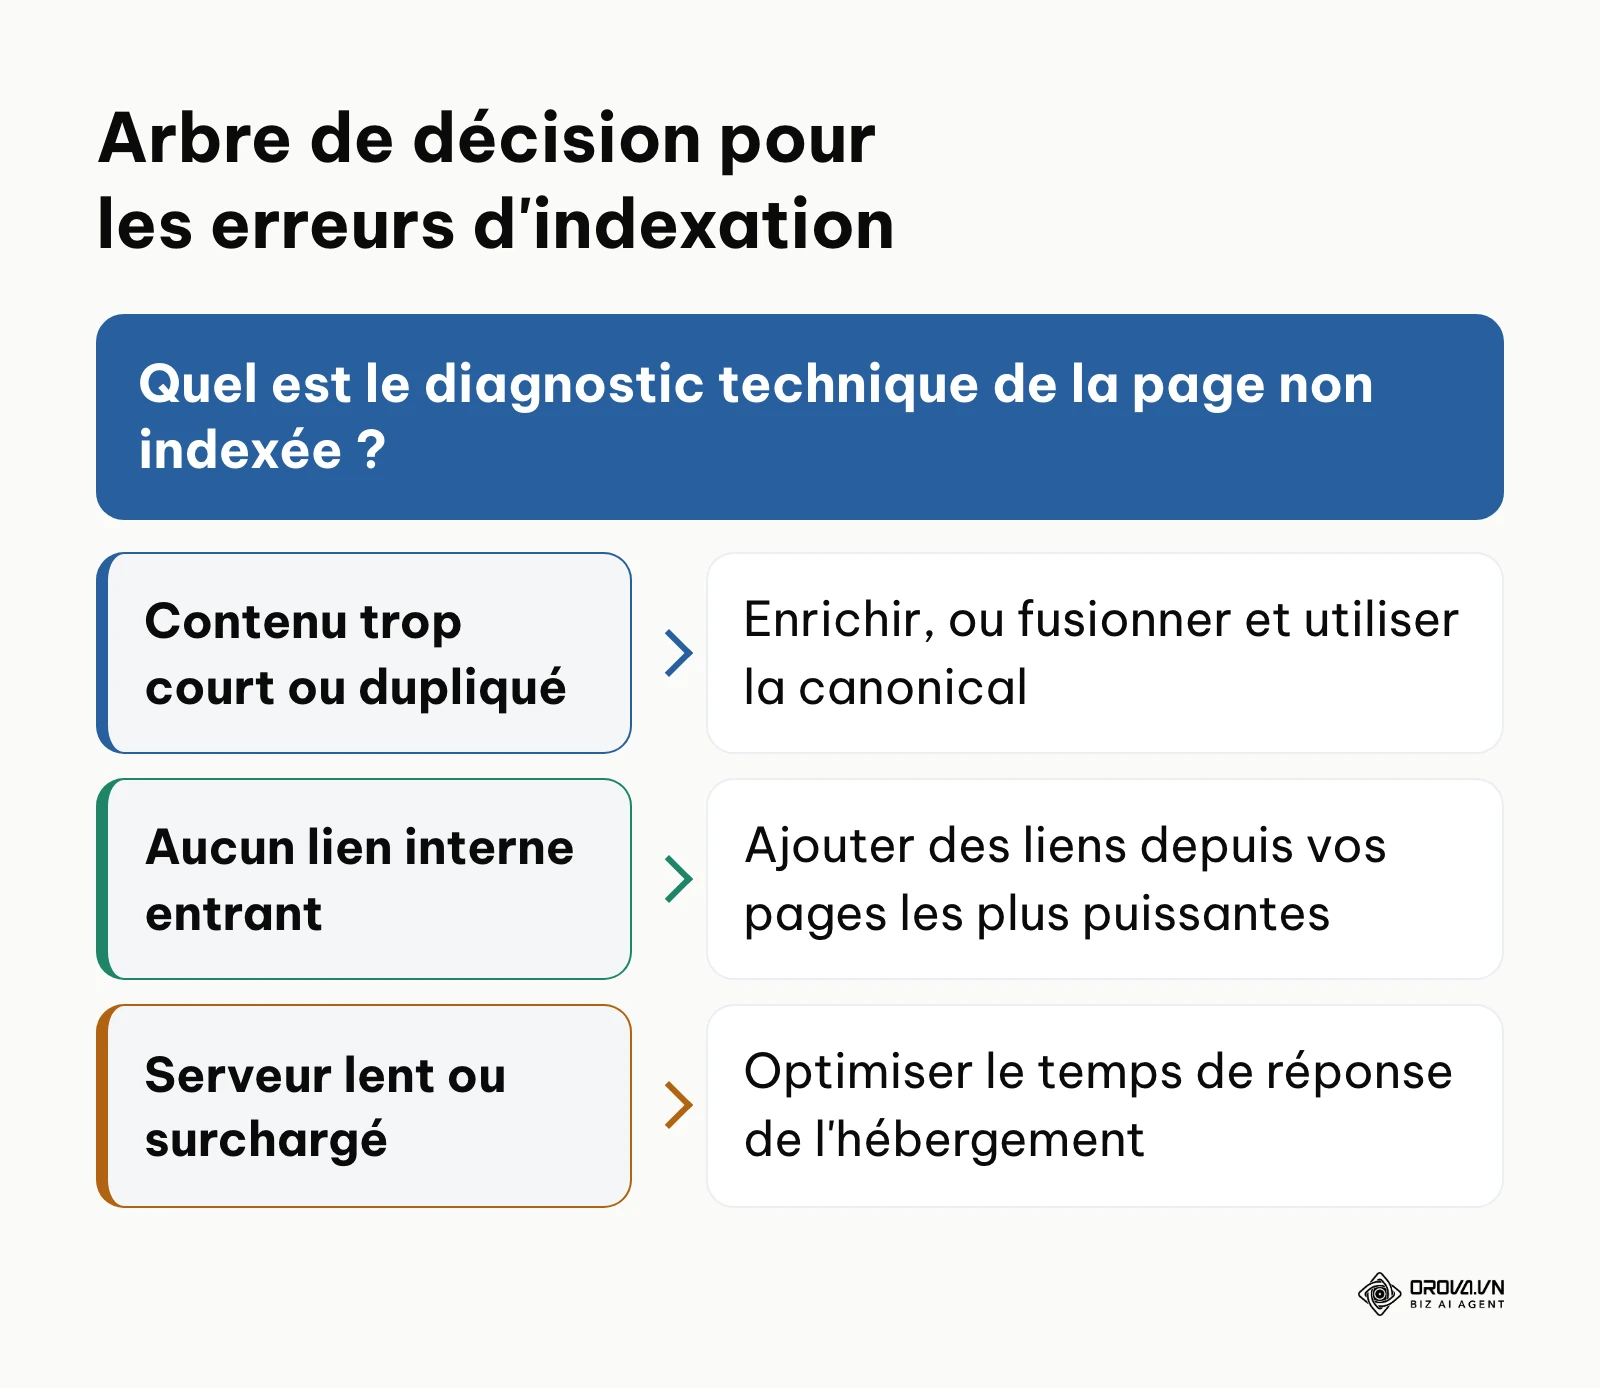
Pour résoudre ce problème, il faut attaquer sur plusieurs fronts. Premièrement, vérifiez s'il s'agit d'un problème de "Thin Content" (contenu mince). Si votre page est très courte et n'apporte aucune valeur unique par rapport aux autres pages du web, Google refusera de dépenser des ressources pour la stocker. La solution est d'enrichir le texte, d'ajouter des données structurées, des images originales et des vidéos. Deuxièmement, consolidez le contenu dupliqué. Si cette page ressemble fortement à une autre page de votre site, Google risque de l'écarter. Utilisez la balise canonical ou fusionnez les pages, comme expliqué dans le guide sur la cannibalisation seo. Enfin, le problème vient souvent d'une surcharge du serveur. Si Googlebot estime que l'exploration ralentira l'expérience des utilisateurs réels, il recule. Vous devez optimiser le temps de réponse de votre hébergement.
Exemple illustratif :
- Contexte : Un site de petites annonces automobiles voyait des milliers de ses pages de véhicules d'occasion stagner sous le statut « Détectée, actuellement non indexée » dans le rapport Pages.
- Étapes réalisées : L'équipe SEO a analysé les pages concernées et constaté qu'elles manquaient de texte descriptif, ne contenant qu'une simple liste de caractéristiques techniques (moteur, kilométrage). Ils ont injecté un module générant des descriptions uniques de 150 mots basées sur les spécifications, et ont ajouté des liens internes vers d'autres modèles similaires en bas de page.
- Obstacle et solution : La génération massive de texte a ralenti le temps de chargement du serveur (TTFB > 1.5s), forçant Googlebot à réduire son taux d'exploration. Ils ont résolu cela en mettant en place un système de cache robuste (Redis) pour servir les pages statiquement en moins de 200ms.
- Résultat visible : Dans les deux semaines suivant l'optimisation des performances et de la qualité du contenu, le nombre d'URL indexées a nettement progressé dans le rapport Pages.
Le signe que vos actions portent leurs fruits est le passage de l'URL au statut « Explorée, actuellement non indexée » (Google l'a visitée), puis à « Indexée ». L'erreur à ne pas faire est de modifier légèrement une virgule et de demander une réindexation : Google a besoin d'un changement de qualité structurel majeur pour réévaluer sa décision.
Étape 7 : Appliquer une stratégie différente pour une nouvelle page vs une page mise à jour
Les algorithmes de Google ne traitent pas une URL fraîchement publiée de la même manière qu'une URL historique mise à jour. Ignorer cette différence entraîne des stratégies d'indexation inefficaces et une perte de temps considérable.
Pour une nouvelle page sur un domaine récent, Google manque de données de confiance. Pour faire indexer une page vierge, combinez plusieurs signaux de découverte : inspection d'URL, sitemap à jour, liens depuis vos pages piliers et, si possible, un lien depuis une page publique externe déjà explorée.
Pour une page mise à jour (une ancienne page dont vous avez modifié le contenu, le titre ou ajouté des informations), la stratégie est plus subtile. L'URL est déjà connue et possède un historique. Le simple fait de modifier la date de mise à jour (<lastmod>) dans le sitemap XML et de rafraîchir un lien interne existant suffit souvent à déclencher un crawl de vérification. Si la mise à jour est critique (changement de prix, de produit, ou correction d'une information fausse), un simple passage par l'outil d'inspection d'URL de la Search Console est l'action la plus appropriée et la plus respectueuse des quotas. L'erreur commune est de redemander l'indexation et de modifier <lastmod> pour des changements mineurs (comme la correction d'une faute d'orthographe) : la date de modification doit refléter un vrai changement de contenu.
Découvrez Orova.vn – une plateforme Biz AI Agent dotée de la solution OROVA SEO complète, destinée à tous les sites web. Le système accompagne l'optimisation pour les moteurs de recherche de A à Z, avec les fonctionnalités suivantes : recherche de mots-clés, rédaction de nouveaux articles optimisés pour le SEO, optimisation des contenus existants, suivi des positions, ainsi que l'analyse des concurrents et l'analyse technique approfondie. Inscrivez-vous dès aujourd'hui pour découvrir OROVA SEO entièrement gratuitement (offre valable jusqu'au 7 juillet 2027).
Analyse approfondie : Vitesse d'indexation et outils tiers
Comprendre la vitesse d'indexation est crucial pour gérer vos attentes et piloter vos campagnes. La course à l'indexation a donné naissance à une industrie d'outils tiers, souvent appelés "Indexers", qui promettent des miracles moyennant un abonnement. Il est essentiel de peser le pour et le contre de chaque approche technique.
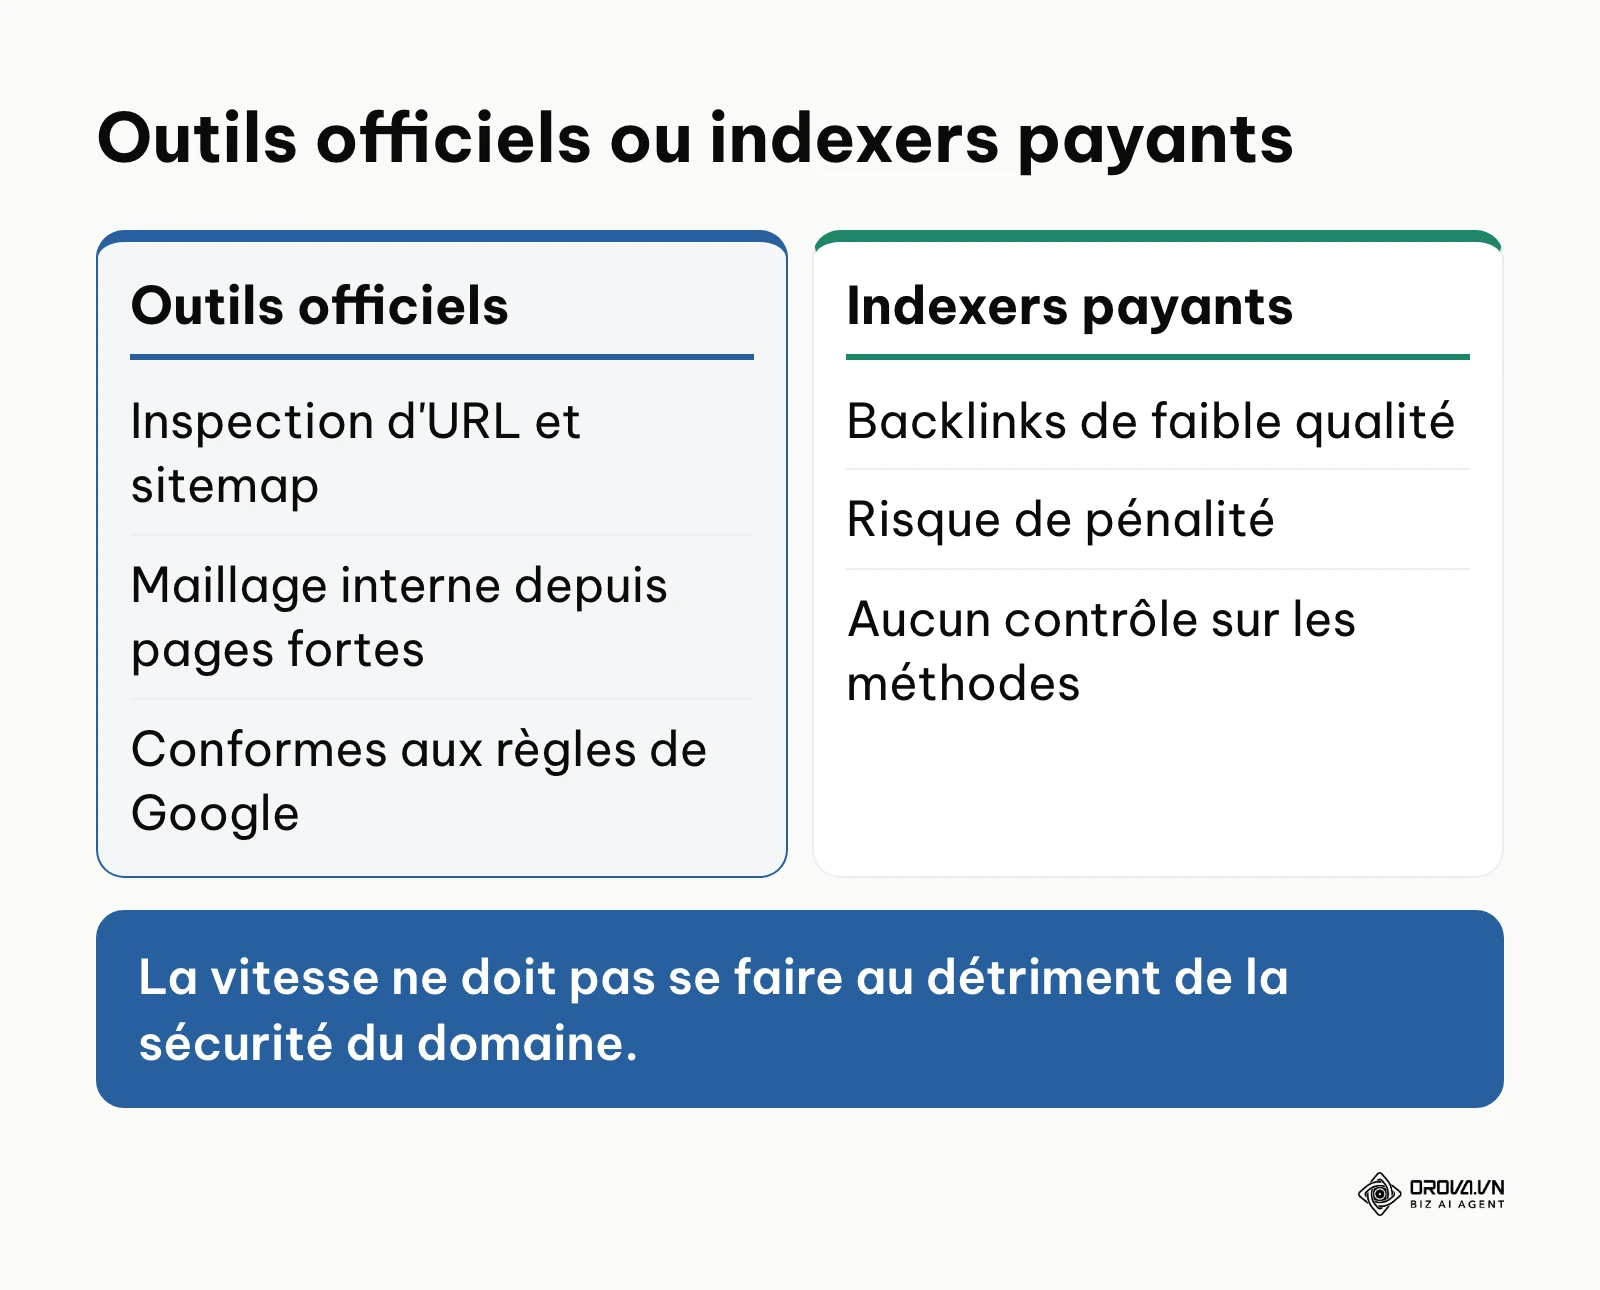
Les outils d'indexation payants fonctionnent souvent en générant massivement des backlinks de faible qualité depuis des réseaux de blogs (PBN) ou en exploitant des failles dans les API de services de statistiques pour forcer la découverte des URL. Si ces méthodes peuvent parfois accélérer les choses, elles comportent un risque systémique élevé de pénalité manuelle ou algorithmique pour manipulation de liens. À l'inverse, l'utilisation des outils officiels (Search Console, sitemap, maillage interne) demande plus de rigueur technique mais bâtit une autorité pérenne. Le délai d'indexation dépend fondamentalement de la qualité de la méthode choisie, du profil de liens du domaine et de la propreté du code source.
| Méthode d'indexation | Idéal pour la situation suivante | Point faible et vulnérabilité |
|---|---|---|
| Attente passive (Sitemap seul) | Sites immenses, contenu evergreen non urgent | Vitesse très lente, aucun contrôle sur les délais |
| Inspection GSC manuelle | Articles unitaires, mises à jour critiques | Limite de quota journalier, chronophage |
| API d'indexation Google | Pages d'offres d'emploi (JobPosting) et vidéos en direct (BroadcastEvent) uniquement | Non prévue pour les articles et pages classiques |
| Indexers payants tiers | Réseaux de sites satellites, SEO black-hat / grey-hat | Risque élevé de pénalité algorithmique à long terme |
| Boost par liens internes | Nouvelle page stratégique sur un domaine établi | Nécessite d'avoir déjà des pages à fort trafic |
Si vous gérez une plateforme e-commerce ou un média d'information, investissez plutôt dans un sitemap généré automatiquement avec des dates <lastmod> fiables et un maillage interne qui relie chaque nouvelle page à ses rubriques. Pour les sites qui produisent des pages à grande échelle, notre guide du seo programmatique détaille comment garder ces pages utiles et indexables. La vitesse ne doit pas se faire au détriment de la sécurité de votre domaine.
Mesurer les résultats : Comment vérifier que votre page est indexée
L'exécution des méthodes d'indexation n'est qu'une partie du travail ; vous devez mesurer scientifiquement l'impact de vos actions pour ne pas opérer à l'aveugle. Savoir lire les rapports est indispensable pour adapter vos efforts.
La vérification la plus basique est la commande site:votresite.com/votre-url-exacte dans la barre de recherche Google. Bien que rapide, cette commande est parfois capricieuse et ne reflète pas l'indexation profonde ou le positionnement réel. Pour des données fiables, le rapport "Pages" (anciennement Couverture) de la Google Search Console est votre source de vérité absolue. Vous devez surveiller la transition de vos URL depuis les statuts « Non indexée » (comme « Détectée, actuellement non indexée ») vers le statut « Indexée ».
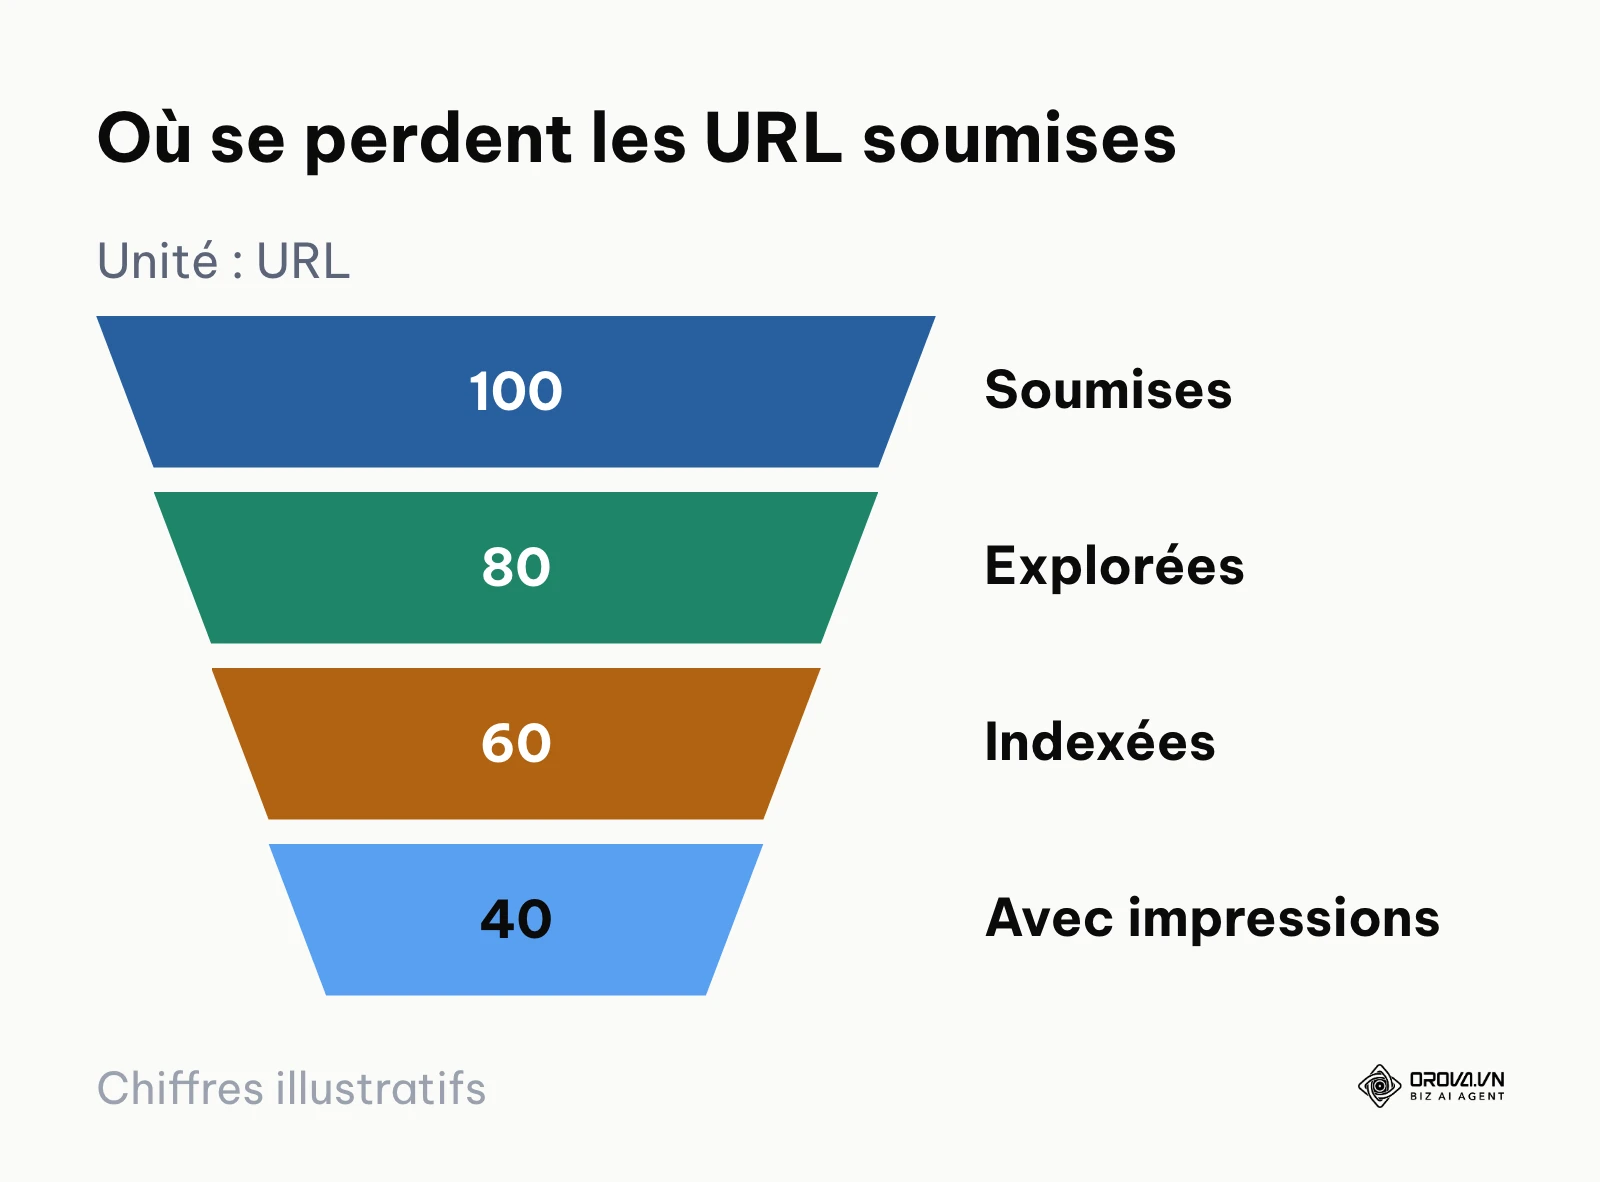
Exemple illustratif : sur 100 URL soumises, 80 sont explorées, 60 sont indexées et 40 obtiennent des impressions. Lire ce parcours étape par étape montre où se situe la perte.
Suivre vos kpi seo vous permet de confirmer non seulement que la page est dans la base de données, mais qu'elle génère de la valeur. L'analyse des fichiers logs du serveur est la méthode la plus technique et la plus précise : elle permet de voir la date et l'heure exactes où le user-agent "Googlebot" a frappé votre URL. Si Googlebot télécharge le code 200, l'indexation suivra généralement.
| Indicateur clé à surveiller | Signification de la métrique | Seuil critique et action requise |
|---|---|---|
| Hit Googlebot (Logs serveur) | Le robot a physiquement visité et téléchargé la page | Aucun hit après 48h : vérifier blocage pare-feu ou robots.txt |
| Statut URL GSC | Position dans le pipeline d'indexation de Google | "Erreur 404/5xx" : corriger le serveur d'urgence |
| Impressions (GSC Perf.) | La page a été affichée dans un résultat de recherche | 0 impression après indexation : problème de mots-clés ou de qualité |
| Pages actives organiques (GA4) | Un humain a cliqué et visité la page depuis Google | Taux de rebond excessif : le contenu ne répond pas à l'intention |
| Délai de rendu WRS | Temps nécessaire pour exécuter le JavaScript complexe | Rendu partiel : optimiser le DOM et réduire la taille des scripts |
Ne confondez jamais "être indexé" et "être positionné". Une page peut parfaitement être validée dans l'index de Google et se retrouver à la centième position, ne générant ainsi aucune impression visible.
Avec OROVA.VN et le module OROVA SEO, vous mettez définitivement fin aux journées épuisantes de travail manuel. Au lieu de passer des heures à rédiger des articles et à préparer des rapports, l'ensemble du processus est désormais optimisé et bouclé en seulement 5 minutes.
Les 7 erreurs courantes qui bloquent l'indexation
Même les experts SEO les plus aguerris trébuchent sur des détails techniques invisibles à l'œil nu. Une seule de ces erreurs peut anéantir tous vos efforts de rédaction et de promotion. Il est vital de les identifier et de les éradiquer méthodiquement.
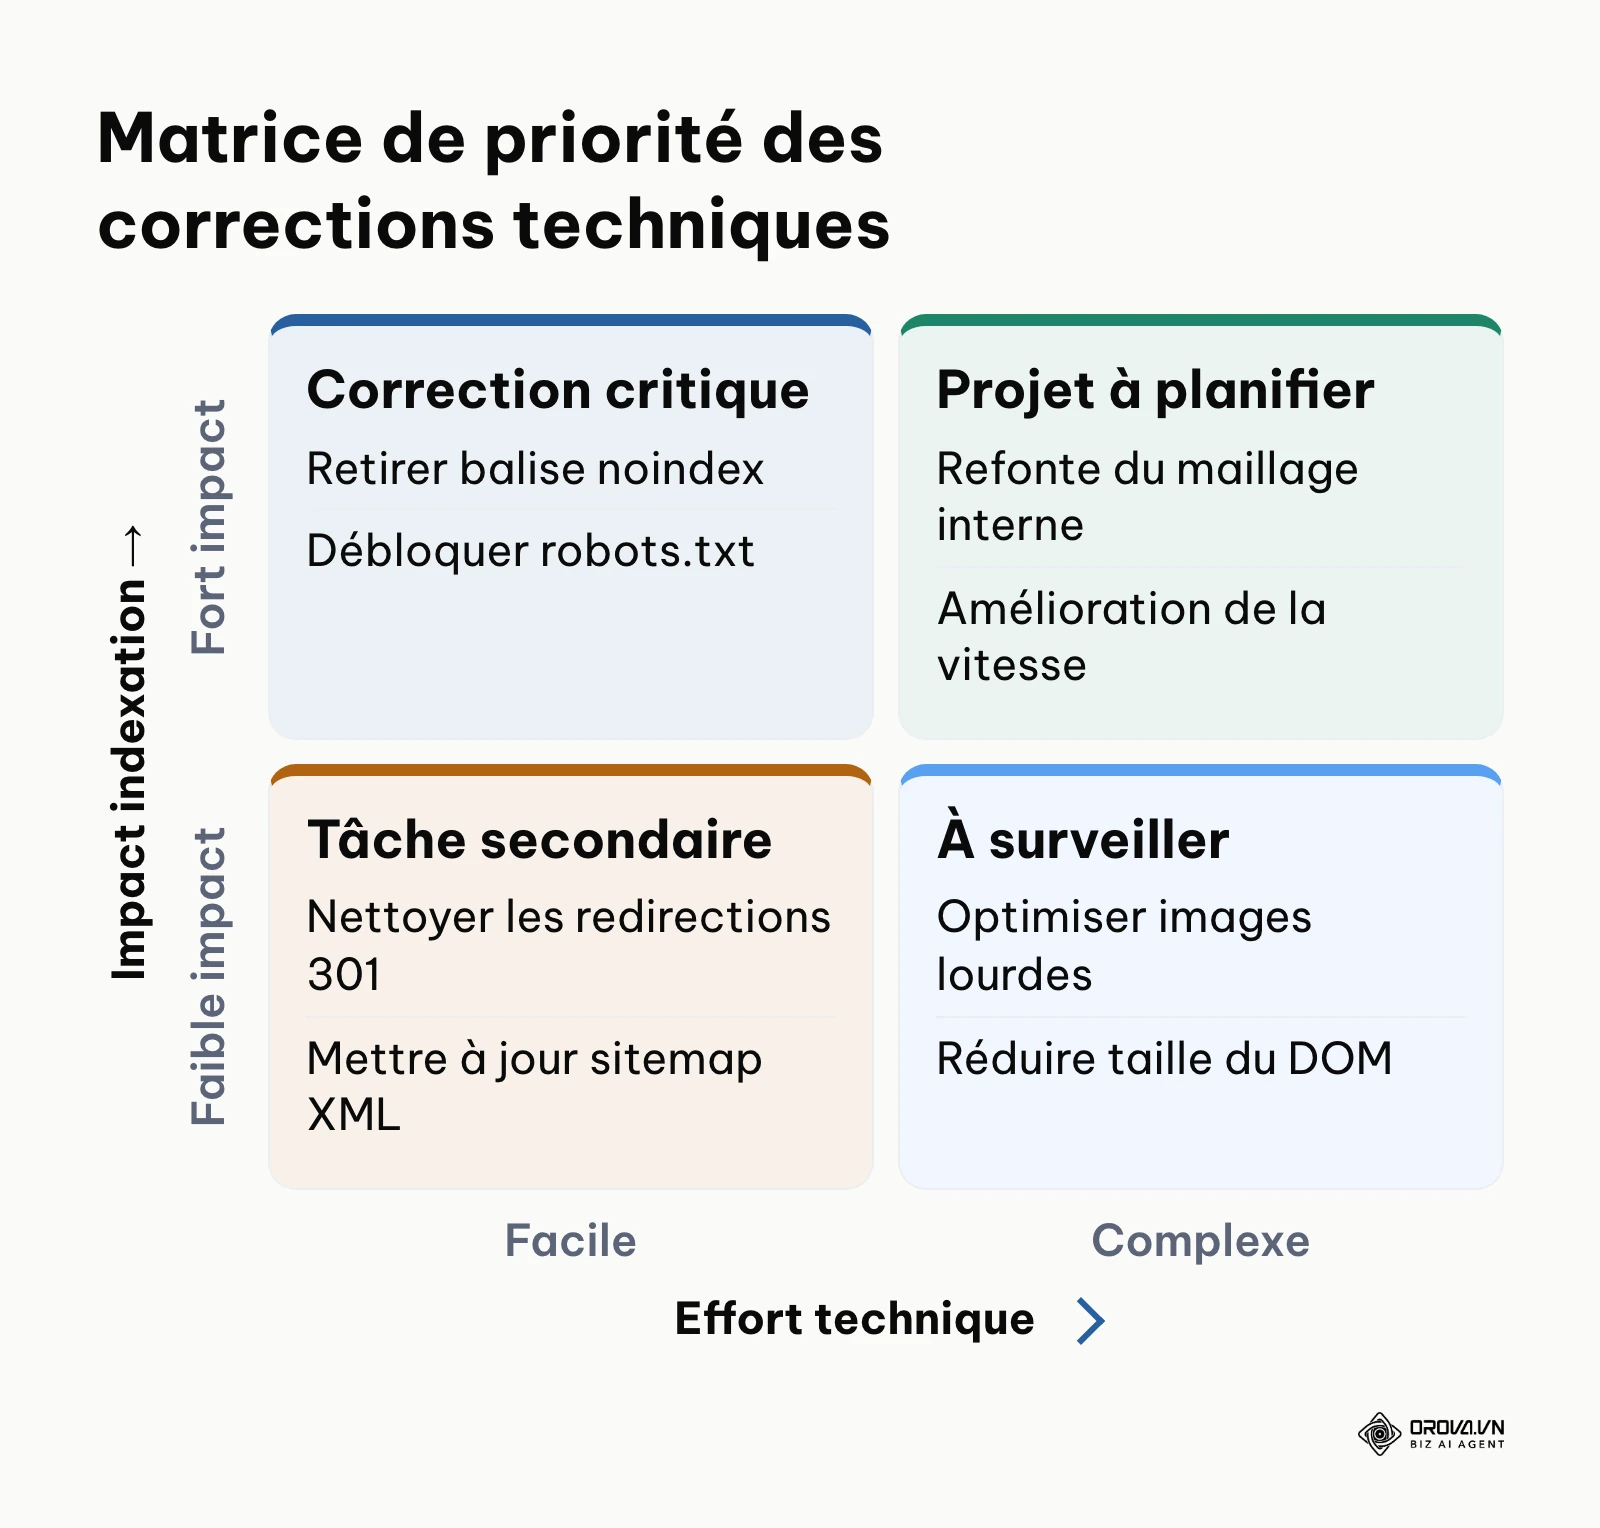
- Laisser une directive noindex persistante : L'erreur la plus absurde mais la plus commune. Lors de la phase de développement ou de refonte, les développeurs placent une balise <meta name="robots" content="noindex"> pour éviter l'indexation prématurée. L'oubli de sa suppression lors de la mise en production bloque définitivement le site. La solution est un scan systématique avant chaque lancement.
- Créer des pages orphelines : Une page brillante sans aucun lien interne pointant vers elle est une île déserte. Si Googlebot ne trouve pas de chemin pour y accéder, il ne la crawlera pas. Assurez-vous que chaque nouvelle publication est liée depuis le menu, le plan du site HTML, ou un maillage contextuel solide.
- Bloquer le JavaScript et CSS critiques : Si votre fichier robots.txt empêche Googlebot d'accéder à vos feuilles de style ou à vos fichiers JS essentiels, le moteur ne pourra pas rendre la page correctement. Il la considérera comme vide ou cassée, et refusera l'indexation. Vérifiez le rendu avec le test en direct de l'outil d'inspection d'URL.
- Générer des Soft 404 (Erreurs 404 douces) : Une page vide, une catégorie sans produits ou un article supprimé qui renvoie un code HTTP 200 au lieu d'un vrai code 404 ou 410 trompe les moteurs. Google détecte la vacuité du contenu et classe la page en soft 404, gaspillant votre budget. Implémentez des codes de statut HTTP stricts.
- Avoir un temps de chargement désastreux (TTFB élevé) : Si votre serveur met plus de 2 secondes à répondre à la première requête, Googlebot limitera son taux de crawl pour ne pas crasher votre hébergement. Les pages profondes ne seront jamais atteintes. Investissez dans un bon cache système et un CDN performant.
- Bâcler la canonicalisation : Si une URL possède des paramètres de suivi (comme ?utm_source=...) et que la balise <link rel="canonical"> n'est pas définie vers l'URL propre, Google indexera des doublons, diluera l'autorité et finira par bloquer l'indexation des nouvelles variantes par prévention contre la duplication.
- Proposer un contenu trop mince (Thin Content) : Comme vu précédemment pour l'erreur page découverte non indexée, publier une centaine de pages générées automatiquement avec 50 mots de texte et aucune valeur ajoutée déclenche les systèmes de qualité de Google. La solution est l'enrichissement et la consolidation ; le guide du seo programmatique montre comment éviter ce piège à grande échelle.
Tendances de l'indexation Google dans les prochaines années : L'avis de l'auteur
En date de 2026, on observe déjà des mutations profondes dans la manière dont les moteurs de recherche traitent l'information. L'époque où il suffisait de publier un article texte pour qu'il soit indexé aveuglément est révolue. Selon moi, l'avenir de l'indexation s'articule autour de trois bouleversements majeurs qui forceront les webmasters à repenser leur stratégie technique et éditoriale.
L'évaluation qualitative pré-indexation par l'IA Je pense que Google pourrait intensifier l'utilisation de modèles linguistiques majeurs (LLMs) pour évaluer la qualité d'une page avant même de décider de l'indexer. Aujourd'hui, l'erreur de la page découverte non indexée est un symptôme précoce de ce filtre. À terme, l'IA de Google pourrait lire le texte brut dès la phase de découverte pour détecter si le contenu est une simple reformulation de l'existant. Si la valeur ajoutée (informationnelle ou d'opinion) est jugée nulle, la page n'entrera jamais dans la base de données. Vous devez dès maintenant vous préparer en intégrant des données uniques, des expériences vérifiables et des points de vue singuliers dans chaque publication, plutôt que de miser sur la quantité.
L'avènement de l'indexation instantanée comme norme universelle Je considère que le modèle basé sur l'attente du passage d'un bot d'exploration (pull) va disparaître au profit d'un modèle basé sur la notification en temps réel (push). Des protocoles comme IndexNow, lancé par Bing et Yandex, poussent déjà une partie de l'industrie dans cette direction, même si Google ne l'utilise pas à ce jour. Je pense qu'à terme, la notification des moteurs pourrait devenir une fonction standard des CMS, mais rien ne garantit que Google suive ce chemin. Les éditeurs doivent d'ores et déjà adapter leur infrastructure pour pouvoir "pousser" la donnée vers les moteurs, sous peine d'être toujours en retard sur l'actualité chaude.
L'indexation des entités plutôt que des URL classiques Je penche vers l'idée que la recherche par "Zéro clic" et les réponses génératives (AI Overviews) vont modifier la nature même de ce qui est indexé. Google indexera de moins en moins des pages web traditionnelles pour privilégier l'indexation de fragments de données, d'entités, de faits et de statistiques extraits de vos sites. L'objectif sera de structurer le monde sous forme de graphe de connaissances. La préparation à ce changement passe, selon moi, par un usage soigné des données structurées Schema.org. Baliser les éléments pertinents de votre site (auteurs, événements, produits) aide l'IA du moteur à extraire et indexer l'information granulaire sans même avoir besoin de classer l'URL complète.
Foire aux questions (FAQ) sur comment indexer une page sur google
Combien de temps faut-il pour indexer une page avec seulement un sitemap ?
Si vous vous reposez uniquement sur la soumission d'un sitemap XML pour un domaine ayant une autorité moyenne, le délai varie fortement d'un site à l'autre, et il est souvent plus long pour un site totalement nouveau sans aucun lien entrant. Le sitemap indique l'existence du chemin, mais ne fournit pas l'urgence nécessaire pour déclencher un crawl prioritaire.
Pourquoi ma page n'est-elle pas indexée malgré l'absence d'erreurs techniques ?
C'est le diagnostic typique des statuts « Détectée » ou « Explorée, actuellement non indexée ». Si votre site est techniquement parfait (code 200, mobile-friendly, pas de noindex), le blocage est qualitatif. Google juge que votre domaine n'a pas assez d'autorité (budget de crawl limité) pour justifier la dépense de ressources, ou que le contenu n'apporte aucune valeur ajoutée par rapport aux millions de pages déjà existantes sur le même sujet.
Faut-il payer pour des services tiers d'indexation (Indexers) ?
En règle générale, il est fortement déconseillé d'utiliser des Indexers payants agressifs (Black Hat). Bien qu'ils puissent forcer indexation google à court terme via des injections artificielles de backlinks poubelles, ils exposent votre domaine à des pénalités algorithmiques graves. Privilégiez l'inspection d'URL, un sitemap propre et le renforcement naturel de votre maillage interne, qui sont des méthodes pérennes et conformes aux directives.
Quel est le rôle de l'IA dans la décision d'indexation de Google ?
L'intelligence artificielle est de plus en plus utilisée par Google pour filtrer le spam généré massivement et évaluer la pertinence (systèmes de classement liés à la qualité). L'IA analyse l'intention de la page, la structure sémantique et la fraîcheur de l'information pour déterminer si le coût de stockage de l'URL dans d'immenses centres de données est justifié par rapport à la valeur potentielle apportée à l'utilisateur final.
Dois-je soumettre chaque nouvelle URL manuellement dans la Search Console ?
Pour un petit site publiant un article par semaine, la soumission manuelle via l'outil d'inspection est tout à fait adéquate et efficace. En revanche, pour un site e-commerce, un média d'actualité ou un site de petites annonces générant des dizaines de pages par jour, cette approche est intenable et soumise aux quotas stricts de Google. Un sitemap généré automatiquement, avec des dates <lastmod> fiables, et un maillage interne solide deviennent alors la base.
Par où commencer pour indexer vos pages aujourd'hui ?
Si la quantité d'informations techniques vous semble écrasante, la clé est de ne pas essayer de tout implémenter le même jour. Votre stratégie d'action dépend intégralement de l'état actuel de votre infrastructure et de vos blocages spécifiques. Voici les premières actions concrètes à mener en fonction de votre situation.
Si vous avez lancé un site complètement neuf et que rien n'apparaît sur Google depuis plusieurs semaines, ne cherchez pas encore de solutions complexes. Votre première action doit être de vérifier l'absence d'erreurs fatales. Passez 30 minutes à vérifier que WordPress (ou votre CMS) n'a pas l'option "Demander aux moteurs de recherche de ne pas indexer ce site" cochée, vérifiez robots.txt et la balise canonical, puis soumettez votre sitemap XML propre dans la Search Console.
Si votre site est déjà bien établi, mais qu'une nouvelle page stratégique importante tarde à monter, concentrez-vous sur le transfert de puissance interne. Votre tâche immédiate pour cet après-midi est d'ouvrir votre outil d'analyse (comme Google Analytics), d'identifier les trois pages de votre site qui génèrent le plus de trafic organique de la thématique, et d'y insérer de manière fluide un paragraphe contenant un lien dofollow vers la nouvelle page récalcitrante. C'est l'accélérateur le plus naturel et le plus puissant.
Si le statut « Détectée, actuellement non indexée » touche des centaines d'URL dans votre rapport Pages, vous devez entamer un audit de qualité de contenu. Prenez une demi-journée pour exporter la liste de ces URL, identifiez celles qui sont très courtes ou presque identiques, et rédigez un plan pour les fusionner via des redirections 301 ou pour étoffer considérablement leur contenu. Une fois l'optimisation terminée, relancez la validation dans la Search Console pour demander à Google de réévaluer ces pages.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Pilotez votre activité avec des AI Agents
Orova est le Biz AI Agent qui ne s'arrête jamais : il planifie, exécute et optimise le travail à votre place.
Gagnez du temps, gagnez en efficacité.