Robots txt: как настроить файл для сайта за 7 шагов (2026)
Robots txt — это текстовый файл в корне сайта (https://vash-sait.ru/robots.txt), который сообщает поисковым роботам, какие разделы можно сканировать, а какие нет. Чтобы настроить его, выпишите служебные разделы, задайте группы User-agent с правилами Disallow и Allow, укажите Sitemap, загрузите файл в корень сайта и проверьте его в Яндекс Вебмастере и Google Search Console. Ниже — 7 шагов, таблица различий Google и Яндекса, сверенная с документацией Google Search Central и Справкой Яндекс Вебмастера, и шаблоны для WordPress и 1С-Битрикс как отправная точка.
Если вы только знакомитесь с поисковой оптимизацией, сначала разберитесь, что такое SEO и как сканирование связано с индексацией и позициями: robots.txt управляет только первым звеном этой цепочки.
Для работы понадобятся доступ к корню сайта (FTP, SFTP или файловый менеджер хостинга), подтвержденные права в Яндекс Вебмастере и Google Search Console и текстовый редактор, который сохраняет файлы в UTF-8.
Инструкция не нужна, если сайт целиком закрыт паролем на уровне веб-сервера: такие страницы роботы и так не получат, а robots.txt не заменяет авторизацию.
Что такое robots txt и какие задачи решает файл
Файл robots txt работает по стандарту Robots Exclusion Protocol, который Инженерный совет Интернета (IETF) описал в спецификации RFC 9309 в 2022 году. Поисковый робот запрашивает файл до того, как начать обход страниц хоста, и читает подходящую ему группу правил.
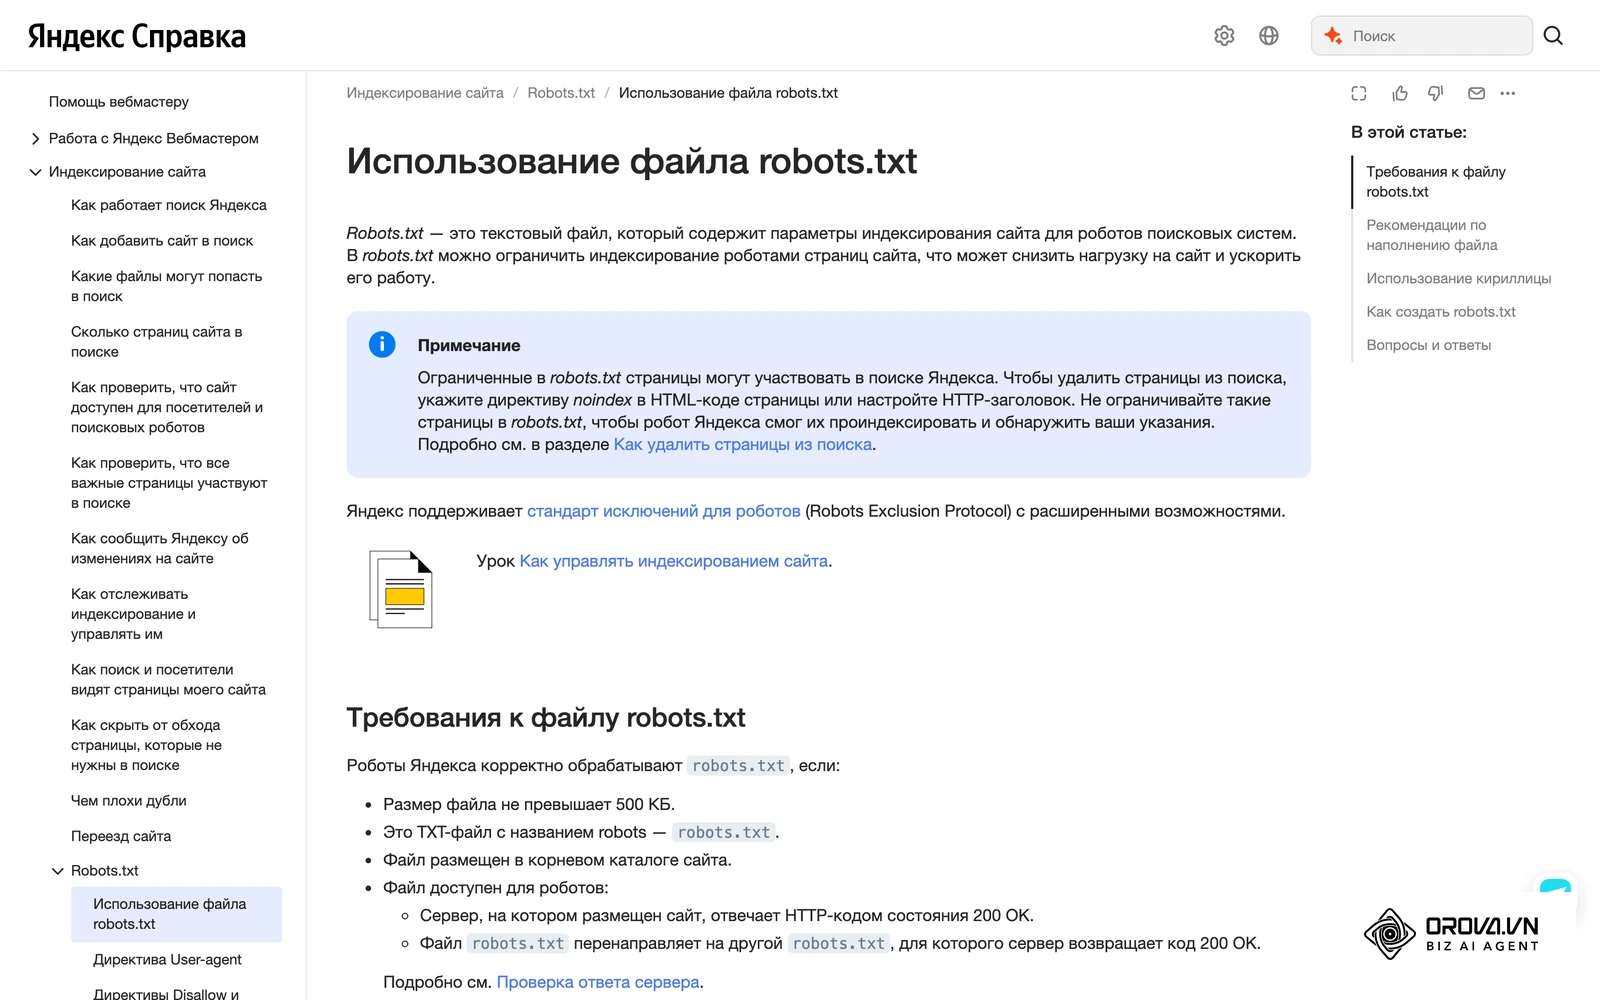
Важно различать сканирование и индексацию. Директива Disallow запрещает роботу загружать страницу, но не гарантирует, что адрес не попадет в поиск: если на URL ведут ссылки, Google может показать его без описания. Справка Яндекса тоже предупреждает, что ограниченные в robots.txt страницы могут участвовать в поиске. Чтобы убрать страницу из выдачи, оставьте ее открытой для сканирования и укажите noindex в метатеге robots или в HTTP-заголовке X-Robots-Tag.
Минимальный рабочий файл выглядит так:
User-agent: *
Disallow: /admin/
Allow: /admin/public/

Sitemap: https://vash-sait.ru/sitemap.xml
Базовые требования, которые совпадают у Google и Яндекса:
| Требование | Что это значит на практике |
|---|---|
| Имя и место | Файл называется robots.txt (строчными буквами) и лежит в корне хоста |
| Один файл на хост | Для каждого поддомена и протокола нужен свой robots.txt |
| Ответ сервера | Файл отдается с кодом 200 OK |
| Кодировка | Обычный текст в UTF-8 |
| Размер | Google обрабатывает первые 500 КиБ, остальное игнорирует; Яндекс корректно обрабатывает файлы до 500 КБ |
| Не защита | Добросовестные роботы соблюдают правила, но файл виден всем — закрытые данные защищайте паролем |
Что подготовить перед началом настройки robots.txt
Перед началом работы соберите доступы к серверу и панелям вебмастеров:
| Что подготовить | Где взять | Что будет, если пропустить |
|---|---|---|
| Доступ к корню по FTP / SFTP | Панель хостинга или письмо от провайдера | Невозможно разместить или изменить файл |
| Права в Google Search Console | search.google.com/search-console | Нельзя посмотреть отчет о файлах robots.txt и протестировать страницы |
| Права в Яндекс Вебмастере | webmaster.yandex.ru | Нельзя проверить директивы в «Анализе robots.txt» |
| Список служебных URL и параметров | Выгрузка из CMS, sitemap или логи сервера | Риск закрыть полезные разделы или оставить дубли |
| Текстовый редактор с UTF-8 | VS Code, Notepad++ или Sublime Text | Невидимые символы и сбои кодировки в первой строке |
Шаг 1: Проведите аудит структуры сайта и выделите закрываемые разделы
Составьте перечень служебных папок, страниц корзины, личных кабинетов, внутреннего поиска и параметров, которые не нужны в поиске.
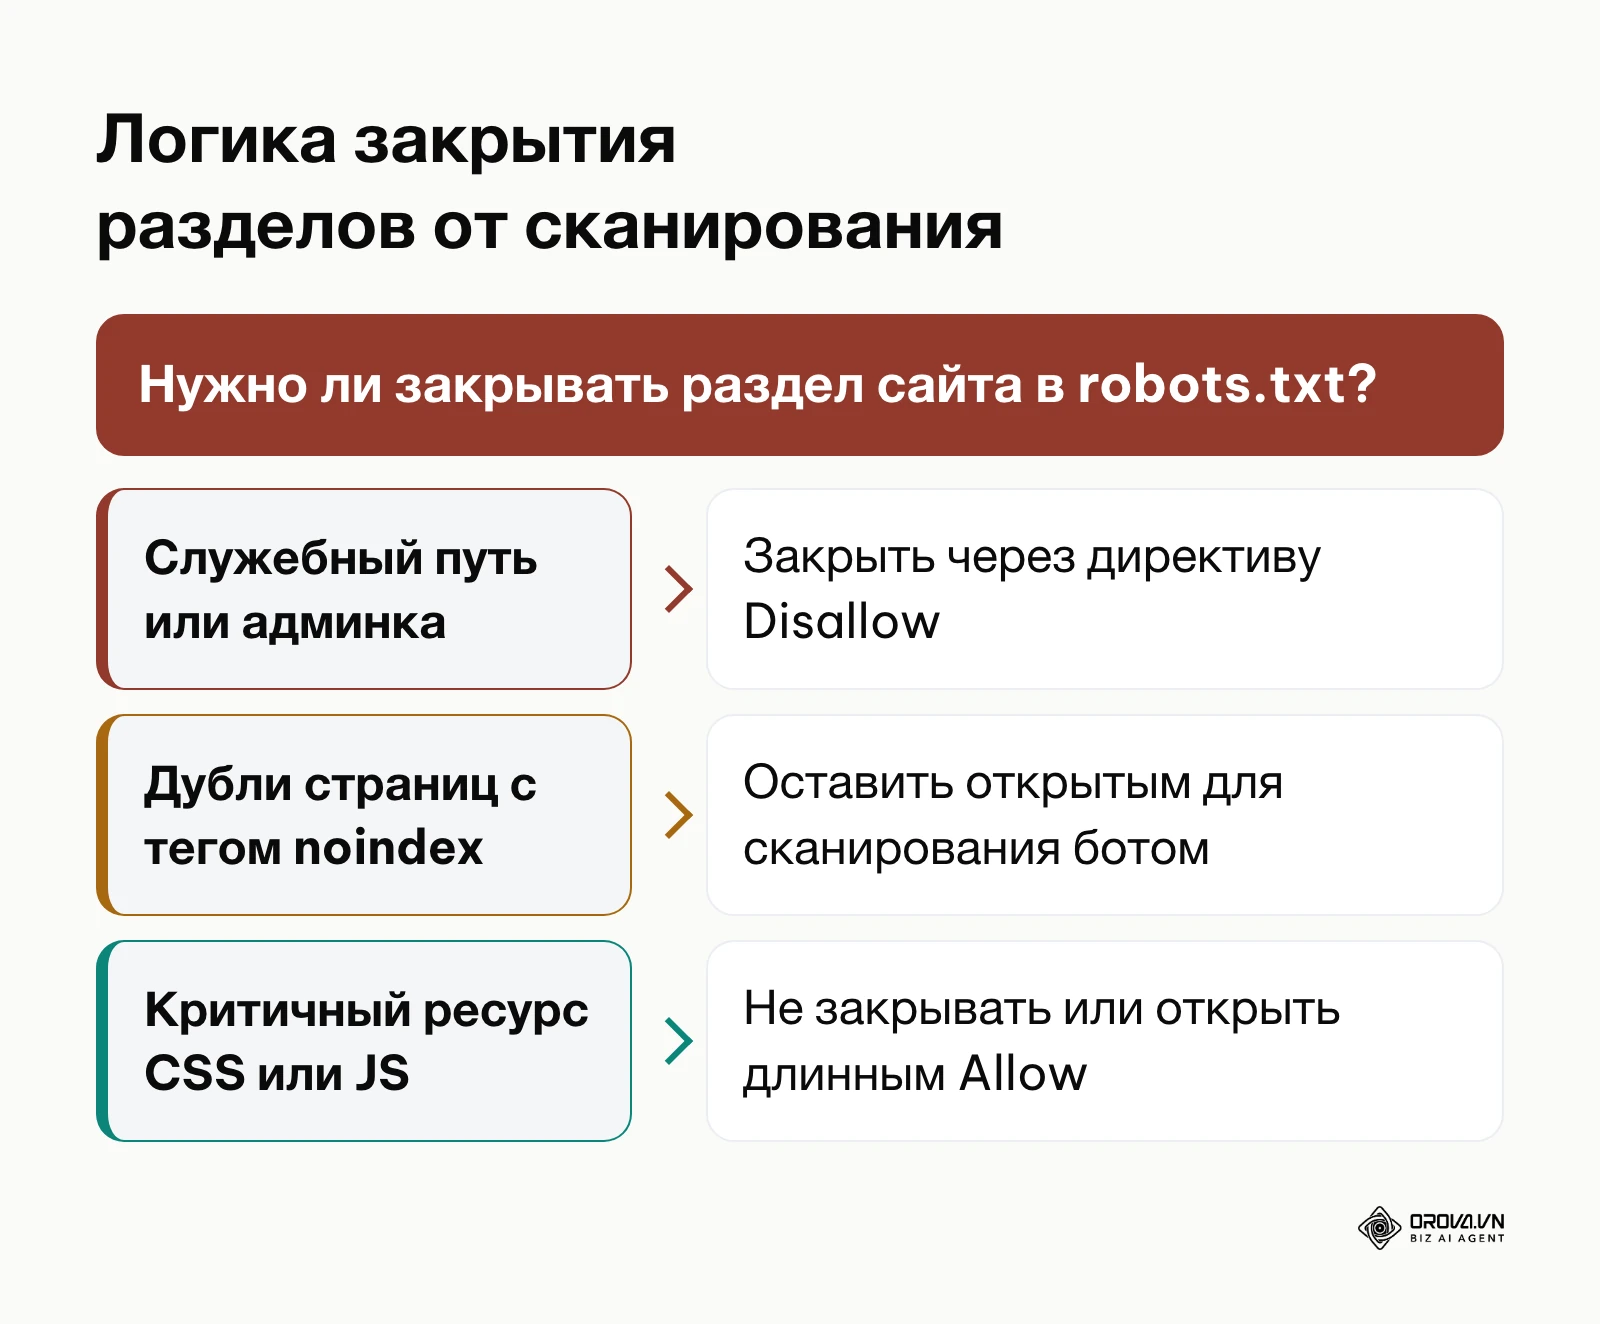
Откройте панель CMS, структуру папок в файловом менеджере хостинга и карту sitemap.xml. Выпишите пути к ядру CMS, авторизации, корзине, оформлению заказа, сортировкам и результатам внутреннего поиска. Отдельно отметьте GET-параметры, которые не меняют содержимое страницы (сортировка, вид списка, идентификатор сессии): для Яндекса их удобнее склеить директивой Clean-param, а не закрывать.
Результат: список масок URL в текстовом документе, разделенный на системные каталоги и GET-параметры, без путей к полезным статьям, категориям и товарам.
Частая ошибка: закрытие пагинации каталога и страниц тегов. Симптом: товары и статьи со второй и дальнейших страниц хуже находятся роботом. Исправление: оставьте пагинацию открытой, а дубли решайте через rel="canonical".
Условный пример. Интернет-магазин сантехники при аудите внес в список закрываемых всю папку /catalog/filter/. При сверке с sitemap выяснилось, что в ней лежат посадочные страницы брендов, которые продвигаются в поиске. Запрет сузили до параметра сортировки ?sort=, а страницы брендов оставили открытыми.
Шаг 2: Настройте базовые директивы для Googlebot и Yandexbot
Сформируйте группы правил с учетом того, что Google и Яндекс читают часть директив по-разному.
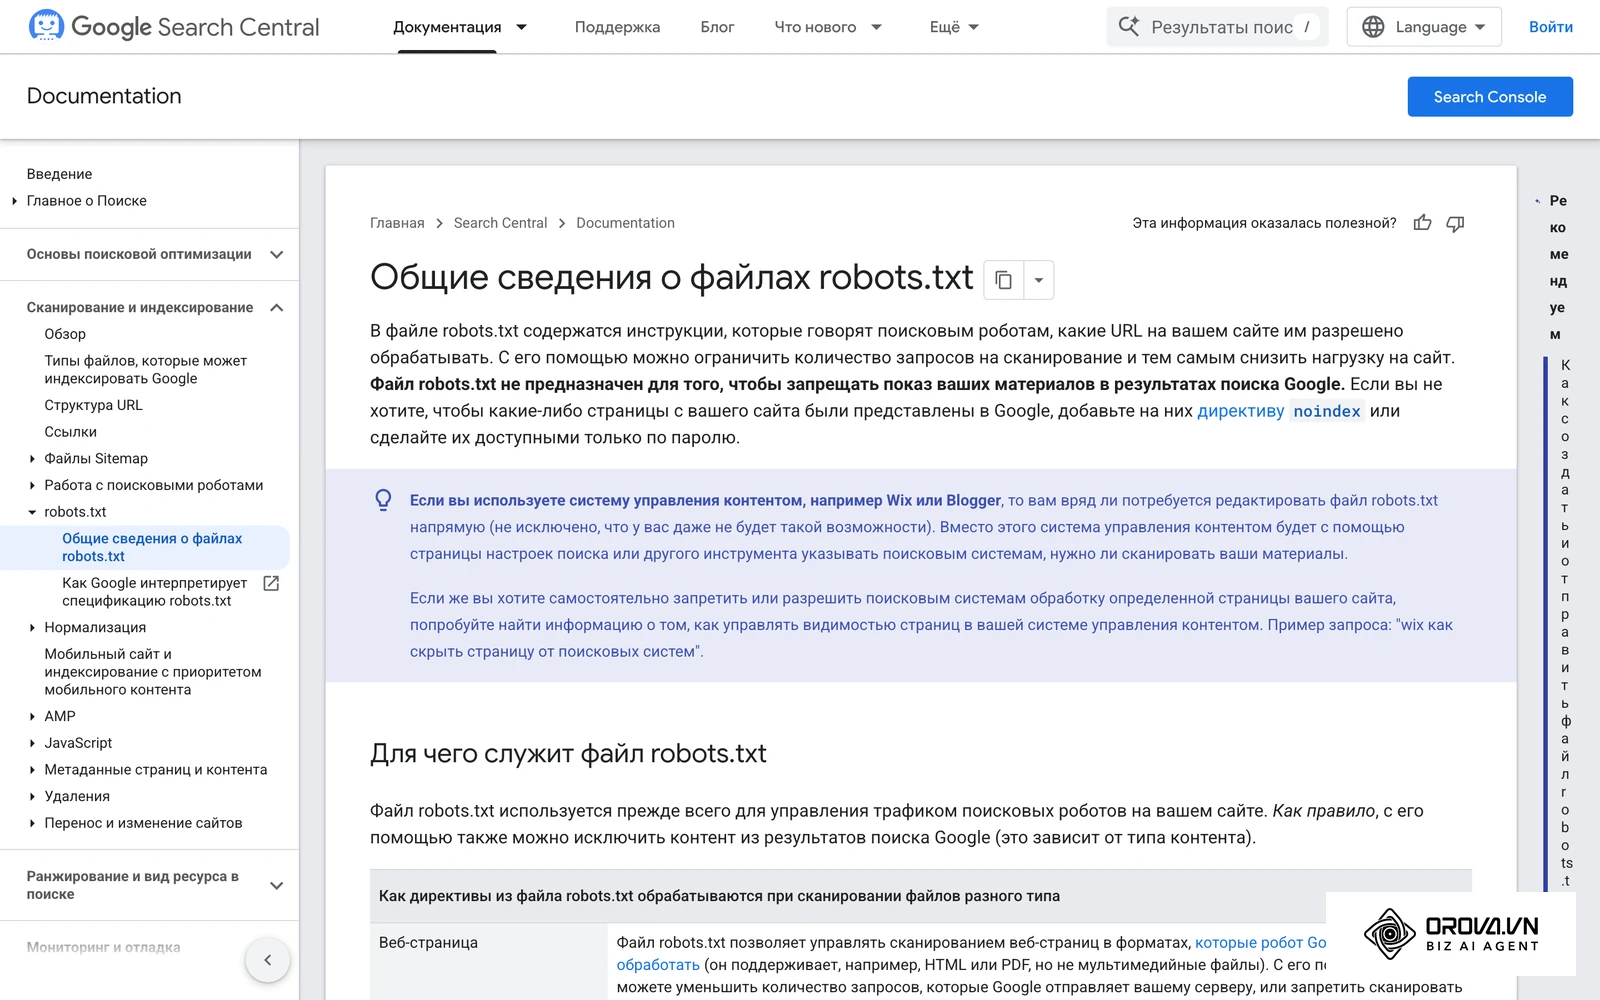
Откройте редактор кода и создайте базовую структуру файла. Согласно спецификации RFC 9309 «Robots Exclusion Protocol», принятой Инженерным советом Интернета (IETF) в 2022 году, поисковый робот выбирает блок правил с наиболее точным совпадением имени агента. По официальной документации Google Search Central о файлах robots.txt, краулер Googlebot не объединяет правила из блока User-agent: * со специализированным блоком User-agent: Googlebot, а читает только один из них. В свою очередь, согласно Справке Яндекс Вебмастера по использованию robots.txt, поисковик Яндекс поддерживает специфическую директиву Clean-param для удаления параметров сортировки и сессий из адресов страниц. Настройка robots.txt требует отдельного внимания к синтаксическим особенностям каждой поисковой системы.
В таблице сопоставлены различия, проверенные по документации обеих систем:
| Директива или правило | Яндекс | Что делать | |
|---|---|---|---|
| Clean-param | Не поддерживается, строка игнорируется | Поддерживается; директива межсекционная, ее можно указать в любом месте файла | Перечислять незначащие параметры для Яндекса; Google строку пропустит |
| Crawl-delay | Не поддерживается | Не учитывается с 22 февраля 2018 года | Удалить строку; скорость обхода Яндекса задавать в Вебмастере («Скорость обхода»), а при перегрузке сервера временно отдавать Google коды 503 или 429 |
| Host | Не поддерживается | Больше не учитывается | Удалить строку; главное зеркало задавать 301-редиректом |
| noindex в robots.txt | Не поддерживается с 1 сентября 2019 года | Не входит в директивы robots.txt | Использовать метатег robots или заголовок X-Robots-Tag на открытой странице |
| Спецсимволы * и $ | Поддерживаются | Поддерживаются | * — любая последовательность символов, $ — конец URL |
| Конфликт Allow и Disallow | Побеждает правило с более длинным путем; при равенстве — менее строгое (Allow) | Правила сортируются по длине префикса; при равной длине приоритет у Allow | Порядок строк в файле не важен, важна длина пути |
| Своя группа User-agent | Читается одна, самая точная группа; общие правила из * не добавляются | При наличии User-agent: Yandex группа * игнорируется | Повторять общие запреты внутри группы для конкретного робота |
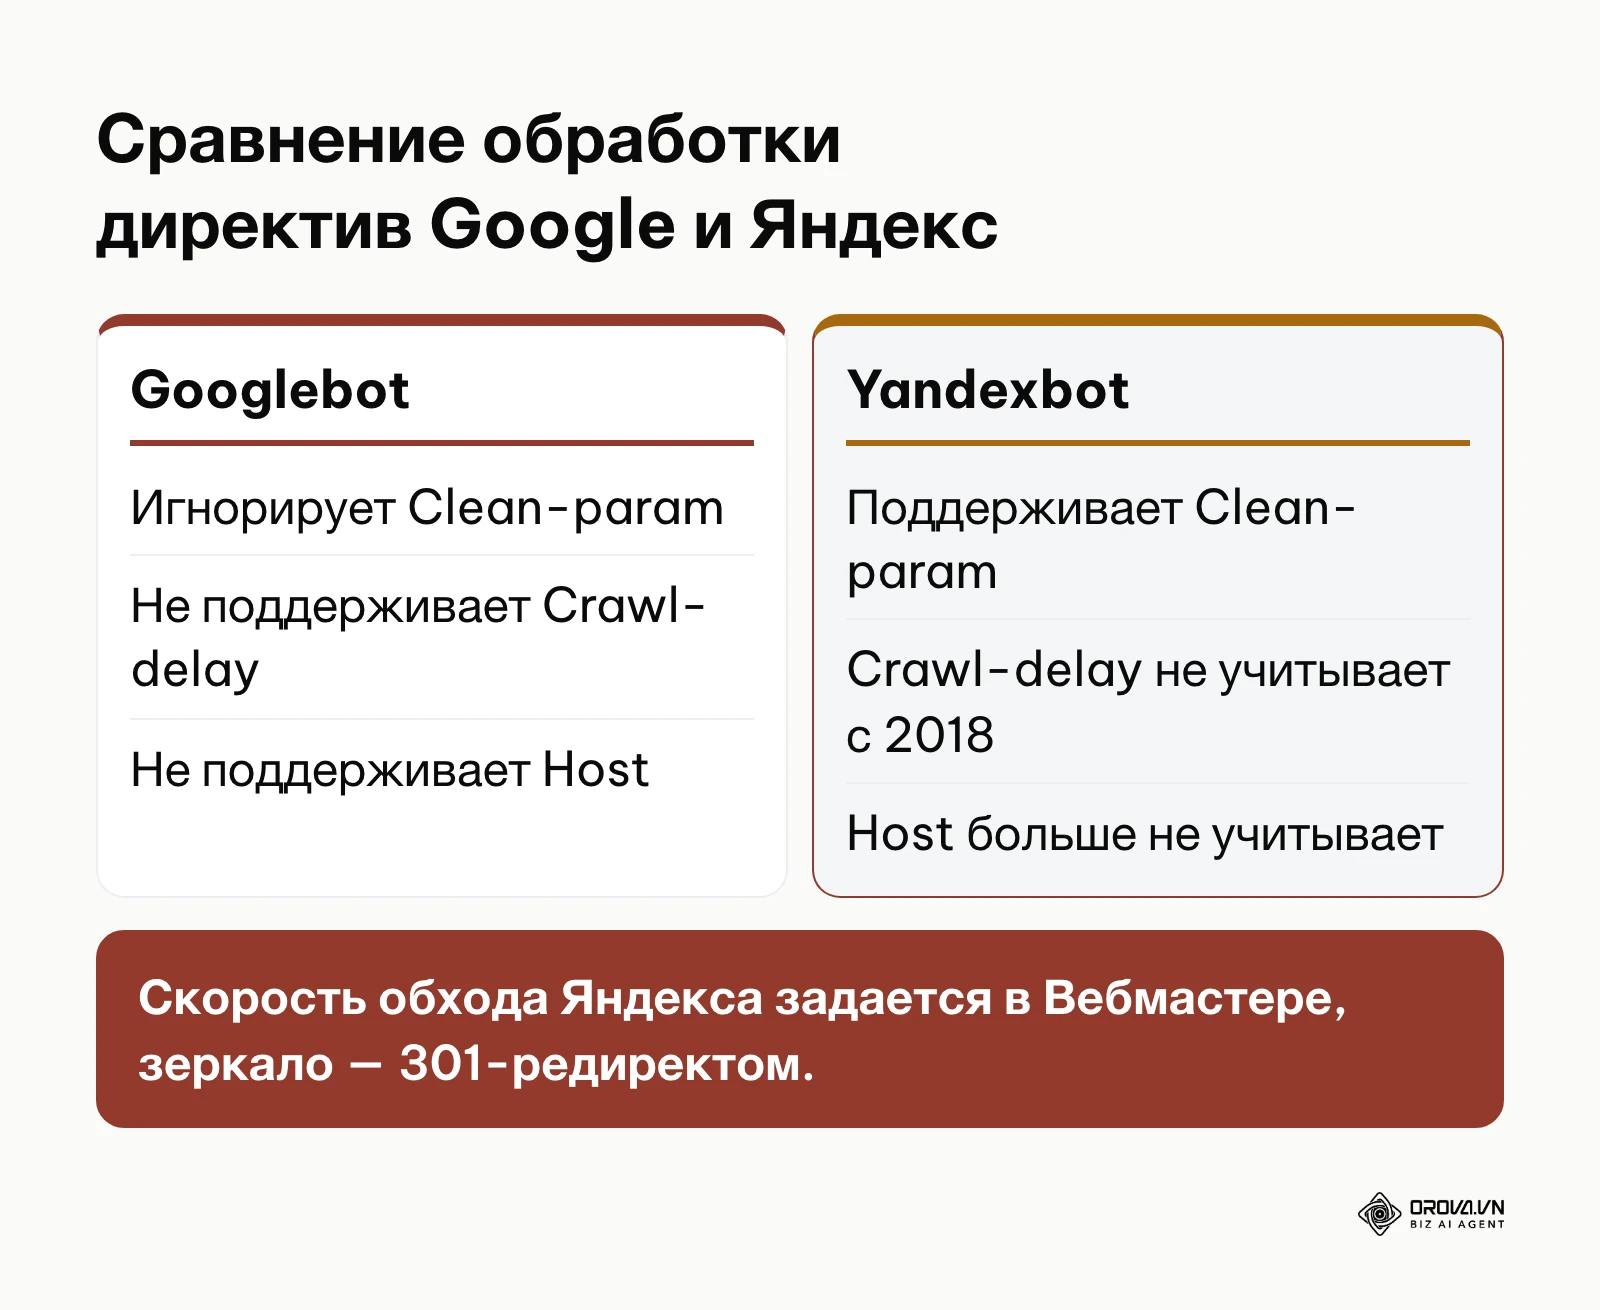
Визуальный результат: в файле есть общий блок User-agent: * и, при необходимости, отдельная секция User-agent: Yandex со всеми правилами для Яндекса.
Частая ошибка: старые строки Host и Crawl-delay, оставшиеся с прошлых лет. Обе системы их не учитывают, поэтому они создают ложное ощущение контроля. Удалите их: зеркало склейте 301-редиректом, скорость обхода Яндекса настройте в Вебмастере.
Шаг 3: Настройте правила для AI-ботов
Решите, каким роботам компаний, разрабатывающих нейросети, вы разрешаете собирать контент сайта.
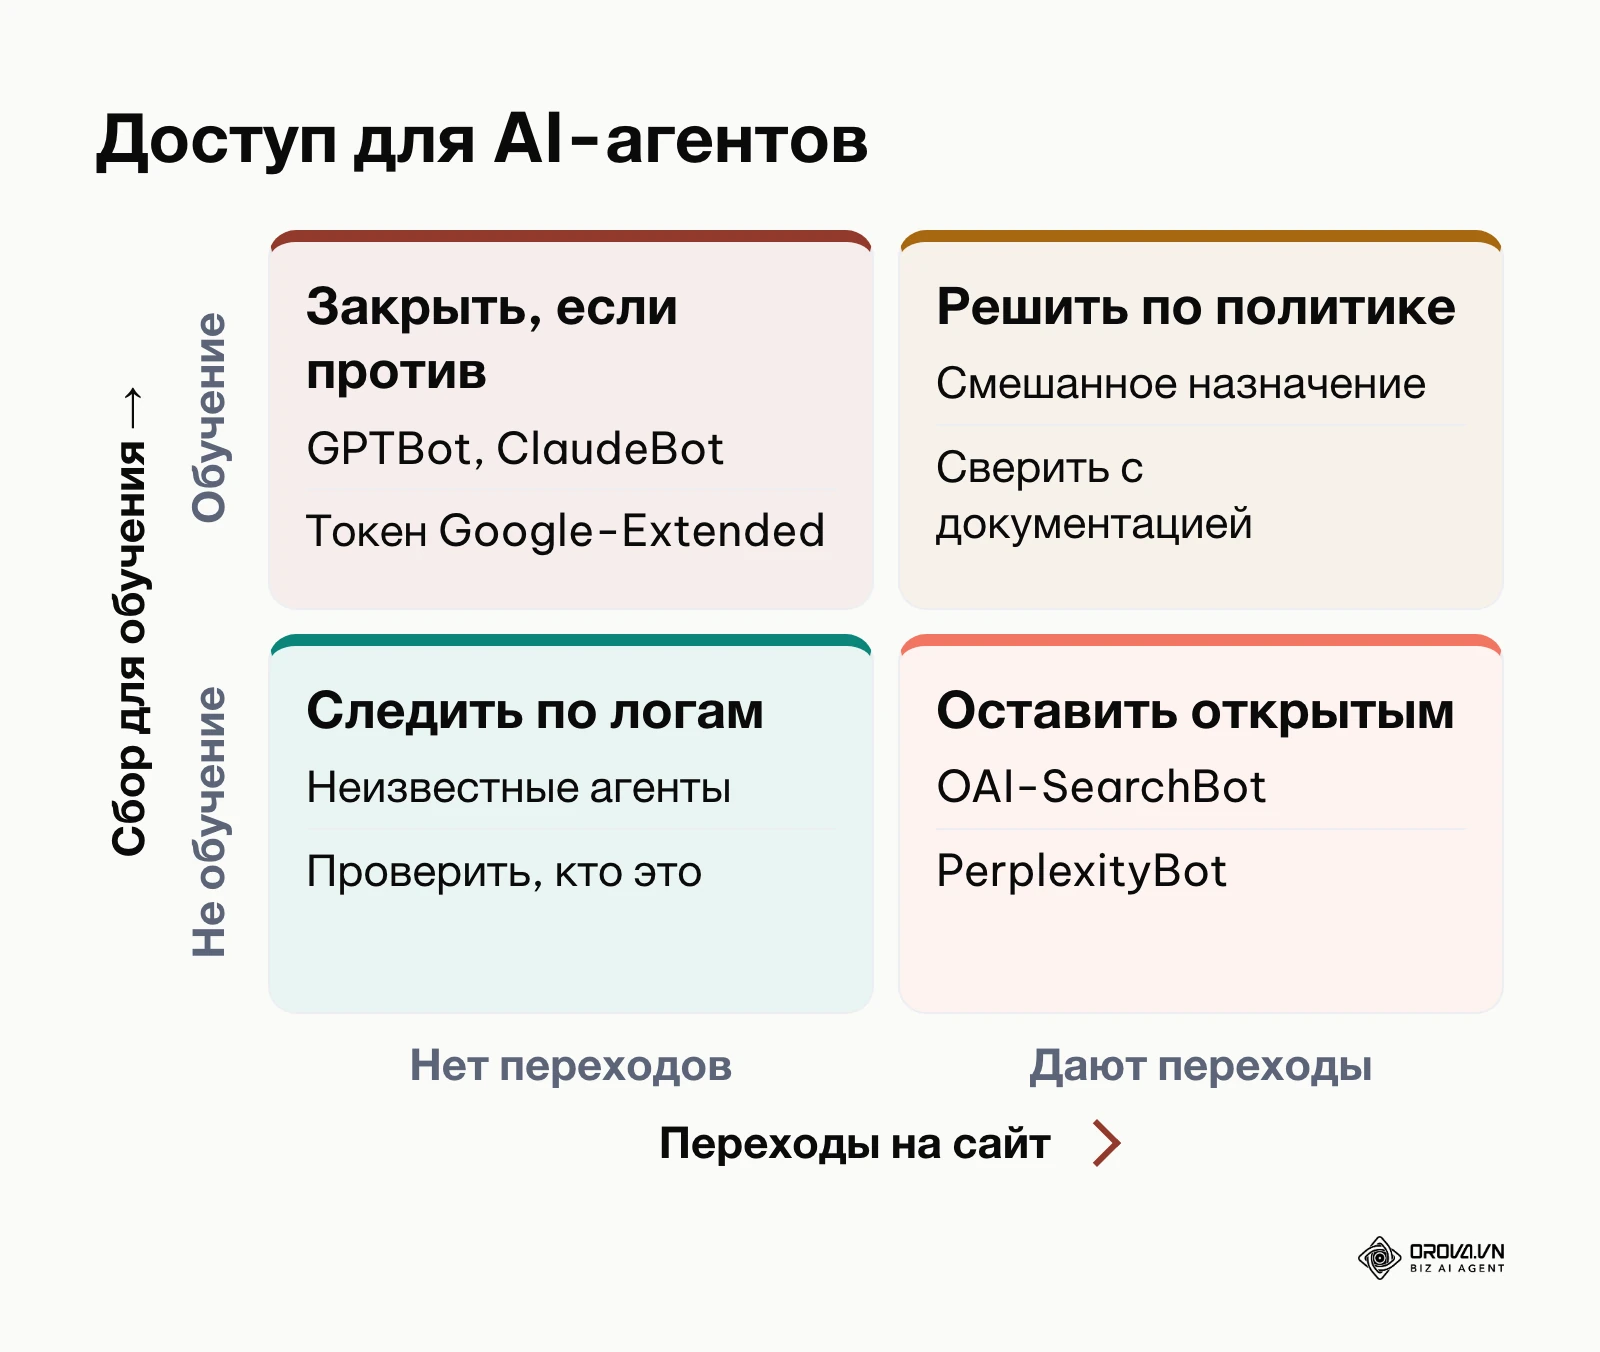
В таблицу включены только агенты, которые описаны на официальных страницах самих компаний. Список меняется, поэтому перед публикацией сверьтесь с документацией каждой компании.
| User-agent | Компания | Назначение по документации компании | Если закрыть |
|---|---|---|---|
| GPTBot | OpenAI | Сбор данных для обучения моделей | Контент не используется для обучения моделей OpenAI |
| OAI-SearchBot | OpenAI | Показ сайтов в результатах поиска ChatGPT | Сайт может не появляться в ответах поиска ChatGPT |
| ClaudeBot | Anthropic | Сбор данных для обучения моделей | Контент не используется для обучения моделей Anthropic |
| Google-Extended | Токен, который управляет использованием контента для обучения и ответов моделей Gemini; отдельного обхода нет | На показ в Google Поиске не влияет | |
| PerplexityBot | Perplexity | Показ сайтов и ссылок в результатах Perplexity | Сайт может не попадать в ответы Perplexity |
Пример разграничения: закрыть сбор для обучения и оставить доступ поисковым AI-агентам.
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /
Учтите две вещи. Во-первых, robots.txt — это просьба, а не блокировка: ее выполняют роботы, которые следуют стандарту. Во-вторых, закрывая AI-агентов, не трогайте основных поисковых роботов.
Визуальный результат: отдельные группы правил для каждого AI-агента, не смешанные с блоками Googlebot и Yandex.
Типичная ошибка: закрыть Googlebot или основной YandexBot, чтобы «спрятаться от нейросетей». Так сайт выпадает из обычного поиска. Для отказа от обучения Gemini используется токен Google-Extended, а не Googlebot. Отдельный user-agent для нейроответов Яндекса в статье не приводится: в Справке Вебмастера список роботов Яндекса смотрите в разделе о роботах в логах сервера.
После того как техническая доступность сайта настроена, переходите к контенту, который привлекает органический трафик. Модуль Orova SEO пишет статьи с изображениями, публикует их в WordPress через Application Password без плагина и обновляет старые статьи с сохранением исходных адресов.
Шаг 4: Откройте критически важные ресурсы CSS и JavaScript для рендеринга
Убедитесь, что поисковые системы могут загрузить таблицы стилей, скрипты и шрифты, без которых страница отображается неправильно.
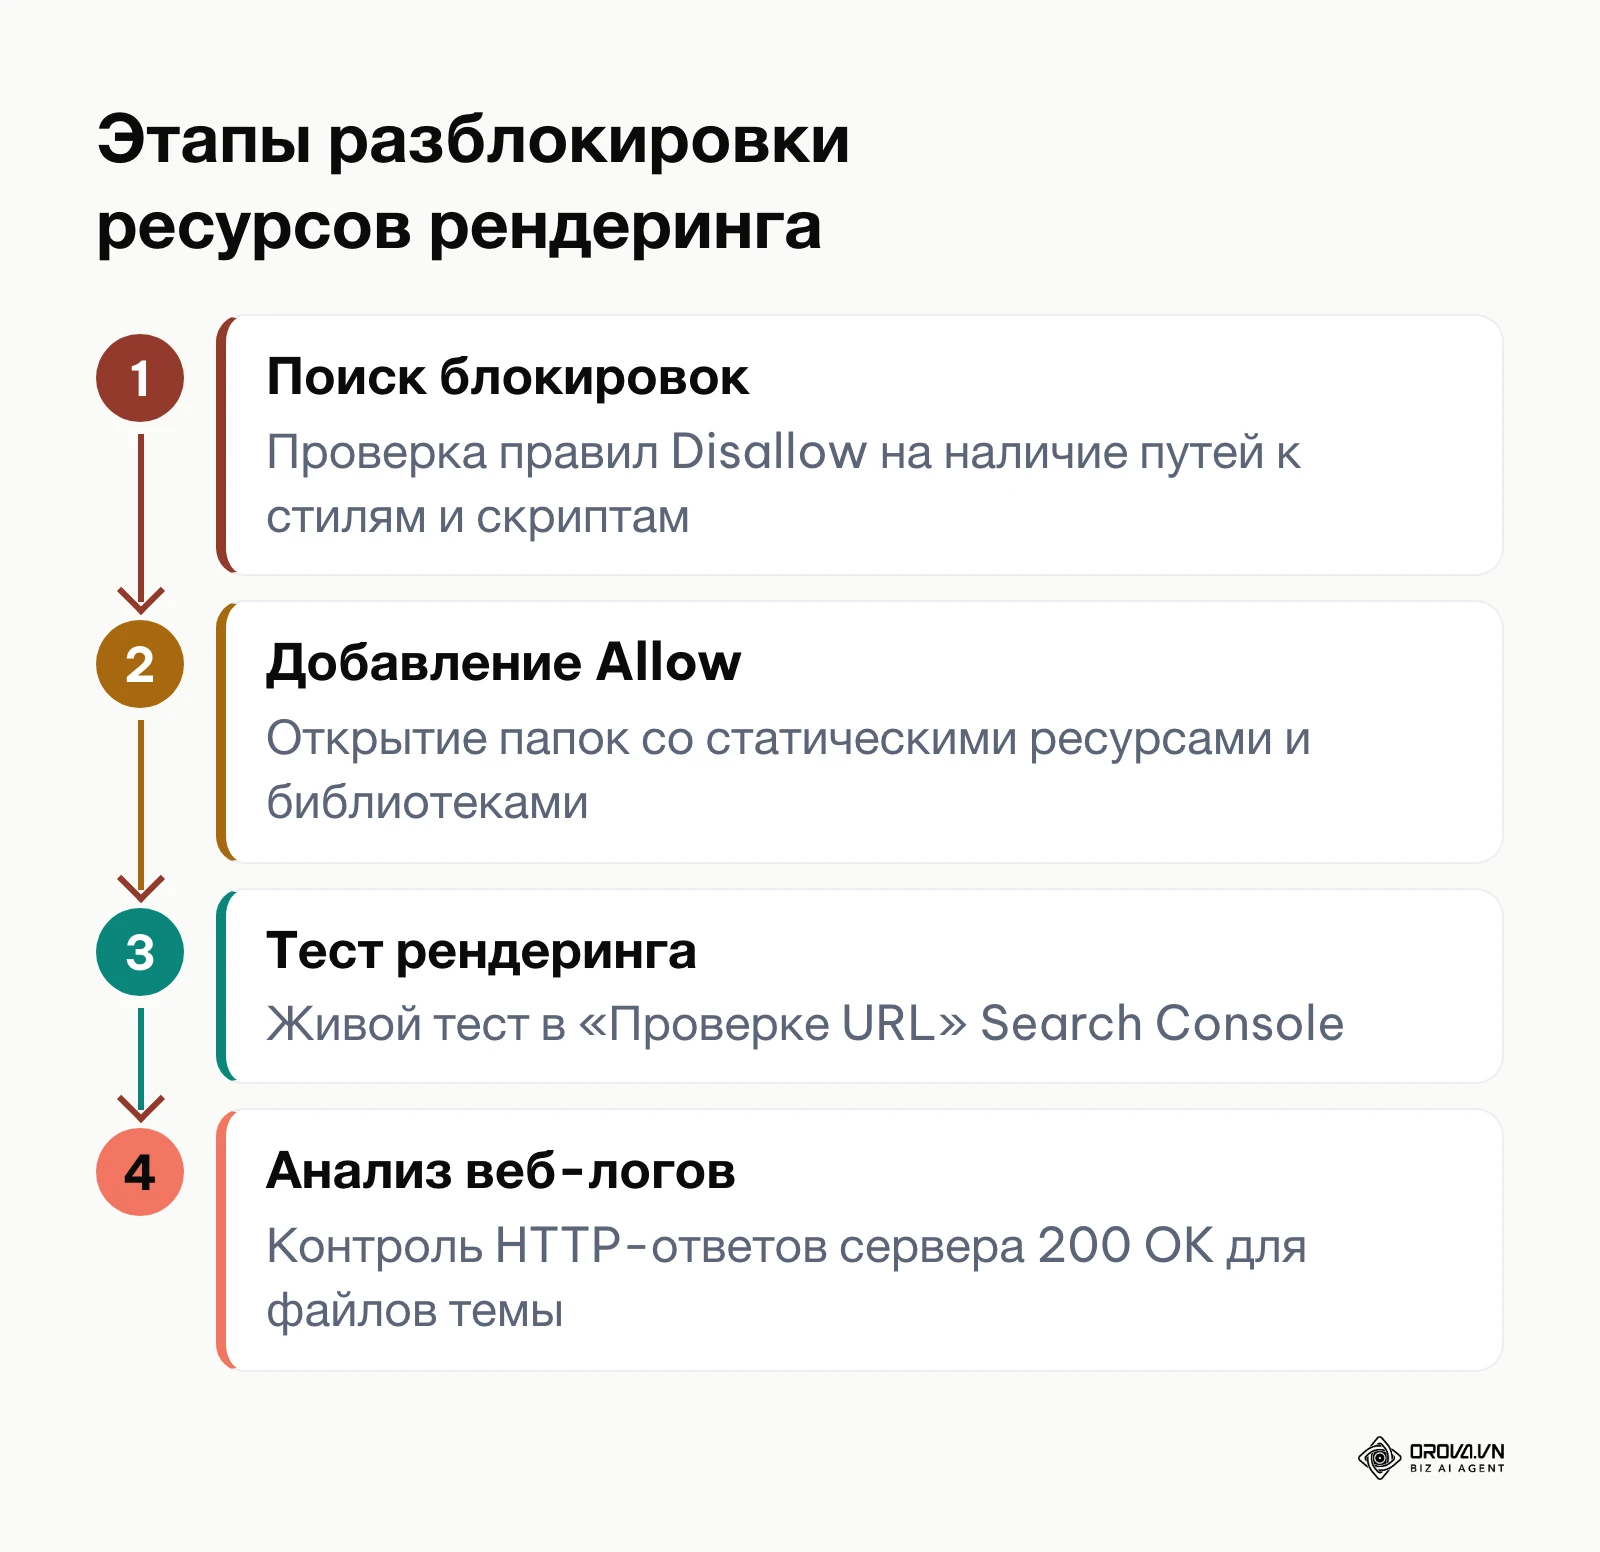
Проанализируйте все правила Disallow. Если вы закрываете родительские папки CMS, проверьте, не попадают ли под запрет файлы стилей и скриптов. Googlebot рендерит страницы в актуальной версии Chromium. Если CSS или JavaScript закрыты, Google может неверно понять содержимое и вёрстку страницы, в том числе ее мобильную версию; поэтому документация Google советует не блокировать ресурсы, нужные для отображения.
Помните о правиле длины пути: Allow: /*.css$ (7 символов) не перекрывает Disallow: /wp-includes/ (13 символов) — в этом случае Google выберет более длинное правило, и стили останутся закрытыми. Надежнее не закрывать такие папки целиком.
Проверочный чек-лист из 10 пунктов для контроля ресурсов рендеринга перед публикацией:
| № | Критерий проверки | Что контролировать | Способ подтверждения |
|---|---|---|---|
| 1 | Скрипты темы | Пути скриптов открыты для робота | Код HTTP 200 по прямому URL |
| 2 | Стили CSS | Файлы стилей доступны краулеру | Вкладка «Сеть» в инструментах разработчика |
| 3 | Файл admin-ajax.php | Обработчик разрешен в WordPress | Проверка URL в «Анализе robots.txt» Яндекса |
| 4 | Веб-шрифты | Шрифты .woff2 не под запретом | Нет ответов 403 в логах сервера |
| 5 | Иконки и графика | Файлы SVG и PNG доступны роботу | Скриншот в «Проверке URL» Search Console |
| 6 | Файлы на CDN | robots.txt CDN-домена не закрывает ресурсы | Открыть robots.txt самого CDN-домена |
| 7 | HTTP-статус ресурсов | Сервер отдает 200 OK без цепочек редиректов | Проверка заголовков через cURL |
| 8 | REST API CMS | Точки API, из которых строится контент, открыты | Валидный ответ JSON по прямому URL |
| 9 | Мобильная вёрстка | Робот видит метатег viewport и адаптивные стили | Скриншот живого теста в «Проверке URL» |
| 10 | Рендеринг текста | Основной текст не зависит от закрытого скрипта | Сравнение отрендеренного HTML со страницей |
Визуальный результат: в инструменте «Проверка URL» Google Search Console скриншот страницы совпадает с тем, что видит посетитель, а в списке ресурсов нет загрузок, заблокированных robots.txt.
Главная ошибка: закрытие папки wp-includes целиком в WordPress или /bitrix/ в Битрикс без разрешающих правил с более длинным путем.
Шаг 5: Сформируйте готовый файл под вашу CMS (WordPress или 1С-Битрикс)
Соберите целостный файл с учетом структуры каталогов вашей системы управления сайтом.
Важно: шаблоны ниже — пример-отправная точка, а не готовое решение. Пути зависят от темы, плагинов, настроек ЧПУ и структуры каталога. Перед публикацией проверьте каждый важный адрес своего сайта в «Анализе robots.txt» Яндекса и в «Проверке URL» Google.
Шаблон-пример для WordPress и WooCommerce
Замените домен и адрес карты сайта на свои:
# Пример-отправная точка: проверьте пути под свой сайт
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /*?s=
Disallow: /search/
# Страницы WooCommerce со стандартными адресами
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/

User-agent: Yandex
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /*?s=
Disallow: /search/
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/

# Межсекционная директива для Яндекса
Clean-param: replytocom

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

# Адрес карты: у WordPress без плагинов — /wp-sitemap.xml
Sitemap: https://vash-sait.ru/sitemap_index.xml
Метки utm_source, utm_medium и похожие параметры аналитики Яндекс, по его Справке, может отбрасывать автоматически, поэтому прописывать их в Clean-param обычно не нужно.
Шаблон-пример для 1С-Битрикс
Для 1С-Битрикс конфигурация закрывает системные папки, но оставляет открытыми ресурсы шаблона:
# Пример-отправная точка: проверьте пути под свой сайт
User-agent: *
Disallow: /bitrix/
Allow: /bitrix/cache/
Allow: /bitrix/js/
Allow: /bitrix/templates/
Disallow: /personal/
Disallow: /search/
Disallow: /auth/
Disallow: /*?sort=
# Закрывайте страницы фильтра, только если они не служат посадочными
# Disallow: /*/filter/

User-agent: Yandex
Disallow: /bitrix/
Allow: /bitrix/cache/
Allow: /bitrix/js/
Allow: /bitrix/templates/
Disallow: /personal/
Disallow: /search/
Disallow: /auth/

Clean-param: sort&order&view /catalog/

User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

Sitemap: https://vash-sait.ru/sitemap.xml
Если шаблон сайта лежит в папке /local/templates/, он не попадает под запрет /bitrix/. В конструкторе Tilda файл robots.txt формируется автоматически; какие правки доступны в вашем проекте, уточните в справке Tilda.
Условный пример. Корпоративный блог на WordPress после редизайна получил строку Disallow: /wp-includes/ и правила Allow: /*.css$. Редактор считал, что стили открыты, но в «Проверке URL» скриншот страницы оказался без оформления: более длинное правило Disallow перекрыло короткое Allow. Строку Disallow: /wp-includes/ удалили, после чего живой тест показал страницу в нормальном виде.
Визуальный результат: текстовый файл с проверенными под ваш сайт директивами и абсолютным адресом карты сайта.
Ошибка: указание относительного адреса карты (например, Sitemap: /sitemap.xml). Директиве нужен полный URL с протоколом https://.
Шаг 6: Загрузите файл в корневой каталог веб-сервера через FTP или хостинг
Разместите файл на сервере и проверьте, что он отдается с правильным кодом ответа.
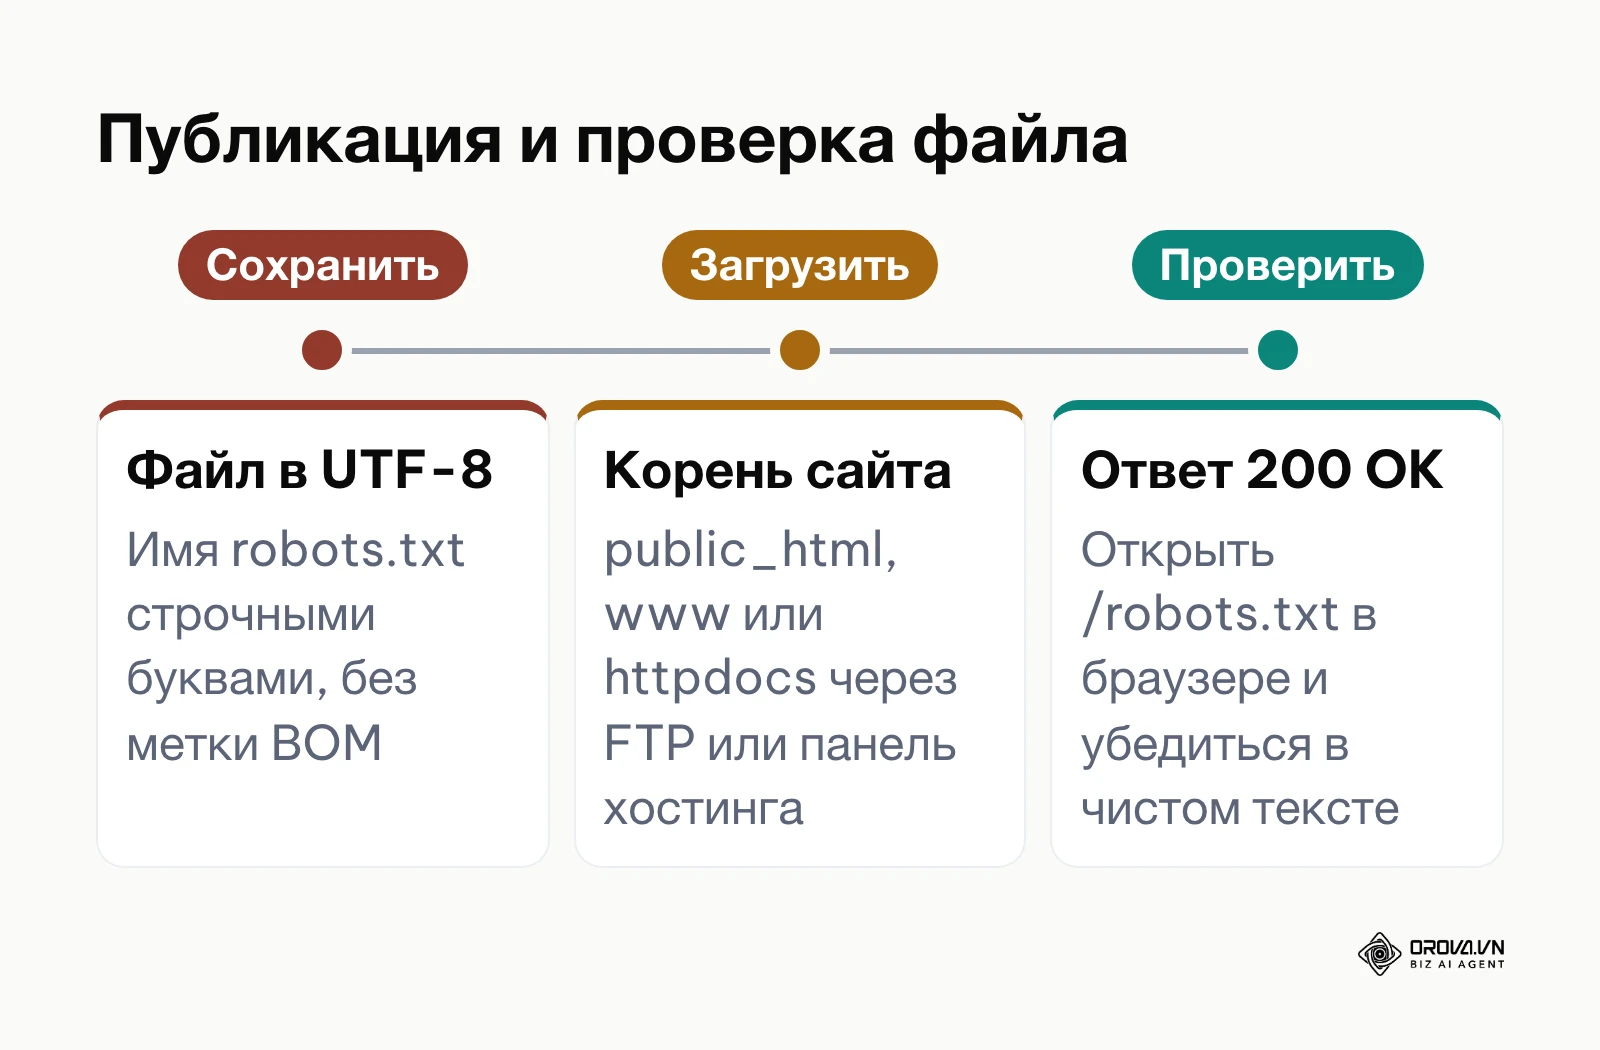
Подключитесь к серверу через FTP-клиент FileZilla или файловый менеджер панели хостинга (cPanel, FastPanel или ISPmanager). Перейдите в корневую директорию сайта (public_html, www или httpdocs). Загрузите файл строго под именем robots.txt в нижнем регистре. Права доступа 644 разрешают веб-серверу читать файл.
Откройте браузер и перейдите по адресу https://vash-sait.ru/robots.txt. На экране должен отобразиться чистый текст без HTML-оформления.
Как Google реагирует на код ответа (по спецификации Google Search Central):
| Ответ сервера | Что делает Google |
|---|---|
| 200 OK | Читает правила из файла |
| 4xx (кроме 429), в том числе 404 | Считает, что файла нет и ограничений сканирования нет |
| 5xx | Первые 12 часов не сканирует сайт и пытается получить файл снова; затем до 30 дней использует последнюю удачную версию |
Типичная ошибка: файл сохранен с меткой BOM. Google по своей спецификации игнорирует BOM в начале файла, но другие роботы и парсеры могут прочитать эти байты как часть первой строки. Сохраняйте файл без BOM: в Notepad++ выберите «Кодировки» → «Преобразовать в UTF-8».
Шаг 7: Протестируйте правила в Яндекс Вебмастере и Google Search Console
Проверьте синтаксис и то, как правила применяются к конкретным адресам.
В Яндекс Вебмастере откройте «Инструменты» → «Анализ robots.txt». Загрузите текущий файл сайта или вставьте новый текст, затем добавьте в список проверки адреса: главную страницу, категорию каталога, корзину, внутренний поиск и admin-ajax.php. Запустите проверку и убедитесь, что корзина и поиск запрещены, а главная и каталог разрешены. Для запрещенного адреса инструмент показывает правило, которое сработало.
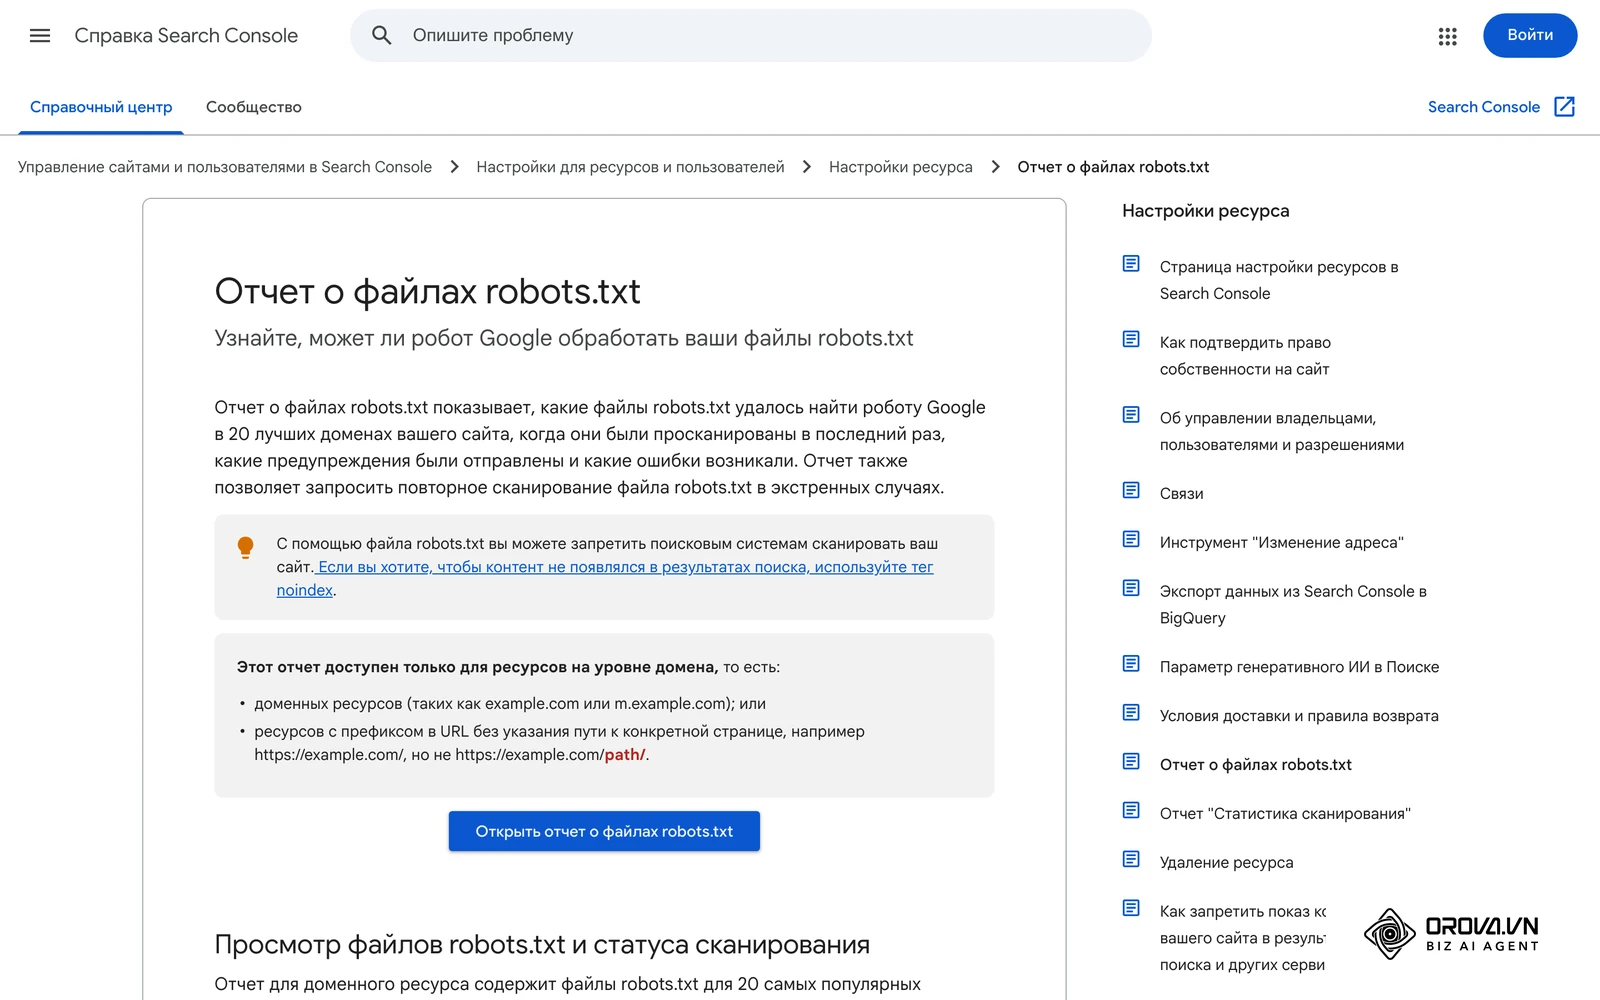
В Google Search Console откройте «Настройки» → «Отчет о файлах robots.txt». В отчете видно, какие файлы robots.txt нашел робот Google, статус получения («Получен» или «Не получен»), время последнего сканирования, предупреждения и ошибки. После срочной правки там же можно запросить повторное сканирование файла. Затем проверьте ключевую страницу инструментом «Проверка URL» и запустите живой тест опубликованной версии. Если вы впервые работаете с консолью, пригодится наше руководство по Google Search Console.
Визуальный результат: в «Анализе robots.txt» нет ошибок, нужные адреса разрешены, а в отчете Search Console файл имеет статус «Получен» без предупреждений.
Частая ошибка: не проверить ответ сервера. Если robots.txt отдает 5xx, Google временно прекращает сканирование сайта, поэтому ошибку сервера нужно исправить в первую очередь.
Условный пример. Технический директор каталога оборудования на 1С-Битрикс перед релизом вставил черновик файла в «Анализ robots.txt» и проверил список ключевых адресов. Инструмент отметил строку Clean-param с параметрами, разделенными запятыми. По Справке Яндекса параметры перечисляются через &, поэтому запись исправили на Clean-param: sort&page /catalog/, и повторная проверка прошла без ошибок.
Сводный чек-лист настройки robots.txt от создания до проверки
Сводная таблица этапов и признаков готовности:
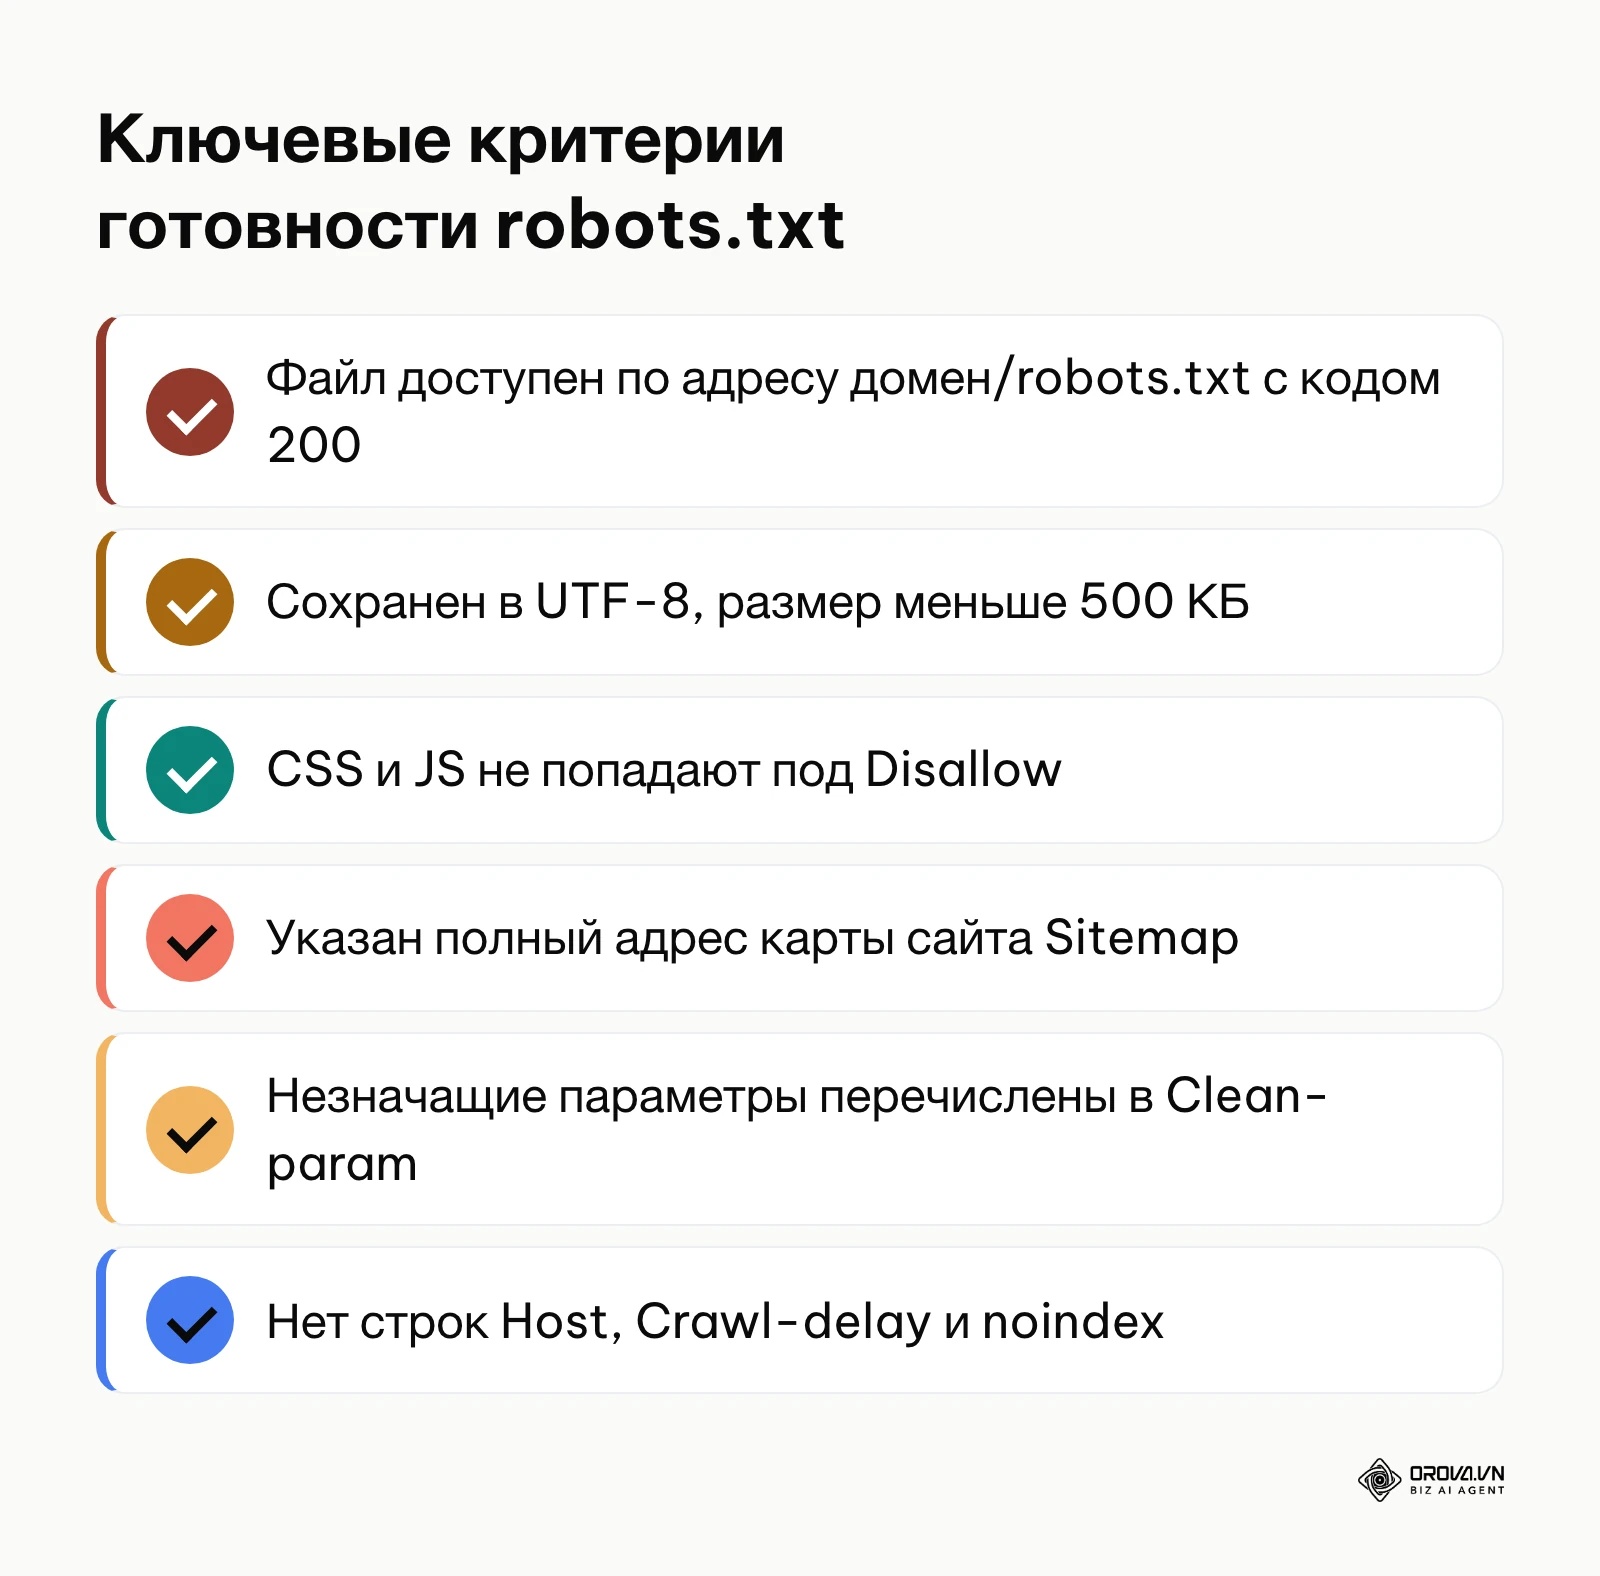
| Шаг | Главная задача | Признак готовности |
|---|---|---|
| 1. Аудит разделов | Выделение служебных путей и параметров | Список масок URL в текстовом документе |
| 2. Базовые директивы | Группы для всех роботов и для Яндекса | Нет строк Host, Crawl-delay и noindex |
| 3. Правила AI-ботов | Решение по агентам обучения и AI-поиска | Отдельные группы для выбранных агентов |
| 4. Открытие рендеринга | Доступ к стилям, скриптам и шрифтам | CSS, JS и admin-ajax.php не под запретом |
| 5. Сборка под CMS | Адаптация шаблона под свой сайт | Абсолютный адрес Sitemap, пути проверены |
| 6. Публикация на сервере | Загрузка файла в корень | Файл отдает HTTP 200, кодировка UTF-8 |
| 7. Тестирование | Проверка в Вебмастере и Search Console | Нет ошибок, статус «Получен» |
Выбирайте темы на основе данных вашей Google Search Console: модуль Orova SEO выделяет приоритетные запросы с позиций 8–30 и помогает вести контент для них в одном месте. Платформа доступна бесплатно до 7 июля 2027 года.
Ошибки в robots.txt и способы их исправления
Распространенные сбои, их причины и способы исправления:
| Ошибка | Вероятная причина | Как исправить |
|---|---|---|
| Закрытие сайта правилом Disallow: / | Перенос конфигурации с тестового домена | Замените на выборочные правила |
| Попытка удалить URL через Disallow | Путаница между сканированием и индексацией | Откройте URL в robots.txt и добавьте noindex в метатег robots |
| noindex внутри robots.txt | Старая неофициальная практика | Google не поддерживает его с 2019 года; используйте метатег или X-Robots-Tag |
| Строки Host и Crawl-delay | Устаревшие инструкции | Удалите; зеркало — 301-редиректом, скорость обхода Яндекса — в Вебмастере |
| Стили закрыты, хотя есть Allow | Disallow с более длинным путем перекрывает Allow | Сузьте Disallow или добавьте Allow с более длинным путем |
| Относительный путь к Sitemap | Ошибка при ручном заполнении | Укажите полный адрес карты с https:// |
Как быстро проверить сайт с Orova SEO Check и Orova SEO
Перед ручной проверкой можно получить технический срез страницы в Orova SEO Check (orova.vn/ru/seo-check). Это бесплатный инструмент (бесплатно до 7 июля 2027 года), регистрация не нужна:
- Откройте Orova SEO Check и вставьте ссылку на страницу сайта.
- Получите отчет: технические проверки страницы, данные PageSpeed и ссылочный профиль на уровне домена.
- Сверьте найденные проблемы с шагами этой инструкции. Инструмент проверяет указанную страницу, а не обходит весь сайт, поэтому сам robots.txt все равно проверяйте в «Анализе robots.txt» Яндекса и в отчете Search Console.
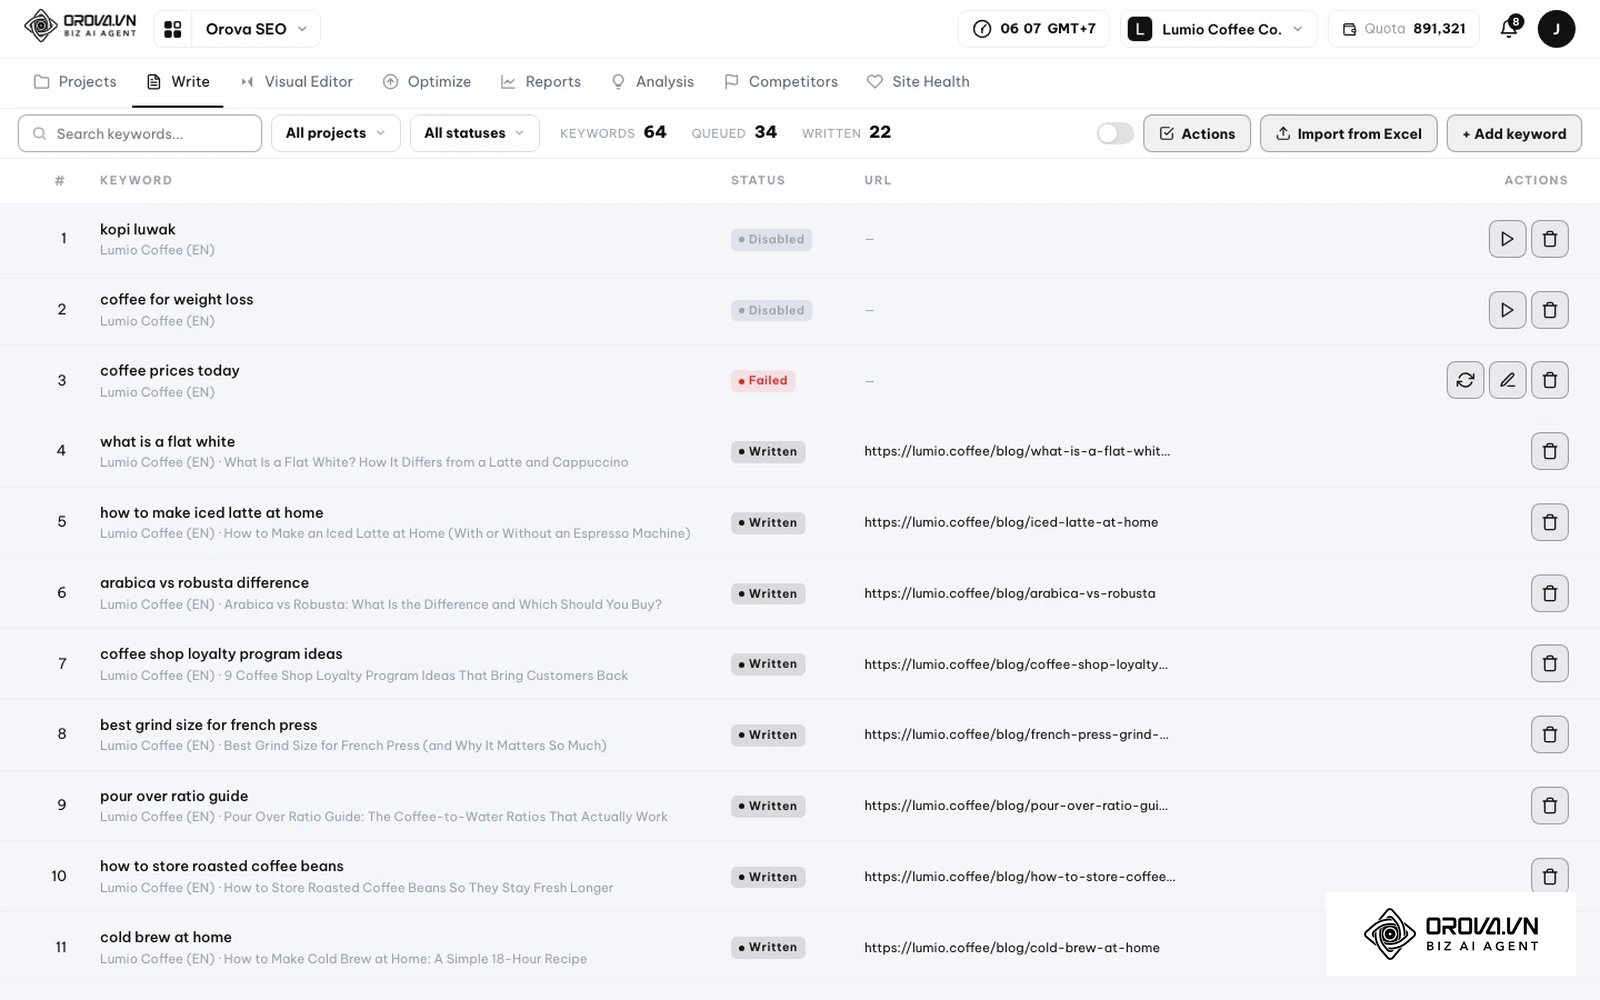
Когда технические вопросы закрыты, переходите к контенту: темы удобно распределить по шаблону контент-плана, а сами статьи вести в модуле Orova SEO. Он берет приоритетные ключевые запросы из вашей Google Search Console (позиции 8–30), пишет статьи с изображениями, публикует их в WordPress через Application Password без плагина и обновляет старые статьи с сохранением адреса:
- Откройте в Orova SEO вкладку Write — в ней список ключевых слов со статусами и адресами опубликованных статей.
- Нажмите + Add keyword, чтобы добавить запрос, или Import from Excel, чтобы загрузить список.
Как оценить результаты корректной настройки robots.txt
Оценивайте результат по отчетам самих поисковых систем.
В Google Search Console откройте «Настройки» → «Статистика сканирования». Смотрите на общее число запросов, среднее время ответа сервера и типы файлов. После закрытия мусорных URL доля обращений к ним должна снижаться, а доля полезных HTML-страниц — расти.
В Яндекс Вебмастере отслеживайте «Индексирование» → «Статистика обхода» и раздел «Страницы в поиске». Адреса с параметрами из Clean-param Вебмастер отмечает как исключенные этой директивой.
Изменения появляются не сразу. Google обычно кэширует robots.txt до 24 часов, а перераспределение обхода и выпадение лишних адресов из поиска занимает больше времени — сроки зависят от размера и структуры сайта.
Тренды управления краулингом и robots txt в ближайшие годы: мнение автора
Глядя на то, как меняются краулеры, я выделяю три направления, которые, на мой взгляд, будут влиять на управление сканированием:
Первое: разделение доступа для поиска и для обучения моделей. Уже сейчас у OpenAI есть отдельные агенты для обучения и для поиска, а у Google — отдельный токен Google-Extended рядом с Googlebot. Я думаю, такое разделение будет только расширяться, и владельцам сайтов придется принимать решение по каждому агенту отдельно. Формат llms.txt я пока считаю предложением сообщества, а не стандартом, и не стал бы рассчитывать на него как на замену robots.txt.
Второе: рост ценности серверного рендеринга. Рендеринг JavaScript требует от поисковиков заметных ресурсов. Мне кажется, страницы, которые отдают основной контент уже в исходном HTML, будут в более выгодном положении, поэтому имеет смысл проверять, что ключевой текст не зависит от закрытых или тяжелых скриптов.
Третье: более строгое следование RFC 9309. Сейчас роботы стараются разобрать даже файлы с мелкими ошибками. Я ожидаю, что поисковики будут все точнее придерживаться стандарта, а значит, синтаксическую проверку файла стоит встроить в каждый выпуск сайта.
Мои суждения могут оказаться ошибочными, если поисковые платформы перейдут на другие способы получения контента, например прямую передачу данных через API.
Часто задаваемые вопросы о robots txt
Удалит ли директива Disallow страницу из результатов поиска Google и Яндекс?
Нет, директива Disallow лишь запрещает роботу загружать страницу. Если на URL ведут ссылки, поисковик может показать адрес без описания. Чтобы удалить страницу из поиска, оставьте ее открытой в robots.txt и добавьте noindex в метатег robots или заголовок X-Robots-Tag.
Поддерживает ли Google директиву noindex в robots.txt?
Нет. Google прекратил поддержку неофициальных правил вроде noindex в robots.txt с 1 сентября 2019 года. Используйте метатег robots или HTTP-заголовок X-Robots-Tag на странице, открытой для сканирования.
Почему изменения в файле robots.txt учитываются не сразу?
Роботы перечитывают файл по своему расписанию. Google обычно кэширует robots.txt до 24 часов, а в отчете о файлах robots.txt в Search Console можно запросить повторное сканирование в срочных случаях. Яндекс тоже использует сохраненную копию до следующего обращения к файлу.
Каков максимальный размер файла robots.txt?
Google обрабатывает первые 500 КиБ файла, а все, что ниже этого объема, игнорирует. Яндекс в Справке указывает, что корректно обрабатывает файлы размером до 500 КБ. Если файл приближается к лимиту, объединяйте правила масками вместо перечисления отдельных страниц.
Можно ли закрыть сайт от AI-ботов и остаться в поиске?
Да. Закрывайте конкретных агентов, например GPTBot, ClaudeBot или токен Google-Extended, и не трогайте Googlebot и основной робот Яндекса. Учтите, что правила выполняют только роботы, которые следуют стандарту.
Можно ли указать несколько файлов Sitemap в robots.txt?
Да, каждый файл карты сайта указывается в отдельной строке с директивой Sitemap и полным адресом. Если карт много, удобнее сослаться на индексный файл карты сайта.
С чего начать?
Оцените текущее состояние сайта и выполните один первый шаг:
Ситуация 1: Новый сайт перед публичным запуском. Откройте файл в корне сайта и убедитесь, что в нем нет сплошной блокирующей строки Disallow: /, оставшейся со стадии разработки. Пропишите базовый блок правил, добавьте полный адрес карты сайта и проверьте ответ сервера в браузере.
Ситуация 2: Действующий интернет-магазин с мусорными страницами в поиске. Откройте логи сервера, выделите самые частые GET-параметры сортировок и фильтров, которые не меняют содержимое, и оформите для них Clean-param для Яндекса. Для Google решайте дубли через rel="canonical" или точечные правила Disallow.
Ситуация 3: Контентный блог, потерявший позиции после редизайна. Запустите живой тест ключевых статей в «Проверке URL» Google Search Console и убедитесь, что файлы стилей и скриптов темы не заблокированы в родительских папках.
Сверяйте каждый шаг с официальной документацией Google Search Central и Справкой Яндекс Вебмастера: правила для роботов меняются, и файл robots txt стоит пересматривать после каждого крупного обновления сайта.
Об авторе
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Ведите бизнес с AI Agents
Orova — Biz AI Agent, который работает без перерывов: планирует, выполняет и оптимизирует задачи за вас.
Экономьте время, раскрывайте продуктивность.