Páginas huérfanas: qué son y cómo resolverlas para recuperar tu SEO
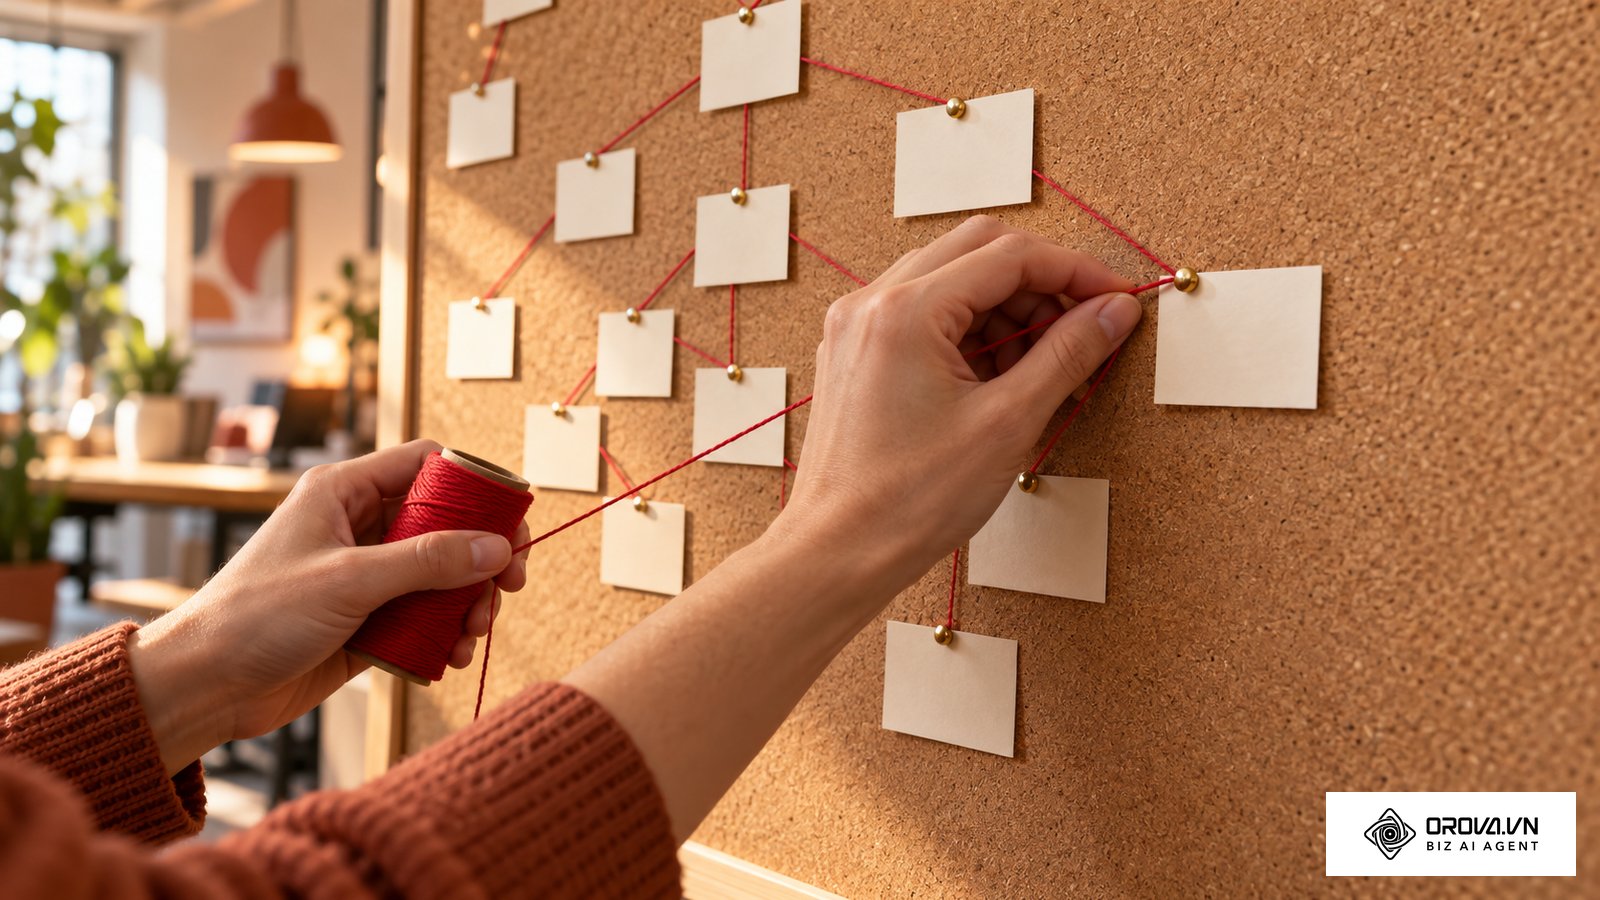
Las páginas huérfanas son URLs de tu web hacia las que no apunta ningún enlace interno, de modo que ni los buscadores ni los usuarios pueden llegar a ellas navegando por el sitio. Representan uno de los problemas silenciosos más perjudiciales para cualquier proyecto digital que busca visibilidad orgánica sostenible. Es habitual publicar contenidos valiosos, actualizar fichas de catálogo o rediseñar categorías completas, para luego comprobar con frustración que Googlebot tarda semanas en descubrir las URLs o que el tráfico orgánico se estanca sin motivo aparente. Durante años se asumió que incluir una página en el archivo XML Sitemap o utilizar comandos básicos en el buscador era suficiente para garantizar la relevancia de cada URL. Sin embargo, ese enfoque ignora cómo operan el rastreo y la autoridad interna. Esta guía técnica desglosa el proceso para auditar tu arquitectura, cruzando herramientas de rastreo con Google Search Console y analítica web, aplicando una matriz cuantitativa para sanear tu estructura.
¿Qué son las páginas huérfanas en SEO?
Las páginas huérfanas son páginas web que carecen por completo de enlaces internos entrantes desde otras secciones del mismo sitio, lo que impide que los motores de búsqueda las rastreen a través de la navegación normal. Se diferencian de los enlaces rotos porque responden con un código de estado válido pero permanecen aisladas en la arquitectura web.
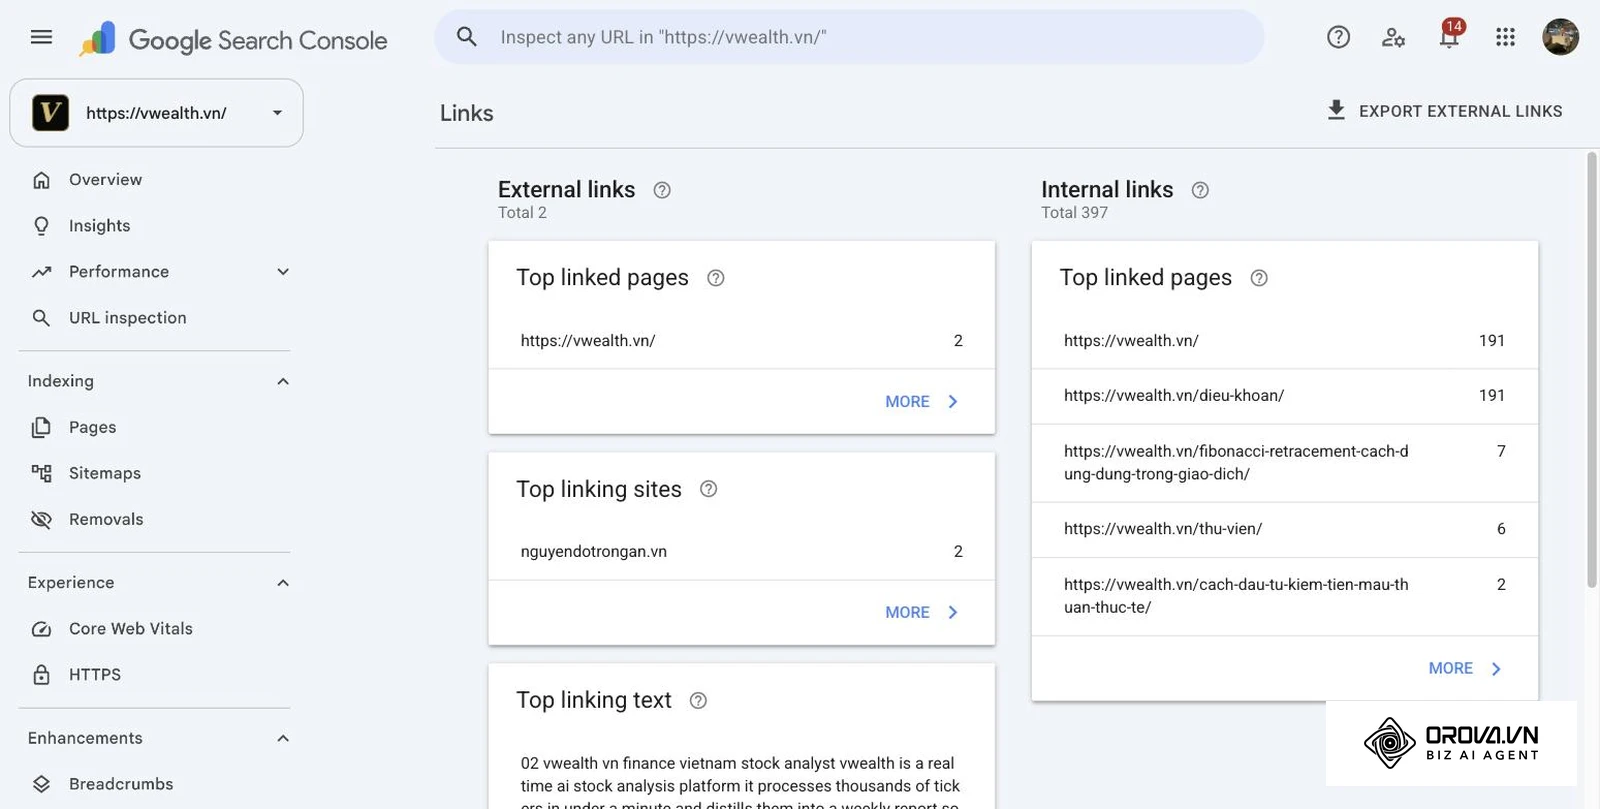
El término proviene directamente del concepto informático de nodos desconectados en estructuras de datos de grafos. En un sitio web, cada página funciona como un vértice y cada hipervínculo representa una arista orientada; cuando un nodo no posee aristas que apunten hacia él, queda desconectado de la raíz.
Para comprender con exactitud qué son las páginas huérfanas SEO y evitar confusiones terminológicas frecuentes entre profesionales que se inician en la optimización técnica, conviene contrastar este problema frente a otros fallos estructurales comunes:
| Concepto | En qué se diferencia | Ejemplo real |
|---|---|---|
| Páginas huérfanas | Responden con código HTTP 200 pero ningún hipervínculo interno del propio dominio apunta hacia su URL. | Una landing page de Navidad creada hace dos años que no aparece en ningún menú, artículo o categoría. |
| Páginas sin salida (Dead-end) | Reciben enlaces internos con normalidad, pero carecen de hipervínculos salientes hacia otras partes de la web. | Una página de confirmación de formulario que no incluye pie de página navegable ni menú superior. |
| Páginas 404 / Enlaces rotos | La URL ya no existe en el servidor web o devuelve un código de error de cliente, aunque todavía reciba enlaces. | Un producto descatalogado eliminado de la base de datos cuyo enlace sigue presente en un post del blog. |
| Páginas no indexadas por metaetiqueta | Tienen enlaces internos y funcionan, pero indican expresamente a los robots que no deben mostrarlas en los resultados. | Un panel de administración o una página de política de privacidad marcada con la directiva noindex. |
Un ejemplo cotidiano ayuda a ilustrar esta situación. Imagina una urbanización residencial donde se construye una vivienda moderna, con suministro eléctrico y número de puerta asignado, pero los operarios olvidan construir la calle de acceso que la comunica con la red municipal de carreteras. La casa existe físicamente, pero ningún vehículo de reparto puede llegar a ella siguiendo las señales de tráfico estándar.
Es crucial refutar una práctica desaconsejada que aún recomiendan algunos tutoriales superficiales: intentar localizar estas URLs mediante el comando de búsqueda de Google site:tudominio.com/url. Este operador únicamente consulta el índice actual de la base de datos de Google, pero no refleja la topología de hipervínculos internos del servidor. Si una URL huérfana fue indexada en el pasado o figura en un sitemap XML, el comando la mostrará como indexada, ocultando por completo su condición de aislamiento técnico. Descubrir estas anomalías exige confrontar datos de rastreo con registros de servidor o consolas de analítica.
Importancia de las páginas huérfanas en la arquitectura web y el rastreo
La detección sistemática de páginas huérfanas resuelve el problema de la invisibilidad de contenidos valiosos y optimiza la asignación de recursos computacionales de los motores de búsqueda. En la jerarquía técnica de un proyecto digital, este análisis se sitúa inmediatamente después del diseño del enlazado interno y actúa como el filtro de control previo a cualquier esfuerzo avanzado de optimización de arquitectura web SEO.
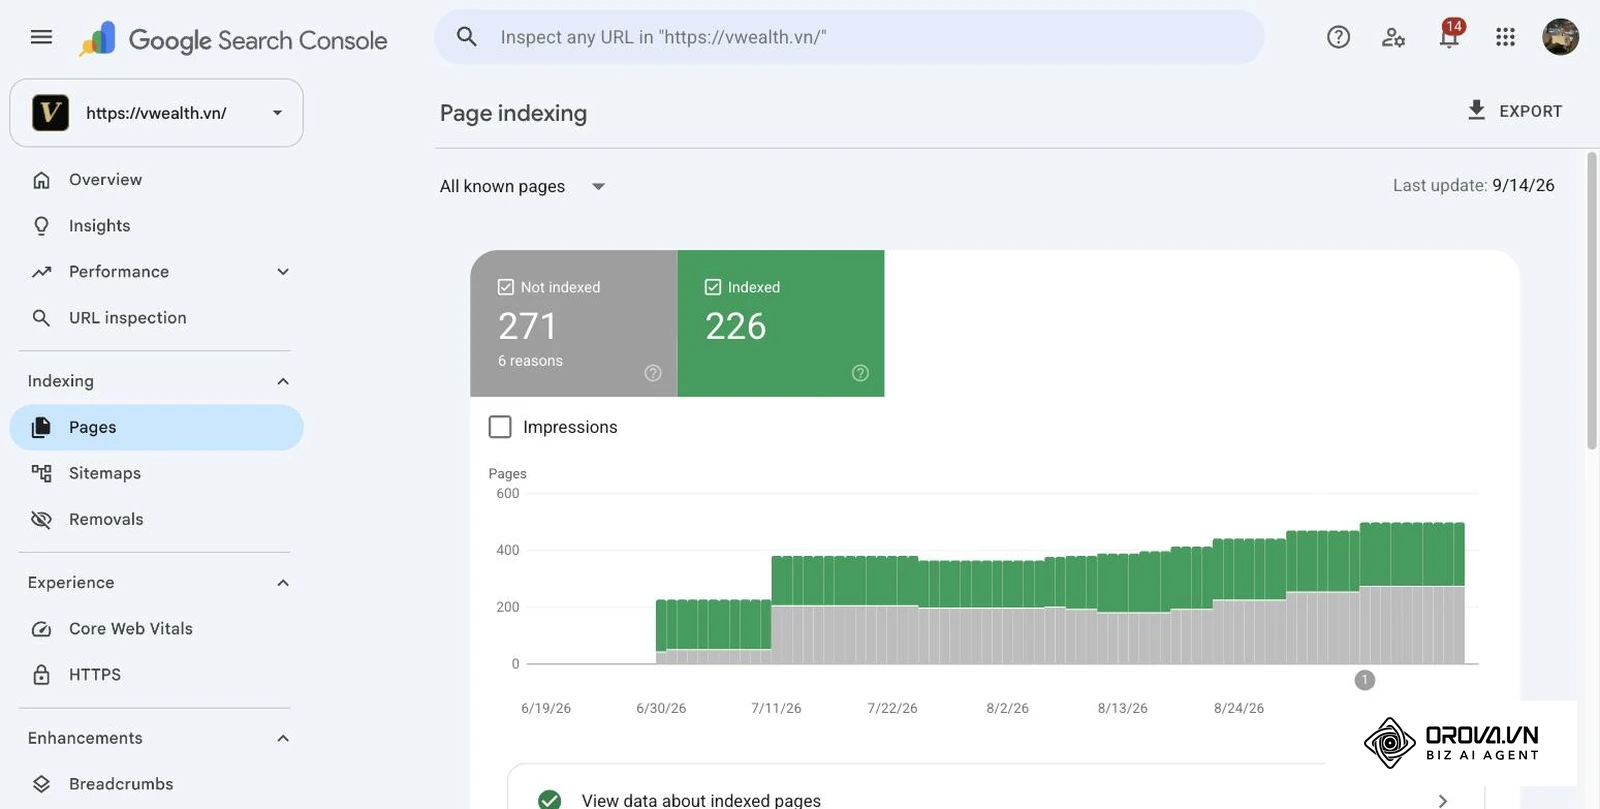
El siguiente esquema resume este flujo y muestra cómo el aislamiento técnico degrada progresivamente la presencia de una URL en los índices de búsqueda.
Cuando los motores de búsqueda descubren una URL únicamente mediante un sitemap XML o una mención externa pero no encuentran rutas internas hacia ella, se genera una señal contradictoria. Google Search Console refleja este síntoma de forma indirecta en su informe de Indexación de Páginas a través de los estados "Descubierta: actualmente sin indexar" y "Rastreada: actualmente sin indexar". Al no percibir enlaces entrantes internos, los sistemas de asignación de rastreo deducen que el propio editor del sitio considera ese documento irrelevante, espaciando o suspendiendo su procesamiento.
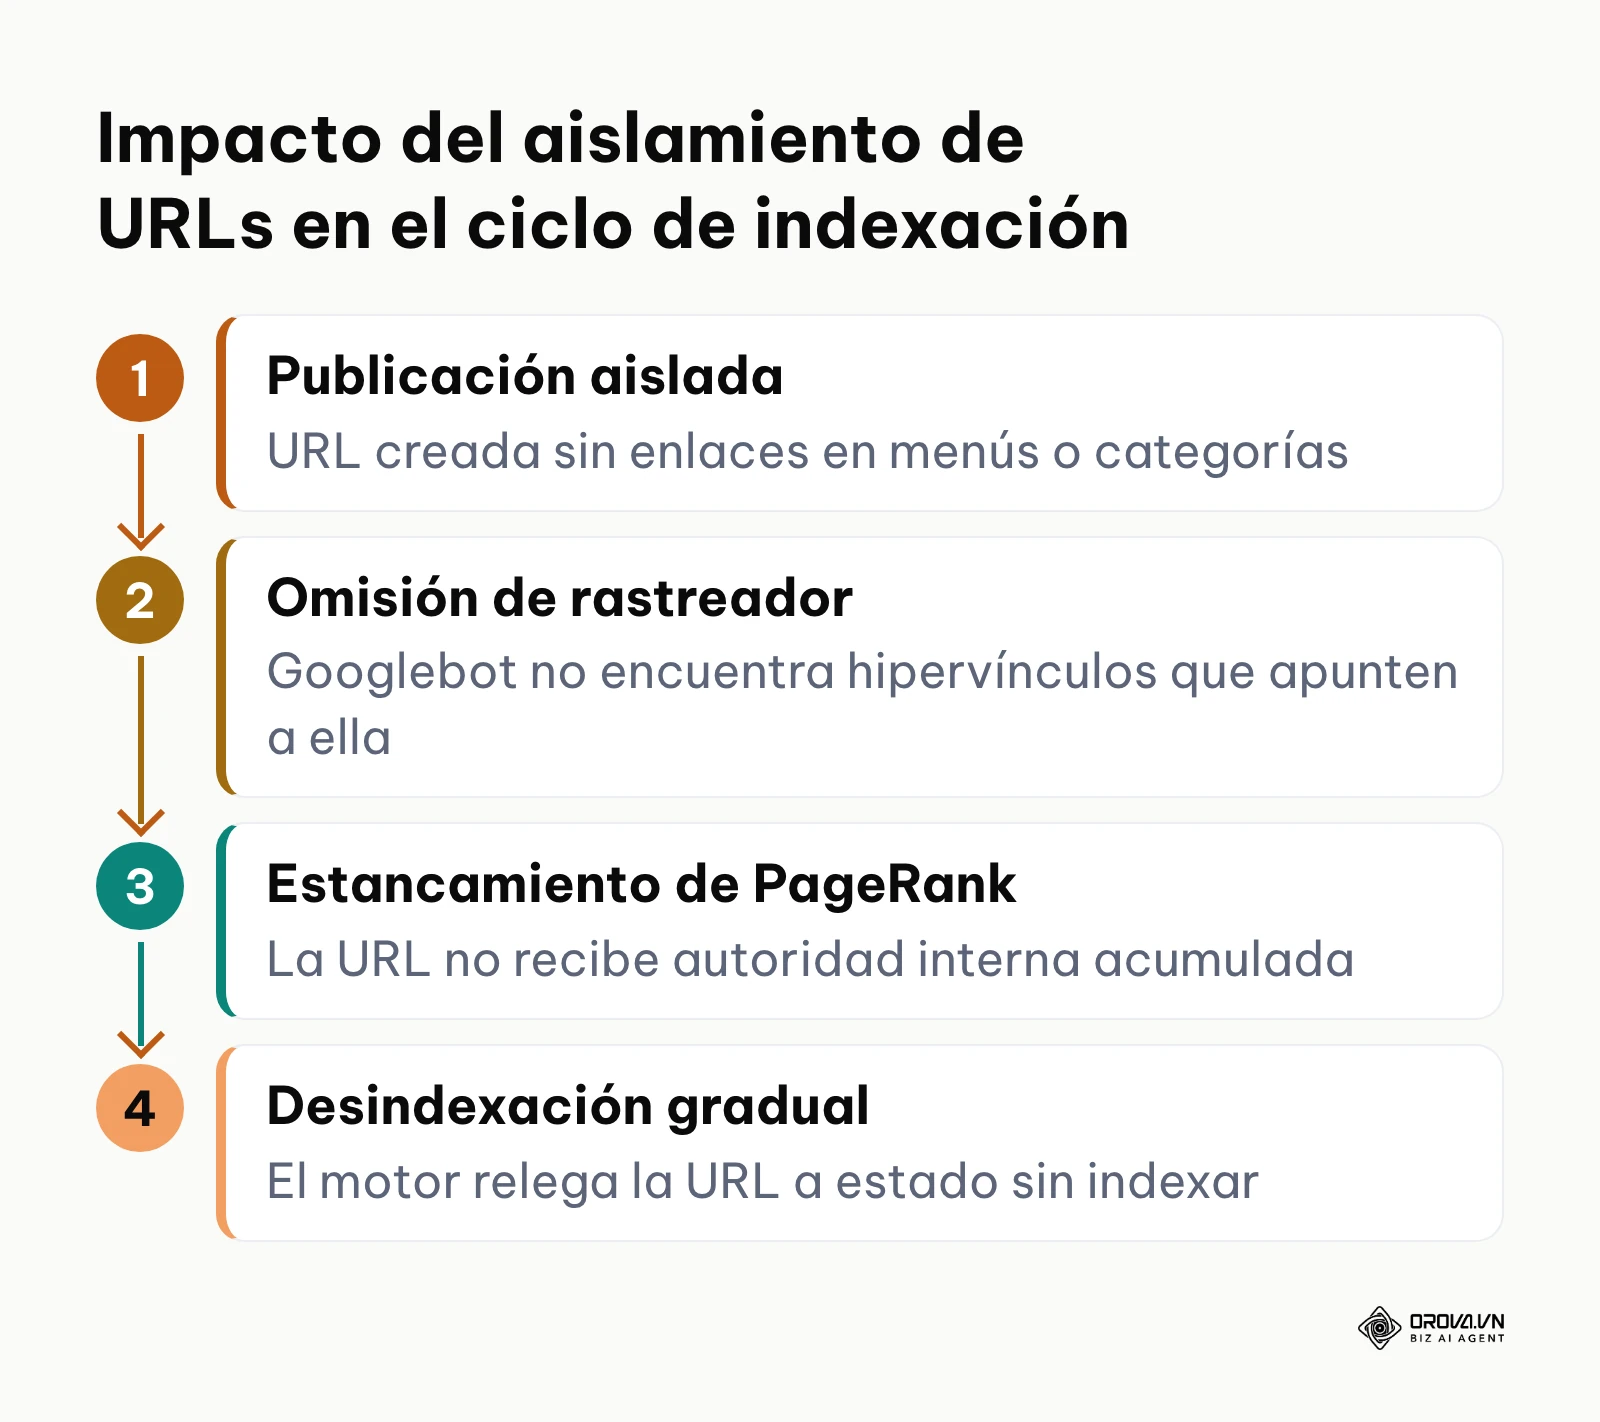
Asimismo, surge con frecuencia la duda de si una URL huérfana que recibe enlaces externos entrantes de alta calidad (backlinks) logra transferir su autoridad hacia el resto de la web. La respuesta técnica es negativa: se convierte en un auténtico callejón sin salida de PageRank. La fuerza acumulada llega a la página huérfana, pero al no existir enlaces internos contextuales que conecten ese nodo con categorías o productos estratégicos, el flujo de valor queda atrapado sin beneficiar al dominio global.
Si un equipo ignora estas anomalías, las consecuencias acumuladas deterioran el rendimiento del negocio:
- Dilución del presupuesto de rastreo (crawl budget), obligando a Googlebot a procesar documentos obsoletos en lugar de páginas de conversión.
- Retraso severo en la indexación de nuevos lanzamientos editoriales o productos comerciales.
- Canibalización semántica involuntaria provocada por URLs antiguas desvinculadas que compiten contra versiones actualizadas.
Cuándo aún no es prioritario sanear páginas huérfanas
No todos los proyectos necesitan auditar páginas huérfanas de inmediato. En sitios web nuevos con menos de treinta URLs, la estructura es visible de un vistazo y el presupuesto de rastreo no supone un cuello de botella. Tampoco es prioritario intervenir en páginas de aterrizaje diseñadas exclusivamente para campañas publicitarias de pago que ya cuentan con la etiqueta meta noindex deliberada, ni en entornos de desarrollo bloqueados por contraseña. En esas situaciones, conviene priorizar la creación de contenido temático y la definición básica de categorías.
Beneficios tangibles de solucionar las páginas huérfanas para el negocio y el equipo técnico
Resolver las desconexiones estructurales genera un doble impacto positivo: protege la rentabilidad y el retorno de inversión para la dirección de la empresa, y agiliza las operaciones técnicas cotidianas del especialista en posicionamiento web.
A nivel de negocio, una arquitectura limpia reduce el consumo innecesario de transferencia en servidores dedicados, maximiza la visibilidad de páginas que generan transacciones y previene caídas imprevistas de facturación orgánica causadas por contenidos obsoletos que confunden a los compradores. Para los profesionales técnicos, erradicar nodos aislados aporta claridad sobre el inventario real del CMS y previene incidentes graves durante migraciones de plataforma.
Optimización del presupuesto de rastreo y aceleración de indexación
El presupuesto de rastreo representa el límite de solicitudes que Googlebot está dispuesto a realizar en un servidor en un periodo determinado sin sobrecargarlo. Cuando la estructura carece de fugas, los rastreadores dedican sus ciclos exclusivamente a documentos activos.
Antes de intervenir una web, los robots consumen tiempo explorando URLs generadas por promociones caducadas o parámetros de filtrado desvinculados del menú. Tras sanear las rutas, la frecuencia de rastreo se concentra en las páginas de destino prioritarias.
Estas son las señales que conviene revisar para saber si el rastreo se está desperdiciando en URLs huérfanas:
| Señal | Dónde revisarla | Qué indica |
|---|---|---|
| Muchas URLs en "Descubierta: actualmente sin indexar" | Search Console > Indexación de páginas | Google conoce la URL pero no le da prioridad para rastrearla |
| Googlebot pide URLs que no aparecen en tu rastreo interno | Registros del servidor (logs) frente a la exportación del rastreador | El bot gasta peticiones en páginas sin enlaces internos |
| URLs del sitemap sin enlaces entrantes | Filtro Orphan URLs de la pestaña Sitemaps en Screaming Frog | El sitemap anuncia páginas que la navegación no conecta |
| Páginas con visitas en GA4 que el rastreador no encuentra | Filtro Orphan URLs de la pestaña Analytics | Hay tráfico llegando a páginas aisladas que podrían recibir enlaces |
Ejemplo ilustrativo:
- Contexto: Una plataforma de comercio electrónico de suministros industriales con un catálogo de doce mil referencias gestionada por un equipo técnico interno.
- Pasos ejecutados: Se ejecutó una auditoría cruzada extrayendo URLs del sitemap frente al árbol de rastreo, se aislaron mil cuatrocientas URLs huérfanas correspondientes a promociones descatalogadas de años previos y se eliminaron de los sitemaps aplicando directivas de depuración.
- Obstáculo técnico y resolución: Gran parte de esas URLs aún recibían visitas esporádicas desde marcadores antiguos de clientes; se implementó una redirección selectiva hacia las categorías activas inmediatas en lugar de un borrado masivo sin criterio.
- Resultado observable: La frecuencia con la que Googlebot visitó las categorías principales aumentó de dos veces por semana a revisiones diarias continuas, reflejándose en una indexación más ágil en los registros de rastreo.
Recuperación del flujo de autoridad interna y valor de negocio
La autoridad interna (PageRank distribuido) se diluye cuando existen nodos desconectados. Al reconectar una página estratégica a la navegación general, recibe el impulso acumulado por las páginas principales del dominio.
Antes de la intervención, páginas informativas con excelente redacción permanecen ocultas en los rankings debido a una profundidad de clics inalcanzable. Tras insertar enlaces contextuales desde artículos afines o menús secundarios, los buscadores comprenden la jerarquía y elevan la posición media de esas consultas en las páginas de resultados. Para asegurar que los motores procesen este cambio con rapidez, conviene revisar cómo indexar una página en Google aplicando las directivas recomendadas.
Prevención de canibalizaciones y contenidos desactualizados
En portales con años de trayectoria, es habitual que coexistan guías creadas en diferentes ejercicios fiscales sobre un mismo tema. Cuando una versión antigua queda sin enlaces pero sigue existiendo en el servidor, Google puede continuar mostrándola a los usuarios en detrimento de la versión moderna.
Antes del saneamiento, los clientes acceden a precios antiguos o condiciones comerciales derogadas. Al auditar las URLs huérfanas, el equipo decide si fusionar los textos o retirar definitivamente los documentos caducados, garantizando coherencia de marca.
A continuación se muestra un caso numérico simulado basado en métricas estándar de un sitio de comercio electrónico con diez mil URLs registradas, ilustrando cómo se distribuye el esfuerzo del rastreador antes y después de eliminar mil doscientas páginas huérfanas improductivas:
| Métrica de rastreo | Antes del saneamiento | Después del saneamiento | Variación porcentual |
|---|---|---|---|
| URLs totales en el servidor | 10.000 | 8.800 | -12,0% |
| URLs huérfanas detectadas | 1.200 | 0 | -100,0% |
| Peticiones diarias de Googlebot | 1.500 | 1.480 | -1,3% |
| Peticiones a URLs huérfanas / día | 270 (18,0%) | 5 (0,3%) | -98,1% |
| Peticiones a categorías y fichas clave | 1.230 (82,0%) | 1.475 (99,7%) | +19,9% |
| Tiempo medio de indexación de nuevos ítems | 14 días | 48 horas | -85,7% |
El cuadro evidencia que el beneficio no radica en aumentar el volumen bruto de peticiones de Google, sino en dirigir la capacidad de procesamiento del buscador hacia documentos que generan conversiones directas.
| Beneficio obtenido | Métrica de impacto (KPI) | Tiempo estimado de visibilidad |
|---|---|---|
| Concentración de rastreo | Porcentaje de solicitudes a URLs 200 estratégicas en logs | 2 a 4 semanas tras la limpieza |
| Aceleración de indexación | Días transcurridos entre publicación y primera impresión en GSC | 1 a 3 semanas |
| Recuperación de autoridad | Posición media de URLs huérfanas reincorporadas | 4 a 8 semanas |
| Limpieza de índice | Reducción de URLs en estado "Excluidas" en Search Console | 3 a 6 semanas |
Descubre Orova.vn – una plataforma Biz AI Agent con la solución OROVA SEO completa, destinada a todos los sitios web. El sistema acompaña la optimización para motores de búsqueda de A a Z con las siguientes funciones: investigación de palabras clave, redacción de nuevos artículos optimizados para SEO, optimización de los contenidos existentes, seguimiento de posiciones, además del análisis de la competencia y el análisis técnico en profundidad. Regístrate hoy mismo para descubrir OROVA SEO de forma totalmente gratuita (oferta válida hasta el 7 de julio de 2027).
Cómo detectar y solucionar las páginas huérfanas: metodología técnica paso a paso
Identificar estas anomalías requiere una metodología rigurosa porque ningún rastreador estándar puede encontrar un nodo huérfano navegando únicamente desde la página de inicio. Es indispensable triangular tres fuentes independientes de datos: el rastreo estructural del código HTML, los registros históricos de visibilidad en Google Search Console y la actividad de usuarios en Google Analytics 4.
Configuración de Screaming Frog con APIs de Google Search Console y GA4
La herramienta Screaming Frog SEO Spider permite realizar auditorías avanzadas si se configuran sus conectores externos.
Para ejecutar una auditoría completa sobre screaming frog páginas huérfanas, sigue minuciosamente los siguientes pasos:
- Habilitar acceso a Google Search Console: Dirígete a Configuration > API Access > Google Search Console. Conecta la cuenta correspondiente, selecciona la propiedad exacta del dominio y define un intervalo de fechas representativo de los últimos tres a seis meses. En la pestaña General, marca la casilla obligatoria "Crawl New URLs Discovered In Google Search Console" para que el software añada a la cola aquellas direcciones que no encuentre en los enlaces hipertexto.
- Conectar Google Analytics 4: En Configuration > API Access > Google Analytics, vincula la propiedad activa de GA4 y, si lo deseas, limita los datos al tráfico de búsqueda orgánica. Esta configuración permite descubrir páginas que carecen de enlaces internos pero siguen recibiendo visitas residuales de usuarios.
- Integrar Sitemaps XML: Accede a Configuration > Spider > Crawl y activa "Crawl Linked Sitemaps" o introduce la URL directa del índice de sitemaps en Configuration > Spider > Sitemaps.
- Ejecutar el rastreo maestro: Inicia el análisis del dominio y espera a que el rastreo principal alcance el cien por cien.
- Procesar el análisis posterior (Crawl Analysis): Este paso es el que omiten la mayoría de principiantes. Una vez finalizado el rastreo, dirígete al menú superior Crawl Analysis > Configure. Asegúrate de que las casillas "Sitemaps" y "Search Console" estén marcadas dentro del módulo de páginas huérfanas. Posteriormente, pulsa Crawl Analysis > Start.
- Inspeccionar la pestaña de resultados: Abre las pestañas Sitemaps, Search Console y Analytics y aplica en cada una el filtro Orphan URLs; así verás las URLs huérfanas según su origen de descubrimiento (sitemap, GSC o GA4). También puedes exportarlas juntas desde Reports > Orphan Pages.
- Entradas: Credenciales de acceso a las APIs de Google y la URL base del dominio.
- Salidas: Listado consolidado de URLs con valor de enlaces entrantes (Inlinks) igual a cero.
- Punto crítico de fallo: Omitir el paso 5. Si no se ejecuta el post-procesamiento de Crawl Analysis, la pestaña de URLs huérfanas permanecerá vacía a pesar de haber conectado las APIs con éxito.
Resumen de dónde se activa cada fuente dentro de Screaming Frog:
| Fuente de datos | Ruta en el menú | Qué URLs huérfanas aporta |
|---|---|---|
| Google Search Console | Configuration > API Access > Google Search Console | URLs con impresiones o clics que no reciben enlaces internos |
| Google Analytics 4 | Configuration > API Access > Google Analytics | URLs con visitas de usuarios que el rastreo no alcanza |
| Sitemaps XML | Configuration > Spider > Crawl (Crawl Linked Sitemaps) | URLs declaradas en el sitemap sin enlaces entrantes |
| Crawl Analysis | Crawl Analysis > Configure y Crawl Analysis > Start | Cruce final que rellena los filtros Orphan URLs |
Ejemplo ilustrativo:
- Contexto: Una empresa de servicios de software corporativo con un sitio de tres mil quinientas URLs que experimentaba una pérdida gradual de posiciones tras migrar de gestor de contenidos.
- Pasos ejecutados: El especialista conectó las APIs de Search Console y GA4 en Screaming Frog con un rango de ciento ochenta días, activó el rastreo de URLs descubiertas y completó el Crawl Analysis final.
- Obstáculo técnico y resolución: La API de Google Search Console devolvió errores de límite de peticiones por minuto durante el volcado; se solventó ajustando el límite de consultas por segundo en la configuración de conexión del programa y segmentando el análisis en dos bloques de plantillas.
- Resultado observable: La auditoría arrojó trescientas cincuenta URLs huérfanas con tráfico histórico que habían quedado fuera de los nuevos menús de cabecera y pie de página, permitiendo restaurar sus enlaces inmediatamente.
Auditoría cruzada mediante hojas de cálculo para inventarios sin software de pago
Si no dispones de licencias de herramientas de rastreo con soporte de API, es perfectamente viable cruzar los datos mediante fórmulas en Google Sheets o Excel.
Para aplicar este método de conciliación de inventario:
- Exporta el listado completo de URLs internas descubiertas por un rastreador básico gratuito y pégalo en una pestaña denominada Rastreo_Interno (Columna A).
- Exporta el informe de páginas de Google Search Console (Rendimiento > Páginas) de los últimos tres meses y pégalo en una pestaña llamada URLs_Consola (Columna A).
- En la pestaña URLs_Consola, inserta en la celda B2 la siguiente fórmula de comprobación condicional:
=IF(ISNA(VLOOKUP(A2; Rastreo_Interno!A:A; 1; FALSE)); "Huérfana"; "Conectada")
Si prefieres una fórmula más corta, cuenta las coincidencias directamente (en Excel en español: =SI(CONTAR.SI(Rastreo_Interno!A:A; A2)=0; "Huérfana"; "Conectada")):
=IF(COUNTIF(Rastreo_Interno!A:A; A2)=0; "Huérfana"; "Conectada")
Así queda la pestaña URLs_Consola una vez aplicada la fórmula (URLs de ejemplo):
| Columna A: URL en Search Console | Columna B: resultado | Qué hacer |
|---|---|---|
| https://tudominio.com/blog/guia-tallas/ | Conectada | Nada; recibe enlaces internos |
| https://tudominio.com/promo-navidad-2024/ | Huérfana | Revisar tráfico y backlinks en la matriz de decisión |
| https://tudominio.com/producto/zapatilla-azul-38/ | Huérfana | Reenlazar desde su categoría o redirigir con 301 |
| https://tudominio.com/categoria/zapatillas/ | Conectada | Nada; usarla como origen de enlaces |
- Entradas: Lista de URLs de rastreo HTML y lista de URLs con impresiones en Search Console.
- Salidas: Etiquetado binario ("Huérfana" o "Conectada") para cada documento conocido por Google.
- Punto crítico de fallo: No normalizar previamente las barras diagonales finales (trailing slashes), el protocolo (HTTP frente a HTTPS) o las mayúsculas entre ambas listas, lo que genera falsos positivos en las fórmulas de búsqueda.
Matriz de decisión técnica para clasificar y resolver cada URL huérfana
Una vez identificadas las URLs huérfanas, surge el dilema operativo: ¿qué hacer con cada una de ellas? Aplicar una solución uniforme constituye un grave error estratégico.
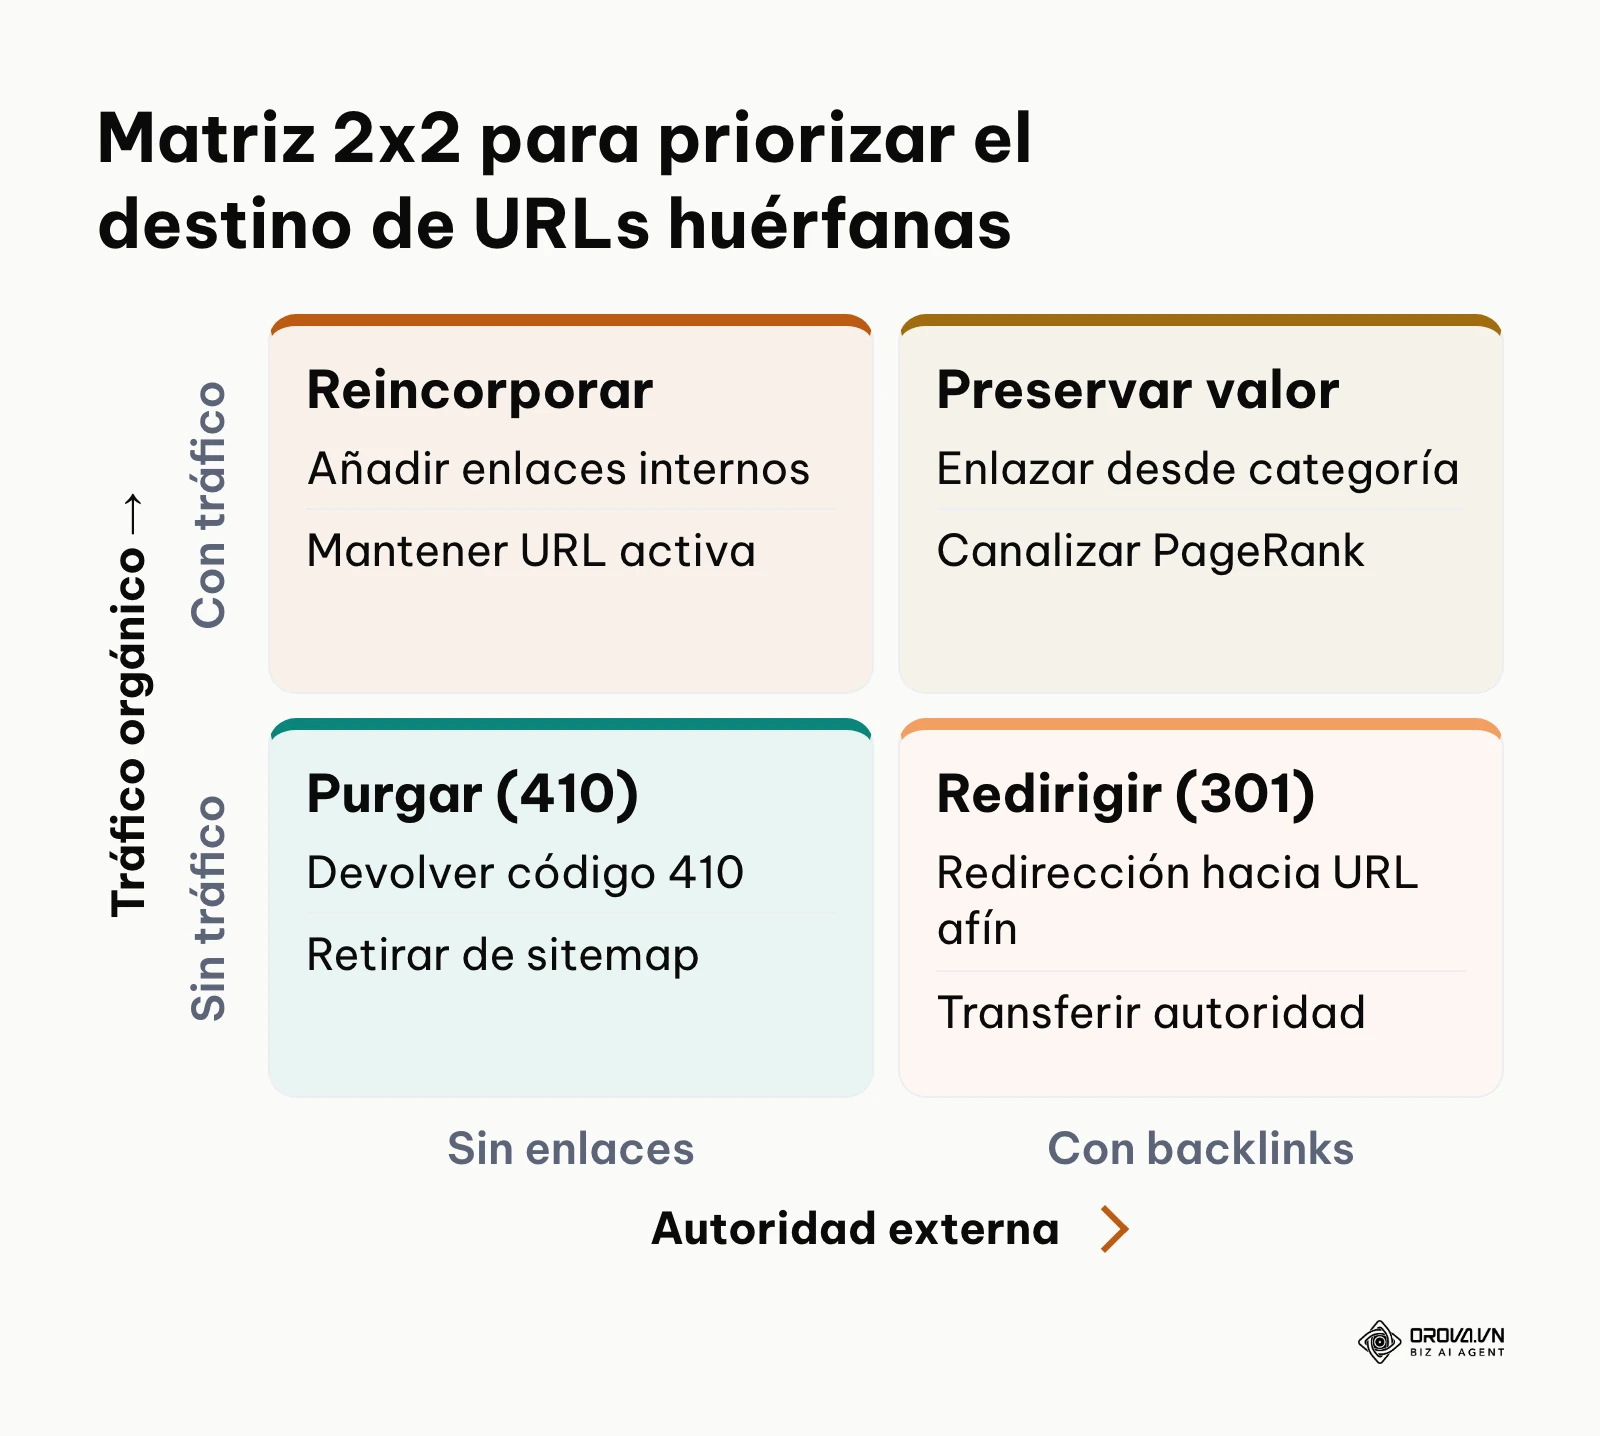
El siguiente esquema resume este flujo de decisión mediante una matriz bidimensional orientada a preservar la autoridad y el tráfico real.
La siguiente tabla establece una matriz cuantitativa de cuatro vías basada en umbrales de métricas objetivas para determinar la acción técnica exacta:
| Tipo de página huérfana | Umbrales métricos (Tráfico / Backlinks / Valor) | Decisión técnica | Código de respuesta HTTP | Acción en XML Sitemap |
|---|---|---|---|---|
| Contenido estratégico activo | Más de 50 clics orgánicos en 6 meses o valor de conversión directo | Reincorporar / Enlazar | Código 200 OK | Mantener en el sitemap principal |
| URL obsoleta con autoridad externa | 0 conversiones, pero posee 3 o más dominios de referencia (backlinks) | Redirigir 301 hacia categoría afín | Código 301 Redirect | Eliminar URL antigua; incluir URL destino |
| Página basura o temporal caducada | 0 visitas en 6 meses, 0 backlinks externos y sin utilidad | Purgar definitivamente | Código 410 Gone | Eliminar de forma inmediata del sitemap |
| Página privada o de uso interno | Accesible por enlaces directos de clientes (ej. agradecimiento) | Excluir del índice | Código 200 con meta noindex | Retirar del sitemap XML |
En este punto es necesario resolver una pregunta recurrente: ¿por qué es técnicamente preferible utilizar el código 410 (Gone) en lugar del habitual 404 (Not Found) para eliminar URLs huérfanas sin valor?
La documentación de Google Search Central sobre códigos de estado HTTP indica que Google trata los errores 4xx (salvo el 429) de forma similar: ambos acaban retirando la URL del índice. La diferencia es de matiz: un 404 solo dice que el recurso no se ha encontrado, mientras que el 410 comunica de manera explícita que se ha eliminado de forma permanente. Por eso muchos equipos prefieren el 410 para purgas definitivas, sabiendo que Googlebot puede volver a comprobar la URL de vez en cuando en ambos casos.
Tratamiento especializado para comercio electrónico y arquitecturas multilingües
Los sitios de comercio electrónico y los portales internacionales generan miles de URLs huérfanas de forma automatizada debido a fallos de diseño en sus plataformas.
En tiendas online, cuando un producto se queda sin existencias o es desactivado en el gestor de contenidos (como Shopify, WooCommerce o PrestaShop), la plataforma suele desvincularlo automáticamente del listado de su categoría. Sin embargo, si la URL sigue respondiendo con código 200 y permanece dentro de los sitemaps o enlazada desde reseñas externas, se convierte de inmediato en una página huérfana. La solución recomendada consiste en mantener el producto accesible dentro de su categoría señalando su estado de "Agotado" con enlaces hacia artículos alternativos, o aplicar una redirección 301 hacia la categoría padre si no volverá a comercializarse.
En proyectos internacionales con etiquetas de idioma (hreflang), las páginas huérfanas proliferan cuando se traduce un artículo pero se omite su enlace en el conmutador de idiomas (language switcher) de la cabecera, o cuando las etiquetas hreflang carecen de correspondencia bidireccional estricta. El valor de una página en la web depende en gran medida de que otras páginas enlacen hacia ella. Si la versión en inglés apunta a una versión en español, pero la versión en español no enlaza de vuelta ni aparece en los índices locales de navegación, los motores aíslan la traducción.
Para evaluar en profundidad la salud global de tus contenidos antes de reestructurar catálogos extensos, resulta conveniente apoyarse en una auditoría de contenidos periódica.
Ejemplo ilustrativo:
- Contexto: Una cadena minorista internacional de moda que operaba en cinco idiomas sobre una arquitectura técnica unificada.
- Pasos ejecutados: Se descargaron los datos de la pestaña de idiomas en Screaming Frog y se cruzaron las etiquetas hreflang con el módulo de páginas huérfanas.
- Obstáculo técnico y resolución: Se detectó que seiscientas páginas traducidas al español no recibían enlaces internos porque el filtro automático de la categoría ocultaba los artículos de fin de temporada en esa región.
- Resultado observable: Se corrigió la plantilla de la taxonomía regional, logrando que las seiscientas URLs volvieran a integrarse en la arquitectura de navegación y recuperaran impresiones orgánicas en tres semanas.
Lista de verificación de seis pasos para migraciones y rediseños web
Durante una migración de CMS o un rediseño de marca, el riesgo de generar inadvertidamente cientos de páginas huérfanas es sumamente elevado.
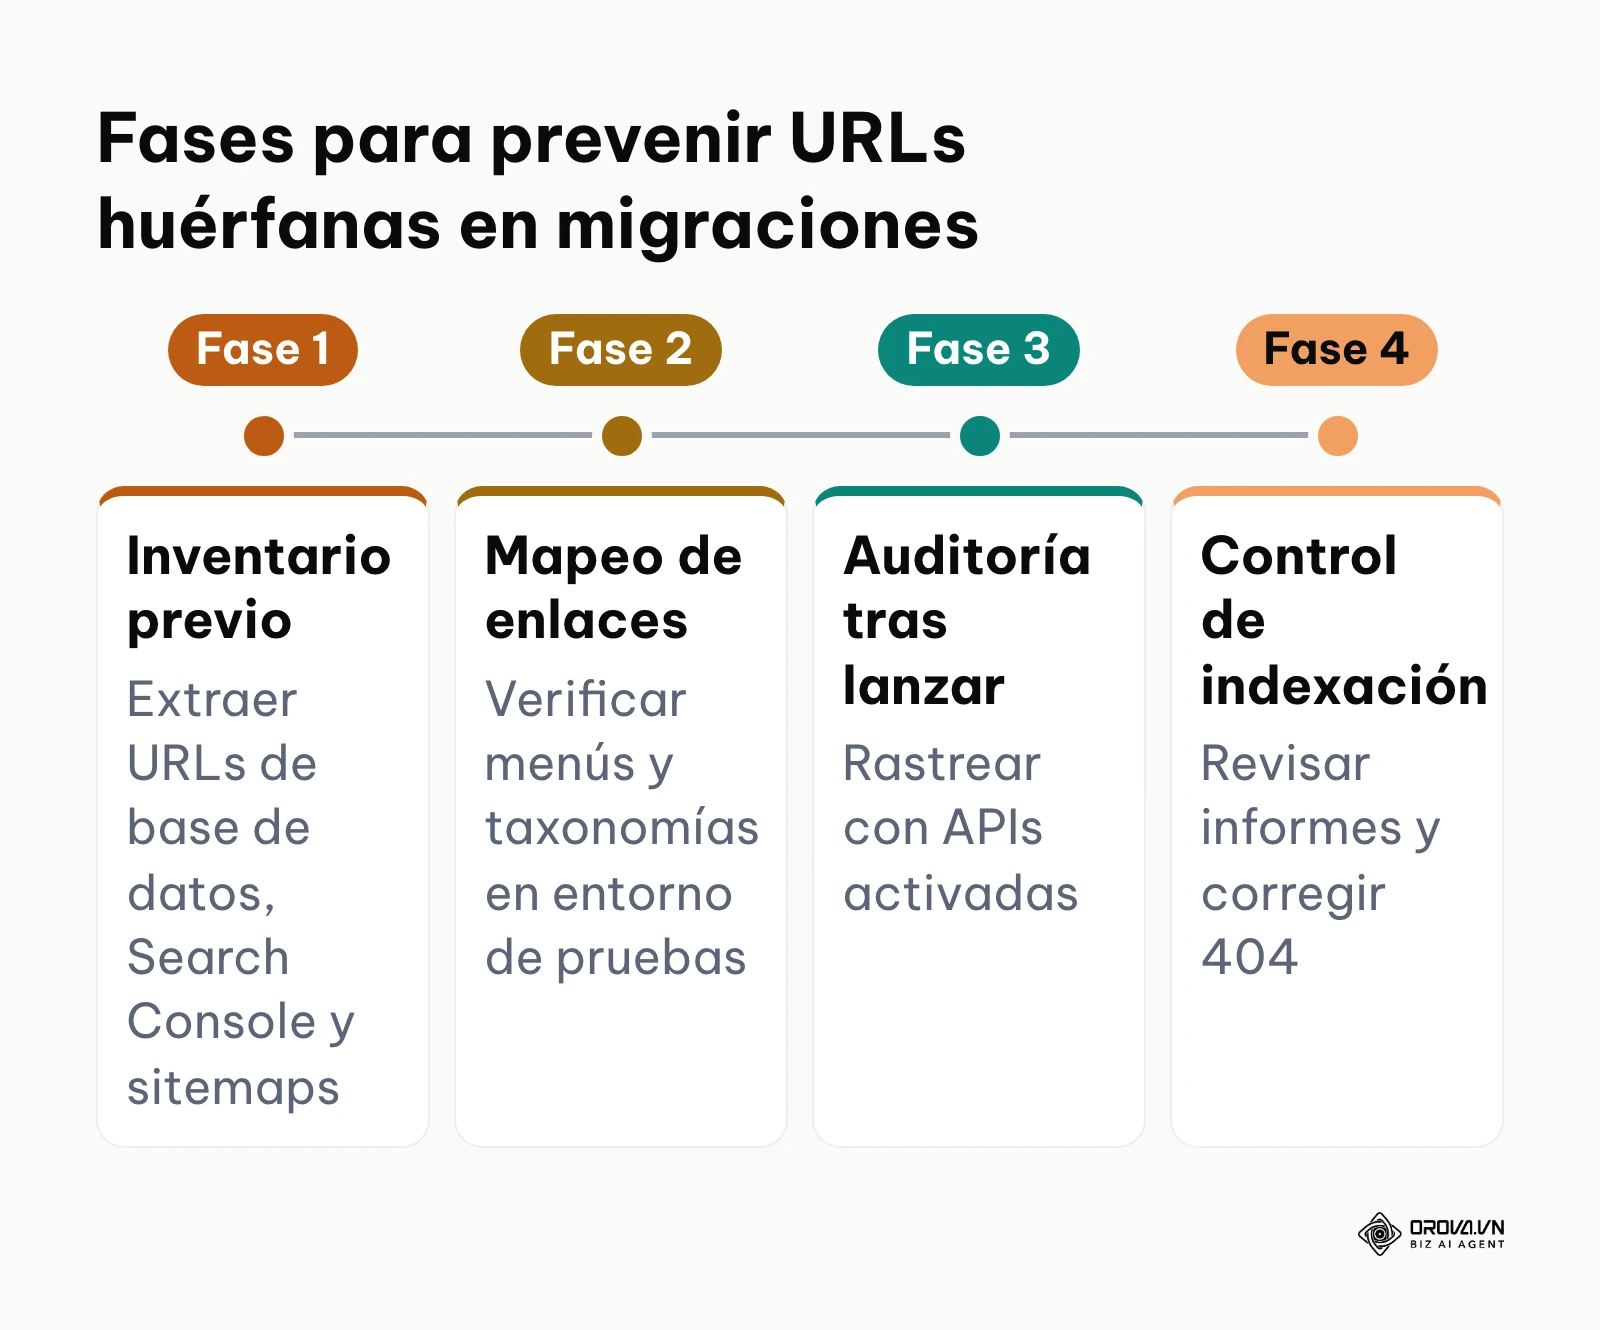
El siguiente esquema resume este flujo en cuatro fases temporales para mantener bajo control la integridad de los enlaces durante cualquier cambio de infraestructura.
Para asegurar una transición limpia, apóyate en esta lista de control técnico:
- Compilación del inventario maestro: Extrae todas las URLs activas del entorno antiguo combinando el rastreo HTML, el informe de cobertura de Search Console, los últimos noventa días de GA4 y los registros del servidor web (logs).
- Mapeo de redirecciones uno a uno: Diseña una tabla de equivalencias asegurando que ninguna URL con tráfico histórico quede huérfana o abandonada sin una redirección 301 hacia su equivalente en la nueva estructura.
- Validación de taxonomías en entorno de pruebas (Staging): Ejecuta un rastreo completo sobre el servidor de desarrollo antes de abrir la web al público, comprobando que todas las entradas de blog y fichas de producto dependan de al menos una categoría visible en el menú.
- Verificación de sitemaps XML: Regenera los sitemaps asegurándote de que contengan única y exclusivamente URLs que respondan con código 200 y que estén presentes en el enlazado interno.
- Auditoría con APIs en las primeras 48 horas: Tras el lanzamiento, repite el rastreo con Screaming Frog conectando Search Console para verificar que el filtro Orphan URLs se mantenga en cero.
- Supervisión de errores en consola: Monitorea semanalmente los informes de rastreo para detectar picos anómalos de errores 404 o páginas descubiertas no indexadas. Si necesitas un marco de comprobación exhaustivo para cada fase técnica, consulta nuestra checklist SEO.
Para sistematizar estas causas y sus soluciones, consulta el siguiente cuadro técnico:
| Tipología de página huérfana | Causa técnica habitual | Impacto en el rastreo | Acción recomendada |
|---|---|---|---|
| Landing pages de campañas PPC | Diseñadas para conversión publicitaria sin enlaces en cabecera | Consumo innecesario de rastreo si no están bloqueadas | Añadir directiva meta noindex y excluir del sitemap |
| Productos fuera de temporada | Desmarcados de categorías por el gestor de catálogo | Pérdida de tráfico histórico y acumulación de URLs inertes | Reenlazar en módulos de "Productos similares" o aplicar 301 |
| Entradas de blog sin categoría | Artículos asignados a categorías eliminadas o sin archivar | Caída drástica de impresiones orgánicas por falta de PageRank | Reasignar categoría activa e insertar enlaces contextuales |
| Páginas de test o desarrollo | Archivos subidos por equipos técnicos olvidados en el servidor | Riesgo de indexación de contenido duplicado o confidencial | Eliminar con código 410 o restringir acceso mediante robots.txt |
Con OROVA.VN y el módulo OROVA SEO, pones fin definitivamente a las jornadas agotadoras de trabajo manual. En lugar de batallar durante horas para redactar artículos y elaborar informes, todo el proceso queda ahora optimizado y completado en tan solo 5 minutos.
Plan de acción para gestionar páginas huérfanas según el perfil de tu organización
Abordar este problema requiere adaptar las tareas a los recursos, conocimientos y responsabilidades de cada estructura organizativa.
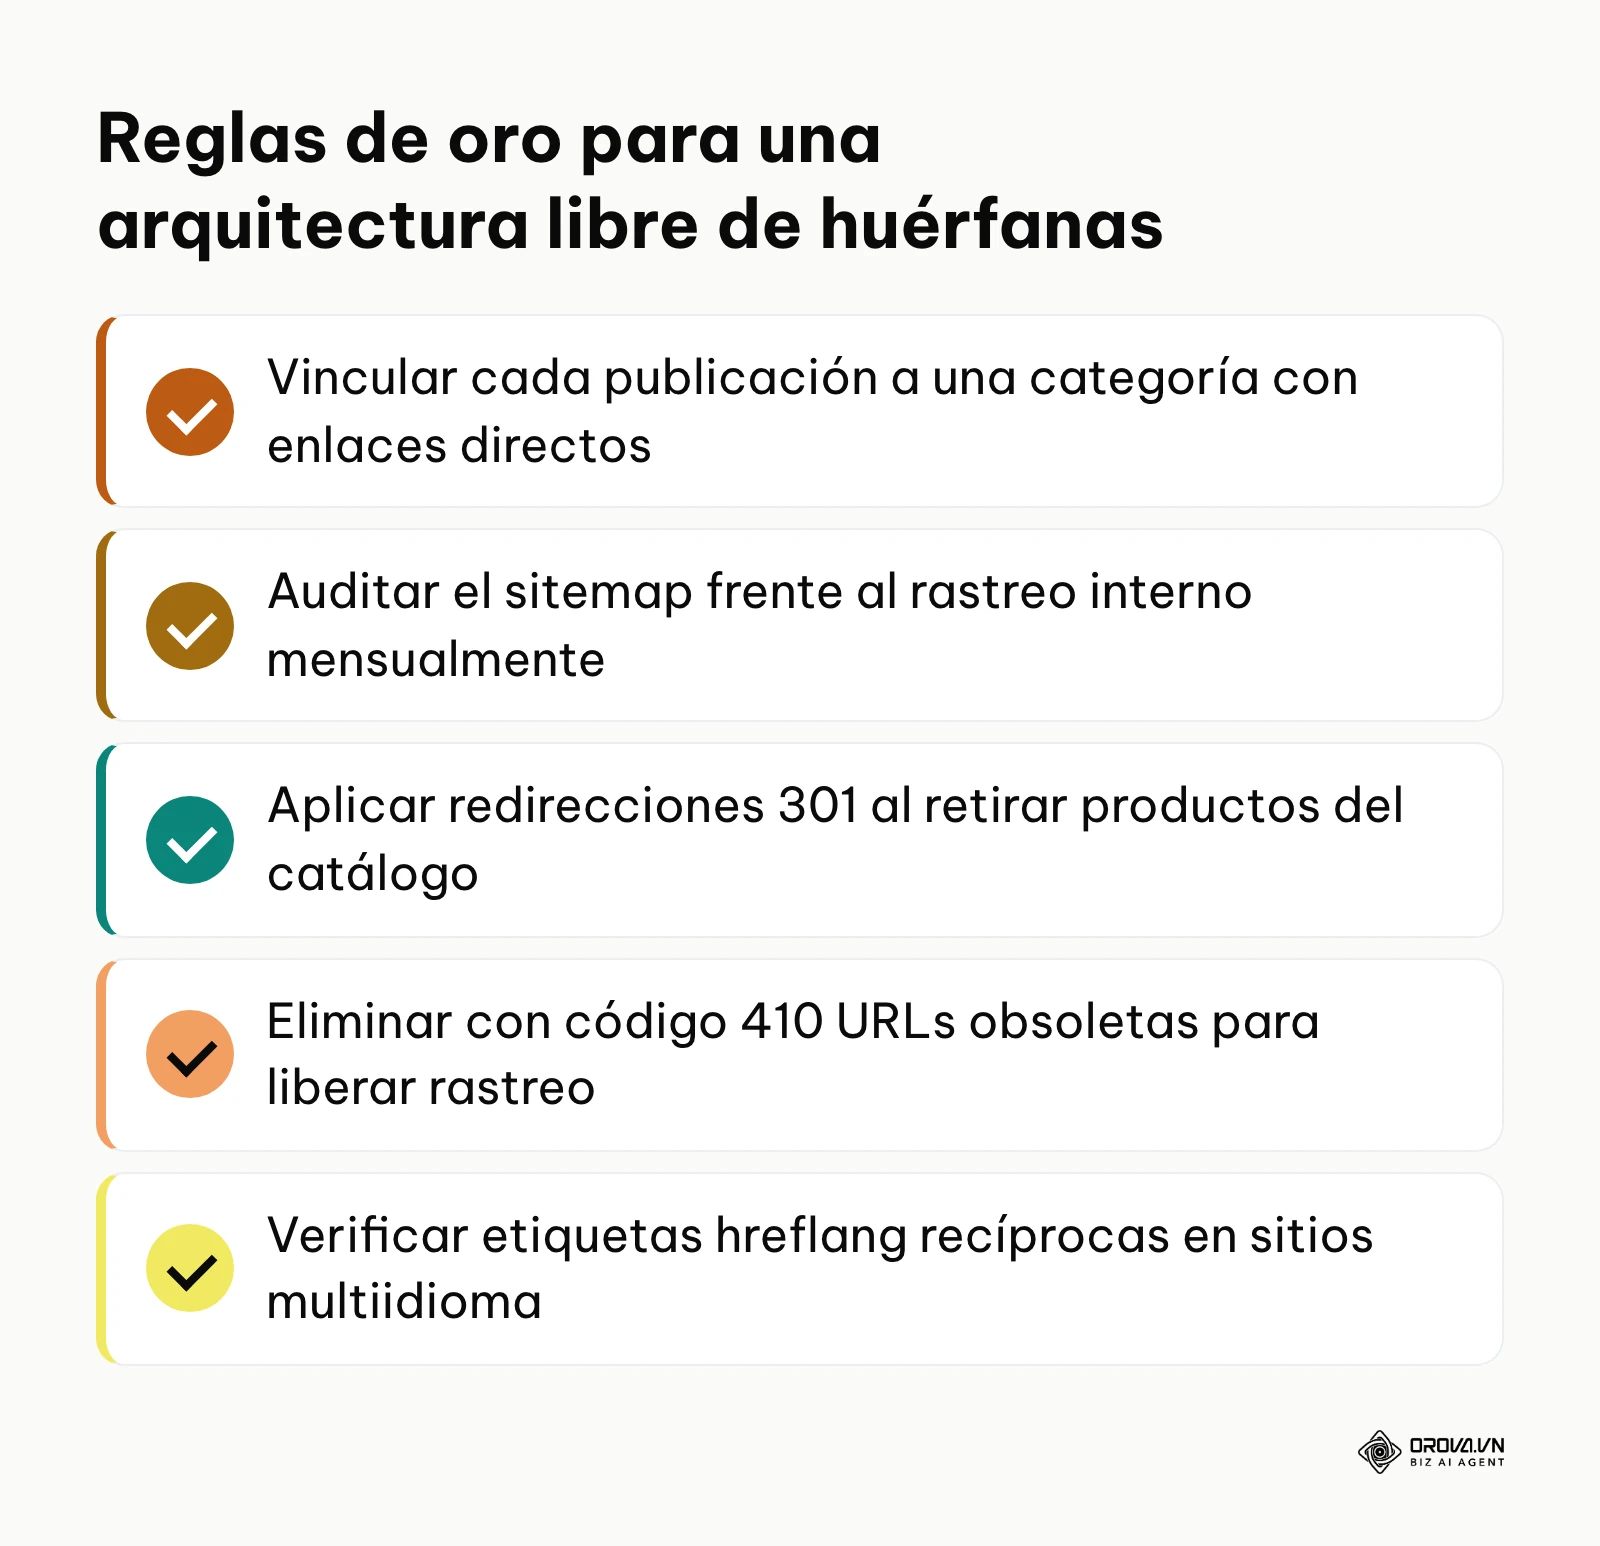
El siguiente esquema resume este flujo y recoge las reglas esenciales para conservar una arquitectura web saludable en cualquier escala de trabajo.
Dueños de pequeñas empresas y tiendas online
Si gestionas tu propio negocio digital y no cuentas con un departamento técnico dedicado, enfoca tus esfuerzos en tareas de alto impacto:
- Revisión del catálogo semanal: Al ocultar o eliminar un producto de tu catálogo, comprueba inmediatamente que no queden enlaces rotos ni páginas huérfanas olvidadas; si no volverás a venderlo, aplica una redirección hacia la categoría superior.
- Control básico en Search Console: Accede una vez al mes a la sección "Indexación de páginas" y filtra las URLs que aparecen en "Descubierta: actualmente sin indexar".
- Enlazado contextual manual: Cuando publiques un nuevo artículo o servicio, incluye siempre dos o tres enlaces desde publicaciones antiguas relevantes hacia esa nueva página para integrarla en la red interna.
Responsables de marketing y SEO in-house
Los profesionales internos que coordinan equipos editoriales y de desarrollo deben protocolizar los flujos de publicación:
- Auditoría mensual automatizada: Configura rastreos periódicos programados que crucen datos de Search Console y analítica para emitir alertas automáticas si se detectan URLs sin enlaces entrantes.
- Guía de estilo editorial: Establece como requisito obligatorio para redactores y creadores de contenido que ningún artículo sea publicado sin haber asignado una categoría madre y al menos dos enlaces internos recíprocos.
- Depuración trimestral de sitemaps: Realiza una limpieza periódica de los sitemaps XML para asegurar que reflejen con exactitud las páginas estratégicas del negocio y no almacenen residuos de campañas finalizadas.
Consultores técnicos y agencias de posicionamiento web
Los auditores externos que asesoran a clientes deben entregar soluciones sistemáticas y escalables:
- Auditoría inicial de arquitectura: Incluye la detección de páginas huérfanas como un hito ineludible en el diagnóstico técnico inicial, cruzando rastreo HTML con registros brutos del servidor (log files).
- Entrega de matrices de redirección: Proporciona a los desarrolladores del cliente un documento con la asignación precisa de códigos de estado (301, 410 o inclusión de enlaces), evitando recomendaciones ambiguas.
- Monitorización post-implementación: Comprueba en las semanas posteriores que las URLs corregidas sean efectivamente procesadas por los motores mediante la supervisión de las estadísticas de rastreo en Search Console.
A continuación se resumen las equivocaciones más comunes y cómo eludirlas:
| Error frecuente | Consecuencia técnica | Cómo evitarlo |
|---|---|---|
| Confiar exclusivamente en el sitemap XML | Asumir que por estar en el sitemap la página recibirá rastreo y autoridad | Auditar la presencia de hipervínculos internos en el HTML real |
| Aplicar redirecciones masivas a la portada | Dilución de relevancia semántica y generación de errores Soft 404 | Redirigir siempre a la categoría o producto más estrechamente relacionado |
| Borrar URLs con código 404 sin revisar enlaces externos | Pérdida definitiva de autoridad acumulada por menciones externas | Comprobar backlinks antes de purgar; si tiene enlaces, aplicar 301 |
| Dejar páginas de test abiertas en el servidor | Indexación indeseada de contenidos basura que dañan la imagen de marca | Proteger directorios de prueba con autenticación HTTP o eliminarlos |
Tendencias sobre las páginas huérfanas en los próximos años: opinión del autor
A fecha de 2026, observo con claridad cómo los motores de búsqueda basados en modelos de lenguaje y agentes de recuperación de información procesan la web de forma distinta a los rastreadores puramente sintácticos de la década pasada.
En primer lugar, considero que en los próximos dos a tres años las páginas huérfanas perderán cualquier mínima posibilidad de visibilidad en los sistemas de búsqueda generativa. Los motores actuales ya no se limitan a listar documentos por concordancia de palabras clave; construyen grafos de conocimiento semántico basados en las relaciones de las entidades dentro del contenido. Si una página web no está conectada mediante enlaces internos contextuales a otros nodos temáticos del mismo dominio, los sistemas de inteligencia artificial no podrán inferir su autoridad contextual ni su relevancia de entidad, descartándola de las respuestas sintetizadas. Para prepararse, los profesionales deben abandonar el enlazado mecánico y estructurar redes temáticas basadas en silos semánticos rigurosos.
En segundo lugar, me inclino a pensar que la proliferación de arquitecturas desacopladas (Headless CMS) y la generación programática de páginas web acelerará la creación masiva involuntaria de contenidos huérfanos. Hoy en día es sencillo desplegar miles de URLs mediante bases de datos dinámicas, pero con frecuencia los desarrolladores olvidan generar los índices de archivo que las vinculan a la navegación principal. Los equipos técnicos deben implementar sistemas de integración continua que bloqueen despliegues si el rastreador interno detecta URLs aisladas en el entorno previo.
Por último, considero que los motores de búsqueda terminarán prescindiendo casi por completo de los sitemaps XML como criterio prioritario de rastreo, basando su asignación de recursos exclusivamente en el flujo real de navegación de los usuarios y las señales de interacción acumuladas. Esto significaría que incluir una URL huérfana en un sitemap será totalmente estéril si no registra navegación real. Esta previsión podría resultar errónea si los consorcios internacionales adoptan un protocolo estandarizado de indexación directa mediante APIs en tiempo real que sustituya por completo al rastreo web convencional, aunque hoy por hoy el coste computacional hace improbable ese escenario a corto plazo.
Preguntas frecuentes sobre las páginas huérfanas
¿Cómo avisa Google Search Console de la existencia de páginas huérfanas?
Google Search Console no cuenta con una pestaña específica denominada "páginas huérfanas", pero refleja su presencia a través de métricas indirectas en el informe de Indexación de Páginas. Las URLs que figuran bajo los estados "Descubierta: actualmente sin indexar" y "Rastreada: actualmente sin indexar" suelen corresponder a documentos que los robots conocieron mediante sitemaps o enlaces externos antiguos, pero que carecen de enlaces internos que justifiquen su relevancia técnica dentro del dominio.
¿Transmite autoridad una página huérfana si recibe backlinks externos de calidad?
No logra transferir esa autoridad al resto del sitio web porque carece de hipervínculos internos salientes estructurados hacia otras páginas del dominio. El valor del enlace externo queda confinado en esa URL aislada, convirtiéndola en un callejón sin salida de PageRank. Para aprovechar esa fuerza, es indispensable insertar enlaces contextuales desde esa página hacia secciones comerciales o categorías estratégicas.
¿Es mejor devolver código 404 o 410 al eliminar páginas huérfanas obsoletas?
Ambos sirven: Google trata los errores 404 y 410 de forma similar y retira la URL del índice en los dos casos. El 410 (Gone) es la opción más explícita para URLs huérfanas de baja calidad que no volverán, porque declara que el recurso se ha eliminado de forma permanente; el 404 es igual de válido si tu CMS no permite configurar el 410.
¿Es útil el comando "site:" para encontrar páginas huérfanas en Google?
No es una técnica válida y utilizarla induce a errores graves de diagnóstico. El comando site:tudominio.com consulta el índice global de Google, pero no revela la arquitectura de enlaces internos de tu servidor. Una página huérfana puede figurar en el índice si fue rastreada mediante un sitemap, y una página perfectamente enlazada puede no aparecer si sufrió una exclusión temporal de calidad.
¿Con qué frecuencia se debe auditar la existencia de páginas huérfanas en una tienda online?
En catálogos de comercio electrónico con rotación constante de stock, se aconseja ejecutar una auditoría cruzada con APIs de analítica al menos una vez al mes. En sitios web corporativos con publicaciones semanales o mensuales, una revisión trimestral o inmediatamente después de cualquier rediseño web resulta suficiente para mantener la arquitectura limpia.
¿Siguen siendo un problema las páginas huérfanas con la llegada de los buscadores con inteligencia artificial?
Siguen siendo un obstáculo crítico e incluso más perjudicial que en el pasado. Los sistemas de búsqueda basados en inteligencia artificial y recuperación aumentada por generación dependen de grafos de conocimiento estructurados para validar la veracidad y contexto de una fuente. Una página aislada carece de conexiones semánticas dentro del dominio, por lo que los modelos de lenguaje tienden a descartarla como fuente fiable para sus resúmenes.
¿Por dónde deberías empezar a limpiar tus páginas huérfanas hoy mismo?
Comenzar a ordenar la arquitectura de tu sitio web no exige resolver miles de URLs en una sola jornada; requiere identificar con precisión en qué estado se encuentra tu proyecto y ejecutar un primer paso técnico inmediato.
Si te encuentras en una situación inicial donde nunca has realizado un inventario ni dispones de auditorías previas, no compres software complejo de inmediato. Accede hoy mismo a tu cuenta de Google Search Console, descarga el informe de páginas en formato CSV, filtra las diez URLs que registren impresiones pero muestren una caída prolongada de clics, y revisa manualmente en tu navegador si existe algún enlace hacia ellas desde la página principal o los menús. Enlazar esas diez páginas desde categorías de autoridad consolidada es una acción que puedes completar en menos de dos horas.
Si ya cuentas con rastreos aislados pero nunca has cruzado los datos con fuentes analíticas externas, tu primer paso consiste en abrir una hoja de cálculo y confrontar las URLs del sitemap XML con el listado exportado de tu rastreador mediante la fórmula condicional explicada en esta guía. Aislar el número exacto de documentos no vinculados te proporcionará una lista clara sobre la cual priorizar decisiones sin avanzar a ciegas.
Si ya has aplicado correcciones técnicas en el pasado pero no mides su impacto real en la indexación, inspecciona los registros de servidor o el panel de estadísticas de rastreo en Search Console para verificar que Googlebot haya dejado de consultar las URLs purgadas y haya aumentado su frecuencia sobre las páginas reincorporadas. Dedicar una sola sesión a conectar tus fuentes de datos y estructurar tu arquitectura interna es el paso más rentable para erradicar definitivamente las páginas huérfanas.
About the author
Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Gestiona tu negocio con AI Agents
Orova es el Biz AI Agent que nunca para: planifica, ejecuta y optimiza el trabajo por ti.
Gana tiempo y multiplica tu productividad.