
SEO programático: guía técnica, arquitectura y prevención de penalizaciones
El SEO programático permite transformar conjuntos de datos estructurados en miles de páginas de aterrizaje optimizadas para capturar la demanda de búsqueda de cola larga (long-tail), pero implementarlo sin una base de ingeniería sólida suele conducir al estancamiento de indexación y a sanciones algorítmicas severas. Muchos equipos intentan escalar su presencia digital redactando artículos manuales uno a uno, lo que genera cuellos de botella inasumibles frente a catálogos con miles de combinaciones posibles. Otros caen en el extremo opuesto: conectan un modelo de lenguaje comercial a una hoja de cálculo básica para publicar miles de textos clónicos en pocas horas, saturando su dominio con contenido superficial que los motores de búsqueda descartan de inmediato.
Esta guía desglosa la arquitectura técnica completa para construir sistemas de páginas automatizadas con valor real, integrando tuberías de enriquecimiento de datos, controles matemáticos de similitud semántica, distribución eficiente del presupuesto de rastreo y marcado interoperable para motores de respuesta de inteligencia artificial.
¿Qué es el SEO programático y cuándo conviene implementarlo en tu negocio?
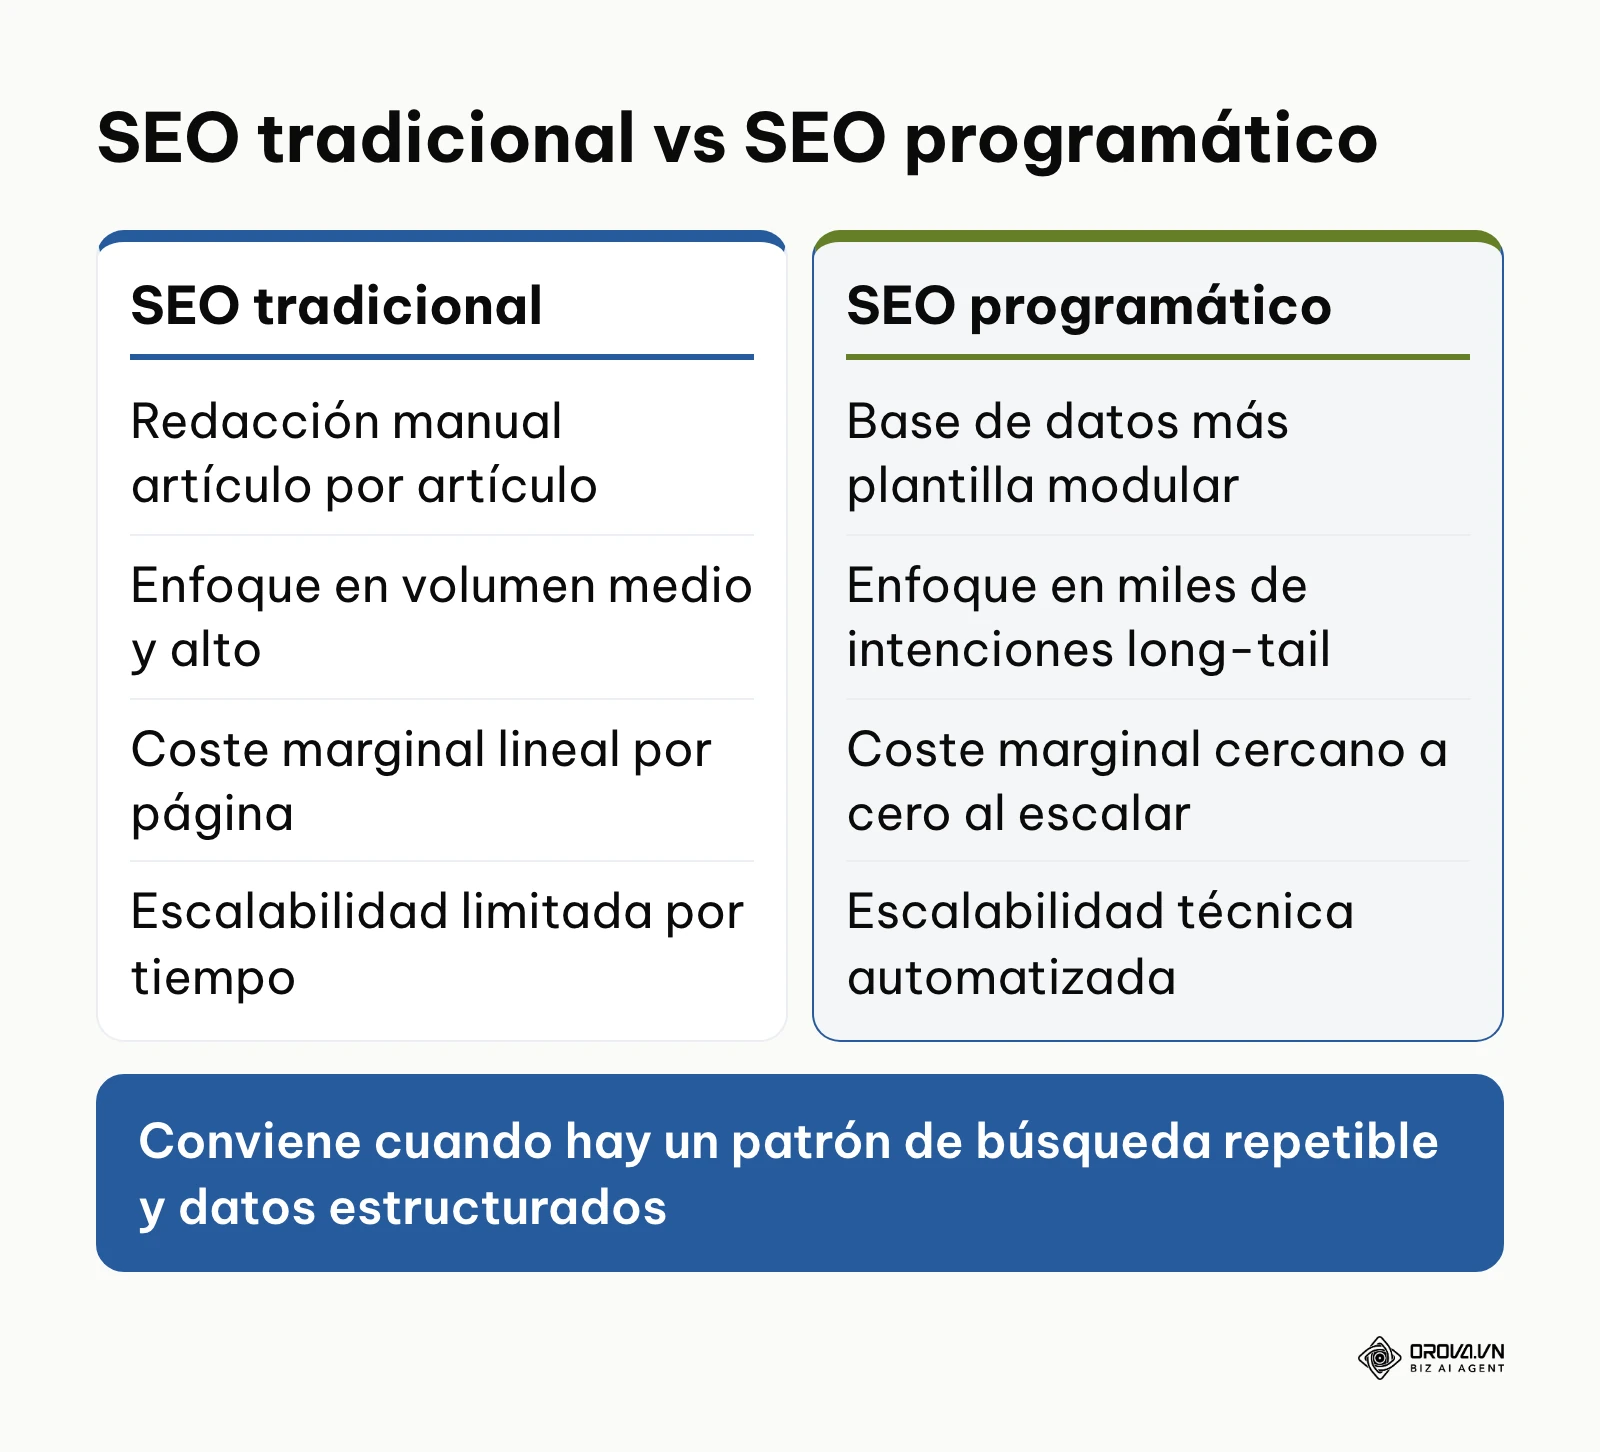
El SEO programático es una metodología técnica que combina una base de datos estructurada con una plantilla de diseño modular para generar de forma automatizada cientos o miles de páginas web indexables, orientadas a patrones de búsqueda repetibles de cola larga. Su objetivo principal consiste en captar tráfico orgánico transaccional o informativo con un coste marginal de producción prácticamente nulo tras configurar la infraestructura inicial. El siguiente diagrama resume las diferencias operativas esenciales frente a la creación manual de contenidos.
Si necesitas repasar antes los fundamentos del posicionamiento SEO, conviene hacerlo: el método programático no sustituye esos principios, solo los aplica a escala.
Este enfoque resulta idóneo para modelos de negocio que ya cuentan con datos propietarios extensos o catálogos parametrizables:
- Plataformas de comercio electrónico con miles de combinaciones de productos, atributos y compatibilidades técnicas.
- Portales inmobiliarios, bolsas de empleo y directorios de servicios clasificados por ubicación geográfica y categoría.
- Empresas de software que ofrecen integraciones entre cientos de aplicaciones, comparativas de precios o convertidores de formatos de archivo.
- Mercados bilaterales que conectan oferta y demanda mediante filtros estructurados y repetitivos.
Por el contrario, no conviene implementar esta estrategia en proyectos editoriales basados en análisis de opinión personal, en marcas de servicios empresariales hiperespecializados donde el volumen de búsqueda mensual es inferior a cien consultas en todo el sector, ni en sitios web que carecen de una base de datos rica en especificaciones técnicas. Si cada página resultante solo va a variar en el nombre de una ciudad o una palabra clave sin aportar datos tangibles, el riesgo de ser clasificado como página puerta (doorway page) desaconseja por completo este método.
Preparación técnica: qué necesitas antes de construir tu primera plantilla
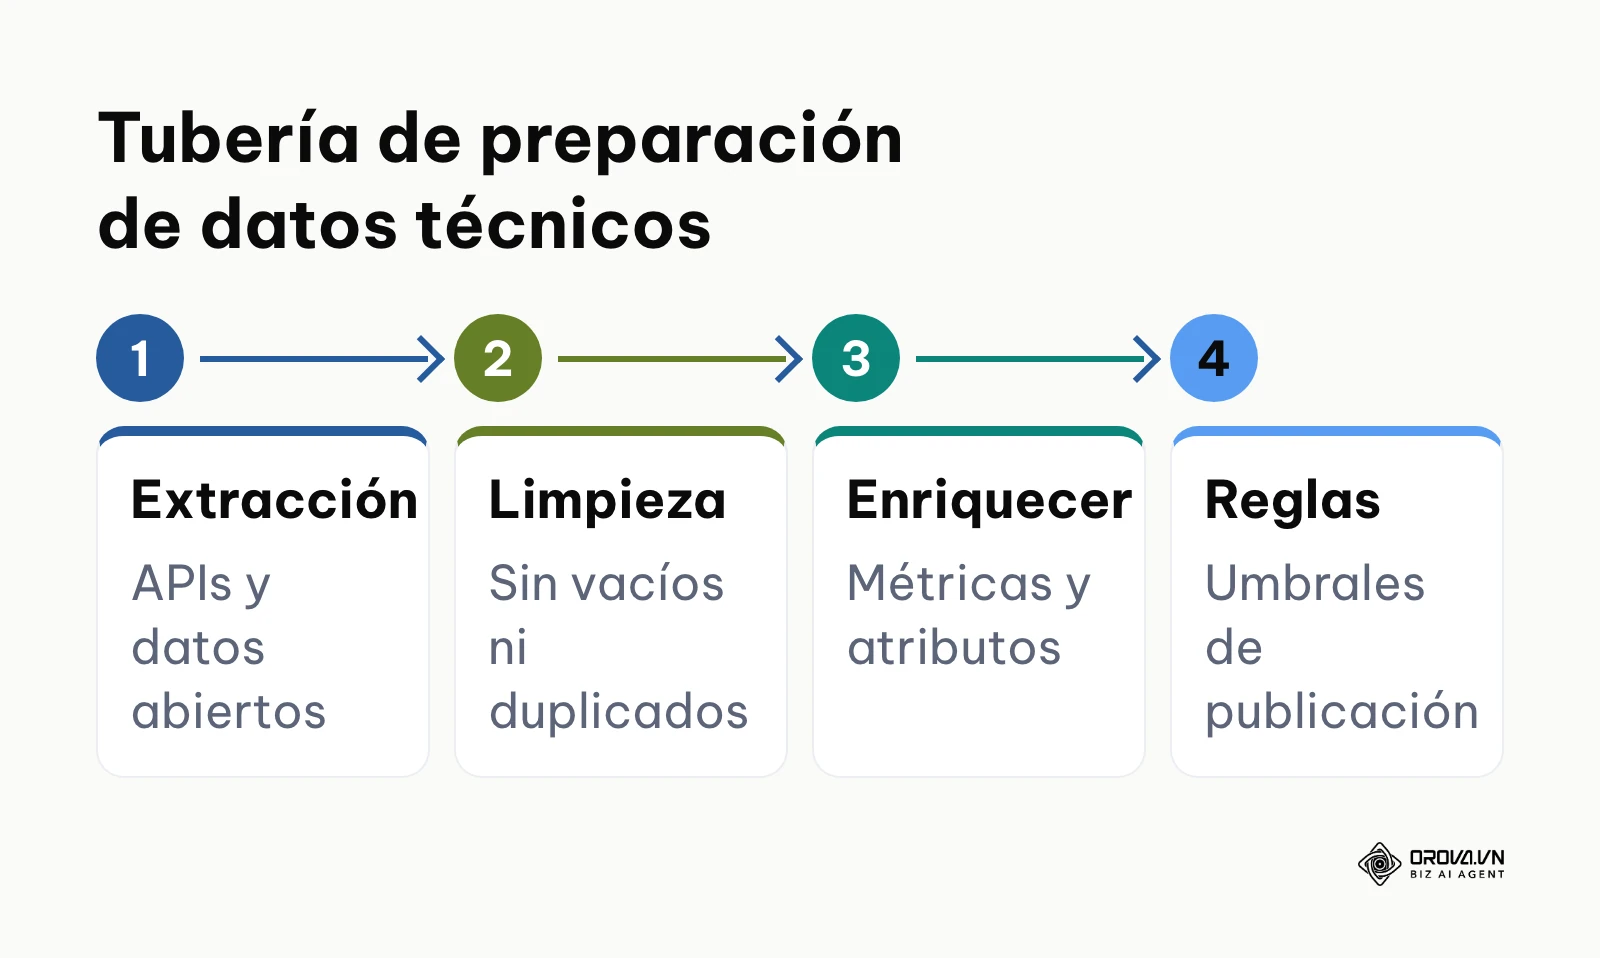
Antes de escribir una sola línea de código o maquetar un componente visual, debes asegurar la infraestructura de datos, la taxonomía de URLs y los filtros de validación técnica que sostendrán el proyecto. La solidez de un despliegue masivo depende de la calidad del conjunto de datos subyacente y no de la velocidad del generador de páginas. El siguiente diagrama resume la tubería de preparación de datos técnicos indispensable antes de iniciar la maquetación.
La siguiente tabla resume los componentes indispensables, sus fuentes de extracción recomendadas y el tiempo medio que demanda su preparación en un entorno profesional:
| Componente requerido | Origen y herramientas de extracción | Tiempo estimado de configuración |
|---|---|---|
| Conjunto de datos base estructurado | APIs públicas, exportaciones internas de base de datos relacional, plataformas de extracción ética de datos | De 3 a 5 semanas |
| Mapeo de entidades y atributos únicos | Normalización en PostgreSQL, Supabase o scripts de depuración en Python | De 1 a 2 semanas |
| Plantilla de componentes modulares | Motores de componentes estáticos, frameworks modernos de maquetación | De 1 a 2 semanas |
| Matriz de reglas condicionales | Fórmulas lógicas de publicación y umbrales de densidad informativa | De 3 a 5 días |
| Infraestructura de sitemaps segmentados | Scripts de generación XML divididos por temática y prioridad | De 2 a 4 días |
Para obtener datos sin disponer de un sistema de planificación de recursos empresariales (ERP), recurre a cuatro vías fiables: repositorios de datos abiertos gubernamentales o sectoriales (como datos.gob.es o portales estadísticos internacionales), plataformas de extracción de datos con renderizado headless, interfaces de programación de aplicaciones (APIs) especializadas en métricas de mercado y procesos de enriquecimiento mediante scripts que calculan medias, ratios y clasificaciones a partir de los datos sin procesar.
A continuación se detalla la plantilla de esquema de datos recomendada para estructurar tu proyecto en una hoja de cálculo avanzada o base de datos relacional:
Estructura de columnas:
[ID_Entidad] | [Nombre_Principal] | [Slug_Canonico] | [Categoria_Padre] | [Atributo_Tecnico_1] | [Atributo_Tecnico_2] | [Metrica_Calculada] | [Conteo_Atributos_Unicos] | [Puntaje_Similitud_Vecina] | [Estado_Publicacion]

Fórmulas clave aplicables:
1. Slug Canónico: =LOWER(SUBSTITUTE(REGEXREPLACE(B2; "[^a-zA-Z0-9 ]"; ""); " "; "-"))
2. Conteo de Atributos: =COUNTA(E2:G2)
3. Regla Condicional de Publicación: =IF(AND(H2>=5; I2<=0.75); "Aprobado"; "Noindex/Borrador")
El cálculo del umbral de similitud léxica previene que páginas con datos insuficientes se envíen a los motores de búsqueda, manteniendo la autoridad global del dominio protegida.
Cómo hacer SEO programático paso a paso: guía técnica de ejecución
A continuación, analizamos cómo hacer SEO programático paso a paso desde el diseño conceptual del patrón de búsqueda hasta el despliegue optimizado en producción. Cada etapa requiere precisión técnica para asegurar que cada nueva URL aporte valor tangible al usuario y a los motores de búsqueda.
Paso 1: Investigación de patrones de búsqueda repetibles y arquitectura de URLs
El primer paso consiste en detectar fórmulas lingüísticas con demanda contrastada donde los usuarios busquen variaciones sistemáticas de un concepto central. Por ejemplo: [herramienta A] vs [herramienta B], precio de [servicio] en [ciudad] o plantilla de [documento] para [profesión].
Para ejecutar este análisis, extrae volúmenes de búsqueda agrupados mediante herramientas de análisis de palabras clave y valida que exista una intención de búsqueda específica detrás de cada variación. Define una taxonomía de directorios estricta que refleje la jerarquía de los datos, evitando parámetros dinámicos complejos:
Estructura recomendada:
https://ejemplo.com/integraciones/[plataforma-origen]-con-[plataforma-destino]/
https://ejemplo.com/tarifas/[servicio]/[ciudad]/
Para evitar la canibalización SEO entre páginas conceptualmente próximas, establece una regla de desduplicación de intenciones: si dos consultas comparten más del 80% de los resultados en los primeros diez puestos de la página de resultados de Google (SERP), deben resolverse en una única página que agrupe ambas entidades mediante parámetros secundarios en lugar de crear dos URLs independientes.
El signo de haber completado este paso con éxito es disponer de un árbol taxonómico cerrado donde cada URL proyectada responde a una combinación única de entidades. El error más común radica en crear páginas para sinónimos casi idénticos, lo que fragmenta la relevancia temática del sitio y confunde a los rastreadores.
Paso 2: Minería, limpieza y enriquecimiento del conjunto de datos
Una base de datos bruta rara vez está lista para publicarse. Este paso implica limpiar valores nulos, estandarizar formatos de texto, normalizar unidades de medida y generar atributos sintéticos que aporten valor contextual.
Para ejecutar esta fase, procesa el conjunto de datos mediante consultas estructuradas o scripts de transformación:
-- Ejemplo de normalización y cálculo de ratio diferencial
SELECT
    id,
    TRIM(nombre_servicio) AS entidad_limpia,
    ciudad,
    coste_medio,
    tiempo_respuesta_horas,
    ROUND((coste_medio / AVG(coste_medio) OVER(PARTITION BY ciudad)) * 100, 2) AS indice_precio_local
FROM servicios_locales
WHERE coste_medio IS NOT NULL AND tiempo_respuesta_horas > 0;
Genera campos enriquecidos como medianas regionales, puntuaciones relativas frente a la media del sector y resúmenes estructurados basados en hechos numéricos.
Ejemplo ilustrativo: Una plataforma de reservas de espacios de trabajo compartido con 1.500 ubicaciones en 45 ciudades europeas, gestionada por un único responsable de marketing digital. El responsable compiló un conjunto de datos base combinando registros municipales abiertos y APIs de transporte público; implementó un script de verificación que exigía al menos seis atributos únicos por espacio (velocidad de conexión inalámbrica verificada, precio del pase diario, estaciones de metro a menos de 500 metros, disponibilidad de salas silenciosas, horario nocturno y tipo de café); aplicó un cálculo de similitud vectorial de texto para fusionar fichas de distritos contiguos con descripciones redundantes. Inicialmente, 400 fichas compartían exactamente el mismo párrafo introductorio redactado por una plantilla rígida, lo que provocó que los rastreadores las agruparan como páginas duplicadas; la solución consistió en transformar las descripciones en tablas comparativas basadas exclusivamente en entidades y limitar el texto generado a variaciones sintácticas condicionadas por datos reales. Como resultado, las fichas comenzaron a posicionarse en las búsquedas locales para consultas específicas de proximidad, apareciendo con fragmentos destacados en terminales móviles sin recibir advertencias de contenido duplicado en los paneles de control.
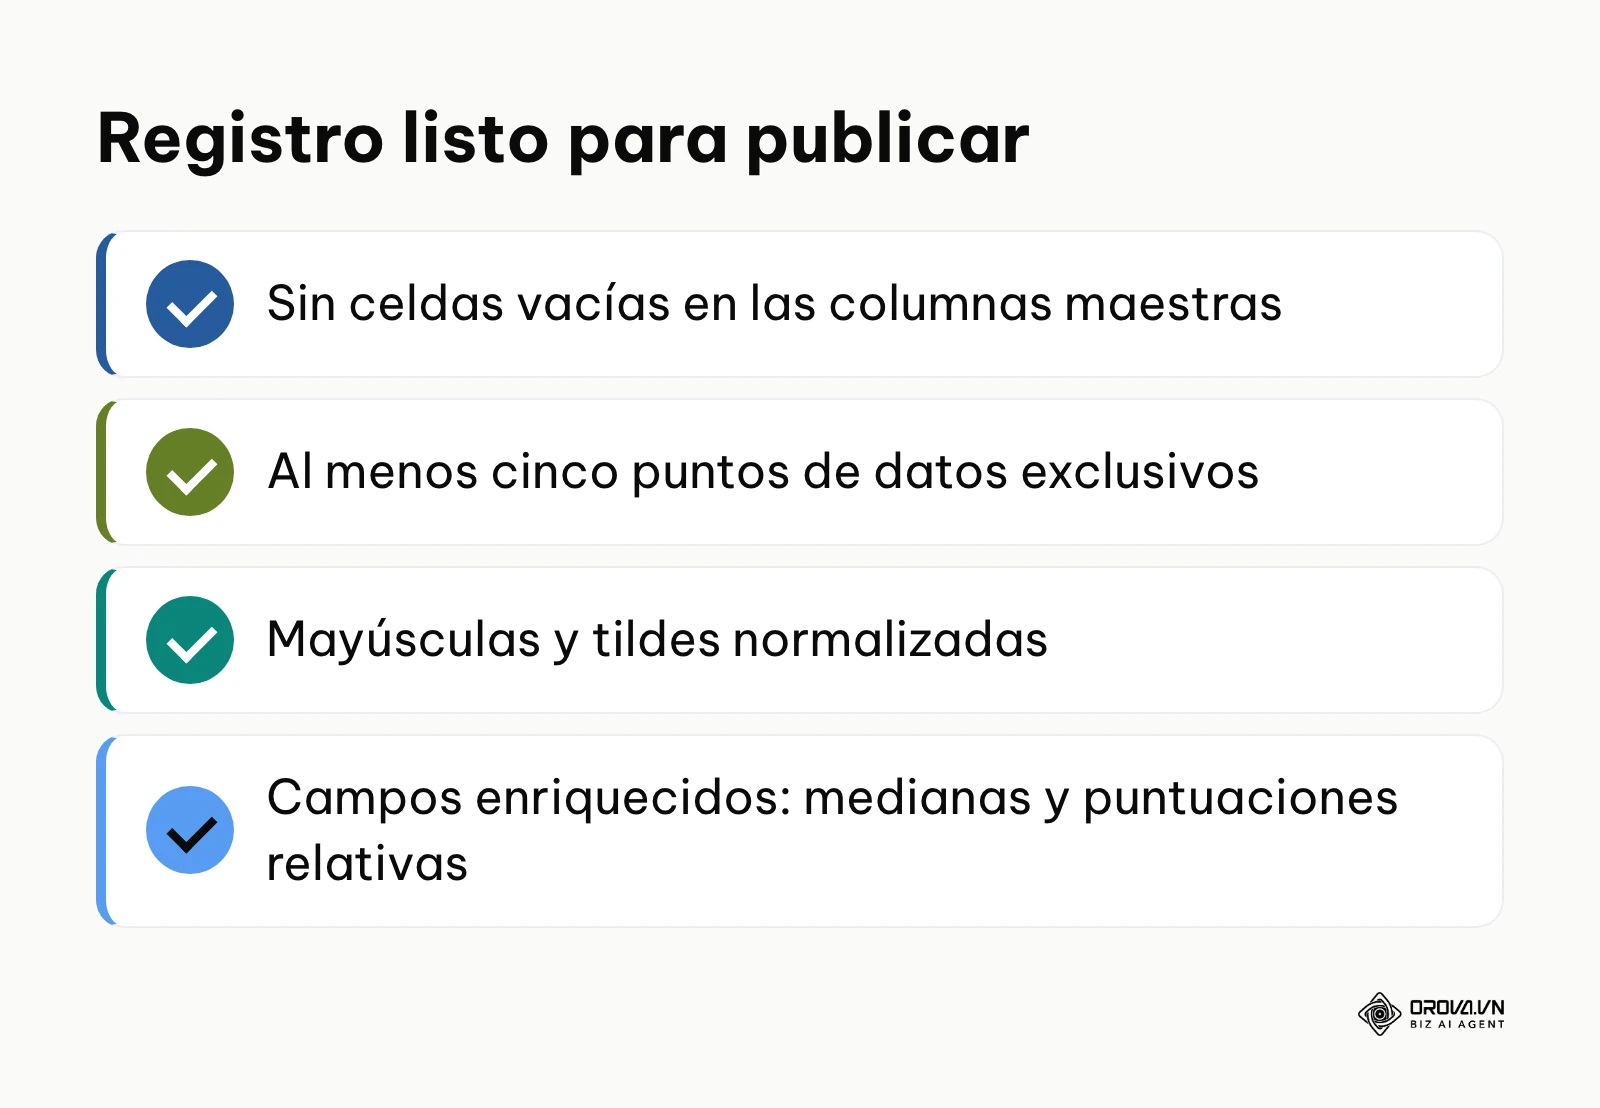
El signo de ejecución correcta es una matriz de datos sin celdas vacías en las columnas maestras y con al menos cinco puntos de datos exclusivos por registro. El error habitual es omitir la normalización de mayúsculas y tildes, provocando fallos de enrutamiento y títulos antiestéticos en la interfaz de usuario.
Paso 3: Diseño de plantillas modulares y optimización GEO
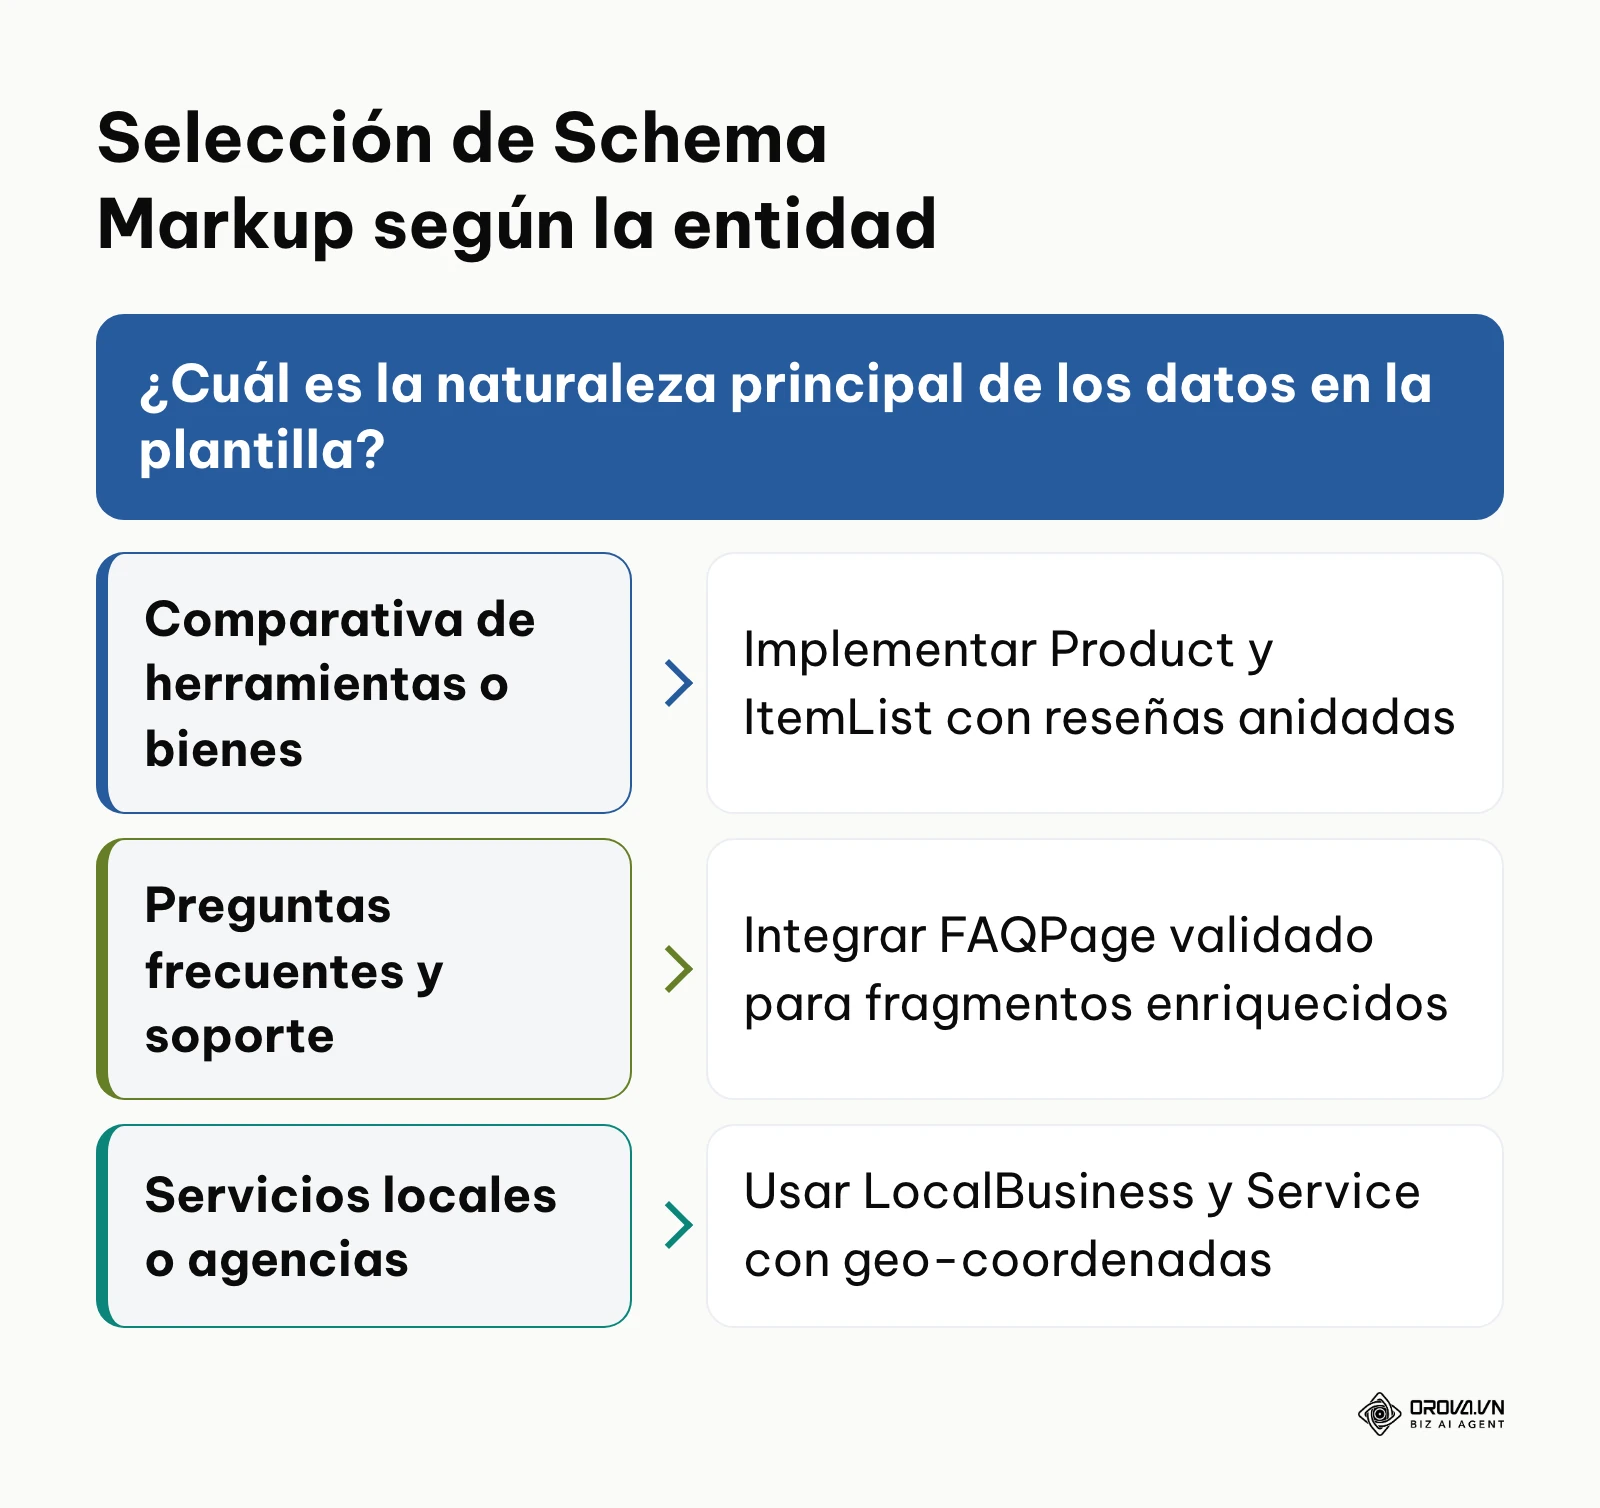
El diseño de plantillas para SEO programático exige abandonar los bloques de texto monolíticos en favor de módulos dinámicos condicionados por los datos disponibles. Además, la plantilla debe adaptarse a la optimización para motores generativos (Generative Engine Optimization o GEO), facilitando que herramientas como ChatGPT Search, Perplexity y las vistas generales creadas por IA de Google extraigan datos estructurados precisos. El siguiente diagrama resume la selección de marcado estructurado según la entidad principal de cada página.
Diseña la plantilla incorporando tres elementos clave:
- Tablas HTML preparadas para fragmentos (snippet-ready): Estructura comparaciones concisas con encabezados de columna semánticos (<thead>, <th>), donde los datos numéricos y las diferencias clave aparezcan en las primeras filas.
- Bloques de respuesta directa a entidades: Párrafos de definición de 40 a 50 palabras que expliquen el resultado exacto de la combinación antes de profundizar en los detalles.
- Marcado estructurado multicapa: Combina varios tipos de esquema del vocabulario Schema.org para describir entidades de forma interoperable.
Para profundizar en la convivencia entre motores tradicionales y modelos de lenguaje, conviene revisar las diferencias estratégicas entre GEO vs SEO, garantizando que tu contenido satisfaga tanto el rastreo clásico como la inferencia semántica.
A continuación se muestra un ejemplo de marcado JSON-LD multicapa para una página de comparación de herramientas:
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@graph": [
    {
      "@type": "Product",
      "@id": "https://ejemplo.com/comparar/herramienta-a#producto",
      "name": "Herramienta A",
      "description": "Software de gestión de flujos de trabajo con integración API.",
      "category": "Software de Gestión"
    },
    {
      "@type": "ItemList",
      "name": "Comparativa técnica: Herramienta A vs Herramienta B",
      "itemListElement": [
        {
          "@type": "ListItem",
          "position": 1,
          "name": "Capacidad de almacenamiento"
        },
        {
          "@type": "ListItem",
          "position": 2,
          "name": "Latencia de sincronización"
        }
      ]
    },
    {
      "@type": "FAQPage",
      "mainEntity": [
        {
          "@type": "Question",
          "name": "¿Cuál es la diferencia principal entre Herramienta A y Herramienta B?",
          "acceptedAnswer": {
            "@type": "Answer",
            "text": "Herramienta A ofrece sincronización en tiempo diferido orientada a procesamiento por lotes, mientras que Herramienta B procesa eventos mediante webhooks concurrentes."
          }
        }
      ]
    }
  ]
}
</script>
El signo de éxito en esta fase es validar la plantilla en la herramienta de prueba de resultados enriquecidos sin advertencias de campos obligatorios faltantes. El error crítico consiste en ocultar datos en pestañas sin renderizado semántico nativo en el código fuente HTML.
Paso 4: Implementación del filtro de calidad IA y prevención de Scaled Content Abuse
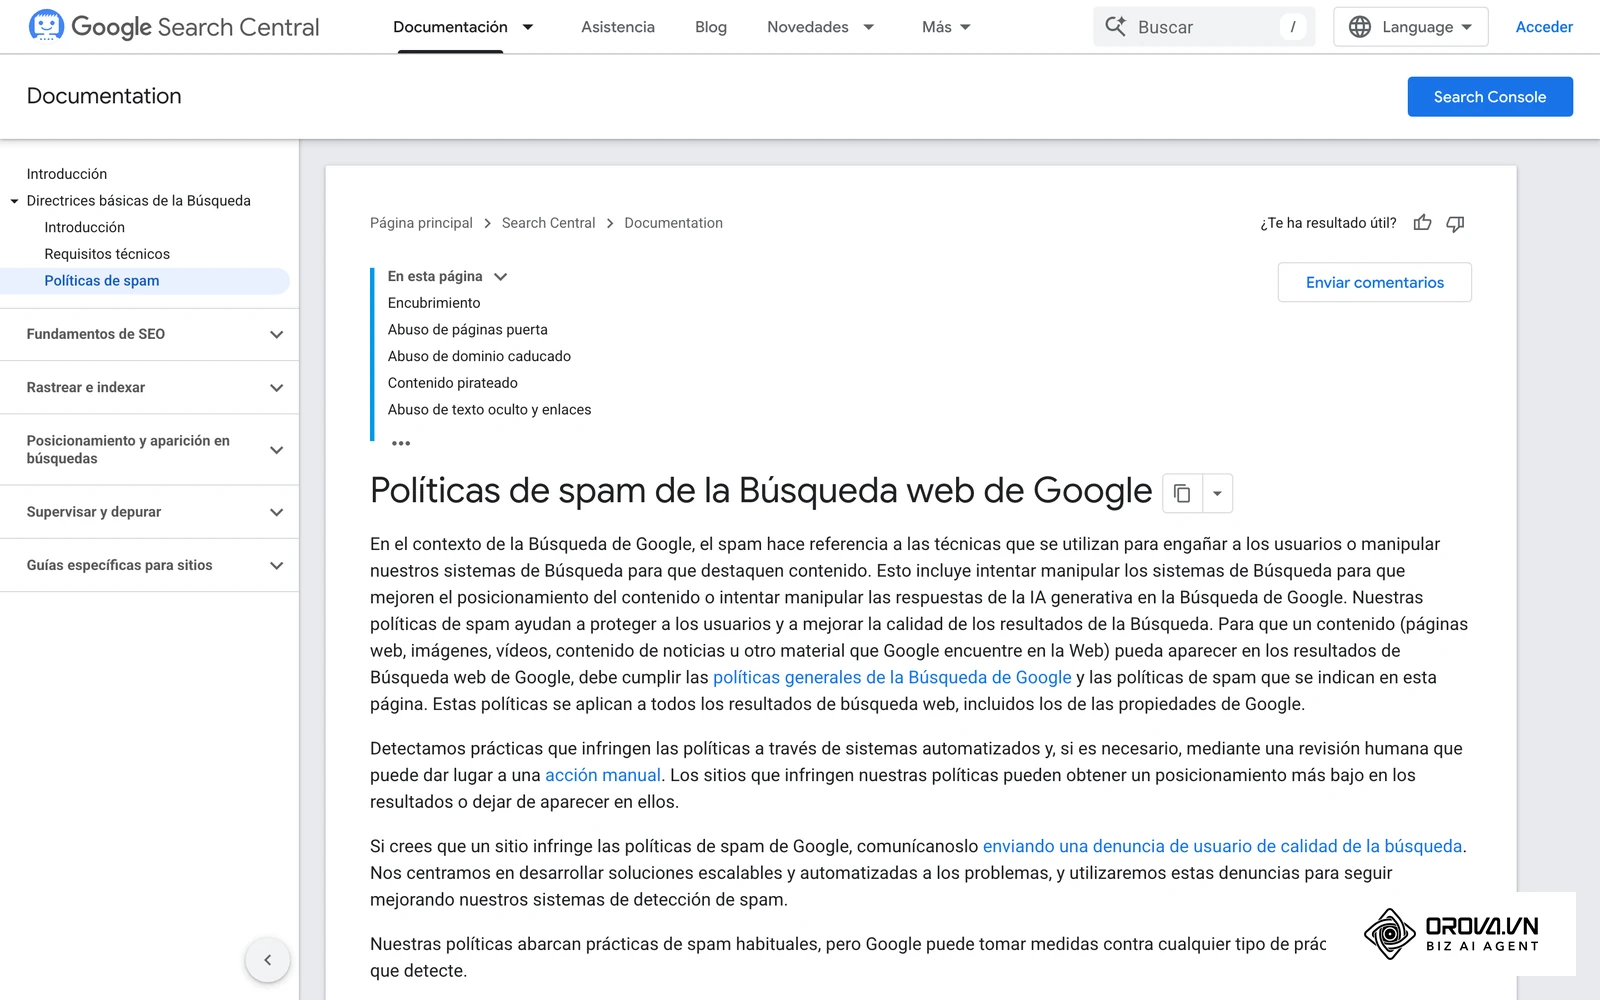
Tras las actualizaciones de los algoritmos de búsqueda, generar miles de páginas con prosa sintética uniforme activa los filtros contra el spam. Específicamente, según las Políticas de spam para la búsqueda web de Google publicadas por Google Search Central en 2024, la generación masiva de páginas sin valor diferencial añadido se clasifica como abuso de contenido a escala (Scaled Content Abuse).
Para evitar que tu sitio sea degradado, implementa una puerta de control de calidad (AI QA Gatekeeping) con dos salvaguardas técnicas:
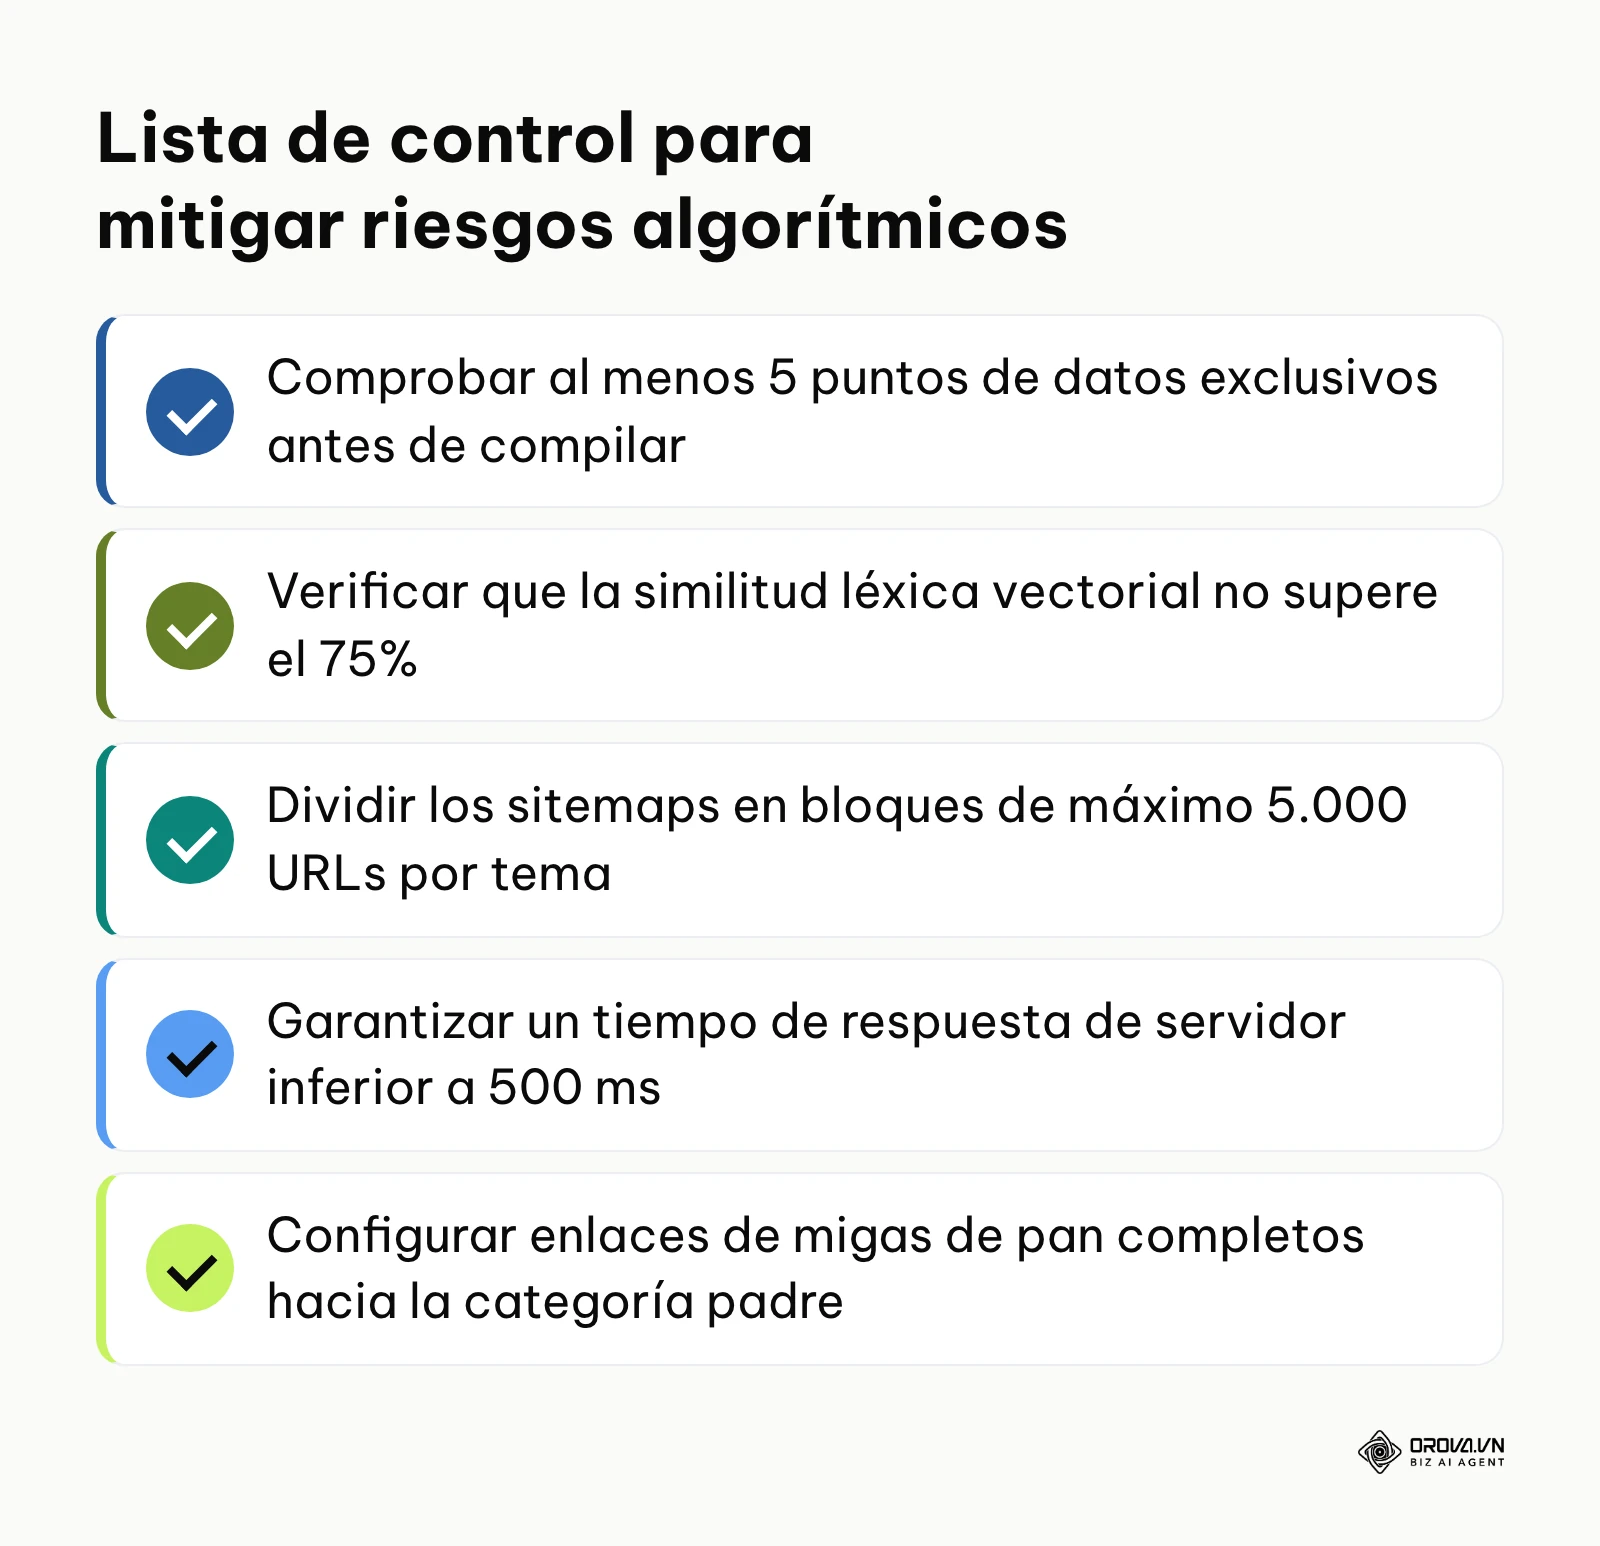
- Matriz de condiciones de publicación: Una regla lógica en el compilador que solo permita compilar y servir una página si el registro cuenta con al menos cinco campos exclusivos no derivados de plantillas comunes. Si un registro solo tiene nombre y código postal, se excluye del proceso de compilación.
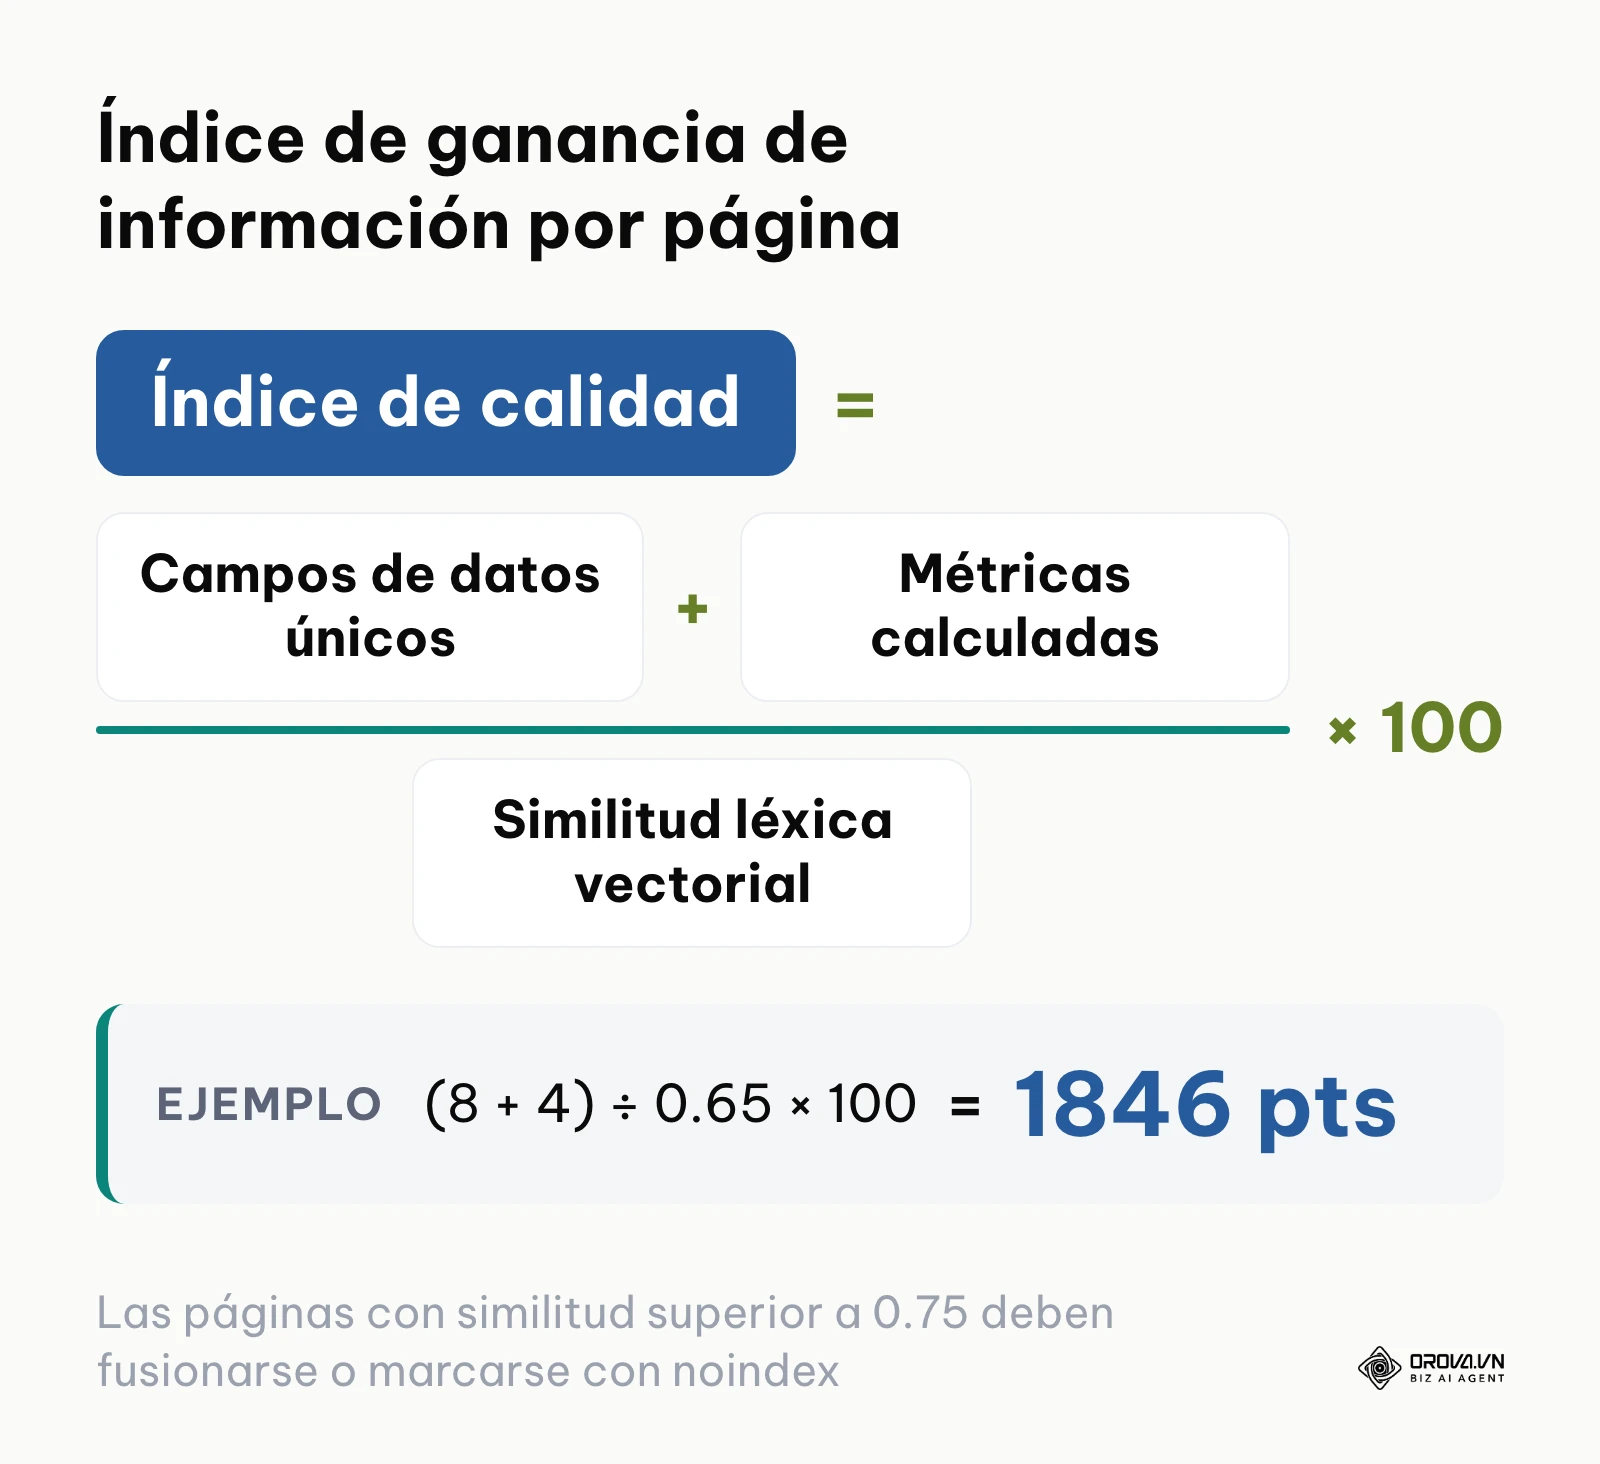
- Control de similitud semántica vectorial: Calcula la similitud del coseno (Cosine Similarity) sobre los vectores incrustados (text embeddings) del contenido de páginas vecinas. Si la similitud supera el umbral del 75%, el sistema debe abortar la publicación de una de ellas o fusionar ambas entidades en una página agregada. El siguiente diagrama resume la fórmula del índice de ganancia de información por página que evalúa este equilibrio técnico.
Respecto a la proporción de texto generado por modelos de lenguaje en cada página, no existe un porcentaje oficial seguro: Google evalúa la utilidad del contenido, no la herramienta que lo produjo. La pauta prudente es que el texto puramente sintético sea una parte minoritaria de la página y que el peso recaiga en datos fácticos estructurados, tablas de atributos y métricas calculadas.
El signo de cumplimiento adecuado es un registro de compilación donde una parte de los registros iniciales queda descartada automáticamente por no superar los filtros de información única. El error frecuente es saltarse esta criba para inflar artificialmente el número de URLs publicadas.
Paso 5: Selección de stack tecnológico y renderizado a escala
El método de renderizado define el rendimiento de entrega y la estabilidad de los costes de servidor. Puedes profundizar en la configuración de gestores de contenido tradicionales consultando la guía sobre SEO para WordPress, donde la gestión de base de datos requiere ajustes de indexación específicos para soportar miles de entradas.
En proyectos que superan las diez mil URLs, los sistemas tradicionales de gestión de contenidos basados en bases de datos relacionales consultadas en cada petición sufren problemas de latencia severos. Para escalar sin degradar el tiempo de respuesta:
- Emplea generadores de sitios estáticos (Static Site Generation o SSG) que compilen el código HTML previamente, sirviéndolo a través de redes de distribución perimetrales (Edge CDNs).
- Si los datos cambian con frecuencia diaria, utiliza regeneración estática incremental (Incremental Static Regeneration o ISR), reconstruyendo bajo demanda únicamente los nodos modificados.
El signo de una arquitectura sólida es un tiempo hasta el primer byte (Time to First Byte o TTFB) inferior a 200 milisegundos en pruebas realizadas desde diferentes ubicaciones geográficas. El error habitual es mantener llamadas dinámicas directas a bases de datos relacionales sin capas de almacenamiento en caché en páginas con miles de visitas concurrentes.
Paso 6: Despliegue escalonado e indexación por lotes
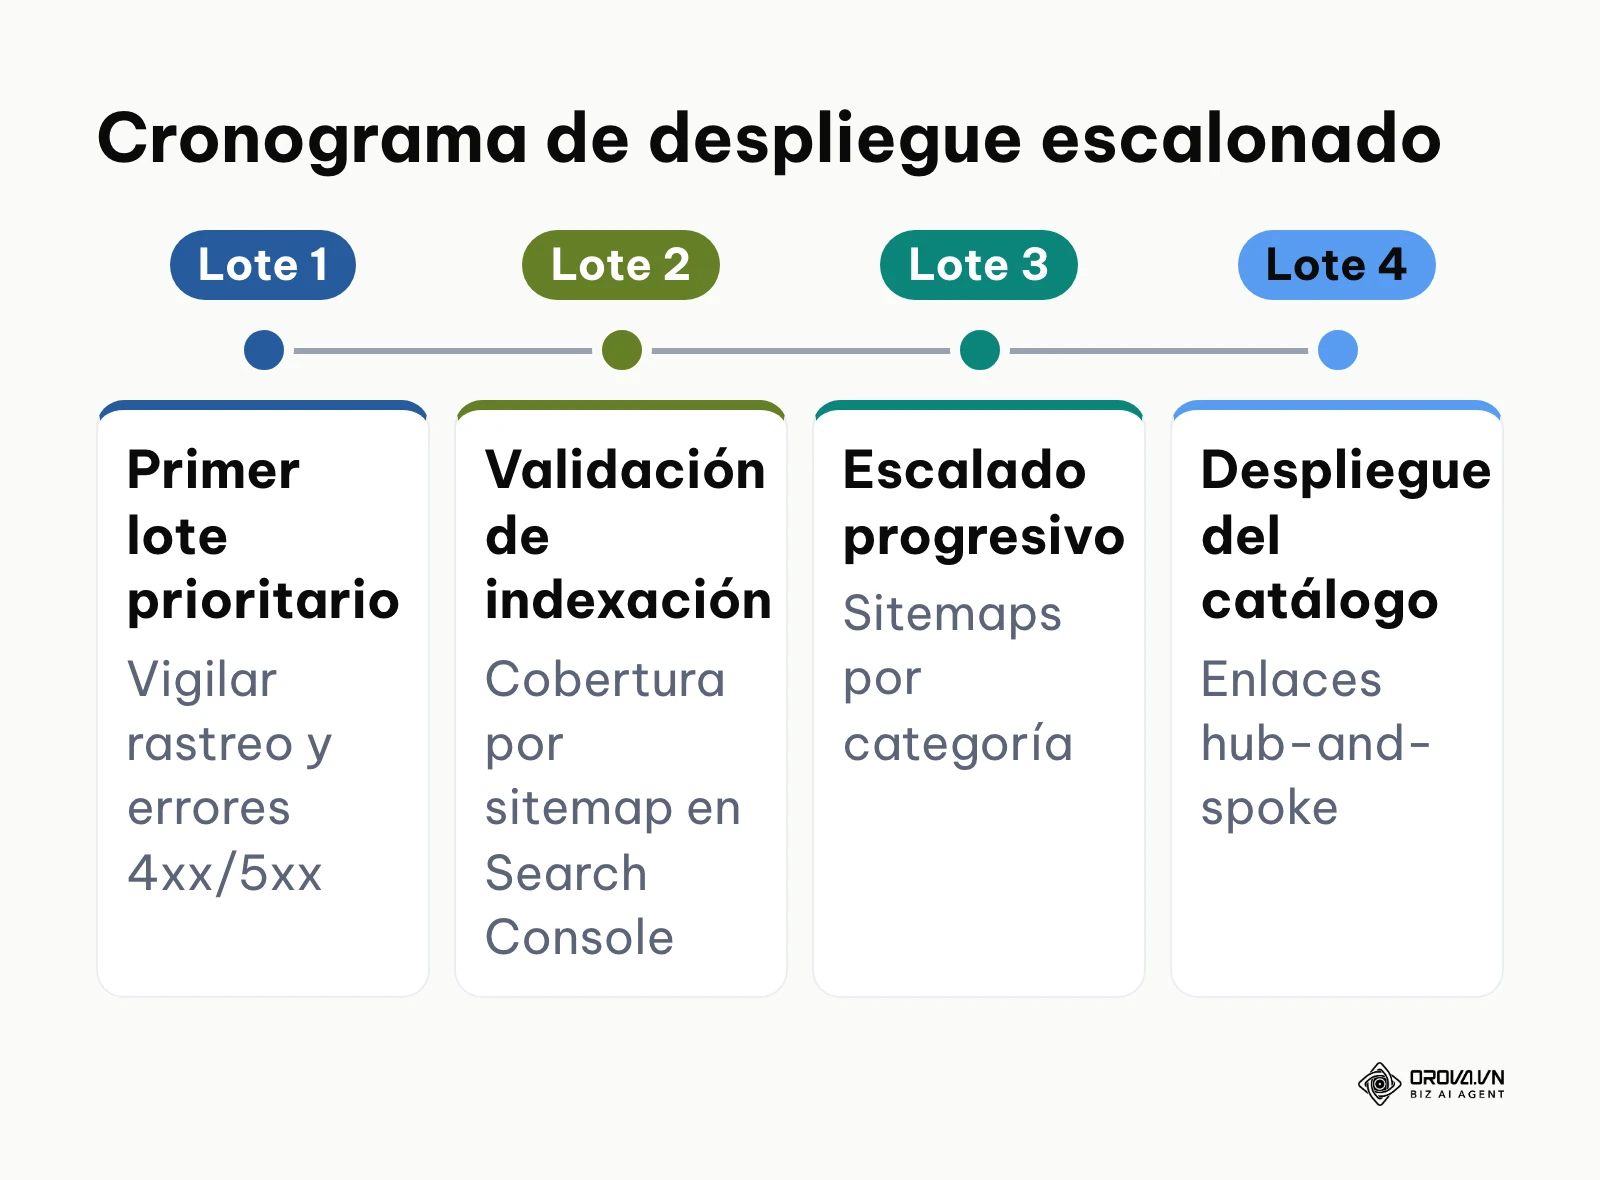
Publicar decenas de miles de URLs simultáneamente en un dominio sin historial de autoridad satura el presupuesto de rastreo (crawl budget). Cuando esto ocurre, los robots de los motores de búsqueda limitan su frecuencia de exploración y dejan la mayoría de las páginas en el limbo de rastreo. El siguiente diagrama resume el cronograma de despliegue escalonado en cuatro etapas para mitigar este riesgo.
Aplica un despliegue en fases controladas:
- Fragmentación de sitemaps XML: Divide el mapa del sitio en archivos independientes de no más de 5.000 URLs por archivo, agrupados por categorías temáticas coherentes (sitemap-integraciones-crm.xml, sitemap-integraciones-erp.xml). Esto permite supervisar en Google Search Console qué subcategorías presentan cuellos de botella de indexación.
- Indexación condicionada por demanda: Aplica la metaetiqueta noindex, follow a las combinaciones que presenten una demanda de búsqueda estimada de cero consultas mensuales según los registros de palabras clave, reservando la etiqueta indexable únicamente para URLs con intención validada.
- Arquitectura interna en silos (Hub-and-Spoke): Construye centros temáticos (hubs) que concentren la autoridad de la página de inicio y distribuyan enlaces hacia las páginas programáticas hijas (spokes), asegurando que cada nodo secundario enlace a su categoría superior y a tres nodos hermanos estrechamente vinculados.
Ejemplo ilustrativo: Un catálogo B2B de comparación de software industrial con 8.000 combinaciones de integraciones entre herramientas, liderado por un consultor técnico de SEO. El consultor fragmentó el sitemap general en 16 sitemaps XML de 500 URLs organizados por categoría tecnológica; configuró una regla condicional en el servidor para aplicar la etiqueta noindex, follow a las 3.200 combinaciones con demanda de búsqueda nula en herramientas de análisis de palabras clave; publicó las primeras 1.000 páginas prioritarias enlazadas directamente desde centros temáticos principales con enlaces de migas de pan completos. Googlebot visitó inicialmente 2.500 páginas pero dejó 1.800 en el estado "Rastreada: actualmente sin indexar" debido a la baja autoridad de los nodos finales; la dificultad se corrigió rediseñando una estructura de enlazado en racimo donde cada página enlazaba obligatoriamente a tres alternativas de la misma familia y al centro principal, retirando temporalmente el sitemap plano. Tras este ajuste, el informe de cobertura de la consola de búsqueda mostró un cambio de estado progresivo hacia páginas válidas e indexadas, logrando que las páginas de integración clave recibieran impresiones orgánicas diarias estables para consultas de compatibilidad técnica.
Para monitorizar este proceso con rigor, revisa la guía de Google Search Console, prestando especial atención a los informes de cobertura y estadísticas de rastreo del servidor.
El signo de una ejecución impecable es una curva ascendente regular de páginas indexadas en los informes de cobertura sin picos erráticos de desindexación. El error habitual es subir un único archivo sitemap gigantesco con 50.000 URLs en un dominio recién creado.
Paso 7: Diagnóstico y resolución de URLs rastreadas pero no indexadas
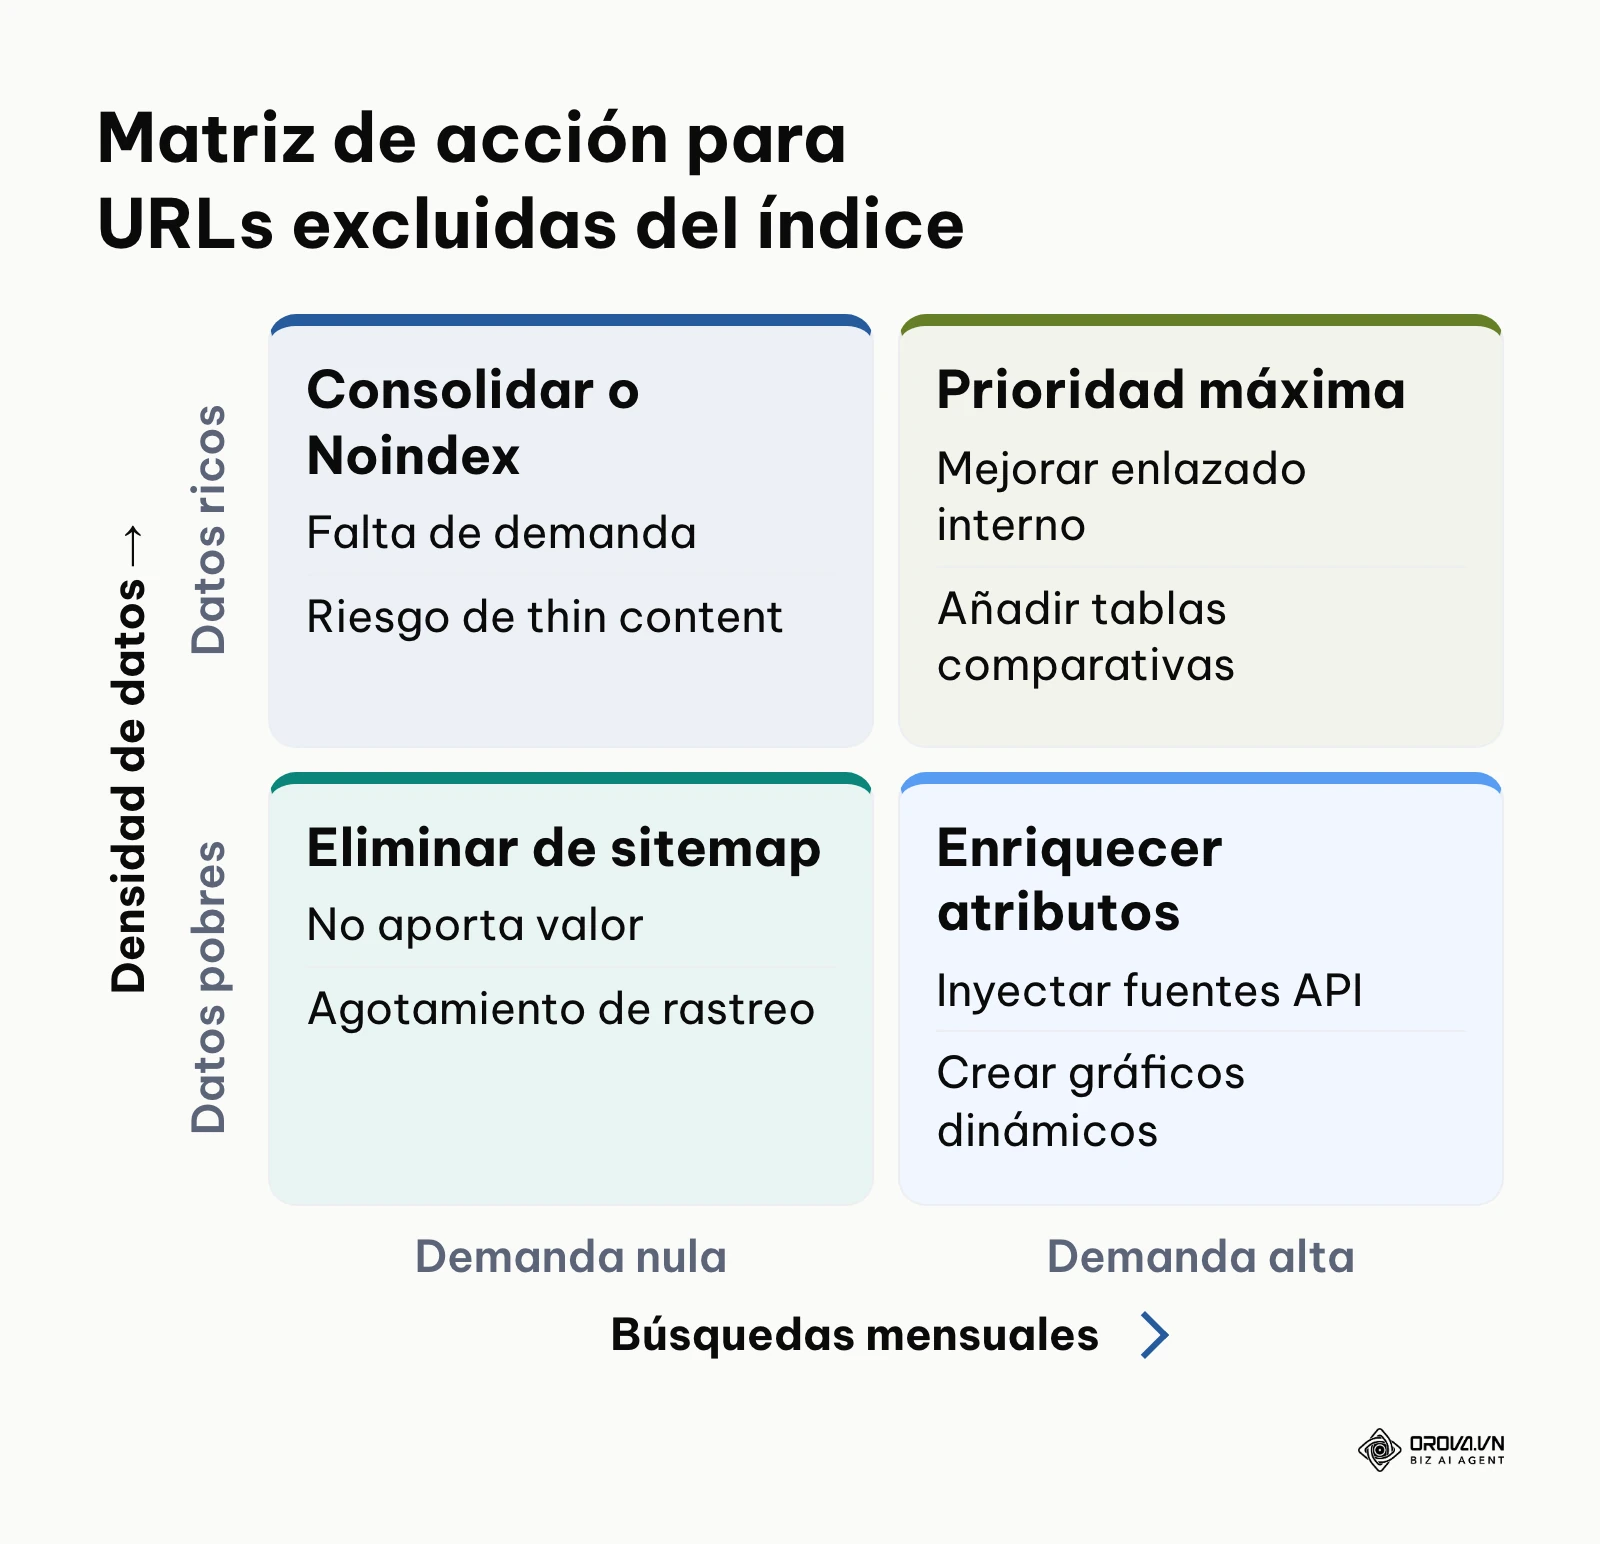
Uno de los problemas más comunes en proyectos masivos es encontrar miles de URLs clasificadas bajo el estado "Rastreada: actualmente sin indexar" (Crawled - currently not indexed). Este estado indica que el motor de búsqueda destinó recursos de rastreo a visitar el documento, pero tras analizar su contenido consideró que no cumplía con los estándares mínimos de calidad o que representaba una duplicación redundante de otras páginas ya indexadas. El siguiente diagrama resume la matriz de acción para URLs excluidas del índice según su demanda y calidad de datos.
Para diagnosticar y solucionar este bloqueo de forma sistemática:
- Auditoría de similitud y volumen textual: Verifica si las URLs excluidas presentan una longitud de contenido útil inferior a la media de las URLs indexadas con éxito. Si la página consta casi exclusivamente de menús y encabezados comunes con solo dos líneas de datos únicos, agrúpala con entidades superiores.
- Revisión del presupuesto de rastreo y latencia de entrega: De acuerdo con la guía de Google Search Central sobre la gestión del presupuesto de rastreo en sitios grandes, la capacidad de rastreo se reduce cuando el servidor responde con lentitud y los contenidos duplicados desperdician parte del rastreo; comprueba que el tiempo de descarga del documento no supere los 500 milisegundos.
- Inyección de datos dinámicos exclusivos: Añade gráficos generados mediante código vectorial (SVG), testimonios estructurados o tablas de cálculo interactivo que aumenten la ganancia de información (information gain) de la página.
- Refuerzo del enlazado interno contextual: Una URL excluida a menudo carece de enlaces internos relevantes. Asegúrate de que reciba enlaces desde artículos editoriales del blog o páginas de categoría principal con texto ancla descriptivo.
El signo de corrección es el paso paulatino de las URLs al estado indexado en las siguientes dos a cuatro semanas tras solicitar la validación de la corrección en la consola de búsqueda. El error frecuente es reenviar el sitemap sin alterar el contenido de las páginas, esperando un resultado diferente de forma pasiva.
Descubre Orova.vn – una plataforma Biz AI Agent con la solución OROVA SEO completa, destinada a todos los sitios web. El sistema acompaña la optimización para motores de búsqueda de A a Z con las siguientes funciones: investigación de palabras clave, redacción de nuevos artículos optimizados para SEO, optimización de los contenidos existentes, seguimiento de posiciones, además del análisis de la competencia y el análisis técnico en profundidad. Regístrate hoy mismo para descubrir OROVA SEO de forma totalmente gratuita (oferta válida hasta el 7 de julio de 2027).
Análisis comparativo de stacks tecnológicos: costes, límites y rendimiento
La elección de herramientas para SEO programático define la viabilidad financiera y la velocidad de entrega de cualquier iniciativa a gran escala. Las soluciones disponibles se dividen en tres grandes familias según su nivel de complejidad técnica y su capacidad para procesar volúmenes crecientes de información. La siguiente tabla compara las tres capas tecnológicas habituales según su capacidad de URLs, costes operativos reales, exigencia técnica y principales restricciones:
| Enfoque tecnológico | Pila recomendada | Rango óptimo de URLs | Coste mensual aproximado | Nivel técnico requerido | Puntos débiles principales |
|---|---|---|---|---|---|
| Capa 1: No-code | Airtable + Make + WordPress / Webflow | Menos de 2.000 URLs | Medio-alto y creciente con el volumen | Principiante | Límites estrictos de registros en CMS, costes crecientes por operaciones API y tiempos de renderizado lentos |
| Capa 2: Low-code | Supabase + WP All Import / Framer | De 2.000 a 10.000 URLs | Medio | Intermedio | Sobrecarga de base de datos en WordPress, necesidad de mantenimiento de extensiones y cachés complejas |
| Capa 3: Full-code | PostgreSQL + Astro SSG / Next.js + Cloudflare Pages | Más de 10.000 URLs | Bajo | Avanzado (desarrollo web) | Requiere conocimientos de programación, desarrollo de componentes a medida y despliegues mediante repositorios de código |
Muchos profesionales caen en la trampa económica del entorno sin código: comenzar con herramientas como Webflow o Airtable parece accesible, pero al crecer el número de elementos los planes de pago suben de nivel con rapidez, chocando con techos de base de datos que bloquean la publicación de catálogos medianos.
Por contrapartida, un entorno basado en Astro compilado estáticamente sobre una red de entrega global permite alojar más de 50.000 páginas con costes de infraestructura prácticamente inexistentes, ofreciendo una velocidad de carga inalcanzable para gestores de contenido dinámicos tradicionales.
Ejemplo ilustrativo: Un directorio de cálculo de tasas e impuestos locales para trabajadores autónomos con 12.000 URLs proyectadas, administrado por un equipo de dos fundadores. Los fundadores migraron la arquitectura inicial basada en una base de datos sin código y un gestor dinámico hacia un generador de sitios estáticos con Astro alojado en Cloudflare Pages y conectado a una base de datos PostgreSQL en Supabase; crearon componentes modulares reutilizables para renderizar tablas dinámicas de cálculo fiscal; automatizaron la regeneración estática semanal mediante webhooks vinculados a cambios en las normativas fiscales. En la plataforma anterior, las limitaciones de elementos en el gestor y los costes por llamada externa encarecieron el proyecto antes de alcanzar las 3.000 páginas, provocando además tiempos de respuesta de servidor superiores a 2,5 segundos que frenaban el rastreo; la migración a archivos estáticos redujo la latencia de entrega a milisegundos a través de la red perimetral de distribución. Tras el cambio, los robots de búsqueda aumentaron la frecuencia de rastreo diario a miles de páginas por jornada según las estadísticas del servidor, mientras que el proyecto mantuvo una infraestructura operativa estable y predecible sin interrupciones por límites de procesamiento.
Al analizar ejemplos de SEO programático exitosos como Zapier con sus páginas de integración bidireccional, plataformas de viajes que parametrizan vuelos y hoteles por destino o comparadores de tarifas de telecomunicaciones, se comprueba que todos comparten una base técnica similar: generación estática, enriquecimiento fáctico de datos y renderizado optimizado para tiempos de respuesta instantáneos.
Medición del rendimiento orgánico: métricas clave y diagnóstico de indexación
Gestionar miles de páginas simultáneas exige cuadros de mando, por ejemplo construidos en Looker Studio sobre los datos de Search Console, que distingan entre el volumen de URLs generadas y el impacto orgánico real que logran capturar. Para asegurar un seguimiento financiero riguroso de estas acciones, apóyate en el marco de KPIs SEO para vincular el tráfico indexado con la captación de clientes.
La siguiente tabla detalla los indicadores de control indispensables para monitorizar el rendimiento de un catálogo programático:
| Métrica | Significado técnico | Fuente de medición | Umbral de alerta |
|---|---|---|---|
| Tasa de indexación efectiva | Proporción de URLs publicadas que Google incorpora activamente a su índice | Google Search Console (Informe de Cobertura) | Inferior al 65% tras 60 días de publicación |
| Impresiones de cola larga | Volumen acumulado de impresiones en consultas con tres o más términos | Google Search Console (Rendimiento) | Curva plana o descendente durante más de 4 semanas consecutivas |
| Porcentaje de clics (CTR) medio | Relevancia del título dinámico frente a la intención de búsqueda | Google Search Console (Rendimiento) | Inferior al 1,5% en posiciones comprendidas entre la 1 y la 5 |
| Tiempo de respuesta de rastreo | Milisegundos que tarda el servidor en entregar el documento a los robots | Google Search Console (Estadísticas de Rastreo) | Superior a 600 ms de forma sostenida |
| Tasa de páginas zombi | Porcentaje de URLs indexadas que no reciben ni una sola visita en 90 días | Analítica web (GA4) vinculada a base de datos | Superior al 40% del total de URLs indexadas |
Para garantizar que ninguna página problemática llegue a producción, aplica la siguiente lista de verificación de control de calidad previa a la publicación:
- El registro de datos cuenta con un mínimo de cinco campos técnicos exclusivos y validados.
- La fórmula de generación del título dinámico se mantiene entre 50 y 60 caracteres sin truncarse.
- La metaetiqueta de descripción dinámica aporta datos numéricos concretos en menos de 155 caracteres.
- La etiqueta canónica apunta con precisión a la versión definitiva del protocolo HTTPS sin barras finales duplicadas.
- Los encabezados H1, H2 y H3 respetan la jerarquía semántica sin saltarse niveles estructurales.
- La puntuación de similitud léxica vectorial frente a páginas hermanas no supera el umbral del 75%.
- La plantilla incluye al menos una tabla de datos estructurada con etiquetas HTML nativas.
- El marcado JSON-LD no presenta errores de validación en la herramienta oficial de datos estructurados.
- Los enlaces de migas de pan (breadcrumbs) enlazan correctamente a toda la cadena de categorías ascendentes.
- La página enlaza a un mínimo de tres páginas hermanas de la misma subcategoría temática.
- Los activos gráficos cuentan con atributos de texto alternativo (alt) descriptivos y formatos comprimidos.
- La respuesta del servidor en pruebas locales entrega un código de estado HTTP 200 en menos de 300 milisegundos.
Con OROVA.VN y el módulo OROVA SEO, pones fin definitivamente a las jornadas agotadoras de trabajo manual. En lugar de batallar durante horas para redactar artículos y elaborar informes, todo el proceso queda ahora optimizado y completado en tan solo 5 minutos.
Errores comunes en proyectos de SEO programático y cómo corregirlos
El fracaso de la mayoría de los despliegues a gran escala suele deberse a descuidos estructurales previsibles. A continuación se examinan los fallos técnicos más habituales, sus consecuencias inmediatas y la metodología para solventarlos. El siguiente diagrama resume los puntos críticos de control de calidad indispensables para mitigar riesgos algorítmicos.
- Publicar miles de URLs con contenido escaso (Thin Content): Generar páginas donde solo cambian el nombre de la ciudad o el título del producto sin añadir datos locales o especificaciones diferenciadas provoca la pérdida masiva de indexación en las siguientes revisiones del núcleo algorítmico (Core Updates). Consecuencia: Desindexación masiva y pérdida de confianza global en todo el dominio. Solución: Implementa una regla de exclusión estricta: si un registro no posee métricas exclusivas, precios locales o atributos diferenciales, aplícale la etiqueta noindex o consolídalo en una página regional superior.
- Liberar todo el catálogo de golpe saturando el presupuesto de rastreo: Subir 30.000 URLs en un dominio joven provoca que los rastreadores visiten solo una fracción superficial, dejando el resto sin procesar durante meses. Consecuencia: URLs atrapadas en el estado "Detectada: actualmente sin indexar" durante periodos prolongados. Solución: Publica en lotes progresivos de 500 a 1.000 URLs mediante sitemaps fragmentados, escalando el ritmo de publicación solo cuando la tasa de indexación del lote previo supere el 70%.
- Arquitectura con páginas huérfanas (Orphan Pages): Confiar exclusivamente en el mapa del sitio XML para que los motores descubran las páginas sin tejer una red de enlaces internos navegables dentro de la interfaz web. Consecuencia: Distribución nula de autoridad interna (PageRank) hacia los nodos finales, lo que impide que alcancen posiciones competitivas. Solución: Construye componentes de navegación contextual en la plantilla, como módulos de "soluciones relacionadas", listados de entidades por letra inicial o selectores de navegación facetada estática.
Errores de mantenimiento y de uso de la IA
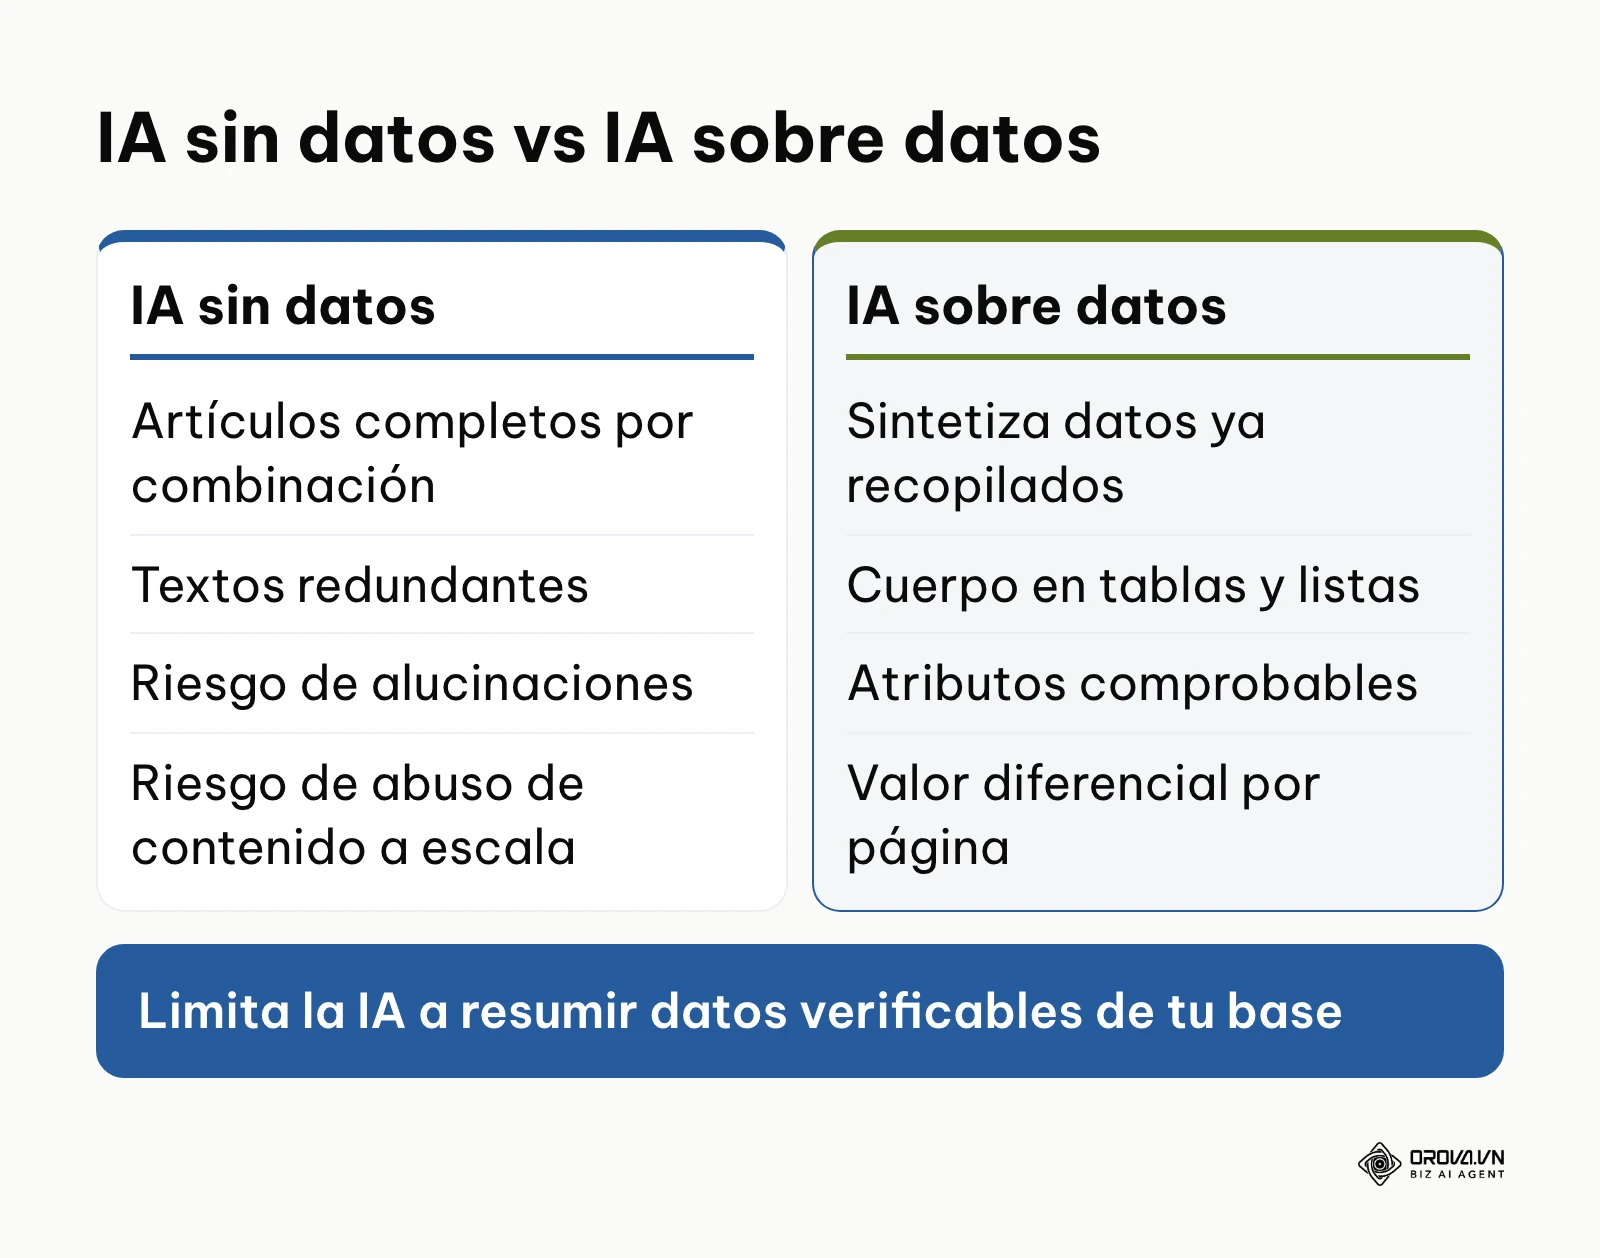
Los tres fallos siguientes aparecen después del lanzamiento, cuando el catálogo ya está publicado. El siguiente diagrama resume la diferencia entre usar la IA sin datos y usarla sobre datos enriquecidos.
- Canibalización descontrolada entre intenciones idénticas: Crear páginas independientes para variaciones morfológicas menores que responden a la misma necesidad del usuario. Consecuencia: Dos o más páginas de tu propio sitio compiten entre sí en las posiciones secundarias de los resultados de búsqueda, alternándose continuamente sin consolidarse en los primeros puestos. Solución: Agrupa variantes sinónimas bajo una única entidad canónica y utiliza anclajes internos secundarios para responder a matices léxicos dentro del mismo documento.
- Bases de datos desactualizadas con información obsoleta: Dejar las páginas desatendidas tras la publicación inicial sin actualizar precios, normativas o características que varían con el tiempo. Consecuencia: Aumento de la tasa de rebote por insatisfacción del usuario y pérdida progresiva de señales de interacción positiva. Solución: Configura rutinas de sincronización programada mediante tareas cron o webhooks que refresquen la base de datos periódicamente y actualicen la fecha de modificación en los sitemaps.
- Delegar el texto completo a modelos de inteligencia artificial sin datos enriquecidos: Pedir a un modelo lingüístico que redacte artículos completos para cada combinación sin inyectar datos duros ni parámetros verificables. Consecuencia: Textos redundantes, alucinaciones factuales y penalizaciones por abuso de contenido generado a escala. Solución: Limita la IA a sintetizar los datos previamente recopilados en la base de datos, estructurando el cuerpo principal en tablas y listas de atributos comprobables.
Tendencias de SEO programático en los próximos años: reflexiones del autor
Al analizar la evolución de los motores de búsqueda a fecha de 2026, observo señales claras de que las páginas programáticas basadas solo en texto plano pierden terreno. Los motores de búsqueda y las plataformas de respuesta sintetizada ya no premian el volumen de documentos indexados, sino la densidad de datos verificables y la interactividad funcional.
En mi opinión, durante los próximos dos o tres años es probable que veamos una convergencia creciente entre las páginas de resultados orgánicos y los motores de inferencia generativa. Considero que las páginas que se limitan a listar datos pasivos perderán buena parte de sus clics frente a las respuestas automáticas de las interfaces de búsqueda. Por el contrario, los proyectos programáticos que sobrevivan y multipliquen su tráfico serán aquellos estructurados como microaplicaciones modulares, integrando calculadoras dinámicas, simuladores en tiempo real y comparadores interactivos que un modelo de lenguaje no pueda replicar en su propia interfaz sin enviar al usuario a la fuente original.
Me inclino por anticipar que los sistemas de rastreo incorporarán filtros de calidad algorítmica previos a la fase de renderizado completo, descartando URLs masivas si detectan que el código fuente carece de esquemas semánticos interoperables o si su contenido es casi idéntico al de otras páginas del mismo dominio. Para prepararse ante este escenario, los profesionales deben dejar de pensar como redactores de contenido a gran escala y comenzar a operar como arquitectos de datos: tu ventaja competitiva ya no radicará en cuántos miles de páginas puedas compilar, sino en la exclusividad, precisión y estructura de las bases de datos propietarias que alimentan tu ecosistema.
Sin embargo, esta predicción podría verse alterada si los motores de búsqueda principales cierran sus ecosistemas hacia búsquedas conversacionales sin navegación externa, limitando la atribución de enlaces a fuentes académicas o gubernamentales cerradas, o si el coste de computación para rastrear la web abierta obliga a las plataformas a recortar drásticamente sus índices públicos.
Preguntas frecuentes sobre el SEO programático
¿Cómo solucionar de raíz el error 'Rastreada: actualmente sin indexar' en miles de URLs programáticas?
Debes auditar la densidad de datos únicos de las URLs afectadas y reforzar su enlazado interno desde categorías con autoridad. Si las páginas comparten más del 75% de su contenido con otras URLs del sitio, inyecta atributos diferenciales mediante APIs externas o consolida las entidades débiles bajo una página agregada. Verifica además que el tiempo de respuesta del servidor sea inferior a 500 milisegundos y fragmenta tus sitemaps XML para guiar la exploración de los rastreadores hacia los lotes prioritarios.
¿Cuál es la diferencia exacta entre SEO tradicional y SEO programático?
El SEO tradicional se enfoca en investigar, redactar y optimizar páginas de forma individual para términos con volumen medio o alto de búsqueda, demandando recursos manuales continuos. El enfoque programático, en cambio, utiliza una base de datos estructurada y plantillas de diseño modular para generar de forma automatizada miles de páginas dirigidas a consultas de cola larga con patrones repetitivos, reduciendo el coste marginal de creación por página prácticamente a cero.
¿Qué porcentaje de contenido generado por IA es seguro en cada página sin arriesgar penalizaciones?
No hay un porcentaje oficial: Google valora la utilidad del contenido, no la herramienta que lo redacta. La pauta prudente es que el texto redactado por modelos de inteligencia artificial sea una parte minoritaria del contenido visible y que el resto esté compuesto por tablas de especificaciones, métricas calculadas a partir de datos duros, listas estructuradas y atributos fácticos verificables que garanticen una ganancia de información clara frente a contenidos puramente sintéticos.
¿Cómo influye la inteligencia artificial generativa en el futuro de las plantillas para SEO programático?
La inteligencia artificial generativa obliga a diseñar plantillas preparadas para la optimización de motores generativos (GEO), incorporando esquemas JSON-LD multicapa y tablas de datos semánticas de fácil lectura para los modelos de lenguaje. En lugar de limitarse a rellenar párrafos con texto genérico, la inteligencia artificial debe utilizarse para normalizar conjuntos de datos dispersos y redactar resúmenes fácticos breves condicionados por atributos numéricos reales.
¿Cuánto cuesta realmente mantener una base de datos de más de 10.000 páginas programáticas?
Si utilizas herramientas sin código basadas en bases de datos propietarias y gestores de contenido convencionales, el coste mensual suele ser el más alto de las tres opciones y crece con el volumen por los límites de almacenamiento y los cobros por operaciones de API. Si optas por una arquitectura de código personalizado con generación de sitios estáticos sobre redes perimetrales conectadas a bases de datos relacionales abiertas, el coste de infraestructura suele ser bajo y estable; el gasto principal pasa a ser el tiempo de desarrollo.
¿Cómo evitar que las páginas programáticas canibalicen el tráfico de mis páginas principales?
Debes delimitar estrictamente la intención de búsqueda de cada nivel jerárquico: las páginas pilares deben optimizarse para términos genéricos de alto volumen, mientras que las páginas programáticas deben responder a consultas hiperespecíficas compuestas por tres o más modificadores. Si dos consultas comparten la mayoría de los resultados en la página de resultados de búsqueda, unifica ambas variaciones en una sola página programática mediante parámetros secundarios.
¿Por dónde deberías empezar?
Para iniciar tu proyecto sin cometer errores que comprometan la autoridad de tu dominio, identifica cuál de las siguientes tres situaciones describe mejor el estado actual de tu infraestructura:
- Si eres un profesional o comercializador sin perfil técnico que busca validar la demanda inicial: No contrates plataformas de desarrollo complejas ni generes miles de páginas de inmediato. Dedica una tarde a seleccionar un patrón de búsqueda de cola larga con al menos veinte variantes claras, crea una hoja de cálculo con diez filas de datos ricos y redacta manualmente tres páginas de prueba para comprobar si Google las indexa y genera impresiones antes de intentar cualquier automatización. Si prefieres delegar la parte técnica, revisa antes los criterios para elegir una agencia SEO que entienda proyectos de datos.
- Si cuentas con un equipo de desarrollo y dispones de una base de datos propia consolidada: No utilices gestores de contenido tradicionales que colapsen ante consultas masivas. Programa una reunión técnica para diseñar una prueba de concepto estática de 500 URLs alojadas en una red de distribución perimetral, fragmenta un sitemap XML específico para ese subdirectorio y valida que el tiempo hasta el primer byte se mantenga por debajo de los 200 milisegundos en todas las peticiones.
- Si ya desplegaste un catálogo masivo pero la mayoría de las páginas están desindexadas o perdieron tráfico: Detén de inmediato la publicación de nuevas páginas y no reenvíes los mapas del sitio de forma masiva. Descarga el informe de cobertura de la consola de búsqueda, aplica un filtro de similitud semántica para identificar las páginas que superen el 75% de coincidencia léxica y coloca temporalmente la etiqueta noindex en los registros con menor densidad de datos para sanear el rastreo de tu dominio.
La clave del éxito a largo plazo radica en tratar cada página generada como un activo de información útil para el usuario, asegurando que la ingeniería de datos y la relevancia semántica guíen cada fase de tu estrategia de SEO programático.
About the author

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Gestiona tu negocio con AI Agents
Orova es el Biz AI Agent que nunca para: planifica, ejecuta y optimiza el trabajo por ti.
Gana tiempo y multiplica tu productividad.