
Hur fungerar en ai-textgenerator? Från tokens till färdig text
Att förstå hur fungerar en ai-textgenerator i praktiken är skillnaden mellan att drunkna i platt, generiskt innehåll och att bygga en skalbar publiceringsmotor. Många som testar tekniken för första gången betraktar den som ett magiskt orakel som tänker och förstår världen på samma sätt som en människa. När verktyget plötsligt hittar på felaktiga källor eller tappar tråden halvvägs genom en längre text uppstår frustration. Den enkla förklaringen att AI bara gissar nästa ord är visserligen sann, men den räcker inte för att förstå varför vissa texter blir knivskarpa medan andra spårar ur. Denna guide går under huven på tekniken för att visa de matematiska principerna, hur parametrarna styr slutresultatet och hur du bygger ett professionellt produktionsflöde som levererar hög kvalitet varje gång.
Vad är en AI-textgenerator och hur fungerar en ai-textgenerator?
En ai-textgenerator är ett mjukvaruverktyg baserat på stora språkmodeller som analyserar textmönster för att automatiskt förutsäga och producera sammanhängande text. Verktyget används för att skapa artiklar, e-postmeddelanden och produktbeskrivningar. Till skillnad från traditionella sökmotorer eller regelstyrda mallar skapar generatorn nytt, unikt innehåll genom statistiska sannolikhetsberäkningar på orddelar snarare än att återge statiska dokument.
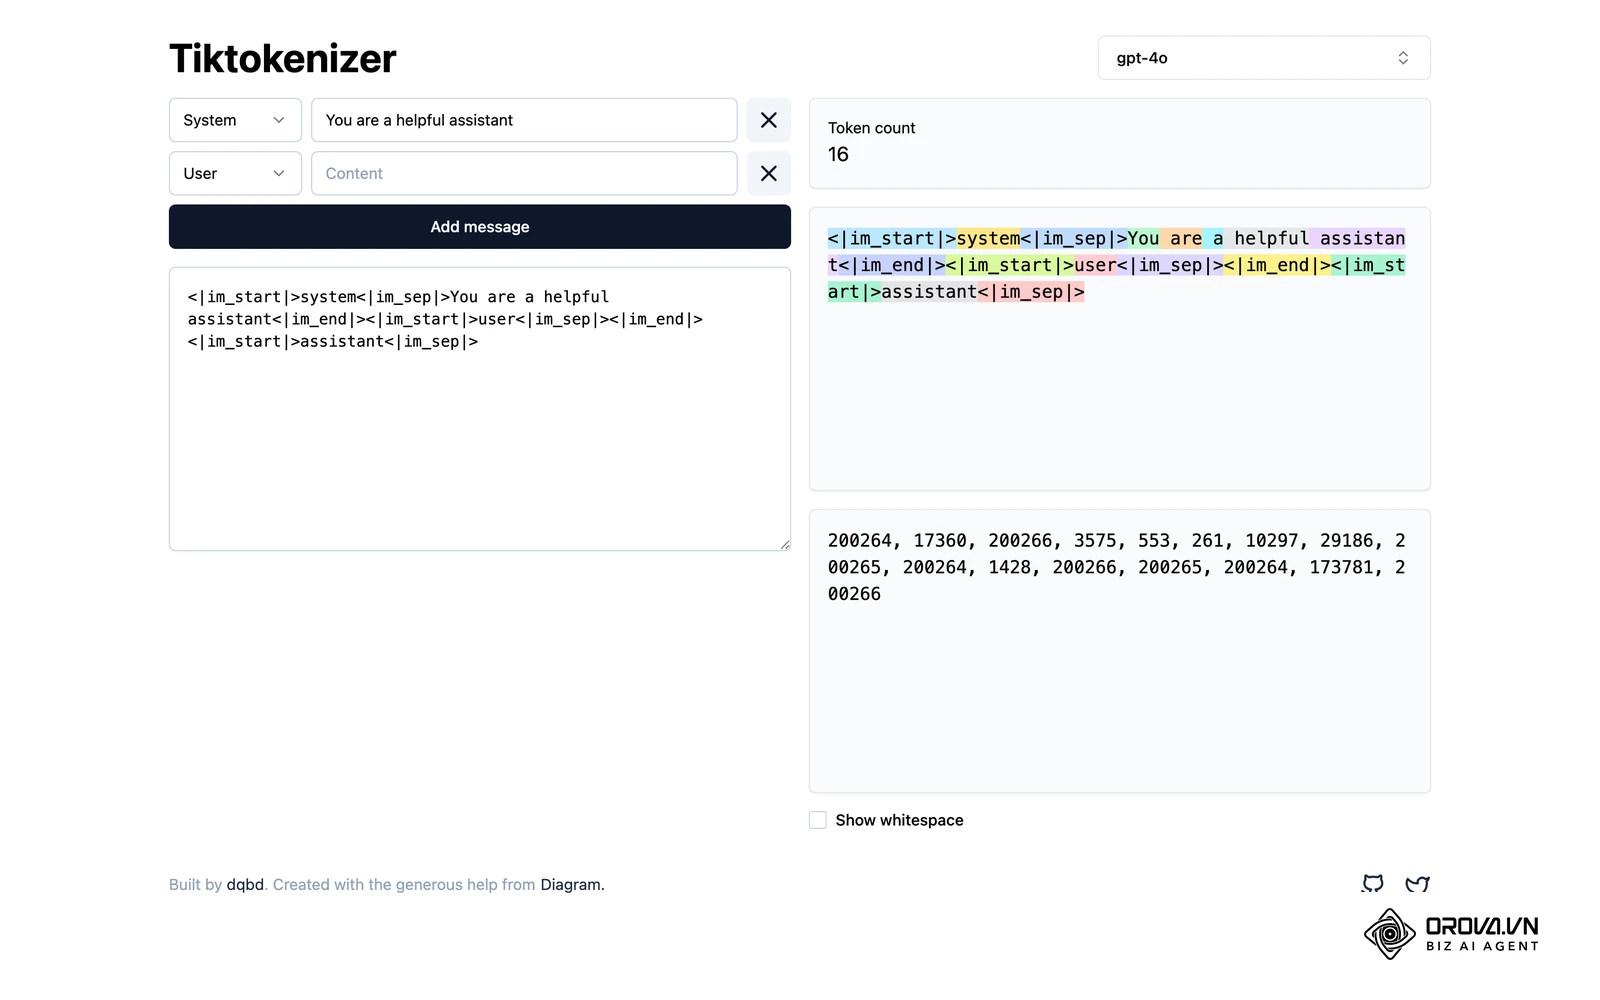
Begreppet härstammar från det bredare fältet naturlig språkbehandling, ofta förkortat NLP efter engelskans natural language processing. Historiskt sett förlitade sig textgenerering på förprogrammerade grammatiska regler och statiska ordböcker. När utvecklingen rörde sig mot maskininlärning och djupa neurala nätverk förändrades förutsättningarna i grunden. Dagens generatorer bygger på storskaliga språkmodeller, så kallade LLM efter engelskans large language models, som tränats på massiva mängder text från böcker, artiklar och webbsidor.
Det är vanligt att blanda ihop en AI-textgenerator med andra digitala verktyg som hanterar text, men deras grundläggande arkitektur skiljer sig radikalt. Tabellen nedan förtydligar skillnaderna mot tre närliggande tekniker.
| Koncept | Hur tekniken skiljer sig | Konkret exempel på användning |
|---|---|---|
| AI-textgenerator | Beräknar matematiska sannolikheter för att skapa ny, unik text utifrån en given instruktion | Skriver ett helt blogginlägg utifrån en disposition och bifogade källor |
| Sökmotor | Indexerar befintliga webbsidor och matchar sökfrågor mot lagrad information utan att skapa nytt | Presenterar länkar och utdrag från relevanta artiklar som redan publicerats |
| Regelbaserad mallmotor | Fyller i fördefinierade fält i en statisk mall utifrån fasta logiska regler | Skickar en automatisk orderbekräftelse där kundens namn och ordernummer klistras in |
| Stavnings- och grammatikkontroll | Analyserar befintlig text mot formella grammatiska regler och ordböcker | Rödmarkerar felstavade ord och föreslår korrekta böjningsformer i ett dokument |
För att förstå mekanismen i vardagen kan du tänka på hur telefonens tangentbord föreslår nästa ord när du skriver ett textmeddelande. Om du skriver "Jag kommer" föreslår telefonen ofta "snart" eller "hem". En modern AI-textgenerator fungerar enligt samma grundprincip, men i stället för att bara titta på de två senaste orden analyserar den tusentals ord samtidigt och väger samman stil, tonfall, grammatik och logisk struktur i en gigantisk matematisk modell.
Varför finns AI-textgeneratorer och vilka problem löser de?
Tekniken bakom automatiserad textgenerering uppstod inte som en underhållningsprodukt, utan som ett svar på ett växande strukturellt problem: informationssamhällets extrema behov av skräddarsydd text i kombination med människans begränsade skrivhastighet. Företag, organisationer och enskilda kreatörer förväntas producera guider, produktsidor, nyhetsbrev och dokumentation i en takt som traditionella redaktioner sällan hinner med.
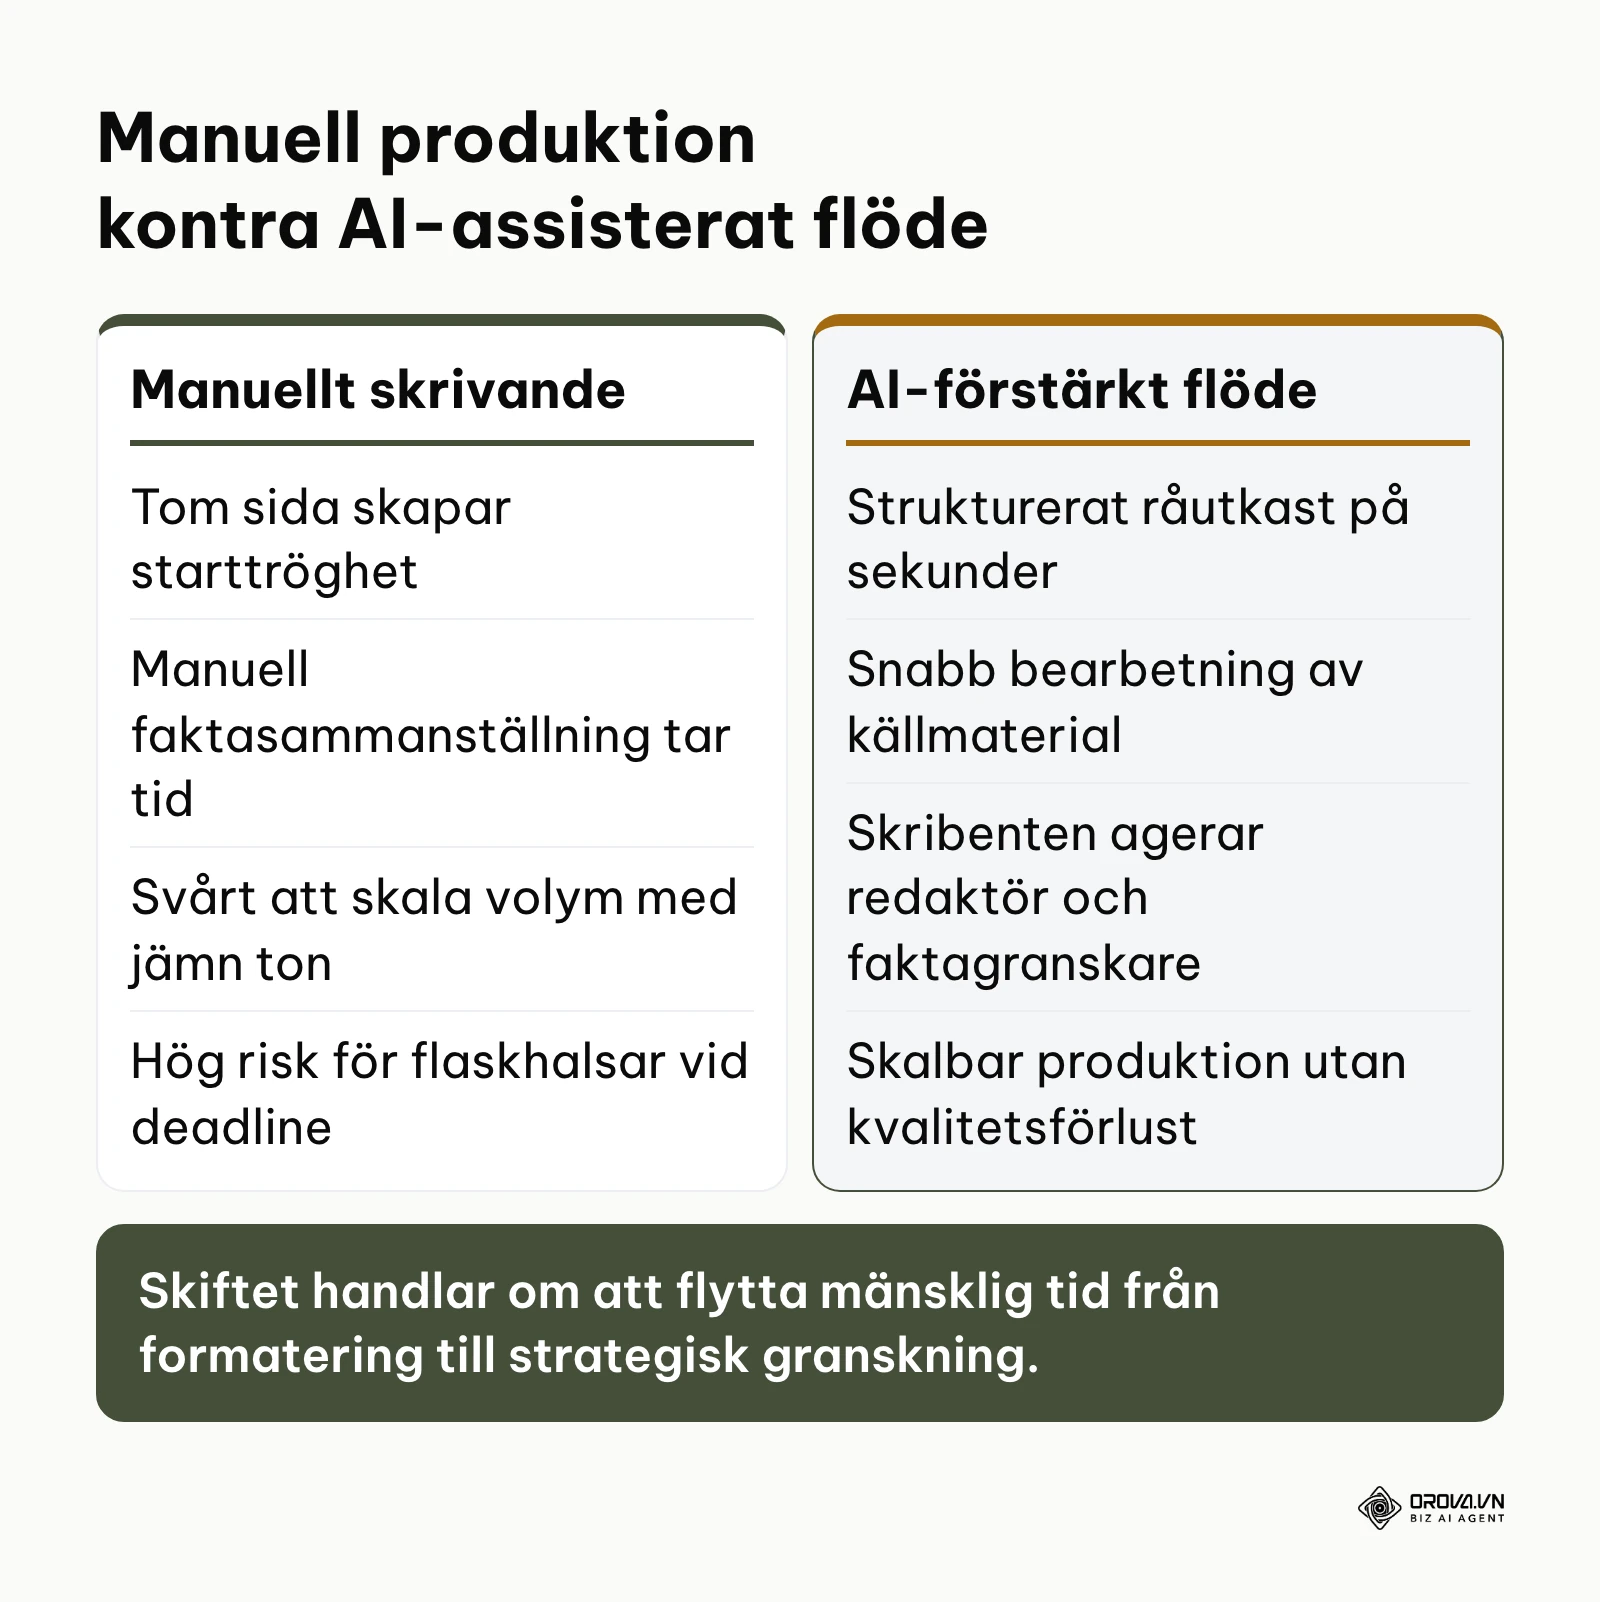
I ett större organisatoriskt sammanhang placerar sig textgeneratorn mitt i produktionsledet. Före generatorn krävs alltid strategisk planering, målgruppsanalys och insamling av källmaterial. Efter generatorn krävs redaktörsarbete, faktagranskning, formatering och teknisk publicering. AI-verktyget ersätter alltså inte hela kommunikationsprocessen, utan fungerar som en katalysator i det mest tidskrävande momentet, nämligen själva utkastfasen.
Om en verksamhet helt ignorerar dessa verktyg uppstår ofta allvarliga flaskhalsar. Skribenter fastnar framför tomma dokument, lanseringar försenas i väntan på produkttexter och kostnaden per producerat ord skenar. Att manuellt formulera hundratals varianter av en metabeskrivning eller anpassa en grundtext för tre olika målgrupper är varken ekonomiskt eller intellektuellt stimulerande för en mänsklig specialist. Söker du inspiration för att distribuera ditt material effektivt kan du läsa vår guide om att bygga en hållbar strategi för sociala medier.
När du inte behöver en AI-textgenerator: Det finns situationer där tekniken gör mer skada än nytta. För det första bör du undvika automatiserad textgenerering vid juridiska avtal eller medicinska råd där minsta faktafel medför allvarliga konsekvenser. För det andra är tekniken olämplig för unika grävande journalistiska reportage som bygger på slutna källor och fysiska intervjuer. Slutligen är det slöseri med resurser att koppla på avancerade språkmodeller för enkla standardsvar som enkelt hanteras med statiska mallar. I dessa lägen är manuellt skrivande och expertgranskning oersättligt.
Följande sammanställning förtydligar när automatiserad textgenerering bör undvikas och vilken metod som i stället krävs:
| Situation | Varför AI-textgenerator inte bör användas | Rekommenderad manuell metod |
|---|---|---|
| Juridiska avtal och regelefterlevnad | Risk för felaktiga villkor och allvarliga juridiska följder | Granskning av erfaren bolagsjurist |
| Grävande och undersökande journalistik | Saknar tillgång till fysiska intervjuer och slutna källor | Mänskligt journalistiskt fältarbete |
| Medicinska och kliniska råd | Hallucinationer medför allvarliga hälsorisker | Legitimerad expert med manuell faktakontroll |
| Enkla standardiserade bekräftelser | Onödigt resurskrävande och komplex drift | Regelbaserade mallar utan språkmodeller |
Affärsnytta och praktiska fördelar med automatiserat skrivande
Att integrera en AI-textgenerator handlar i grunden om att omfördela resurser. När ett företag flyttar fokus från mekanisk tangentbordsknappning till strategisk styrning uppstår konkreta fördelar på två distinkta nivåer: affärsledningen och det operativa teamet.
Affärsnytta: minskade kostnader och kontrollerad risk
För företagsledningen innebär tekniken att tröskeln för innehållsproduktion sänks dramatiskt. Den ekonomiska vinsten uppstår inte genom att avskeda skribenter, utan genom att samma personalstyrka kan producera ett mångdubbelt värde utan att gå in i väggen.
Tidigare innebar en expansion till nya marknader eller lansering av en ny produktkategori att dussintals frilansare behövde briefas, vilket skapade stora fasta kostnader och långa ledtider. Med automatiserade system kan grundläggande produktinformation och informationsartiklar tas fram på en bråkdel av tiden. Risken för ojämn språklig kvalitet minskar dessutom när systemet styrs av tydliga mallar och tonalitetsregler.
Operativ nytta: eliminering av skrivkramp och monotoni
För skribenten, marknadsföraren eller redaktören innebär verktyget en dramatisk förbättring av den dagliga arbetsmiljön. Den mest krävande delen av skrivprocessen är ofta att ta sig från ett tomt dokument till ett fungerande första utkast.
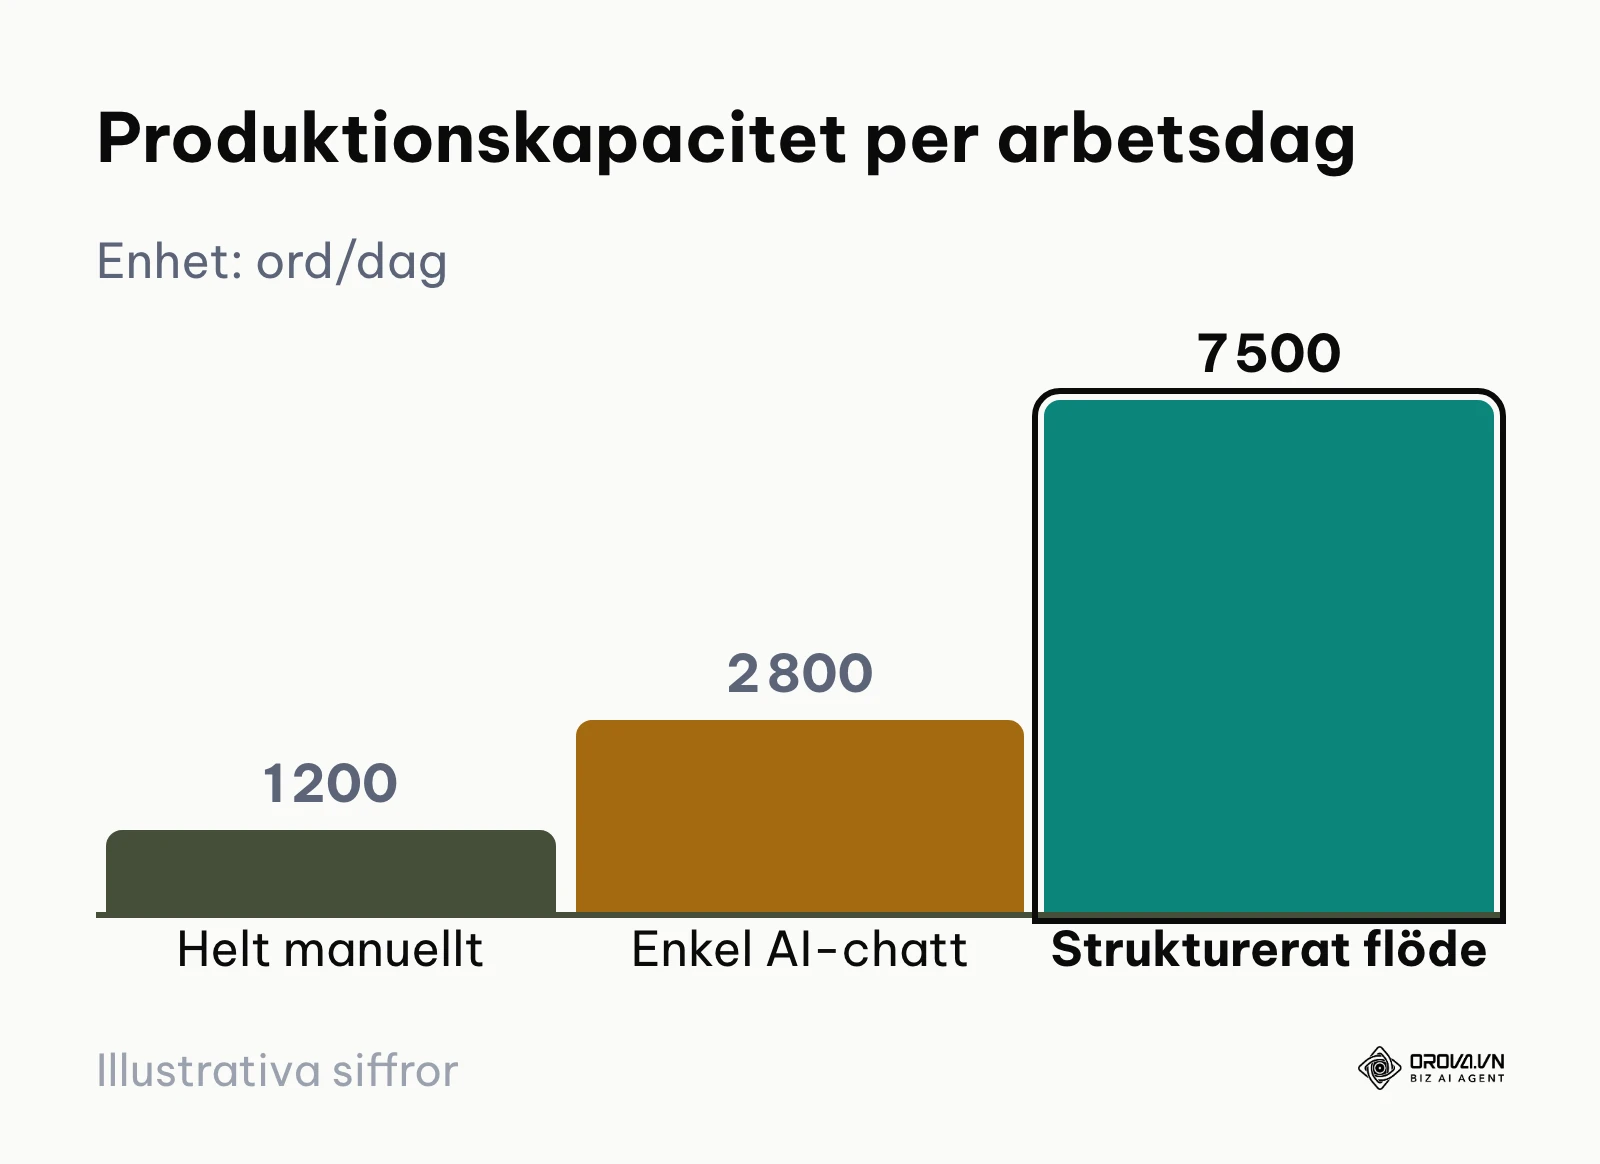
När AI genererar en sammanhängande stomme utifrån stödord kan den mänskliga experten direkt kliva in i rollen som redaktör. Arbetet handlar då om att förädla resonemang, tillföra unika erfarenheter, kontrollera fakta och vässa formuleringar. Detta skifte minskar den mentala tröttheten och gör det möjligt att lägga mer energi på kvalificerad analys och kreativ vinkling. Detta blir särskilt tydligt när teamet behöver skriva nyhetsbrev som engagerar läsarna med hög frekvens.
Illustrerande exempel:
- Bakgrund: Ett svenskt B2B-företag med tre anställda inom marknadsföring behövde producera 40 djupgående kunskapsartiklar inför en nylansering av sin mjukvara.
- Genomförda steg: Teamet tog fram en fast artikelmall med sju obligatoriska rubriker, matade in teknisk dokumentation som källfiler och lät en textgenerator skapa fullständiga råutkast sektion för sektion.
- Hinder och lösning: De första utkasten saknade branschspecifik jargong och kändes opersonliga. Lösningen blev att införa en lista med 15 förbjudna klyschor samt instruera modellen att alltid inkludera konkreta exempel för varje teoretiskt påstående.
- Observerbart resultat: Företaget kunde publicera alla 40 artiklarna inom loppet av fem veckor med samma redaktionella team, samtidigt som artiklarna började ranka på relevanta branschfrågor i sökmotorerna.
Följande tabell visar hur organisationer mäter effekten av att implementera textgeneratorer i sitt arbete.
| Affärs- eller arbetsfördel | Primärt mätetal | Förväntad tidsram för mätbart resultat |
|---|---|---|
| Minskad ledtid per artikel | Timmar från idé till färdigt utkast | Direkt synligt vid första produktionscykeln |
| Högre publiceringstakt | Antal publicerade artiklar per månad | Mätbart inom 30 till 60 dagar |
| Bredare sökordsräckvidd | Antal indexerade sidor i organiskt sök | Tydligt mätbart efter 3 till 6 månader |
| Lägre produktionskostnad per enhet | Extern frilanskostnad per tusen ord | Synligt i månadsbokslutet efter 60 dagar |
När du förstår hur språkmodeller väljer ord blir det uppenbart varför enkla chattverktyg inte räcker för sammanhängande artiklar. Orova SEO automatiserar flerstegsskrivning upp till 20 000 ord, hämtar fakta från dina Drive-filer och strukturerar interna länkar direkt mot din WordPress-webbplats.
Hur fungerar en ai-textgenerator under huven?
För att behärska tekniken fullt ut måste vi lyfta på motorhuven och titta på de matematiska och arkitektoniska komponenterna. En AI-textgenerator tänker inte, känner ingenting och har ingen konceptuell förståelse för världen. Den är en avancerad statistisk maskin som beräknar mönster i gigantiska talmatriser.
Tokenisering: hur ord omvandlas till matematiska vektorer
Datorer kan inte läsa bokstäver eller förstå ord i textform. Det första steget i varje textgenerator är därför att bryta ned inkommande text i mindre beståndsdelar som kallas tokens.
- Vad den gör: Den delar upp ord och meningar i standardiserade teckenkombinationer och tilldelar varje del ett unikt numeriskt ID. På svenska motsvarar ett token ofta ett vanligt ord, en ordstam eller ett prefix/suffix.
- Indata: Rå textsträng från användarens prompt eller källmaterial.
- Utdata: En sekvens av heltal, där varje tal representerar ett specifikt token i modellens ordförråd.
- Vanliga felkällor: Ovanliga språk eller sammansatta ord delas upp i oproportionerligt många små tokens. Detta kan leda till stavfel, förvanskade böjningsformer eller att modellens minneskapacitet förbrukas mycket snabbare än vid engelsk text.
När ett token har fått sitt ID slås det upp i en så kallad inbäddningsmatris, engelskans embedding matrix. Här representeras varje token som en vektor, det vill säga en lång lista med decimaltal som beskriver ordets matematiska relation till alla andra ord i vokabulären. Ord som "kung" och "drottning" hamnar mycket nära varandra i detta flerdimensionella rum, vilket gör att modellen kan räkna på semantiska likheter med ren geometri.
Transformatormodeller och självuppmärksamhet (self-attention)
Enligt forskningsrapporten Attention Is All You Need från Google Research (2017) bygger hela den moderna vågen av textgeneratorer på transformerarkitekturen och dess mekanism för självuppmärksamhet. Detta var det avgörande genombrottet som gjorde det möjligt att bearbeta hela textstycken parallellt i stället för att läsa ett ord i taget. Schemat nedan sammanfattar denna process.
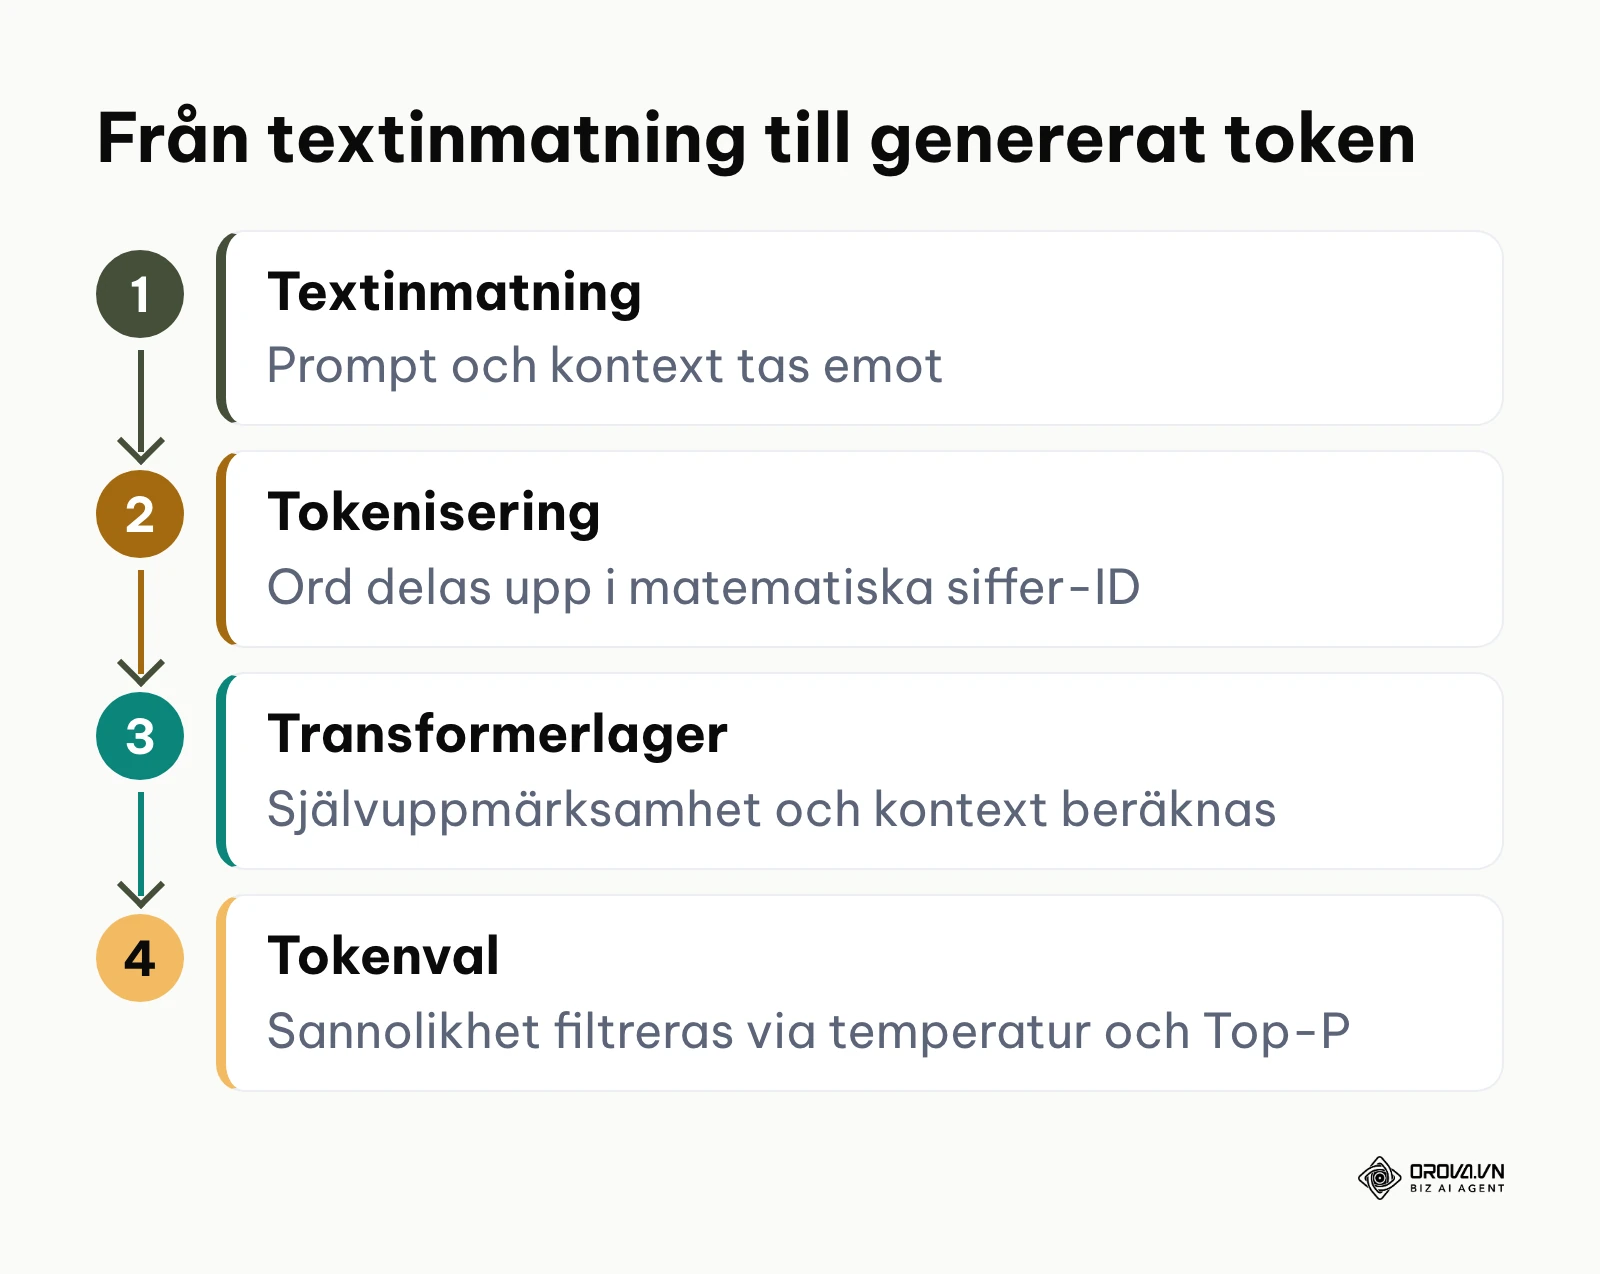
- Vad den gör: Självuppmärksamhetsmekanismen, self-attention, låter modellen analysera relationen mellan varje ord i texten och alla andra ord i samma sammanhang, oavsett hur långt ifrån varandra de står i meningen.
- Indata: En sekvens av inbäddade tokenvektorer samt information om deras inbördes position i texten.
- Utdata: Uppdaterade vektorer där varje ords matematiska representation har färgats av det omgivande sammanhanget.
- Vanliga felkällor: Om meningen innehåller tvetydiga pronomen eller syftningar kan mekanismen väga fel ord starkast, vilket gör att texten tappar logisk koppling till det ursprungliga subjektet.
Om du matar in meningen "Banken nekade lånet eftersom företaget saknade säkerhet" förstår transformatorn att ordet "banken" här syftar på ett finansiellt institut och inte en sittbänk i en park, eftersom vikterna mot "lånet" och "företaget" är matematiskt dominerande i just denna kontext.
Sannolikhetskalkyler och val av nästa token
När transformatorn har bearbetat hela textsekvensen landar den i ett enda delmål: att beräkna sannolikheten för vilket token som borde komma härnäst. Detta kallas för prediktion av nästa token, eller next-token prediction.
Modellen spottar inte bara ur sig ett ord. Den genererar en lista över hela sitt ordförråd, ofta över 50 000 till 100 000 unika tokens, där varje enskilt alternativ tilldelas en sannolikhetsprocent baserad på träningsdatan. Det är här parametrarna Temperature och Top-P kliver in för att avgöra vilket ord som faktiskt väljs.
- Temperature: Ett matematiskt värde som skalar sannolikhetsfördelningen. Ett lågt värde, exempelvis 0,2, gör de mest sannolika orden ännu mer dominanta, vilket resulterar i en förutsägbar och formell text. Ett högt värde, exempelvis 0,8 eller högre, jämnar ut skillnaderna och ger mer oväntade ordval och kreativ variation.
- Top-P (Nucleus Sampling): En tröskel som skär av svansen av osannolika ord. Om Top-P sätts till 0,9 väljer modellen endast bland de mest troliga orden vars sammanlagda sannolikhet når upp till 90 procent, medan resterande 10 procent helt utesluts.
För att illustrera hur detta fungerar i praktiken kan vi titta på ett konkret matematiskt exempel. Antag att modellen har bearbetat den ofullständiga svenska meningen: "Sveriges huvudstad är känd för..."
I tabellen nedan ser vi fyra kandidat-tokens och hur deras urvalssannolikhet förändras radikalt beroende på om temperaturen är inställd på strikt fakta (0,2) eller kreativ variation (0,8).
| Kandidat-token | Ursprunglig sannolikhet | Beräknad sannolikhet vid Temp = 0,2 | Beräknad sannolikhet vid Temp = 0,8 | Typiskt användningsområde |
|---|---|---|---|---|
| sin | 48,0 % | 86,4 % | 41,2 % | Formell och förutsägbar sakprosa |
| sina | 31,0 % | 12,8 % | 30,5 % | Grammatisk standardvariation |
| vackra | 14,0 % | 0,8 % | 18,6 % | Beskrivande och engagerande bloggtext |
| innovativa | 7,0 % | 0,0 % | 9,7 % | Kreativ marknadsföringstext |
Vid en temperatur på 0,2 väljer generatorn nästan garanterat ordet "sin" (86,4 procents sannolikhet). Texten blir stringent och logisk, men riskerar att upplevas som torr vid längre stycken. Vid en temperatur på 0,8 får adjektiv som "vackra" och "innovativa" en reell chans att väljas, vilket skapar ett mer levande språk men samtidigt ökar risken för stilistiska snedsteg.
Arkitekturval för textgenerering: Pure LLM, RAG och flerstegs-agenter
Många användare förutsätter att all AI-text skapas på samma sätt, men i modern mjukvaruutveckling skiljer man tydligt på tre olika generationer av arkitektur. Valet av arkitektur avgör om texten blir ytlig och full av faktafel eller djupgående och pålitlig.
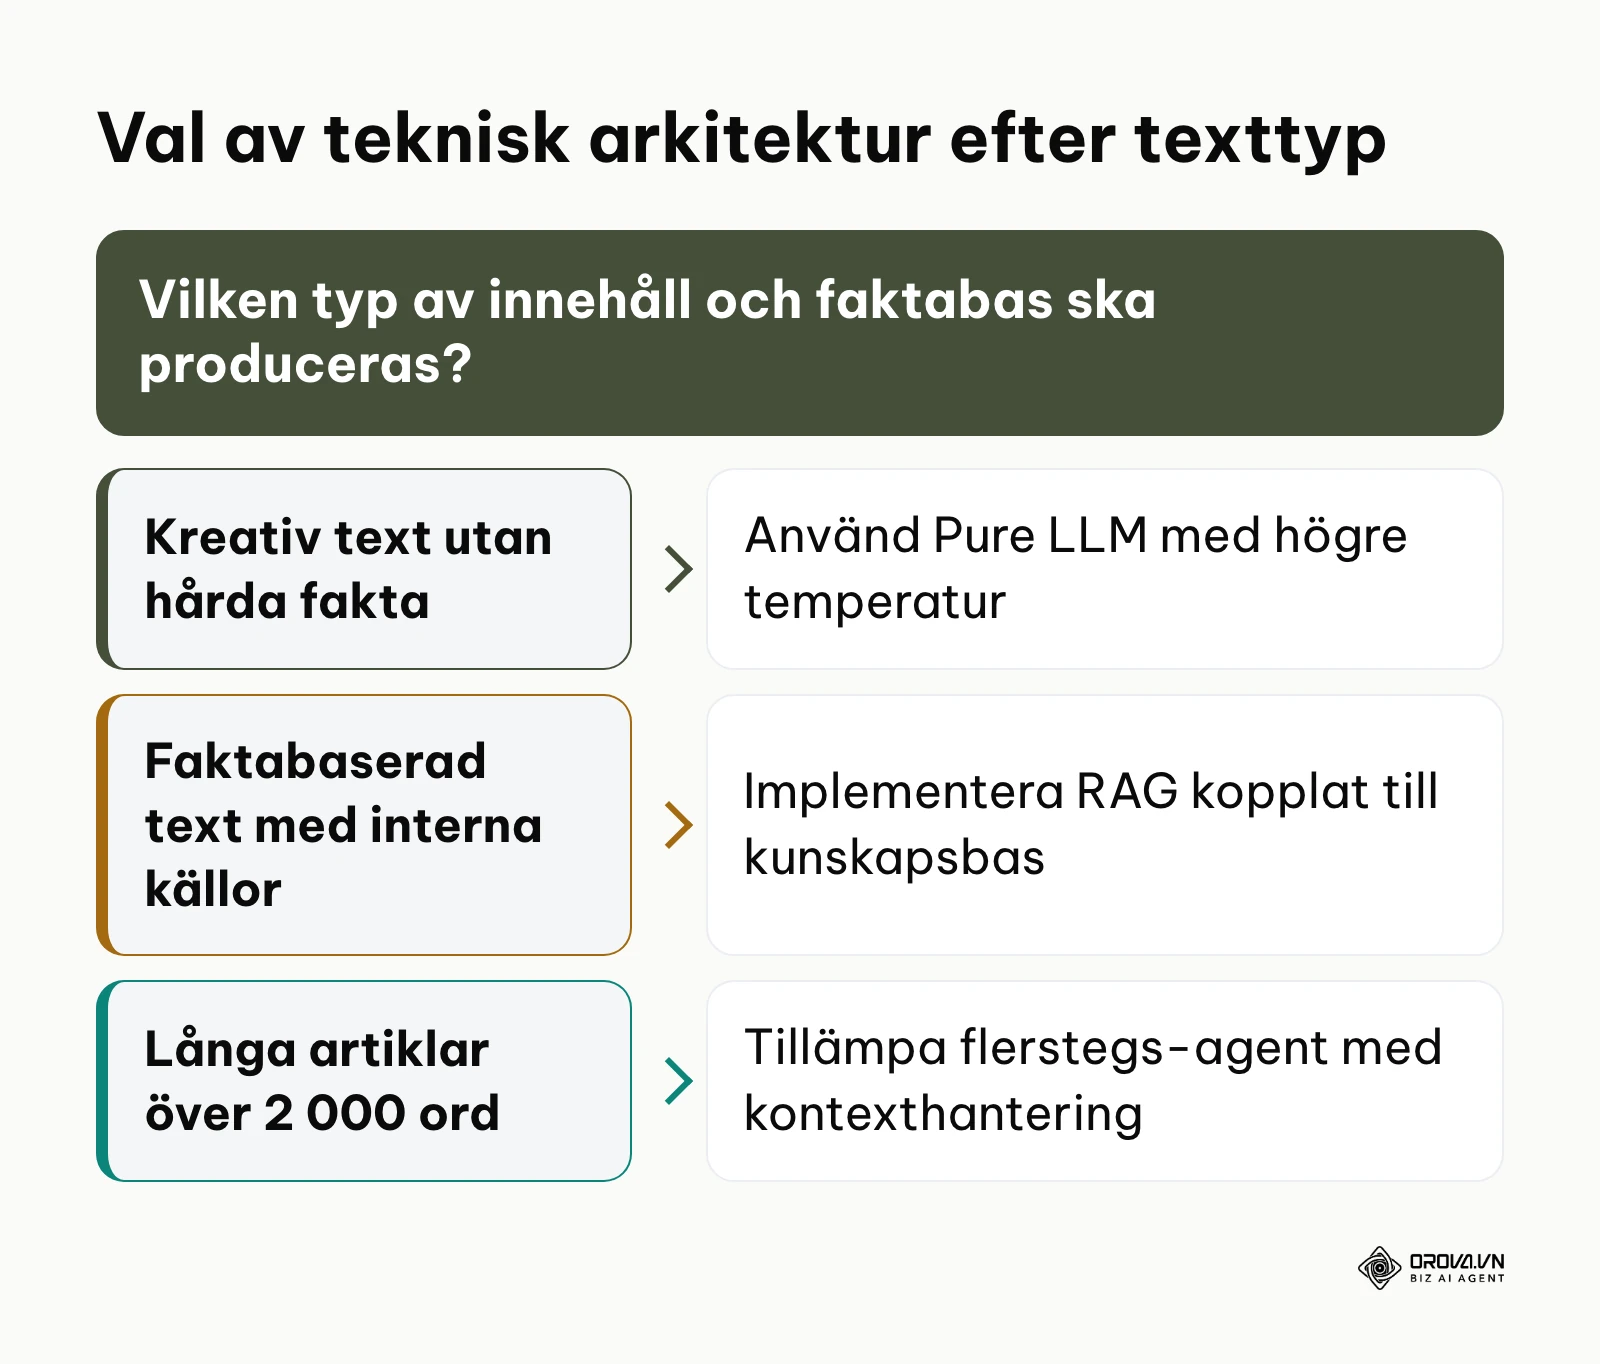
- Pure LLM (Ren språkmodell): Modellen får en instruktion och genererar svar enbart baserat på den kunskap som finns inkodad i dess förtränade parametrar. Detta fungerar utmärkt för översättning, omformuleringar och fria kreativa texter.
- RAG (Retrieval-Augmented Generation): Modellen kopplas samman med en extern sökmotor eller databas. Innan texten genereras söker systemet upp relevanta dokument, exempelvis interna PDF-filer eller webbsidor, och skickar med dem som faktaunderlag i prompten.
- Flerstegs-agenter (Multi-turn Agent): I stället för att försöka generera en hel text i ett enda svep bryter en agent ned uppgiften i diskreta delmoment. Den skapar först en disposition, granskar sin egen plan, hämtar underlag för sektion ett, genererar texten, sparar sammanhanget och går därefter vidare till sektion två.
Följande jämförelse belyser de tekniska skillnaderna mellan dessa tre metoder:
| Kriterium | Pure LLM (Fristående modell) | RAG (Källförankrad generering) | Flerstegs-agent (Multi-turn Agent) |
|---|---|---|---|
| Maximal textlängd utan kvalitetsförlust | 600 till 1 200 ord | 1 000 till 2 500 ord | Upp till 20 000 ord i sekvens |
| Risk för faktamässiga hallucinationer | Hög (modellen gissar vid osäkerhet) | Mycket låg (svar förankras i källor) | Låg till mycket låg (delsteg verifieras) |
| Förmåga att följa komplex disposition | Medelgod (tappar ofta slutet) | God (följer tillgängligt underlag) | Exceptionell (varje sektion styrs separat) |
| Resurs- och tokenförbrukning | Låg (en enda API-förfrågan) | Medelhög (sökning plus kontext) | Hög (många iterativa anrop) |
| Automatiseringsgrad vid SEO-produktion | Låg (kräver manuell styrning i chatt) | Medelgod (bra för faktabaserade svar) | Mycket hög (kan skriva, länka och publicera) |
Enligt GPT-4 Technical Report från OpenAI (2023) minskar risken för hallucinationer markant när modellen förses med extern kontext och förankrad källdata snarare än att enbart förlita sig på parametrarnas förtränade vikter. När du bygger storskaligt innehåll är RAG och agentarkitekturer därför den enda hållbara vägen framåt.
Långformatsgenerering och kontextfönster över 2 000 ord
Ett av de vanligaste problemen som skribenter möter är att en AI-textgenerator plötsligt börjar upprepa sig själv, tappar tråden eller klipper av en mening mitt i ett stycke när texten överstiger 1 500 ord. Detta beror på hur modellens kontextfönster, context window, fungerar.
Kontextfönstret är det maximala antalet tokens som modellen kan hålla i sitt aktiva arbetsminne under en beräkning. Även om moderna modeller har mycket stora fönster, fungerar uppmärksamhetsmekanismen sämre när mängden data växer. Ju längre texten blir, desto mer "utspädd" blir uppmärksamheten på de inledande instruktionerna.
För att producera djupgående artiklar på 2 000 till 5 000 ord utan avbrott krävs en teknik som kallas blockindelning, eller chunking, i kombination med flerstegsgenerering.
Illustrerande exempel:
- Bakgrund: En digital redaktör ville producera en komplett teknisk köpguide på 3 500 ord om molnbaserade affärssystem utan att texten blev repetitiv.
- Genomförda steg: Redaktören lät systemet skapa en detaljerad disposition med sju huvudrubriker. Därefter kördes sju separata genereringsrundor där varje runda enbart matades med dispositionen, föregående sektions avslutande sammanfattning samt källfakta för den aktuella rubriken.
- Hinder och lösning: I runda fyra började generatorn återanvända samma inledningsfras som i runda ett. Detta löstes genom att lägga till ett dynamiskt minnesfilter som explicit förbjöd de 20 senaste meningarna från att återanvändas strukturellt.
- Observerbart resultat: Artikeln levererades med en röd tråd genom samtliga 3 500 ord, fullständig källförankring i varje kapitel och utan en enda upprepad ingressformulering.
Hur du anpassar ditt arbetsflöde och implementerar tekniken
För att lyckas med AI-genererad text räcker det inte att förstå matematiken; du måste etablera en fungerande vardagsrutin i din organisation. Olika roller har helt skilda behov och förutsättningar vid implementeringen.
Småföretagare och entreprenörer
Som småföretagare är din tid den absolut mest begränsade resursen. Du behöver verktyg som snabbt producerar användbart material utan att kräva avancerad kodning.
- Kartlägg dina vanligaste kundfrågor: Samla de tio frågor du oftast får via e-post eller telefon. Detta utgör din första faktabas.
- Skapa en tydlig företagsprofil: Skriv ett dokument på en halv A4-sida som beskriver er verksamhet, era kärnvärden och hur ni vill tilltala kunden. Detta dokument bifogas som instruktion vid varje generering.
- Börja med korta format i veckan: Testa att låta verktyget formulera svar på kundfrågor eller författa korta produktbeskrivningar innan du ger dig på stora artiklar.
- Granska alltid fakta före publicering: Läs igenom texten med kritiska ögon för att säkerställa att priser, leveranstider och garantier stämmer till hundra procent.
Innehållsansvariga och SEO-specialister
För dig som ansvarar för organisk synlighet handlar det om att integrera textgeneratorn i en bredare publiceringsstrategi där struktur, sökintention och teknisk optimering samverkar.
- Identifiera sökordsluckor: Använd dina befintliga analysverktyg för att hitta söktermer där din webbplats redan har viss synlighet men saknar heltäckande artiklar. Ett utmärkt sätt att hitta dessa möjligheter är att analysera sökdata i Google Search Console.
- Bygg modulära artikeldispositioner: Skapa mallar som specificerar var H2- och H3-rubriker ska placeras, vilka frågor som måste besvaras och var interna länkar ska vävas in.
- Mata modellen med rådata: Låt aldrig generatorn hitta på fakta fritt. Förse den med interna rapporter, produktblad eller transkriberade intervjuer som underlag.
- Säkerställ länkstruktur och spårning: Integrera relevanta interna länkar och se till att spåra kampanjer med UTM-länkar när innehållet distribueras vidare.
Marknadsföringsbyråer och digitala konsulter
Byråer hanterar många olika varumärken parallellt och måste kunna garantera att varje kund behåller sin unika röst utan att arbetet blir olönsamt.
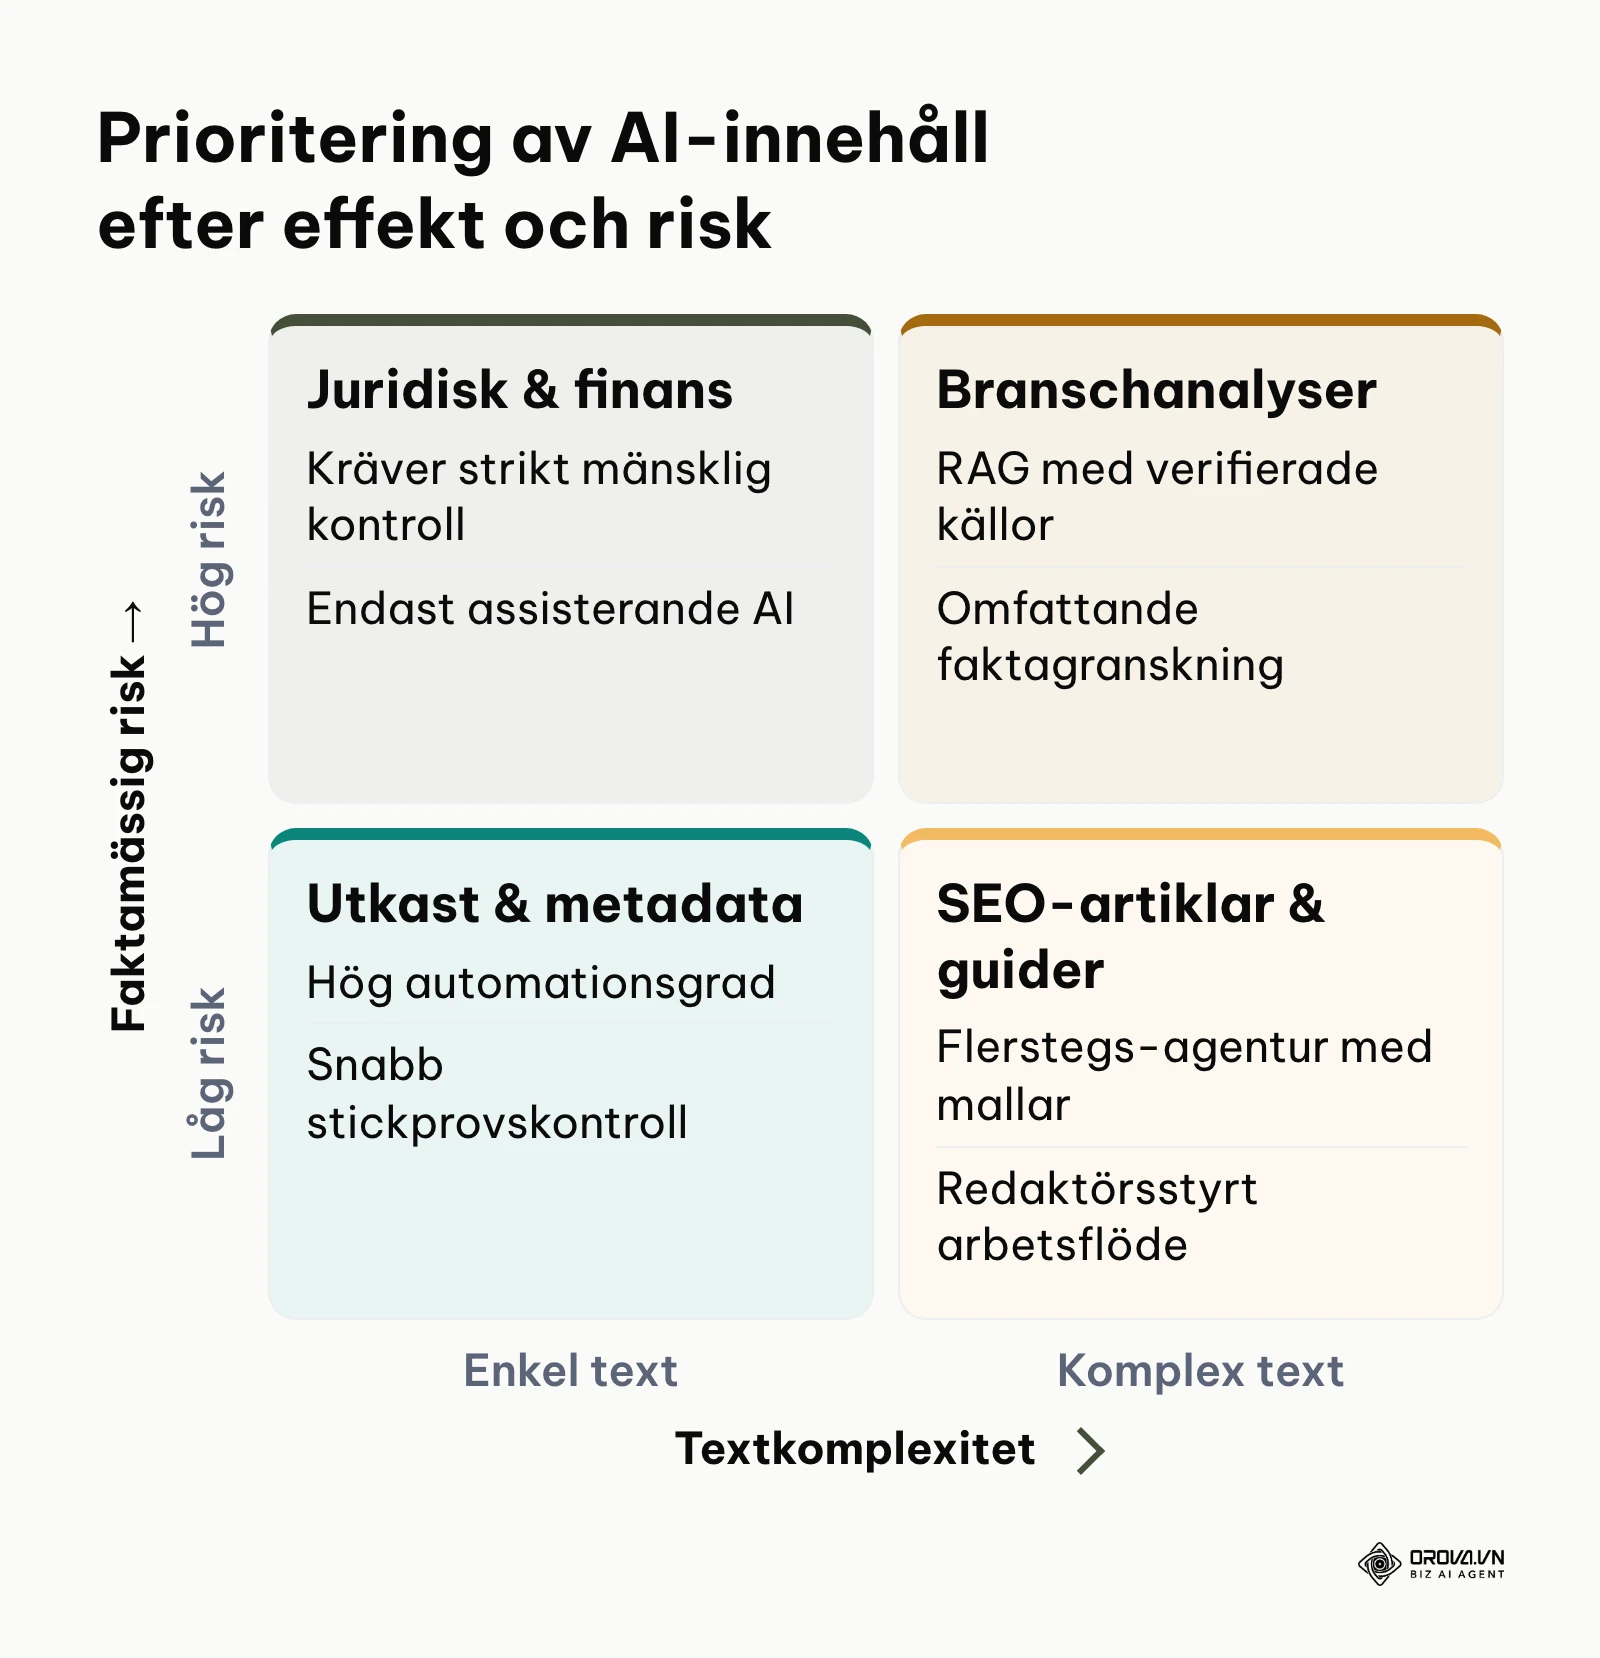
- Etablera separata varumärkesprofiler: Bygg ett system där varje kunds specifika tonalitet, förbjudna ord och stilregler sparas i separata konfigurationer.
- Standardisera granskningsprocessen: Utbilda juniora skribenter i faktagranskning och redaktörskap i stället för att låta dem skriva all råtext för hand.
- Automatisera överföringen till kundens webbplats: Koppla ihop produktionsverktyget med kundernas publiceringssystem via säkra API:er eller applikationslösenord för att eliminera manuellt klipp-och-klistra-arbete.
- Mät tidsåtgången per projekt: Säkerställ att tidsvinsten faktiskt realiseras och att den frigjorda tiden investeras i djupare kundanalys och strategisk rådgivning.
Att arbeta med textgeneratorer innebär också att man måste undvika vissa klassiska fallgropar. Tabellen nedan listar de vanligaste misstagen och hur de motverkas.
| Vanligt misstag | Direkt konsekvens | Hur du undviker det i praktiken |
|---|---|---|
| Publicera råutkast utan granskning | Faktafel och hallucinationer skadar varumärkets trovärdighet | Inför ett obligatoriskt steg där en människa signerar texten |
| Generiska och intetsägande prompter | Texten blir platt, klyschig och liknar tusentals andra artiklar | Ange alltid målgrupp, önskad längd, struktur och bifoga unika källfakta |
| Överdriven användning av hög temperatur | Texten svävar iväg från ämnet och tappar sin logiska stringens | Justera ned temperaturen till mellan 0,2 och 0,4 vid saklig information |
| Ignorera källförankring (RAG) | Modellen fyller kunskapsluckor med statistiskt sannolika påhitt | Ladda upp faktadokument och instruera modellen att enbart använda dessa |
Teknisk checklista i 7 steg för kvalitetsgranskning mot hallucinationer
I ramverket Artificial Intelligence Risk Management Framework (AI RMF 1.0) från National Institute of Standards and Technology (NIST, 2023) betonas vikten av spårbarhet och mänsklig verifiering vid automatiserad textframställning. Följande checklista är utformad för att fånga upp felaktigheter innan texten laddas upp i ditt innehållshanteringssystem (CMS):
- Siffer- och dataverifiering: Kontrollera varje enskilt årtal, procenttal, valutabelopp och statistiskt påstående mot en extern, pålitlig primärkälla.
- Namn och titlar: Verifiera att alla nämnda personer, organisationer, boktitlar och produktnamn faktiskt existerar och stavas korrekt.
- Rubrikernas logiska samband: Granska att H2- och H3-rubrikerna bildar en röd tråd som direkt besvarar sökintentionen utan att upprepa samma poäng med andra ord.
- Undersökning av källhänvisningar: Om texten refererar till en rapport eller studie, säkerställ att den citerade organisationen faktiskt har publicerat dokumentet och att slutsatsen inte förvanskats.
- Kontroll av interna länkankare: Säkerställ att ord och fraser som valts för internlänkning är relevanta för målsidan och flyter naturligt i meningsbyggnaden.
- Eliminering av AI-klyschor: Rensa bort återkommande modeord och floskler som "i dagens snabbrörliga värld", "dyk djupare", "en revolutionerande spelväxlare" eller "sammanfattningsvis".
- Flödes- och tonkontroll: Läs texten högt för att upptäcka styltiga meningsbyggnader, onödigt långa bisatser eller monotona styckelängder.
För team som vill skala upp sin produktion erbjuder Orova SEO en integrerad miljö som löser flera av dessa tekniska hinder. Modellen hanterar flerstegsgenerering i upp till 20 omgångar för att skapa artiklar på upp till 20 000 ord utan avbrott, med automatisk generering av metabeskrivningar på 140 till 160 tecken och internlänkar. Genom att koppla upp till fem Google Drive-dokument per artikel och aktivera webbsökning förankras informationen i faktiska källor. Systemet stödjer 50 språk och upp till 50 unika varumärkesröster per projekt, med direkt publicering till WordPress via säkra applikationslösenord.
Vill du gå från manuell promptning till en automatiserad innehållsmotor som publicerar färdiga artiklar med bilder och metabeskrivningar? Med Orova SEO kopplar du upp din sajt via säkra applikationslösenord på några minuter. Alla funktioner är kostnadsfritt fram till den 7 juli 2027.
Trender för AI-textgeneratorer fram till 2028: författarens analys
Utvecklingen inom språkteknologi rör sig i en rasande takt. I skrivande stund, fram till 2026, har vi sett hur basmodellerna blivit standardiserade råvaror och hur fokus förskjutits mot källintegration och specialiserade flöden. Här är min personliga analys av vart tekniken är på väg de kommande åren.
Följande översikt sammanfattar de tre mest avgörande trendskiftena och hur företag bör förbereda sina arbetsflöden:
| Trend fram till 2028 | Drivkraft bakom skiftet | Konkret rekommendation för företag |
|---|---|---|
| Osynliga bakgrundsmotorer | API-agenter automatiserar datainsamling och textutkast | Strukturera intern företagsdata så att den är maskinläsbar via öppna API:er |
| Fokus på unika erfarenheter | Sökmotorer premierar förstahandskällor framför generisk text | Dokumentera och publicera unika kundcase och interna mätresultat |
| Kompakta, lokala språkmodeller | Lägre driftskostnader och högre dataintegritet | Undvik att låsa innehållsstrategin till en enda molnleverantör |
Skiftet från fristående chattfönster till osynliga bakgrundsmotorer
Dagens arbetssätt, där skribenter sitter och matar in instruktioner i ett fristående chattfönster, är enligt min mening en övergångsfas. Tecknen syns redan tydligt i hur API-anrop och automatiserade agenter tar över rutinmässig innehållsproduktion.
Jag anser att textgeneratorer inom två till tre år kommer att vara helt osynliga komponenter i företagets affärssystem. I stället för att en människa ber om en artikel kommer systemet självt att identifiera en förändring i lagerstatus, en uppdatering i en produktdatabas eller en ny söktrend, och därefter självständigt generera, optimera och förbereda utkastet för publicering. Det som skulle kunna fördröja denna utveckling är om regelverk kring upphovsrätt eller dataskydd skärps så kraftigt att automatisk bearbetning begränsas juridiskt. Förbered dig redan nu genom att strukturera din interna data så att den är maskinläsbar via API:er.
Slutet för generisk volym-SEO och återkomsten för unika erfarenheter
När kostnaden för att generera en acceptabel text sjunker mot noll översvämmas internet av identiskt, omformulerat material. Sökmotorerna svarar redan på detta genom att förändra sina algoritmer till förmån för förstahandserfarenheter och unika insikter.
Enligt mig kommer ren sammanställningstext helt att förlora sitt organiska värde före 2028. De textgeneratorer som överlever i marknadsföringssammanhang är de som kan matas med proprietär data: interna försäljningssiffror, unika kundfall och proprietära expertintervjuer. Om du bara ber en modell att skriva om det som redan står på de tio bäst rankade sidorna på Google bygger du ett digitalt korthus. Det som skulle kunna motbevisa min tes är om sökmotorernas förmåga att sålla bort generiskt material kollapsar under trycket från syntetisk text, men historien visar att kvalitetsfilter förr eller senare segrar. Din viktigaste åtgärd idag är att börja samla och dokumentera unika kundupplevelser som ingen extern part kan efterlikna.
Små, lokala modeller utmanar de gigantiska molnjättarna
Vi ser idag en tydlig trend mot mer effektiva, specialiserade språkmodeller som kan köras lokalt på vanlig hårdvara i stället för i gigantiska datacenter.
Jag förutspår att många företag fram till 2028 kommer att överge de största allmänna modellerna till förmån för kompakta, lokalt tränade modeller som enbart behärskar företagets specifika bransch och interna terminologi. Detta löser inte bara integritetsfrågor och minskar beroendet av externa leverantörer, utan minskar också driftskostnaderna drastiskt. Skulle utvecklingen av specialiserade AI-chip stanna av kan molnjättarna behålla sitt försprång längre, men den tekniska trenden pekar mot decentralisering. Företag bör därför säkerställa att deras innehållsstrategi inte är låst till en enda proprietär leverantör.
Vanliga frågor om hur en ai-textgenerator fungerar
Vad är skillnaden mellan en token och ett vanligt ord?
Ett token är inte alltid ett helt ord, utan en matematisk teckenkombination som modellen använder som grundenhet. På engelska motsvarar ett token ungefär fyra bokstäver eller 0,75 ord. På mindre språk som svenska delas sammansatta ord ofta upp i flera tokens, vilket innebär att ordet "webbplatsoptimering" kan brytas ned i tre eller fyra separata delar med unika ID-nummer.
Varför hittar AI-textgeneratorer ibland på falska fakta?
Detta fenomen kallas hallucination och beror på att modellen inte har en databas med sanningar, utan beräknar vad som är språkligt och statistiskt rimligt att skriva härnäst. Om modellen saknar specifik kunskap om ett ämne väljer den ord som låter övertygande och grammatiskt korrekta utifrån sammanhanget, även om faktainnehållet är helt felaktigt.
Behövs mänskliga skribenter fortfarande när AI-textgeneratorer finns?
Ja, men skribentens yrkesroll förändras från mekanisk formulering till redaktionell styrning, faktagranskning och strategiskt tänkande. AI-modeller saknar personliga erfarenheter, moralisk kompass och förmåga att göra självständiga journalistiska undersökningar. Den mänskliga skribenten behövs för att säkerställa att texten är sann, relevant och anpassad efter verkliga människors behov.
Hur påverkar parametern Temperature textens kvalitet?
Temperaturen styr hur strikt modellen håller sig till de mest statistiskt sannolika orden. Ett lågt värde mellan 0,1 och 0,3 ger mycket fokuserade, logiska och förutsägbara texter som passar för teknisk dokumentation. Ett högre värde mellan 0,7 och 0,9 ökar ordförrådets variation och kreativitet, men ökar också risken för att texten tappar fokus eller innehåller sakfel.
Kan sökmotorer som Google identifiera och straffa AI-genererad text?
Sökmotorer fokuserar primärt på textens kvalitet, hjälpsamhet och användarnytta snarare än vilken metod som använts för att framställa den. Däremot straffas texter som är tunna, saknar mervärde, är fulla av faktafel eller uppenbart skapats enbart för att manipulera sökresultat. Automatiserat innehåll som berikats med unika källor och redigerats noggrant fungerar utmärkt i sökresultaten.
Vad innebär RAG och varför är det viktigt för innehållsskapare?
RAG står för Retrieval-Augmented Generation och är en teknik där språkmodellen kopplas ihop med externa kunskapskällor. I stället för att enbart lita på modellens inbyggda minne hämtar systemet relevanta stycken från uppladdade filer eller webbsidor och skickar med dem som underlag i beräkningen. Detta minimerar risken för faktafel och gör det möjligt att skriva om helt färska ämnen.
Var ska du börja?
Att börja använda en AI-textgenerator på ett strukturerat sätt kräver inte att du bygger om hela din digitala infrastruktur över en natt. Beroende på var din verksamhet befinner sig idag kan du ta ett första, konkret steg redan under din nästa arbetsdag.
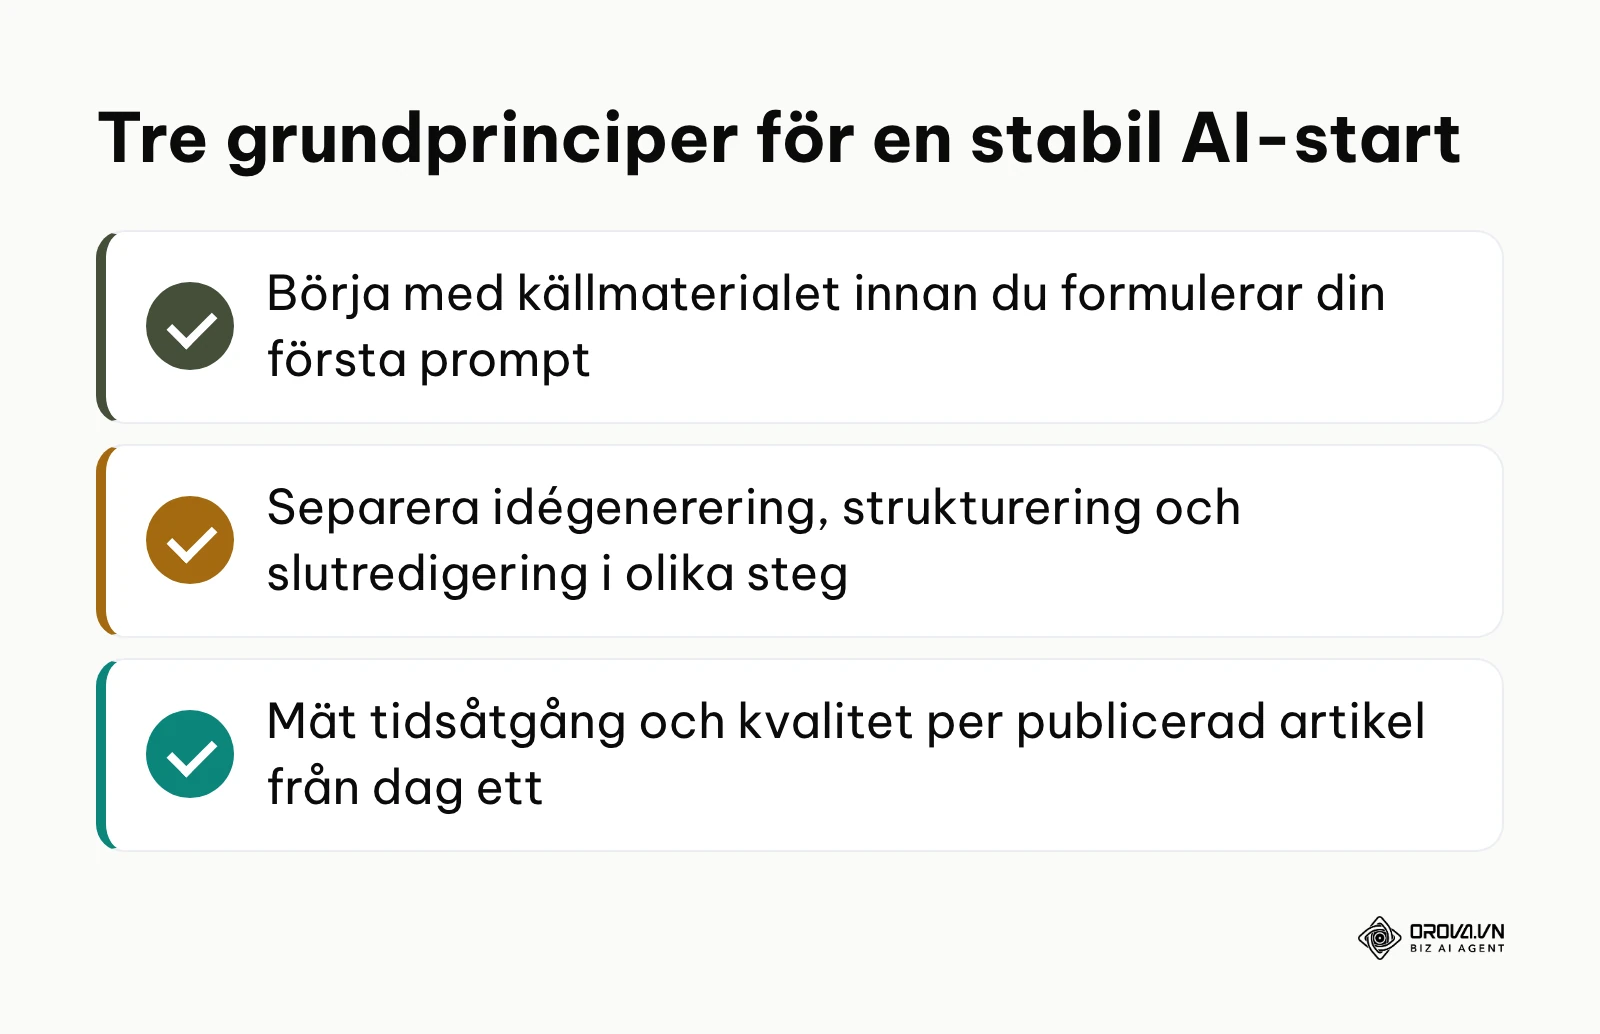
Om du helt saknar tidigare verktyg eller process bör du inte börja med att köpa in avancerade mjukvarulösningar. Din första uppgift är att öppna en enkel textfil och skriva ned en detaljerad beskrivning av din ideala läsare samt en lista med fem återkommande frågor som dina kunder ställer. Detta dokument kommer att fungera som din första grundinstruktion oavsett vilket verktyg du senare väljer att testa.
Om du redan använder AI men på ett splittrat sätt, där olika medarbetare matar in slumpmässiga prompter i gratisverktyg, behöver du standardisera flödet. Ägna en timme åt att skapa ett gemensamt dokument med en fast artikeldisposition och en lista med stilregler som hela teamet måste använda. När alla utgår från samma struktur blir kvaliteten genast mer förutsägbar och jämn.
Om du redan producerar AI-innehåll i stor skala men saknar systematisk uppföljning är din prioritet att införa mätpunkter. Välj ut de tio senast publicerade artiklarna och kör dem genom checklistan mot hallucinationer för att kartlägga eventuella kvalitetsbrister. Därefter sätter du upp en enkel uppföljning för att analysera hur väl artiklarna faktiskt presterar i sökmotorerna över tid. Om du vill ha inspiration för att styra andra digitala kanaler kan du läsa vår genomgång om att framgångsrikt driva sociala medier för företag.
Med rätt grundförståelse för hur fungerar en ai-textgenerator kan du förvandla slumpmässigt chattande till ett förutsägbart, värdeskapande produktionsflöde.
Om skribenten

Builder of Orova
Nguyễn Đỗ Trọng Ân has 8 years of experience in marketing, including 6 years managing market development across Asia. He builds Orova, a Biz AI Agent that never sleeps: it plans, runs and optimizes work for businesses.
Driv ditt företag med AI Agents
Orova är din alltid aktiva Biz AI Agent — den planerar, utför och optimerar arbetet åt dig.
Spara tid, frigör produktivitet.